

« Si votre travail ne tire pas profit des outils d'IA actuels, c'est un constat, pas un échec », a écrit Amazon à ses ingénieurs logiciels dans un mémo rapporté par CNBC. Voilà une phrase inhabituelle de la part d'une entreprise qui vend de l'IA à d'autres entreprises, et elle se résume facilement en titre : Amazon dit à ses ingénieurs d'utiliser moins d'IA.
Le mémo est plus nuancé que ce titre, et le débat qui l'entoure compte davantage que le mémo lui-même. Les tokens sont désormais une ligne des budgets d'ingénierie, et partout, on demande aux managers ce qu'Amazon vient de répondre publiquement : comment savoir que ces dépenses rapportent quelque chose ? Voici ce que le mémo dit et ne dit pas, ce que coûte réellement une licence sur quatre grands outils, et dans quels cas un plafond aide ou nuit.
Le tokenmaxxing, un problème de classement
CNBC définit le tokenmaxxing comme le fait, pour des développeurs, d'utiliser l'IA « autant que possible sans se soucier du résultat ». Le terme a une petite histoire chez Amazon. Selon CNBC, l'entreprise a fermé plus tôt cette année un classement interne après avoir constaté que des employés faisaient du tokenmaxxing pour grimper dans le tableau. Le récit d'I-Programmer, qui s'appuie sur des informations du Financial Times, indique que ce classement s'appelait Kirorank, n'a duré que quelques semaines et n'a jamais été officiellement autorisé. Des gens inventaient des tâches sans intérêt à confier à des agents IA, et Amazon payait les tokens.
Amazon n'était pas seule. Selon le même article, Meta a fermé plus tôt cette année un classement conçu par ses employés, où le personnel se disputait des titres comme Token Legend, selon le nombre de tokens consommés dans Claude Code. Il rappelle aussi un message interne ayant fuité plus tôt, signé du vice-président senior d'Amazon Dave Treadwell, demandant aux équipes d'arrêter d'« utiliser l'IA juste pour utiliser l'IA ».
Il n'a fallu aucune malhonnêteté pour en arriver là. Affichez un chiffre à l'écran, classez les gens dessus, et le chiffre monte.
Ce que dit le mémo, et ce qu'il ne dit pas
Selon CNBC, le mémo a circulé en interne avant qu'Amazon ne le publie sur son site. Il révise la façon dont Amazon décrit le métier des ingénieurs en développement logiciel et de leurs managers. Son constat central porte sur la mesure. Le volume de tokens, le taux d'adoption des outils d'IA et le nombre de modifications de code ou de revues restent des moyens « profondément défaillants » de juger l'usage de l'IA par une équipe, explique le mémo, car ils peuvent faire grimper les coûts et la complexité.
Il ne va pas jusqu'à interdire ces chiffres. Ils doivent être lus « avec soin et discernement » aux côtés d'autres données, et l'étalon préféré du mémo est énoncé clairement : « Nous pensons qu'il vaut mieux mesurer, et être mesuré, sur les résultats à long terme. »
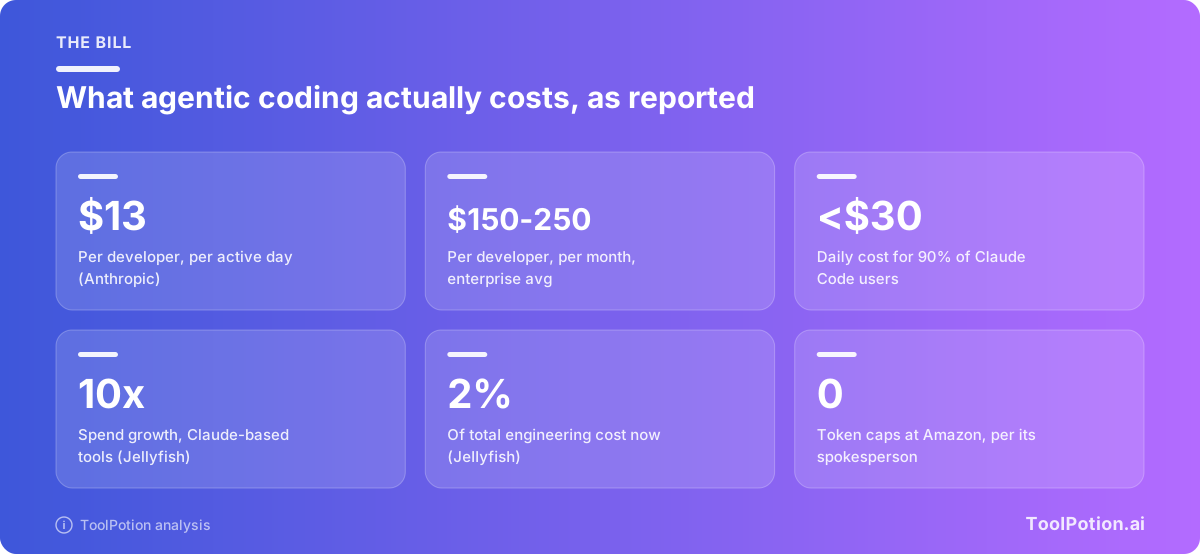
Un porte-parole d'Amazon a indiqué à CNBC que l'entreprise n'avait pas instauré de plafonds sur l'usage des tokens. C'est important, car « utilisez moins d'IA » va plus loin que ce qui a été rapporté. Rien dans la couverture que nous avons lue ne décrit un quota, un budget par ingénieur ou un montant en dollars. Amazon n'a pas dit ce qu'elle dépense, et aucun article n'a pu le dire non plus.
Marc Brooker, vice-président et ingénieur émérite chez AWS, a exposé à CNBC la logique en deux temps. L'entreprise examine des indicateurs comme la vélocité de livraison des fonctionnalités (nombre de lancements, nombre de changements réussis en production) et considère la dépense comme un investissement. Ce qu'elle ne veut pas, a-t-il dit, c'est du « travail inutile » sur des problèmes sans importance, et il a reconnu qu'il est parfois difficile de savoir lesquels, d'où un certain appétit pour l'expérimentation qui demeure.
Lu ainsi, le mémo ressemble davantage à une politique d'évaluation des performances qu'à un plan d'économies. La phrase que nous soulignerions est celle citée en ouverture. Un ingénieur capable d'expliquer où l'IA n'aide pas encore « fait preuve du discernement que nous attendons », dit le mémo. C'est une entreprise qui demande à ses managers de ne pas punir ceux qui éteignent un outil.
Pourquoi une entreprise qui vend de l'IA freinerait
La réponse simple, c'est le coût, et les montants croissent plus vite que les budgets. Jellyfish, qui édite des outils pour les équipes d'ingénierie, a publié un rapport sur les outils de code agentiques que TechCrunch a relayé. Chez les clients de Jellyfish, les dépenses en Claude Code et autres outils fondés sur les modèles d'Anthropic ont été multipliées par 10 depuis le début de l'année et représentent désormais environ 2 % du coût total d'ingénierie. Deux pour cent, c'est peu, mais Nicholas Arcolano, directeur scientifique de Jellyfish, a déclaré à TechCrunch que « cette croissance par 10, la plupart des directeurs financiers ne l'avaient pas prévue ».
La documentation d'Anthropic donne un ordre de grandeur plancher pour le coût individuel. Sur l'ensemble des déploiements en entreprise, le coût moyen de Claude Code est d'environ 13 $ par développeur et par jour d'activité, soit 150 à 250 $ par développeur et par mois, et 90 % des utilisateurs restent sous 30 $ par jour (documentation Claude Code). C'est une moyenne issue des propres clients d'un éditeur : considérez votre propre pilote comme le vrai chiffre.
Deux autres raisons relèvent de notre déduction, et rien dans les articles ne les énonce. Un indicateur fondé sur les modifications de code et les revues peut noyer les relecteurs sous une production que personne n'a demandée. Et un ingénieur qui court après un chiffre d'usage n'a guère de raison de se demander si une tâche nécessitait un modèle. Ni la couverture du mémo ni les articles autour ne mentionnent la sécurité comme moteur, nous ne prétendrons donc pas que ce fut le cas.
Les départs volontaires de Microsoft et un éditeur qui vend le compteur
Le mémo d'Amazon est tombé la même semaine que d'autres histoires d'entreprises qui conciliaient l'IA et leurs comptes, et ce n'est pas la même histoire. Microsoft a proposé des départs volontaires à un groupe d'environ 60 000 employés éligibles, soit environ 27 % de ses effectifs, tout en arbitrant entre un coûteux déploiement d'infrastructures IA et l'efficacité du capital. CNBC relie cela aux infrastructures et à la trésorerie, pas à l'usage de tokens de qui que ce soit. Le même article précise toutefois que Microsoft cherche à facturer ses clients selon l'usage réel qu'ils font de l'IA, ce qui revient à retourner le compteur.
Et puis il y a l'entreprise qui a le plus à gagner si vous dépensez davantage. Anthropic a lancé des outils de reporting qui permettent à un manager de voir ce qu'une équipe a produit sur une période donnée, ce que cela a coûté et où les workflows ont déraillé, ainsi que des budgets de groupe mutualisés pour que les équipes pilotent leurs dépenses en tokens. TechCrunch y voit une tentative évidente de prouver le retour sur investissement. Quelle que soit votre opinion sur le motif, le produit montre ce que les acheteurs demandent désormais : un coût par résultat plutôt qu'un coût par licence.
Découvrez ce que coûte vraiment une licence
Commencez par un groupe pilote et une base de référence, et faites-le avant que quiconque n'écrive un plafond. Tous les éditeurs ont évolué vers la facturation à l'usage, si bien que le prix affiché d'une licence en dit moins chaque année. Voici ce que mesure chaque grand outil, d'après les pages des éditeurs eux-mêmes.
| Outil | Ce qui est mesuré | Où plafonner |
|---|---|---|
| GitHub Copilot | Tokens, convertis en crédits IA à 0,01 $ l'unité. Business mutualise 1 900 crédits par utilisateur et par mois, Enterprise 3 900 | Budgets en dollars par utilisateur, centre de coûts et organisation |
| Cursor (Teams) | Enveloppe hebdomadaire par licence payante pour les modèles propres à Cursor. Les modèles tiers sont facturés sur un solde prépayé partagé | Limite mensuelle d'équipe, plus limites par défaut et par membre |
| Claude Code | Tokens d'API. Teams et Enterprise puisent dans les allocations des licences | Limites de dépenses dans les paramètres d'administration, ou limites d'espace de travail dans la Console |
| Codex (ChatGPT) | Allocation partagée avec ChatGPT Work, puis crédits | Crédits que vous achetez, et tableau de bord d'usage pour suivre le rythme |
Quelques détails trouvés dans la documentation qu'une page de tarifs ne vous donnera pas. La politique d'usage payant de Copilot est activée par défaut pour Business et Enterprise : la dépense au-delà des crédits mutualisés se poursuit donc, sauf si un administrateur la désactive explicitement (documentation GitHub). Les complétions en ligne restent illimitées, même avec un budget de 0 $. La revue de code Copilot est tarifée selon le niveau d'effort : GitHub estime 0,05 à 1 $ pour Lite et 1,50 à 25 $ pour Max, environ 10 $ en moyenne, avec en plus les minutes Actions (modèles et tarifs GitHub). Ce sont des estimations, et la documentation précise que la taille de la pull request les fait varier.
Si vous comparez les éditeurs eux-mêmes, Cursor vs GitHub Copilot vs Windsurf traite le sujet. Le plan Teams de Cursor vend des licences Premium, Super et Ultra à 30, 100 et 200 $ par mois, chacune avec sa propre enveloppe hebdomadaire pour les modèles propres à Cursor, non transférable entre collègues. Les modèles tiers, Claude compris, ne sont pas dans l'enveloppe : ils sont facturés sur un solde prépayé partagé au tarif catalogue de l'API, plus un tarif Cursor de 0,25 $ par million de tokens (documentation Cursor). Le plan Enterprise de Claude coûte 20 $ par licence et par mois, plus l'usage facturé aux tarifs de l'API (tarifs Claude). La page de tarifs de Codex indique clairement que les prix des tokens d'API sont distincts de l'usage inclus dans l'abonnement et ne doivent pas servir à estimer les tâches incluses.
Orientez le travail de routine vers un modèle moins cher
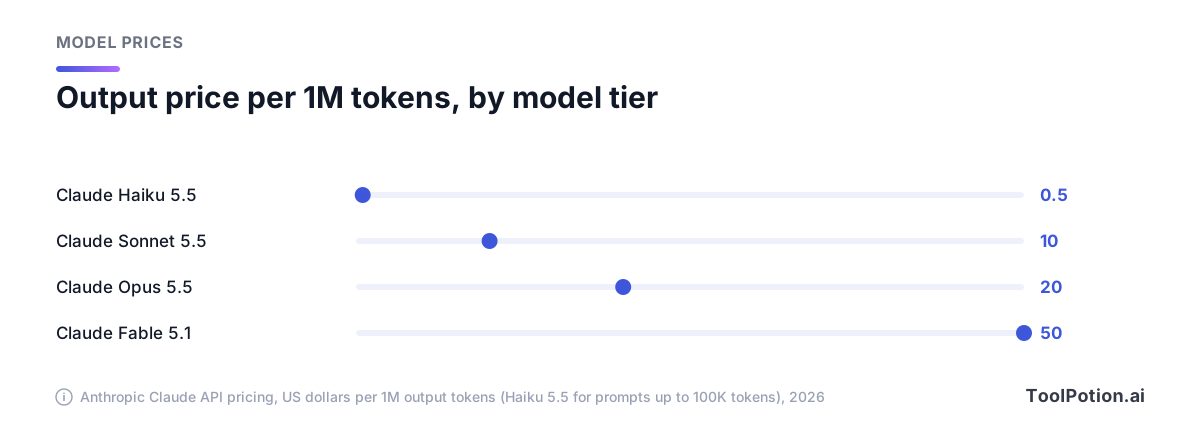
Le plus gros levier dans la documentation n'est pas un plafond. C'est le modèle. Sur la grille tarifaire de l'API d'Anthropic, Claude Haiku 5.5 facture 0,50 $ par million de tokens de sortie pour des prompts jusqu'à 100 000 tokens (le prix passe à 2,50 $ au-delà), Sonnet 5.5 10 $, Opus 5.5 20 $ et Fable 5.1 50 $. Soit un écart de 1 à 100 entre le bas et le haut d'une même gamme, et les tableaux de GitHub et de Cursor affichent les mêmes prix de sortie.
Les conseils d'Anthropic sur les coûts vont dans le sens de l'arithmétique. Sonnet « gère bien la plupart des tâches de code et coûte moins cher qu'Opus », indique-t-elle, Opus étant réservé aux décisions d'architecture ou au raisonnement en plusieurs étapes, et model: haiku aux tâches simples de sous-agents (documentation Claude Code). Notre analyse plus détaillée sur l'adéquation des niveaux de modèle aux tâches se trouve dans quel niveau de modèle IA pour quelle tâche, et les agents en terminal sont comparés dans Claude Code vs Codex vs Gemini CLI.
Voici l'économie aux prix catalogue, la part du travail qu'un petit modèle peut absorber étant votre propre estimation. Les prix sont les tarifs catalogue d'Anthropic pour des prompts courts.
Les tokens de sortie ne sont qu'une partie de la facture, et la part du petit modèle est une hypothèse que vous devrez valider avec vos propres tâches. Renommer des variables et écrire des squelettes de tests s'y prêtent probablement. Un plan de migration pour un service de paiement, probablement pas.
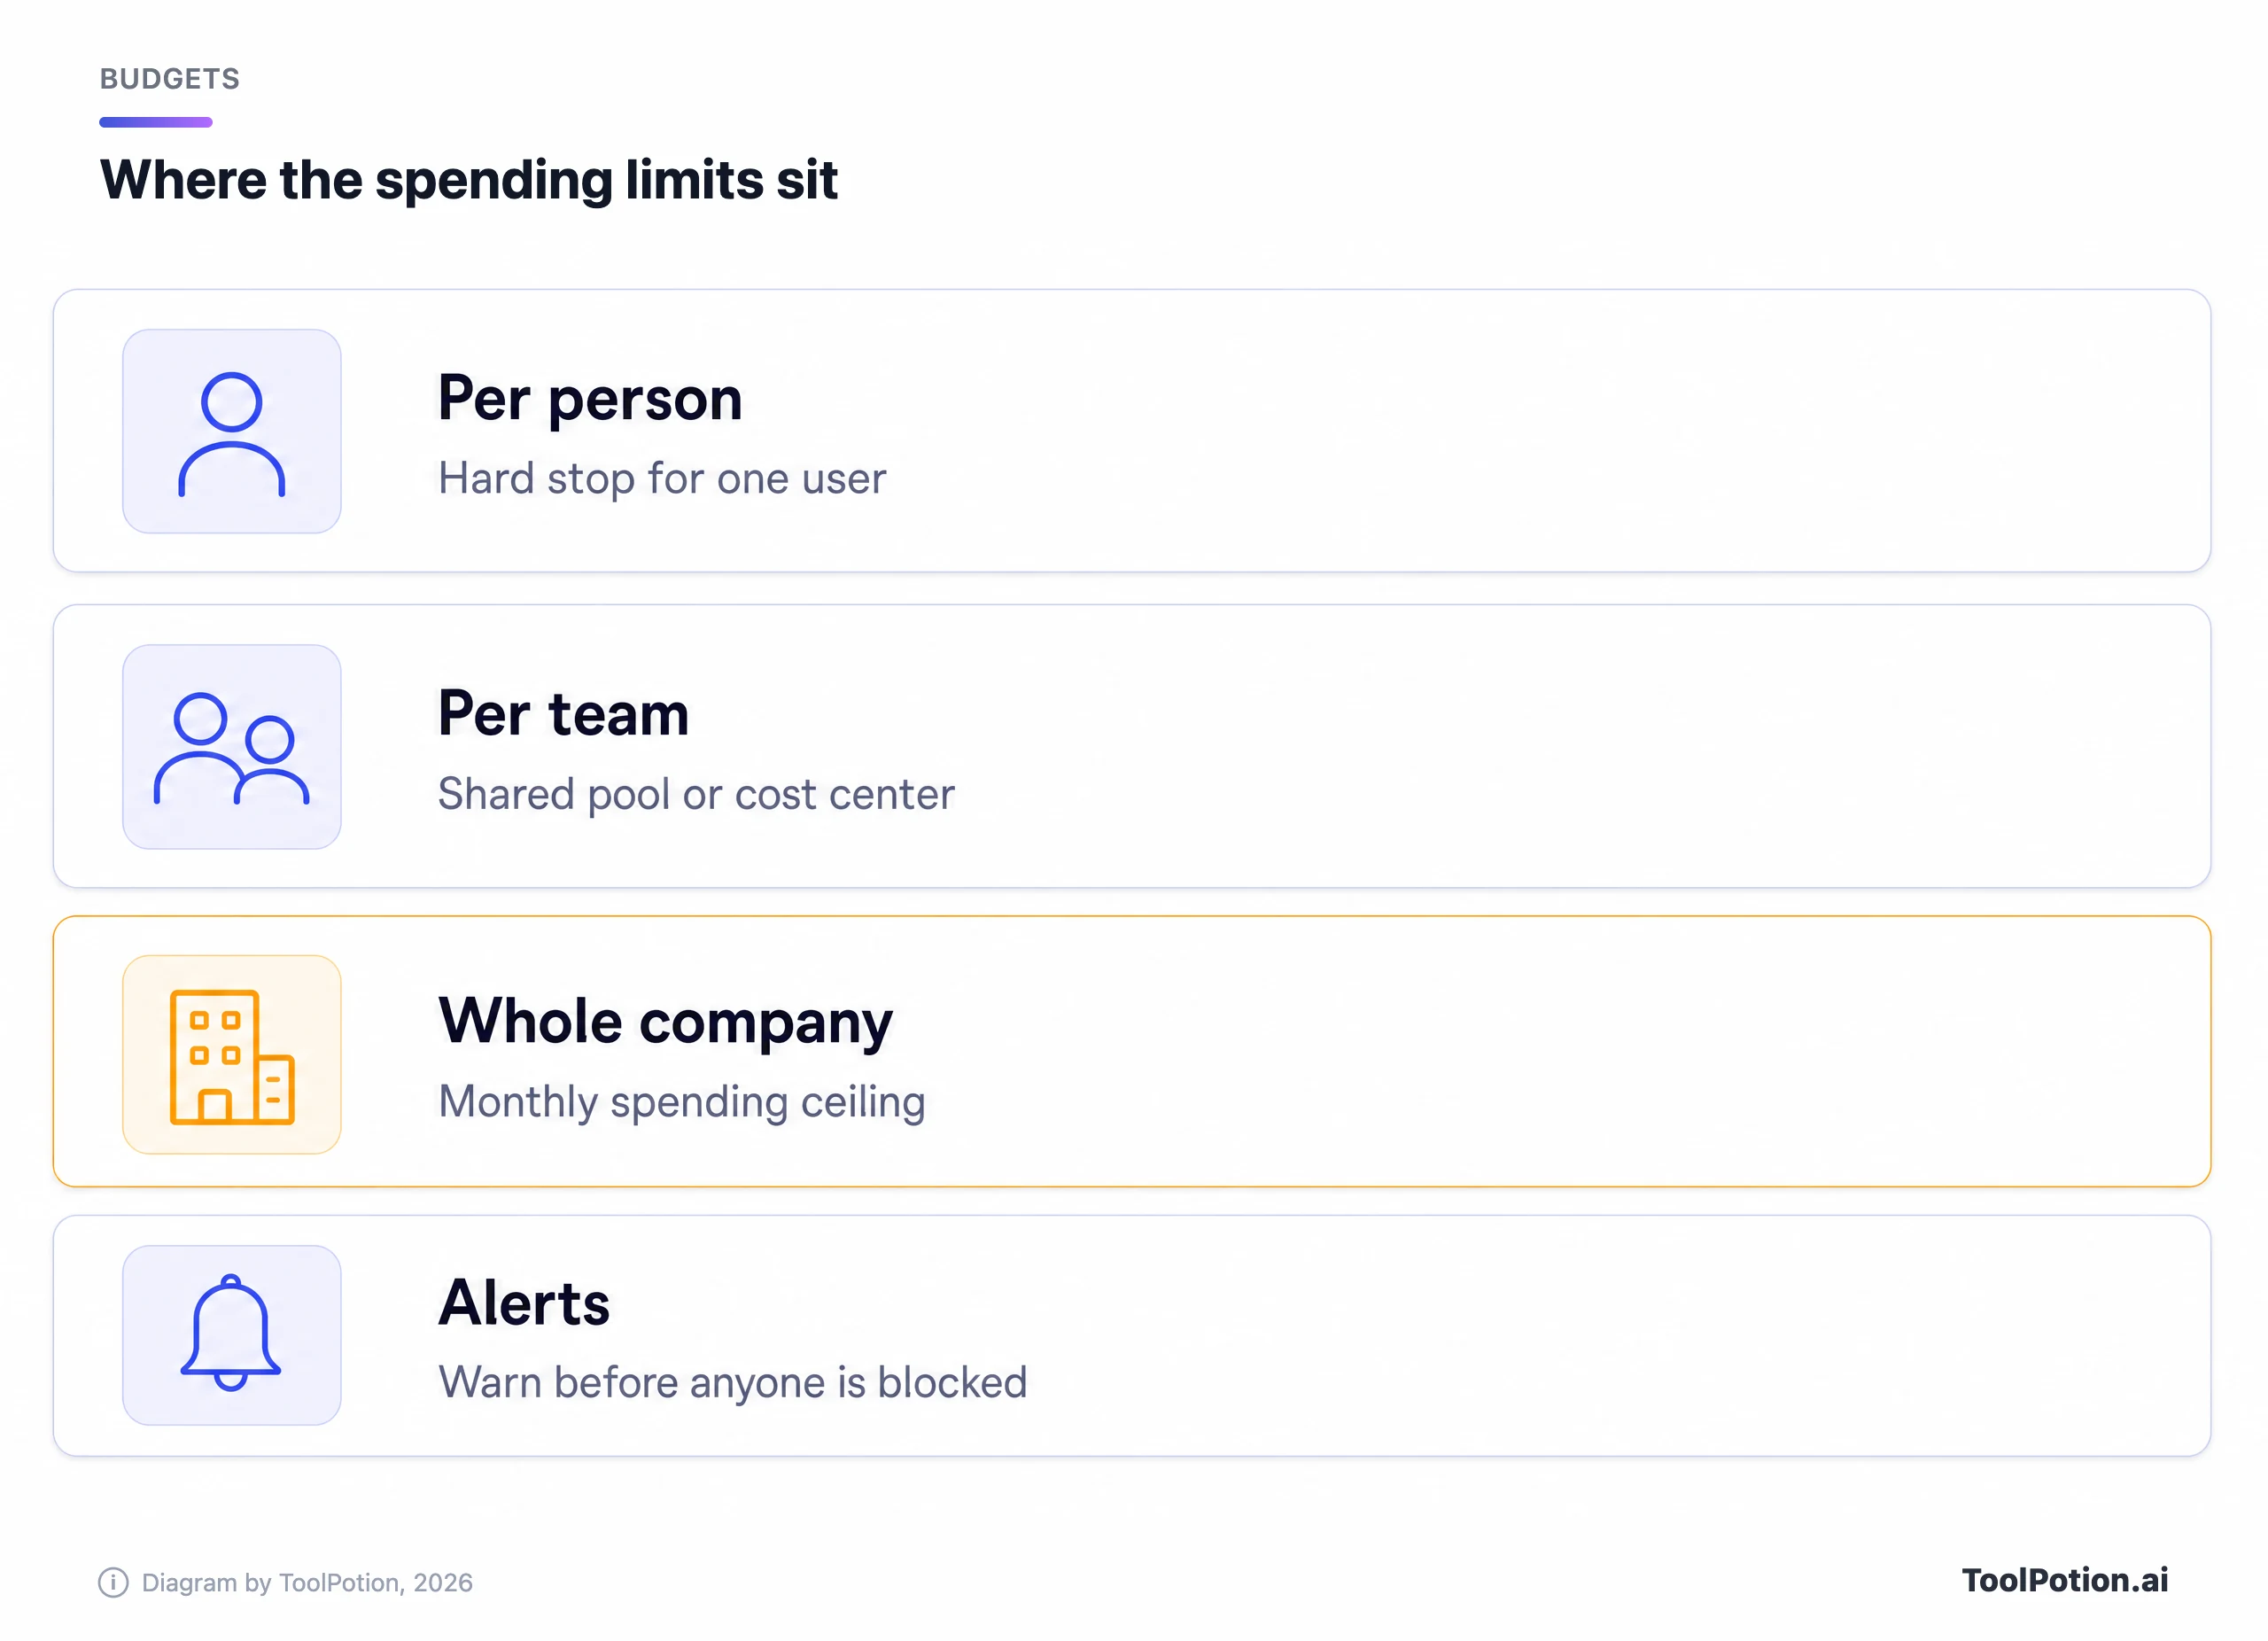
Les plafonds, dans l'ordre où nous les fixerions
- Activez le reporting d'usage pour un groupe pilote et lisez-en deux semaines avant de choisir un chiffre.
- Configurez d'abord les alertes. GitHub peut envoyer un e-mail et afficher une bannière à 75 %, 90 % et 100 % d'un budget (documentation GitHub).
- Ajoutez un plafond mensuel pour toute l'entreprise que vous pourriez supporter si chaque licence était utilisée à fond, afin qu'une boucle d'agent hors de contrôle coûte un montant connu.
- Ajoutez seulement ensuite des limites par équipe ou par personne, et rendez-les souples quand l'outil le permet. Le budget au niveau utilisateur de GitHub bloque toujours net, et sa documentation avertit que des budgets qui se chevauchent peuvent empêcher des personnes d'accéder à un outil dont elles dépendent.
- Faites descendre d'un niveau les modèles par défaut pour le travail de routine et faites du modèle premium un choix délibéré.
La documentation de Claude Code donne aussi des points de départ de limites de débit par utilisateur selon la taille de l'équipe, par exemple 15 000 à 20 000 tokens par minute et par utilisateur pour 100 à 500 utilisateurs. Ce sont des limitations de débit, pas des budgets, et la documentation les présente comme des recommandations à ajuster.
Quand rationner est malin, et quand c'est une fausse économie
Nous rationnerions le gaspillage, jamais les tentatives. Un plafond qui fait réfléchir un développeur avant de coller tout un dépôt dans le meilleur modèle remplit son rôle. Un plafond qui pousse ce même développeur à sauter l'exécution de tests générés par IA, ou à éviter l'agent pour le refactoring difficile où il est le plus rentable, coûte plus qu'il ne rapporte.
Faites le calcul. Si les outils agentiques représentent environ 2 % du coût d'ingénierie, comme le rapporte Jellyfish, diviser la facture par deux économise 1 % du coût d'ingénierie. Un ingénieur ralenti de 1 % annule ce gain. Rationner ne gagne que s'il supprime une dépense qui n'a rien produit, ce qui est précisément le point d'Amazon sur le travail inutile.
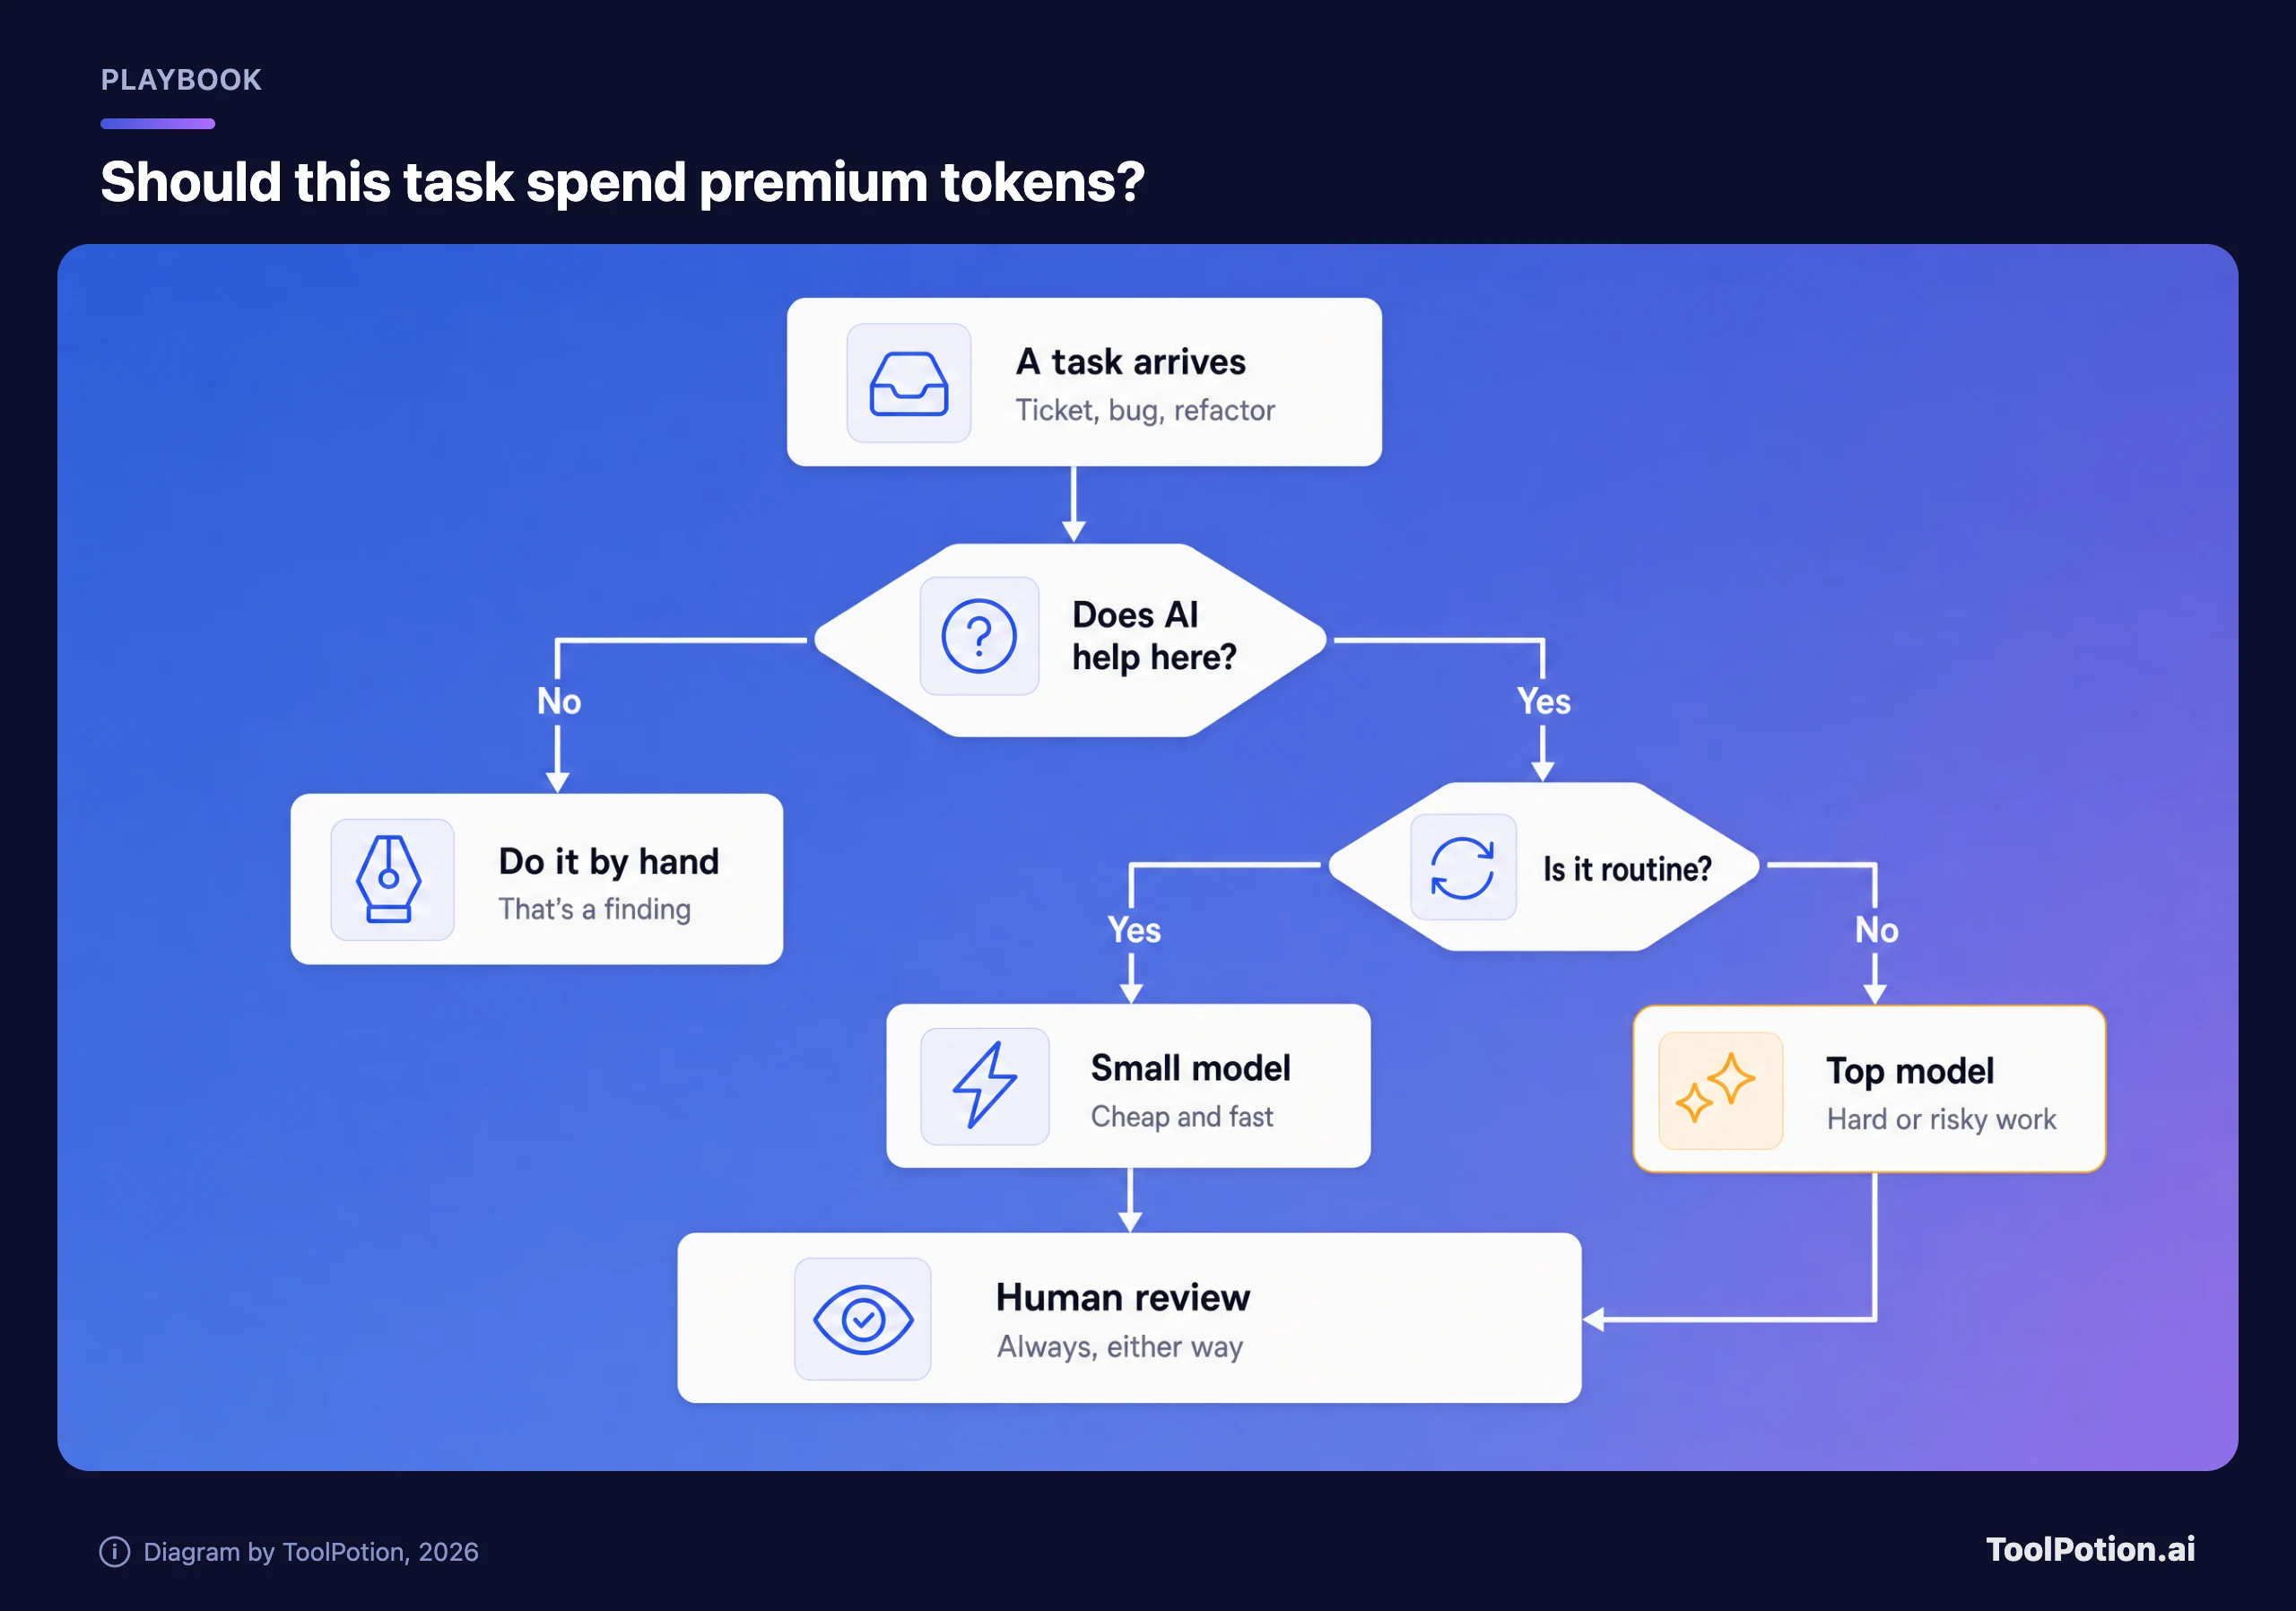
Rationner est judicieux pour l'automatisation en arrière-plan que personne ne lit, pour le modèle haut de gamme sur des tâches de routine et pour les classements par personne. C'est une fausse économie pour la revue de code, les tests et l'intégration. Si l'étape de revue par IA est ce qui attrape la mauvaise fusion, la brider revient à parier contre son propre filet de sécurité, et notre guide des outils de revue de code IA ainsi que le classement ToolRank pour la revue et les tests montrent combien d'alternatives existent avant de couper quoi que ce soit.
Ce que nous ne couperions pas
La relecture humaine reste, quel que soit le modèle qui a écrit le code. Le mémo d'Amazon déconseille de mesurer le nombre de revues, mais il ne suggère pas de les sauter. La formation reste aussi, car celui qui sait quand recourir au modèle bon marché est celui à qui l'on a montré à quoi sert chaque modèle. Et l'expérimentation reste, car Brooker reconnaît lui-même que personne ne peut dire à l'avance quels problèmes comptent.
Suivez bien les résultats comme le fait le mémo : lancements, changements réussis en production, délai entre la demande et la fusion. Les tokens bruts relèvent de la colonne des coûts, et surtout pas d'une évaluation de performance. Si vous n'avez pas écrit noir sur blanc ce que votre équipe peut ou non confier à ces outils, notre modèle de politique d'usage de l'IA est un bon début, et l'explication des modèles de tarification et l'audit de stack couvrent le volet abonnements.
Après avoir lu les pages de tarifs de GitHub Copilot, Cursor, Claude Code et Codex, nous retenons une règle : le prix de la licence n'est que le droit d'entrée. Sortez l'usage par personne d'un mois récent depuis l'outil que vous utilisez, triez-le et regardez les cinq premières lignes. Si ce sont vos meilleurs ingénieurs, laissez-les tranquilles. Si c'est un seul script dans une boucle, vous avez trouvé votre plafond.