

Lance Fortnow tient un blog sur la complexité algorithmique depuis plus de vingt ans, et ce n'est pas quelqu'un qui s'emballe. Son billet sur cette nouvelle annonce se termine par une phrase prudente : « Je n'ai pas vérifié la preuve moi-même, mais on peut désormais supposer sans trop de risque que l'hypothèse du temps exponentiel est bonne pour la poubelle » (Computational Complexity).
L'annonce vient de deux labos. OpenAI, l'entreprise derrière ChatGPT, affirme que son modèle a réfuté l'Exponential Time Hypothesis, généralement abrégée en ETH. Quelques heures plus tard, Anthropic, éditeur de Claude (nous comparons les deux assistants ici), a publié sa propre réfutation. Les gros titres ont ensuite relié l'affaire à une querelle entre mathématiciens et à des craintes pour le chiffrement mondial. Nous avons lu les publications des deux labos, les commentaires d'experts et la couverture presse, et notre avis est net : le résultat est probablement réel et important pour les théoriciens, et ce n'est pas une raison de changer votre façon de protéger vos données. Deux des trois gros titres concernent d'autres différends, et le troisième parle d'une tendance.
Qu'est-ce que l'Exponential Time Hypothesis, en termes simples ?
Partons d'un casse-tête appelé 3-SAT. Vous disposez d'une longue liste de conditions portant sur n interrupteurs vrai/faux, chacune du type « A, ou non B, ou C », et vous devez trouver une configuration des interrupteurs qui les satisfasse toutes. Vérifier une configuration proposée est rapide. En trouver une, c'est la partie difficile, un peu comme un sudoku : une grille remplie se vérifie facilement, une grille vide beaucoup moins.
L'ETH, proposée en 1999 par Russell Impagliazzo et Ramamohan Paturi (avec Francis Zane), affirme que tout algorithme pour 3-SAT demande un temps qui croît comme 2 puissance c fois n, pour une constante c strictement positive (Fortnow). Imaginez un cadenas à combinaison où chaque molette supplémentaire multiplie le travail par un facteur fixe, disons 1,3. L'ETH dit que ce facteur peut être réduit, mais jamais jusqu'à 1.
La réfutation dit que le facteur se rapproche bien de 1 à mesure que les formules grandissent. D'après Fortnow, l'article d'OpenAI donne un temps d'exécution d'environ 2 puissance n fois log log n divisé par la racine carrée de log n. C'est encore loin d'être rapide : cela croît simplement plus lentement que n'importe quel multiplicateur fixe. Anthropic est franc là-dessus dans sa publication : « Le résultat est purement asymptotique et ne dit rien de la résolution de formules en pratique » (Anthropic).
Pourquoi les théoriciens y tenaient-ils tant ? L'ETH a servi dans des centaines d'articles comme substitut à « ce problème ne peut pas être résolu beaucoup plus vite » (OpenAI). Si l'hypothèse est fausse, ces arguments de difficulté doivent être revérifiés, même si Fortnow rappelle que « le fait que l'ETH et la SETH échouent ne signifie pas que leurs implications sont fausses ».
Plus vérifié que d'habitude, mais loin d'être tranché
La vérification déjà faite dépasse ce que reçoivent la plupart des percées en une première semaine. OpenAI affirme que son modèle a trouvé la réfutation dix jours avant l'annonce et qu'elle a été formalisée dans Lean, un vérificateur de preuves qui n'accepte que les étapes qu'il peut valider (OpenAI). Anthropic indique qu'un modèle Claude interne a trouvé sa version, et que ses fichiers Lean ont été écrits par des modèles d'IA (Anthropic).
Des humains s'y sont depuis mis. Ryan O'Donnell, de Carnegie Mellon, a publié une réécriture de l'exposé de la preuve, et selon Fortnow, Shiva Kintali en a posté une autre, toutes deux visant la simplicité plutôt que les meilleures bornes. Timothy Gowers a qualifié la chose de « Très surprenant et lourd de conséquences que ce soit faux » (Business Insider).
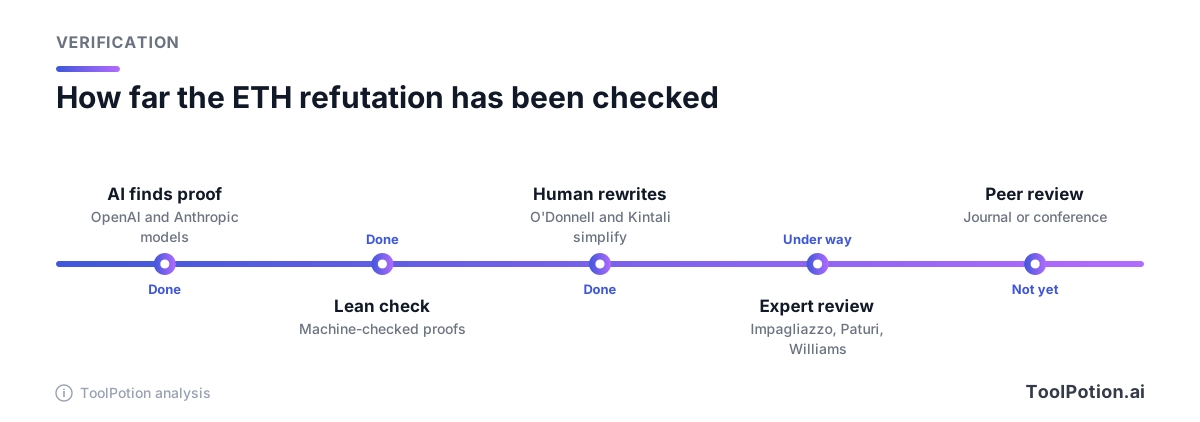
Les personnes officiellement chargées de la vérifier sont Impagliazzo, Paturi et Ryan Williams du MIT, qui a confié à TechCrunch que certaines parties de la preuve sont classiques, mais qu'« il y a deux ou trois passages d'aspect étrange ». Business Insider rapporte que Williams n'a pas certifié le résultat et que le groupe précise que sa participation ne vaut pas validation. Une autre mise en garde, tirée du dépôt d'Anthropic : Lean vérifie les preuves, mais « aucune machine ne vérifie que ce fichier dit bien ce que dit l'article », si bien qu'un humain doit relire le court fichier d'énoncés. Ils l'ont gardé court pour cette raison.
Notre lecture : une annonce venue de deux labos, des preuves vérifiées par machine et des réécritures humaines en quelques jours, c'est exceptionnellement solide. Cela reste une annonce tant que le groupe d'experts et une revue ne se prononcent pas.
La querelle des mathématiciens concerne-t-elle ce résultat ?
Pas vraiment. Le « bust-up between mathematicians » de la BBC porte sur un autre problème. Son article traite du différend sur Navier-Stokes, où Tristan Buckmaster, de NYU, a demandé si ses brouillons, stockés dans l'outil Codex d'OpenAI, avaient pu alimenter les propres travaux d'OpenAI. OpenAI répond que personne chez elle n'a vu les travaux de l'autre équipe, et que ses prompts « n'ont pas pu influencer le système de quelque manière que ce soit ».
Le titre « scooped » de Scientific American concerne Yang-Mills, un problème de physique. Le magazine écrit qu'OpenAI semble avoir devancé Ethan Sussman, qui travaille avec Levent Alpöge d'Anthropic, vers une preuve. Alpöge s'est opposé sur X. Rien de tout cela ne touche à la question de savoir si l'algorithme pour 3-SAT fonctionne.
La dispute sur l'ETH porte sur la méthode. Williams avait qualifié une précédente publication d'OpenAI d'« attaque DDOS contre les mathématiciens » (X), puis a accepté d'aider sur celle-ci. Selon Scientific American, la démarche d'OpenAI sur deux des trois résultats contrevenait à une déclaration de clarification de son propre groupe consultatif d'experts sur l'IA et les mathématiques, et les prompts et la chaîne de raisonnement associés restent privés. Pour l'ETH, OpenAI a en revanche accepté de publier la preuve et de financer une conférence.
Cela casse-t-il RSA ou le chiffrement de mon téléphone ?
Non, et pas par cette voie. Nous sommes aussi catégoriques parce que les raisons sont précises. D'abord, l'algorithme résout k-SAT. Fortnow insiste : il « n'apporte rien de nouveau pour Subset Sum ou le voyageur de commerce », car les ramener à 3-SAT fait trop gonfler le nombre de variables. Ensuite, RSA repose sur la difficulté de décomposer un énorme nombre en deux facteurs premiers (le Financial Times décrit la méthode sans la nommer), un problème différent de la satisfaction de formules logiques, et aucune des sources que nous avons lues ne dit que le nouvel algorithme l'atteint. Enfin, la borne est asymptotique : rien ne change pour une clé de 2 048 bits sur aucune machine existante.
Williams a soulevé l'inquiétude évidente auprès du responsable science d'OpenAI, Dan Roberts. D'après TechCrunch, il a demandé si quoi que ce soit était désormais vulnérable, et a rapporté qu'OpenAI aurait vérifié et se disait « raisonnablement confiante » que cela n'impliquait aucune faille. C'est de seconde main et non publié, à pondérer en conséquence. Williams a aussi dit qu'un algorithme amélioré pourrait faire considérer certaines tailles de clés comme cassées.
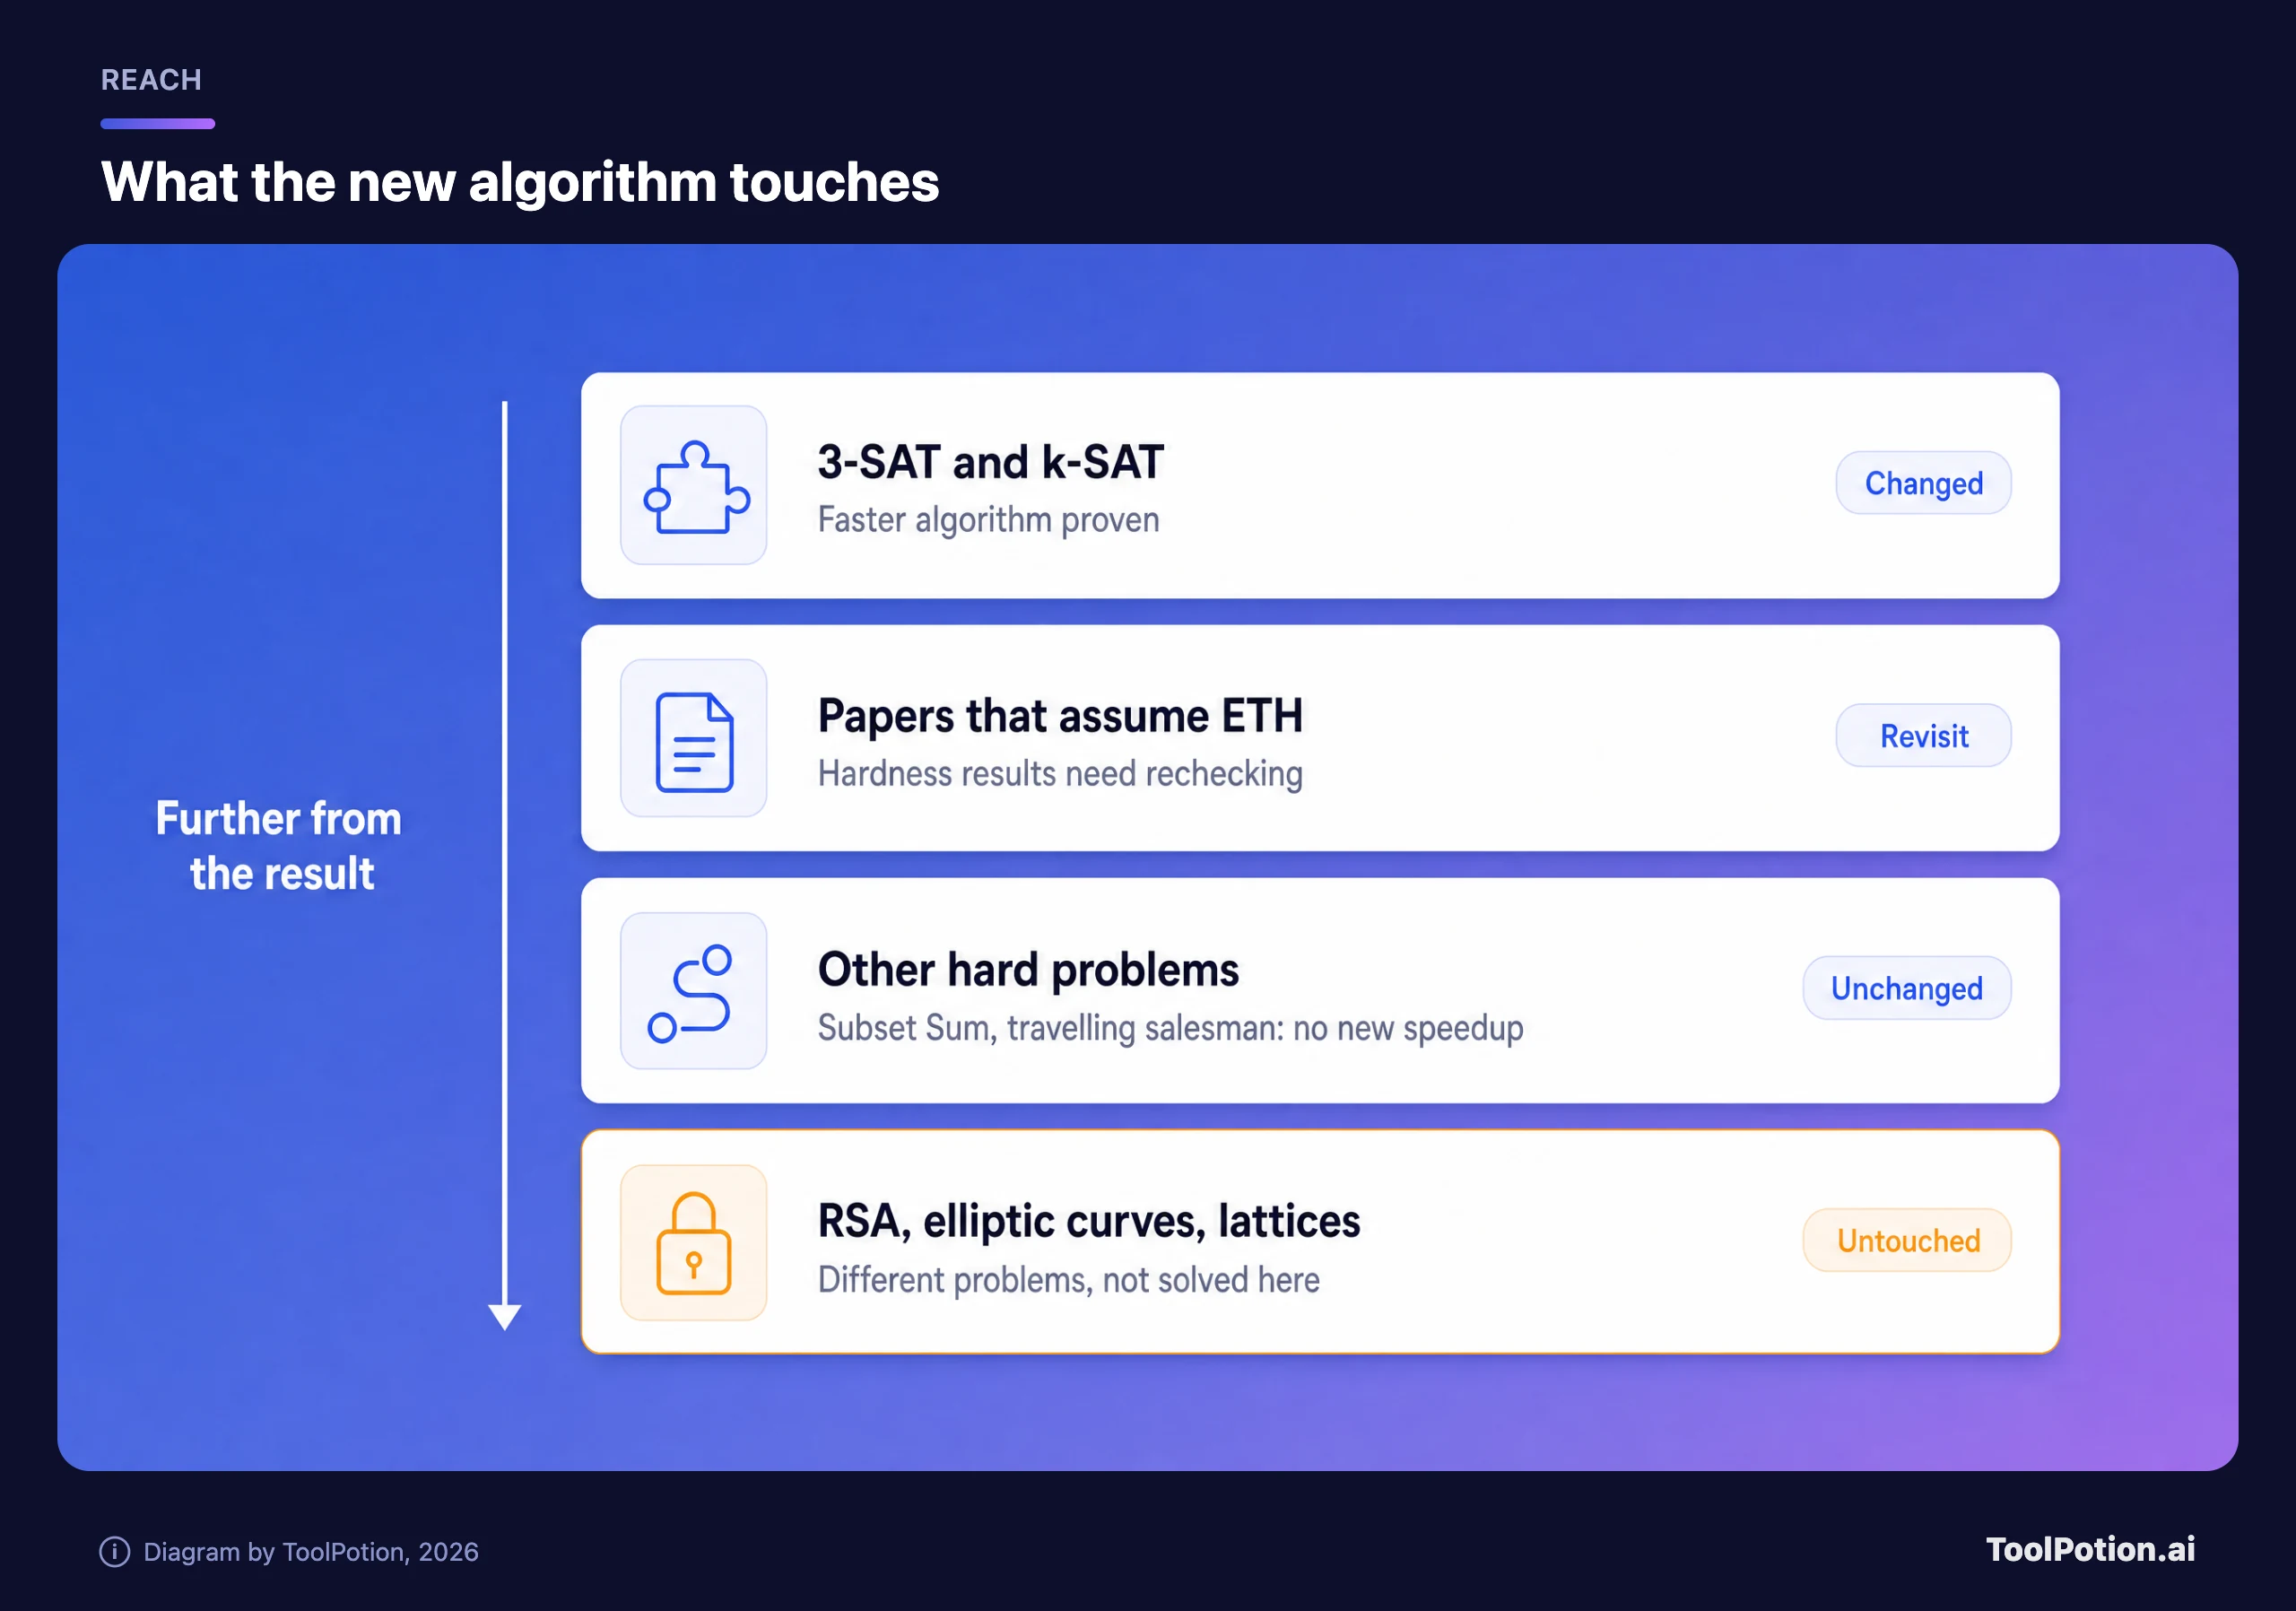
Il y a une vraie question ouverte en dessous. Williams dit que « tout informaticien devrait probablement accorder un peu plus de poids à la plausibilité de P = NP », mais John D. Cook rappelle que « le statut de P = NP reste inconnu » (Business Insider). Williams ne pense pas non plus que le nouvel algorithme soit optimal. Si un algorithme plus affûté arrive, les arguments changeront.
L'article du Financial Times parle d'une tendance, pas de cette preuve
L'article du FT porte sur la capacité mathématique croissante de l'IA et sur le chiffrement en général, et dans le texte que nous avons pu lire, il ne mentionne jamais l'ETH. Ses sources sont mesurées. Le mathématicien australien Geordie Williamson a dit à un auditoire de l'Imperial College que l'IA provoque « une restructuration complète de ce qu'est la difficulté », et qu'il faut s'attendre à des chocs. Daniel Shiu, de l'université de Manchester, a qualifié le fait que l'IA casse le chiffrement de « risque significatif » pour les « formes de cryptographie plus mathématiques », en citant certains algorithmes résistants au quantique « moins matures ». Le FT lui-même écrit que l'IA « n'a pas encore cassé de méthode cryptographique de base ».
Scott Aaronson ajoute un fil à tirer : la cryptographie brille par son absence dans la précédente liste de 376 articles d'OpenAI, et dans une mise à jour de son billet, il écrit que ses sources lui disent que des entreprises d'IA ont commencé à étudier si leurs modèles peuvent casser des protocoles. Il n'a donné aucun nom, et nous non plus.
Notre lecture : l'inquiétude raisonnable concerne les schémas récents, pas ceux de votre navigateur. Les standards du NIST de 2024 comprennent deux schémas à base de réseaux euclidiens et un troisième standard de signature fondé sur un autre type de mathématiques, gardé en secours au cas où le premier se révélerait vulnérable.
Ce que doit vraiment faire une petite entreprise
Presque rien, et rien d'urgent. L'arbre ci-dessous classe les trois situations qui comptent selon nous.
Une habitude vaut la peine d'être adoptée, quelle que soit cette histoire. Le régulateur britannique a déclaré au FT que « les entreprises ne devraient pas attendre pour agir » face aux risques que l'IA et le quantique font peser sur la cryptographie, et BT dit vouloir une cryptographie qui soit « changée plus facilement à mesure que les standards, technologies et menaces évoluent ». Pour une petite structure, cela revient à garder ses logiciels à jour et à demander aux fournisseurs comment ils changeraient d'algorithme. Notre cadre pour confier vos données à des outils d'IA détaille les questions à poser aux fournisseurs, et le classement Security & Privacy de ToolRank liste les outils par catégorie.
Trois points à surveiller avant de parler de résultat acquis
Surveillez trois choses. Le rapport du groupe d'experts composé d'Impagliazzo, Paturi et Williams, et la conférence qu'OpenAI a accepté de financer. Des relectures indépendantes des fichiers d'énoncés Lean, puisque c'est là qu'une erreur subtile pourrait se cacher. Et la relecture par les pairs d'une revue, dont nous n'avons trouvé aucune trace pour l'instant. Tant que le premier de ces éléments n'est pas paru, nous dirons « très probablement réfutée ».