

„Wenn Ihre Arbeit von aktuellen KI-Tools nicht profitiert, ist das eine Erkenntnis, kein Versagen“, teilte Amazon seinen Softwareentwicklern in einem Memo mit, über das CNBC berichtete. Das ist ein ungewöhnlicher Satz von einem Unternehmen, das KI an andere Firmen verkauft, und er lässt sich leicht zur Schlagzeile verkürzen: Amazon sagt Entwicklern, sie sollen weniger KI nutzen.
Das Memo ist differenzierter als diese Schlagzeile, und die Debatte drumherum ist wichtiger als das Memo selbst. Tokens sind inzwischen ein Posten im Engineering-Budget, und Führungskräfte überall müssen die Frage beantworten, die Amazon gerade öffentlich beantwortet hat: Woher wissen Sie, dass das Geld überhaupt etwas bringt? Im Folgenden lesen Sie, was im Memo steht und was nicht, was ein Seat bei vier großen Tools tatsächlich kostet und wo ein Limit hilft oder schadet.
Tokenmaxxing ist ein Leaderboard-Problem
CNBC definiert Tokenmaxxing so: Entwickler nutzen KI „so viel wie möglich, ohne Rücksicht auf das Ergebnis“. Der Begriff hat bei Amazon eine kleine Vorgeschichte. Laut CNBC hat das Unternehmen Anfang des Jahres ein internes Leaderboard abgeschaltet, nachdem sich herausgestellt hatte, dass Mitarbeitende per Tokenmaxxing im Ranking nach oben kletterten. Der Bericht von I-Programmer, der sich auf Berichte der Financial Times stützt, nennt das Board Kirorank; es lief nur wenige Wochen und war nie offiziell genehmigt. Die Leute erfanden banale Aufgaben für KI-Agenten, und Amazon bezahlte die Tokens.
Amazon war damit nicht allein. Laut demselben Bericht hat Meta Anfang des Jahres ein von Mitarbeitenden gebautes Board geschlossen, auf dem die Belegschaft um Titel wie Token Legend konkurrierte, gerankt danach, wie viele Tokens sie in Claude Code verbrannten. Der Bericht erinnert außerdem an eine frühere, durchgesickerte Nachricht von Amazons Senior Vice President Dave Treadwell, in der er die Belegschaft bat, aufzuhören, „KI nur um der KI willen zu nutzen“.
Dafür musste niemand unehrlich sein. Man stellt eine Zahl auf einen Bildschirm, rankt die Leute danach, und die Zahl steigt.
Was das Memo sagt und was nicht
Laut CNBC kursierte das Memo intern, bevor Amazon es auf seiner Website veröffentlichte. Es überarbeitet, wie Amazon die Aufgabe von Softwareentwicklern und ihren Vorgesetzten beschreibt. Die Kernaussage betrifft die Messung. Token-Verbrauch, Adoptionsrate von KI-Tools und die Zahl von Code-Änderungen oder Reviews seien allesamt „grundlegend fehlerhafte“ Maßstäbe, um die KI-Nutzung eines Teams zu beurteilen, heißt es im Memo, weil sie höhere Kosten und zu viel Komplexität verursachen können.
Die Zahlen verbietet das Memo nicht. Man solle sie „mit Sorgfalt und Urteilsvermögen“ neben anderen Daten lesen, und der bevorzugte Maßstab wird klar benannt: „Wir glauben, dass es am besten ist, langfristige Ergebnisse zu messen und daran gemessen zu werden.“
Ein Amazon-Sprecher sagte CNBC, das Unternehmen habe keine Obergrenzen für den Token-Verbrauch eingeführt. Das ist wichtig, denn „weniger KI nutzen“ schießt über das Berichtete hinaus. In der von uns gelesenen Berichterstattung steht nichts von einer Quote, einem Budget pro Entwickler oder einem Dollarbetrag. Amazon hat nicht gesagt, was es ausgibt, und die Berichte konnten es auch nicht sagen.
Marc Brooker, Vice President und Distinguished Engineer bei AWS, erklärte CNBC die Logik in zwei Teilen. Das Unternehmen schaue auf Dinge wie Feature-Velocity (wie viele Launches, wie viele erfolgreiche Änderungen in Produktion) und behandle die Ausgaben als Investition. Was man nicht wolle, seien „vergeudete Mühen“ bei Problemen, die keine Rolle spielen. Er räumte ein, dass sich manchmal schwer sagen lasse, welche das sind, weshalb ein gewisser Spielraum zum Experimentieren bleibe.
So gelesen, ähnelt das Memo eher einer Richtlinie für Leistungsbeurteilungen als einem Sparprogramm. Der Satz, den wir unterstreichen würden, ist der ganz oben zitierte. Ein Entwickler, der erklären kann, wo KI noch nicht hilft, zeigt laut Memo „genau das Urteilsvermögen, das wir erwarten“. Hier sagt ein Unternehmen seinen Führungskräften, sie sollen Leute nicht dafür bestrafen, dass sie ein Tool abschalten.
Warum ein Unternehmen, das KI verkauft, sich zurückhält
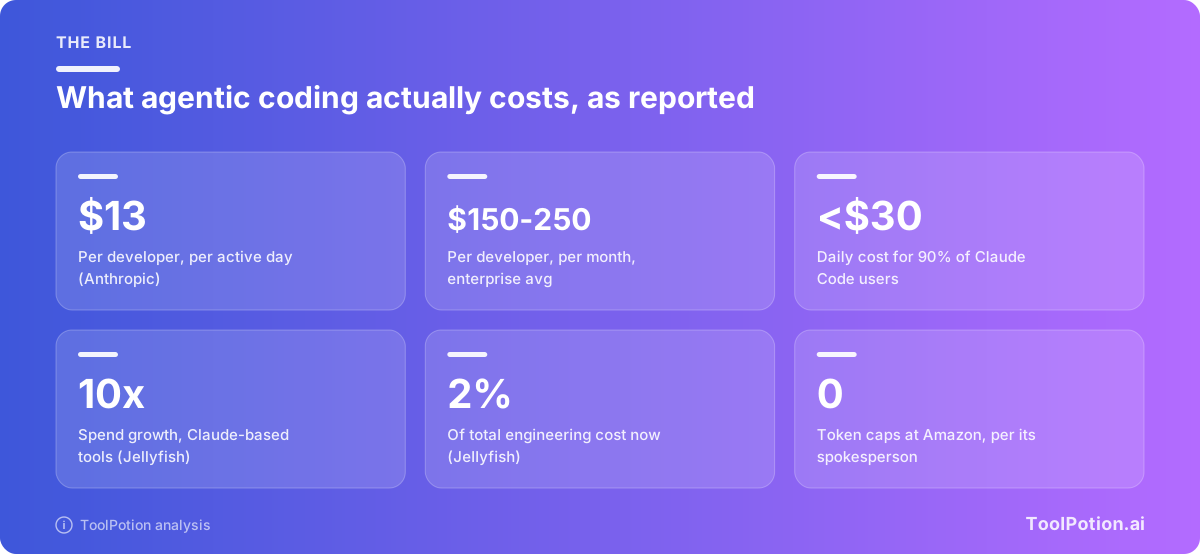
Die naheliegende Antwort sind die Kosten, und die Zahlen wachsen schneller als die Budgets. Jellyfish, das Tools für Engineering-Teams entwickelt, hat einen Report zu agentischen Coding-Tools veröffentlicht, über den TechCrunch berichtete. Bei den Kunden von Jellyfish sind die Ausgaben für Claude Code und andere auf Anthropic-Modellen aufbauende Tools seit Jahresbeginn um das Zehnfache gestiegen und machen jetzt rund 2 % der gesamten Engineering-Kosten aus. Zwei Prozent sind wenig, aber Jellyfish-Chefwissenschaftler Nicholas Arcolano sagte TechCrunch: „Dieses zehnfache Wachstum haben die meisten CFOs nicht eingeplant.“
Anthropics eigene Dokumentation liefert eine Untergrenze für die Zahl pro Person. Über Enterprise-Deployments hinweg liegen die durchschnittlichen Kosten von Claude Code bei etwa 13 $ pro Entwickler und aktivem Tag und bei 150 bis 250 $ pro Entwickler und Monat, und 90 % der Nutzer bleiben unter 30 $ pro Tag (Claude-Code-Dokumentation). Das ist ein Durchschnitt der eigenen Kunden eines Anbieters; verlassen Sie sich also auf Ihren eigenen Pilot als die echte Zahl.
Zwei weitere Gründe sind unsere eigene Schlussfolgerung, in der Berichterstattung steht dazu nichts. Eine Kennzahl auf Basis von Code-Änderungen und Reviews kann Reviewer unter Output begraben, den niemand bestellt hat. Und wer einer Nutzungszahl hinterherjagt, hat wenig Anlass zu fragen, ob eine Aufgabe überhaupt ein Modell brauchte. Weder die Berichte zum Memo noch die Berichterstattung drumherum nennen Sicherheit als Treiber, also tun wir nicht so, als wäre sie einer gewesen.
Microsofts Abfindungsangebote und ein Anbieter, der den Zähler verkauft
Amazons Memo erschien in derselben Woche wie andere Meldungen über Unternehmen, die KI mit ihren Bilanzen in Einklang bringen müssen, und es sind nicht dieselben Geschichten. Microsoft bot freiwillige Abfindungen an, und zwar rund 60.000 berechtigten Mitarbeitenden, etwa 27 % der Belegschaft, während es den teuren Ausbau seiner KI-Infrastruktur mit Kapitaleffizienz in Einklang bringen muss. CNBC bringt das mit Infrastruktur und Cashflow in Verbindung, nicht mit dem Token-Verbrauch irgendeines Einzelnen. Im selben Artikel heißt es allerdings, Microsoft versuche, Kunden nach tatsächlicher KI-Nutzung abzurechnen, also den Zähler umzudrehen.
Dann gibt es noch das Unternehmen, das am meisten davon hat, wenn Sie mehr ausgeben. Anthropic hat Reporting-Tools veröffentlicht, mit denen Führungskräfte sehen, was ein Team in einem Zeitraum produziert hat, was es gekostet hat und wo Workflows gehakt haben, dazu gemeinsame Gruppenbudgets, damit Teams ihre Token-Ausgaben steuern können. TechCrunch nennt das einen klaren Versuch, den Return on Investment zu belegen. Was auch immer man vom Motiv hält: Das Produkt zeigt, was Käufer heute verlangen, nämlich Kosten pro Ergebnis statt Kosten pro Seat.
Finden Sie heraus, was ein Seat wirklich kostet
Beginnen Sie mit einer Pilotgruppe und einer Baseline, und zwar bevor jemand ein Limit festlegt. Die Anbieter sind alle zu nutzungsbasierter Abrechnung übergegangen, der Listenpreis eines Seats sagt deshalb von Jahr zu Jahr weniger aus. Hier steht, was jedes große Tool laut den Seiten der Anbieter misst.
| Tool | Was gemessen wird | Wo Sie begrenzen |
|---|---|---|
| GitHub Copilot | Tokens, umgerechnet in AI Credits zu je 0,01 $. Business bündelt 1.900 Credits pro Nutzer und Monat, Enterprise 3.900 | Budgets in Dollar pro Nutzer, Kostenstelle und Organisation |
| Cursor (Teams) | Wöchentlicher Pool pro bezahltem Seat für Cursors eigene Modelle. Modelle von Drittanbietern werden über ein gemeinsames Prepaid-Guthaben abgerechnet | Monatliches Teamlimit, dazu Standard- und Pro-Mitglied-Limits |
| Claude Code | API-Tokens. Teams und Enterprise greifen auf Seat-Kontingente zu | Ausgabenlimits in den Admin-Einstellungen oder Workspace-Limits in der Console |
| Codex (ChatGPT) | Gemeinsames Kontingent mit ChatGPT Work, danach Credits | Credits, die Sie kaufen, und das Nutzungs-Dashboard, um das Tempo im Blick zu behalten |
Ein paar Details aus den Dokumentationen, die eine Preisseite nicht verrät. Die Richtlinie für kostenpflichtige Nutzung ist bei Copilot Business und Enterprise standardmäßig aktiv, Ausgaben über die gebündelten Credits hinaus laufen also weiter, solange ein Admin sie nicht ausdrücklich abschaltet (GitHub-Dokumentation). Inline-Vervollständigungen bleiben selbst bei einem Budget von 0 $ unbegrenzt. Copilot Code Review wird nach Aufwandsstufe berechnet: GitHub schätzt 0,05 bis 1 $ für Lite und 1,50 bis 25 $ für Max, im Schnitt rund 10 $, zuzüglich Actions-Minuten (GitHub-Modelle und -Preise). Das sind Schätzungen, und laut Dokumentation beeinflusst die Größe des Pull Requests sie.
Wenn Sie die Editoren selbst vergleichen wollen, hilft Cursor vs GitHub Copilot vs Windsurf weiter. Cursors Teams-Tarif verkauft Premium-, Super- und Ultra-Seats für 30, 100 und 200 $ im Monat, jeweils mit eigenem Wochenpool für Cursors eigene Modelle, der sich nicht zwischen Kollegen übertragen lässt. Modelle von Drittanbietern, auch Claude, sind nicht im Pool enthalten: Sie werden aus einem gemeinsamen Prepaid-Guthaben zum API-Listenpreis plus einem Cursor-Aufschlag von 0,25 $ pro Million Tokens abgerechnet (Cursor-Dokumentation). Claudes Enterprise-Tarif kostet 20 $ pro Seat und Monat plus Nutzung zu API-Preisen (Claude-Preise). Die Codex-Preisseite sagt klar, dass API-Token-Preise getrennt von der Abo-Nutzung gelten und nicht dazu taugen, die enthaltenen Aufgaben zu schätzen.
Routinearbeit auf ein günstigeres Modell lenken
Der größte Hebel in den Dokumentationen ist kein Limit. Es ist das Modell. Laut Anthropics API-Preisliste kostet Claude Haiku 5.5 bei Prompts bis 100.000 Tokens 0,50 $ pro Million Output-Tokens (darüber steigt es auf 2,50 $), Sonnet 5.5 10 $, Opus 5.5 20 $ und Fable 5.1 50 $. Das ist ein Faktor 100 zwischen dem unteren und dem oberen Ende einer einzigen Modellreihe, und die Tabellen von GitHub und Cursor führen dieselben Output-Preise auf.
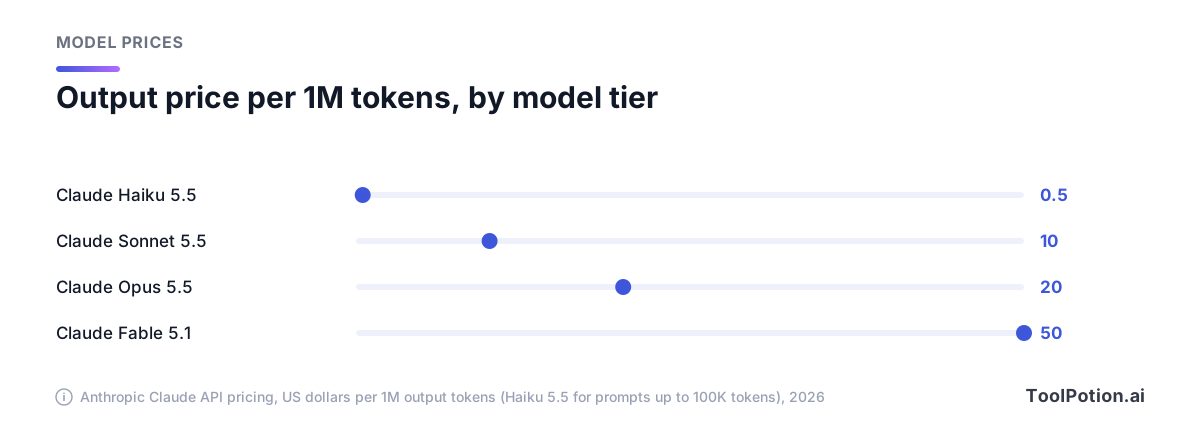
Anthropics eigene Kostenempfehlung deckt sich mit der Rechnung. Sonnet „erledigt die meisten Coding-Aufgaben gut und kostet weniger als Opus“, heißt es dort, Opus sei für Architekturentscheidungen oder mehrstufiges Reasoning reserviert, und model: haiku für einfache Subagent-Aufgaben (Claude-Code-Dokumentation). Unsere ausführlichere Einschätzung, wie man Modellstufen und Aufgaben zuordnet, finden Sie in welche KI-Modellstufe für welche Aufgabe, und die Terminal-Agenten vergleichen wir in Claude Code vs Codex vs Gemini CLI.
Hier die Ersparnis zu Listenpreisen, wobei der Anteil der Arbeit, den ein kleines Modell übernehmen kann, Ihre eigene Schätzung ist. Die Preise sind Anthropics Listenpreise für kurze Prompts.
Output-Tokens sind nur ein Teil der Rechnung, und der Anteil des kleinen Modells ist eine Annahme, die Sie sich mit Ihren eigenen Aufgaben erst verdienen müssen. Variablen umbenennen und Test-Gerüste schreiben dürften dazugehören. Ein Migrationsplan für einen Payment-Service wahrscheinlich nicht.
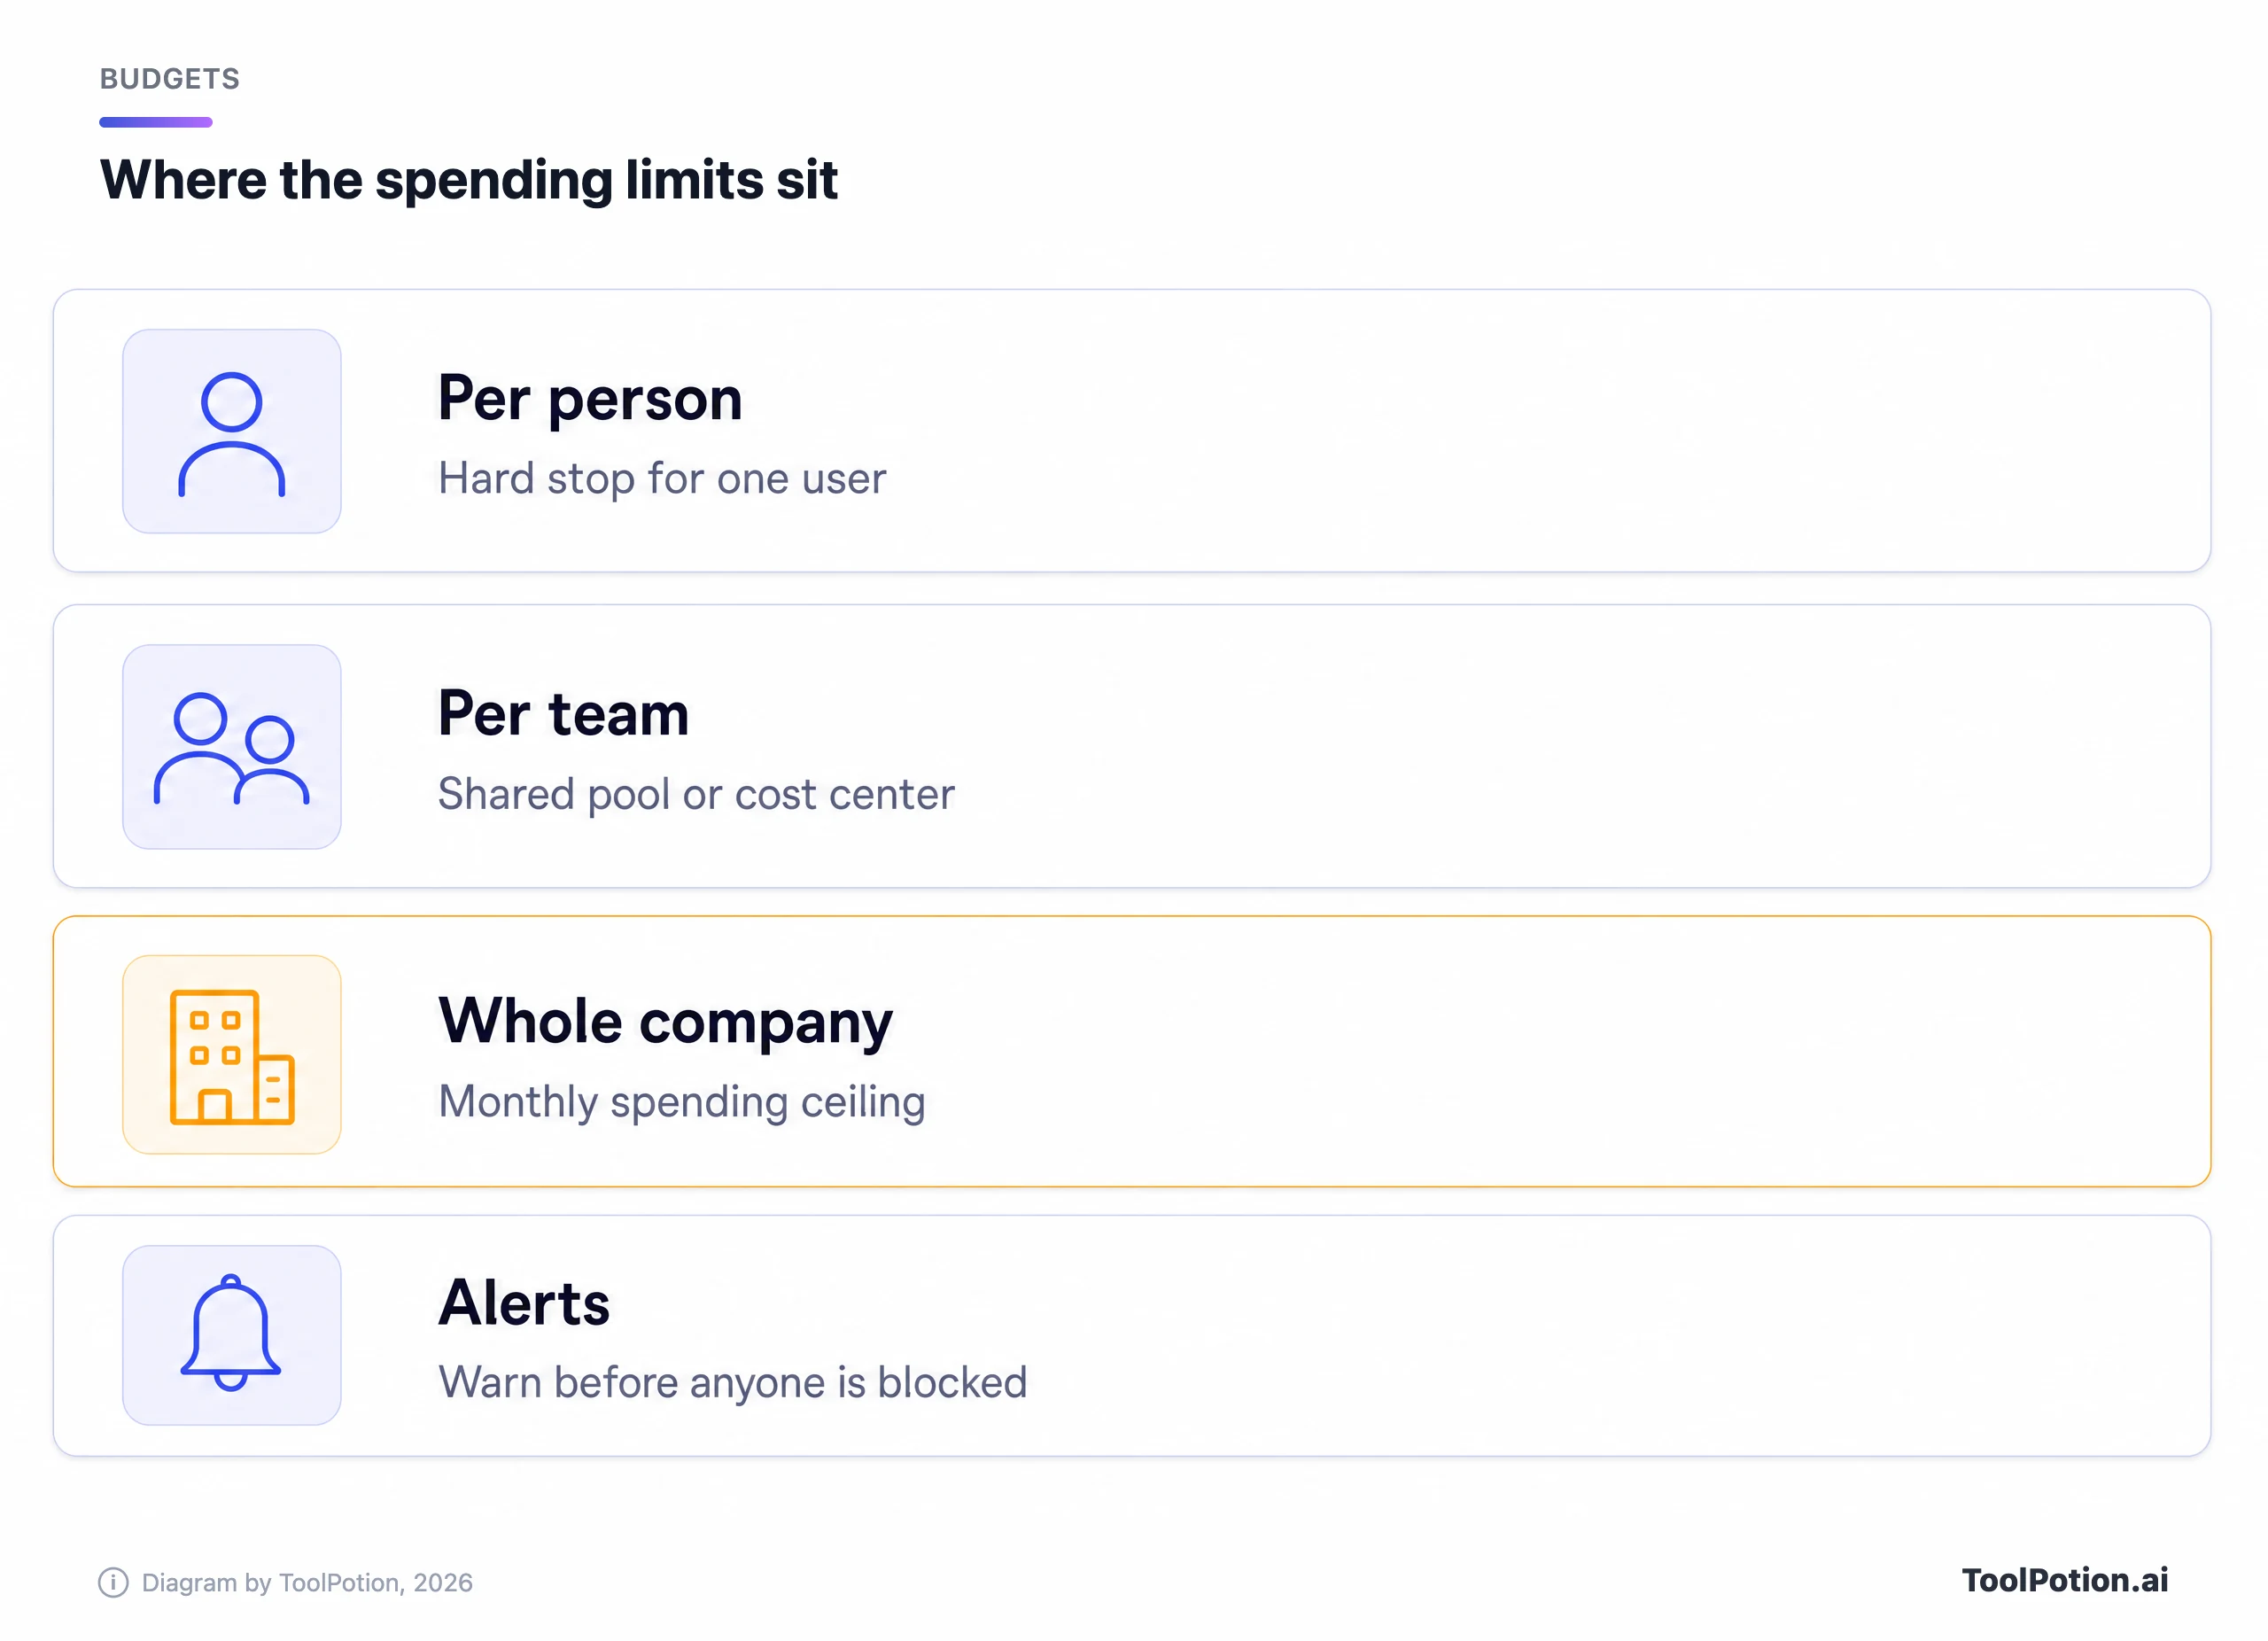
Limits in der Reihenfolge, in der wir sie setzen würden
- Aktivieren Sie das Usage-Reporting für eine Pilotgruppe und werten Sie zwei Wochen aus, bevor Sie irgendeine Zahl wählen.
- Setzen Sie zuerst Warnungen. GitHub kann bei 75 %, 90 % und 100 % eines Budgets per E-Mail und Banner warnen (GitHub-Dokumentation).
- Legen Sie eine unternehmensweite monatliche Obergrenze fest, mit der Sie leben könnten, wenn jeder Seat voll ausgereizt wird, damit eine außer Kontrolle geratene Agent-Schleife einen bekannten Betrag kostet.
- Erst dann kommen Team- oder Personenlimits, und machen Sie sie weich, wo das Tool es erlaubt. GitHubs Budget auf Nutzerebene stoppt immer hart, und die Dokumentation warnt, dass sich überlappende Budgets Leute von einem Tool aussperren können, auf das sie angewiesen sind.
- Stellen Sie die Standardmodelle für Routinearbeit eine Stufe tiefer ein und machen Sie das Premium-Modell zu einer bewussten Entscheidung.
Die Claude-Code-Dokumentation nennt außerdem Richtwerte für Rate-Limits pro Nutzer nach Teamgröße, etwa 15.000 bis 20.000 Tokens pro Minute und Nutzer bei 100 bis 500 Nutzern. Das sind Drosselungen, keine Budgets, und die Dokumentation nennt sie Empfehlungen, die man anpassen soll.
Wann Rationierung klug ist und wann Scheinsparen
Wir würden Verschwendung rationieren, nie Versuche. Ein Limit, das Entwickler zweimal nachdenken lässt, bevor sie ein ganzes Repository ins Top-Modell kippen, erfüllt seinen Zweck. Ein Limit, das denselben Entwickler dazu bringt, den KI-generierten Testlauf zu überspringen oder den Agenten beim schwierigen Refactoring zu meiden, wo er sich am meisten auszahlt, kostet mehr, als es spart.
Rechnen Sie nach. Wenn agentische Tools etwa 2 % der Engineering-Kosten ausmachen, wie Jellyfish berichtet, spart eine halbierte Rechnung 1 % der Engineering-Kosten. Ein Entwickler, der um 1 % ausgebremst wird, gibt das wieder her. Rationierung gewinnt nur, wenn sie Ausgaben streicht, die nichts gebracht haben, und genau das ist Amazons Punkt zu vergeudeter Mühe.
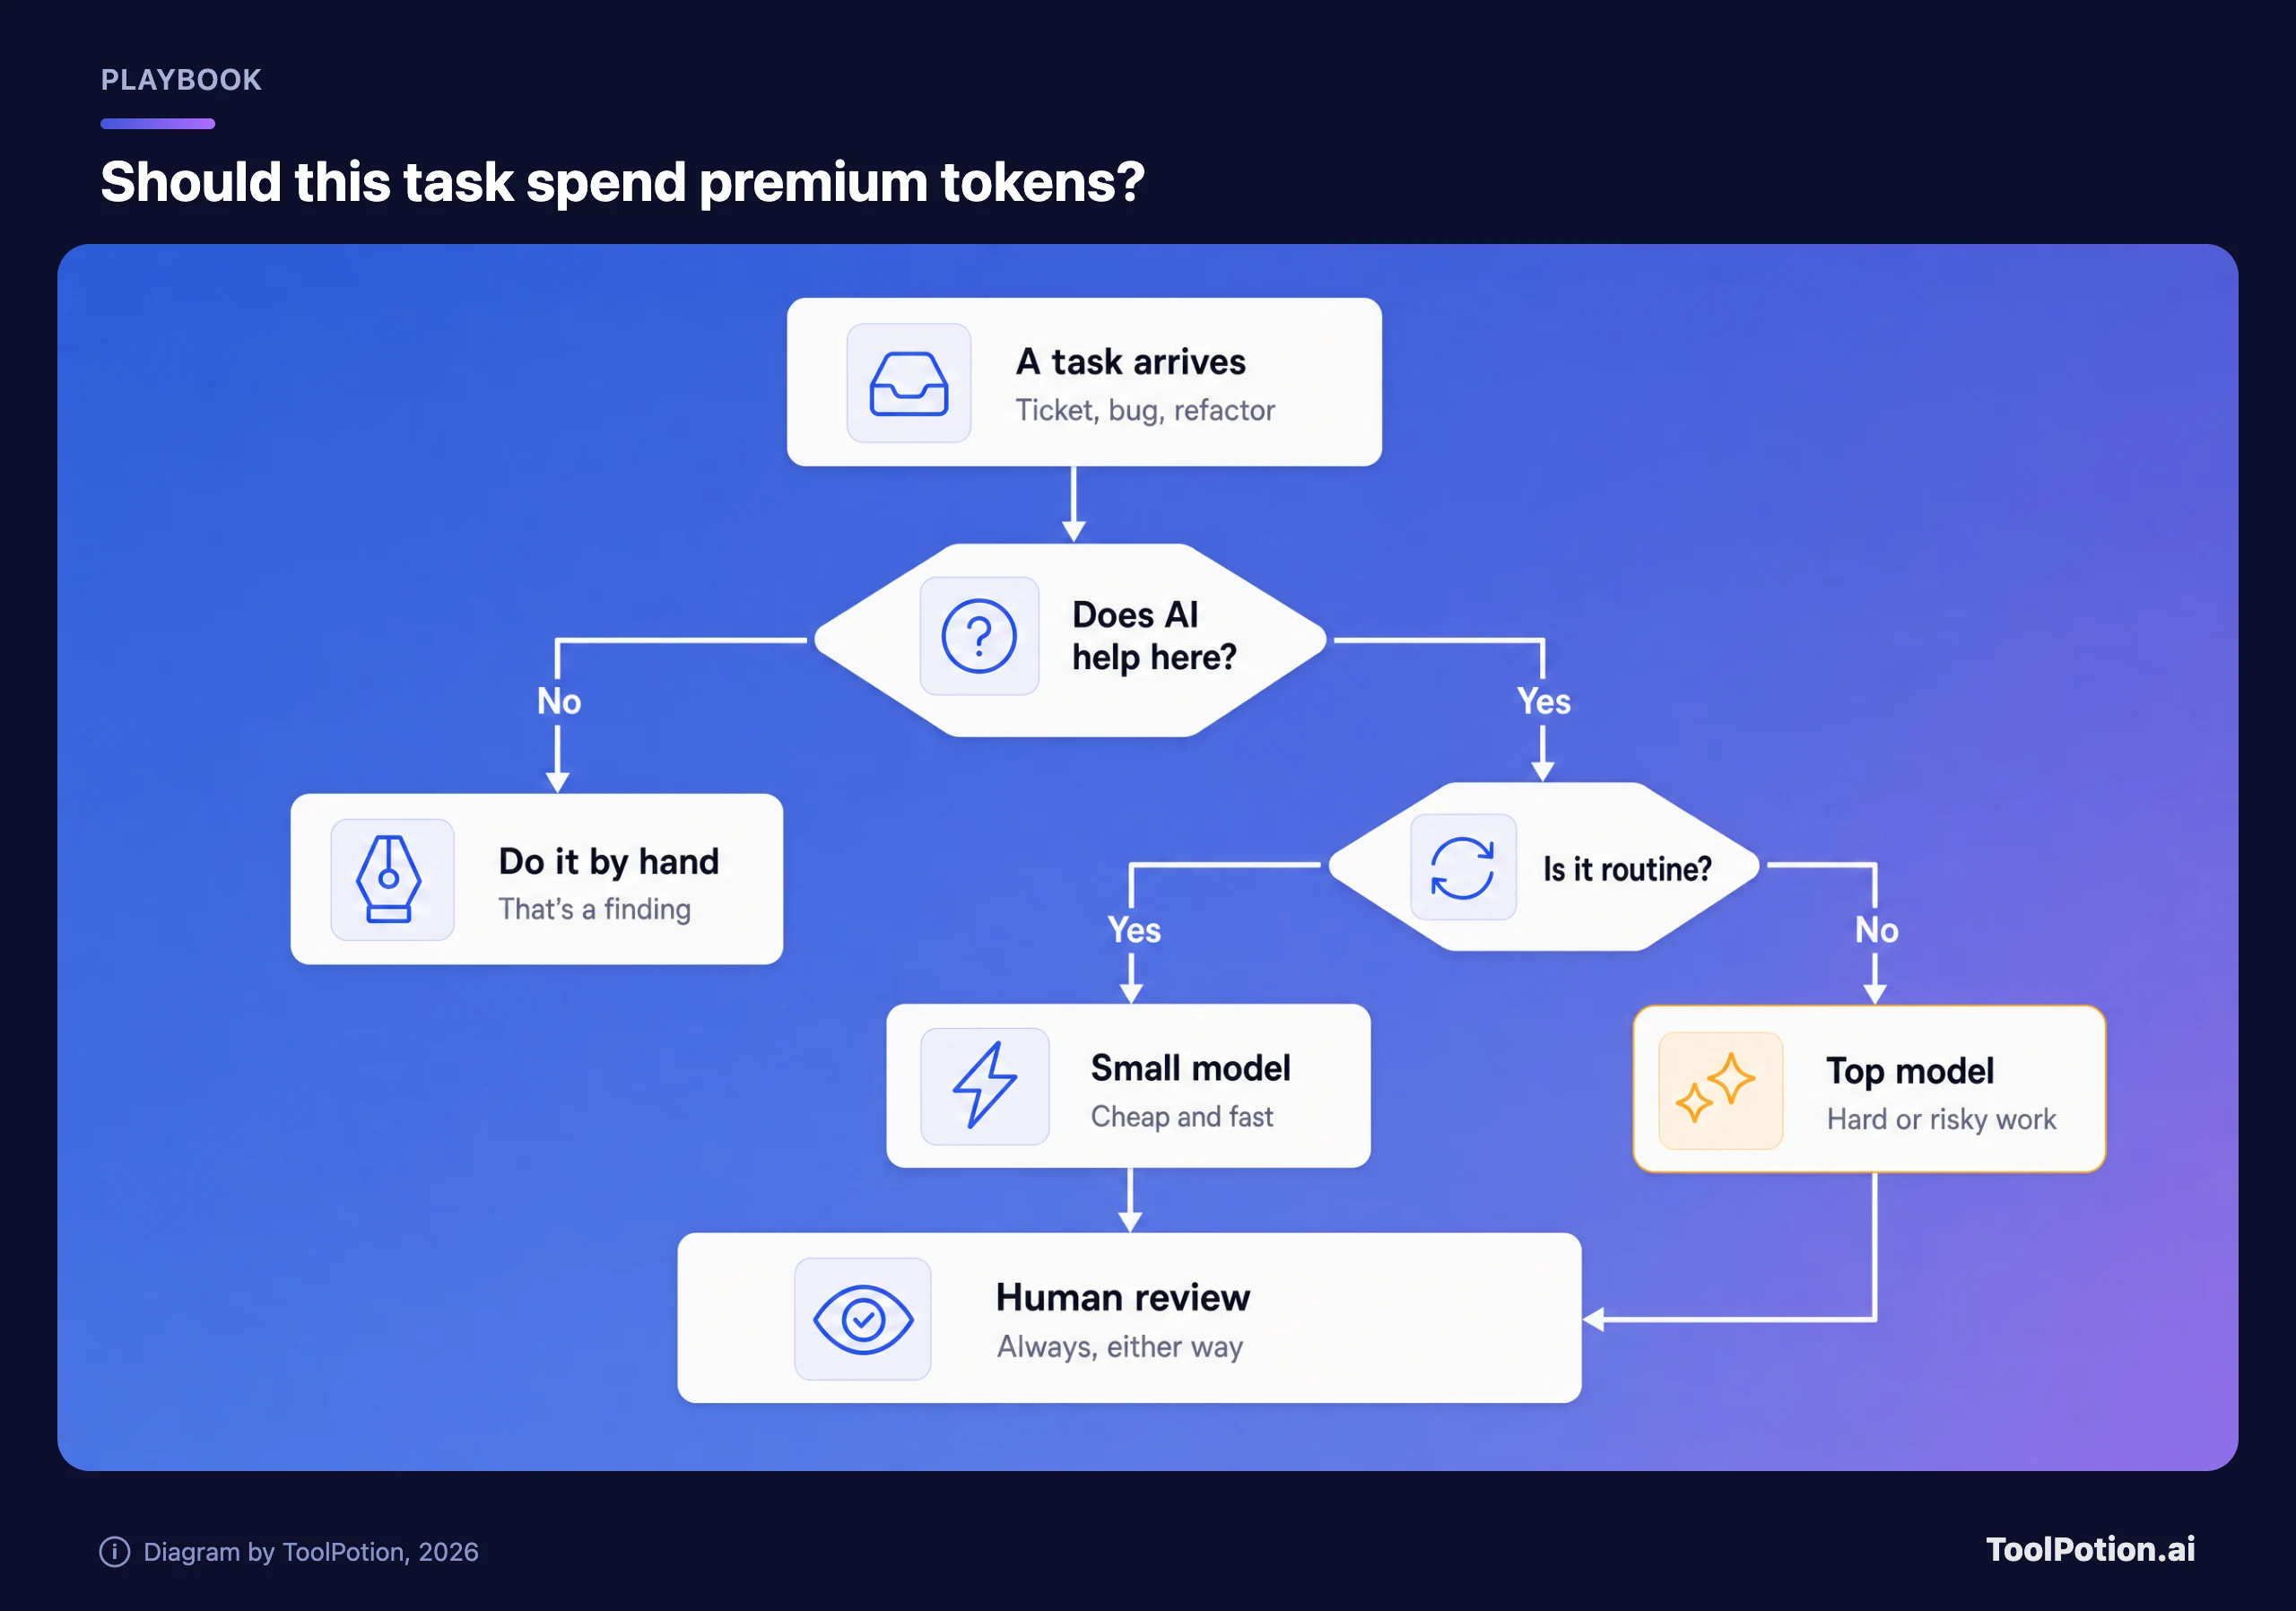
Rationierung ist sinnvoll bei Hintergrundautomatisierung, die niemand liest, beim Top-Modell für Routinejobs und bei Leaderboards pro Person. Scheinsparen ist sie bei Code-Review, Tests und Onboarding. Wenn der KI-Review-Schritt der ist, der den schlechten Merge abfängt, wetten Sie mit einer Drosselung gegen Ihr eigenes Sicherheitsnetz. Unser Leitfaden zu KI-Code-Review-Tools und das ToolRank-Board für Review und Testing zeigen, wie viele Alternativen es gibt, bevor Sie irgendetwas kürzen.
Was wir nicht streichen würden
Das menschliche Review bleibt, egal welches Modell den Code geschrieben hat. Amazons Memo warnt davor, Review-Zahlen zu messen, schlägt aber nicht vor, Reviews zu überspringen. Auch Schulungen bleiben, denn wer weiß, wann man zum günstigen Modell greift, dem wurde gezeigt, wofür jedes Modell gut ist. Und das Experimentieren bleibt, denn Brookers eigenes Eingeständnis lautet, dass niemand vorher sagen kann, welche Probleme zählen.
Verfolgen Sie Ergebnisse so wie das Memo: Launches, erfolgreiche Änderungen in Produktion, Zeit von der Anfrage bis zum Merge. Rohe Tokens gehören in die Kostenspalte und keinesfalls in eine Leistungsbeurteilung. Falls Sie noch nicht aufgeschrieben haben, was Ihr Team diesen Tools füttern darf und was nicht, ist unsere Vorlage für eine KI-Nutzungsrichtlinie ein guter Anfang, und die Erklärung der Preismodelle sowie das Stack-Audit behandeln die Abo-Seite.
Nach der Lektüre der Preisseiten von GitHub Copilot, Cursor, Claude Code und Codex bleibt uns eine Regel: Der Seat-Preis ist nur die Eintrittsgebühr. Ziehen Sie sich aus dem Tool, das Sie nutzen, die Nutzung eines aktuellen Monats pro Person, sortieren Sie sie und schauen Sie auf die obersten fünf Zeilen. Wenn das Ihre besten Entwickler sind, lassen Sie sie in Ruhe. Wenn es ein einzelnes Skript in einer Schleife ist, haben Sie Ihr Limit gefunden.