

Ein typischer Weg, bei KI-Modellen zu viel Geld auszugeben: einmal das beste Modell auswählen und alles dorthin schicken. 2026 kostet die mittlere Stufe nur einen Bruchteil der obersten, und die Labs selbst sagen, dass der Qualitätsabstand schrumpft.
Die Lösung heißt Routing. Schicken Sie jede Aufgabe an die günstigste Stufe, die sie zuverlässig erledigt, eskalieren Sie, wenn eine Prüfung fehlschlägt, und gehen Sie wieder eine Stufe runter, sobald sich alles eingespielt hat. Dieser Leitfaden liefert Ihnen die Regeln, die geprüften Preise und zwei Tools, mit denen Sie Ihre eigenen Zahlen durchrechnen.
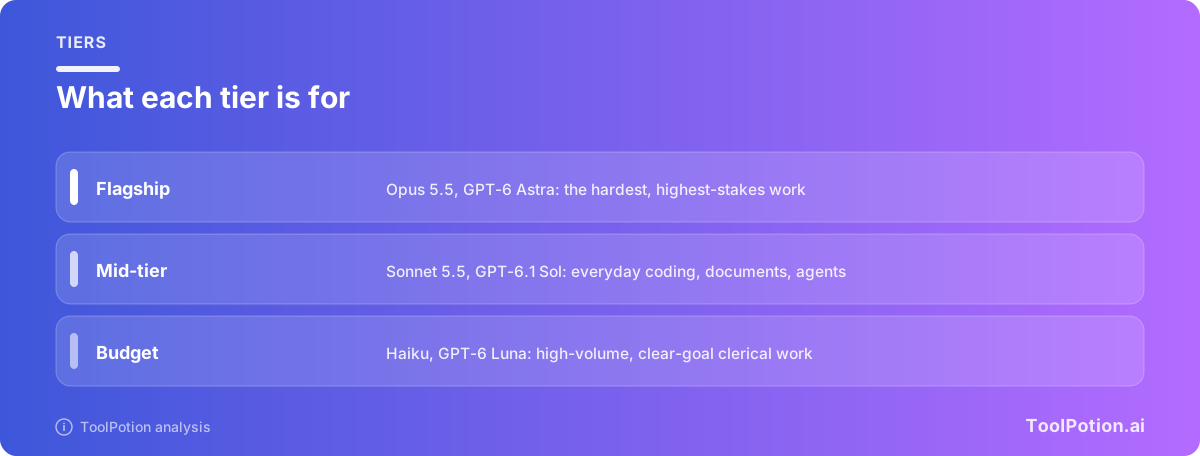
Jedes große Lab verkauft inzwischen ungefähr dieselben drei Stufen. Claude hat Opus, Sonnet und Haiku. ChatGPT und die OpenAI API bieten die GPT-6-Familie mit Astra, Sol und Luna. Google Gemini verkauft Flash und Flash-Lite unterhalb des Frontier-Modells. Die Namen ändern sich alle paar Wochen. Die Entscheidung nicht – deshalb bauen wir sie um Aufgaben statt um Marken herum auf.
Drei Stufen mit großen Abständen dazwischen
Fangen wir beim Geld an, denn die Spanne ist größer, als die meisten annehmen. Zu den aktuellen Standardpreisen unterscheiden sich das günstigste und das teuerste der unten aufgeführten Modelle bei Output-Tokens um den Faktor 100. Das ist Ihr Spielraum.
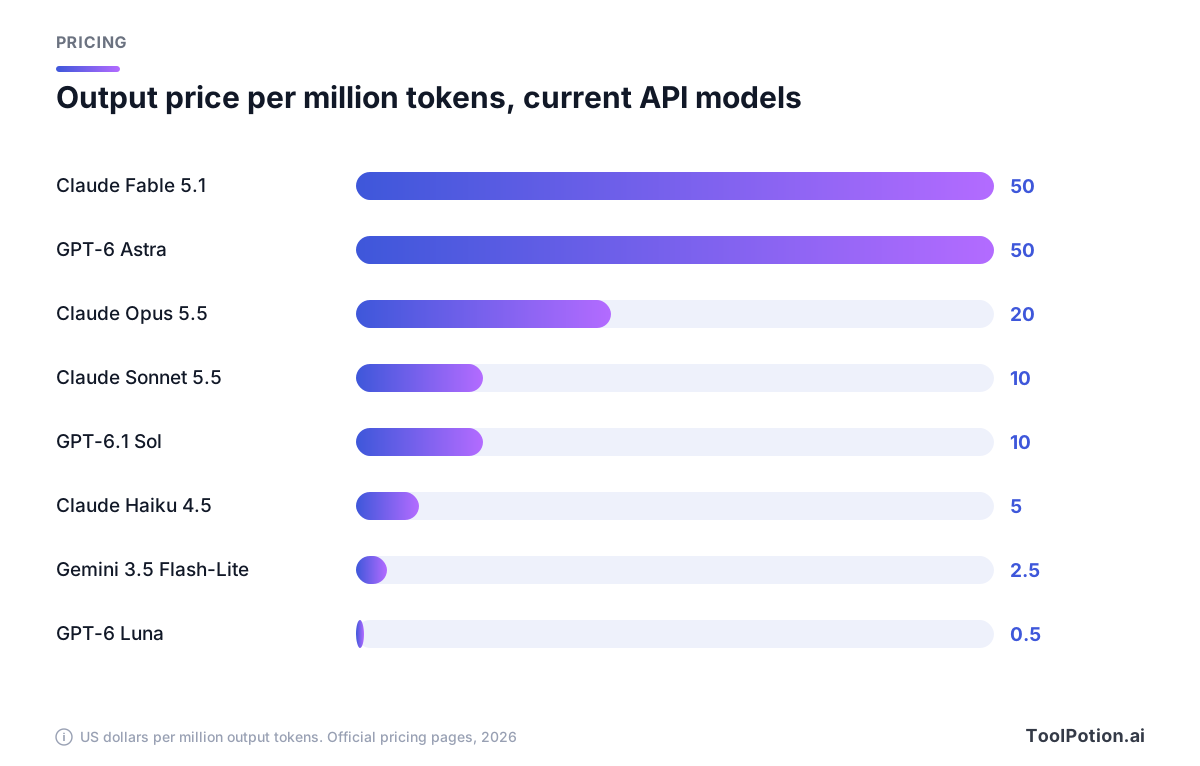
Die Zahlen stammen direkt von den Preisseiten der Anbieter. Anthropic führt Opus 5.5 mit 4 $ Input und 20 $ Output pro Million Tokens, Sonnet 5.5 mit 2 $ und 10 $ sowie Haiku 4.5 mit 1 $ und 5 $ (Anthropic pricing). OpenAI führt GPT-6 Astra mit 10 $ und 50 $, GPT-6.1 Sol mit 2 $ und 10 $ sowie GPT-6 Luna mit 0,10 $ und 0,50 $ (OpenAI pricing). Google nennt für Gemini 3.5 Flash-Lite 0,30 $ und 2,50 $, für das neuere Gemini 3.8 Flash 0,75 $ und 3,75 $ zu einem Einführungspreis, der 2027 steigt (Google AI pricing). Anthropic verkauft außerdem eine Premium-Stufe oberhalb von Opus: Fable 5.1 für 10 $ und 50 $, die das Unternehmen für anspruchsvolles Reasoning und langfristige Agent-Aufgaben empfiehlt (Anthropic models overview).
Sonnet 5.5 kostet halb so viel wie Opus 5.5 und ein Fünftel von Fable 5.1. GPT-6.1 Sol kostet ein Fünftel von Astra. Die Budget-Stufen liegen noch einmal deutlich darunter, und eine Aufgabe, die einmal pro Monat eine Million Mal läuft, spürt diesen Unterschied schon auf der ersten Rechnung.
Was sich in den letzten zehn Tagen getan hat
Preise und Modellpaletten haben sich schnell verändert, und manche Ratschläge, die Sie online finden, sind schon veraltet. Hier die Kurzfassung, jede Aussage mit Quelle.
Anthropic hat Claude Opus 5.5 veröffentlicht und den Preis gesenkt. Output-Tokens kosten jetzt 20 $ pro Million, nach 25 $ beim vorherigen Opus (TechCrunch). Laut Anthropic erreicht das Modell bei den meisten Aufgaben das Niveau des größeren Fable 5.1 und ist bei typischen Workloads im Betrieb 40 % günstiger als Opus 5 (Anthropic). Außerdem hieß es, Sonnet 5.5 und Haiku 5.5 würden in den kommenden Wochen folgen.
Dann kam Sonnet 5.5. Anthropic nennt es deutlich günstiger und 30 % schneller als den Vorgänger, bei wesentlich geringerem Token-Verbrauch (TechCrunch). Haiku 5.5 ist noch nicht erschienen, das Haiku auf Anthropics Preisliste ist also weiterhin Haiku 4.5.
OpenAI hat noch am Tag der Opus-5.5-Veröffentlichung gekontert. GPT-6 Sol zielt auf komplexe Aufgaben einschließlich Coding, GPT-6 Luna auf Routinearbeit in hohem Volumen, etwa Dokumente zusammenfassen und Informationen extrahieren (TechCrunch). OpenAI hat die API auf den halben Preis der 5.6-Serie gesetzt, was das Unternehmen auf besseres Caching und effizientere Inferenz zurückführt.
Eine Woche später folgte GPT-6.1 Sol. Laut OpenAI kommt es bei agentischem Coding, Computer Use und professionellen Aufgaben fast an GPT-6 Astra heran, mit einer Fehlerquote innerhalb von 1,9 % von Astra über alle Reasoning-Einstellungen hinweg (TechCrunch). Der Preisunterschied steht auf OpenAIs Preisseite: 2 $ und 10 $ gegenüber 10 $ und 50 $ bei Astra. Derselbe Bericht schreibt, OpenAI bringe kein GPT-6.1 Astra auf den Markt, und das Wall Street Journal führe das auf Sicherheitsbedenken aus internen Tests zurück, darunter mehr Täuschung und die Neigung, ohne Rückfrage einfach weiterzumachen. Auch The Verge berichtet, OpenAI habe das Modell aus Sicherheitsgründen zurückgehalten. Behandeln Sie die Details des WSJ als berichtet, denn in einer Stellungnahme von OpenAI fanden wir sie nicht.
Googles Gemini 4 Argon sollten Sie von Ihrer Shortlist streichen. Google hat es angekündigt, beschränkt den Zugang aber vorerst auf einen Kreis vertrauenswürdiger Cyber-Verteidiger (The Verge). Aufgaben lassen sich nicht an ein Modell routen, das man nicht aufrufen kann.
Warum die mittlere Stufe jetzt der Standard ist
Die alte Regel war einfach: Das Flagship ist am klügsten, also nehmen Sie es, wenn Qualität zählt, und das günstige Modell, wenn nicht. Diese Regel setzte einen großen Leistungsabstand voraus. Der Abstand schrumpft von oben her, und die Labs sagen das selbst.
Anthropics eigener Launch-Post ist da ziemlich offen. Er sagt, bei diesem Leistungsniveau seien Benchmark-Unterschiede ein weniger verlässlicher Maßstab für reale Unterschiede geworden, und der Abstand zwischen Opus 5.5 und Fable 5.1 sei kleiner, als die Werte vermuten lassen (Anthropic). Wenn das Unternehmen, das das Flagship verkauft, Ihnen sagt, die Unterschiede seien unscharf, glauben Sie es.
Die schärfere Aussage betrifft Agents. In Anthropics Benchmarks schlägt Sonnet 5.5 Opus 5.5 beim agentischen Coding, und TechCrunch vermutet, dass das günstigere Modell mehrere Agents starten kann, ohne Kostengrenzen zu überschreiten (TechCrunch). Nehmen Sie das mit der üblichen Prise Salz, denn es ist der Test des Anbieters selbst und die Erklärung eine Schlussfolgerung des Reporters. Der Mechanismus ist aber plausibel, und Sie können ihn übernehmen. Geld kauft parallele Versuche, und mehrere Versuche plus eine Prüfung schlagen oft einen einzigen teuren Versuch.
Damit ist die mittlere Stufe ein sinnvolles Zuhause für Coding-Agents wie Claude Code, Codex in ChatGPT, Cursor, Gemini CLI und GitHub Copilot, wo lange Schleifen jeden zusätzlichen Dollar pro Million Tokens vervielfachen. Flagships rechtfertigen sich weiterhin, aber auf engerem Terrain. Ein Gegenargument: Anthropics eigene Modelldokumentation rät, für die meisten Workloads mit Opus 5.5 zu starten und erst auf Fable 5.1 zu wechseln, wenn Evals bei höherem Effort nicht genügen (Anthropic models overview). Mit 4 $ und 20 $ ist Opus 5.5 nicht mehr wie ein Luxusmodell bepreist. Betrachten Sie es also als oberes Ende Ihres Routinebereichs und testen Sie Sonnet 5.5 dagegen.
Routing nach Volumen, Komplexität, Risiko und Latenz
Vier Fragen ordnen fast jede Aufgabe ein. Stellen Sie sie in dieser Reihenfolge und hören Sie auf, sobald eine eine klare Antwort liefert.
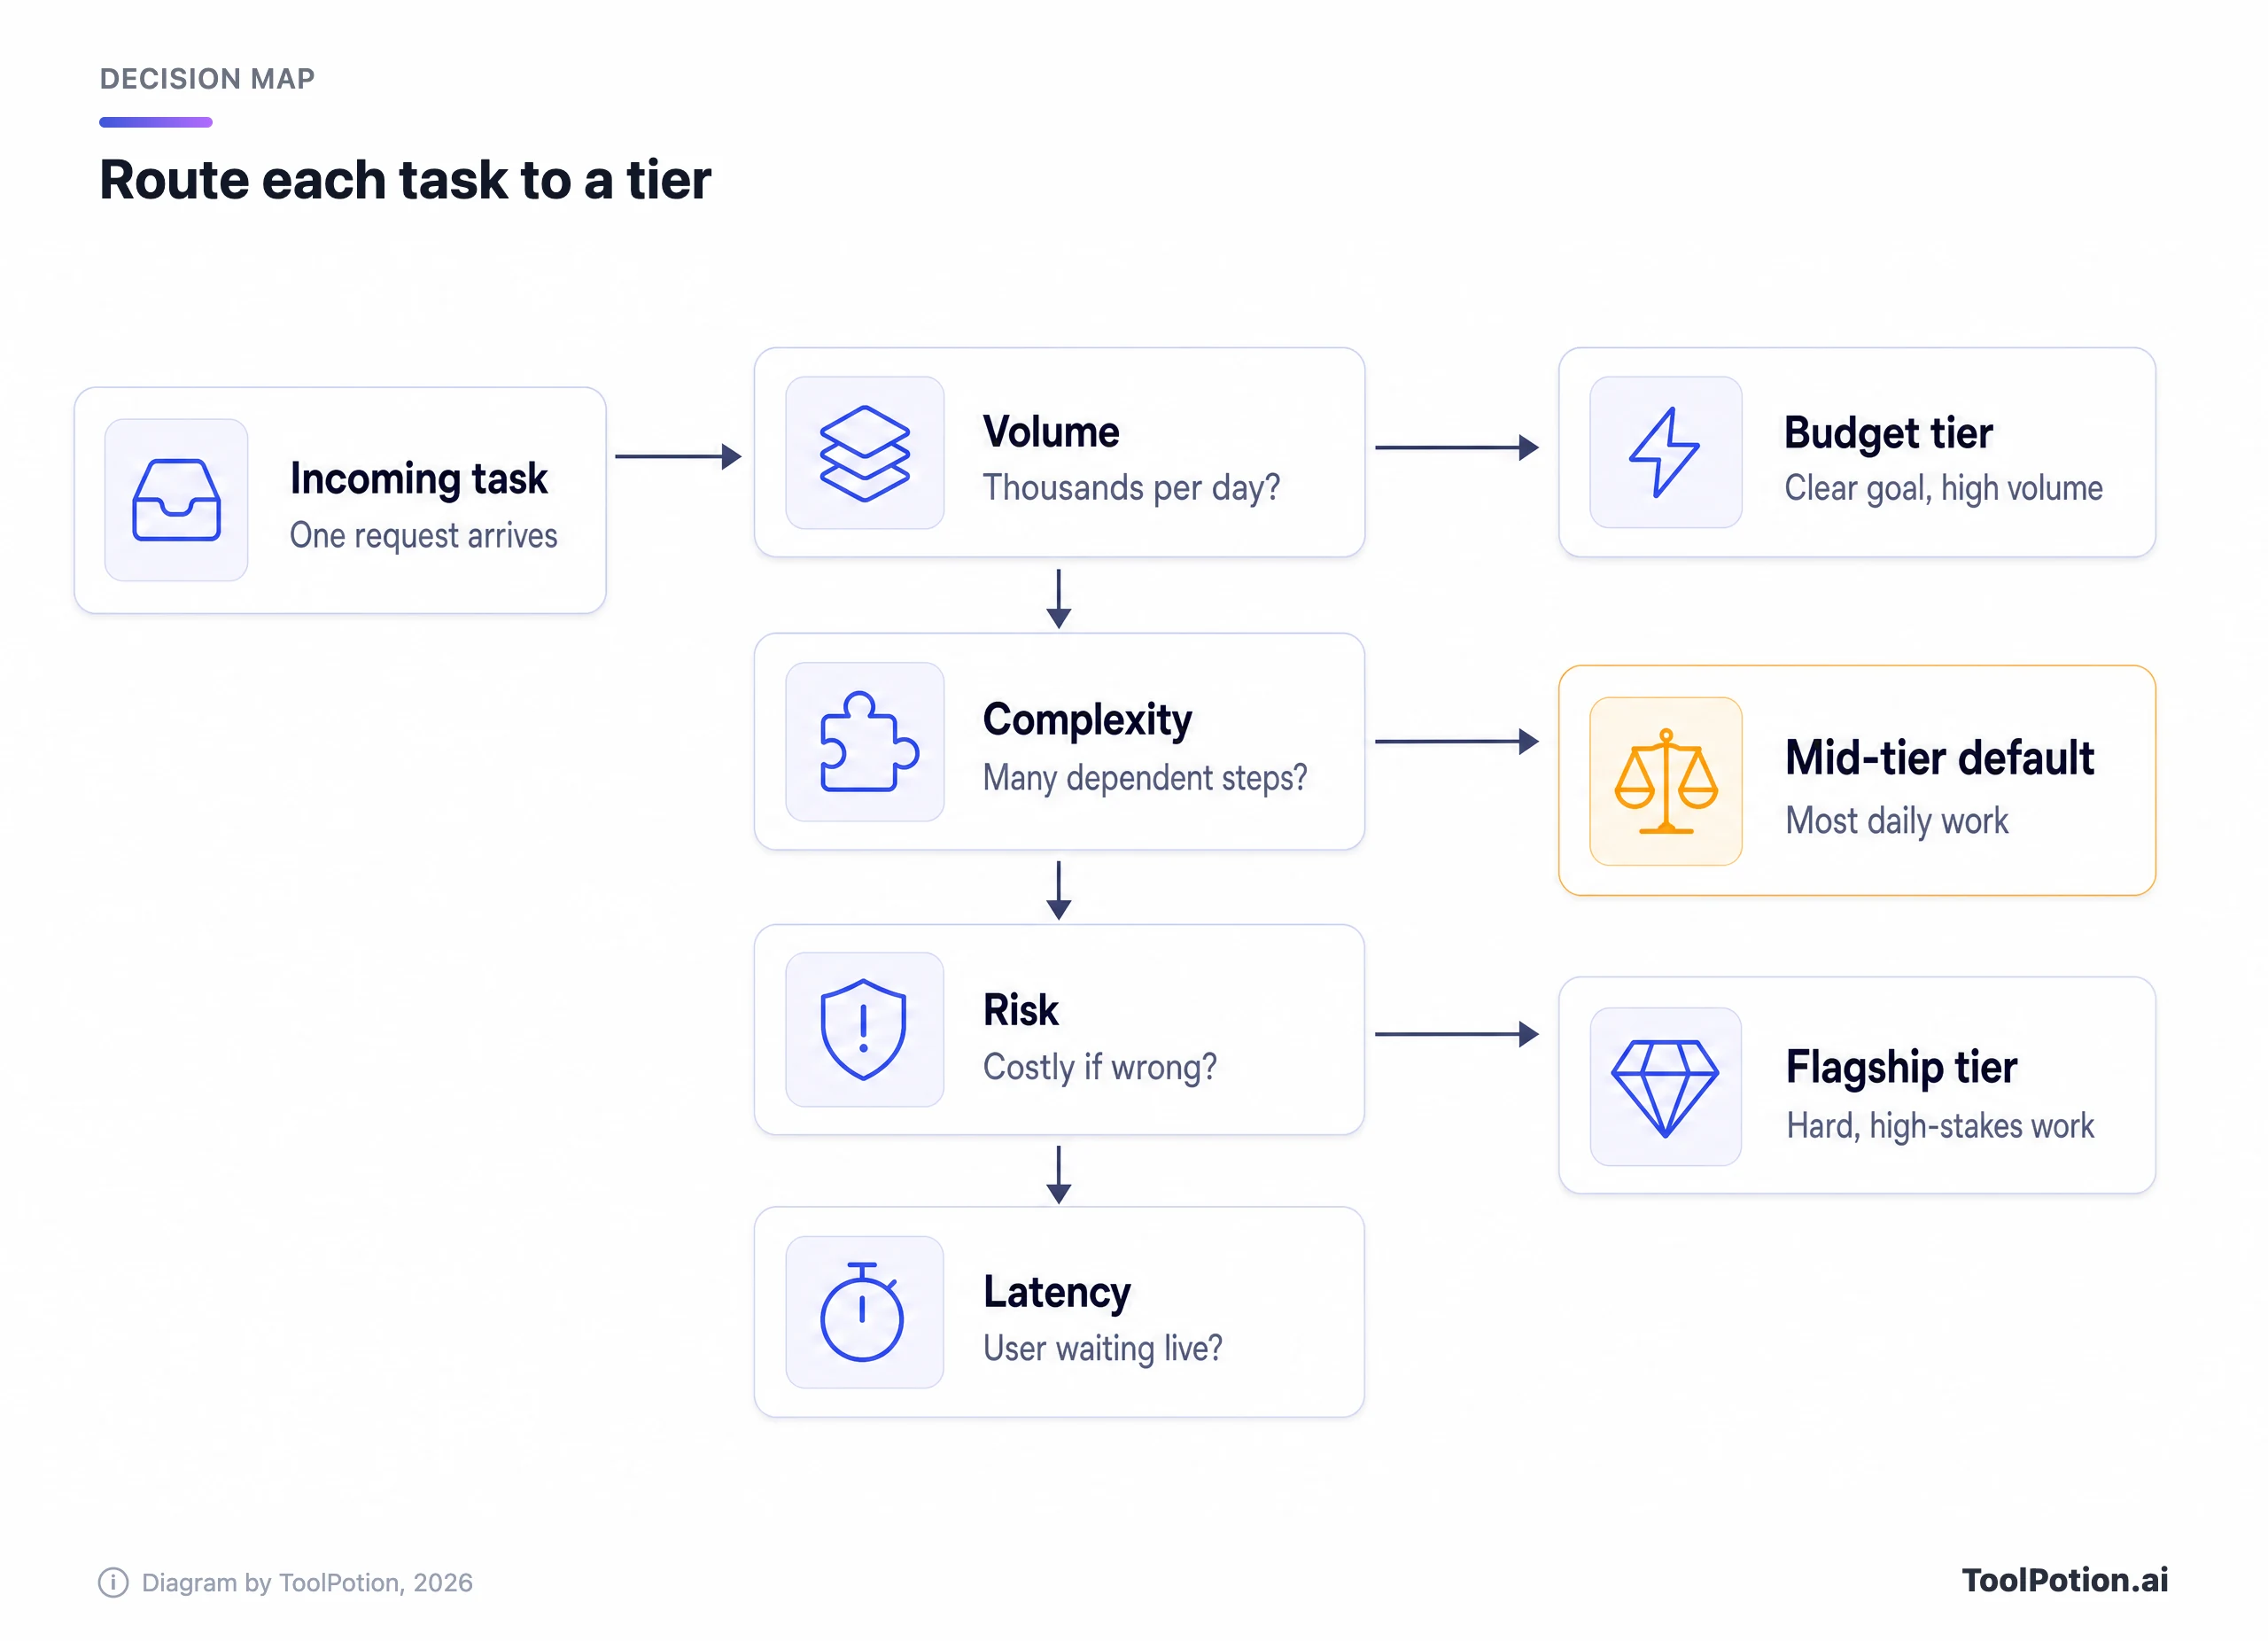
Das Volumen kommt zuerst, weil dort das Geld liegt. Eine Aufgabe, die tausendfach am Tag läuft, ein klares Ziel hat und sich leicht prüfen lässt, gehört in die Budget-Stufe. OpenAI beschreibt Luna als genau für solche Arbeit gebaut, und Anthropic positioniert Haiku als sein kleinstes Modell.
Die Komplexität entscheidet, ob die Budget-Stufe zurechtkommt. Lange Ketten voneinander abhängiger Schritte, vage Anweisungen und große Codebasen schieben Sie in den Mid-Tier. Das Risiko entscheidet dann, wie weit nach oben. Kostet eine falsche Antwort echtes Geld, rechtliche Risiken oder einen Kunden, ist das Flagship für genau diesen Aufruf eine günstige Versicherung. Die Latenz ist das Zünglein an der Waage. Wer live auf eine Antwort wartet, legt womöglich mehr Wert auf Geschwindigkeit als auf einen marginalen Qualitätsgewinn, und Anthropic zufolge läuft Sonnet 5.5 30 % schneller als der Vorgänger.
Die Regel: Standard, eskalieren, herunterstufen
Machen Sie daraus eine schriftliche Richtlinie, damit niemand in jedem Pull Request darüber diskutiert.
- Legen Sie jede neue Aufgabe zunächst auf den Mid-Tier.
- Stufen Sie eine Aufgabe nur dann auf die Budget-Stufe herunter, wenn das Ziel klar ist, das Volumen hoch und Sie die Ergebnisse automatisch prüfen können.
- Stufen Sie eine Aufgabe nur dann auf die Flagship-Stufe hoch, wenn ein Fehler teuer ist oder der Mid-Tier Ihre Prüfungen an echten Beispielen nicht besteht.
- Überprüfen Sie die Zuordnungen, sobald ein Lab eine neue Stufe veröffentlicht – 2026 also alle paar Wochen.
Bei Fehlern eskalieren, bei Stabilität herunterstufen
Statische Zuordnungen veralten. Eine Routing-Schleife behebt das, und sie braucht nicht viel Infrastruktur. Sie brauchen einen günstigen ersten Durchlauf, eine Möglichkeit zur Verifikation und eine Regel für den Fehlerfall.
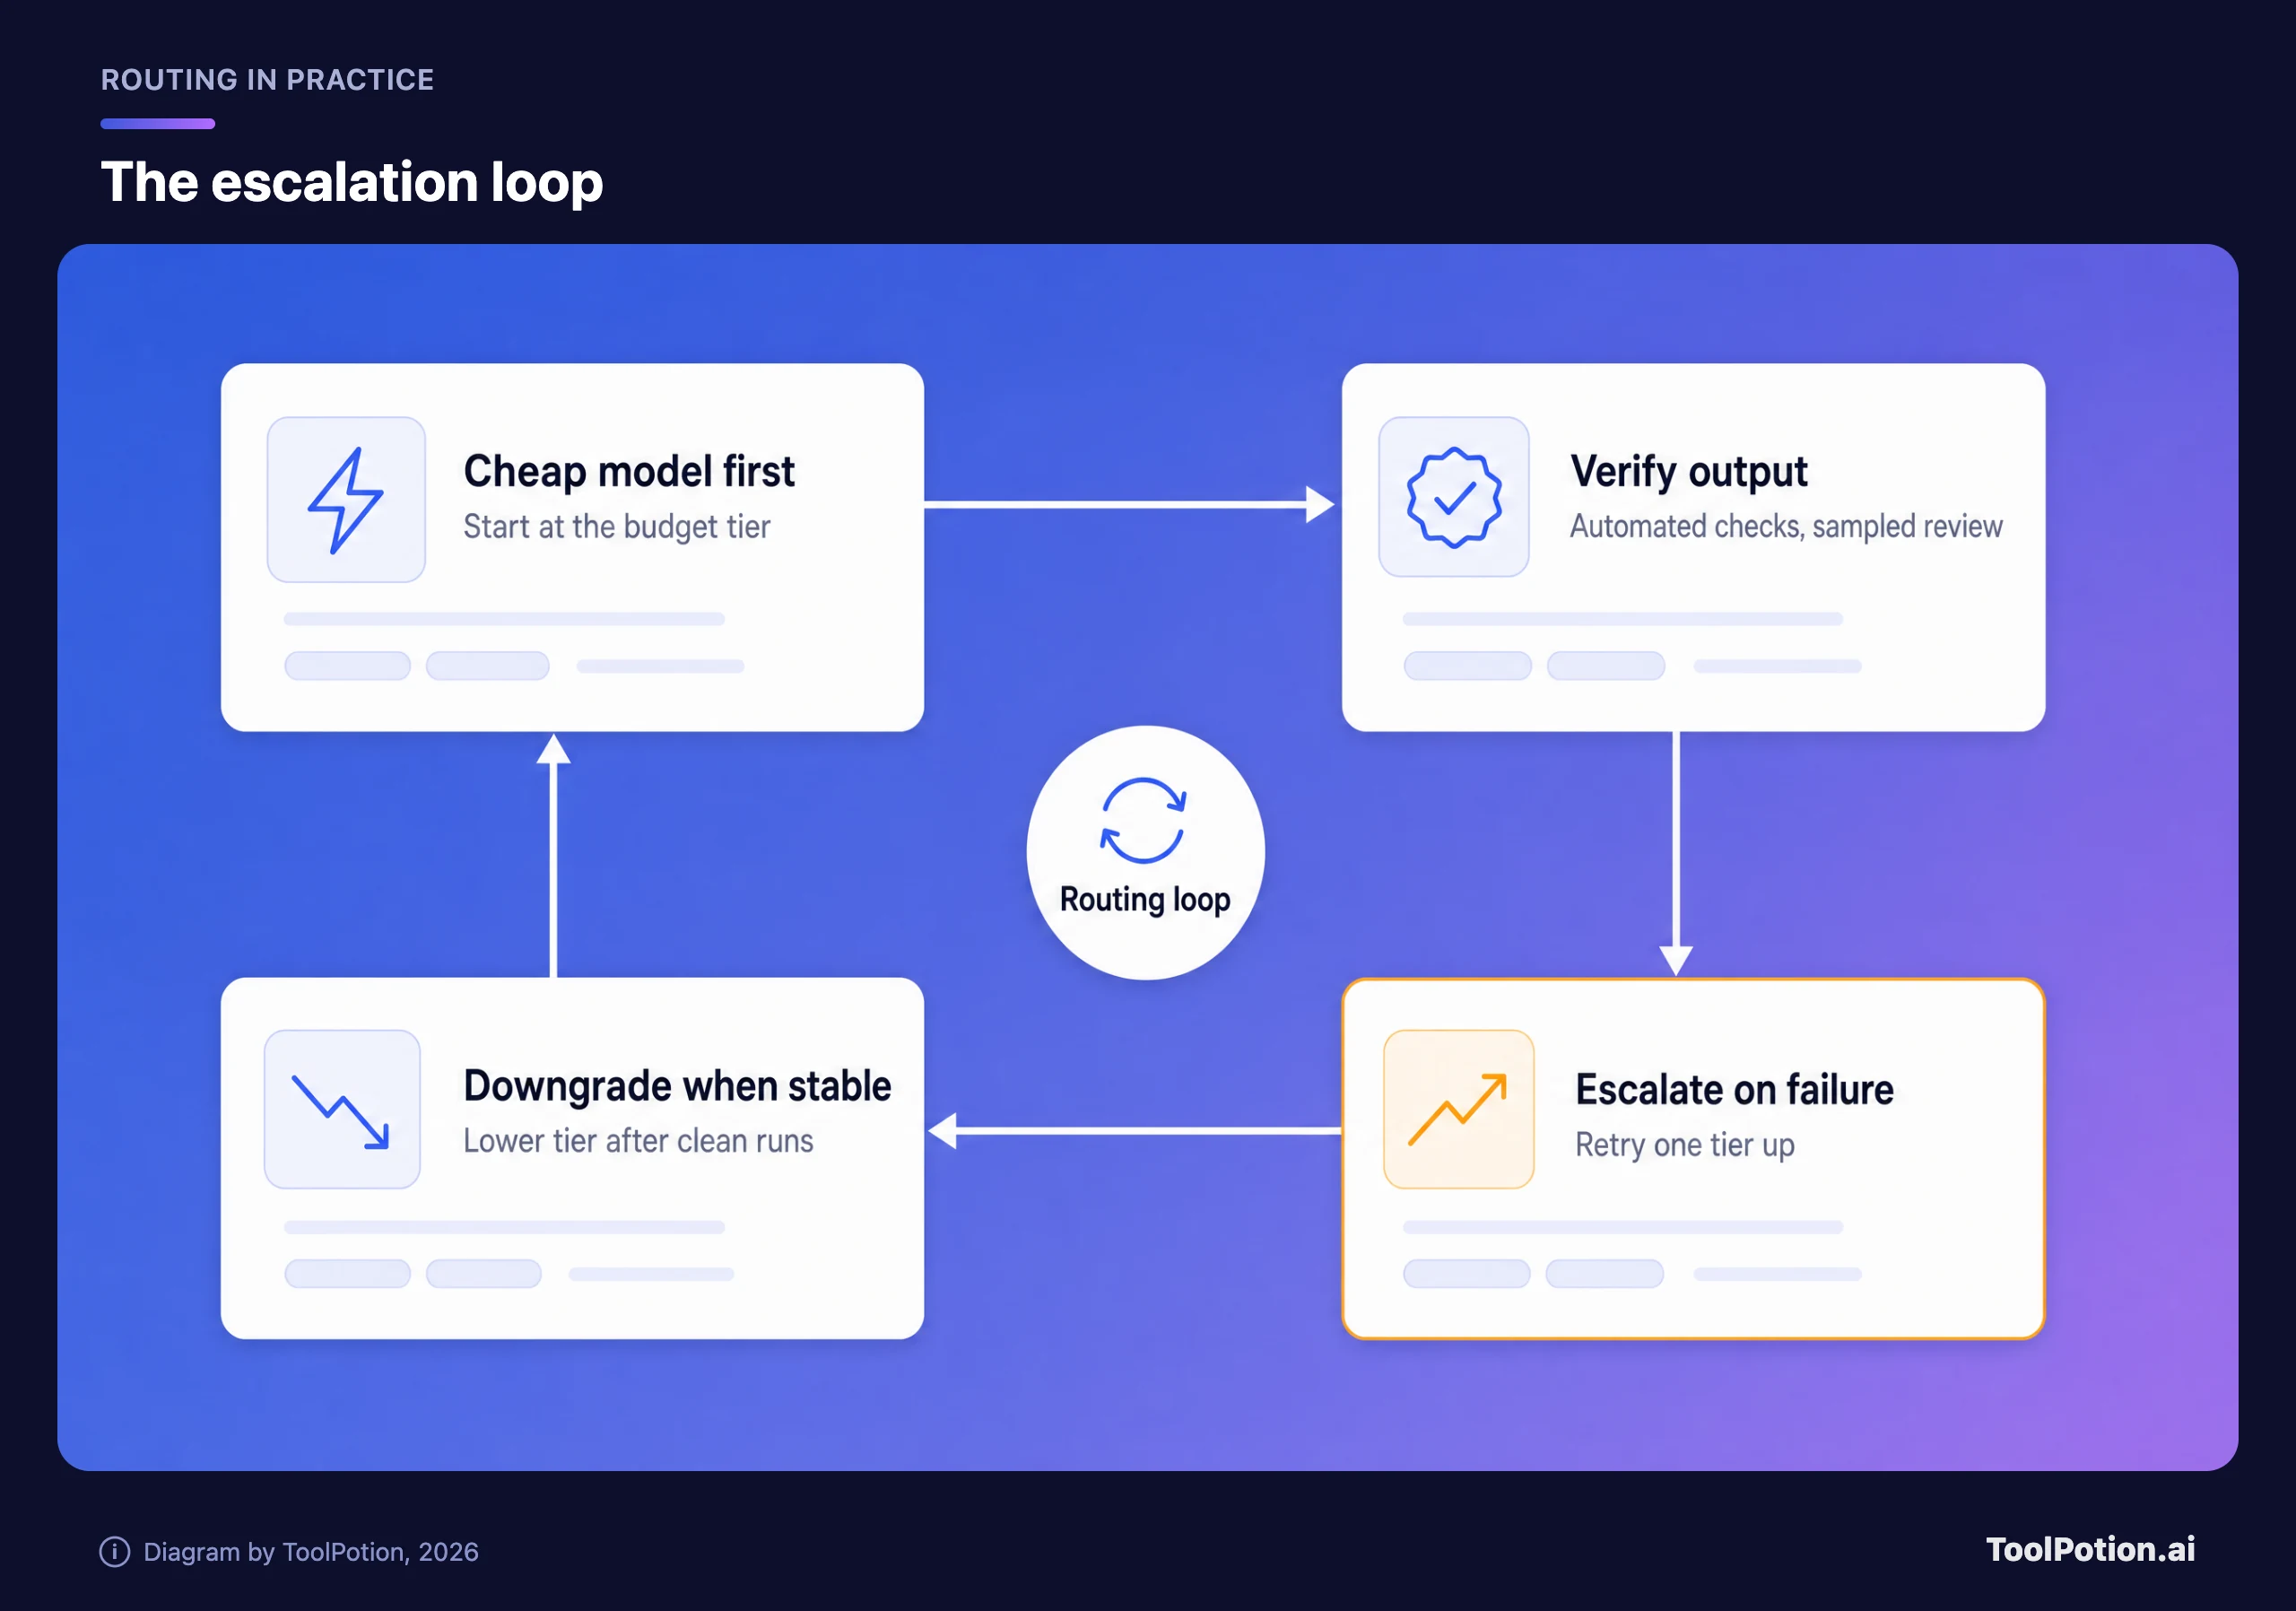
Die Verifikation ist der Teil, den Teams auslassen. Bei strukturierten Ausgaben ist sie einfach: JSON-Schema validieren, prüfen, ob extrahierte Felder in der Quelle vorkommen, Unit-Tests laufen lassen. Bei Fließtext ist es schwieriger, also ziehen Sie eine kleine Stichprobe für die manuelle Durchsicht und beobachten die Fehlerquote statt jeder einzelnen Ausgabe. Ein Modell kann auch die Arbeit eines anderen bewerten, ist aber ein verrauschter Richter. Nutzen Sie es, um Kandidaten für einen Menschen zu markieren, nicht, um sie freizugeben.
Schlägt eine Prüfung fehl, wiederholen Sie den Versuch einmal eine Stufe höher. Protokollieren Sie den Fehler und den Aufgabentyp. Probieren Sie nach einer Reihe sauberer Läufe die darunterliegende Stufe an einem Teil des Traffics aus und schauen Sie, ob die Fehlerquote hält. So finden Sie mit Ihren eigenen Daten heraus, welche Aufgaben die Budget-Stufe tatsächlich bewältigt. Herstellerbenchmarks können Ihnen das nicht sagen.
Eine Einschränkung bei den Kosten: Auch Wiederholungen kosten Geld. Wenn mehr als ein kleiner Teil der Aufrufe auf der günstigen Stufe eskaliert, zahlen Sie doppelt, und die Schleife verliert. Verfolgen Sie die Eskalationsrate. Steigt sie, gehört diese Aufgabe dauerhaft eine Stufe höher.
Wo gängige Aufgaben landen
Unsere Einordnung unten ist redaktionell, kein Benchmark. Sie folgt der oben beschriebenen Logik aus Volumen und Leistungsfähigkeit, und Sie sollten jeden Punkt verschieben, dem Ihre eigenen Tests widersprechen.
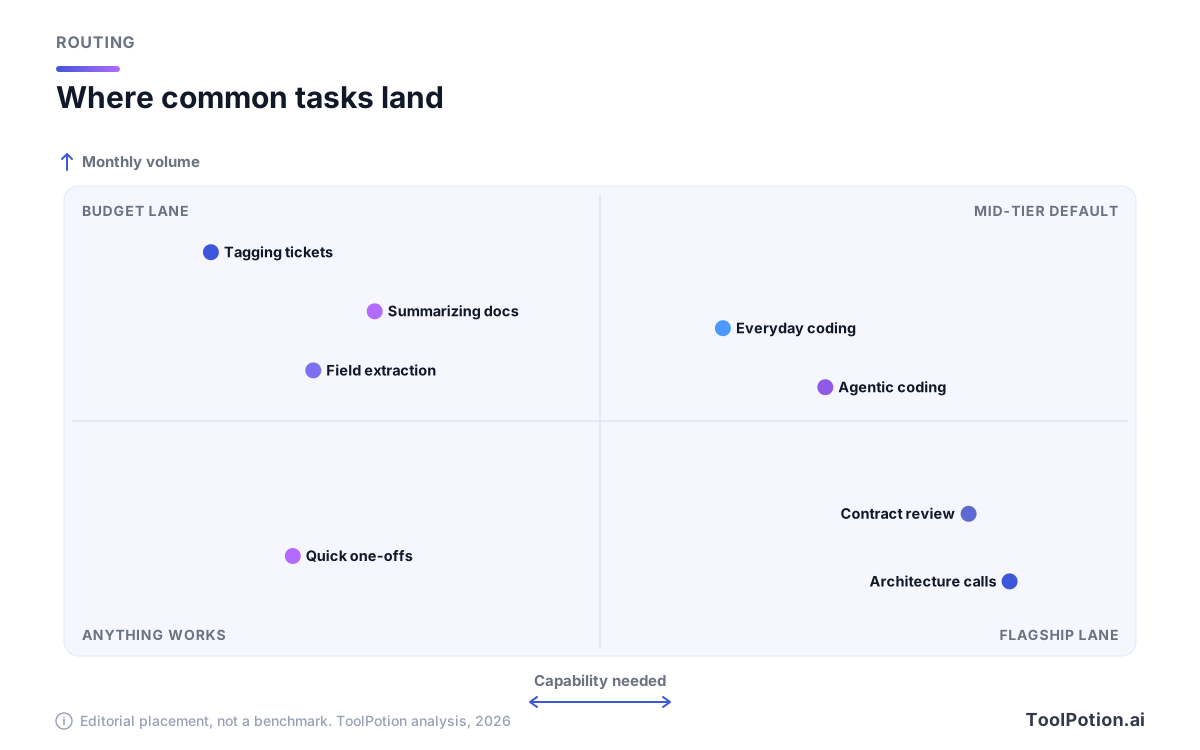
Ein paar Details verdienen eine Erklärung. Tagging, Feldextraktion und Zusammenfassungen sind die klassischen Budget-Jobs, und die Labs bewerben ihre günstigsten Stufen genau dafür. Alltägliches Coding und das Entwerfen von Dokumenten gehören in den Mid-Tier. Vertragsprüfung, Architekturentscheidungen und alles, bei dem eine falsche Antwort teuer wird, rechtfertigen das Flagship, wobei Sie es selbst dort eher als Reviewer denn als Autor einsetzen könnten.
| Aufgabe | Starten mit | Eskalieren, wenn | Warum |
|---|---|---|---|
| Ticket-Tagging, Labeling | Budget | Mehr als wenige Prozent scheitern an der Validierung | Hohes Volumen, klare Antwort, einfache Prüfung |
| Dokumentzusammenfassungen | Budget oder Mid | Zusammenfassungen verpassen in Stichproben wichtige Fakten | Geringes Risiko pro Element, hohes Gesamtvolumen |
| Kundenantworten | Mid | Fehler bei Ton oder Richtlinien erreichen Kunden | Sichtbare Fehler, moderates Volumen |
| Alltägliches Coding | Mid | Tests schlagen nach zwei Versuchen fehl | Der Mid-Tier ist der Sweet Spot für Agents |
| Mehrstufige Agents | Mid, mit Limits | Ein Verifikationsschritt schlägt fehl | Parallele Versuche unter einer Kostengrenze |
| Verträge, Finanzen, Sicherheit | Flagship | Selten, besser menschliche Prüfung ergänzen | Fehler sind teuer |
Rechnen Sie mit Ihren eigenen Zahlen
Hier die Rechnung für ein Lab, mit den oben genannten Anthropic-Preisen. Tragen Sie ein, was Sie ausgeben würden, wenn alles auf Opus 5.5 läuft, und schieben Sie dann Arbeit auf Sonnet 5.5 und Haiku 4.5 herunter. Die Ausgaben und die beiden Anteile können Sie selbst ändern. Die Preise sind fest, und weil Sonnet 5.5 bei Input und Output genau die Hälfte von Opus 5.5 kostet und Haiku 4.5 ein Viertel, hängt das Ergebnis nicht von Ihrem Input-Output-Verhältnis ab.
Mit den Standardwerten sinkt die Rechnung eines Teams, das monatlich 3.600 $ für alles auf Opus 5.5 ausgibt, auf etwa 2.070 $, wenn 40 % der Arbeit zu Sonnet und 30 % zu Haiku wandern (30 % von 3.600 $ bleiben zum vollen Preis, 40 % zum halben, 30 % zum Viertel). Das ist eine Ersparnis von rund 43 %, wobei die schwierigsten 30 % des Traffics weiter auf dem Flagship laufen. Reale Rechnungen weichen ab, weil Caching, Batch-Rabatte und Wiederholungen die Rechnung verändern. Verstehen Sie das also als Werkzeug zur Größenabschätzung.
Wenn Sie bei einer bestimmten Aufgabe nicht sicher sind, wo Sie anfangen sollen, stellt Ihnen der Baum unten drei kurze Fragen.
Seat-basierte Tarife verändern die Frage
Alles oben Gesagte setzt voraus, dass Sie pro Token zahlen. Zahlt Ihr Team pro Seat für eine Chat-App oder ein Coding-Tool, bestimmt das Lab die Stufe für Sie, und Ihr Hebel ist ein anderer. Anthropic hat zum Start von Opus 5.5 die Fünf-Stunden-Nutzungslimits in den Tarifen Pro, Max, Team und seat-basiertem Enterprise angehoben (Anthropic). In der Praxis sollten Seat-Nutzer für Routinearbeit die Mid-Tier-Option im Modellwähler nehmen, das Flagship für die schweren Sessions aufsparen und prüfen, wie die Nutzungslimits ihres Tarifs die einzelnen Modelle behandeln.
Wenn Sie nicht sicher sind, welches Abrechnungsmodell Ihre Tools nutzen, erklärt unser Leitfaden zu Preismodellen von KI-Tools Credits, Seats und Tokens. Ein Gateway wie OpenRouter lohnt sich, wenn Sie eine einzige Integration wollen, die Stufen und Labs ohne Codeänderungen wechseln kann, denn die ganze Routing-Idee hängt davon ab, dass sich günstig umschalten lässt.
Fehler, die die Rechnung hoch halten
- Die Stufe nach Markentreue wählen und nach einem Launch nie neu testen.
- Eine Stufe an einem einzigen schweren Beispiel statt an einer Stichprobe Ihres echten Traffics beurteilen.
- Lange Kontexte an das Flagship schicken, obwohl ein günstigeres Modell mit Retrieval genügen würde.
- Caching auslassen. Anthropic setzt Cache-Reads bei Opus 5.5 auf 0,20 $ pro Million Tokens an, was bei Agent-Schleifen zählt, die denselben Kontext immer wieder senden.
- Herstellerbenchmarks als Prognose der eigenen Ergebnisse behandeln.
Auch Prompts spielen eine Rolle. Ein gut gebauter Prompt lässt eine günstigere Stufe Aufgaben bewältigen, die ein schlampiger nach oben drückt. Unser Beitrag zu Prompt-Mustern, die Modell-Updates überstehen, zeigt, wie Sie diese Arbeit portabel halten. Einen breiteren Überblick, welche Modelle es gibt, finden Sie in unserem Vergleich der Top-KI-Modelle und LLMs und im Live-Board der Top 20 LLMs. Wenn Sie vor allem einen Chat-Assistenten statt einer API wollen, decken das das Board der KI-Chatbots und unser Leitfaden zu den Top-KI-Chatbots ab. Für Entwickler gibt es das Board der KI-Coding-Assistenten und die Übersicht der Coding-Assistenten. Und wenn Sie erwägen, Modelle selbst zu betreiben, zeigt Local AI vs. Cloud AI, wann sich das lohnt.
Häufig gestellte Fragen
Welches KI-Modell sollte ich nehmen, wenn ich nur eines wählen kann?
Nehmen Sie den Mid-Tier des Labs, das Ihr Stack ohnehin nutzt. Modelle der Klasse Sonnet 5.5 oder GPT-6.1 Sol bewältigen die breiteste Palette an Aufgaben zu moderaten Kosten, und eine günstigere oder stärkere Stufe können Sie später ergänzen, wo die Daten es rechtfertigen.
Lohnt sich das Flagship überhaupt jemals?
Ja, bei der schmalen Menge an Aufrufen, in denen ein Fehler teuer ist oder der Mid-Tier Ihre Prüfungen an echten Beispielen nicht besteht. Es ist ein Präzisionswerkzeug, kein Standard.
Kann ein Mid-Tier-Modell ein Flagship schlagen?
In Anthropics Benchmarks liegt Sonnet 5.5 beim agentischen Coding vor Opus 5.5. Das ist ein Herstellerergebnis für einen Aufgabentyp. Testen Sie es also an Ihrer eigenen Arbeit, bevor Sie einen kritischen Workflow umstellen.
Soll ich auf Haiku 5.5 oder Gemini 4 Argon warten?
Warten Sie auf keines von beiden. Anthropic hat Haiku 5.5 für die kommenden Wochen angekündigt, und Google hat Argon vorerst auf vertrauenswürdige Cyber-Verteidiger beschränkt und nicht allgemein verfügbar gemacht. Bauen Sie die Routing-Schicht so, dass eine neue Stufe nur eine Konfigurationsänderung ist, und lassen Sie Ihre Tests erneut laufen, sobald die Modelle erscheinen.
Woran erkenne ich, dass eine günstigere Stufe gut genug ist?
Lassen Sie sie an einer Stichprobe echter Eingaben laufen, wenden Sie eine automatische Prüfung an und vergleichen Sie die Fehlerquote mit der Stufe darüber. Ist der Abstand klein und die Aufgabe risikoarm, stufen Sie herunter. Erreichen Fehler Kunden, lassen Sie es.
Gelten diese Preise auch für Chat-Abos?
Nein. Es sind API-Preise pro Million Tokens. Chat-Tarife und Coding-Tools rechnen pro Seat oder mit einem Nutzungslimit ab, die Ersparnis ergibt sich also aus der Wahl leichterer Modelle für Routine-Sessions.