

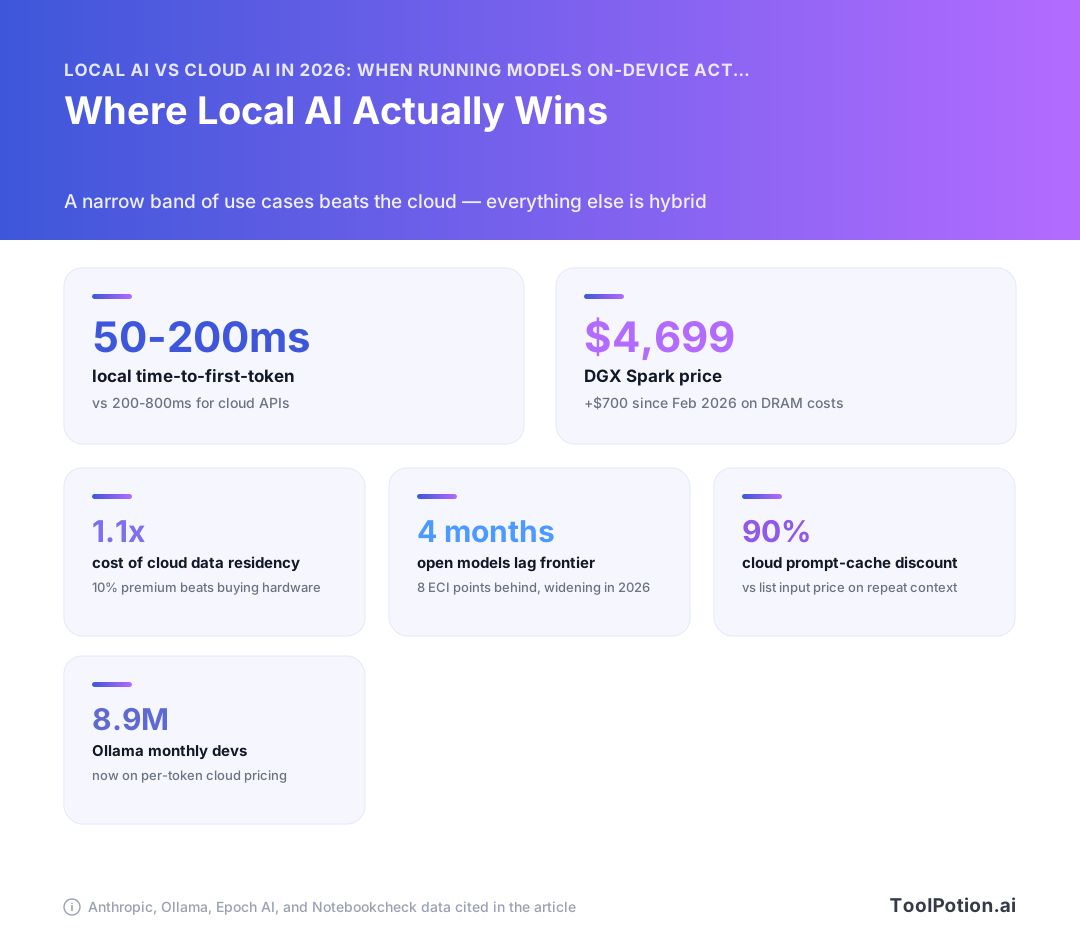
Kauf die GPU nur, wenn du sie wirklich auslasten wirst. Das ist die Kurzantwort zur Frage lokale KI vs. Cloud-KI in 2026: Ab etwa 26 % dauerhafter täglicher Auslastung schlägt ein lokaler Rechner das Bezahlen pro Token. Darunter finanzierst du brachliegendes Silizium zu den Speicherpreisen von 2026 – und diese Preise sind brutal: NVIDIA hat den DGX Spark im Februar 2026 von 3.999 $ auf 4.699 $ angehoben und dabei auf steigende DRAM- und Speicherkosten verwiesen (Notebookcheck).
Die Cloud-Seite wurde derweil günstiger – auf eine Weise, die die meisten Vergleiche übergehen. Prompt-Cache-Lesezugriffe werden zu 0,1-fachem Eingabepreis berechnet, und der 50 %-Batch-Rabatt kommt noch oben drauf, womit Claude Haiku 4.5 auf 0,50 $ Eingang / 2,50 $ Ausgang pro Million Token kommt (Anthropic).
So sieht diese Rechnung aus, was 24 GB tatsächlich ausführt und wo die Grenze für dich liegt.
Lokale KI vs. Cloud-KI: Das Spielbuch von 2026 ist an vier Stellen zerbrochen
Die Break-even-Rechnung, die du gelesen hast, ist falsch – und das nicht wegen eines Rundungsfehlers. Sie ist falsch, weil die Hardware teurer wurde, die Fähigkeitskennzahl falsch gelesen wurde, die Tooling-Seite gewechselt hat und die Cloud-Preisliste still unter jedermanns Tabellenkalkulation gesunken ist.
Die drei Annahmen, die jeder Vergleich noch immer trifft
Fast jeder Leitfaden zu lokal vs. Cloud auf der ersten Ergebnisseite stützt sich auf dieselben drei Behauptungen, die alle aus 2024 stammen. Erstens: Hardware ist ein fixer, sinkender Kostenfaktor – man amortisiert eine 1.999-$-GPU über 18 Monate und vergleicht das mit dem Token-Verbrauch. Zweitens: Open-Weight-Modelle liegen drei bis sechs Monate hinter geschlossenen Frontier-Modellen, also ist alles, was man zu Hause betreibt, ein paar Quartale im Rückstand. Drittens: "Lokal" bedeutet Ollama auf dem eigenen Rechner und "Cloud" bedeutet eine Frontier-API – ein sauberer Zweikampf.
Alle drei waren 2024 vernünftig. Keine übersteht die Konfrontation mit 2026.
Was sich zwischen 2024 und heute verändert hat
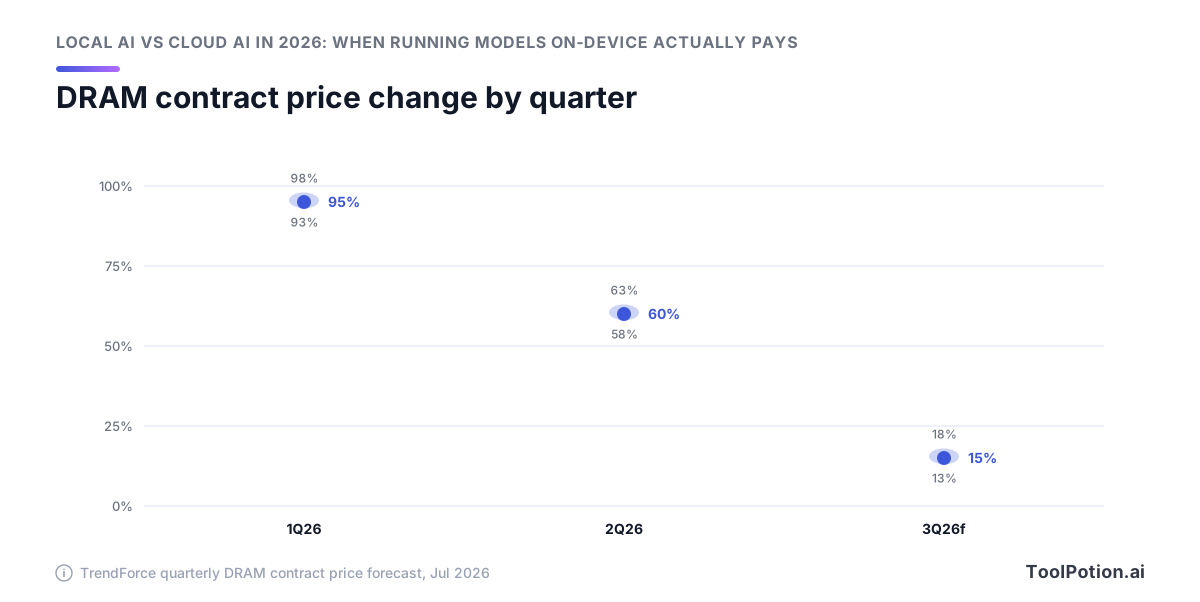
Beginnen wir mit dem Hardware-Boden, denn er hat sich in die falsche Richtung verschoben. NVIDIA hat den DGX Spark im Februar 2026 von 3.999 $ auf 4.699 $ angehoben – ein Plus von 700 $, das das Unternehmen mit explodierenden DRAM- und Speicherkosten begründete. Konventionelle DRAM-Vertragspreise stiegen in 1Q26 um rund 93–98 % im Quartalsvergleich und klettern in 3Q26 laut Prognosen um weitere 13–18 %. Jeder Rechner, der UVPs zitiert, unterschätzt dein CapEx um vierstellige Beträge.
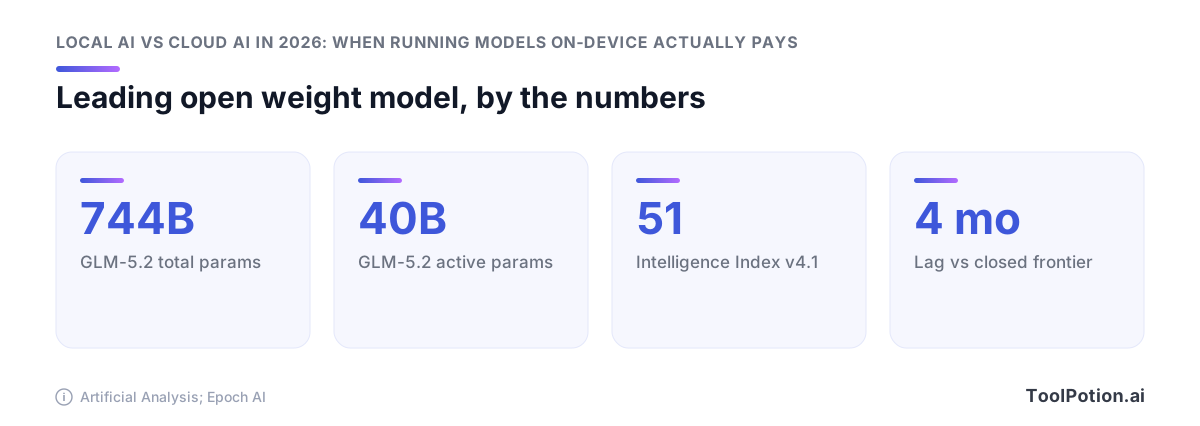
Dann die Fähigkeitslücke. Epoch AI beziffert den Rückstand auf 4 Monate oder 8 ECI-Punkte seit Januar 2026 – breiter als der 3-Monats-Durchschnitt von Januar 2023 bis Oktober 2025. Was niemand zitiert: Das Modell, das diesen Anspruch trägt, GLM-5.2, hat 744 B Gesamtparameter und 40 B aktive Parameter. Das ist ein Serverrack, kein Laptop.
Der dritte Bruch ist der seltsamste. Am 31. August 2026 wechselte Ollama Pro, Max und Team zu tokenbasierter Cloud-Preisgestaltung bei 20 $, 100 $ und 500 $ im Monat. Das Standard-Tool für "lokal betreiben" verkauft jetzt Tokens – damit wird der Vergleich zu einem Dreikampf zwischen der eigenen GPU, günstigen gehosteten Open-Weight-Modellen und Frontier-APIs. Wenn du die KI-Modelle, die wir tracken, gegeneinander abwägst, ist diese mittlere Option die, die du zuerst kalkulieren solltest.
Und die Cloud-Seite wurde günstiger auf eine Weise, die kein veröffentlichter Rechner abbildet: Prompt-Cache-Lesezugriffe zu 0,1-fachem Basis-Eingabepreis, ein 50 %-Batch-API-Rabatt obendrauf und US-only-Inferenz-Pinning zu einem 1,1-fachen Multiplikator. Letzteres verkauft dir die Datenschutzeigenschaft, für die Leute Hardware kaufen – zu einem 10 %-Aufpreis statt 4.699 $.
Was lokale Modelle in 2026 wirklich leisten
Eine 24-GB-Karte läuft 2026 ein gutes 20–30-B-Mixture-of-Experts-Modell, und dieses Modell entwirft, fasst zusammen, klassifiziert und arbeitet sich durch strukturierte Probleme mit einer Qualität, die die meisten Teams für akzeptabel halten. Es erfindet auch selbstsicher Fakten über alles, was außerhalb seiner Trainingsdaten liegt. Diese beiden Sätze sind die Fähigkeitslandkarte – und die meisten Break-even-Leitfäden überspringen den zweiten.
Die Obergrenze für Consumer-Hardware ist die 20–30-B-MoE-Klasse
gpt-oss-20b und Qwen3-30B-A3B sind die praktische Obergrenze für eine einzelne Consumer-GPU. Beide sind spärliche MoE-Architekturen, sodass die aktive Parameteranzahl klein genug bleibt, dass eine 24-GB-Karte die Gewichte hält und noch Platz für Kontext lässt. Darunter liegen die dichten Llama-, Mistral- und Phi-Klassen-Modelle bei 7–14 B, die komfortabler hineinpassen und dafür an Leistung einbüßen. Unsere Open-Weight-LLM-Einträge konzentrieren sich stark auf dieses Band, weil es das ist, was Menschen zu Hause betreiben können.
Stark im Schlussfolgern, schwach bei Weltwissen
Gib einem lokalen 30-B-Modell ein Dokument und bitte es, Felder zu extrahieren, einem Schema zu folgen oder eine Abfolge von Schritten durchzuarbeiten – es hält stand. Frag es, wer wen 2024 übernommen hat, und du bekommst plausible Fiktion.
Parameteranzahl ist das, was memorierte Fakten kauft, und ein Consumer-Modell hat den größten Teil dieser Parameter weggeworfen. Retrieval schließt die Lücke: Füge die Fakten in den Kontext ein und lass das lokale Modell den strukturierten Teil erledigen. Alles, was breiten Abruf ohne Retrieval-Schicht dahinter benötigt, gehört zu einer Frontier-API.
Warum die Schlagzeile "Open-Weight-Modelle holen auf" über Hardware handelt, die du nicht besitzt
Epoch AI beziffert die Lücke auf 4 Monate oder 8 ECI-Punkte seit Januar 2026, geringfügig breiter als der 3-Monats-Durchschnitt von Januar 2023 bis Oktober 2025 (Epoch AI). Die Zahl ist solide und sagt nichts über deinen Laptop aus. Das Modell, das die Open-Weight-Krone trägt, GLM-5.2, erzielt auf dem Intelligence Index v4.1 von Artificial Analysis 51 Punkte bei 744 B Gesamtparametern und 40 B aktiven Parametern (Artificial Analysis). Das ist Rechenzentrums-Hardware. Dieselbe Messung zeigt, dass GLM-5.2 43.000 Ausgabe-Token pro Aufgabe verbrennt, davon 37.000 Reasoning-Token, was bei rund 0,46 $ pro Aufgabe landet – gegenüber 0,18 $ für MiniMax-M3.
Was Quantisierung kostet
Q4_K_M ist nicht ohne Grund der Standard. Bei Mistral-7B-Instruct-v0.2 unter llama.cpp auf einem Apple M1 Pro reduzierte es das Modell von 7,2 GB auf 4,1 GB – 43,1 % kleiner – bei 0,51 % Perplexitätsverlust (dasroot). Q2_K ist der Punkt, an dem die Kurve bricht: 7,94 % Perplexitätsverlust, und das spürt man beim Befolgen von Anweisungen, lange bevor man es in einem Benchmark sieht. Quantisiere auf 4-Bit, hör dort auf und verwende den gesparten Speicher für Kontextlänge.
Der Hardware-Boden hat sich verschoben – und zwar in die falsche Richtung
Jeder Break-even-Rechner, den du findest, geht davon aus, dass du die Hardware zum Listenpreis kaufen kannst. In 2026 kannst du das meistens nicht – und der Listenpreis selbst ist gestiegen.
Die Speicherkrise – in Preisen, die du nachprüfen kannst
Konventionelle DRAM-Vertragspreise stiegen in 1Q26 um rund 93–98 % im Quartalsvergleich, in 2Q26 um weitere 58–63 %, und TrendForce prognostiziert für 3Q26 nochmals 13–18 % (TrendForce). Das ist eine Verlangsamung, keine Entspannung. Die Preise steigen weiter von einer Basis, die sich bereits verdoppelt hat. Die Nachfrage kommt nicht von dir: Rechenzentren absorbieren 2026 bis zu 70 % der weltweiten Speicherproduktion, gegenüber etwa 20–30 % in 2022, und allein HBM hat dieses Jahr 23 % der DRAM-Wafer beansprucht, gegenüber 8 % in 2024 (IDC). Lokale Inferenz ist ein Speicherkapazitätskauf im Wettbewerb mit denen, die die Clouds aufbauen, die du zu vermeiden versuchst.
DGX Spark, RTX 5090 und die Lücke zwischen UVP und Straßenpreis
NVIDIA hat den DGX Spark im Februar 2026 von 3.999 $ auf 4.699 $ angehoben – ein Plus von 700 $, das das Unternehmen auf explodierend steigende DRAM- und Speicherkosten zurückführte (Notebookcheck). Die 128 GB LPDDR5X sind der eigentliche Grund, warum er für lokale Modelle interessant ist – und auch der Grund, warum sein Preis einem Rohstoffmarkt folgt, den du nicht kontrollierst.
Behandle jede UVP aus 2025, die du in einem Vergleichsbeitrag zitiert siehst, als Fiktion. Prüfe, was das Teil diese Woche kostet, und rechne dann auf Basis dieser Zahl.
Stromkosten – der Posten, den alle vergessen
Eine GPU ist ein Einmalkauf, der dir jeden Monat eine Rechnung schickt. US-Haushaltsstromindustriepreis lag im Juni 2026 bei durchschnittlich 18,34 ¢/kWh, ein Anstieg von 5,0 % im Jahresvergleich, mit bundesstaatlichen Spannen von 8,96 ¢ in New Mexico bis 28,50 ¢ in Kalifornien (EIA). Der gleiche Rechner hat laufende Kosten, die je nach Standort um mehr als den Faktor 3 variieren. In Kalifornien kann allein der Strom dem Gegenwert gehosteter Tokens entsprechen. In New Mexico sieht die Rechnung anders genug aus, um das Ergebnis zu ändern.
Was ein vertretbarer 2026-Rechner kostet
Kalkuliere den Rechner zum aktuellen Straßenpreis, addiere die Leistungsaufnahme zu deinem tatsächlichen Stromtarif, und addiere die Stunden, die du mit lokalen Inferenz-Frameworks und Quantisierungs-Tuning verbringst, was ein gehosteter Endpunkt von dir nicht verlangt. Eine vierstellige CapEx-Zahl mit einem dreistelligen jährlichen OpEx-Anhang ist der ehrliche Ausgangspunkt – und beide Hälften wurden dieses Jahr schlechter, aus Gründen, die nichts damit zu tun haben, wie gut die Modelle sind.
Ollama vs. Cloud-API-Kosten: Der Vergleich ist jetzt dreigleisig
Drei Preise sind jetzt relevant: die GPU, die du kaufst, gehostete Open-Weight-Modelle und eine Frontier-API. Die mittlere Option gewinnt bei den meisten Workloads – und sie ist genau die, die fast kein veröffentlichter Break-even-Rechner einschließt.
Ollama selbst wurde am 31. August 2026 zu einer Cloud-API
Das Tool, das einer ganzen Entwicklergeneration beibrachte, Modelle auf dem eigenen Rechner zu betreiben, verkauft jetzt Tokens. Am 31. August 2026 wechselte Ollama Pro, Max und Team zu tokenbasierter Cloud-Preisgestaltung: 20 $/Monat inklusive 60 $ Nutzung, 100 $/Monat inklusive 300 $ und 500 $/Monat inklusive 1.000 $ für unbegrenzte Nutzer, mit null Datenspeicherung und Hosting in den USA und Europa (Ollama). "Ollama vs. die Cloud" beschreibt also keine echte Wahl mehr.
Gehostete Open-Weight-Modelle: die mittlere Option, die niemand einkalkuliert
| Modell | Eingang / Ausgang pro MTok | Quelle |
|---|---|---|
| nemotron-3-super (Ollama Cloud) | $0,015 / $0,60 | Ollama |
| deepseek-v4-flash (Ollama Cloud) | $0,22 / $0,66 | Ollama |
| qwen3.5:397b (Ollama Cloud) | $0,60 / $3,60 | Ollama |
| Claude Haiku 4.5 | $1,00 / $5,00 | Anthropic |
| Claude Sonnet 5 | $2,00 / $10,00 | Anthropic |
Lies das Kleingedruckte, bevor du eine Prognose auf diese Zahlen aufbaust. Die meisten Ollama-Cloud-Tarife verdoppeln sich zwischen 12:00 und 18:00 UTC an Wochentagen (Ollama), was deine Rechnung zu einer Planungsfrage macht. Schiebs Massenaufträge auf Abende und Wochenenden, und du behältst den Grundtarif. Betreibst du ein interaktives Produkt für europäische Nachmittagsnutzer, zahlst du den doppelten Tarif jeden Werktag. Diese Zeitvariable verdient mehr Aufmerksamkeit als die Wahl zwischen zwei ähnlich teuren Hosting-Anbietern.
Frontier-APIs sind günstiger als ihr Listenpreis suggeriert
Cache-Lesezugriffe werden zum 0,1-fachen Basis-Eingabepreis berechnet, die Batch-API nimmt 50 % auf Eingang und Ausgang ab, und beide Rabatte stapeln sich (Anthropic). Batch-Haiku 4.5 landet bei 0,50 $ Eingang und 2,50 $ Ausgang pro Million Token, und Sonnet 5 behielt seinen Einführungspreis von 2 $/10 $ statt wie geplant am 1. September 2026 auf 3 $/15 $ zu wechseln (Anthropic). Asynchrone Massenarbeit ist genau das, wofür lokale Rechner vermarktet werden – und es ist der Workload, bei dem Cloud-Rabatte am härtesten zuschlagen.
Der Tokenizer-Hinweis, der in die andere Richtung wirkt
Claude 4.7 und später verwenden einen neueren Tokenizer, der für denselben Text rund 30 % mehr Token erzeugt (Anthropic). Deine tatsächliche Sonnet-5-Rechnung für ein festes Corpus liegt etwa 30 % über dem, was die 2 $/10 $-Karte impliziert, wenn du mit einem lokalen Modell mit älterem Tokenizer vergleichst. Zähle Token auf deinem eigenen Text mit beiden, bevor du dich festlegst.
Den Kreuzungspunkt berechnen: Ab welchem Volumen gewinnt deine GPU?
Eigene Hardware beginnt gehostete Open-Weight-Modelle bei etwa 26 % dauerhafter täglicher GPU-Auslastung zu schlagen – rund sechs Stunden echter Arbeit pro Tag, täglich, amortisiert über 2026-Hardware-Preise und deinen lokalen Stromtarif. Unterhalb dieser Grenze liegt die Karte brach, während die Abschreibungsuhr läuft. Kalkuliere dein eigenes Volumen gegen den gehosteten Tarif, bevor du kaufst: deepseek-v4-flash kostet 0,22 $ Eingang und 0,66 $ Ausgang pro Million Token auf Ollama Cloud (Ollama).
Wo lokale KI gewinnt (eine kurze, benennbare Liste)
Vier Fälle halten einer genauen Prüfung stand. Alles andere ist ein hybrides Setup, bei dem du einfache Anfragen an ein lokales Modell weiterleitest und den Rest eskalierst.
Dauerhafter Hochvolumen-Batch-Betrieb, der die Karte auslastet
Wenn deine GPU 90 % des Tages brach liegt, hast du eine Heizung gekauft. Das Kaufargument erfordert, dass die Karte mehr als ein Viertel des Tages arbeitet, täglich – und es muss dem Vergleich mit der Claude Batch API standhalten, die Eingangs- und Ausgabe-Token um 50 % reduziert und sich mit Prompt-Caching stapelt (Anthropic). Das bringt Haiku-4.5-Batch-Arbeit auf 0,50 $ pro Million Eingabe-Token und 2,50 $ Ausgabe. Dein lokaler Rechner muss das auf amortisierter Hardware plus Strom schlagen, und bei einem US-Haushaltsdurchschnitt von 18,34 ¢/kWh im Juni 2026 (EIA) ist eine wirklich ausgelastete Karte auch nicht kostenlos. Rechne mit deinem tatsächlichen Token-Volumen, bevor du mit einem Datenblatt rechnest.
Harte Datensouveränität – CLOUD Act und nicht nur DSGVO
Diese Kategorie existiert wirklich, und sie ist enger als die meisten behaupten. DSGVO-Konformität ist ein Vertragsproblem. Die Anforderung, dass keine US-Rechtsträger dazu gezwungen werden können, deine Daten herauszugeben, ist ein physikalisches Problem – und physikalische Probleme löst man mit Hardware, die man kontrolliert.
Interaktive Schleifen, bei denen Time-to-First-Token das Produkt ist
Lokale Inferenz liefert 50–200 ms Time-to-First-Token gegenüber 200–800 ms für die Cloud, wobei Claude Haiku 4.5 bei 597 ms und GPT-4.1 Mini bei rund 2.400 ms gemessen wurde (Eden AI). Für ein Chat-Fenster bemerkt das niemand. Für Inline-Code-Vervollständigung oder einen Multi-Step-Agenten, der acht Aufrufe verkettet, summiert sich der Unterschied zu etwas, das Nutzer spüren. Wenn du in dieser Form entwickelst, schau dir die KI-Agenten in unserem Verzeichnis an und prüfe, wie viele davon pro Tastendruck einen Roundtrip machen.
Offline- und Air-Gap-Betrieb
Kein Argument nötig. Entweder das Netzwerk ist da oder nicht.
Das Datenschutzargument, das die Cloud jetzt zurückverkauft
Das stärkste Gegenargument zu Fall zwei ist, dass Anthropic dir diese Eigenschaft direkt verkauft. Ab Claude 4.6 und später kostet das Einschränken der Inferenz auf US-only mit inference_geo: "us" einen 1,1-fachen Multiplikator auf alle Token-Kategorien (Anthropic). Das ist ein 10-%-Aufpreis statt 4.699 $ für den DGX Spark. Ollamas Bezahlpläne werben unterdessen mit null Datenspeicherung, gehostet in den USA und Europa, seit dem 31. August 2026 (Ollama). Wenn deine Datenschutzanforderung durch eine vertragliche Garantie und eine geografische Einschränkung erfüllt wird, hast du keine Hardware-Anforderung.
Das hybride Setup, auf das die meisten Praktiker setzen
Route nach Schwierigkeit, nicht nach Prinzip. Ein 20–30-B-MoE-Modell auf der eigenen Karte bearbeitet rund sieben von zehn Anfragen in einem typischen Assistenten- oder Dokumentenverarbeitungs-Workload, die restlichen drei gehen an eine Frontier-API. Diese Aufteilung ist die Architektur. Alles andere ist Feinabstimmung.
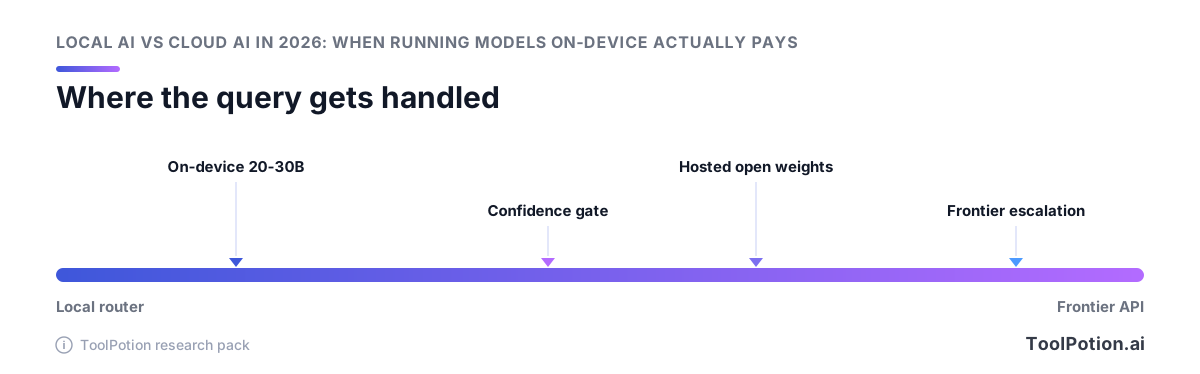
Drei Signale entscheiden über die Eskalation, und du kannst alle berechnen, bevor das lokale Modell fertig ist: die eigene Konfidenz des Modells (Log-Prob-Marge oder eine günstige Selbstprüfung), ob die Anfrage Weltwissen benötigt, das die lokalen Gewichte nicht haben, und die Kontextlänge. Das Wissenssignal fängt die meisten Fehler ab. Ein 24-GB-Modell schlussfolgert gut und erinnert sich schlecht – daher sollte alles, das klingt wie "Wer hat wen 2025 übernommen?", lokal gar nicht erst verarbeitet werden.
Ein konkreter Stack, der funktioniert
Ollama oder LM Studio vorne, eine Frontier-API dahinter und ein schlanker Router dazwischen, der jede Entscheidung protokolliert.
Schicke den eskalierten Traffic zuerst an Claude Haiku 4.5 zu 1 $/MTok Eingang und 5 $/MTok Ausgang, und greife erst auf Sonnet 5 zu 2 $/10 $ zurück, wenn Haikus Antwort deine Prüfung nicht besteht (Anthropic-Preise). Wenn die eskalierte Arbeit asynchron ist, bündle sie: Die Batch-API halbiert beide Seiten, sodass Haiku bei 0,50 $/2,50 $ landet. Die meisten Teams überspringen das und zahlen den Listenpreis für Arbeit, die zwanzig Minuten hätte warten können.
Instrumentiere die Eskalationsrate, oder du fliegst blind
Protokolliere vier Zahlen pro Anfrage: welche Ebene sie bedient hat, die Konfidenz des lokalen Modells, Token-Anzahlen und ob ein Mensch die Antwort wiederholt hat. Die Wiederholungsrate ist dein echtes Qualitätssignal. Liegt die Eskalation unter etwa 20 %, beantwortet dein lokales Modell Dinge, die es nicht sollte – du wirst es an den Wiederholungen sehen. Über 45 % verdient die GPU ihre Abschreibung nicht.
Warum sich die Grenze jedes Quartal verschiebt
Preise auf beiden Seiten bewegen sich schneller als deine Architektur. Ollama hat Pro, Max und Team am 31. August 2026 auf tokenbasierte Cloud-Abrechnung umgestellt (Ollama), Ollama-Cloud-Tarife verdoppeln sich zwischen 12:00 und 18:00 UTC an Wochentagen (Ollama-Preise), und Open-Weight-Kapazität liegt seit Januar 2026 im Schnitt etwa 4 Monate hinter geschlossenen Frontier-Modellen (Epoch AI). Überprüfe deine Routing-Schwellenwerte einmal im Quartal anhand aktueller Zahlen. Trag es in den Kalender ein.
Die Tooling-Schicht ist stabil genug zum Daraufbauen
Ollama läuft bei 8,9 Millionen monatlich aktiven Entwicklern mit einem 14-köpfigen Team, ist in 85 % der Fortune-500-Unternehmen integriert und hat im Juli 2026 unter Führung von Theory Ventures 65 Mio. $ eingesammelt (TechCrunch). Das ist kein Projekt, das nächstes Jahr verschwindet. Den Router-Kleber drumherum besitzt du, und den Großteil davon kannst du aus den Open-Source-KI-Repos borgen, die dieses Muster bereits veröffentlichen.
In fünf Fragen entscheiden
Beantworte diese der Reihe nach. Die erste, die dir ein klares Ja gibt, entscheidet über dein Setup – dort kannst du aufhören.
Hast du eine harte Souveränitätsanforderung?
Hart bedeutet: Air-Gap, CLOUD-Act-Exposition, die der Rechtsdienst schriftlich festgehalten hat, oder ein Vertrag, der die Maschine benennt. Wenn das auf dich zutrifft, kauf die Hardware und hör auf, den Kostenabschnitt zu lesen. Wenn deine Anforderung weicher ist, wird Anthropic die Inferenz mit inference_geo: "us" auf US-only einschränken – ab Claude 4.6 und später zu einem 1,1-fachen Multiplikator auf alle Token-Kategorien (Anthropic-Preisdokumentation) –, und Ollamas Bezahlpläne laufen mit null Datenspeicherung in den USA und Europa (Ollama). Ein 10-%-Aufpreis schlägt für fast jeden 4.699 $ Hardware.
Ist deine Arbeit latenzgebunden oder durchsatzgebunden?
Interaktive Schleifen, bei denen ein Mensch auf jedes Token wartet, begünstigen lokal: 50–200 ms bis zum ersten Token gegenüber 200–800 ms für die Cloud, wobei Claude Haiku 4.5 bei 597 ms gemessen wurde (Eden AI). Durchsatzarbeit läuft andersherum. Bündele sie und nimm den 50-%-Rabatt mit, was Haiku 4.5 auf 0,50 $/MTok Eingang und 2,50 $ Ausgang bringt (Anthropic).
Wird die GPU mehr als ein Viertel des Tages ausgelastet sein?
Unterhalb dieser Grenze schreibt deine Karte ab, während sie brach liegt, und gehostete Open-Weight-Modelle gewinnen bei den Kosten. Darüber beginnt die lokale Rechnung aufzugehen. Sei ehrlich beim Nenner – Nächte und Wochenenden zählen.
Benötigt deine Aufgabe Weltwissen oder nur Schlussfolgerung?
Schlussfolgerung über von dir gelieferten Text läuft gut auf einem 20–30-B-MoE-Modell. Fragen, die von Fakten abhängen, die das Modell bereits kennen muss, gehören zu einer Frontier-API – oder zum gehosteten GLM-5.2, das 744 B Gesamtparameter hat und niemals auf deinen Laptop passt (Artificial Analysis).
Kannst du ein vierteljährliches Nachjustieren tolerieren?
Die Open-Closed-Lücke liegt bei 4 Monaten und hat sich von einem 3-Monats-Durchschnitt verschoben (Epoch AI), dein Routing-Schwellenwert hat also eine Haltbarkeitsdauer. Teams, die ihn nicht überprüfen wollen, sollten standardmäßig eine Frontier-API mit aktiviertem Caching nutzen und nichts routen. Teams, die das können, schauen sich echte Deployment-Fallstudien an, um zu sehen, bei welchen Schwellenwerten andere gelandet sind.
Was dieses Urteil in 2027 verändern würde
Dieser Rat hat ein Ablaufdatum, und drei konkrete Zahlen setzen es.
Speicherpreise verlangsamen sich – sie sinken nicht
Konventionelle DRAM-Vertragspreise stiegen in 1Q26 um rund 93–98 % im Quartalsvergleich, dann 58–63 % in 2Q26, mit einer Prognose von 13–18 % für 3Q26. Diese Kurve flacht ab. Sie zeigt noch immer nach oben. Eine langsamere Steigerungsrate gibt dir nicht die 700 $ zurück, die NVIDIA dem DGX Spark im Februar 2026 aufgeschlagen hat – und die Prognose sagt nicht, dass Straßenpreise nächstes Jahr sinken. Plane damit, dass das Hardware-Argument bis 2027 schwach bleibt, es sei denn, die Nachfrage der Rechenzentren lässt nach.
Beobachte die Open/Closed-Lücke, nicht den Headline-Benchmark
Zwei Signale sind wichtiger als jede Leaderboard-Position. Das erste ist Epoch AIs ECI-Lücke, die seit Januar 2026 bei 4 Monaten oder 8 Punkten liegt. Das zweite ist die aktive Parameteranzahl: GLM-5.2 führt bei Open-Weights mit 40 B aktiven von 744 B Gesamtparametern – der Tag, an dem ein Modell mit weniger als 30 B aktiven Parametern innerhalb weniger ECI-Punkte an der Frontier landet, wird die 24-GB-Karte wieder interessant. Beobachte auch, ob Ollamas Peak-Stunden-Verdoppelung (12:00–18:00 UTC an Wochentagen) bestehen bleibt oder sich normalisiert. Unsere KI-Trendberichte verfolgen die Modell-Releases, die eines dieser Signale bewegen würden.
Häufig gestellte Fragen
Ist es günstiger, ein LLM lokal zu betreiben oder eine Cloud-API in 2026 zu nutzen?
Für die meisten Menschen: Cloud – und die Lücke hat sich 2026 vergrößert. Claude Haiku 4.5 kostet 1 $ pro Million Eingabe-Token und 5 $ pro Million Ausgabe-Token, sinkt über die Batch-API auf 0,50 $/2,50 $, und Prompt-Cache-Treffer werden zu 0,1-fachem Basis-Eingabepreis berechnet (Anthropic-Preise). Auf der anderen Seite stieg ein NVIDIA DGX Spark im Februar 2026 aufgrund von DRAM- und Speicherkosten von 3.999 $ auf 4.699 $ (Notebookcheck), und du zahlst weiterhin Strom zu einem US-Haushalts-Durchschnitt von 18,34 ¢/kWh im Juni 2026 (EIA). Lokale Hardware zahlt sich aus bei dauerhaftem Hochvolumen-Batch-Betrieb, der die Karte einen großen Teil des Tages auslastet, beim Air-Gap-Betrieb und bei latenzempfindlichen Schleifen.
Welche Hardware benötige ich, um ein LLM 2026 lokal zu betreiben?
Eine 24-GB-GPU ist der praktische Consumer-Boden, und sie begrenzt dich auf die 20–30-B-Mixture-of-Experts-Klasse statt auf irgendetwas nahe der Open-Weight-Frontier. Darüber hinaus kaufst du eine 128-GB-LPDDR5X-Box wie den DGX Spark, der jetzt 4.699 $ kostet (Notebookcheck). Kalkuliere weiter steigende Speicherpreise ein: Konventionelle DRAM-Vertragspreise stiegen in 1Q26 um rund 93–98 % und in 2Q26 um 58–63 % im Quartalsvergleich, mit weiteren 13–18 % für 3Q26 prognostiziert (TrendForce). Quantisierung dehnt, was hineinpasst, und 4-Bit ist nahezu kostenlos: Q4_K_M schrumpfte ein 7,2-GB-Modell auf 4,1 GB bei 0,51 % Perplexitätsverlust, während Q2_K bei 7,94 % stark abbaut (Quantisierungs-Tradeoffs).
Wie gut sind lokale Modelle im Vergleich zu Claude oder GPT?
Die oft zitierte Lücke ist real, beschreibt aber Hardware, die du wahrscheinlich nicht besitzt. Epoch AI hat gemessen, dass Open-Weight-Modelle geschlossene Frontier-Modelle im Durchschnitt um 4 Monate oder 8 ECI-Punkte hinterherhinken, seit Januar 2026, geringfügig mehr als der 3-Monats-Durchschnitt von Januar 2023 bis Oktober 2025 (Epoch AI). Das Modell, das diesen Anspruch trägt, GLM-5.2, erzielt 51 Punkte auf dem Intelligence Index v4.1 von Artificial Analysis bei 744 B Gesamt- und 40 B aktiven Parametern – das ist Rechenzentrums-Hardware (Artificial Analysis). Was tatsächlich auf einen Laptop oder eine einzelne GPU passt, ist stark im strukturierten Schlussfolgern und schwach bei Weltwissen – behandle den 4-Monats-Wert als eine Obergrenze, die du zu Hause nicht erreichen kannst.
Ist Ollama noch kostenlos, und wie verhält sich Ollama-Cloud-Preisgestaltung im Vergleich zu Frontier-APIs?
Die Gegenüberstellung lokal-vs.-Ollama hatte am 31. August 2026 keinen Sinn mehr, als Ollama seine Pro-, Max- und Team-Pläne auf tokenbasierte Cloud-Preisgestaltung umstellte: 20 $/Monat inklusive 60 $ Nutzung, 100 $/Monat inklusive 300 $ und 500 $/Monat inklusive 1.000 $ für unbegrenzte Nutzer, mit null Datenspeicherung, gehostet in den USA und Europa (Ollama-Blog). Gehostete Open-Weight-Modelle sind dort günstig: deepseek-v4-flash kostet 0,22 $ Eingang und 0,66 $ Ausgang pro Million Token, nemotron-3-super 0,015 $/0,60 $, qwen3.5:397b 0,60 $/3,60 $ – wobei die meisten Tarife in den Stoßzeiten von 12:00 bis 18:00 UTC an Wochentagen doppelt so hoch sind (Ollama-Preise). Im Vergleich zu Claude Haiku 4.5 zu 1 $/5 $ (Anthropic-Preise) ist die eigentliche Entscheidung dreigleisig, wobei gehostete Open-Weight-Modelle deine eigene GPU bei den Kosten für die meisten Workloads schlagen. Ollama ist in jedem Fall ernst zu nehmen: 8,9 Millionen monatlich aktive Entwickler und 85 % der Fortune-500-Unternehmen (TechCrunch).
Macht das lokale Betreiben eines Modells meine Daten wirklich privater als eine Cloud-API?
Es gibt dir eine Eigenschaft, die sonst nichts bietet: Die Bytes verlassen nie deine Maschine – das ist wichtig für Air-Gap-Betrieb und harte Datensouveränitätsanforderungen wie den CLOUD Act. Für alles, das weicher als das ist, verkaufen Anbieter jetzt dieselbe Garantie günstig. Ab Claude 4.6 und später kostet das Einschränken der Inferenz auf US-only mit inference_geo: "us" einen 1,1-fachen Multiplikator auf alle Token-Kategorien (Anthropic-Preise), und Ollamas Bezahlpläne laufen mit null Datenspeicherung in den USA und Europa (Ollama-Blog). Ein 10-%-Aufpreis ist eine viel geringere Verpflichtung als 4.699 $ Hardware (Notebookcheck).
Mit welchem lokalen Modell soll ich auf einer 24-GB-GPU anfangen?
Beginne mit einem 20–30-B-Mixture-of-Experts-Modell wie Qwen3-30B-A3B oder gpt-oss-20b, quantisiert auf Q4_K_M. Diese Klasse erzielt 73–87 % auf AIME 2024 auf einer einzelnen RTX 5090, also hält das Schlussfolgern stand – während faktischer Abruf über die Welt die Schwachstelle ist. Q4_K_M ist der richtige Quantisierungsstopp: Es schrumpfte ein 7,2-GB-Modell auf 4,1 GB bei 0,51 % Perplexitätsverlust, und Q2_K brach bei 7,94 % stark ein (Quantisierungs-Tradeoffs). Nutze es als ersten Hop und eskaliere wissensintensive Anfragen an ein Cloud-Modell.