

GitHub zufolge hat Copilot Fusion Max im Artificial Analysis Coding Agent Index „60 Punkte erreicht, zwei Punkte hinter Claude Code mit Opus 5.5 Max" (GitHub changelog). Die Schlagzeile der New Stack machte daraus ein System, das „Claude Code bei halben API-Kosten schlägt" (The New Stack). Das sind zwei verschiedene Aussagen, und genau in der Lücke dazwischen sollte ein Team nachdenken.
Fusion ist in GitHub Copilot allgemein verfügbar und erscheint als neuer Eintrag in der Modellauswahl. Sie wählen kein Modell, sondern eine Effort-Stufe, und Copilot entscheidet pro Prompt, welche Modelle in welcher Reihenfolge laufen. Die Idee ist gut, die Belege dafür sind dünn. Wir würden Fusion deshalb zuerst als Funktion zur Kostenkontrolle betrachten und erst danach als Qualitätsversprechen.
60 ist nicht 62
Lesen Sie GitHubs eigene Formulierung noch einmal. Fusion Max lag bei etwa halben durchschnittlichen API-Kosten pro Aufgabe, etwa halb so vielen Tokens und rund 40 % weniger Zeit zwei Punkte hinter Claude Code mit Opus 5.5 Max (Changelog). Das ist ein respektables Ergebnis und ein faires Verkaufsargument. Ein Sieg ist es nicht, und selbst der Fließtext der New Stack spricht von „vergleichbar", obwohl die Überschrift „schlägt" sagt. GitHub wiederholte die Aussage in seinem Universe-Rückblick, wo „halbe Kosten" die Version ist, die sich verbreitet.
Artificial Analysis veröffentlicht den Index, den GitHub zitiert. Er kombiniert drei Benchmarks – FrontierCode, Terminal-Bench 4.0 und SWE-Atlas-QnA-AA – mit gleicher Gewichtung (Artificial Analysis). In der Standardansicht der Seite steht Claude Code mit Opus 5.5 Max bei 62, einen Fusion-Eintrag gibt es dort nicht. Schalten Sie den Schalter „Router models" ein, erscheint GitHub Copilot - Copilot Fusion (Max) mit 60. Die Zahl stimmt also und liegt dort, wo GitHub sie angibt. Derselbe Schalter zeigt Cognitions Devin Fusion CLI, das Opus 5.5 Max mit GPT-6 Luna kombiniert und mit 62 gleichauf mit Claude Code liegt. Das spricht dafür, dass Router als Klasse aufholen, nicht dafür, dass GitHubs Router der zu schlagende ist. Die Kostenspalten der Seite haben wir nicht mit GitHubs Angabe „halbe Kosten" abgeglichen, dieser Teil bleibt also GitHubs Wort.
Drei Pfade hinter einem Menüeintrag
Die Dokumentation nennt Fusion „an intelligent runtime model router and orchestrator" (GitHub Docs). Für jeden Prompt wählt es eines von drei Ausführungsmustern, und verschiedene Prompts derselben Sitzung können unterschiedliche Wege nehmen.
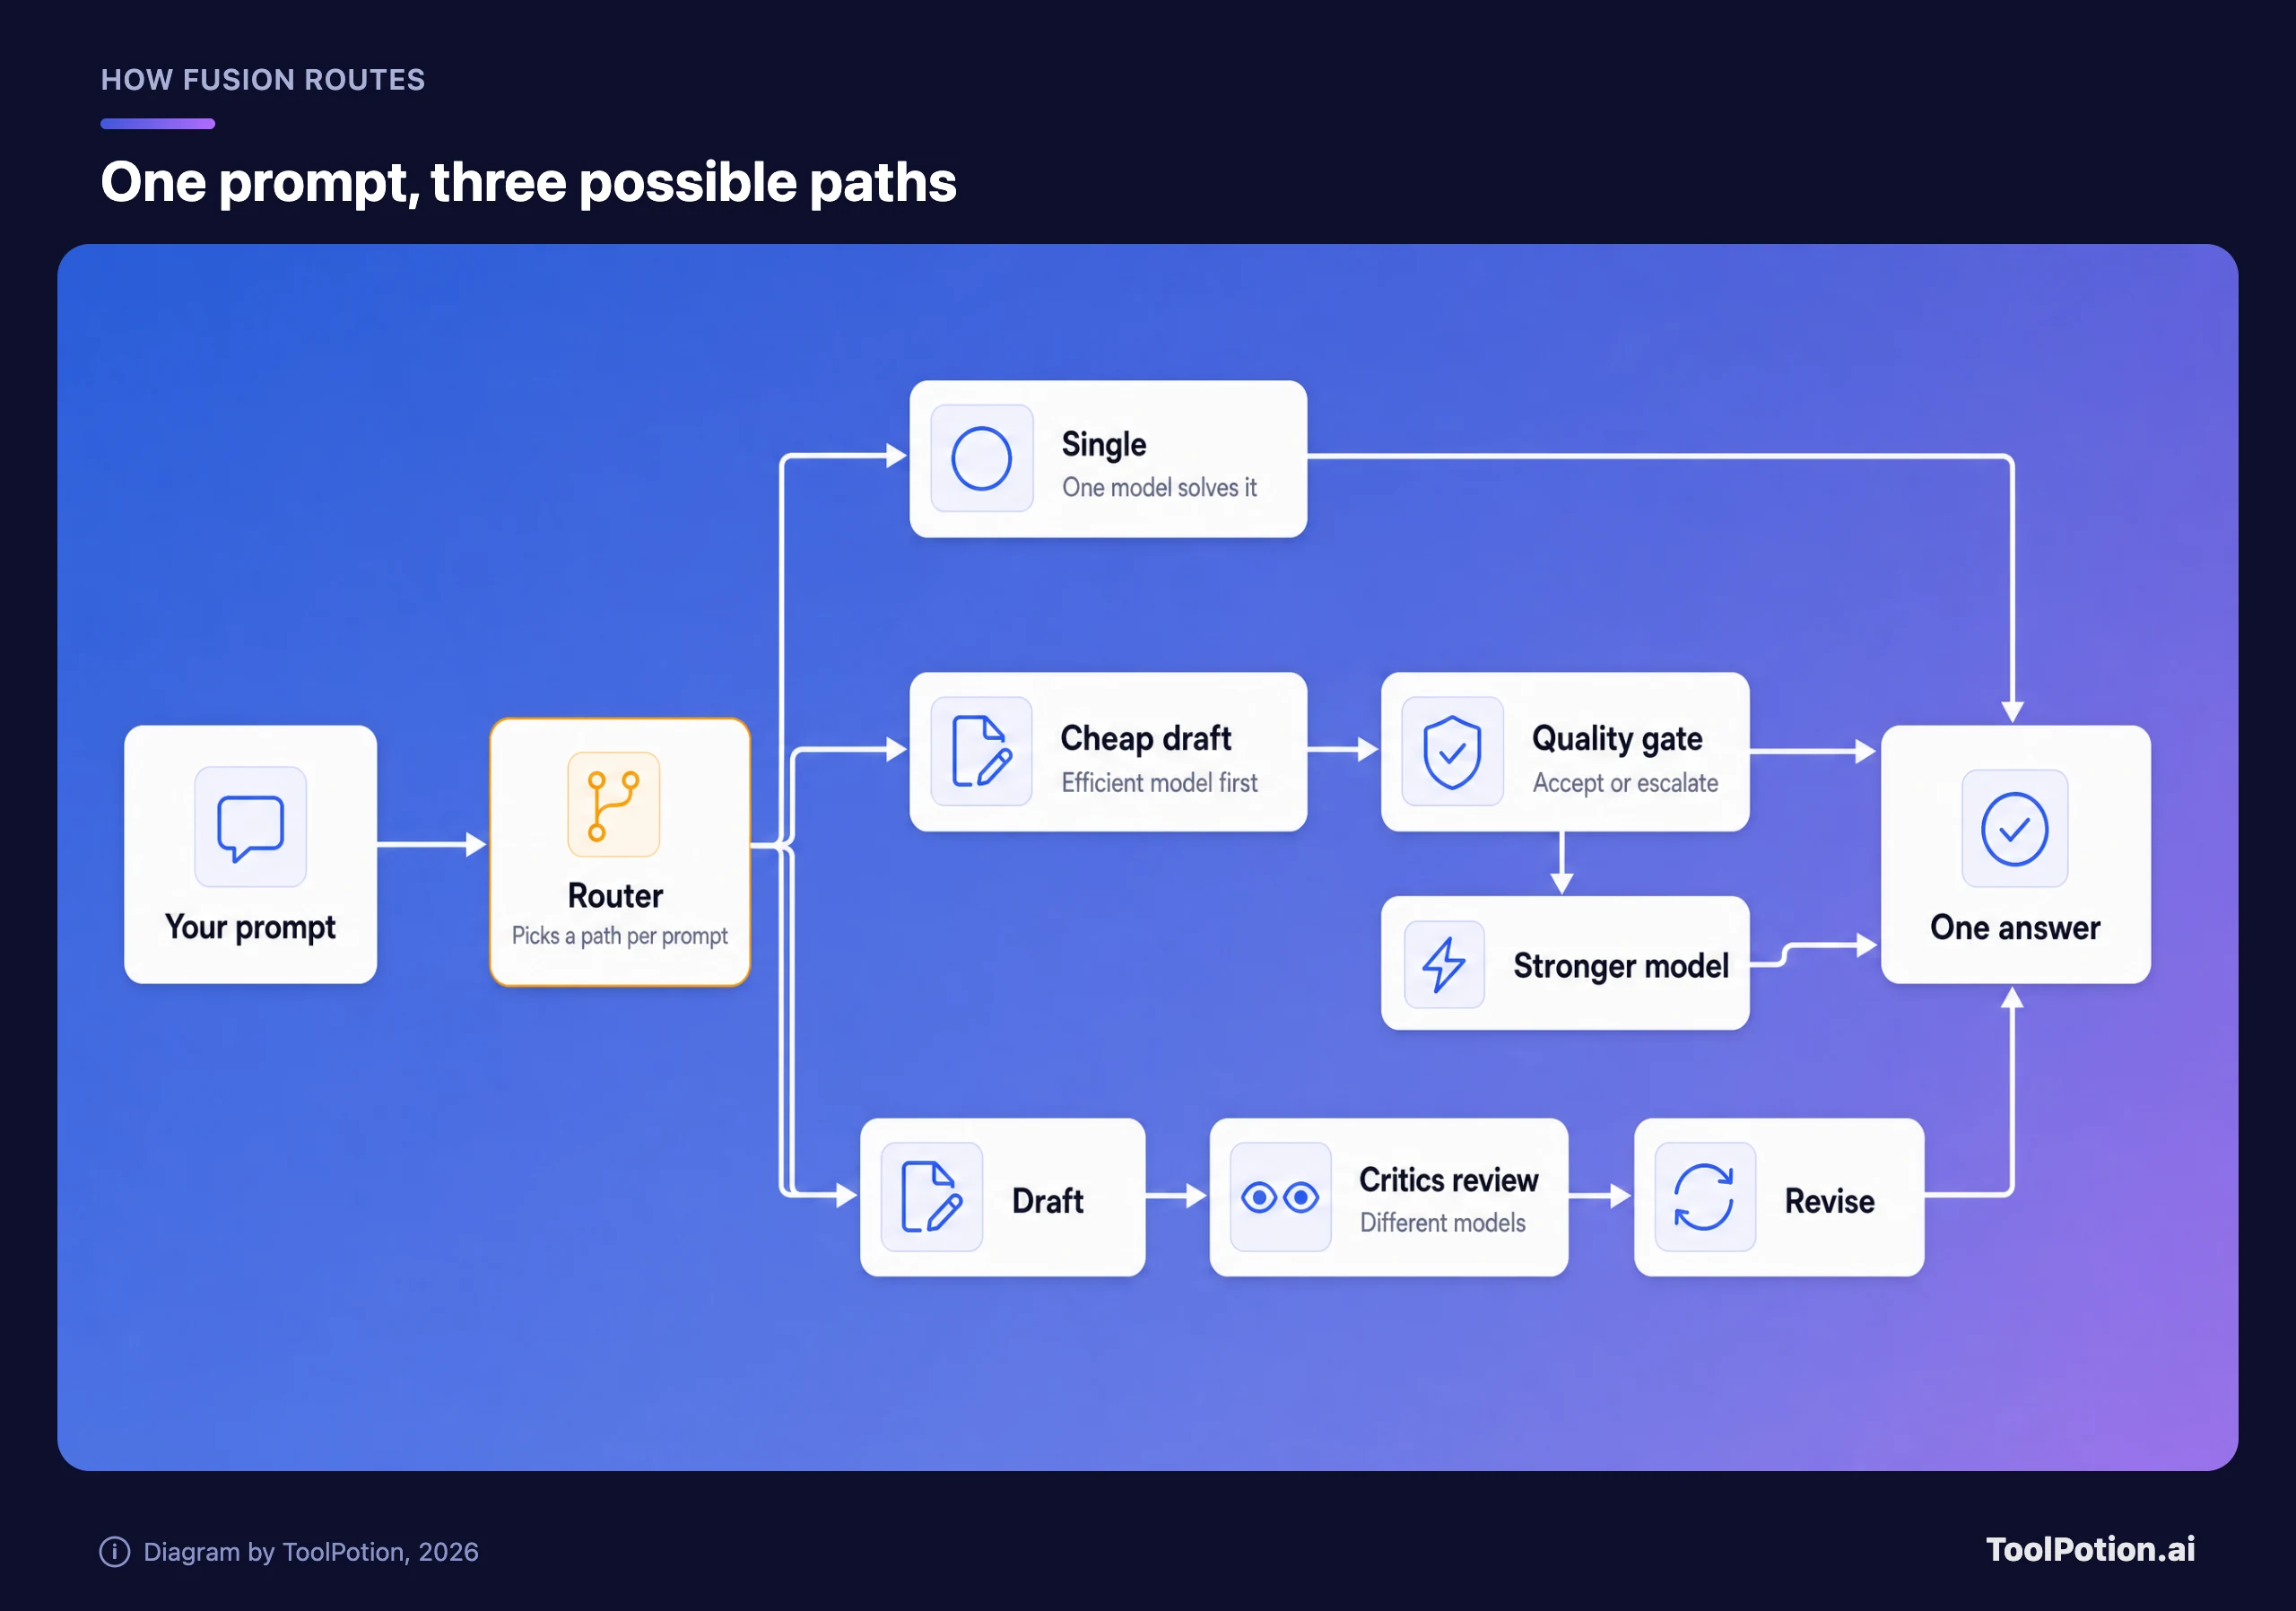
Bei Single antwortet ein einzelnes Modell direkt. Bei Cascade erstellt ein effizientes Modell einen Entwurf, und ein Judge entscheidet, ob der Entwurf akzeptiert oder an ein stärkeres Modell eskaliert wird. Bei Critique erstellt ein Modell den Entwurf, während andere Modelle ihn prüfen, und der Autor überarbeitet ihn. Die Effort-Stufen legen fest, wie aggressiv geroutet wird: Standard für den Alltag, High für umfangreiche Aufgaben, Max für das schwierigste Reasoning.
Zwischen Preview und Launch hat sich ein Detail geändert. GitHubs früherer Research-Preview-Beitrag beschrieb „an independent read-only critic from a different model family" (GitHub blog). Das Launch-Changelog sagt „another model reviews it", die Dokumentation dagegen, dass mehrere Modelle parallel kritisieren und ihr Feedback zusammengeführt wird. Wir lesen das so, dass der Critique-Schritt von einem Prüfer auf mehrere gewachsen ist. GitHub sagt das aber nicht ausdrücklich, und das Changelog weist nicht auf den Unterschied hin.
Jeder Plan bekommt es, und Sie zahlen pro Modell
Laut Changelog ist Fusion in allen Copilot-Plänen in VS Code, der Copilot-App, Copilot CLI und den JetBrains-IDEs verfügbar, weitere Clients sollen folgen. Abgerechnet wird jedes genutzte Modell zu seinem regulären Tarif, eine separate Fusion-Gebühr gibt es nicht. Bezahlte Pläne erhalten zeitlich befristet 30 % Rabatt auf die Modellkosten, und laut Dokumentation endet dieser Rabatt später in diesem Jahr (Docs).
Zwei offene Punkte. Die Fusion-Dokumentation sagt, es sei „available with all GitHub Copilot plans". Die Plan-Seite sagt, dass der Modellzugriff bei Free und Student nur über die automatische Modellauswahl läuft. GitHub löst diesen Widerspruch nicht auf. Die Tabelle der Effort-Stufen pro Plan kennzeichnet die Verfügbarkeit mit Icons, die bei uns als leere Zellen ankamen. Wir können Ihnen also nicht sagen, welche Stufen Free- und Student-Seats bekommen. Prüfen Sie das in Ihrer eigenen Modellauswahl. Und weil High und Max mehrere Modelle aufrufen können, warnt die Dokumentation selbst, dass eine Aufgabe mehr AI Credits verbrauchen kann als auf Standard. „Halbe Kosten pro Aufgabe" ist eine Aussage über Max im Vergleich zu Claude Code, kein Versprechen für Ihr Credit-Guthaben.
Der Benchmark: GitHub bewertet GitHub
Der frühere HydraFusion-Beitrag ist offener als der Launch. Die Tests liefen für alle Modelle auf derselben mittleren Reasoning-Stufe, nutzten geschätzte Kosten unter gemeinsamen Preisannahmen und verglichen gegen Opus 5 und GPT-5.6 Sol. GitHub sagt außerdem, die Routing-Policy per Beam Search über genau die drei Benchmarks getunt zu haben, die auch berichtet wurden (GitHub blog).
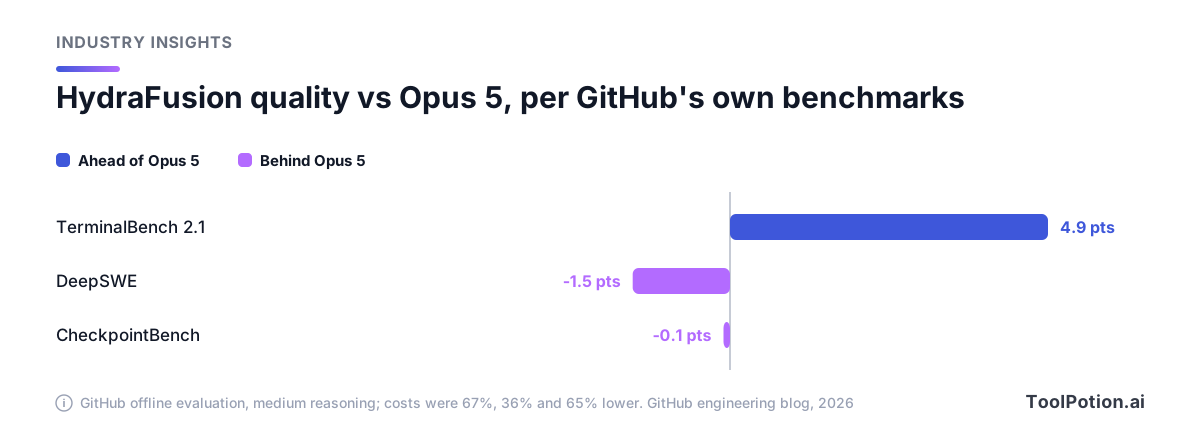
Achten Sie auf das Muster. Ein Benchmark zeigt einen Gewinn von 4,9 Punkten, die anderen beiden leichte Verluste, bei 36 % bis 67 % niedrigeren Kosten. Das ist eine Kostengeschichte bei in etwa gleichbleibender Qualität – und genau das sagt am Ende auch der Launch-Text.
Entwickler auf Hacker News griffen die Baseline an. Ein Kommentator schrieb, „Opus 5 (in practice) is not a good baseline to compare against" (HN). Ein anderer zweifelte das Ergebnis an: „It doesn't take much to beat the frontier in single benchmarks if one puts extra software between the model and the harness" (HN). Ein Copilot-CLI-Nutzer im selben Thread sagte, der Auto-Modus „only changes models at the start of a session or after compaction" (HN), und ein weiterer nannte die automatische Auswahl für sich „basically unusable" (HN). Das sind Einzelstimmen, keine Studien. Sie zeigen aber, wo die Skepsis sitzt.
Dazu kommt eine Abrechnungsfalle. Der Index und GitHubs Vergleich verwenden API-Kosten pro Token. Wer ein Claude-Code-Abo mit Pauschalpreis nutzt, sieht diese Zahl nie. „Halbe Kosten" kommt bei Einzelnutzern deshalb anders an als bei einem Team, das API-Ausgaben misst. Artificial Analysis selbst weist darauf hin, dass viele Nutzer diese Tools über Abos statt pro Token nutzen. Der Schluss ist unsere Folgerung, keine Aussage von GitHub, aber er verändert, an wen sich die Schlagzeile richtet.
Die einzige Kundenstimme, die GitHub liefert, ist die von Hari Pokhrel von AT&T, zitiert in GitHubs eigenem Changelog: „Previously, developers would often choose a more powerful model for a complex task and forget to switch back for everyday activities." Das ist das ehrliche Argument für Fusion: Es verhindert, dass Leute ein teures Modell für Routinearbeit eingeschaltet lassen.
Ihre Policy entscheidet, wer Ihren Diff liest
Diesen Teil würden wir vor dem Benchmark lesen. Fusion nutzt nur Modelle, die in Ihren Enterprise- und Organisations-Policies aktiviert sind. Admins können einzelne Modelle nur für Fusion deaktivieren, ohne sie überall zu sperren, und Modelle, die durch Data-Residency- oder FedRAMP-Policies ausgeschlossen sind, bleiben außen vor (Docs).
Die Prüfung durch ein zweites Modell ist die Design-Wette, und der Preview-Beitrag sagt, dass dieser Prüfer aus einer anderen Modellfamilie stammt. Wenn das einen anderen Anbieter bedeutet, sieht dieser Ihren Diff. Das ist eine Entscheidung zum Datenumgang, die jemand in Ihrem Team bewusst treffen sollte. Nach einer Antwort können Sie mit der Maus über das Effort-Label fahren, um zu sehen, welche Modelle gelaufen sind.
Auch der Abschnitt zu den Einschränkungen ist wichtig. Verwirft Fusion einen Entwurf, werden Dateiänderungen, die dieser Entwurf bereits vorgenommen hat, nicht automatisch rückgängig gemacht. Prüfen Sie den Diff also vor dem Commit. Außerdem hat Fusion kein eigenes Kontextfenster: Angezeigt wird der kleinste Wert unter seinen Modellen.
Wo wir es in einem Team-Test einsetzen würden
Wir würden Fusion Standard als Default für ein Copilot-Team einsetzen und Max nicht als Default setzen. Die 60 im unabhängigen Index sind respektabel, aber Max ist die Stufe, die die meisten Modelle aufruft und die meisten Credits verbraucht. Standard ist die Stufe, auf der die AT&T-Geschichte spielt und auf der das Routing am meisten spart. Für Teams, die schon Claude Code oder Codex nutzen, stellt sich die Lock-in-Frage andersherum: Diese Tools sind an die Modelle eines Anbieters gebunden, während Fusion ein Router ist, den GitHub kontrolliert und jederzeit umbauen kann. Keines von beiden ist frei von Abhängigkeit.
Unsere bestehenden Vergleiche behandeln die Tools selbst: Terminal-Coding-Agents, Cursor gegen Copilot und Windsurf, Modellstufen passend zu Aufgaben und die umfassendere Liste von Coding-Tools. Fusion ändert dort die Kostenspalte, nicht die Wahl des Tools. Für Cursor-Nutzer gibt es noch kein vergleichbares Urteil, und das ToolRank-Ranking der Coding-Assistenten zeigt, wie das Feld aktuell sortiert ist.
Der Test, der die Frage klärt, ist günstig. Nehmen Sie zehn echte Tickets, lassen Sie sie durch Fusion Standard und Ihr aktuelles Setup laufen und zählen Sie akzeptierte Änderungen und verbrauchte Credits. GitHubs Rabatt läuft später in diesem Jahr aus, messen Sie also vorher. Schauen Sie danach noch einmal in die Router-Models-Ansicht bei Artificial Analysis, denn die Router-Einträge dort dürften sich am ehesten bewegen.