

Für die meisten Entwickler läuft die Wahl 2026 auf Claude Code oder Codex hinaus, und auf dem härtesten öffentlichen Benchmark für Terminal-Arbeit liegen die beiden innerhalb der Fehlertoleranz gleichauf. Gemini CLI, der dritte Name in jedem Vergleich des letzten Jahres, ist für kostenlose und private Nutzer Geschichte: Google hat es Anfang des Jahres durch ein Closed-Source-Tool namens Antigravity CLI ersetzt.
Das verschiebt die Entscheidung. Die beiden Spitzenreiter wechseln sich Release für Release an der Spitze ab, die Modellqualität taugt als Tiebreaker also kaum. Entscheidend ist heute, was der Agent auf Ihrem Rechner tun darf, ohne zu fragen, wie Sie dafür bezahlen und ob ein Teamleiter beides steuern kann. Codex liefert die sichersten Standardeinstellungen und einen Open-Source-Client. Claude Code hat das tiefste Toolkit für Teams, die skripten und erweitern wollen. Die CLI von GitHub Copilot passt zu Organisationen, die ohnehin in GitHub zuhause sind und Modelle mehrerer Labs auf einer Rechnung wollen, und OpenCode ist die Wahl, wenn Sie Open Source und freie Modellwahl möchten.
Die Preise und Funktionen unten stammen aus Herstellerdokumentationen und Preisseiten, und bei jedem Benchmark-Wert nennen wir die Quelle.
Was sich bei Terminal-Agenten dieses Jahr geändert hat
Vier Entwicklungen zählen, wenn Sie sich diese Kategorie zuletzt vor einem Jahr angesehen haben.
Google hat Gemini CLI für die meisten Nutzer eingestellt. Auf der Google I/O wurde angekündigt, dass Gemini CLI keine Anfragen mehr von kostenlosen Nutzern sowie von Abonnenten von Google AI Pro und Ultra bedient; die IDE-Erweiterungen wurden am selben Tag abgeschaltet (Google Developers Blog). Der Nachfolger, Antigravity CLI, ist in Go geschrieben und läuft auf demselben Agenten-Backbone wie Googles neue Desktop-App Antigravity 2.0. Organisationen mit Gemini Code Assist Standard oder Enterprise sowie Entwickler, die über Gemini-API-Keys zahlen, behalten Gemini CLI.
GitHub hat Copilot CLI allgemein verfügbar gemacht und dann alle Copilot-Tarife auf nutzungsbasierte AI Credits umgestellt. Terminal-Sessions verbrauchen jetzt ein abgerechnetes Kontingent, bei dem ein Credit 0,01 $ wert ist (GitHub Docs).
Anthropic hat geändert, was beim Öffnen einer Session passiert. Ab Claude Code v2.1.283 starten interaktive Terminal-Sessions im Auto-Modus: Ein zweites Modell, das Anthropic Classifier nennt, prüft die Aktionen, statt Sie bei jeder einzelnen zu fragen (Claude Code docs).
OpenAI hat die Codex CLI diese Woche aufgefrischt: mit Sprachsteuerung, einer /agents-Ansicht zur Verfolgung paralleler Aufgaben und wiederverwendbaren Cloud-Umgebungen, die ein Team mit freigegebenen Einstellungen und Berechtigungen teilen kann (TechCrunch). Aider, der Open-Source-Veteran, hat dagegen seit einem kleinen Patch-Release Anfang des Jahres nichts mehr veröffentlicht, und das letzte Feature-Release stammt aus dem vergangenen Jahr (PyPI).
Die Schleife, die jeder Terminal-Agent durchläuft
Ohne das Branding machen all diese Tools denselben Job. Sie beschreiben eine Aufgabe in normaler Sprache. Der Agent liest die relevanten Dateien, entwirft einen Plan, bearbeitet so viele Dateien wie nötig, führt Build und Tests aus und wiederholt das bei Fehlern, bis er Ihnen einen Diff zeigen kann.
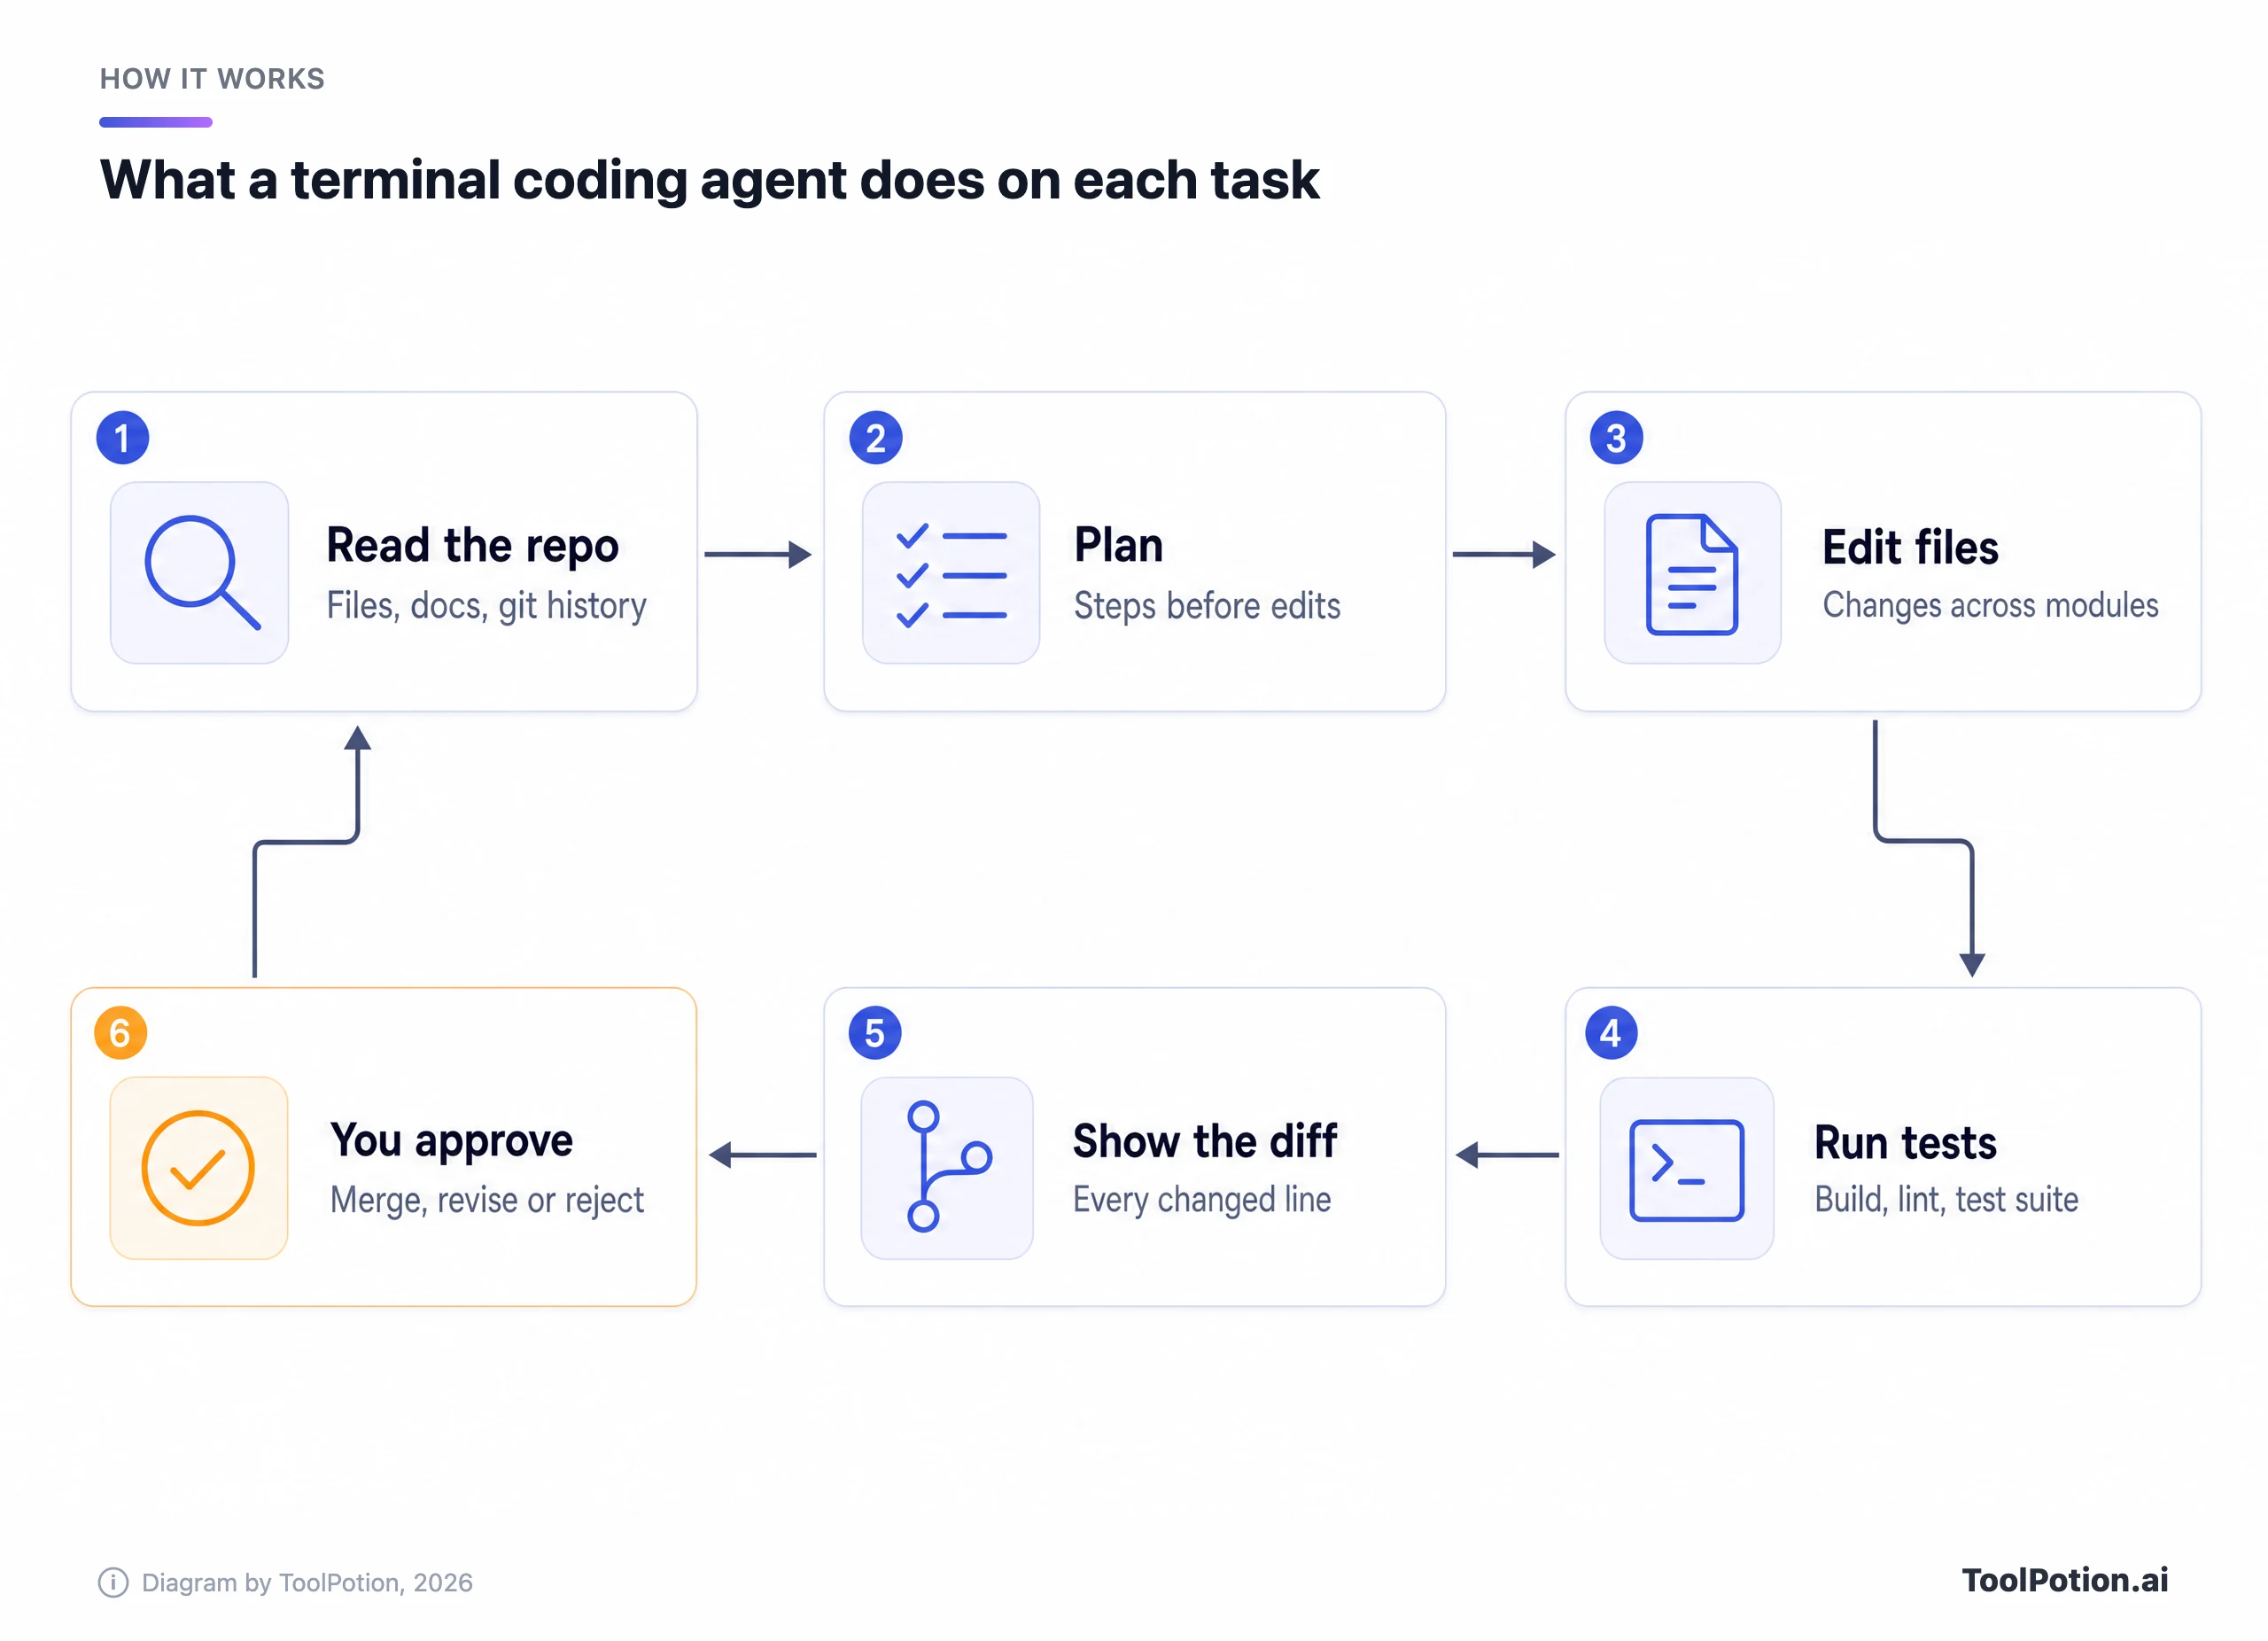
Um den hervorgehobenen Schritt sollten Sie Ihr Setup herum aufbauen, denn bei der Freigabe greifen Ihr Urteil und Ihre Sicherheitsrichtlinie. Die Tools unterscheiden sich an drei Stellen dieser Schleife: welche Modelle sie antreiben, was der Agent vor Ihrer Freigabe tun darf und wo er läuft (auf Ihrem Laptop, in einer OS-Sandbox oder in der Cloud des Anbieters). Die Modelle machen die Schlagzeilen, aber die anderen beiden Punkte entscheiden, ob ein ganzes Team das Tool nutzen kann.
Claude Code vs. Codex im direkten Vergleich
Diese beiden sind aus gutem Grund die Standardwahl. Beide laufen unter macOS, Linux und Windows, beide lesen eine AGENTS.md-Datei, beide unterstützen MCP-Server, Skills, Hooks, Plugins und Subagenten, beide können eine Aufgabe in die Cloud schieben, und beide gibt es mit einem Tarif für 20 $ im Monat. Die Unterschiede stecken im Detail.
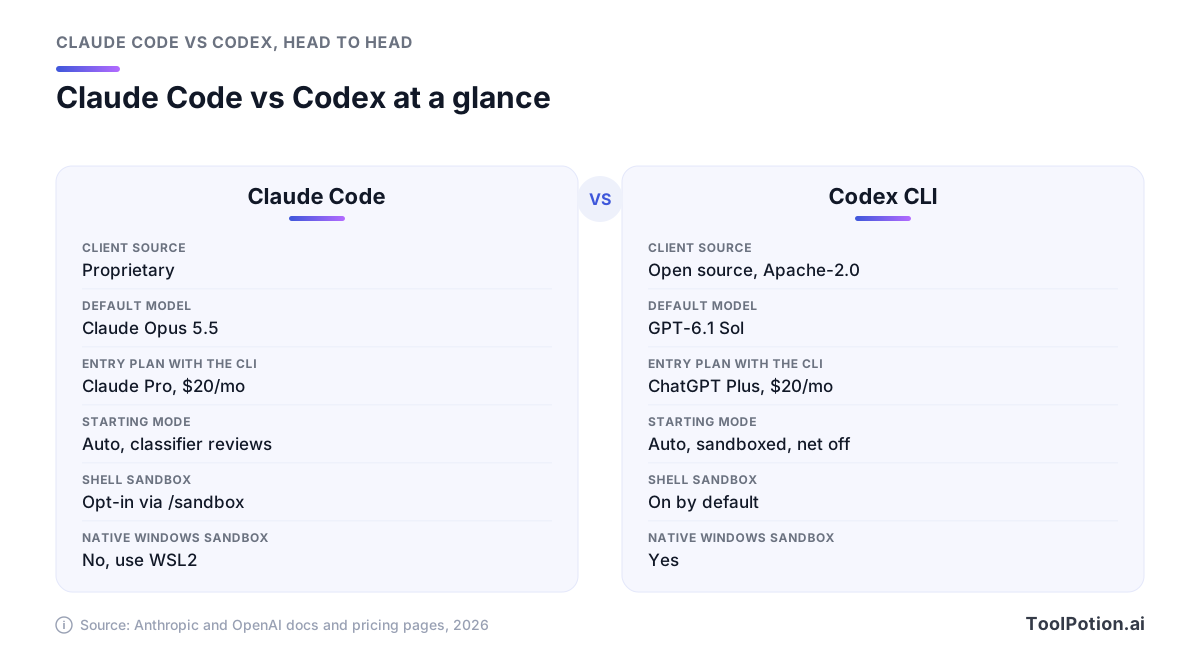
Zuerst die Modelle. Claude Code nutzt ausschließlich Modelle von Anthropic und verwendet in jedem Tarif standardmäßig Claude Opus 5.5, mit Sonnet 5.5 und Haiku als günstigeren Optionen und Fable 5.1, dem leistungsfähigsten Modell in Claude Code, als ausdrücklichem Opt-in, das einige Tarife über zusätzliche Nutzungs-Credits abrechnen. Codex verwendet standardmäßig GPT-6.1 Sol, das laut OpenAI bei agentischem Coding fast an das Flaggschiff GPT-6 Astra heranreicht, bei einem Fünftel des API-Preises. Der Codex-Client ist Open Source unter Apache-2.0 (das openai/codex-Repository ist in Rust geschrieben), während die Lizenz von Claude Code „alle Rechte vorbehalten" lautet.
Bei den Sicherheitsvorgaben liegt der schärfere Unterschied. In einem Git-Repository startet Codex in einem Preset namens Auto: Es kann im Workspace lesen, bearbeiten und Befehle ausführen, aber eine OS-Sandbox (Seatbelt unter macOS, bubblewrap plus seccomp unter Linux, eine native Sandbox unter Windows) blockiert Netzwerkzugriff und alles außerhalb des Projekts, bis Sie es freigeben (OpenAI docs). Außerhalb eines Git-Repos fällt es auf „read-only" zurück.
Claude Code geht den anderen Weg. Die Shell-Sandbox ist standardmäßig aus, die erste Verteidigungslinie sind der Auto-Modus-Classifier und Deny-Regeln, die in jedem Modus greifen. Wenn Sie die Sandbox einschalten, umschließt sie nur Shell-Befehle, und Befehle in der Sandbox können weiterhin große Teile des Rechners lesen, darunter ~/.ssh und ~/.aws/credentials, bis Sie Deny-Regeln ergänzen (Claude Code docs). Unter nativem Windows gibt es gar keine Sandbox, Anthropic verweist auf WSL2.
Bei der Tiefe gewinnt Claude Code. Plugins bündeln Skills, Subagenten, Hooks und MCP-Server und werden aus Marketplaces installiert, die Admins freigeben oder sperren können. Routines führen geplante Jobs in Anthropics Cloud aus, Integrationen für GitHub Actions und GitLab CI/CD übernehmen Review und Triage, und mit dem Agent SDK bauen Sie Agenten auf denselben Tools. Codex deckt das meiste davon mit weniger Aufwand ab (Hooks, Skills, Plugins, codex exec für Skripte, eine GitHub Action), und sein automatisches Code-Review deckt GitHub-Pull-Requests und GitLab-Merge-Requests ab.
Wo liegt jeweils die größte Schwäche? Claude Code bindet Sie an ein einziges Lab und verlässt sich, bis Sie eine Einstellung ändern, auf das Urteil eines Modells statt auf eine OS-Grenze, was manche Security-Teams nicht akzeptieren. Auch Codex bindet Sie an ein Lab, und das Flaggschiff ist im 20-$-Tarif stark rationiert: OpenAI schätzt 5 bis 45 lokale Nachrichten pro fünf Stunden mit GPT-6 Astra in Plus, gegenüber 15 bis 160 mit GPT-6.1 Sol (OpenAI pricing).
Antigravity CLI hat Gemini CLI für die meisten abgelöst
Wer heute nach Gemini CLI sucht, findet weiterhin das Apache-2.0-Repository, das immer noch Releases bekommt (v0.62.0 erschien diese Woche). In der Dokumentation steht jedoch ein Banner, das kostenlose Nutzer und Google-One-Nutzer darüber informiert, dass Gemini CLI ersetzt wurde. Weiter nutzen können es Organisationen mit Gemini Code Assist-Lizenzen vom Typ Standard oder Enterprise sowie Entwickler mit kostenpflichtigen API-Keys für Gemini oder die Gemini Enterprise Agent Platform.
Die CLI, die es innerhalb von Google Antigravity ersetzt hat, ist ein Produkt anderer Art. Sie ist Closed Source, und laut Tech Times enthält ihr öffentliches Repository überhaupt keinen Quellcode – ein wunder Punkt für ein Projekt, das nach Googles eigener Zählung 6.000 Pull Requests gemergt hat. Google räumt ein, dass es noch keine 1:1-Feature-Parität gibt, auch wenn Skills, Hooks, Subagenten und Erweiterungen (jetzt Plugins genannt) den Umzug geschafft haben.
Es gibt auch echte Vorteile. Das Modellmenü von Antigravity führt Gemini 3.8 Flash und Gemini 3.1 Pro neben Claude Sonnet 5.5, Claude Opus 5.5 und dem Open-Weight-Modell GPT-OSS-120b auf, sodass Sie mit einem Google-Abo Modelle zweier Labs erreichen, wobei die Verfügbarkeit je nach Tarif variiert. Das Standard-Preset unter macOS und Linux ist zudem auf dem Papier mindestens so streng wie das von Codex: Terminal-Befehle laufen in einer Sandbox ohne Netzwerk, der Dateizugriff endet an Workspace- und Temp-Ordnern, ~/.ssh und .env-Dateien sind gesperrt, und bei MCP- und Web-Aktionen wird zuerst gefragt (Antigravity docs). Unter Windows ist diese Sandbox standardmäßig aus.
Der Haken ist das Kontingent. Der kostenlose Individual-Tarif nennt grundlegende wöchentliche Rate Limits, weit entfernt von den 1.000 kostenlosen Anfragen pro Tag, die Gemini CLI privaten Konten früher gab. Mehr Kapazität gibt es mit den Tarifen Google AI Pro und Ultra, und Google hat diese Stufen beim Antigravity-Start neu sortiert – lesen Sie die aktuellen Limits daher auf Googles eigener Tarifseite, bevor Sie sich festlegen. Wählen Sie Antigravity CLI, wenn Sie in der Google Cloud zuhause sind, Claude-Modelle ohne separaten Anthropic-Vertrag wollen oder strenge Sandbox-Standards direkt ab Werk schätzen. Lassen Sie es aus, wenn Ihnen ein Open-Source-Client wichtig ist.
Copilot CLI, Cursor, OpenCode und der Rest
Copilot CLI ist die am meisten unterschätzte Option für Unternehmen. Sie nutzt Modelle von Anthropic, OpenAI und Google auf einer Rechnung und bringt modernes Rüstzeug mit: einen Plan-Modus, einen Autopilot-Modus, eingebaute Agenten zum Erkunden und Reviewen von Code, MCP, Plugins, Skills, Hooks und ein &-Präfix, das eine Aufgabe an GitHubs Cloud-Coding-Agenten übergibt (GitHub Changelog). Jeder Tarif enthält sie: Free, Pro für 10 $ im Monat, Pro+ für 39 $ und Max für 100 $, dazu Business für 19 $ und Enterprise für 39 $ pro Seat (GitHub Docs).
Die Schwachstelle sind die Berechtigungen. Copilot bittet Sie, einem Ordner zu vertrauen, und genehmigt Tools dann einzeln oder für die ganze Session. GitHubs eigene Doku warnt, dass das Freigeben von rm für eine Session das Löschen jeder Datei in diesem Verzeichnisbaum ohne Rückfrage erlaubt. Die lokale Sandbox ist nur per /sandbox enable aktivierbar, und ein --yolo-Flag schaltet sämtliche Prüfungen ab.
So stehen die vier größten Namen bei Merkmalen da, die Sie in Dokumentation und Lizenzen prüfen können statt im Marketing.
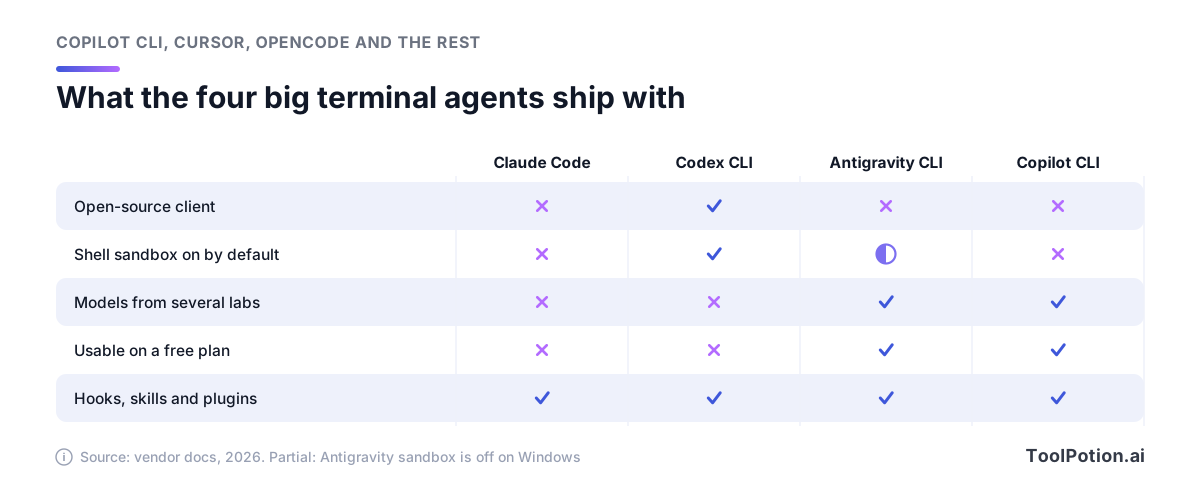
Nur Codex kombiniert einen Open-Source-Client mit einer Sandbox, die überall standardmäßig aktiv ist. Antigravity und Copilot sind die beiden, die Modelle verschiedener Labs ohne zusätzlichen Aufwand mischen. Bei der Erweiterbarkeit haben sich alle angenähert: Alle vier unterstützen Hooks, Skills und Plugins.
Cursor bringt seinen Editor-Agenten ins Terminal, mit Agent-, Plan- und Ask-Modus, einem Print-Modus für Skripte und CI und derselben &-Übergabe an einen Cloud-Agenten. Es ist die naheliegende Ergänzung, wenn Ihr Team ohnehin für Cursor zahlt (Individual ab 20 $ im Monat, Teams für 40 $ pro Nutzer), und ein schwieriger Verkauf, wenn nicht.
OpenCode ist der Open-Source-Primus: MIT-lizenziert, über 211.000 GitHub-Sterne und an mehr als 75 Modellanbieter angebunden, darunter lokale Modelle. Sie können sich mit einem GitHub-Copilot- oder ChatGPT-Plus- bzw. -Pro-Konto anmelden, statt doppelt zu zahlen. Achten Sie aber auf die Standardeinstellungen. OpenCode lässt den Agenten Dateien bearbeiten und Shell-Befehle ausführen, ohne zu fragen, solange Sie keine Regeln schreiben, es hat keine OS-Sandbox, und seine eingebauten Schutzmechanismen decken nur .env-Dateien, Pfade außerhalb des Projekts und einen Agenten ab, der sich in Wiederholungen verfängt (OpenCode docs).
Drei weitere verdienen je eine Zeile. Amp reicht Modellkosten für Einzelnutzer zu Anbieterpreisen ohne Aufschlag durch, mischt unter der Haube GPT-5.6 und Claude Fable 5.1 und hat einen kostenlosen Tarif sowie einen für 20 $. Warp ist jetzt ein AGPL-lizenziertes agentisches Terminal mit eigenem Agenten, preislich von kostenlos über Build für 20 $ bis Max für 200 $, und laut eigener Aussage funktioniert es mit jedem MCP-fähigen Coding-Agenten. Aider hat weiterhin die sauberste Git-Integration und committet jede Änderung mit einer Nachricht, die Sie per Diff ansehen und rückgängig machen können, aber das Release-Tempo ist ins Stocken geraten – prüfen Sie also, ob es das gewünschte Modell unterstützt, bevor Sie sich darauf festlegen. Für das weitere Feld verfolgen unser Board der KI-Coding-Assistenten und unser Board der KI-Agenten die Platzierungen laufend.
Benchmarks sehen Claude Code und Codex im Kopf-an-Kopf-Rennen
Der nützlichste öffentliche Maßstab für diese Kategorie ist Terminal-Bench, betrieben von Stanford, Harbor und dem Laude Institute, der Paare aus Agent und Modell bei schweren Aufgaben in einem echten Terminal bewertet. In der aktuellen 4.0-Rangliste führt Codex mit GPT-6 Astra bei maximalem Reasoning-Aufwand mit 58,2 %, und Claude Code mit Fable 5.1 bei maximalem Aufwand liegt bei 57,9 % (Terminal-Bench). Jeder Eintrag umfasst 330 Durchläufe mit einem Konfidenzintervall von grob drei Punkten in beide Richtungen – das ist also ein Unentschieden.
Die größere Geschichte ist der Aufwandsregler. Vergleichen Sie jedes Paar bei der niedrigsten und der höchsten Reasoning-Einstellung.
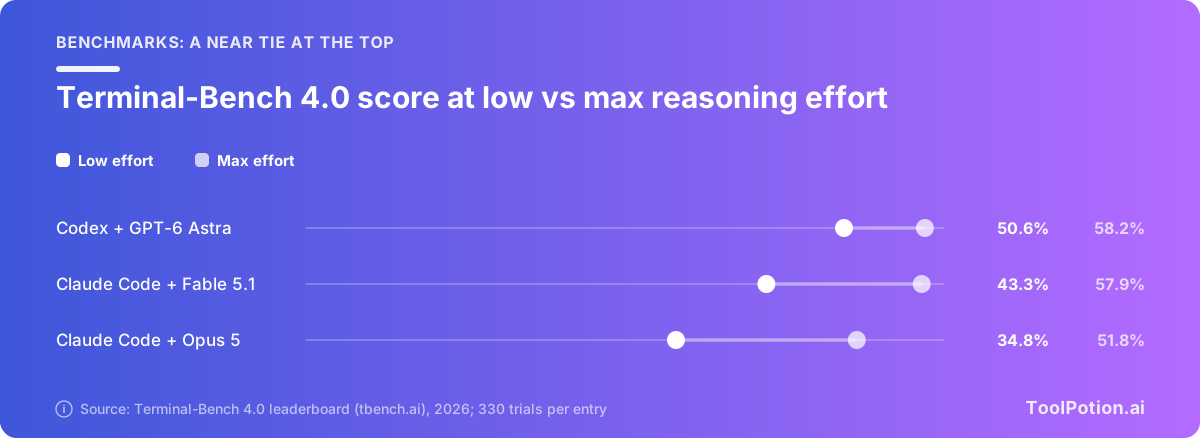
Der Wechsel von maximalem auf niedrigen Aufwand kostet Codex mit Astra weniger als 8 Punkte und Claude Code mit Fable 5.1 fast 15. Claude Code mit dem älteren Opus 5 verliert 17. Die Einstellung, die Sie auf dem Standardwert lassen, kann genauso viel ausmachen wie die Marke auf der Packung.
Die Kosten erzählen eine zweite Geschichte. Die Rangliste protokolliert, was jeder Durchlauf verbraucht hat: 3.267 $ für Codex mit Astra bei maximalem Aufwand gegenüber 6.244 $ für Claude Code mit Fable 5.1, grob 9,90 $ gegenüber 18,90 $ pro Aufgabe bei gleichem Ergebnis. Das sind API-Preise für lange, schwere Aufgaben, nicht das, was ein Abonnent zahlt. Kein Google-Agent taucht überhaupt in der Rangliste auf; der beste Eintrag mit einem Gemini-Modell ist ein Drittanbieter-Agent mit Gemini 3.8 Flash bei 19,1 %. Herstellerbehauptungen, etwa Anthropics Aussage, Sonnet 5.5 schlage Opus 5.5 beim agentischen Coding, stammen aus den eigenen Tests der Hersteller.
Berechtigungsmodi: von Read-only bis Vollautomatik
Jedes Tool bietet inzwischen dieselbe Autonomie-Leiter unter anderen Namen. Welche Stufe Sie wählen, entscheidet darüber, wie oft Sie unterbrochen werden und wie viel Schaden eine schlechte Anweisung (oder eine in einer README versteckte Prompt Injection) anrichten kann.
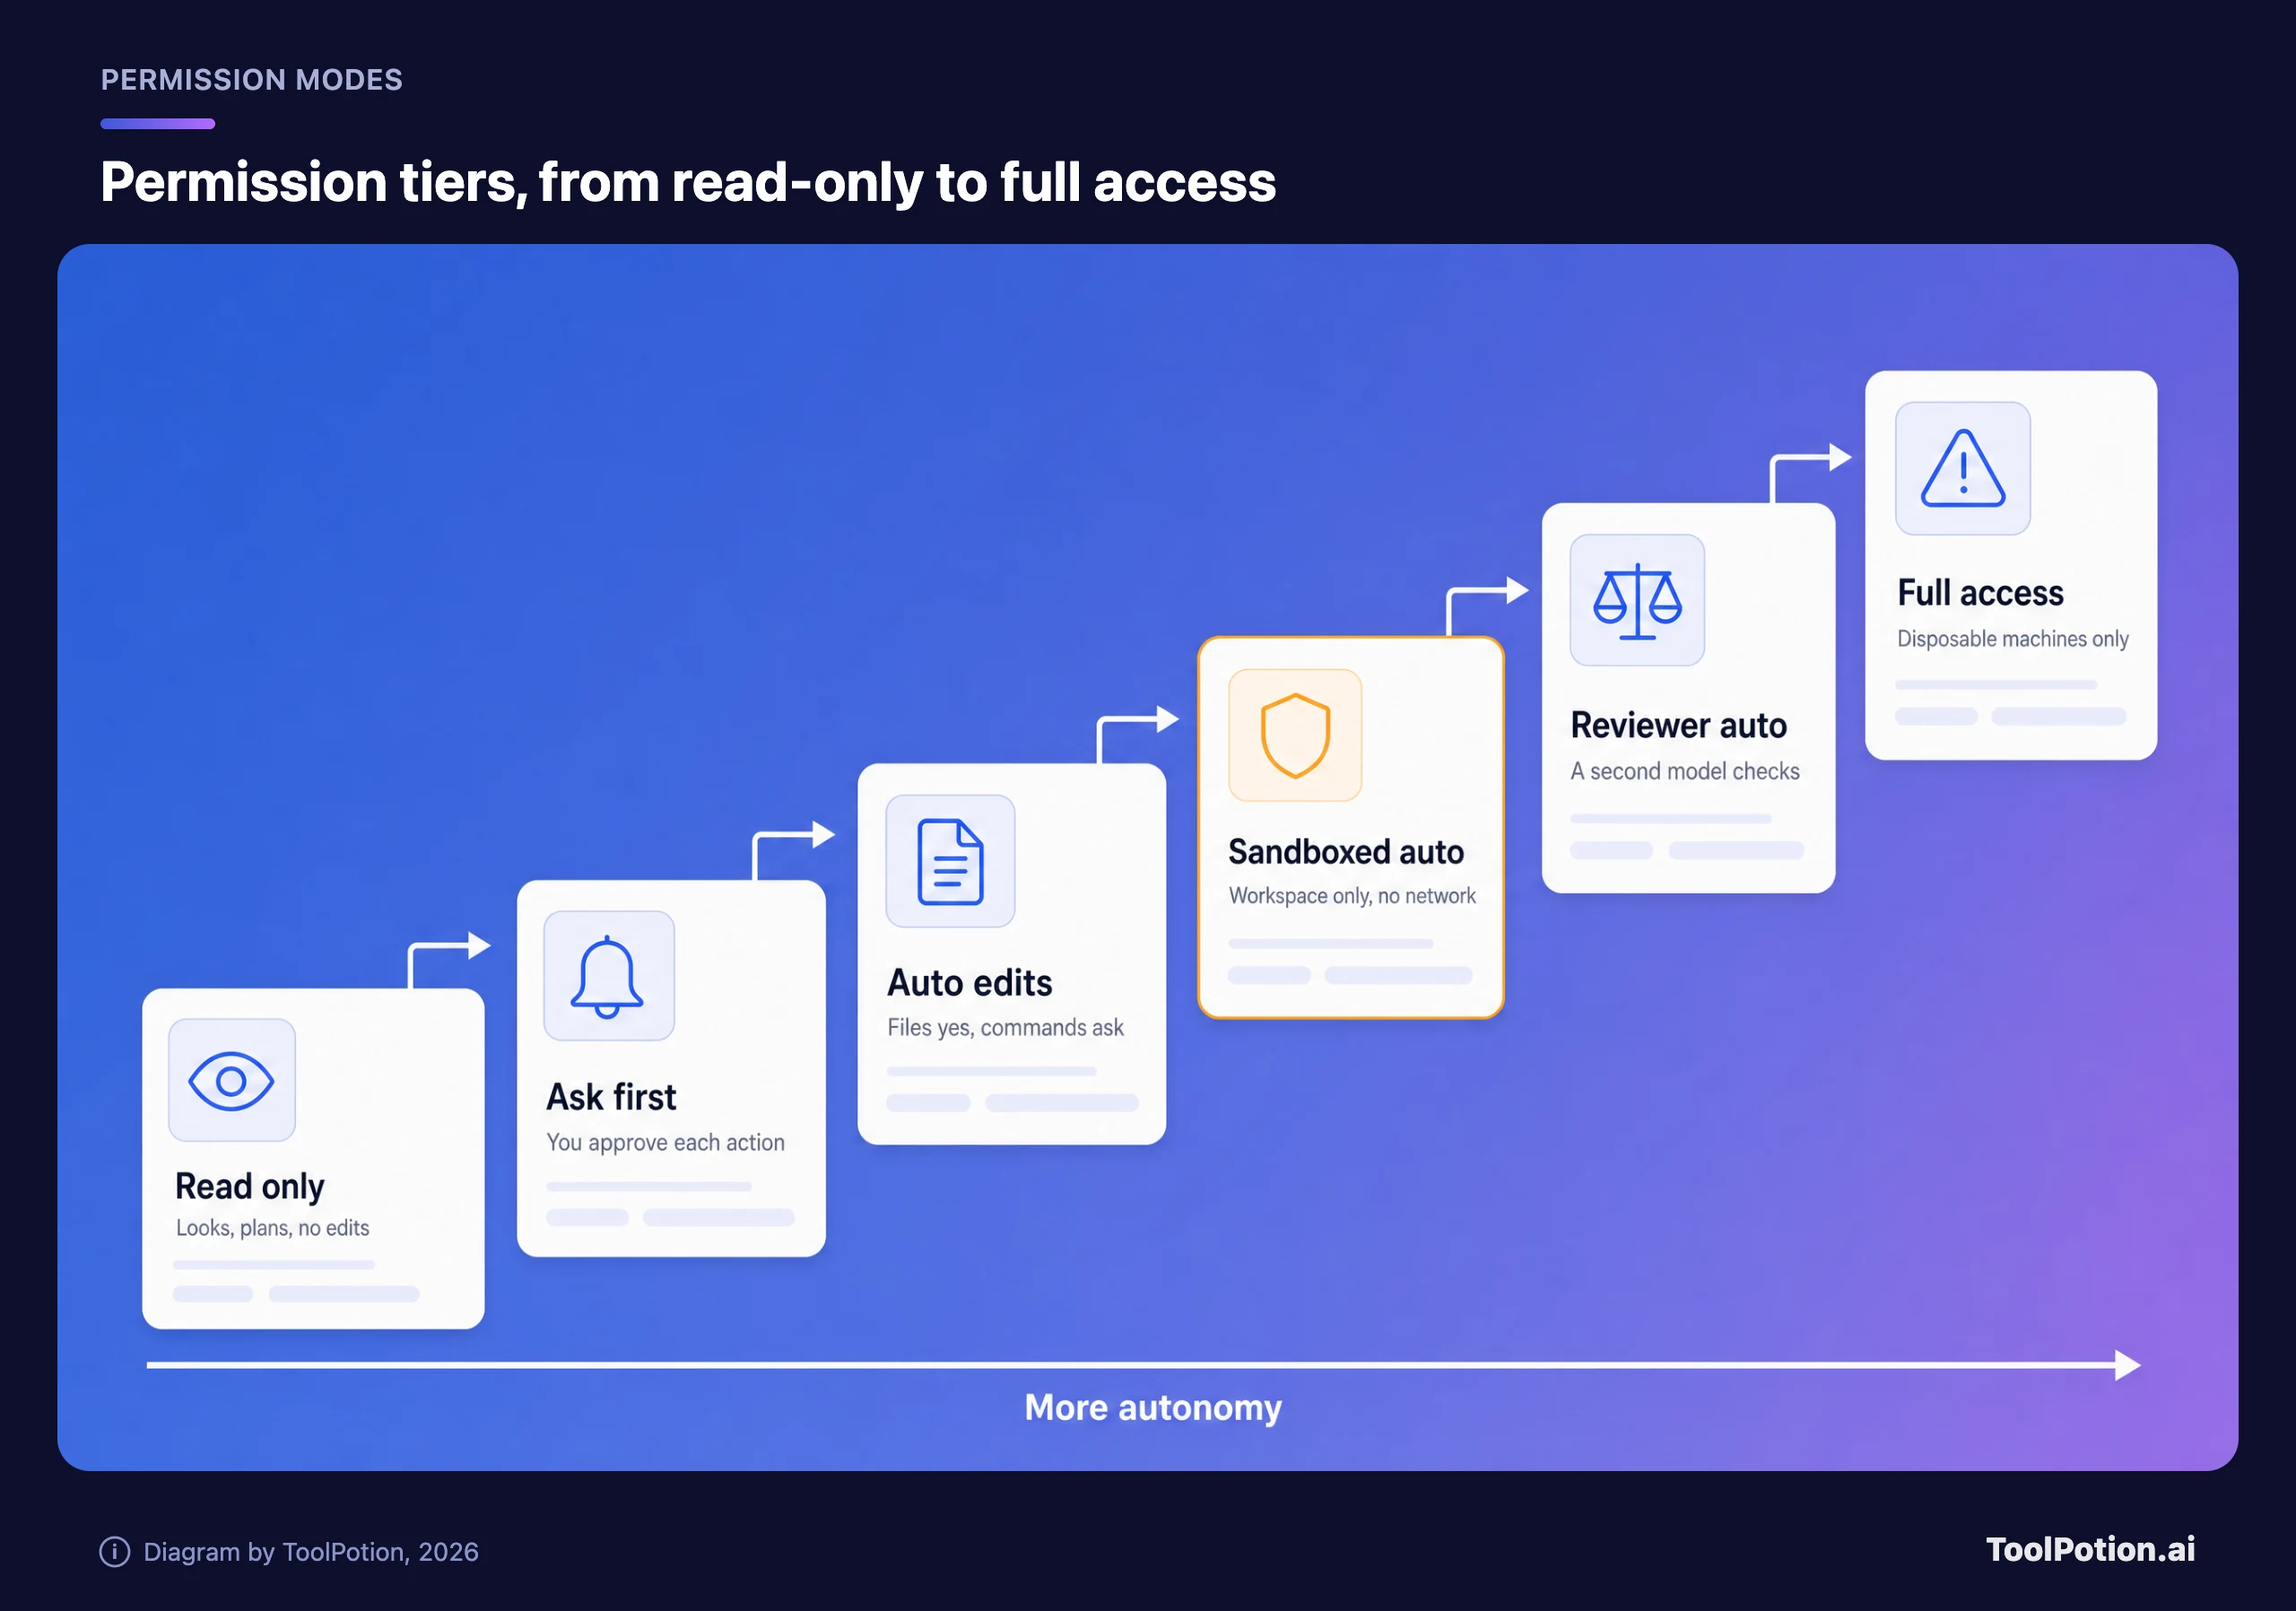
Sandboxed Auto ist der richtige Alltagsstandard. Der Agent bearbeitet Dateien und führt Befehle im Projekt frei aus, ohne Netzwerk und ohne Zugriff auf Ihr Home-Verzeichnis. Reviewer Auto reduziert die Rückfragen weiter, vertraut aber dem Urteil eines Modells. Vollzugriff gehört in Wegwerf-Container und VMs, und genau das sagt Anthropics Doku auch zu bypassPermissions. So heißt jede Stufe in den vier wichtigsten Tools.
| Stufe | Claude Code | Codex CLI | Antigravity CLI | Copilot CLI |
|---|---|---|---|---|
| Read-only | plan | read-only | Plan-Modus | Plan-Modus |
| Erst fragen | default (Manual) | Granulare Freigaben | Request Review | Abfrage pro Tool |
| Automatische Edits | acceptEdits | Keine | Accept-Edits | Tool für Session freigeben |
| Sandboxed Auto | /sandbox auto-allow | Auto (Standard in Git-Repos) | Standard-Preset | /sandbox enable |
| Reviewer Auto | auto (Standard) | Auto-review (Opt-in) | Keine | Keine |
| Vollzugriff | bypassPermissions | danger-full-access | Turbo | --yolo |
Zwei Standardeinstellungen fallen auf. Codex und Antigravity starten Sie in einer Sandbox, Claude Code und Copilot dagegen in Modi, die auf Rückfragen oder die Prüfung durch ein Modell setzen. Wenn Sie Claude Code nutzen, ist das Einschalten der Sandbox die nützlichste einzelne Einstellungsänderung.
Abo oder API-Key: Was Sie zahlen
Jeder Anbieter bietet zwei Zugänge. Ein monatlicher Flatrate-Tarif deckelt Ihre Rechnung, begrenzt Sie aber mit Fünf-Stunden- und Wochenlimits, die die Anbieter als Vielfache und nicht als Token-Zahlen angeben. Ein API-Key rechnet jedes Token zum Listenpreis ab, ohne Obergrenze.
| Agent | Einstiegstarif | Größere Stufen | Teams |
|---|---|---|---|
| Claude Code | Claude Pro, 20 $/Monat (17 $ bei jährlicher Zahlung) | Max 5x 100 $, Max 20x 200 $ | Team-Seats 25 $ oder 125 $/Monat; Enterprise 20 $ pro Seat plus Nutzung zu API-Preisen |
| Codex | ChatGPT Plus, 20 $/Monat (die CLI ist nicht in Free oder Go enthalten) | Pro für 100 $, 200 $ oder 500 $ | Business 20 $/Nutzer (jährlich) |
| Copilot CLI | Pro 10 $/Monat (Free hat ein kleines Kontingent) | Pro+ 39 $, Max 100 $ | Business 19 $, Enterprise 39 $ pro Seat |
| Antigravity CLI | Kostenloser Individual-Tarif | Google AI Pro und Ultra | Business ab 30 $/Seat über Google Cloud |
| Cursor CLI | Individual 20 $/Monat | Höhere Individual-Stufen | Teams 40 $/Nutzer |
Die Preise stammen von den Preisseiten der Anbieter, darunter die von Anthropic. Wenn Sie bei der Tarifrechnung ins Straucheln geraten, erklärt unser Leitfaden zu KI-Tool-Preismodellen Credits, Seats und Tokens.
Die API-Variante ist für Vielnutzer und CI am wichtigsten. Anthropic berechnet für Opus 5.5 4 $ pro Million Input-Token und 20 $ pro Million Output-Token, für Sonnet 5.5 2 $ und 10 $. OpenAI berechnet für GPT-6.1 Sol 2 $ und 10 $ und für GPT-6 Astra 10 $ und 50 $ (OpenAI pricing). Caching verändert die Rechnung stärker als die Listenpreise, weil Agenten-Schleifen ständig denselben Kontext erneut senden. Im oben genannten Terminal-Bench-Lauf waren etwa 96 % der Input-Token von Codex Cache-Reads, die OpenAI mit einem Zehntel von Astras Input-Preis berechnet.
Tragen Sie unten Ihre eigenen Zahlen ein. Die Vorgaben übernehmen den Token-Mix einer dieser Benchmark-Aufgaben (rund 10 $ pro Aufgabe mit Astra). Benchmark-Läufe sind lang und schwer, ersetzen Sie sie daher durch Werte aus Ihrem eigenen Nutzungs-Dashboard, bevor Sie darauf ein Budget stützen.
Mit den Vorgaben würde ein Entwickler, der 40 dieser Aufgaben im Monat mit Opus 5.5 ausführt, über einen API-Key etwa 126 $ zahlen. Claude Pro und Max 5x wären also beide günstiger, sofern ihre Limits reichen. Stellen Sie das Modell auf GPT-6 Astra um, kostet dieselbe Arbeitslast etwa 401 $. Diese Lücke ist der Grund, warum Codex-Nutzer das Flaggschiff den Problemen vorbehalten sollten, die es brauchen, und den Rest GPT-6.1 Sol überlassen.
So wählen Sie aus und rollen sicher aus
Gehen Sie davon aus, wo Ihr Code und Ihre Verträge ohnehin liegen, und lassen Sie dann die Sicherheitsvorgaben den Ausschlag geben.
- Wenn Ihr Team ohnehin für ChatGPT zahlt oder Sie einen Open-Source-Client mit standardmäßig aktiver Sandbox wollen, starten Sie mit Codex.
- Wenn Sie die tiefste Anpassbarkeit wollen und mit Claude-Modellen zufrieden sind, nehmen Sie Claude Code und schalten Sie als Erstes die Sandbox ein.
- Wenn Ihre Organisation auf GitHub läuft und Claude-, GPT- und Gemini-Modelle unter einem Budget mit Limits pro Nutzer will, ist Copilot CLI die reibungsärmste Lösung.
- Google-Cloud-Shops sollten Antigravity CLI ausprobieren.
- Wählen Sie OpenCode, wenn Sie durchgängig Open Source oder lokale Modelle brauchen, und nehmen Sie in Kauf, dass Sie die Leitplanken selbst schreiben.
Noch unentschieden? Gewichten Sie unten, was Ihnen wichtig ist. Die Werte sind unsere redaktionelle Einschätzung der Dokumentation und Preise der Anbieter, keine Testergebnisse.
Wenn Sie Sicherheit am höchsten gewichten, führt Codex und Copilot CLI liegt auf Platz zwei. Setzen Sie Team-Administration und Ausgabenlimits an die Spitze, zieht Copilot vorbei, und wer Modellauswahl und Open Source maximiert, landet bei OpenCode auf Platz eins. Claude Code rückt vor, sobald Erweiterbarkeit mehr zählt als sichere Standardeinstellungen.
Ein sicherer Team-Rollout
- Starten Sie mit einem Pilotprojekt: ein Agent, eine Handvoll Entwickler, ein Repository, damit Sie Ergebnisse statt Tools vergleichen.
- Legen Sie den Berechtigungsstandard zentral fest. In Claude Code heißt das Managed Settings mit eingeschalteter Sandbox und Deny-Regeln für Pushes und Deployments; Admins können den Auto-Modus für die ganze Organisation abschalten. In Codex belassen Sie workspace-write ohne Netzwerk und reservieren danger-full-access für Wegwerf-CI-Läufe.
- Halten Sie Secrets außer Reichweite. Lassen Sie Agenten nicht in Shells laufen, die Produktionszugangsdaten halten, verbieten Sie das Lesen von ~/.ssh, Cloud-Credential-Dateien und .env, und denken Sie daran, dass die Hooks und lokalen MCP-Server von Claude Code außerhalb der Sandbox mit Ihrem vollen Zugriff laufen.
- Prüfen Sie Agenten-Diffs wie den Pull Request eines neuen Kollegen. Agenten können Branches und PRs öffnen, aber ein Mensch mergt. Ein automatischer Reviewer wie Claude Code Security Review oder das Code-Review von Codex ist eine zweite Kontrolle, nie ein Ersatz.
- Deckeln Sie die Ausgaben, bevor Sie skalieren. Copilot unterstützt Budgets pro Nutzer und Kostenstelle, und zusätzliche Nutzung ist standardmäßig aktiv – begrenzen Sie sie also oder schalten Sie sie ab. Anthropics Enterprise-Tarif rechnet Nutzung zu API-Preisen zusätzlich zum Seat ab, und die Business-Tarife von Antigravity bieten Ausgabenlimits für API- und Abo-Nutzung.
- Prüfen Sie Plugins und MCP-Server wie Abhängigkeiten. Laut Anthropics Doku führt ein installiertes Plugin Code mit Ihren Benutzerrechten aus. Geben Sie daher Marketplaces per Allowlist frei, statt jeden eigene hinzufügen zu lassen.
- Geben Sie CI eine exakte Allowlist. Der dontAsk-Modus von Claude Code mit benannten Tools oder Codex in einer Read-only- oder Workspace-write-Sandbox hält unbeaufsichtigte Läufe berechenbar.
Teams, die bereits in anderen Unternehmensbereichen Agenten betreiben, werden das meiste davon aus unserem Beitrag zu KI-Agenten in der Produktion wiedererkennen. Einen breiteren Blick auf Editor-zentrierte Tools bietet unsere Übersicht der KI-Coding-Assistenten.
Häufig gestellte Fragen
Ist Gemini CLI noch verfügbar?
Ja, für Organisationen mit Gemini Code Assist Standard oder Enterprise und für Entwickler mit kostenpflichtigen Gemini-API-Keys. Nutzer von Free, Google AI Pro und Ultra wurden auf Antigravity CLI umgestellt. Der Apache-2.0-Code bleibt auf GitHub, sodass ihn weiterhin jeder forken kann.
Kann ich Claude Code mit einem ChatGPT-Abo nutzen oder Codex mit einem Claude-Tarif?
Nein. Jeder Tarif deckt nur den Agenten des eigenen Anbieters ab. Wenn Sie einen Client für mehrere Anbieter wollen: OpenCode meldet sich mit ChatGPT Plus oder Pro und GitHub-Copilot-Konten an, während Copilot CLI und Antigravity CLI Modelle mehrerer Labs in einem Abo bündeln.
Welcher Terminal-Agent ist für Einzelentwickler am günstigsten?
Copilot Pro für 10 $ im Monat ist der günstigste kostenpflichtige Einstieg. ChatGPT Go für 8 $ enthält die Codex CLI nicht, die erst mit Plus beginnt. Copilot Free und Antigravitys kostenloser Tarif kosten nichts, haben aber kleine Kontingente. Bei intensiverer Nutzung vergleichen Sie Claude Pro und ChatGPT Plus für 20 $ mit Ihrer erwarteten API-Rechnung.
Brauche ich eine Sandbox, wenn ich jeden Diff prüfe?
Ja. Die Diff-Prüfung fängt schlechten Code ab, aber erst, nachdem der Agent bereits Befehle ausgeführt hat. Eine Sandbox begrenzt, was diese Befehle während der Ausführung berühren können, einschließlich Netzwerkaufrufen, die ein Secret an eine Stelle schicken könnten, wohin es nicht gehört.
Ist Terminal-Bench eine verlässliche Entscheidungsgrundlage?
Es ist der beste öffentliche Maßstab für Terminal-Arbeit, misst aber Paare aus Agent und Modell bei festen Aufwandseinstellungen und schweren Aufgaben. Abstände von wenigen Punkten liegen innerhalb der Konfidenzintervalle, behandeln Sie sie also als Unentschieden und führen Sie einen kurzen Pilotlauf auf Ihren eigenen Repositories durch.