

Die Suche verwandelt sich von einer Linkliste in eine einzige Antwort, und die Plattformen zwischen Ihnen und Ihrem Publikum verändern die Spielregeln: Wer bezahlt wird und wer Besuche bekommt, wird neu verteilt. Die nachhaltige Antwort darauf ist unspektakulär und wirksam: Bauen Sie einen Kanal auf, über den Leser Sie ohne fremden Algorithmus finden. Entscheiden Sie bewusst, welche KI-Crawler Ihre Arbeit nutzen dürfen. Und veröffentlichen Sie Seiten, die eine Antwort-Engine sauber zitieren kann.
Das Thema ist gerade jetzt relevant, weil sich 2026 die Meldungen innerhalb weniger Tage häuften. Google bezahlt einige Publisher für KI-Beiträge, Reddit schließt seine offenen Feeds, und Instagram, YouTube und Spotify geben Creatorn und Hörern KI-Steuerung darüber, was sichtbar wird. Dieser Leitfaden macht aus diesen Nachrichten einen Plan, den Sie noch diese Woche umsetzen können, egal ob Sie einen Newsletter, einen Kanal, einen Shop-Blog oder einen Podcast betreiben.
Es ist ein praktischer Playbook, keine Prognose. Wo eine Zahl aus einem Bericht stammt, nennen wir die Quelle. Wo Google, OpenAI oder Perplexity eine Steuerungsmöglichkeit dokumentiert, verlinken wir die Dokumentation. Für die SEO-Software lohnt ein Blick in unsere Übersicht der besten KI-SEO-Tools. Dieser Beitrag behandelt die Strategie, der diese Tools dienen.
Früher endete die Suche auf Ihrer Website
In der klassischen Suche tippte jemand eine Anfrage ein, überflog zehn Links und klickte einen an. Der Klick war das Produkt. Ihre Analytics, Ihre Werbeplätze, Ihr E-Mail-Anmeldefeld: Alles lag auf der anderen Seite dieses Klicks.
Eine KI-Antwort verändert die Mitte dieses Wegs. Der Leser bekommt eine zusammengefasste Antwort mit einigen zitierten Quellen, und der Klick wird optional. Manche klicken trotzdem weiter, und laut Google zählen Seiten, die in AI Overviews und AI Mode als unterstützende Links angezeigt werden, zu Ihrem normalen Web-Traffic in der Search Console. Aber wer klickt, hat oft schon das Wesentliche gelesen. Die Besuche sind also weniger, dafür aber mit konkreterer Absicht.
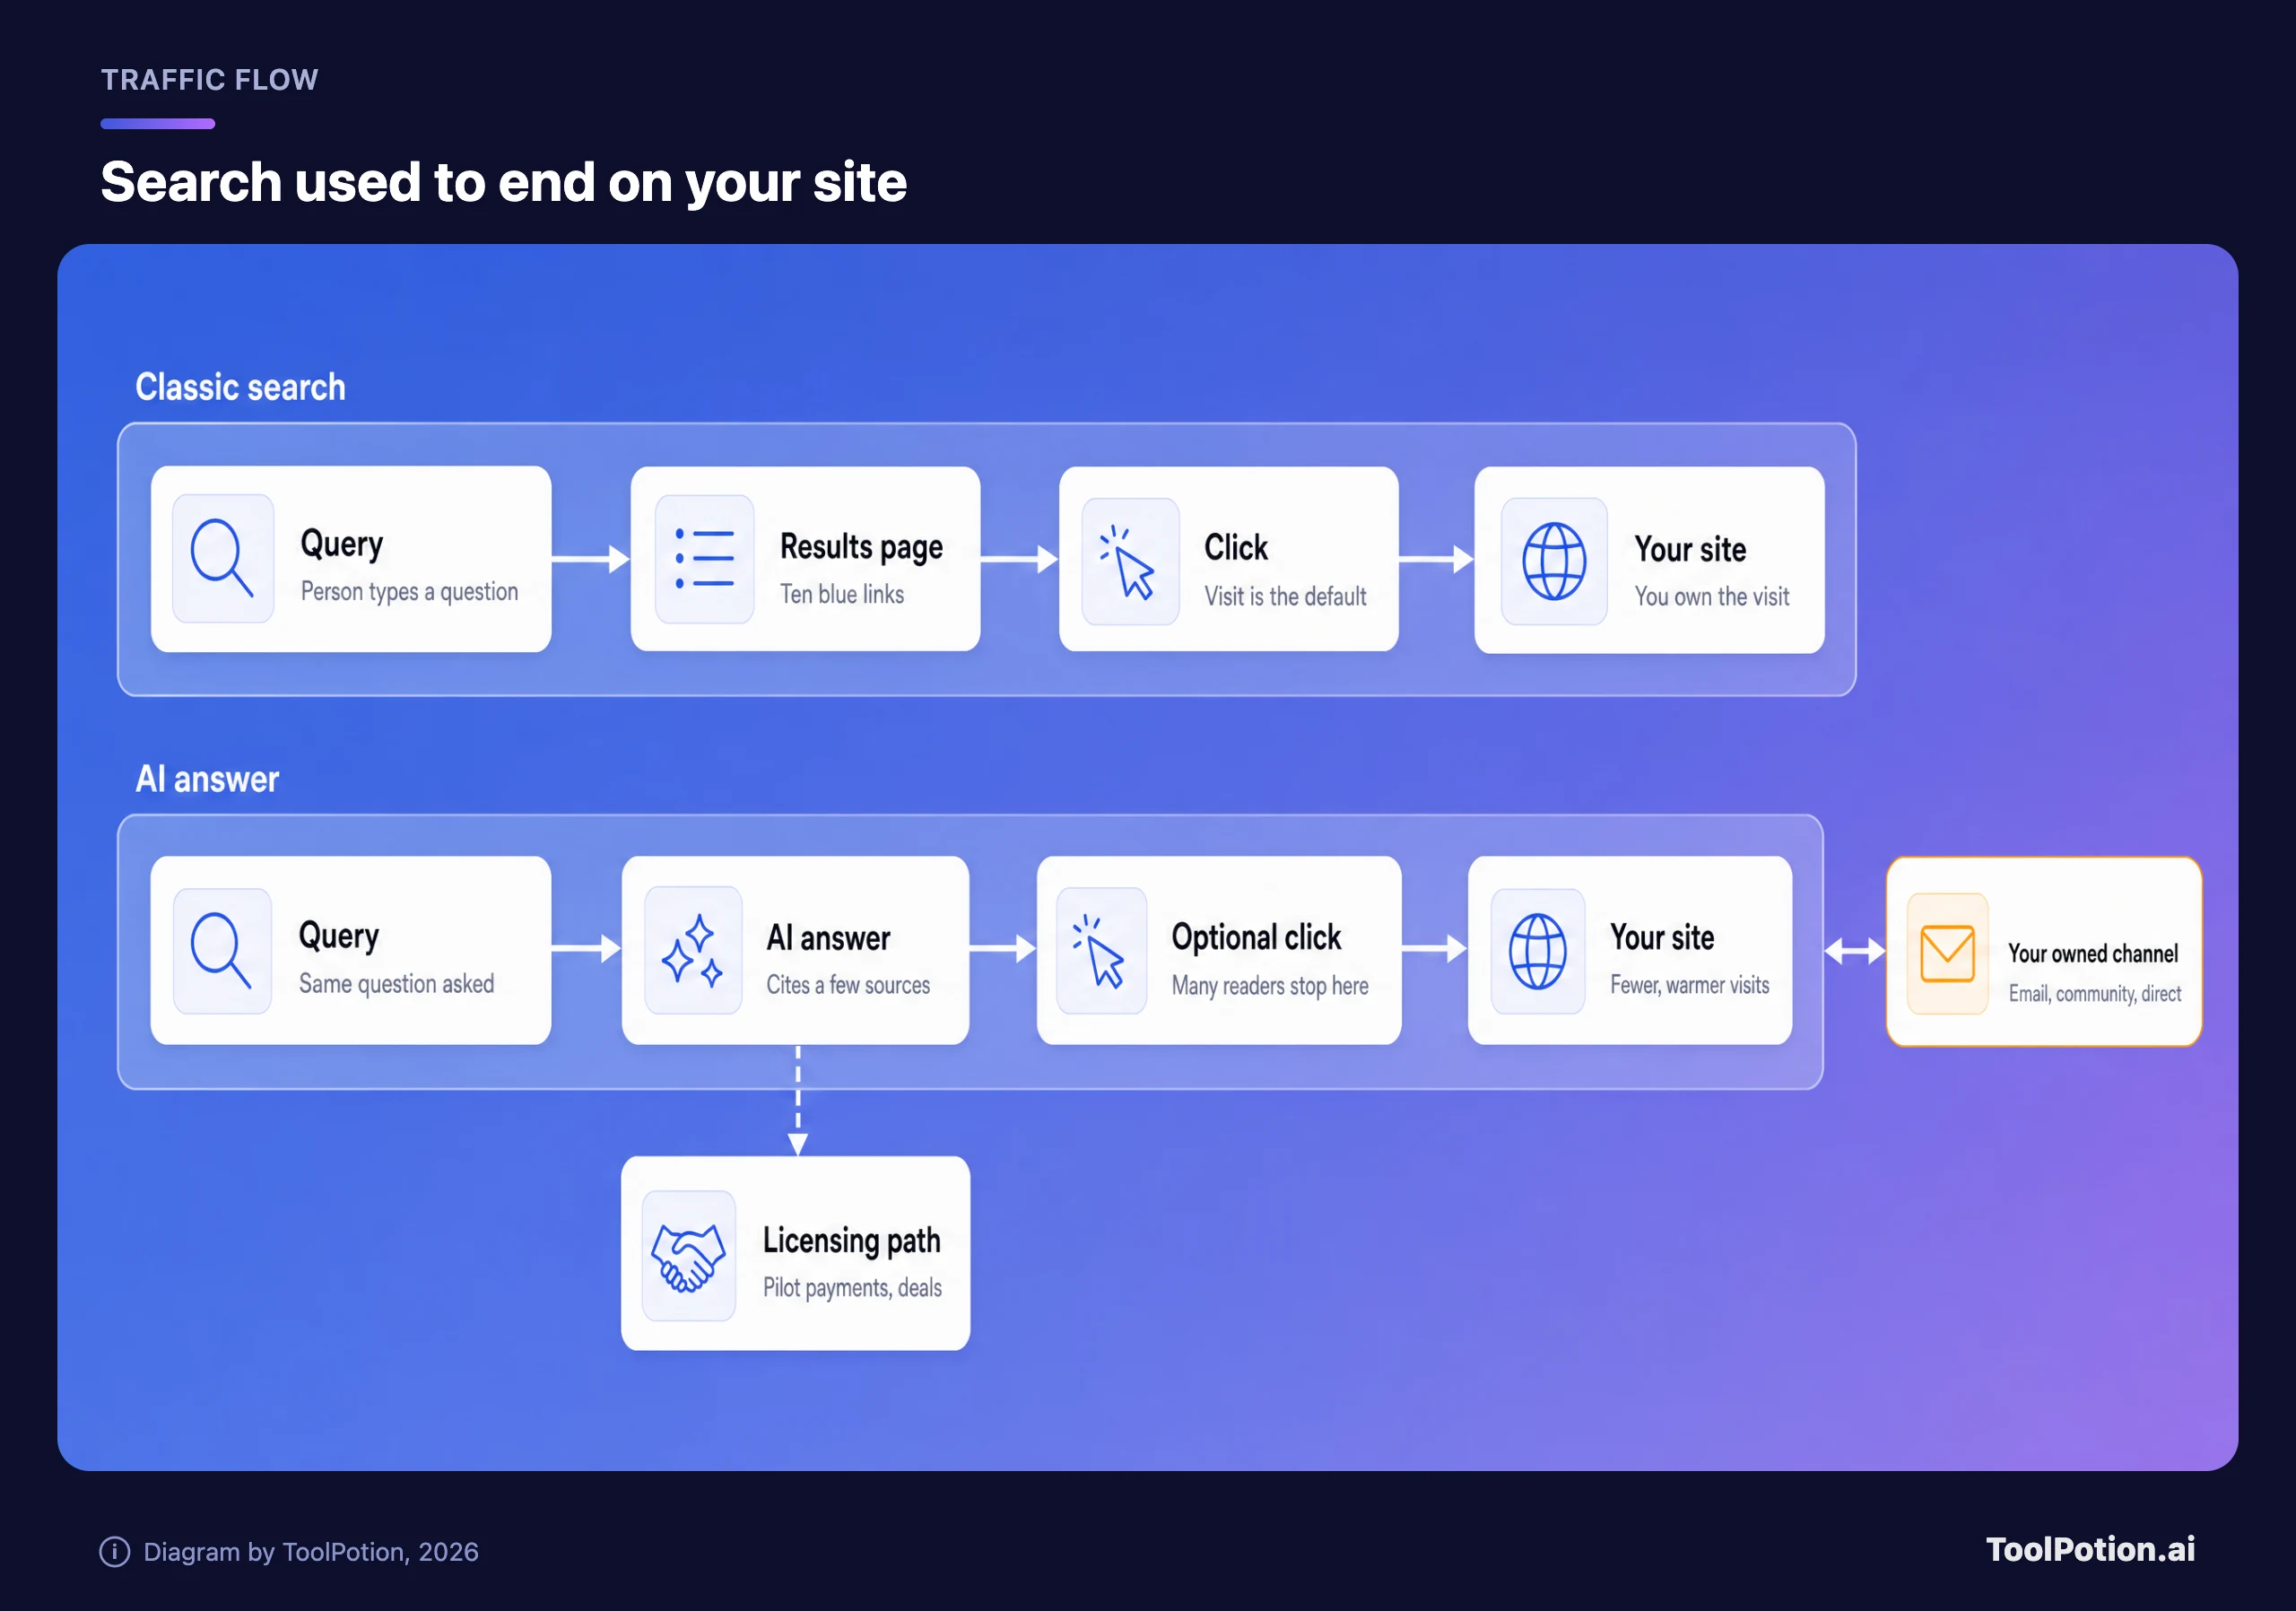
Das Diagramm zeigt auch den Nebenpfad, der in diesem Jahr neu ist: Lizenzierung. Wenn Ihr Content die Antwort speist, zahlt Ihnen womöglich jemand dafür. Ob dieser Jemand genug zahlt, ist die nächste Frage.
Was die Plattformen zahlen und was sie schließen
Googles Pilotprogramm ist der klarste Datenpunkt. Laut The Information, berichtet von The Verge, haben sich rund 100 Publisher einem Programm angeschlossen, das danach zahlt, wie stark ihre Inhalte zu AI Overviews, AI Mode und dem Gemini-Chatbot beigetragen haben. Ein Publisher, der von Anfang an dabei war, soll in einem Jahr über 1 Million US-Dollar verdient haben. Einer, der vor ein paar Monaten eingestiegen ist, kommt laut demselben Bericht auf etwa 50.000 bis 60.000 US-Dollar. Google selbst hat diese Zahlen unseres Wissens nicht veröffentlicht.
Das sind die ermutigenden Zahlen, und sie stützen sich auf einen einzigen Bericht. Frühe und spätere Teilnehmer bekommen sehr unterschiedliche Schecks, und niemand außerhalb des Pilotprogramms kann Ihren eigenen berechnen.
The Verge weist außerdem darauf hin, dass Großbritannien entschieden hat, Google müsse Publishern ermöglichen, sich aus KI-Suchfunktionen auszutragen, und dass die Europäische Union eine Untersuchung zu den Auswirkungen auf den Web-Traffic eingeleitet hat. Sollte das Bestand haben, wird der Opt-out zu einem echten Hebel statt zu einer theoretischen Option.
Reddit zeigt die andere Haltung. Das Unternehmen stellt später in diesem Jahr die RSS-Feeds ein und Anfang 2027 den öffentlichen API-Zugang, berichtet TechCrunch, und begründet das mit massenhaftem Scraping und automatisiertem Missbrauch. Derselbe Bericht nennt für Reddits „sonstige Erlöse“, zu denen KI-Lizenzierung gehört, ein Plus von 24 % gegenüber dem Vorjahr auf 43 Millionen US-Dollar. KI-Assistenten, die Fragen aus Reddit beantworten, bräuchten kommerzielle Vereinbarungen, sobald die offene Tür zu ist. Egal, was das Motiv ist: Für alle, die auf Reddit-Feeds aufgebaut haben, ist die Wirkung gleich. Das offene Web schrumpft, und Zugang wird zum bezahlten Produkt.
Die Lehre für kleine Publisher ist unbequem. Mit Google oder OpenAI können Sie heute vermutlich nicht verhandeln. Sie können aber entscheiden, was Ihre eigene Website erlaubt, und Sie können aufhören, von einer Leitung abzuhängen, die bald jemand anderes abrechnet.
Die Assistenten coachen Sie in Richtung der Ziele der jeweiligen Plattform
Während der Zugang enger wird, geben die Plattformen Creatorn KI-Hilfe an die Hand. Die Edits-App von Instagram hat jetzt einen Kreativ-Assistenten, der Ihre Kontodaten einbezieht. The Verge nennt dabei Likes, Aufrufe, Wiedergabedauer und Shares. Sie können fragen, warum ein Video funktioniert hat und ein anderes nicht, oder welcher Hook passt. YouTube hat sein eigenes KI-Dashboard für Creator gerade aktualisiert; laut demselben Artikel sagt es Creatorn, wie sie die Interaktion maximieren.
Das ist nützlich, aber auch ein geschlossener Kreislauf. Beide Assistenten optimieren auf Interaktion innerhalb der jeweiligen Plattform. The Verge nennt die naheliegende Sorge: Wenn alle auf dieselben Kennzahlen hin optimieren, gleichen sich die Inhalte an, und der Vorteil, dem Rat zu folgen, schrumpft.
Auch auf der Publikumsseite verschiebt sich etwas. YouTube lässt Zuschauer mit Gemini per Texteingabe einen eigenen Feed zusammenstellen, der als Tab auf der Startseite neben den üblichen Empfehlungen angepinnt wird. Mit Spotifys Taste Profile können Premium-Hörer in den USA ab 18 Jahren ihre Empfehlungen in normaler Sprache anpassen, wobei sich die Startseite innerhalb weniger Stunden ändert. Und ChatGPT schlägt mitten im Gespräch jetzt Apps von Drittanbietern vor, mit 16 Launch-Partnern, darunter Notion und Vercel, sowie einem Enterprise-Marktplatz mit über 30 Partnern.
Insgesamt spaltet sich die Discovery auf. Ihr Publikum wird einem Assistenten zunehmend sagen, was es will, und der Assistent entscheidet, was er anzeigt. So schneiden die Funktionen im Vergleich ab.
Das Muster in der letzten Spalte ist der entscheidende Punkt. Fast jede Steuerung liegt bei der Plattform oder beim Zuschauer, und fast keine bei Ihnen. Deshalb beginnt die folgende Strategie bei dem, was Sie selbst in der Hand haben.
Sortieren Sie Ihre Kanäle in eigene, gemietete und lizenzierte
Ein Kanal ist eigen, wenn Sie die Person morgen erreichen können, ohne jemanden um Erlaubnis zu fragen. Eine E-Mail-Liste gehört dazu. Ebenso eine Website mit direkten Besuchern und eine Community, die Sie auf Infrastruktur betreiben, die Sie kontrollieren. Ein Kanal ist gemietet, wenn eine Plattform entscheidet, wer Ihren Beitrag sieht. Dazu zählen Social-Media-Feeds, Videoplattformen und Marktplätze. Lizenziert ist die neueste Ebene: KI-Unternehmen oder Suchmaschinen, die für das Recht zahlen, Ihre Arbeit weiterzuverwenden.
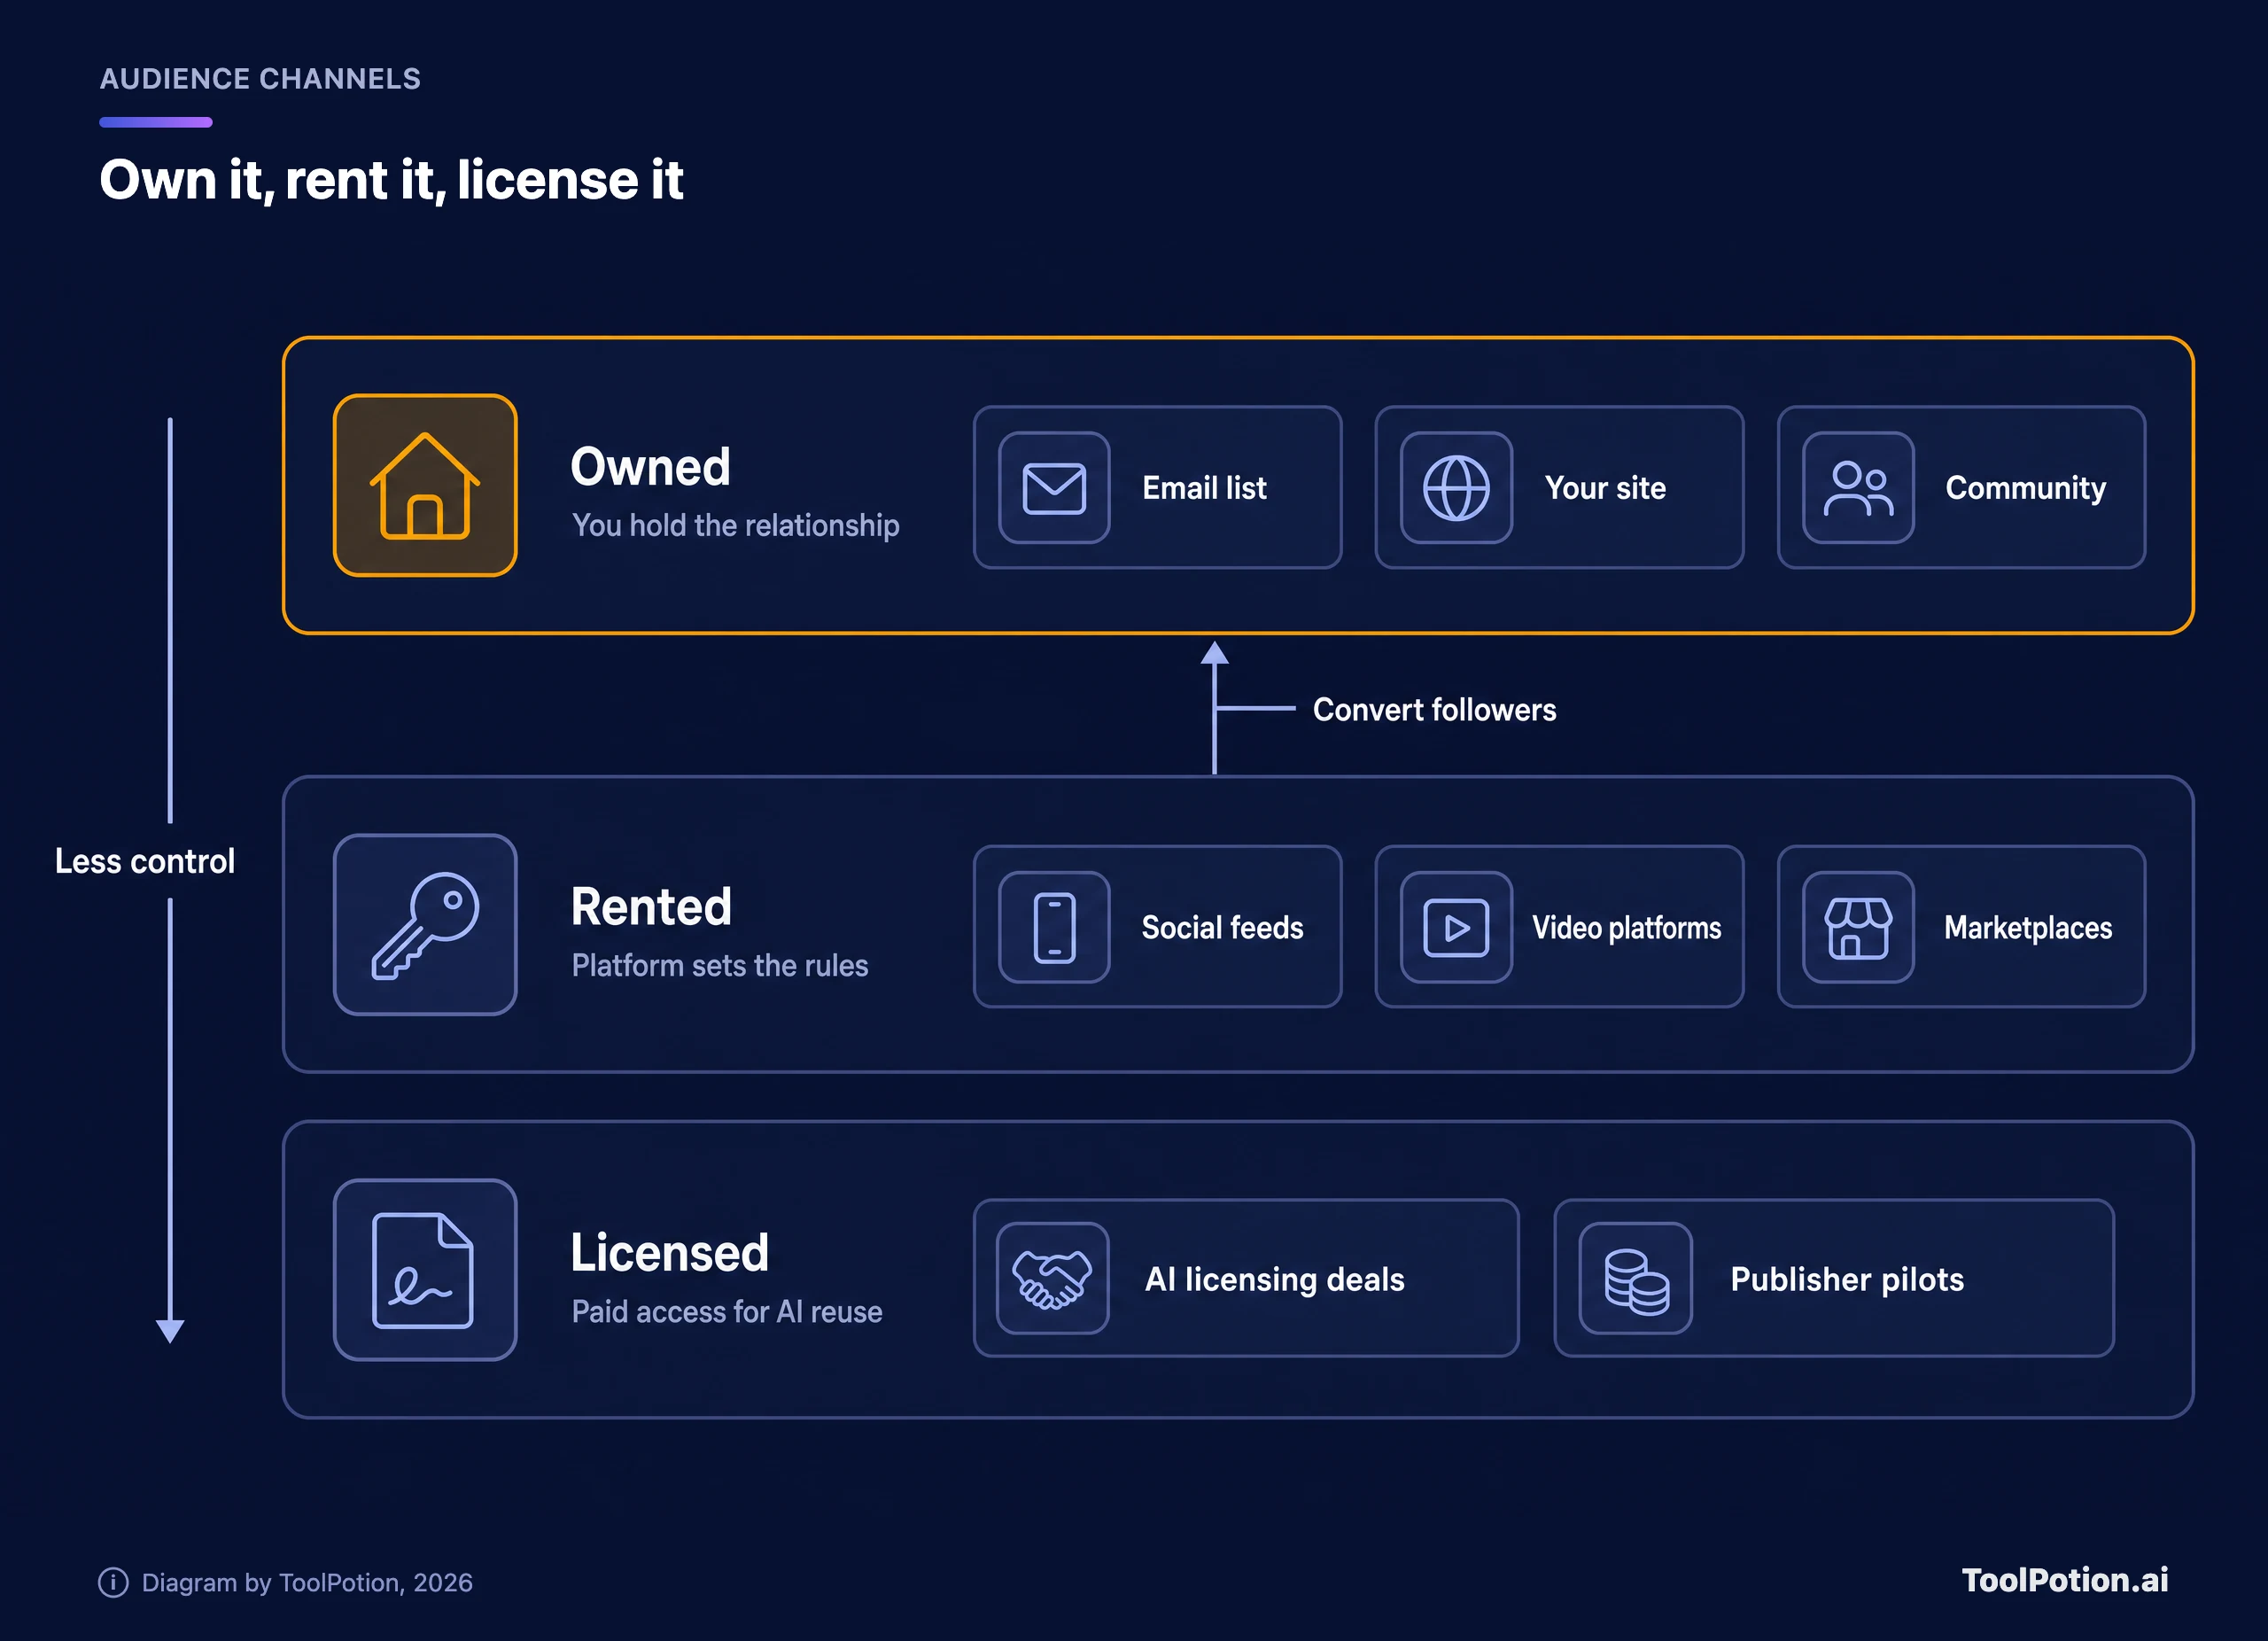
Gemietete Kanäle sind trotzdem nützlich. Dort findet Discovery statt. Der Fehler ist, die Followerzahl als Vermögenswert zu behandeln, obwohl die Plattform sie über Nacht neu sortieren kann. Jeder Beitrag auf einem gemieteten Kanal sollte eine Aufgabe haben, und meist lautet sie, Menschen auf einen Kanal zu bringen, der Ihnen gehört.
Für E-Mail ist eine Plattform wie beehiiv oder Mailchimp der übliche Einstieg. In unserem Verzeichnis sehen Sie, wie etablierte KI-Newsletter wie Superhuman AI und Axios AI+ ihr Publikum halten. Für Community zeigt ein Discord-Server wie der von Midjourney, wozu ein von Creatorn betriebener Raum wachsen kann.
Probieren Sie den Rechner unten mit Ihrer eigenen Analytics-Aufteilung aus. Er ist eine Faustformel, keine Prognose: Er addiert Such- und Social-Anteile, um zu zeigen, wie viel Ihres Traffics über gemietete Kanäle läuft, und wendet dann einen angenommenen Rückgang der Such-Klicks an, den Sie selbst festlegen.
Liegt der gemietete Traffic über etwa 70 %, kann eine einzige Richtlinienänderung bei einer Plattform Sie hart treffen. Zwischen 40 % und 70 % sind Sie angreifbar, aber nicht fragil. Unter 40 % haben Sie bereits eine Basis. Diese Bandbreiten sind unsere Faustregel, passen Sie sie also an Ihre Risikobereitschaft an.
Legen Sie bewusst eine Bot-Zugriffsrichtlinie fest
Die meisten Websites haben keine schriftliche Entscheidung zu KI-Crawlern. Entweder wird alles blockiert, weil sich das sicher anfühlt, oder alles erlaubt, weil nie jemand hingeschaut hat. Beides sind Entscheidungen per Voreinstellung. Besser ist eine Entscheidung pro Bot, abhängig davon, was der jeweilige Bot tatsächlich tut.
OpenAI betreibt drei. In der Crawler-Dokumentation steht, dass OAI-SearchBot Websites in den Suchfunktionen von ChatGPT anzeigt und dass Websites, die sich ausgetragen haben, nicht in ChatGPT-Suchantworten erscheinen. GPTBot sammelt Inhalte zum Training generativer Modelle. ChatGPT-User führt Aktionen aus, die ein Nutzer auslöst, und robots.txt-Regeln gelten dafür womöglich nicht. Jede Einstellung ist unabhängig, und laut OpenAI kann es nach einer Änderung der robots.txt etwa 24 Stunden dauern, bis sich die Suchsysteme anpassen.
Das Google-Extended-Token steuert, ob gecrawlte Inhalte zum Training künftiger Gemini-Modelle und für das Grounding in Gemini-Apps genutzt werden dürfen. Google erklärt, dass es die Aufnahme in die Google-Suche nicht beeinflusst und keinen Einfluss auf das Suchranking hat. AI Overviews werden stattdessen über die normalen Search-Steuerungen geregelt: Der Leitfaden zu KI-Funktionen nennt nosnippet, data-nosnippet, max-snippet und noindex.
Die Dokumentation von Perplexity teilt die Bots in zwei Gruppen. PerplexityBot zeigt Websites in Perplexity-Ergebnissen an und verlinkt sie und wird laut Unternehmen nicht zum Crawlen für das Training von Foundation-Modellen genutzt. Perplexity-User ruft Seiten ab, wenn ein Nutzer danach fragt, und laut Perplexity ignoriert er robots.txt bei diesen Anfragen in der Regel, weil ein Nutzer sie ausgelöst hat.
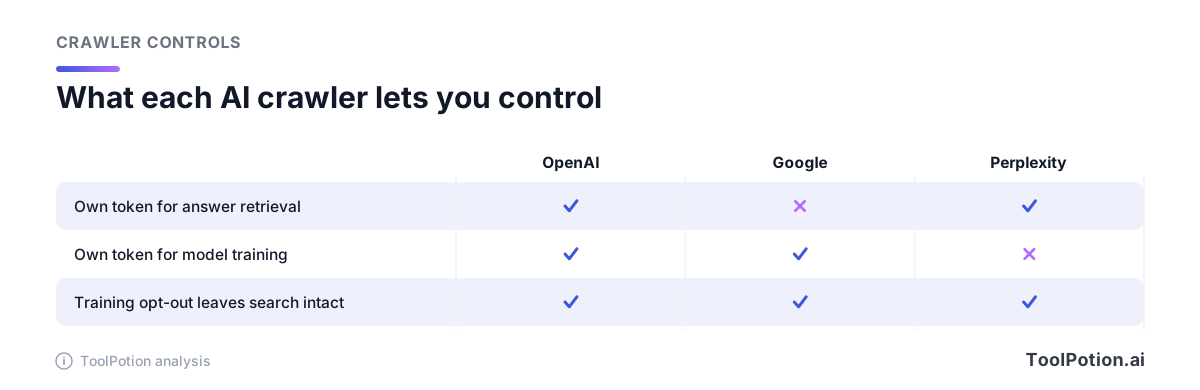
Hier ist ein sinnvoller Standard für Publisher, die Zitate wollen, aber keine kostenlosen Trainingsdaten liefern möchten. Erlauben Sie die Such-Bots (OAI-SearchBot und PerplexityBot), sperren Sie das Trainings-Token (GPTBot) und Google-Extended (Gemini-Training und Grounding), und lassen Sie Googlebot in Ruhe. Eine robots.txt dafür sieht so aus.
User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

# OpenAI model training
User-agent: GPTBot
Disallow: /

# Gemini training and grounding only. Does not affect Search or AI Overviews.
User-agent: Google-Extended
Disallow: /
Beachten Sie, was diese Datei nicht leistet. Wer Google-Extended sperrt, verschwindet nicht aus AI Overviews oder AI Mode, denn die folgen Googlebot und den Search-Steuerungen. Um zu begrenzen, was Google von einer Seite zeigt, nutzen Sie stattdessen nosnippet, data-nosnippet, max-snippet oder noindex, und bedenken Sie, dass jede dieser Optionen Sichtbarkeit kostet.
Ein Shop oder ein Dienstleister will vielleicht das Gegenteil und erlaubt alles, weil es genau darum geht, in einer Antwort genannt zu werden. Ein Publisher mit Paywall und Lizenzambitionen sperrt womöglich mehr. Wenn Sie tatsächlich verhandeln wollen, sind eine schriftliche Richtlinie und saubere Server-Logs Ihr Beleg dafür, was Sie kontrollieren.
Veröffentlichen Sie Seiten, die eine KI-Antwort zitieren kann
Google sagt klar, dass es keinen Spezialtrick gibt. Laut seinen Richtlinien gibt es keine zusätzlichen Anforderungen, um in AI Overviews oder AI Mode zu erscheinen, und Sie brauchen weder neue maschinenlesbare Dateien noch KI-spezifisches Markup. Eine Seite muss indexiert und für die Anzeige mit Snippet zugelassen sein. Das erste Audit ist also unspektakulär: Prüfen Sie, dass nichts, was zitiert werden soll, ein versehentliches noindex oder nosnippet trägt.
Danach ist es redaktionelle Arbeit. Antwort-Engines zitieren Seiten, die etwas klar benennen, die Herkunft nennen und sagen, wer es geschrieben hat. Beginnen Sie jeden Abschnitt mit der Antwort, setzen Sie Zahl und Quelle in denselben Satz und datieren Sie Ihre Aussagen. Eigene Daten schlagen Paraphrasen, weil es sonst nichts zu zitieren gibt.
Strukturierte Daten helfen Maschinen, den Inhalt einer Seite zu lesen, allerdings mit Grenzen. Google empfiehlt JSON-LD, garantiert keine Rich Results und rät davon ab, Informationen auszuzeichnen, die Leser nicht sehen können. Der Article-Typ von Schema.org liefert author, datePublished, dateModified und publisher, also die Eigenschaften, die Sie bei jedem Beitrag richtig setzen sollten. Vollständig und korrekt schlägt erschöpfend.
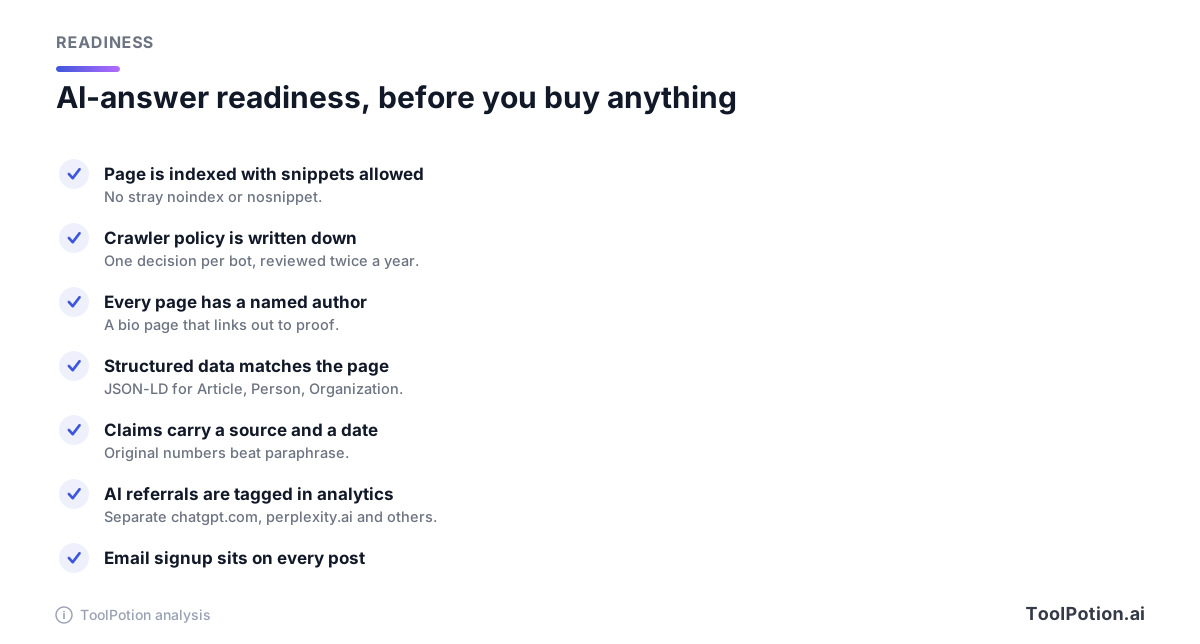
Autorenseiten haben mehr Gewicht als früher. Eine namentlich genannte Person mit einer Bio, die auf Belege ihrer Arbeit verlinkt, lässt sich von Lesern prüfen, und genau diese Eigenschaft nutzt auch ein Modell, wenn es zwischen nahezu identischen Seiten wählt. Wenn Sie Hilfe beim Entwerfen und Prüfen im größeren Maßstab möchten: Das Board der KI-SEO-Tools rankt die Optionen, und Semrush, Ahrefs und Frase sind bekannte Namen für den Vergleich.
Messen Sie KI-Referrals, bevor Sie darauf optimieren
Was Ihre Analytics unter „Direkt“ zusammenwerfen, können Sie nicht steuern. Trennen Sie zunächst die Referrer heraus, die Sie sehen können. Chat-Assistenten und Antwort-Engines schicken Traffic von ihren eigenen Domains, etwa chatgpt.com und perplexity.ai. Ein Segment auf diese Hostnamen liefert Ihnen in einer Woche eine Baseline. In der Search Console erscheinen AI Overviews und AI Mode laut Google im Suchtyp „Web“ zusammen mit allem anderen. Rechnen Sie also nicht mit einem separaten Bericht.
Verfolgen Sie jeden Monat drei Zahlen: Besuche von KI-Referrern, wie viele davon auf Ihrer E-Mail-Anmeldung landen, und wie viele Ihrer Zielseiten zitiert werden, wenn Sie Ihre eigenen Fragen stellen. Die dritte Zahl ermitteln Sie manuell. Öffnen Sie Perplexity und ChatGPT, stellen Sie die zehn Fragen, die Ihre Kunden stellen, und notieren Sie, welche Ihrer Seiten auftauchen. Das dauert eine Stunde und sagt mehr als ein Dashboard.
Behalten Sie auch die Server-Logs im Blick. Ruft ein Bot, den Sie gesperrt haben, weiterhin Seiten ab, müssen Sie die Richtlinie ansprechen. Taucht ein nutzergesteuerter Fetcher trotz robots.txt auf, ist das laut der Herstellerdokumentation oben erwartetes Verhalten, und bei Bedarf lösen Sie es über Firewall-Regeln statt über robots.txt.
Wählen Sie einen Plan nach Geschäftsmodell
Dieselbe Strategie wirkt je nach Geschäftsmodell unterschiedlich.
- Unabhängige Creator auf YouTube, Instagram oder Spotify sollten die Plattform-Assistenten als kostenlose Analytics und nicht mehr betrachten. Nutzen Sie sie, um zu lernen, welche Hooks funktionieren, und setzen Sie dann den Anmelde-Link in jede Videobeschreibung und Bio.
- Publisher mit Werbeeinnahmen sollten zuerst die Bot-Richtlinie schreiben und dann das Google-Pilotprogramm sowie die Maßnahmen in Großbritannien und der EU beobachten, bevor sie über einen Opt-out aus KI-Funktionen entscheiden. Ein Opt-out kostet Sichtbarkeit, und die bisherigen Zahlungen schwanken enorm.
- E-Commerce- und Dienstleistungsunternehmen wollen in Antworten genannt werden. Erlauben Sie die Such-Bots, halten Sie Produkt- und Preisangaben auf indexierbaren Seiten mit passenden strukturierten Daten vor und testen Sie, ob die App-Vorschläge von ChatGPT zu Ihrer Kategorie passen.
- Newsletter-Betreiber besitzen bereits den besten Kanal. Stecken Sie Aufwand in Archivseiten, die Fragen in einfacher Sprache beantworten, denn die werden zitiert und führen neue Leser zurück zum Anmeldeformular.
- Community-Builder trifft das Reddit-Problem am direktesten. Wenn sich Ihr Publikum in einem fremden Forum versammelt, spiegeln Sie die besten Threads in einen Raum, den Sie selbst betreiben.
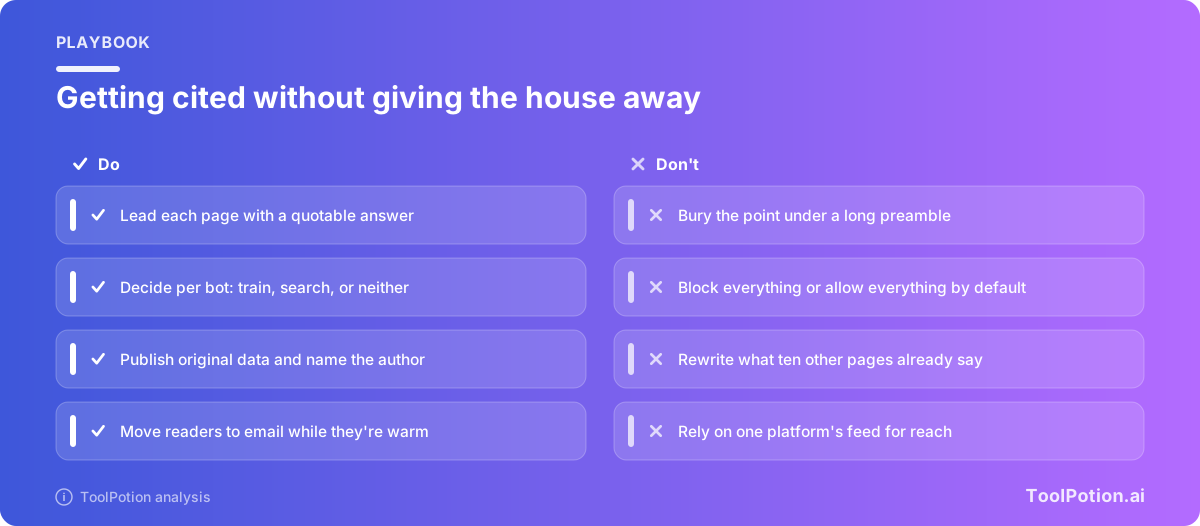
Wenn Sie nicht wissen, wo Sie anfangen sollen, beginnen Sie mit E-Mail. Fügen Sie auf Ihren fünf erfolgreichsten Seiten eine Anmeldung ein, schicken Sie einmal pro Woche eine nützliche Nachricht und beobachten Sie, wie sich der Anteil des Traffics entwickelt, der von selbst zurückkommt. Unser Board für Content Creator und der Leitfaden zu den besten KI-Tools für Content Creator decken Tools für die Produktion ab, und KI-Newsreader zeigt, wie andere ein Stammpublikum aufbauen. Unsere Liste der besten KI-YouTube-Kanäle zeigt, wie ein gemieteter Kanal im großen Maßstab aussieht.
Häufig gestellte Fragen
Brauche ich spezielles Markup, um in Googles AI Overviews zu erscheinen?
Nein. Laut Googles Richtlinien gibt es keine zusätzlichen Anforderungen oder speziellen Optimierungen. Ihre Seite muss indexiert und für die Anzeige mit Snippet zugelassen sein, prüfen Sie also zuerst auf noindex und nosnippet.
Entfernt mich das Sperren von Google-Extended aus der Google-Suche?
Nein. Google erklärt, dass Google-Extended die Aufnahme in die Suche nicht beeinflusst und keinen Einfluss auf das Ranking hat. Es steuert die Nutzung für Gemini-Training und Grounding und entfernt Sie nicht aus AI Overviews oder AI Mode, die den Search-Steuerungen folgen.
Sollte ich GPTBot sperren?
Das hängt davon ab, ob es Sie stört, dass Ihre Inhalte fürs Training genutzt werden. Das Sperren von GPTBot ist unabhängig von OAI-SearchBot. Sie können also das Training untersagen und trotzdem erlauben, dass die Suchfunktionen von ChatGPT Sie zitieren.
Kann ich für die KI-Nutzung meiner Inhalte bezahlt werden?
Möglicherweise, aber nicht verlässlich. Googles Pilotprogramm umfasst laut Berichten rund 100 Publisher mit sehr ungleichen Auszahlungen, und Reddits KI-Lizenzierung steckt laut TechCrunch in einer Erlöszeile von 43 Millionen US-Dollar. Kleine Publisher sollten vorerst von keiner Zahlung ausgehen und eine schriftliche Bot-Richtlinie bereithalten.
Woran erkenne ich, ob KI-Antworten mir Traffic bringen?
Segmentieren Sie in Ihren Analytics die Referrer von chatgpt.com, perplexity.ai und ähnlichen Hostnamen. Die KI-Funktionen von Google werden in der Search Console innerhalb Ihres regulären Web-Suchtraffics gezählt und erscheinen daher nicht als eigene Zeile.
Ist der Traffic-Rechner eine Prognose?
Nein, er ist eine grobe Faustformel. Er addiert Ihre Such- und Social-Anteile, um die gemietete Abhängigkeit zu zeigen, und wendet einen von Ihnen gewählten Rückgang der Such-Klicks an. Das Ergebnis ist also nur so gut wie Ihre Annahme.