

Die Prompt-Engineering-Muster, die einen Modell-Update überleben, sind jene, die Informationen tragen, die das Modell nicht ableiten kann: eine Rolle, die das Publikum festlegt, Kontext, den es nicht kennt, eine Aufgabe mit einer Entscheidungsregel und einen Output-Vertrag, der außerhalb des Prompts durchgesetzt wird. Alles andere ist Folklore mit einem Verfallsdatum.
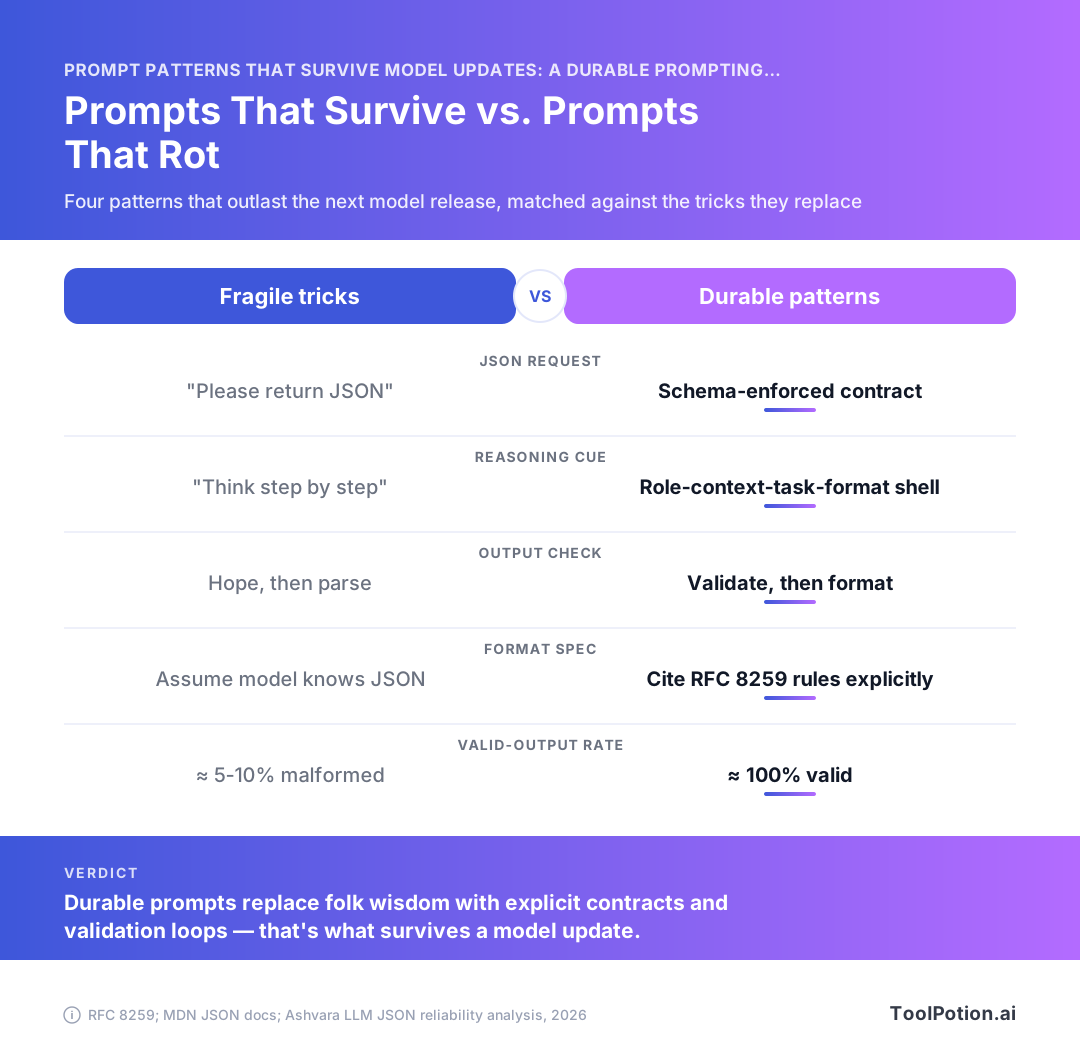
Am deutlichsten sieht man die Trennlinie bei JSON. Ein Modell nett um JSON zu bitten hinterlässt etwa 5–10 % fehlerhafte Ausgaben, der JSON-Modus bringt Sie auf etwa 95–99 % valide Ergebnisse, und schema-gebundenes Decoding liegt effektiv bei 100 % (Ashvara). Gleiche Absicht, drei Durchsetzungsebenen, dramatisch unterschiedliche Fehlerquoten am Release-Tag.
Dieses Playbook behandelt vier Muster, die über Claude, GPT und Gemini hinweg funktionieren, die brüchigen Tricks, die es wert sind, aus Ihrer Bibliothek gelöscht zu werden, sowie eine kleine Eval-Suite, die das nächste Modell-Release zu einem Diff statt einem Vorfall macht.
Warum Prompts veralten: der Fehlermodus, für den niemand versioniert
Prompts verfallen nicht zufällig. Sie verfallen entlang einer vorhersehbaren Naht: Die Teile, die sich auf das Verhalten eines bestimmten Modells stützen, werden durch den nächsten Checkpoint ungültig, während die Teile, die beschreiben, was Sie wollen, überleben.
Zwei Arten von Prompts: jene, die Absichten beschreiben, und jene, die eine Eigenheit ausnutzen
Ein Absichts-Prompt beschreibt, was die Ausgabe sein muss, wer sie liest, und was als falsch gilt. Ein Quirk-Prompt beschreibt, was letzten Dienstag zufällig funktioniert hat. Großgeschriebenes ONLY RETURN JSON. Dreifache Wiederholung derselben Anweisung, weil zweimal nicht gereicht hat. Eine magische Präambel, die aus einem Forum-Thread kopiert wurde. Diese Tricks wurden gegen das Decoding-Verhalten eines bestimmten Checkpoints abgestimmt, und nichts darin sagt einem zukünftigen Modell, was Sie tatsächlich brauchen.
Naives "Bitte gib JSON zurück"-Prompting erzeugt immer noch geschätzte 5–10 % fehlerhafte Ausgaben (Ashvara), und diese Zahl ist eine Eigenschaft des Modells, nicht Ihres Prompts. Tauschen Sie das Modell aus, und die Zahl verändert sich. Sie haben den Vertrag nie aufgeschrieben, also haben Sie nichts, woran Sie das neue Modell festhalten können.
Was am Release-Tag tatsächlich kaputt geht
Der Schaden ist selten laut. Ihr Parser beginnt, bei einem abschließenden Komma zu scheitern (etwa 40 % der JSON-Fehler in einer Analyse stammen genau davon, Flying Fish Space), oder das Modell wird gesprächiger und verpackt saubere Ausgaben in einen einleitenden Satz. Dazu kommt, dass das Tempo neuer Modell-Releases bedeutet, dass der Checkpoint, gegen den Sie abgestimmt haben, nächstes Quartal vielleicht nicht mehr der ist, der den Traffic bedient.
Vergleichen Sie das mit einem schema-gebundenen Aufruf, bei dem die Generierung auf die von Ihnen bereitgestellte Form beschränkt ist und die syntaktische Gültigkeit effektiv bei 100 % liegt (Ashvara). Die Durchsetzung liegt außerhalb des Prompt-Texts. Ein Modell-Update kann Ton, Ausführlichkeit und Argumentationstiefe ändern, ohne ihn zu berühren.
Der Haltbarkeitstest: Würde dieser Prompt noch Sinn ergeben für ein fähigeres Modell?
Eine Frage, gestellt an jeden Prompt, den Sie besitzen: Wenn das Modell über Nacht doppelt so fähig würde, würde diese Anweisung noch nützliche Arbeit leisten?
"Gib ein Objekt mit den Schlüsseln id, status und confidence zurück, wobei status einer von drei buchstäblichen Werten ist" besteht. RFC 8259 legt das Vokabular bereits fest, das Sie ausleihen: vier primitive Typen, zwei strukturierte Typen und genau drei kleingeschriebene buchstäbliche Namen (RFC 8259). Diese Anweisung ist für jedes Modell verständlich, jetzt und in Zukunft. "Atme tief durch und denke Schritt für Schritt" besteht nicht, weil sie eine Schwäche kompensiert, die das nächste Release möglicherweise nicht mehr hat. Löschen Sie die Kompensationen und behalten Sie die Verträge.
Prompt-Engineering-Muster, die übertragbar sind: Rolle, Kontext, Aufgabe, Format
Strukturieren Sie jeden Ad-hoc-Prompt in vier Slots um, und legen Sie in jeden nur Informationen, die das Modell nicht ableiten kann. Rolle, Kontext, Aufgabe, Format. Die Shell übersteht Modell-Updates, weil jeder Slot Fakten über Ihr Problem trägt, nicht Folklore darüber, wie der Checkpoint des letzten Quartals auf Schmeichelei reagiert hat.
Die vier Slots und was in jeden gehört
Rolle ist, für wen die Ausgabe bestimmt ist und welches Fachwissen die Antwort voraussetzt. "Du bist ein weltklasse Experte" setzt eine Stimmung und trägt keine Information. "Du schreibst für einen Payments-Ingenieur, der bereits weiß, was ein Idempotency-Key ist" sagt dem Modell, welche Erklärungen es überspringen kann.
Kontext ist alles, was das Modell unmöglich wissen kann: das Schema, das vorgelagerte System, die Grenzfälle, auf die Sie bereits in der Produktion gestoßen sind, die Tatsache, dass Ihr Parser eine UTF-8-BOM ablehnt. Aufgabe ist das einzelne Verb und sein Objekt. Format ist der Output-Vertrag, und er sollte spezifisch genug sein, um maschinell validiert zu werden.
Ein Format-Slot, der "JSON zurückgeben" sagt, ist ein Wunsch. Ein Format-Slot, der die Schlüssel, ihre Typen und das Verhalten bei einem unbekannten Wert benennt, ist ein Vertrag, den Sie testen können. JSON bietet vier primitive Typen (string, number, boolean, null) und zwei strukturierte Typen, Objekte und Arrays (RFC 8259), also gibt es ein kleines endliches Vokabular, um präzise zu sein. Sagen Sie null statt "lassen Sie es leer", denn die buchstäblichen Namen true, false und null sind kleingeschrieben und nichts anderes ist zulässig (RFC 8259).
Warum die Shell über Claude, GPT und Gemini hinweg übertragbar ist
Nichts in den vier Slots hängt von einem Tokenizer, einem System-Prompt-Quirk oder einem Provider-Feature-Flag ab. Jedem Modell muss mitgeteilt werden, welche Felder Sie wollen und was Ihr nachgelagerter Code damit macht, also fällt dieselbe Shell ohne Umschreiben in Claude, GPT und Gemini. Diese Portabilität ist auch das, was sie aktualisierbar macht: Wenn ein neuer Checkpoint ausgeliefert wird, ist der Kontext-Slot noch wahr und der Format-Slot ist noch der Vertrag, den Ihr Validator durchsetzt. Sie tauschen das Modell aus, führen die Evals erneut aus, und der Diff ist leer.
Die meisten der 212 Prompt-Engineering-Tools, die diese Struktur in unserem Verzeichnis als Template anbieten, verkaufen Ihnen die Slots als Formular. Sie erhalten denselben Effekt mit einem Heredoc und vier Kommentaren.
Constraints als Fakten formulieren, nicht als Beschwörungsformeln
Es gibt einen Test dafür, ob eine Zeile in Ihren Prompt gehört: Könnte ein kompetenter Auftragnehmer danach handeln, ohne eine Rückfrage zu stellen? "Sei gründlich" besteht nicht. "Property-Namen sind doppelt in Anführungszeichen gesetzt, kein abschließendes Komma nach dem letzten Element" besteht, und es entspricht echten Fehlermodi, da abschließende Kommas allein für etwa 40 % der JSON-Fehler in einer Analyse verantwortlich sind (Flying Fish Space).
Eine Beschwörungsformel verdient ihre Tokens nicht mehr, ohne jemals laut zu scheitern, während ein formulierter Fakt seine Bedeutung über jeden Checkpoint hinweg behält, auf den Sie ihn richten.
Ein Praxis-Beispiel: Vorher/Nachher-Umschreibung
| Vorher (Ad-hoc) | Nachher (vier Slots) |
|---|---|
| "Du bist ein erfahrener Datenanalyst. Extrahiere die Rechnungsdetails sorgfältig und gib JSON zurück. Sei genau!" | Rolle: Die Ausgabe wird von einem Python-json.loads-Aufruf verarbeitet, kein Mensch liest sie. Kontext: Rechnungen sind OCR-gescannte PDFs; Lieferantennamen sind oft abgeschnitten; Beträge können ein Währungssymbol enthalten. Aufgabe: Extrahiere Lieferant, Rechnungsnummer, Gesamtbetrag in Cent, Ausstellungsdatum. Format: Ein JSON-Objekt, Schlüssel genau wie angegeben, total_cents als Ganzzahl ohne führende Nullen, unbekannte Werte als null, kein Text davor oder danach. |
Die Nachher-Version sagt nichts über die Persönlichkeit des Modells und alles über Ihre Daten. Beachten Sie, dass null und {} beide gültiges JSON sind, aber verschiedene Bedeutungen haben (Jsonic), also wählen Sie eines und schreiben Sie es auf. Führende Nullen sind in JSON-Zahlen ebenfalls nicht zulässig (MDN), weshalb der Format-Slot die Ganzzahl-Regel explizit aufführt, anstatt darauf zu vertrauen, dass das Modell die Grammatik kennt.
Few-Shot-Gerüste für Übertragbarkeit optimieren
Wählen Sie Beispiele für die Mehrdeutigkeit, die sie auflösen. Ein Few-Shot-Block, der vier Fälle zeigt, bei denen ein Mensch zögern würde, lehrt etwas, das das nächste Modell noch immer braucht. Ein Block, der vier einfache Fälle in einem Hausstil zeigt, lehrt Ton, und Ton ist das Einzige, das jeder Checkpoint selbstständig immer besser errät.
Beispiele, die die Entscheidungsgrenze lehren, nicht das Vokabular
Bevor Sie ein Beispiel einfügen, fragen Sie sich, was sich ändern würde, wenn Sie es löschen würden. Wenn die Antwort lautet "Die Ausgabe klingt etwas weniger wie wir", löschen Sie es. Wenn die Antwort lautet "Das Modell würde eine Rückerstattung mit Teillieferung als Rückgabe statt als Streitfall klassifizieren", behalten Sie es, denn diese Entscheidung ist aus der Aufgabenbeschreibung nicht ableitbar.
Derselbe Test gilt für die Ausgabeform. Ein Beispiel, das ein leeres Ergebnis als [] statt null zeigt, ist mehr wert als fünf Beispiele mit befüllten Ergebnissen, da ein leeres Array und null beide gültiges JSON sind und verschiedene Bedeutungen haben (Jsonic). Modelle raten hier unterschiedlich, und ein Beispiel klärt das ein für alle Mal.
Grenzfälle und negative Beispiele rechtfertigen ihren Token-Aufwand
Zwei oder drei Ihrer Shots sollten Fälle sein, bei denen Sie in der Produktion Fehler gemacht haben. Das fehlende Feld. Die Eingabe, die bereits im Zielformat vorliegt. Der Datensatz, bei dem die richtige Antwort "unzureichende Daten" lautet und ein hilfsbereites Modell stattdessen einen Wert erfindet.
Negative Beispiele funktionieren, wenn Sie sie mit der Korrektur paaren, statt ein Verbot auszusprechen. Zeigen Sie die fehlerhafte Ausgabe und die korrigierte nebeneinander, und die Grenze ist konkret. Bloße "Verwende keine einfachen Anführungszeichen"-Anweisungen altern schlecht, und einfache Anführungszeichen sind einer der wiederkehrenden Übeltäter hinter fehlerhaftem JSON, zusammen mit abschließenden Kommas, die für etwa 40 % der Fehler in einer Analyse verantwortlich sind (Flying Fish Space).
Wie viele Shots, und wann auf null zu reduzieren
Beginnen Sie bei null. Fügen Sie Shots nur hinzu, wenn ein Eval-Fall fehlschlägt, und fügen Sie das kleinste Beispiel hinzu, das diesen Fall behebt. Die meisten Klassifikations- und Extraktions-Prompts stabilisieren sich zwischen drei und sechs; über acht hinaus kompensieren Sie in der Regel eine Aufgabenbeschreibung, die Sie nie richtig geschrieben haben.
Reduzieren Sie auf null, wann immer ein Schema die Arbeit erledigt. Constrained Decoding gegen ein bereitgestelltes Schema liefert effektiv 100 % syntaktisch valides JSON (Ashvara), also sind Format-Beispiele dort totes Gewicht. Behalten Sie die Shots für Urteilsvermögen, und verwenden Sie das Schema für die Struktur.
Der Overfitting-Geruch: Beispiele, die das nächste Modell zu wörtlich imitiert
Achten Sie auf Shots, deren Oberflächenmerkmale zufällig sind. Wenn jede Beispieleingabe etwa 40 Wörter umfasst, könnte ein stärkeres Modell die Länge als Signal behandeln. Wenn alle vier Beispiele auf dasselbe Label fallen, haben Sie den Prior verzerrt. Wenn Ihre Beispiele Platzhalternamen wie Acme Corp verwenden, rechnen Sie damit, dass diese Namen irgendwann in echten Ausgaben auftauchen.
Führen Sie Ihr Few-Shot-Set in der Woche, in der ein neuer Checkpoint erscheint, erneut aus und vergleichen Sie die Ausgaben bei Fällen, die die Beispiele nicht abdecken. Dort leckt die Imitation durch. Teams, die echte Deployment-Berichte veröffentlichen, halten das Beispiel-Set aus genau diesem Grund unter Versionskontrolle: Ein Beispiel, das Sie nicht per Diff vergleichen können, ist ein Beispiel, das Sie nicht ausrangieren können.
Output-Verträge, die das Modell überleben
Verschieben Sie die Durchsetzung im Stack nach unten, bis das Format nicht mehr davon abhängt, wie sich ein Checkpoint an einem bestimmten Tag anfühlt. Höflich um JSON zu bitten ist die schwächste verfügbare Stufe, und sie ist es, auf der der Großteil des Produktionscodes noch immer läuft.
Drei Zuverlässigkeitsstufen: Prosa-Anfrage, JSON-Modus, Constrained Decoding
| Stufe | Wie Sie anfragen | Was zurückkommt |
|---|---|---|
| 1 | "Bitte gib JSON zurück" im Prompt-Text | Schätzungsweise 5–10 % der Ausgaben sind fehlerhaft (Ashvara) |
| 2 | Provider-JSON-Modus aktiviert | In Produktionsbeobachtungen etwa 95–99 % syntaktisch valide (Ashvara) |
| 3 | Generierung auf ein bereitgestelltes Schema beschränkt | Effektiv 100 % syntaktisch valide (Ashvara) |
Nehmen Sie Stufe 3, wo immer Ihr Provider sie unterstützt. Die Validität kommt dann aus dem Decoder statt aus den Gewichten, sodass ein Modellwechsel sie nicht regressieren kann. Behalten Sie trotzdem den Vertrag auf Prompt-Ebene, denn Constrained Decoding garantiert die Form und sagt nichts darüber aus, ob die Werte korrekt sind. Wenn Sie die Implementierung lieber nicht selbst schreiben möchten, umfasst unser Verzeichnis der Frameworks, die Schema-Durchsetzung kapseln, 128 Einträge.
Was ein Vertrag über "JSON zurückgeben" hinaus festlegen muss
Benennen Sie die Schlüssel, den Typ hinter jedem Schlüssel und das Verhalten, wenn das Modell nichts einzutragen hat.
- Jeder Schlüssel genau so buchstabiert, wie Ihr Parser ihn erwartet, mit einem Typ aus den sechs JSON-Typen: vier Primitiven (string, number, boolean, null) und zwei strukturierten Typen, object und array (RFC 8259).
- Nur kleingeschriebene buchstäbliche Werte. Die Grammatik erlaubt genau drei davon: false, null, true (RFC 8259).
- Eindeutige Schlüsselnamen innerhalb jedes Objekts, was RFC 8259 empfiehlt, damit jeder Parser dieselbe Name-Wert-Zuordnung verwendet.
- Ob optionale Schlüssel weggelassen oder mit einem null-Wert ausgegeben werden, und alle Enums, die Sie erwarten, ausgeschrieben als buchstäbliche Zeichenketten.
Die Fehlermodi, die es wert sind, kodiert zu werden: abschließende Kommas, einfache Anführungszeichen, nicht-escapte Zeichenketten
Eine Analyse beziffert abschließende Kommas auf etwa 40 % aller JSON-Fehler, wobei einfache Anführungszeichen, nicht-escapte Anführungszeichen in Zeichenketten, fehlende Kommas und versteckte UTF-8-BOM-Zeichen den Großteil des Rests ausmachen (Flying Fish Space). Diese fünf Fehler kosten Sie vielleicht 25 Tokens, um sie im Format-Slot explizit zu verbieten, und das Verbot bleibt über jedes Modell hinweg korrekt, auf das Sie es richten. Kombinieren Sie es mit einem Validierungs-vor-Format-Schritt auf Ihrer Seite, anstatt der Zeichenkette zu vertrauen (QuickTinyData).
Leeres Objekt, leeres Array, null: drei verschiedene Antworten
Hier lecken Verträge zwischen Modellversionen durch, ohne dass jemand es bemerkt. Ein leeres Objekt und ein leeres Array sind beide gültiges JSON, und beide bedeuten etwas anderes als null (Jsonic). Ein Checkpoint gibt [] für keine Treffer zurück, der nächste gibt null zurück, und Ihr nachgelagerter Code behandelt eines davon als Fehler.
Wählen Sie die Darstellung, halten Sie sie im Vertrag fest und validieren Sie dagegen. Ihr Parser muss auch einen bloßen Wert auf oberster Ebene überleben, da jeder einzelne JSON-Wert ein vollständiges Dokument darstellt, einschließlich einer eigenständigen Zeichenkette oder der Zahl 42 (Jsonic).
Die brüchigen Tricks, die mit jedem Release sterben
Öffnen Sie Ihre Prompt-Bibliothek und suchen Sie nach diesen vier Mustern. Jeder Treffer ist ein Kandidat zum Löschen, denn jedes einzelne kompensierte eine Modellschwäche, die entweder behoben wurde oder sich verschoben hat.
Generisches 'Denke Schritt für Schritt' als Ergänzung
Das Anhängen von "Denke Schritt für Schritt" an einen Prompt ergab Sinn, als Modelle direkt zu einer Antwort sprangen. Aktuelle Reasoning-Modelle zergliedern bereits standardmäßig, sodass die Formulierung Tokens kostet und manchmal eine kurze Klassifikationsaufgabe in drei Absätze Narration zieht, die Sie danach wieder herausfiltern müssen.
Behalten Sie Reasoning-Anweisungen nur, wenn sie aufgabenspezifisch sind: "Liste die widersprüchlichen Klauseln auf, bevor du dich für eine entscheidest" sagt dem Modell, worüber es nachdenken soll. Der dauerhafte Ersatz ist der Aufgaben-Slot Ihrer Rolle-Kontext-Aufgabe-Format-Shell, in dem das gewünschte Zwischenergebnis beschrieben wird. Die generische Beschwörungsformel kommt in den Papierkorb.
Drohungen, Bestechungen und Roleplay-Druck
"Du wirst gefeuert, wenn du das falsch machst." "Ich gebe dir 200 Dollar Trinkgeld." "Du bist der weltbeste Analyst." Diese lehnten sich an Eigenheiten bestimmter RLHF-Checkpoints an, und Eigenheiten überleben kein Retraining. Schlimmer noch: Sie sind unfalsifizierbar. Sie können keinen Test schreiben, der beweist, dass das Trinkgeld das war, was Ihre Ausgabe verbessert hat, also bleibt die Zeile im Prompt für immer, unkontestiert.
Ersetzen Sie Druck durch Constraints. Eine Rubrik, anhand derer das Modell sich selbst bewertet, oder eine explizite Liste dessen, was als Fehler gilt, erledigt dieselbe Arbeit und funktioniert weiterhin, wenn sich der Checkpoint ändert.
Formatierungs-Hacks, die gegen den Tokenizer kämpfen
Prompts mit GROSSBUCHSTABEN-Forderungen, dreifachen Ausrufezeichen oder langen Abfolgen von Trennzeichen wie ##### aufzufüllen ist Folklore. Der Trennzeichen-Teil hatte einen wahren Kern (klare Abschnittsgrenzen helfen), aber die Eskalation nicht. Zwei Zeilenumbrüche und ein XML-ähnliches Tag schlagen vierzig Hash-Zeichen.
Dasselbe gilt für "keine Code-Fences, keine Präambel, keine Erklärung, gib NUR JSON aus", dreifach gestapelt. Sagen Sie es einmal im Format-Slot und setzen Sie dann die Garantie dort ein, wo Garantien tatsächlich greifen: Die Generierung auf ein bereitgestelltes Schema zu beschränken bringt Sie auf effektiv 100 % syntaktisch valides JSON (Ashvara), und kein Stapel von prompt-seitigen Verboten kommt dieser Zahl nahe.
Prompt-Bitten, wo ein Parser hingehört
Die Fehlermodi sind banal und strukturell: abschließende Kommas nach dem letzten Element, nicht-angeführte Schlüssel, ungültige Anführungszeichen, fehlende Kommas, nicht übereinstimmende geschweifte Klammern (QuickTinyData). Abschließende Kommas allein machen etwa 40 % der JSON-Fehler in einem Fehler-Datensatz aus (Flying Fish Space), und sie sind durch das Format selbst verboten (MDN). Kein Maß an höflichem Bitten schließt diese Lücke.
Löschen Sie die Bitten. Setzen Sie stattdessen ein Schema und einen Validator ein, und lassen Sie den Prompt beschreiben, was die Felder bedeuten.
Eval-Schleifen behandeln Prompts als versionierte Artefakte
Erstellen Sie zwanzig Testfälle, bevor Sie irgendetwas Cleveres bauen. Ein Prompt ohne Eval-Set ist ein Prompt, den Sie nicht aktualisieren können, weil Sie keine Möglichkeit haben festzustellen, ob das neue Modell ihn verbessert oder genau den Fall kaputt gemacht hat, der für Ihren größten Kunden wichtig ist, ohne es Ihnen zu sagen.
Zwanzig ist keine Kompromisszahl. Es reicht aus, um die Fehlerkategorien abzufangen, die Sie bereits kennen, ist klein genug, um es an einem Nachmittag zu schreiben, und billig genug, um es bei jedem Checkpoint erneut auszuführen, ohne an die Kosten zu denken.
Das Minimum Viable Eval: 20 Fälle, je eine Assertion
Eine Assertion pro Fall, und machen Sie sie boolesch: Hat die Ausgabe geparst, enthielt sie das erforderliche Feld, hat sie verweigert, wenn sie hätte verweigern sollen. Rubriken, Judge-Modelle und Ähnlichkeits-Scores können später folgen, sobald das Boolean grün ist. Fälle mit drei Assertions werden zu Fällen, die Sie nicht debuggen können, und ein roter Lauf sagt Ihnen nichts darüber aus, welche der drei kaputt gegangen ist.
Wählen Sie Ihre zwanzig aus echtem Traffic, gewichtet zum hässlichen Ende hin. Fünf Happy Paths, fünf mehrdeutige Eingaben, fünf adversarielle oder leere, fünf, die irgendwann in der Produktion kaputt gegangen sind. Speichern Sie sie neben dem Prompt im selben Repository, im selben Commit. Wenn sich der Prompt ändert und die Fälle nicht, ist das ein Review-Kommentar.
Erst validieren, dann formatieren: den JSON-Debugging-Workflow übernehmen
Die JSON-Welt hat dieses Argument vor Jahren geklärt. Der Troubleshooting-Leitfaden von QuickTinyData empfiehlt, zuerst zu validieren und dann zu formatieren, weil das Pretty-Printing eines kaputten Dokuments den genauen Strukturfehler versteckt, nach dem man sucht: abschließende Kommas, nicht-angeführte Schlüssel, falsche Anführungszeichen, fehlende Kommas, nicht übereinstimmende geschweifte Klammern (QuickTinyData).
Führen Sie Ihr Eval auf dieselbe Weise aus. Bestätigen Sie die Gültigkeit, bevor Sie die Qualität bestätigen. Eine Modellausgabe, die json.loads nicht besteht, sollte nicht zur semantischen Prüfung weitergehen, und sie sollte auch keine Teilpunkte erhalten. Ihre Eval-Suite benötigt zwei Spalten: Parse-Rate und Pass-Rate, wobei die zweite nur Zeilen zählt, bei denen die erste erfolgreich war.
Die Fehlerverteilung zu kennen sagt Ihnen, was Sie assertieren sollen. Eine Analyse beziffert abschließende Kommas auf etwa 40 % der JSON-Fehler, wobei einfache Anführungszeichen, nicht-escapte Anführungszeichen in Zeichenketten, fehlende Kommas und versteckte UTF-8-BOM-Zeichen den Großteil des Rests ausmachen (Flying Fish Space). Die BOM-Sache ist eine dedizierte Assertion wert, da sie in jedem Editor, den Sie zur Überprüfung der Ausgabe verwenden werden, unsichtbar ist.
Regressionsläufe am Release-Tag
Ein neuer Checkpoint wird ausgeliefert. Sie führen die zwanzig aus, erhalten einen Diff und entscheiden. Das ist das gesamte Verfahren, und es dauert etwa vier Minuten, wenn Sie die Suite richtig gebaut haben.
- Pinnen Sie das alte Modell und führen Sie die Suite erneut aus, um zu bestätigen, dass Ihre Baseline noch reproduzierbar ist. Wenn nicht, liegt das Problem in Ihrem Test-Setup und nicht im Release.
- Führen Sie die Suite gegen den neuen Checkpoint aus und erfassen Sie Parse-Rate und Pass-Rate separat.
- Lesen Sie jeden Fall, der sich in beide Richtungen geändert hat. Ein Fall, der neu bestanden hat, kann Glück sein, und er verdient genau so viel Aufmerksamkeit wie eine Regression.
- Liefern aus, rollen Sie zurück oder patchen Sie den Prompt. Committen Sie dann die neuen Baseline-Zahlen neben der Prompt-Datei.
Dies ist am wichtigsten in Agent-Stacks, wo ein einzelner schlechter Parse kaskadiert, weil der Fehler drei Tool-Aufrufe später als etwas auftaucht, das einem Formatierungsfehler überhaupt nicht ähnelt.
Versionen pinnen – und was zu tun ist, wenn das nicht geht
Pinnen Sie überall, wo möglich, auf datierte Modell-IDs, und behandeln Sie einen Alias wie eine Floating-Abhängigkeit, die Sie sich entschieden haben, nicht zu sperren. Manche Provider geben Ihnen keinen Pin, oder deprecaten den, den Sie verwenden, mit einem kurzen Zeitfenster. Wenn das passiert, ist Ihre Eval-Suite das Einzige, das zwischen einer stillen Verhaltensänderung und einem Support-Ticket steht, das Sie nicht reproduzieren können.
Führen Sie die Suite regelmäßig gegen den ungepinnten Endpunkt aus. Wöchentlich reicht. Sie finden die Drift, bevor Ihre Nutzer sie Ihnen in einem Bug-Report schildern.
Einen Prompt über Claude, GPT und Gemini portieren
Etwa 80 % eines gut gebauten Prompts werden unverändert portiert. Der Rest ist eine Adapter-Schicht, die Sie einmal pro Provider schreiben und danach größtenteils vergessen. Wenn Sie den gesamten Prompt für jeden Anbieter neu schreiben, trug Ihr Prompt provider-spezifisches Verhalten, das er nie hätte tragen müssen.
Was identisch bleibt: die Shell, die Beispiele, der Vertrag
Die Vier-Slot-Shell wechselt ohne jede Bearbeitung zwischen Anbietern. Rolle, Kontext, Aufgabe, Format beschreiben den Job, und der Job ändert sich nicht, wenn man Checkpoints tauscht. Dasselbe gilt für Ihren Few-Shot-Block: Beispiele, die echte Mehrdeutigkeit in Ihrer Domäne auflösen, lehren jedes Modell dieselbe Sache, weil die Mehrdeutigkeit in Ihren Daten liegt und nicht im Decoder.
Ihr Output-Vertrag bleibt ebenfalls identisch, und das muss er. Was immer ein Provider zurückgibt, muss denselben Parser befriedigen: doppelt angeführte Property-Namen, keine abschließenden Kommas, kein NaN oder Infinity, und nur vier zulässige Whitespace-Zeichen (Leerzeichen, Tabulator, Zeilenvorschub, Wagenrücklauf) (MDN). Schreiben Sie das Schema einmal. Validieren Sie alle drei Ausgaben mit demselben Validator und vergleichen Sie die Fehler.
Halten Sie Ihr Eval-Set auch anbieterneutral. Zwanzig Fälle, die bei Claude bestehen und bei Gemini fehlschlagen, sagen Ihnen etwas Nützliches. Zwanzig Fälle, die auf Claude's Eigenheiten zugeschnitten sind, sagen Ihnen nichts.
Was Sie pro Provider anpassen: System-Message-Gewichtung, Trennzeichen, Enforcement-API
Drei Dinge bekommen einen Adapter. Wie viel von Ihrer Anweisung in die System-Message im Gegensatz zur User-Turn geht, da Provider diese unterschiedlich gewichten. Was Sie zum Einzäunen von Blöcken verwenden, XML-ähnliche Tags oder Markdown-Header. Und welche Enforcement-API Sie aufrufen.
Der letzte Punkt ist der knifflige Teil. Der JSON-Modus jeder Art bringt Ihnen Syntax und hört dort auf: Produktionsbeobachtungen beziffern ihn auf etwa 95–99 % syntaktisch valide, während die Generierung auf ein bereitgestelltes Schema zu beschränken effektiv 100 % liefert (Ashvara). Keine Stufe sagt etwas darüber aus, ob die Schlüssel die sind, die Sie angefordert haben, also bleibt die Schema-Prüfung unabhängig vom Anbieter in Ihrem Code. Wenn Sie Ziele auswählen, lohnt es sich, die Modelle selbst zu vergleichen, bevor Sie sich festlegen, und die Multi-Provider-Plattformen in unserem Verzeichnis werden einen Teil dieser Adapter-Arbeit für Sie übernehmen.
Eine Portierbarkeits-Checkliste vor dem Liefern
- Entfernen Sie jeden Satz, der ein Modell, eine Version oder ein bekanntes Verhalten eines Modells benennt. Das sind die Zeilen, die als Erste brechen.
- Führen Sie dasselbe Eval-Set gegen alle drei Provider aus und erfassen Sie Pass-Rates pro Fall, nicht nur einen Durchschnitt.
- Bestätigen Sie, dass der Schema-Validator bei jeder Antwort läuft, unabhängig davon, ob der Provider Constrained Decoding behauptet.
- Lesen Sie die Enforcement-Dokumentation jedes Providers erneut, wenn Sie den Adapter verdrahten, und halten Sie alle erforderlichen Formulierungen oder Flags innerhalb des Adapters und nicht im gemeinsamen Prompt.
- Protokollieren Sie, welcher Adapter ausgelöst wurde. Wenn ein Checkpoint ausgeliefert wird und sich die Qualität verändert, wollen Sie wissen, ob der Prompt oder der Adapter sich darunter geändert hat.
Wenn ein Prompt diese Checkliste bei nur einem Anbieter nicht besteht, liegt der Fehler fast immer im Adapter und nicht in der Shell.
Häufig gestellte Fragen
Muss ich meine Prompts jedes Mal neu schreiben, wenn ein neues Modell ausgeliefert wird?
Nein, und wenn Sie es tun, trug Ihr Prompt wahrscheinlich modellspezifische Hacks statt Anweisungen. Die Teile, die Updates überleben, sind jene, die an etwas außerhalb des Modells gebunden sind: eine Aufgabenbeschreibung, Eingabedaten und ein Output-Vertrag wie ein JSON-Schema. Constrained Decoding gegen ein bereitgestelltes Schema erzeugt effektiv 100 % syntaktisch valides JSON, unabhängig davon, welches Modell dahintersteckt, weil die Einschränkung im Decoder liegt. Was Sie bei einem Modellwechsel neu schreiben sollten: nichts. Was Sie erneut ausführen sollten: Ihr Eval-Set.
Funktioniert 'Denke Schritt für Schritt' noch bei aktuellen Modellen?
Es ist größtenteils totes Gewicht jetzt. Diese Formulierung war ein Workaround für Modelle, die direkt zu einer Antwort springen würden, und aktuelle Modelle zergliedern mehrstufige Arbeit bereits ohne Aufforderung. Schlimmer noch: Das Anhängen an einen Prompt, der strenge JSON-Ausgabe fordert, lädt das Modell ein, Reasoning-Prosa um das Objekt herum auszugeben, was genau die Fehlerklasse ist, die naive Prompts auf eine geschätzte Fehlerquote von 5–10 % fehlerhaftem JSON treibt. Wenn Sie Reasoning wollen, geben Sie ihm ein benanntes Feld in Ihrem Schema und lassen Sie den Parser es vom Payload getrennt halten.
Reicht der JSON-Modus, oder brauche ich ein Schema?
Verwenden Sie das Schema. Der JSON-Modus bringt Sie auf etwa 95–99 % syntaktisch valide Ausgabe, was gut klingt, bis Sie zehntausend Aufrufe pro Tag ausführen und hundert Fehler schlucken. Schema-gebundenes Decoding hebt die syntaktische Gültigkeit auf effektiv 100 %, und es fixiert auch Ihre Schlüsselnamen, was wichtig ist, weil RFC 8259 ein JSON-Objekt als ungeordnete Sammlung von Name-Wert-Paaren behandelt und nur eindeutige Namen empfiehlt. Syntaktische Gültigkeit ist keine semantische Korrektheit, also validieren Sie das geparste Objekt in jedem Fall gegen Ihre eigenen Regeln.
Wie viele Few-Shot-Beispiele sollte ein dauerhafter Prompt enthalten?
Zwei bis vier, und wählen Sie sie für Grenzfall-Abdeckung statt für Volumen. Beispiele, die denselben Happy Path wiederholt zeigen, lehren ein Modell nichts, was es nicht bereits tut; Beispiele, die die schwierigen Fälle festnageln, sind jene, die über Modelle hinweg übertragen werden. Für strukturierte Ausgaben verwenden Sie mindestens ein Beispiel auf den Unterschied zwischen einem leeren Container und einem fehlenden Wert, da [ein leeres Objekt {} und ein leeres Array [] beide gültiges JSON sind, sich aber semantisch von null unterscheiden](https://jsonic.io/guides/json-examples). Wenn Ihre Beispiele Formatierungen enthalten, die ein strenger Parser ablehnen würde, lehren Sie den Fehler: Abschließende Kommas allein machen etwa 40 % der JSON-Fehler in einer Analyse aus.
Wie groß muss ein Prompt-Eval-Set sein, bevor es nützlich ist?
Dreißig bis fünfzig beschriftete Fälle fangen die meisten Regressionen ab, und zwanzig ist besser als die null, mit denen die meisten Teams arbeiten. Größe ist weniger wichtig als Zusammensetzung: Gewichten Sie das Set in Richtung der Fehlermodi, die Sie tatsächlich in der Produktion gesehen haben, wie nicht-angeführte Schlüssel, einfache Anführungszeichen, nicht-escapte Anführungszeichen in Zeichenketten, fehlende Kommas und versteckte UTF-8-BOM-Zeichen, die alle in dokumentierten JSON-Fehleraufschlüsselungen auftauchen. Führen Sie die Validierung vor der Formatierung aus, um strukturelle Fehler zu erkennen statt sie zu maskieren, was der von QuickTinyData empfohlene Workflow ist. Versionieren Sie das Set zusammen mit dem Prompt und führen Sie es an dem Tag erneut aus, an dem ein neues Modell erscheint.
Kann derselbe Prompt wirklich unverändert auf Claude, GPT und Gemini laufen?
Der Anweisungskörper portiert sauber. Die Output-Enforcement-Schicht nicht, weil der JSON-Modus und Schema-gebundenes Decoding pro Provider unterschiedlich konfiguriert werden, also planen Sie mit einem Prompt und drei dünnen Adaptern. Den Vertrag in einem Format zu halten, auf das sich alle Provider bereits einigen, hilft: RFC 8259 ist sprachunabhängig und definiert vier primitive Typen plus Objekte und Arrays, mit kleingeschriebenen true, false und null als einzigen buchstäblichen Namen. Wenn Sie nach Tools suchen, um Prompts über Provider hinweg zu verwalten, listet unser Verzeichnis 212 Prompt-Engineering-Tools und 324 Einträge unter KI-Modellen.