

Vier KI-Finanz-Workflows bestehen 2026 den Test: Abstimmung, Prognosen, Ausgabenkategorisierung und Prüfungsvorbereitung. Alles andere ist ein Pilotprojekt mit einer guten Demo.
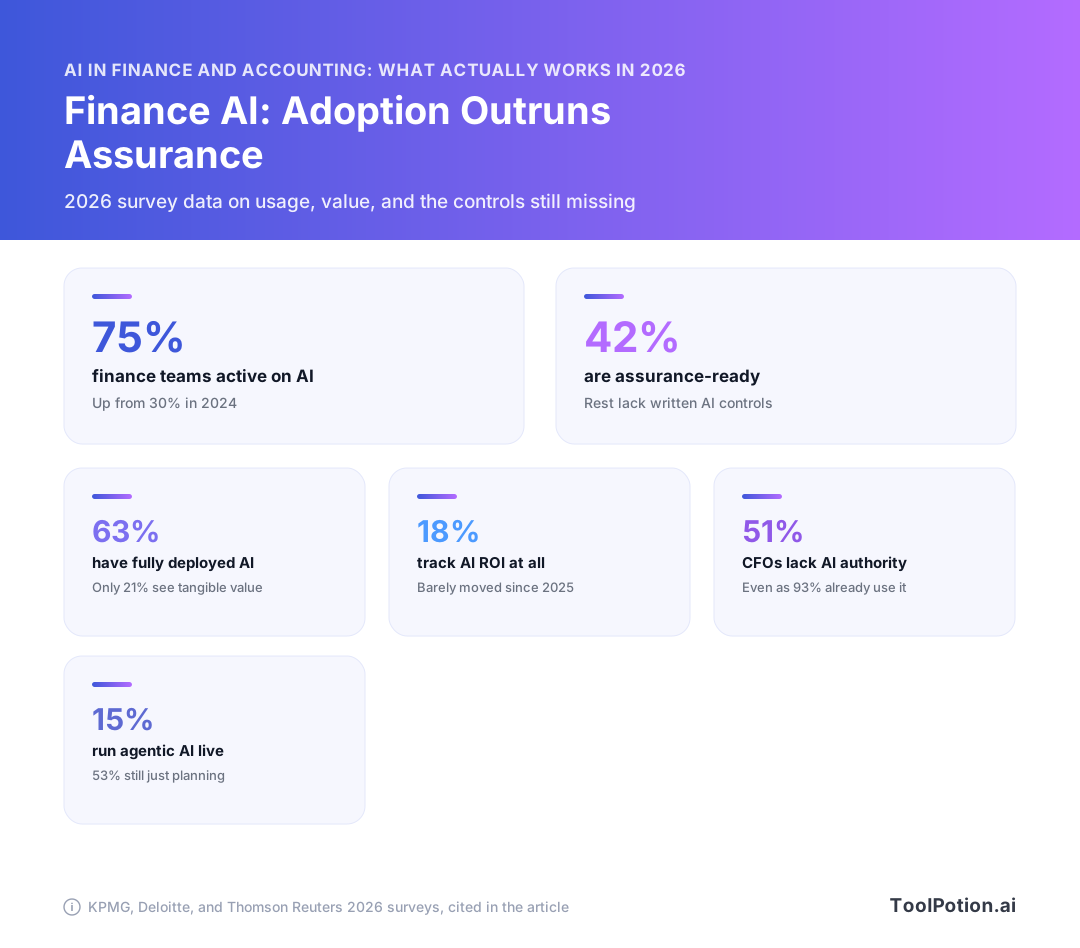
Die Adoptionszahlen helfen Ihnen nicht bei der Entscheidung. KPMG zufolge stieg die aktive KI-Nutzung in der Finanzfunktion auf 75 % im Jahr 2026, gegenüber 30 % im Jahr 2024. Deloittes Finance Trends Survey unter 1.326 Führungskräften ergab, dass 63 % vollständig implementiert haben, aber nur 21 % greifbaren Mehrwert sehen. Thomson Reuters stellte fest, dass nur 18 % den ROI überhaupt irgendwie messen. Das sind keine Widersprüche - es sind drei Definitionen des Begriffs "Adoption".
Dieser Beitrag filtert deshalb nach Kontrollen: Was COSOs GenAI-Leitfaden vom Februar 2026 verlangt, was die Genauigkeitsfußnote eines Anbieters tatsächlich gemessen hat und welche der 309 Finanz- und Banking-Tools in unserem Verzeichnis beide Tests bestehen.
Die Adoptionszahlen 2026 widersprechen sich - lesen Sie sie nach Definition
Wenn eine Umfrage 93 % und eine andere 14 % angibt, können beide richtig liegen. Sie zählen verschiedene Dinge, und fast keine gibt das in der Überschrift an.
Pilotnutzung, Implementierung und Kernworkflow-Nutzung sind drei verschiedene Fragen
KPMGs Global AI in Finance 2026 stellte fest, dass die aktive KI-Nutzung in der Finanzfunktion von 30 % im Jahr 2024 auf 75 % im Jahr 2026 mehr als verdoppelt wurde, wobei 71 % der Finanzführungskräfte angaben, dass KI den ROI-Erwartungen entspricht oder diese übertrifft. "Aktive Nutzung" umfasst dabei alles, was läuft - einschließlich eines Controllers, der Abweichungskommentare in ein Chat-Fenster einfügt. Thomson Reuters, das nach der unternehmensweiten GenAI-Nutzung fragte, kam auf 40 %, gegenüber 22 % ein Jahr zuvor, und auf nur 15 % für agentische KI, während 53 % dies planen oder in Betracht ziehen. Gleiches Jahr, gleicher Beruf, dreifache Spreizung. Das machte die Fragenformulierung - nicht der Markt.
Suchen Sie also vor dem Zitieren einer Zahl nach der Definition: Wird jemand gezählt, der ein Tool ausprobiert hat, jemand, dessen Unternehmen eines gekauft hat, oder ein Workflow, der einen Monatsabschluss unter Aufsicht eines Prüfers überlebt hat? Nur das Dritte sagt etwas über Ihre eigene Roadmap aus.
Die Lücke zwischen Implementierung und Mehrwert, die niemand überbrückt
Deloittes Finance Trends 2026 Survey unter 1.326 globalen Finanzführungskräften ist die wichtigste, weil sie beide Seiten abfragt. 63 % haben KI im Finanzbereich vollständig implementiert, 21 % glauben, dass diese Investitionen greifbaren Mehrwert geliefert haben, und 14 % haben KI-Agenten vollständig integriert. Implementierung ist ungefähr dreimal so häufig wie Mehrwert. Diese Lücke ist der tatsächliche Stand der Finanz-KI im Jahr 2026, und das ist die Zahl, die Sie in jedes Anbietergespräch mitnehmen sollten.
Fast niemand misst überhaupt den ROI
Hier der Teil, der jedes Adoptionsdiagramm wackeliger macht, als es aussieht: Nur 18 % der Befragten wussten, dass ihre Organisation den KI-ROI irgendwie misst - nahezu unverändert gegenüber dem Vorjahr -, und die meisten, die ihn messen, erfassen interne operative Kennzahlen statt Geschäftsergebnisse. Selbst gemeldete Zufriedenheit mit nicht gemessenem Aufwand ist eine Stimmung, kein Beweis.
Zwei Gewohnheiten helfen. Lesen Sie jede Statistik gegen die eigene Definition der Umfrage, bevor Sie sie weitergeben, und behandeln Sie jede Zahl aus einer vom Anbieter gesponserten Studie als Marketingbehauptung, bis Sie die Fußnote gefunden haben. Wir wenden denselben Filter auf die 309 KI-Tools für Finanzen und Banking in unserem Verzeichnis sowie auf die KI-Trend-Berichte, die wir verfolgen, an - weshalb die Shortlist im nächsten Abschnitt kurz ist.
Abstimmung: Die Auto-Match-Rate, die Sie tatsächlich erzielen werden
Planen Sie mit 60 % bis 80 % automatisch zertifizierten Konten und erstellen Sie Ihren Business Case am unteren Ende dieser Spanne. Die Anbieterzahl, die Sie in der Demo hören werden, lautet "bis zu 98 %" automatische Zertifizierung bei 99 % Abgleichgenauigkeit. Tatsächliche Kundeneinsätze landen zwischen 43 % und 85 %, weshalb 60-80 % die ehrliche Planungsannahme ist (Numeric). Wenn Ihr Personalmodell für den Abschluss nur bei 90 % funktioniert, scheitert das Projekt vor dem ersten Monatsende.
Marketing-Obergrenze vs. beobachteter Kundenbereich
Diese 43 %-Untergrenze und 85 %-Obergrenze sind dieselbe Software. Die Spreizung liegt in Ihren Daten, nicht im Modell des Anbieters.
Eine 98-%-Zahl ist bei einem engen Ausschnitt erreichbar: hochvolumige, varianzarme Konten wie Bankbarmittel und Kreditkartenclearing, mit sauberem Eins-zu-eins-Abgleich und einem großzügig gesetzten Wesentlichkeitsschwellenwert. Erweitern Sie dasselbe Tool auf Vorauszahlungen, Intercompany-Transaktionen, abgegrenzte Verbindlichkeiten und Vorräte, sinkt der zertifizierte Prozentsatz stark, weil diese Konten Urteilsvermögen erfordern, keine Zuordnung. Fragen Sie jeden Anbieter, welche Kontotypen das Prozentsatz seines Referenzkunden abdecken. Lautet die Antwort "Kasse und Forderungen", haben Sie gelernt, dass die Zahl eine Teilmenge ist, keine Portfolio-Rate.
Was die Lücke verursacht: Datenqualität, Nebenbuchabdeckung, Wesentlichkeitsschwellen
Drei Dinge entscheiden, wo Sie landen - und Sie haben alle unter Kontrolle, bevor Sie irgendetwas unterzeichnen. Die Nebenbuchabdeckung kommt zuerst: Konten, deren Belege in einer Tabellenkalkulation oder einem System ohne API liegen, können bei keiner Genauigkeit automatisch zertifiziert werden - zählen Sie sie und subtrahieren Sie sie jetzt vom Nenner. Die Datenqualität kommt an zweiter Stelle: konsistente Referenz-IDs, stabile Lieferantenbezeichnungen und ein Bankdaten-Feed, der keine Vorperioden neu ausweist. Wesentlichkeitsschwellen kommen an dritter Stelle - und sind der Hebel, den Menschen still ziehen, damit das Dashboard gut aussieht.
Erhöhen Sie Ihren Auto-Zertifizierungsschwellenwert von 500 $ auf 5.000 $ und Ihre Rate springt, ohne dass sich der Abgleich grundlegend verbessert. Ihr Prüfer wird es bemerken. Setzen Sie den Schwellenwert aus Ihrer bestehenden SOX-Dokumentation und lassen Sie ihn für den Pilot unverändert, dann messen Sie. Die KI-Fallstudien mit offengelegten Ergebnissen in unserem Verzeichnis sind mit demselben Filter lesenswert: Prüfen Sie, ob die gemeldete Rate die Kontotypen und den Schwellenwert nennt - denn die meisten tun es nicht.
Die Abnahmekriterien, die Sie in Ihren Pilot schreiben sollten
Schreiben Sie diese in den Bestellschein, nicht in das Kick-off-Deck. Führen Sie ein vollständiges Quartalsende durch - alle drei Monate - über Ihr gesamtes reales Kontenportfolio.
- Auto-Zertifizierungsrate von mindestens 65 % über alle Bilanzkonten im Geltungsbereich, gemessen an Ihrem aktuellen Wesentlichkeitsschwellenwert, der für die Pilotphase eingefroren wird.
- Falsch-Zertifizierungsrate von null bei wesentlichen Konten, wobei eine Falsch-Zertifizierung bedeutet, dass das Tool ein Saldo zertifiziert hat, das ein Prüfer später wieder öffnen musste. Das ist die Zahl, die den Pilot beendet, nicht die Abgleichrate.
- Jede Zertifizierung erzeugt einen exportierbaren Prüfpfad, der die abgeglichenen Quelldatensätze, die angewandte Regel oder Modellversion und den Menschen zeigt, der die Ausnahme-Warteschlange genehmigt hat.
- Überschreibungsrate wird monatlich verfolgt und Ihnen gemeldet, damit Sie den Drift erkennen, bevor es Ihr Prüfer tut.
Wenn sich der Anbieter nicht auf eine gemessene Rate mit Ihren Daten festlegen will, kalkulieren Sie das Angebot so, als würden Sie 43 % erhalten.
Prognosen: Echte Geschwindigkeitsgewinne, sehr ungleichmäßige Genauigkeitsgewinne
Kaufen Sie FP&A-KI für kürzere Zykluszeiten, nicht für eine bessere Zahl. KPMGs Umfrage vom März 2026 unter 1.013 leitenden Finanzführungskräften aus 20 Ländern ergab, dass sich die Entscheidungsgeschwindigkeit bei 71 % und die Entscheidungsqualität bei 70 % verbesserte, während sich die Prognosegenauigkeit bei 64 % verbesserte (KPMG). Diese 64 % sind der weichste der drei Werte und verbergen eine Spreizung, die breit genug ist, um einen Business Case zu kippen.
Entscheidungsgeschwindigkeit verbessert sich zuverlässiger als Prognosegenauigkeit
Geschwindigkeits- und Qualitätsgewinne entstehen bei Aufgaben, die KI gut beherrscht: Ist-Daten aus vier Systemen in eine Abweichungsansicht ziehen, den Kommentar entwerfen, ein Szenario in Minuten statt einem Tag neu berechnen. Nichts davon erfordert, dass das Modell etwas vorhersagt. Es muss zusammenfügen und erklären - der Teil, den es gut kann.
Schreiben Sie Ihre Erfolgskriterien daher in Tagen, nicht in Basispunkten. Durchlaufzeit vom Abschluss bis zur Prognose, Anzahl der Szenarien pro Zyklus, Analystenzeit für die Datenzusammenstellung. Wenn Ihr einziges Abnahmekriterium der Prognosefehler ist, setzen Sie auf das schwächste der drei von KPMG gemessenen Ergebnisse.
Warum Banking 71 % und Healthcare 44 % verzeichnet
Die Verbesserungen bei der Prognosegenauigkeit reichten in denselben KPMG-Daten von 71 % im Banking bis zu 44 % im Healthcare (KPMG). Die Lücke entspricht dem Umfang sauberer, hochfrequenter, strukturierter historischer Daten im Sektor. Banking verfügt über tägliche Transaktionsdaten, dekadenlang, bepreist und zeitgestempelt. Healthcare-Prognosen hängen von Kostenträger-Mix, Vertragsbedingungen und Erstattungstiming ab, die in Texten stehen und sich je nach Vertrag ändern.
Fragen Sie Ihren Anbieter, aus welcher dieser beiden Welten seine Referenzkunden stammen. Ein 71-%-Ergebnis in einem datenreichen Sektor sagt Ihnen fast nichts über Ihre Umsatzprognose, wenn Ihre Eingaben Vertrags-PDFs sind.
Wo FP&A-Copiloten aufhören: Die Annahme-Ebene bleibt beim Menschen
Das Modell kann Ihren Buchungstrend extrapolieren. Es kann nicht entscheiden, dass die neue Preisstaffel die Abwanderung ändert, dass der Q3-Einstellungsplan sechs Wochen verschoben wird oder dass ein Kunde, der im November neu verhandelt, um 30 % abgeschlagen werden soll. Diese Annahmen treiben die Prognose an, und sie kommen von Menschen, die mit Vertrieb und Operations sprechen.
Begrenzen Sie das Tool auf alles unterhalb der Annahme-Ebene und halten Sie die Annahmen in einem überprüfbaren Register mit Verantwortlichem und Datum für jede einzelne.
Ausgabenkategorisierung: Der dem gelösten Workflow am nächsten kommende Anwendungsfall
Wenn Sie in diesem Quartal einen KI-Finanz-Workflow pilotieren, machen Sie es die Transaktionskodierung und die Überprüfung von Ausgabenrichtlinien. Die Aufgabe ist eng, die Wahrheit ist in Ihrem eigenen Richtliniendokument niedergeschrieben, und jede Entscheidung des Agenten hinterlässt einen überprüfbaren Pfad.
Warum Richtlinienprüfungen besser zu einem Agenten passen als Urteilsvermögen
Eine Richtlinienprüfung ist eine Suche gegen Regeln, die Sie selbst geschrieben haben. Hat dieses 340-$-Abendessen einen Beleg, einen Geschäftszweck und Teilnehmer unterhalb der Pro-Kopf-Obergrenze? Das ist deterministisches Schlussfolgern über strukturierte Felder plus ein Belegbild, und die Fehlermodi sind für einen Prüfer in Sekunden sichtbar. Vergleichen Sie das mit einer Prognose, wo niemand sagen kann, ob die Zahl falsch war, bis das Quartal geschlossen ist. Kodierung liegt näher am Richtlinienende: Händler, Betrag, Abteilung, Sachkonto, mit historischer Kodierung als Labelset.
Das Volumen hilft ebenfalls. Sie erhalten Tausende nahezu identischer Entscheidungen pro Monat - genau die Form, die eine Genauigkeitsrate bedeutungsvoll statt anekdotisch macht.
Was die Genauigkeitsdefinition des Anbieters tatsächlich misst
Ramp veröffentlicht ~85 % Reduktion manueller Überprüfungen bei 99%+ Genauigkeit für seinen Policy-Agenten und definiert Genauigkeit in der Fußnote: Vom Agenten empfohlene Genehmigungen, die menschliche Prüfer ebenfalls genehmigt haben, aus einer internen Analyse vom 1.7.25 (Ramp Support). Lesen Sie diese Definition zweimal, bevor sie in einen Business Case fließt. Sie bewertet die Übereinstimmung beim Genehmigungspfad und sagt nichts über Ausgaben, die der Agent fälschlicherweise markierte und ein Prüfer rückgängig machen musste, sowie nichts über Verstöße, die er genehmigt hat und ein Prüfer durchgewunken hat. Die offengelegte Methodik stellt Ramp vor die meisten Wettbewerber, die meist einen Prozentsatz ohne Nenner veröffentlichen. Fordern Sie von jedem Anbieter auf Ihrer Shortlist dieselbe Fußnote - und behandeln Sie eine Ablehnung als Antwort.
Human-in-the-Loop-Design für die verbleibenden Ausnahmen
Leiten Sie die 15 %, die der Agent nicht freigeben wird, an einen namentlich genannten Prüfer weiter, protokollieren Sie die Überschreibungsrate und setzen Sie einen Schwellenwert, der ein Nachtraining auslöst, wenn die Überschreibungen steigen. Dieser Überschreibungsprozentsatz ist einer der Drift-KPIs, den COSO in seinem GenAI-Leitfaden vom Februar 2026 fordert (Deloitte Heads Up). Unter den 550 KI-Agenten in unserem Verzeichnis sind die lohnenden diejenigen, die Ihnen dieses Protokoll ohne Support-Ticket aushändigen.
Prüfungsvorbereitung: Belege, die Ihr Prüfer tatsächlich testen kann
Stellen Sie jedem Anbieter für Prüfungsvorbereitungen eine Frage, bevor Sie sich die Demo ansehen: Wie sieht der Export aus, wenn mein Prüferteam fragt, wie diese Zahl entstanden ist? Lautet die Antwort "ein Chat-Protokoll", kaufen Sie ein Produktivitätswerkzeug, kein Prüfungsvorbereitungs-Tool.
Kein GenAI-spezifischer PCAOB-Standard, aber AS 1105 und AS 2301 gelten bereits
Es gibt keinen PCAOB-Standard für generative KI. Das ist keine Lücke, in der Sie sitzen können. Die bestehenden Standards zu Prüfungsnachweisen und Risikobeurteilung setzen bereits die Messlatte für KI-gestützte Arbeiten (Fieldguide), was bedeutet, dass ein KI-erstellter Abschluss hinsichtlich Hinlänglichkeit und Eignung genauso bewertet wird wie eine Tabellenkalkulation, die ein Mitarbeiter von Hand erstellt hat. Ihr Prüfer braucht keine neue Regel, um ihn abzulehnen.
COSO hat die Governance-Seite am 23. Februar 2026 mit der ersten formalen Erweiterung seines Internal Control-Integrated Framework auf KI ergänzt und GenAI-Anwendungsfälle in acht Fähigkeitstypen eingeteilt, darunter Erfassung, Transformation, Buchung und Urteilsvermögen (Journal of Accountancy). Erfassung und Transformation sind die einfach zu verteidigenden. Beim Urteilsvermögen werden die Fragen lang.
Was hinreichend angemessene Belege bedeutet, wenn ein Modell sie erstellt hat
Das bedeutet, dass die Ausgabe auf ein Quelldokument zurückverfolgt werden muss, das Ihr Prüfer öffnen kann. Extraktion ist der Workflow, bei dem das am besten hält, weil das zugrundeliegende PDF oder die Rechnung weiterhin der Beleg ist und das Modell ein schnelleres Augenpaar darüber ist. Wenn Sie diese Ebene kaufen möchten, führt unser Verzeichnis 217 Dokument- und PDF-Extraktions-Tools - und die lohnenden zeigen Ihnen einen Seiten-und-Koordinaten-Verweis für jedes extrahierte Feld, keine zusammengefasste Antwort.
Sebastian Stöckle, KPMGs Global Head of Audit Innovation & AI, brachte den Test auf den Punkt: "KI liefert nur dann echten Mehrwert, wenn sie erklärt und kontrolliert werden kann" (KPMG).
Aufbewahrung, Protokollierung und Reproduzierbarkeit von Anfang an festlegen
Schreiben Sie dies in den Vertrag, denn die Nachrüstung nach einem Deployment ist teuer. Verlangen Sie: Modell- und Versionskennung, die auf jeden Durchlauf gestempelt wird; verwendeter Prompt oder verwendete Konfiguration; unveränderliche Herkunft vom Ausgabefeld bis zum Quelldokument und zur Seite; exportierbares Protokoll, wer jeden Posten mit Zeitstempel überprüft und genehmigt hat; Aufbewahrungsfenster entsprechend Ihrer Prüfungsaufbewahrungsrichtlinie statt des Standardwerts des Anbieters. Fragen Sie, was mit Ihren Protokollen passiert, wenn der Anbieter das zugrundeliegende Modell mitten im Jahr aktualisiert.
Beobachten Sie es dann weiterhin. COSOs Leitfaden fordert kontinuierliches Monitoring der Modellleistung mit KPIs wie Transaktionsvolumen, Transaktionsgröße und Überschreibungsraten, weil Set-and-Forget-Kontrollen keinen Drift erkennen (Deloitte). Die Überschreibungsrate ist die, die auf ein Dashboard gehört. Wenn Ihre Prüfer das Modell bei 30 % der Posten still korrigieren, haben Sie einen Kontrollfund in der Warteschlange und einen Business Case, der nie gelandet ist.
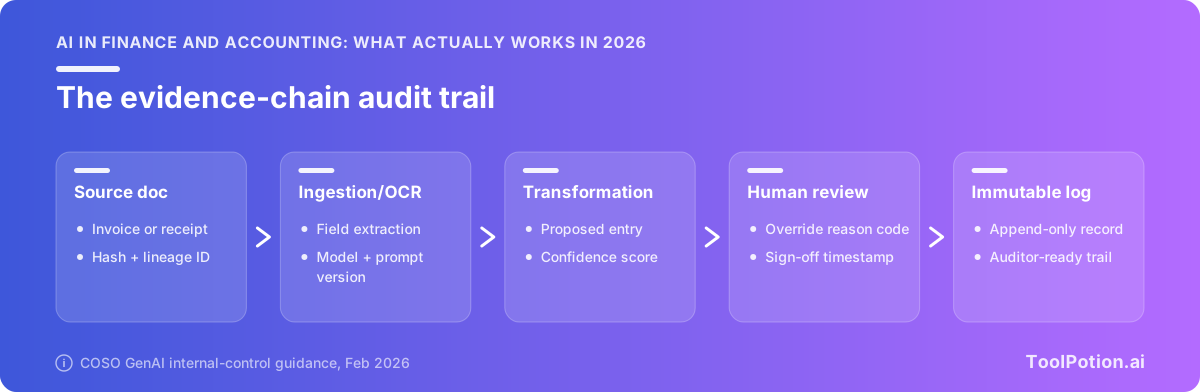
Die Kontroll-Checkliste, die Ihre Shortlist filtert
Übergeben Sie diese vor der zweiten Demo an jeden Anbieter. Der Großteil stammt direkt aus COSOs 'Achieving Effective Internal Control Over Generative AI', veröffentlicht am 23. Februar 2026 als erste formale Erweiterung des Internal Control-Integrated Framework (2013) in die KI-Governance (Journal of Accountancy). Es ist das Nächste, was Sie einem schriftlichen Standard haben, und Anbieter, die in den Finanzbereich verkaufen, sollten ihn bereits kennen.
COSOs acht GenAI-Fähigkeitstypen und welche Ihr Anwendungsfall berührt
COSO teilt GenAI-Anwendungsfälle in acht Fähigkeitstypen ein: Erfassung, Transformation, Buchung, Orchestrierung, Urteilsvermögen, Monitoring, Regulatory Intelligence und Mensch-KI-Interaktion (Journal of Accountancy). Lassen Sie sich vom Anbieter schriftlich mitteilen, welche davon sein Produkt ausführt.
Die entscheidende Grenze ist Buchung und Urteilsvermögen. Ein Tool, das nur Dokumente erfasst und in einen Entwurf transformiert, ist ein anderes Kontrollproblem als eines, das ins Hauptbuch schreibt oder entscheidet, ob eine Ausnahme akzeptabel ist. Ausgabenkodierung berührt üblicherweise Erfassung, Transformation und Urteilsvermögen. Abstimmungs-Auto-Zertifizierung berührt Buchung. Lautet die Antwort des Anbieters "alle acht", hat er ihn auch nicht gelesen.
Von der einmaligen Zusicherung zur kontinuierlichen Überwachung
Ihr alter SOC-Walkthrough deckt kein Modell ab, das zwischen Quartalen driftet. COSOs Leitfaden fordert kontinuierliches Monitoring der Modellleistung statt statischer, einmaliger Zusicherungen, mit KPIs, die auf Transaktionsvolumen, Transaktionsgröße und Überschreibungsraten ausgerichtet sind, um Drift zu erkennen. Set-and-Forget-Kontrollen sind ausdrücklich unzureichend (Deloitte Heads Up).
Die Überschreibungsrate und Drift-KPIs, die Sie im Vertrag fordern sollten
- Überschreibungsrate nach Benutzer und Transaktionstyp, monatlich exportierbar, nicht nur im Dashboard sichtbar.
- Modellversionsverlauf mit Daten, damit Sie eine Änderung der Fehlerrate einem bestimmten Release zuordnen können statt zu raten.
- Genauigkeit gemessen an Ihren Daten während eines von Ihnen definierten Parallelbetriebszeitraums, mit schriftlich festgehaltenem Nenner.
- Ein benannter Schwellenwert, der eine Überprüfung auslöst. Legen Sie jetzt eine Zahl fest (z. B. Überschreibungsrate über 8 % in einem Monat) und schreiben Sie sie in den Vertrag.
Prüfungsbereitschaft ist die Variable, die Ergebnisse vorhersagt
KPMG stellte fest, dass nur 42 % der Organisationen vollständig prüfungsbereit sind, und der Ergebnisunterschied ist nicht subtil: Diese Unternehmen melden Fehlerreduzierungsverbesserungen von 33 % gegenüber 6 % bei nicht bereiten Wettbewerbern, und Vertrauen in die Skalierung von KI von 42 % gegenüber 14 % (KPMG).
KI liefert nur dann echten Mehrwert, wenn sie erklärt und kontrolliert werden kann. Prüfungsbereitschaft unterscheidet nachhaltige Leistung von verborgenem Risiko. - Sebastian Stöckle, Global Head of Audit Innovation & AI, KPMG International
Führen Sie die Checkliste vor der Shortlist-Erstellung durch, nicht danach. Unsere Finanz- und Banking-Kategorie hat 309 Einträge, und die Checkliste reduziert das schneller auf eine Handvoll als jeder Funktionsvergleich.
Lesen Sie jede Genauigkeitsbehauptung gegen ihre eigene Fußnote
Jede Leistungszahl in einer Finanz-KI-Demo ist eine Messung, und eine Messung ohne ihre Population, ihre Definition von "korrekt" und ihr Datum ist ein Marketing-Asset. Die Fußnoten sind meist veröffentlicht. Fast niemand liest sie.
Drei Fragen, die die meisten Zahlen entzaubern
Stellen Sie diese der Reihe nach, schriftlich, vor der zweiten Demo.
- Welche Transaktionen wurden gezählt? Nicht das Gesamtvolumen, sondern die Teilmenge, über die die Zahl berechnet wurde.
- Was machte eine Antwort korrekt? Jemand hat eine Wahrheit definiert. Holen Sie sich diese Definition im Wortlaut.
- Wann wurde gemessen, und auf wessen Daten? Eine einzelne interne Analyse vom letzten Jahr ist kein Service Level.
Nenner, Daten und selbst ausgewählte Vergleiche
Ramps Policy-Agent veröffentlicht eine Reduktion manueller Ausgabenprüfungen um ~85 % bei 99%+ Genauigkeit, und seine eigene Dokumentation definiert diese Genauigkeit als vom Agenten empfohlene Genehmigungen, die menschliche Prüfer ebenfalls genehmigt haben, aus einer internen Analyse vom 1.7.25 (Ramp Support). Das ist ein Übereinstimmungsmaß für den Genehmigungspfad. Es sagt nichts über Ausgaben, die der Agent fälschlicherweise markierte und ein Prüfer rückgängig machen musste - genau der Fehlertyp, den Ihr Controller interessiert.
Abstimmungsbehauptungen scheitern anders. Die Auto-Zertifizierungszahl wird als Obergrenze angegeben, "bis zu 98 %", während Kundeneinsätze in einem Bereich von 43 % bis 85 % landen (Numeric). Eine Obergrenze ist eine Aussage über das beste Konto im besten Monat beim besten Kunden.
Wie eine glaubwürdige Offenlegung aussieht
Sie nennt Stichprobengröße, Bewertungsregel und Datum - so wie Ramp es tut - und berichtet die Falsch-Genehmigungs-Rate neben der Genauigkeitsrate. Verlangen Sie die Zahl, berechnet auf Ihren eigenen Daten des letzten Quartals während des Pilots. Ein Anbieter, der diesen Test nicht durchführt, hat Ihnen gesagt, was seine Fußnote sagen würde.
Warum Demos beim Monatsabschluss scheitern und welches Pilot-Design das verhindert
Eine Demo läuft auf einem kuratierten Extrakt. Das saubere Nebenbuch des letzten Quartals, ein Dutzend wohlgeformte Rechnungen, kein Intercompany, kein manuelles Journal, das das Steuerteam um 23 Uhr an Tag drei gebucht hat. Der Abschluss ist die entgegengesetzte Population, und jeder Fehlermodus, den ein Vertriebsingenieur aus einem Gespräch herausfiltern würde, taucht auf einmal auf, unter Zeitdruck, vor Ihrem Controller.
Retrieval-Aufbau dominiert die Genauigkeit mehr als die Modellwahl
Tauschen Sie ein Frontier-Modell gegen ein anderes auf demselben Finanzfrage-Set aus, und die Antworten verschieben sich etwas. Ändern Sie die Chunking-Methode für Dokumente, welche Periode abgerufen wird und ob Fußnoten mit der Tabelle mitgenommen werden - und die Antworten verschieben sich erheblich. Die meisten falschen Antworten im Finanz-QA sind Retrieval-Fehler in einem fehlerfreien Satz: Das Tool fand den GJ24-Abschluss, als Sie nach GJ25 fragten, und der Prosatext liest sich in beiden Fällen perfekt.
COSOs Leitfaden vom Februar 2026 behandelt Erfassung und Transformation als von Urteilsvermögen separate Fähigkeitstypen, jeweils mit eigenen Kontrollen (Journal of Accountancy). Testen Sie die Pipeline an Ihren eigenen unordentlichen Quelldateien. Das Muster des Anbieters sagt Ihnen fast nichts.
Erfahrene Prüfer erfassen den Großteil des Gewinns
Geben Sie das Tool Ihren zwei stärksten Senior-Mitarbeitern, bevor Sie es an das Personal weitergeben. Feldforschung zur Quantifizierung der Zeitersparnisse von KI für CPAs zeigt in dieselbe Richtung: Die Stunden landen bei Menschen, die bereits wissen, wie eine richtige Antwort aussieht, und eine falsche in Sekunden erkennen (Journal of Accountancy).
Überspringen Sie die Prüfschicht und Sie erhalten das Deloitte-Ergebnis: Eine Rückerstattung von mehr als 60.000 $ an die australische Regierung für einen Bericht mit KI-generierten Fehlern (CFO Dive).
Kosten, unklarer Mehrwert und schwache Risikokontrollen bringen agentische Projekte zum Scheitern
Modell-Fähigkeiten sind selten das, was diese Programme zum Stillstand bringt. Deloittes Finance Trends Survey unter 1.326 Finanzführungskräften ergab, dass 63 % KI im Finanzbereich vollständig implementiert hatten, während nur 21 % greifbaren Mehrwert sahen und 14 % KI-Agenten vollständig integriert hatten (CFO Dive). Thomson Reuters beziffert die agentische Adoption auf 15 % gegenüber 53 % Planenden oder Überlegenden (Thomson Reuters). In Deloittes CFO Signals Q2 2026 nannten 59 % der CFOs die Balance zwischen Deployment-Druck und Risiko als ihre größte Herausforderung, und 51 % gaben an, keine Governance-Autorität zu haben (Deloitte).
Ein 90-Tage-Pilot mit im Voraus aufgeschriebenen Zahlen
- Wählen Sie einen Workflow und eine Einheit. Abstimmung für eine einzelne Tochtergesellschaft schlägt einen unternehmensweiten Rollout, den Sie nicht messen können.
- Erfassen Sie die Ausgangslage für zwei Abschlüsse, bevor das Tool irgendetwas berührt: aufgewendete Stunden, Ausnahmeanzahl, Nacharbeitsrate, Tage bis zur Zertifizierung.
- Vereinbaren Sie den Abnahmeschwellenwert schriftlich mit Ihrem Controller und dem Prüfungspartner Ihres externen Prüfers, und setzen Sie ein Datum.
- Überwachen Sie die Überschreibungsraten wöchentlich, zusammen mit Transaktionsvolumen und Transaktionsgröße - das ist das Drift-Signal, auf dem COSOs kontinuierliche Monitoring-Erwartung aufbaut (Deloitte Heads Up).
- Schreiben Sie das Abbruchkriterium am ersten Tag auf. Zum Beispiel: Wenn die Auto-Zertifizierung an Tag 90 unter 55 % liegt oder die Prüfer-Überschreibung drei aufeinanderfolgende Wochen 15 % übersteigt, stoppen wir und verhandeln neu.
Veröffentlichen Sie das Ergebnis dann intern, Zahlen inklusive, so wie es Teams tun, die echte Deployments dokumentieren in unserem Verzeichnis. Nur 18 % der Organisationen verfolgen den KI-ROI in irgendeiner Form (Thomson Reuters), daher bringt Sie eine einzelne schriftliche Ausgangslage bei der Verlängerung vor vier von fünf Käufern.
Häufig gestellte Fragen
Ist KI 2026 zuverlässig genug, um Buchhaltung ohne menschliche Prüfung zu erledigen?
Nein, und die Kontrollrahmen gehen jetzt davon aus, dass Sie einen Prüfer behalten. KPMG beziffert die aktive KI-Nutzung in der Finanzfunktion auf 75 % im Jahr 2026, gegenüber 30 % im Jahr 2024, aber nur 42 % der Organisationen sind vollständig prüfungsbereit, und diejenigen, die es sind, berichten von Fehlerreduzierungsgewinnen von 33 % gegenüber 6 % bei den übrigen (KPMG, 11. Mai 2026). COSOs Leitfaden vom Februar 2026 behandelt "Set-and-Forget"-Kontrollen als ausdrücklich unzureichend und fordert stattdessen kontinuierliches Monitoring der Modellleistung (Deloitte Heads Up). Ungeprüfte Ausgaben haben bereits einen Preis: Deloitte erstattete der australischen Regierung über 60.000 $ für einen Bericht mit KI-Fehlern (CFO Dive).
Welche Auto-Match-Rate sollte ich von KI-Abstimmungssoftware erwarten?
Planen Sie mit 60 % bis 80 % Auto-Zertifizierung, nicht mit der Folienzahl. Abstimmungsanbieter vermarkten "bis zu 98 %" automatisch zertifiziert bei 99 % Abgleichgenauigkeit, während beobachtete Kundenergebnisse in einem Bereich von 43 % bis 85 % landen (Numeric). Schreiben Sie die Rate in Ihre Abnahmekriterien und messen Sie sie an Ihrem eigenen historischen Hauptbuch während des Pilots - nicht an Demo-Daten -, und messen Sie nach drei Abschlüssen neu, da die Abgleichqualität driftet, wenn sich Ihr Transaktionsmix ändert (Deloitte Heads Up zu COSO).
Was verlangt der COSO-Leitfaden vom Februar 2026 für KI in der Finanzberichterstattung?
COSO veröffentlichte "Achieving Effective Internal Control Over Generative AI" am 23. Februar 2026, die erste formale Erweiterung seines Internal Control-Integrated Framework von 2013 in die KI-Governance, und teilt GenAI-Anwendungsfälle in acht Fähigkeitstypen ein: Erfassung, Transformation, Buchung, Orchestrierung, Urteilsvermögen, Monitoring, Regulatory Intelligence und Mensch-KI-Interaktion (Journal of Accountancy). Die operative Anforderung ist ein Wechsel von einmaliger Zusicherung zu kontinuierlichem Monitoring, mit KPIs wie Transaktionsvolumen, Transaktionsgröße und Überschreibungsraten zur Erkennung von Modell-Drift (Deloitte Heads Up). Klassifizieren Sie jedes Tool, das Sie betreiben, nach Fähigkeitstyp, legen Sie einen Schwellenwert für jeden KPI fest und protokollieren Sie Überschreibungen vom ersten Tag an, denn ein Buchungs- oder Urteilsvermögen-Tool trägt weitaus höhere Kontrollerwartungen als ein Erfassungs-Tool.
Akzeptiert mein Prüfer mit generativer KI erstellte Arbeitspapiere?
Ja, wenn Sie zeigen können, wie die Ausgabe erstellt wurde und wer sie überprüft hat. Das PCAOB hat keinen Standard für generative KI erlassen, und seine bestehenden Standards zu Prüfungsnachweisen und Risikobeurteilung setzen bereits die Messlatte für Hinlänglichkeit, Eignung und Überprüfbarkeit (Fieldguide). Bewahren Sie den Prompt, die vom Tool abgerufenen Quelldokumente, das Modell und die Version, das Datum sowie die Unterschriften von Ersteller und Prüfer auf, damit das Arbeitspapier für sich steht, ohne dass jemand das Modell neu ausführt. Erwarten Sie schärfere Fragen: PwC hat dem PCAOB mitgeteilt, dass KI in der Prüfung seine vorrangige Priorität sein soll (Big4 News).
Wie berechne ich den ROI eines KI-Finanz-Tools, wenn nur 18 % der Organisationen ihn verfolgen?
Erfassen Sie die Ausgangslage, bevor der Pilot beginnt, denn Sie können sie später nicht mehr rekonstruieren. Nur 18 % der Fachleute wussten 2026, dass ihre Organisation den KI-ROI in irgendeiner Form verfolgt - nahezu unverändert gegenüber 2025 -, und die meisten davon messen interne operative Kennzahlen statt Geschäftsergebnisse (Thomson Reuters, 9. Feb. 2026). Die dadurch entstehende Lücke ist in Deloittes Finance Trends Survey unter 1.326 Finanzführungskräften sichtbar: 63 % haben KI im Finanzbereich vollständig implementiert und 21 % glauben, dass sie greifbaren Mehrwert geliefert hat (CFO Dive). Verfolgen Sie vier Zahlen über ein festes Zeitfenster: Stunden bis zum Abschluss, Ausnahmerate, Zykluszeit pro Transaktion und vollständige Kosten einschließlich der Prüfzeit, die das Tool erzeugt. KPMGs Feststellung, dass 71 % der Finanzführungskräfte sagen, KI erfülle oder übertreffe ROI-Erwartungen, misst Erwartungen - ersetzen Sie es nicht durch Ihre eigenen Zahlen (KPMG).
Welchen Finanz-Workflow sollte ich zuerst automatisieren?
Ausgabenkategorisierung und Richtlinienprüfung, vor allem weil es der einzige Workflow ist, bei dem ein Anbieter veröffentlicht, was seine Genauigkeitszahl bedeutet: Ramp berichtet von ~85 % weniger manuellen Prüfungen bei 99%+ Genauigkeit, definiert als vom Agenten empfohlene Genehmigungen, die menschliche Prüfer ebenfalls genehmigt haben, aus einer internen Analyse vom 1.7.25 (Ramp). Abstimmung kommt an zweiter Stelle, da die erreichbare Abgleichrate deutlich unter der vermarkteten liegt und einen bezahlten Pilot mit Ihren Daten erfordert (Numeric). Prognosen kommen später: 44 % der CFOs bei Unternehmen mit mehr als 1 Mrd. $ nutzen bereits KI für Planung und Budgetierung (Deloitte Q2 2026 CFO Signals), aber die Genauigkeitsgewinne schwanken stark nach Sektor, von 71 % im Banking bis zu 44 % im Healthcare (KPMG). Grenzen Sie das Feld ein, bevor Sie irgendetwas demonstrieren, denn unser Verzeichnis allein führt 550 KI-Agenten, und sehr wenige wurden für einen kontrollierten Abschluss entwickelt.