

Ihre multimodale Pipeline wird nicht scheitern, weil ein Modell halluziniert. Sie wird scheitern, weil Soras Download-URL 61 Minuten nach dem Rendern abgelaufen ist, oder weil Ihr 90-minütiger Podcast das 25-MB-Transkriptionslimit von OpenAI überschritten hat, während AssemblyAI die gesamten 5 GB in einer einzigen Anfrage verarbeitet hätte.
Jeder Schritt zwischen den Modellen hat einen Vertrag: ein genaues Dateiformat, eine Plantier, die es freischaltet, ein Ablaufzeitfenster und einen Fallback für den Fall, dass der Anbieter das Modell abkündigt. Die meisten Guides überspringen alle vier.
Dieser hier gibt Ihnen die Verträge, drei ausgearbeitete Pipelines und den Wechselplan, den Sie brauchen, bevor OpenAI die Videos API und beide Sora-2-Modelle am 24. September 2026 ohne genannten Nachfolger abschaltet. Das sind noch 19 Tage.
Warum multimodale Pipelines an den Übergaben scheitern, nicht an den Modellen
Jedes Modell in Ihrer Kette funktioniert. Die Transkription ist korrekt, das Bild sieht richtig aus, die Stimme klingt menschlich, das Video wird gerendert. Was scheitert, ist der Moment, in dem der Output eines Modells zum Input des nächsten werden muss, und niemand hat aufgeschrieben, wie dieser Output aussehen sollte.
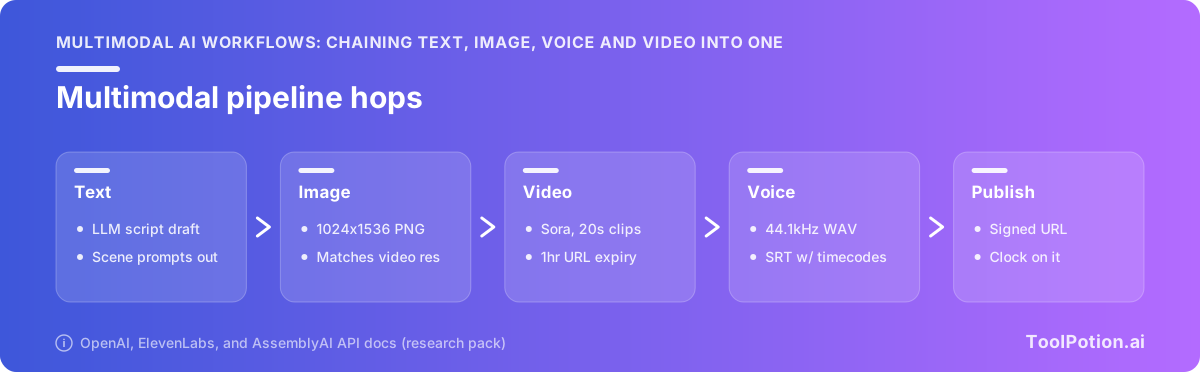
Ein konkretes Beispiel: Soras Download-URLs für generierte Assets bleiben maximal eine Stunde nach der Generierung gültig, und der Output kommt als MP4 plus WebP-Thumbnail und JPG-Spritesheet an (OpenAI). Wenn Ihre Pipeline das Rendering in die Warteschlange stellt und 90 Minuten später zum Kopierschritt gelangt, ist das Rendering weg. Das Modell hat seinen Job einwandfrei erledigt.
Der Übergabevertrag: Format, Tier, Ablaufzeit, Fallback
Behandeln Sie jeden Schritt als einen Vertrag mit vier Bedingungen, die Sie aufschreiben, bevor Sie irgendetwas bauen.
Format ist die genaue Dateispezifikation, die der nächste Schritt verlangt, bis hin zu Abtastrate und Pixelabmessungen – nicht ein Seitenverhältnis und Hoffnung. Tier ist die Planstufe oder der einzelne API-Parameter, der dieses Format freischaltet, weil viele der Formate, die Sie brauchen, hinter einem kostenpflichtigen Abo oder einem alten Modellnamen stecken. Ablaufzeit ist, wie lange das Artefakt beim Anbieter abrufbar bleibt, bevor Sie den Verlust tragen. Fallback ist, was Sie einwechseln, wenn der Anbieter das Modell einstellt – was gerade kein hypothetisches Szenario ist.
Schreiben Sie diese vier Zeilen pro Schritt auf, und die meisten Debugging-Probleme verschwinden, bevor Sie anfangen.
Vier Fehlerquellen, die eine Pipeline mittendrin zum Absturz bringen
- Der vorgelagerte Schritt gibt ein Format aus, das der nachgelagerte Schritt stillschweigend herabstuft oder ganz ablehnt.
- Eine Funktion, die Sie in der API vorausgesetzt haben, steckt hinter einer höheren Planstufe oder einer älteren Modellversion.
- Das Artefakt läuft im Speicher des Anbieters ab, während Ihr Job noch in der Warteschlange ist.
- Das Modell, auf dem Sie aufgebaut haben, erhält ein Abschaltdatum, und der Anbieter nennt keinen empfohlenen Nachfolger.
Die drei folgenden Pipelines sind allesamt Beispiele desselben Vertrags: Podcast zu Show Notes, Skript zu nariertem Video und Produktfoto zu Kampagnenset. Jede benennt Format, Tier, Ablaufzeit und Fallback an jedem Schritt.
Dieser Artikel richtet sich an jemanden, der ein Ergebnis liefern will, nicht an jemanden, der Fusionsarchitekturen vergleicht. Die einzelnen Tools können Sie aus den 18.982 aktiven KI-Tools in unserem Verzeichnis auswählen. Wie man sie zusammenverkabelt, ist der Teil, den niemand dokumentiert.
Pipeline 1: Blogbeitrag zu nariertem Video
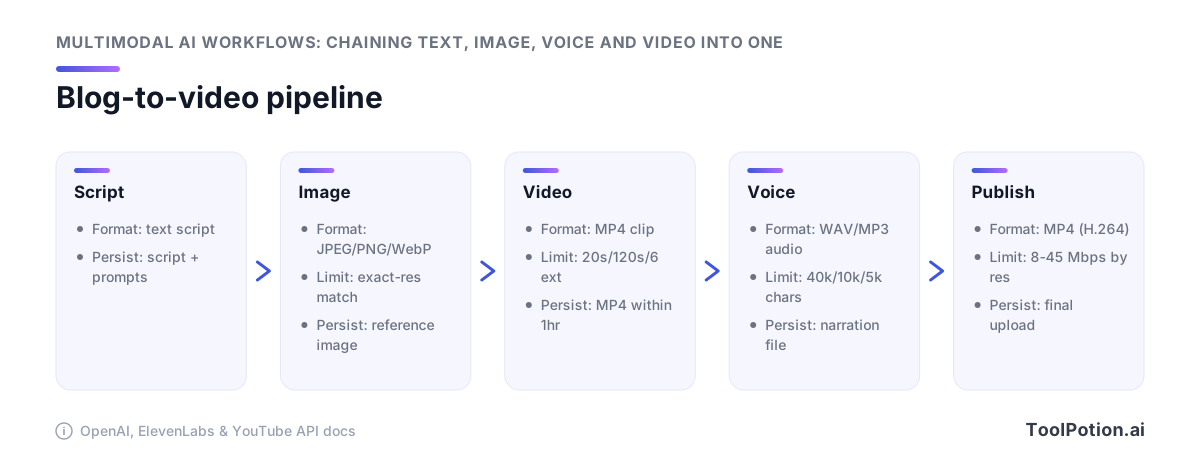
Sie nehmen einen Artikel mit 1.200 Wörtern und wollen am anderen Ende ein zweiminütiges nariertes Video. Vier Schritte: Text aufteilen, Standbilder generieren, animieren, vertonen. Jeder dieser Schritte hat eine Spezifikation, die der vorherige erfüllen muss – und die meisten dieser Spezifikationen legen Sie fest, bevor Sie einen einzigen API-Aufruf machen.
Skriptsegmentierung vor jedem Generierungsaufruf
Segmentierung ist kein Formatierungsschritt, den Sie am Ende erledigen. Es ist der Parameter, den alle nachgelagerten Schritte erben, weil das Sprachmodell, das Sie wählen, vorgibt, was Sie pro Anfrage senden können. Eleven Flash v2.5 nimmt 40.000 Zeichen, Multilingual v2 nimmt 10.000, und v3 stoppt bei 5.000 (ElevenLabs). Wählen Sie v3 für ausdrucksstarke Narration und Ihr 1.200-Wörter-Skript passt in einen Aufruf. Wählen Sie es für einen 9.000-Wörter-Erklärartikel und Sie teilen es in zwei Teile auf, mit einer Naht, die Sie verstecken müssen.
Segmentieren Sie an Szenengrenzen, nicht nach Satzzahlen. Jedes Segment braucht eine visuelle Idee, eine Zieldauer in Sekunden und eine Zielpixelauflösung als Metadaten. Dieses letzte Feld ist es, das der Bildschritt liest.
Bildschritt: exakte Pixelabmessungen des Videoschritts einhalten
Soras Bild-zu-Video-Pfad erfordert, dass das Referenzbild exakt mit der Ziel-Videoauflösung übereinstimmt, in image/jpeg, image/png oder image/webp (OpenAI). Exakt bedeutet Pixel, nicht „16:9“. Ein Bildgenerator, dem man aufträgt, ein Breitbild-Standbild zu erzeugen, liefert gern 1792x1024, wenn der Video-Aufruf 1280x720 erwartet – und der Job schlägt bei der Einreichung fehl, nicht beim Rendern. Das Bild-Prompt-Template trägt daher Breite und Höhe als ganze Zahlen, die aus der Konfiguration des Videoschritts gezogen werden, und Sie validieren die Abmessungen und den MIME-Typ der zurückgegebenen Datei, bevor Sie irgendetwas in die Warteschlange stellen. Unter den 324 KI-Modellen in unserem Verzeichnis sind diejenigen am wertvollsten, die beliebige Pixelabmessungen statt vordefinierter Voreinstellungen erlauben.
Videoschritt: 16- und 20-Sekunden-Clips, verkettet
Sowohl sora-2 als auch sora-2-pro generieren 16- oder 20-Sekunden-Clips. Jede Erweiterung fügt bis zu 20 Sekunden hinzu, begrenzt auf sechs Erweiterungen und 120 Sekunden insgesamt (OpenAI). Ihr zweiminütiges Segment ist sechs verkettete Aufrufe.
Die Kontinuität über diese sechs Aufrufe hinweg ist Ihr Problem. Das Modell erinnert sich nicht an den narrativen Bogen zwischen Erweiterung 3 und Erweiterung 4, also muss der Prompt für jeden Aufruf die Szenerie, das Motiv und das Kameraverhalten neu beschreiben. Planen Sie Wiederholungsversuche an den Nahtstellen ein.
Sprachschritt und der Mux
Generieren Sie Narration pro Segment, nicht pro Video, damit ein schlechter Take nur einen Aufruf kostet. Dann synchronisieren: Das Audio für Segment 4 muss in den 20-Sekunden-Clip passen, den Sie für Segment 4 gerendert haben – was in der Regel bedeutet, den Skripttext zu kürzen statt das Audio zu strecken. Mux mit ffmpeg, ein Segment nach dem anderen, dann zusammenfügen.
Pipeline 2: Podcast-Episode zu Clips und Show Notes
Eine 58-minütige WAV-Datei geht rein. Heraus kommen ein Transkript, Kapitel mit Zeitstempeln, sechs vertikale Clips mit eingebrannten Untertiteln und eine Show-Notes-Seite. Das Audioformat ändert sich nach dem ersten Schritt nicht mehr, was diese Pipeline einfacher macht als die Video-Pipeline. Entscheidend dafür, ob sie funktioniert, ist, welchen Transkriptionsanbieter Sie wählen und welche drei Parameter Sie in der Anfrage setzen.
Die 25-MB-Mauer und wie man sie umgeht
Der Transkriptionsendpunkt von OpenAI begrenzt Uploads auf 25 MB und akzeptiert mp3, mp4, mpeg, mpga, m4a, wav und webm (OpenAI). Eine 58-minütige 48-kHz-WAV ist ungefähr 300 MB. Also müssen Sie entweder in ein MP3 mit niedriger Bitrate transkodieren und hoffen, oder die Datei aufteilen – wobei das Aufteilen von Audio an beliebigen Byte-Grenzen Wörter mittendurch schneidet und jeden Zeitstempel nach der Naht verschiebt.
AssemblyAI akzeptiert bis zu 5 GB pro Anfrage auf /v2/transcript (2,2 GB bei lokalen Uploads über /v2/upload) und verarbeitet alles von 160 ms bis 10 Stunden (AssemblyAI). Das ist etwa das 200-Fache der Obergrenze. Senden Sie für Langform-Audio die ganze Episode dorthin und behalten Sie Ihren LLM-Anbieter für die Reasoning-Schritte weiter unten in der Kette.
Wort-genaue Zeitstempel sind das Schnitt-Grundelement
Sie können keine Clips automatisch aus einem Transkript schneiden, das nur Absatzgrenzen hat. Sie müssen wissen, dass das Wort „jedenfalls“ bei 00:41:12.340 beginnt, damit der Schnitt davor landet und nicht mittendurch.
Zwei Einschränkungen auf der OpenAI-Seite. SRT- und VTT-Ausgabe sowie der Parameter timestamp_granularities[] funktionieren nur mit whisper-1, nicht mit gpt-transcribe oder gpt-4o-transcribe (OpenAI). Wenn Ihre Pipeline Untertitel einbrennt oder auf Timecode schneidet, behalten Sie das ältere Modell absichtlich in der Kette und hören auf, es als technische Schuld zu behandeln. ElevenLabs Scribe v2 liefert wortgenaue Zeitstempel, Diarisierung und Entitätserkennung in über 90 Sprachen in einer einzigen Antwort (ElevenLabs) – die sauberere Wahl, wenn Sie ohnehin für den TTS-Schritt zahlen.
Diarisierung funktioniert nur, wenn Sie sie anfordern
Sprechermarkierungen erfordern, dass chunking_strategy für jedes Audio länger als 30 Sekunden auf auto gesetzt ist, und gpt-4o-transcribe-diarize macht nur Sprecheridentifikation (OpenAI). Lassen Sie den Parameter weg, und die Anfrage gelingt trotzdem. Sie erhalten einen sauberen, flüssigen, vollständig unmarkierten Textblock, und nichts in der Antwort sagt Ihnen, dass ein Zwei-Host-Interview gerade zu einer einzigen Stimme zusammengefallen ist. Prüfen Sie in Ihrem Validierungsschritt auf Sprecherfelder – nicht mit dem Auge.
Vom Transkript zu Show Notes, Kapiteln und Social-Copy
Ein Transkript mit Worttimings verzweigt sich in vier Artefakte, ohne weitere Audioverarbeitung: Kapitelmarkierungen aus Themenwechseln, ein Zusammenfassungsabsatz plus Linkliste für die Show-Notes-Seite, priorisierte Clip-Kandidaten nach Zitatdichte sowie die vertikalen Schnitte selbst, gerendert aus diesen In- und Out-Punkten. Speisen Sie dasselbe Transkript mit unterschiedlichen Prompts parallel in alle vier. Wenn Sie vor dem Bauen nach Formatreferenzen suchen: In unserem Verzeichnis gibt es 201 KI-Podcasts, die auf ungefähr diesem Stack veröffentlichen.
Pipeline 3: Produktfotos zu Anzeigenvarianten
Ein Studiofoto eines Schuhs wird zu zwölf markenkonformen Standbildern, dann zu vier 8-Sekunden-Bewegtanzeigen für Paid Social. Die Schritte sind Bild rein, Bild raus, Video raus – und das interessante Engineering sitzt zwischen Schritt zwei und drei, wo ein Vision-Modell das prüft, was der Bildgenerator produziert hat, und entscheidet, ob es ausgeliefert wird.
Vision-Modell-Review als QA-Gate
Generierte Produktbilder scheitern auf langweilige Weisen. Falsches Logo-Placement, sechs Ösen statt fünf, ein Schatten, der dem Hauptlicht widerspricht. Sie wollen kein Mensch, der 120 Varianten durchschaut, also schicken Sie sie mit dem Quellbild und einer schriftlichen Markenspezifikation an ein Vision-Modell und bitten um Bestehen/Nichtbestehen plus einen Erklärungsstring.
Claude akzeptiert bis zu 100 Bilder pro Anfrage bei 200k-Kontext-Modellen und 600 bei anderen Modellen, mit 20 pro Nachricht auf claude.ai, begrenzt auf 8000x8000 px und 10 MB pro Bild (Claude Docs). Das sind nicht die Zahlen, die Sie treffen werden.
Das 32-MB-Standard-Anfragelimit ist es. Zwölf 4K-PNGs sprengen es, lange bevor Sie 100 Bilder erreichen, weshalb Anthropic empfiehlt, über die Files API hochzuladen und jedes Bild per file_id zu referenzieren statt Base64 einzubetten (Claude Docs). Bauen Sie den Review-Schritt von Anfang an so. Ihn später nachzurüsten, wenn Ihre Batch-Größen wachsen, bedeutet, den Request-Builder und die Retry-Logik gleichzeitig umzuschreiben.
Frame-Sampling ist ein direkter Kostenhebel
Claude berechnet Bilder als 28x28-Pixel-Visual-Tokens, berechnet als ⌈Breite/28⌉ × ⌈Höhe/28⌉. Ein 3840x2160-Frame kostet 4.784 Visual-Tokens auf der High-Resolution-Tier und 1.560 nach dem Downscaling auf der Standard-Tier, ungefähr 23,92 $ pro tausend 4K-Frames beim Input-Preis von Claude Opus 5 von 5 $/M (Claude Docs). Skalieren Sie herunter, bevor Sie senden – außer wenn die QA-Prüfung von Feindetails wie Nähten oder kleinem Text abhängt.
Dieselbe Rechnung gilt für den Video-Analyse-Schritt. Vier 8-Sekunden-Anzeigen bei 24 fps naiv zu reviewen ergibt 768 Frames. Bei 2 fps sampeln, 64 prüfen, und Ihre Review-Kosten sinken um den Faktor zwölf, ohne einen einzigen Szenenwechsel zu verpassen.
Bilder in Batches verarbeiten, ohne die Anfragegrenze zu treffen
Gruppieren Sie nach Payload-Bytes, nicht nach Bildanzahl. Sortieren Sie Varianten in Gruppen, die unter etwa 25 MB an Referenzen bleiben, behalten Sie das Quellbild in jedem Batch als Vergleichsanker, und senden Sie Fehler einzeln bei voller Auflösung erneut, damit der Erklärungsstring lesbar ist. Unser Verzeichnis führt 727 Bildgeneratoren und 342 Fotoeditoren unter den KI-Bild- und Foto-Tools, und fast keines davon legt die Batch-Mechanik offen, die Sie hier brauchen. Dieser Teil bleibt Ihr Code.
Das Übergabe-Datenblatt: Was an jedem Schritt zu fordern ist
Schreiben Sie den Vertrag, bevor Sie den Code schreiben. Jeder Schritt in einer Kette hat drei Dinge, die Sie festnageln müssen: das genaue Ausgabeformat, das Sie anfordern, die Planstufe oder den Parameter, der es freischaltet, und wie lange das Artefakt erhalten bleibt, bevor es weg ist. Machen Sie das falsch, und der Fehler taucht zwei Schritte später als eine Qualitätsbeschwerde auf, die niemand zurückverfolgen kann.
Audio: Die Tier, die broadcast-qualitative Ausgabe freischaltet
ElevenLabs steckt pcm_44100, pcm_48000, wav_44100 und wav_48000 hinter ein Pro-Abo, und mp3_44100_192 hinter Creator (ElevenLabs API-Referenz). Auf einem kostenlosen oder Einstiegsplan erhält Ihr Videoeditor also ein verlustbehaftetes MP3 mit 128 kbps oder weniger, egal wie gut das Sprachmodell ist. Das ist eine Qualitätsgrenze, die durch Abrechnung gesetzt wird, nicht durch Inferenz.
Wenn Ihr Lieferergebnis ein Podcast ist, der -16 LKFS mit True Peak bei oder unter -1 dBFS erreichen muss (Apple Podcasts), wollen Sie verlustfreies Audio rein und eine einzige Kodierung am Ende. Ein 128-kbps-MP3 zu normalisieren und neu zu kodieren stapelt zwei verlustbehaftete Generierungen. Rechnen Sie den Pro-Tier als Produktionskosten, nicht als Upgrade.
Video: ablaufende URLs und Begleit-Assets
Sora händigt Ihnen nicht eine Datei aus. Ein abgeschlossenes Rendering liefert eine MP4, ein WebP-Thumbnail und ein JPG-Spritesheet, und die Download-URLs bleiben maximal eine Stunde gültig (OpenAI-Videoleitfaden). Ihre Aufgabe an diesem Schritt ist eine Kopie in Ihren eigenen Objektspeicher, ausgelöst durch das Abschlussereignis – nicht durch einen nächtlichen Batch. Verpassen Sie das Fenster, ist das Rendering nicht wiederherstellbar.
Text und Timing: Die Felder, die nachgelagerte Schritte benötigen
Nachgelagerte Schritte benötigen zwingend bestimmte Felder, und die, die Timing brauchen, sind diejenigen, die lautlos brechen. SRT- und VTT-Ausgabe plus timestamp_granularities[] funktionieren nur mit whisper-1, nicht mit den neueren Transkriptionsmodellen (OpenAI Sprache zu Text). Alles, was Clips schneidet oder Untertitel einbrennt, braucht wortgenaue Zeitstempel im Vertrag.
| Schritt | Diese Ausgabe fordern | Was sie freischaltet | Ablaufzeit |
|---|---|---|---|
| Text zu Sprache | wav_48000 oder pcm_44100 | Pro-Tier; Creator für mp3_44100_192 | Kein Ablauf, beim Schreiben speichern |
| Sprache zu Text | Wortgenaue Zeitstempel, Sprechermarkierungen | whisper-1 für SRT/VTT; chunking_strategy: auto über 30 s für Diarisierung | Kein Ablauf |
| Bild zu Video | MP4 plus Thumbnail und Spritesheet | Referenzbild muss exakt mit der Videoauflösung übereinstimmen | 1 Stunde bei Download-URLs |
| Video zu Text | Gesampelte Frames mit fester Rate | Standard- vs. High-Res-Tier ändert Visual-Token-Kosten um ca. 3x | Kein Ablauf |
Welchen Orchestrator Sie auch aus den 128 KI-Frameworks in unserem Verzeichnis wählen, testen Sie ihn zuerst gegen die Binär-Schritte. JSON zwischen Modellen weiterzureichen ist der einfache Teil.
Automatisierungsplattform oder manueller Kleber
Die Regel ist einfach: Lassen Sie die Plattform entscheiden, was wann passiert, und lassen Sie Ihren eigenen Code die Bytes verschieben. Alles, was eine große Datei berührt oder gegen ein Ablaufzeitfenster rennt, gehört in ein Skript mit Objektspeicher dahinter.
Wo eine Plattform gewinnt
Trigger, Wiederholungsversuche bei günstigen Schritten, Freigabe-Gates und die Auffächerung am Ende. Zapier bewirbt über 9.000 App-Integrationen in Zaps, Tables, Forms und Zapier MCP, und dieser Katalog ist der eigentliche Grund, es zu nutzen. Fertige Show Notes in Ihr CMS zu bringen und Clip-Links in einen Content-Kalender einzutragen, ist Connector-Arbeit – diese Connectors selbst zu schreiben bringt Ihnen nichts.
Human-in-the-Loop gehört auch hierher. Ein Zap, der vier Anzeigenvarianten in Slack postet, auf ein Daumen-hoch wartet und dann den Veröffentlichungsschritt freigibt, ist zwanzig Minuten Einrichtung und das Einzige, was zwischen einer halluzinierten Produktbehauptung und Ihrem Paid-Social-Budget steht.
Wo binäre Mediendaten sie besiegen
No-Code-Knoten übergeben JSON gut und Dateien schlecht. Eine 58-minütige WAV muss in Teile von maximal 25 MB aufgeteilt werden, bevor OpenAIs Transkriptionsendpunkt sie akzeptiert (OpenAI). Ein zweiminütiges Sora-Rendering sind bis zu sechs verkettete Erweiterungsaufrufe à 20 Sekunden (OpenAI), und die Download-URL ist maximal eine Stunde nach der Generierung gültig (OpenAI). Retry-Logik über sechs Aufrufe mit einem laufenden Countdown auf dem Artefakt ist ein Programm, kein Canvas.
Zwei Plattformen tragen Mediendaten. n8n hält Dateien als Binärdaten zwischen Knoten, statt Base64-Hin-und-Her zu erzwingen, und sein Code-Knoten sitzt direkt neben den Agent-Knoten (n8n). Descript legt Transkription, Clips und Untertitel über eine API statt einer GUI offen (Descript).
Der mittlere Weg: Plattform für den Kontrollfluss, Code für die Bytes
Jeder Schritt schreibt in Ihren eigenen Bucket und gibt einen Schlüssel zurück. Die Plattform übergibt Schlüssel und Statuscodes, niemals die Datei. Die Arbeit so zu strukturieren spart auch Rechenleistung: Das OnePiece-System meldet einen 16-fachen Rückgang des GPU-Verbrauchs für Wan2.1 Image-to-Video, sobald eine monolithische Pipeline in Staged-Services zerlegt wird (arXiv).
Wenn Sie Komponenten auswählen, verfolgt unser Verzeichnis 550 KI-Agenten und Orchestrierungstools zusammen mit 301 Open-Source-KI-Repos. In den Repos lebt in der Regel der Byte-verschiebende Kleber, weil kein Anbieter diesen Teil verkauft.
Lieferspezifikationen: die Plattform dort abholen, wo sie veröffentlicht
Ihr letzter Schritt ist nicht das Rendern. Es ist der Upload – und der Upload hat auch ein Datenblatt.
Video: Bitrate- und Audio-Ziele für den Upload
YouTube veröffentlicht empfohlene Lieferbitraten nach Auflösung: 8 Mbps für 1080p SDR, 16 Mbps bei 1440p und 35–45 Mbps bei 4K, mit Audio als AAC-LC, Opus oder Eclipsa bei 48 kHz und 384 kbps Stereo (YouTube-Hilfe). Wenn Ihr Videoschritt eine Datei weit unter diesen Zahlen liefert, skalieren Sie die Bitrate beim Export nicht hoch. Sie verschwenden Kodierzeit damit, Kompressions-Artefakte aufzufüllen. Was Sie stattdessen tun sollten: Lassen Sie den Kodierungsschritt die Quellauflösung lesen und das passende Ziel wählen, damit ein 1080p-Sora-Rendering nicht in eine 4K-Leiter gezwängt wird, weil jemand es vor sechs Monaten in einer Konfiguration festgeschrieben hat.
Das Audio-Ziel ist für narierte Inhalte wichtiger als das Video-Ziel. Eine 48-kHz-384-kbps-AAC-Spur aus einer 44,1-kHz-Quelle bedeutet irgendwo eine Neuabtastung – und Sie wollen, dass diese Neuabtastung einmal in Ihrem eigenen ffmpeg-Aufruf stattfindet, wo Sie sie sehen können.
Audio: Lautstärke-Vorkonditionierung vor der Kodierung
Apple Podcasts fordert -16 dB LKFS ±1 dB mit True Peak bei oder unter -1 dB FS, gemessen nach ITU-R BS.1770-5, und stellt klar, dass das Audio vor der Kodierung auf dieses Ziel vorkonditioniert werden soll (Apple Podcasts for Creators). Reihenfolge der Operationen, keine Präferenz. Ein fertiges MP3 zu normalisieren bedeutet, Pegel durch verlustbehaftete Artefakte zu schieben, die bei einem anderen Pegel eingebacken wurden, und der True Peak eines dekodierten MP3 kann bereits überschreiten, was der Encoder gesehen hat. Machen Sie den Lautstärkepass auf der WAV, dann kodieren.
Deshalb bleibt das TTS-Formattier von früher in der Kette wichtig. Ihrem Normalizer ein 128-kbps-MP3 zu übergeben ist ein schlechterer Ausgangspunkt als PCM, und keine nachgelagerte Sorgfalt behebt das.
Herkunft und Kennzeichnung von generierten Assets
Entscheiden Sie über die Herkunft, während Sie die Pipeline entwerfen, nicht nachdem eine Plattform fragt. Googles SynthID versieht generierte Medien bei der Erstellung mit einem Wasserzeichen, was bedeutet, dass es nur dann mit dem Asset mitreist, wenn Ihre Pipeline es nicht herausschneidet oder neu kodiert. Jeder ffmpeg-Durchlauf zwischen Generierung und Upload ist eine Gelegenheit, dieses Signal zu verlieren – also notieren Sie, welcher Schritt die Datei eingeführt hat, und führen Sie einen eigenen Metadaten-Speicher mit Modell, Prompt und Zeitstempel, statt darauf zu vertrauen, dass der Container es trägt.
Für den Wechsel bauen: die Abkündigungs-Klippe unter jedem Video-Schritt
Wenn Ihr Video-Schritt Sora aufruft, haben Sie noch 19 Tage. OpenAI hat am 24. März 2026 angekündigt, dass die Videos API und beide Modelle sora-2 und sora-2-pro am 24. September 2026 abgeschaltet werden – Snapshots sora-2-2025-10-06, sora-2-2025-12-08 und sora-2-pro-2025-10-06 eingeschlossen, ohne empfohlenes Nachfolgemodell (OpenAI-Abkündigungen). Eine leere Nachfolgerspalte bedeutet: Sie wählen den Nachfolger selbst – und zwar vor dem Stichtag, nicht danach.
Den Schritt abstrahieren, damit ein Wechsel eine Konfigurationsänderung ist
Die Lösung ist ein dünner Adapter pro generativen Schritt. Ihre Pipeline übergibt dem Adapter einen normierten Job: Prompt, Referenzbildpfad, Zielauflösung, Dauer in Sekunden, Ausgabe-Bucket-Schlüssel. Der Adapter besitzt alles Anbieter-spezifische. Soras Regel, dass das Referenzbild exakt mit der Videoauflösung übereinstimmen muss, seine 16- und 20-Sekunden-Clips, die in 20-Sekunden-Schritten bis zu einer Obergrenze von 120 Sekunden verlängert werden, seine 1-Stunden-Download-Ablaufzeit (OpenAI-Videogenerierung). Nichts davon dringt in Ihren Orchestrierungscode.
Dann ist der Anbieterwechsel ein Konfigurationswert, kein Neuschreiben. Validieren Sie einen zweiten Adapter gegen Runways Modelldokumentation jetzt, lassen Sie beide auf denselben zehn Prompts laufen, und halten Sie den Verlierer warm.
Bild- und Audiofamilien haben ihre eigenen Daten, also behandeln Sie das als wiederkehrende Wartungsaufgabe statt als einmaligen Sprint. Unser Verzeichnis existiert auch dazu, damit Sie Modellveröffentlichungen und -abkündigungen verfolgen können – über 324 gelistete Modelle.
Eine Migrations-Checkliste für heute laufende Pipelines
- Durchsuchen Sie jeden Repo und jede Workflow-JSON nach
sora-2,sora-2-pround dem Videos-API-Basispfad. Schließen Sie Cron-Jobs und Einzel-Skripte ein – dort leben die vergessenen Aufrufe. - Verpacken Sie jeden Treffer in einen Adapter mit Ihrem eigenen Job-Schema, bevor Sie den Anbieter wechseln, damit Wechsel und Refactoring nicht im selben Commit landen.
- Lassen Sie den alternativen Anbieter auf zehn echten Prompts laufen und vergleichen Sie die Ausgaben auf Auflösung, Clip-Länge und Bewegungsqualität.
- Hängen Sie zwei Wochen vor jedem veröffentlichten Abschaltdatum eine Kalender-Erinnerung auf – pro Anbieter, pro Modellfamilie.
- Protokollieren Sie die Modell-ID und den Snapshot bei jedem Rendering, damit Sie nach Abkündigung des Modells noch sagen können, was dieses Asset generiert hat.
Häufig gestellte Fragen
Was ist ein multimodaler KI-Workflow in der Praxis?
Es ist eine Kette von API-Aufrufen, bei der die Ausgabedatei eines Modells zur Eingabedatei des nächsten wird, und jeder Schritt hat einen Formatvertrag, den Sie erfüllen müssen. Eine typische Kette geht: Transkript → Skript → Standbild → Video → Vertonung → fertiges Rendering, und jeder Pfeil ist eine Stelle, an der eine falsche Auflösung oder ein falscher Codec den Durchlauf bricht. Soras Bild-zu-Video-Schritt ist ein gutes Beispiel dafür, wie wörtlich diese Verträge werden: Das Referenzbild muss exakt mit der Ziel-Videoauflösung übereinstimmen und image/jpeg, image/png oder image/webp sein, also braucht der Bildschritt die Pixelabmessungen des Videoschritts, nicht nur ein Seitenverhältnis (OpenAI-Videogenerierungsdokumentation). Denken Sie an die Pipeline als eine Reihe von Übergaben, nicht als eine Reihe von Tools.
Wie verknüpfe ich KI-Tools so, dass zwischen den Schritten keine Qualität verloren geht?
Legen Sie die Ausgabespezifikation an jedem Schritt auf das fest, was der letzte Schritt in der Kette braucht, und arbeiten Sie sich dann rückwärts vor. Qualitätsverlust entsteht meist durch eine Preis-Tier oder einen Standardparameter, nicht durch das Modell: ElevenLabs steckt pcm_44100, pcm_48000, wav_44100 und wav_48000 hinter ein Pro-Abo und mp3_44100_192 hinter Creator-Tier, also übergibt ein Einstiegsaccount Ihrem Editor ein verlustbehaftetes MP3, ob Sie das wollten oder nicht (ElevenLabs Create-Speech-Referenz). Kopieren Sie jedes generierte Artefakt sofort in Ihren eigenen Objektspeicher, weil Soras Download-URLs maximal eine Stunde nach der Generierung gültig sind (OpenAI-Videogenerierungsdokumentation). Die Abtastrate ist auch ein Kostenhebel, nicht nur ein Qualitätsmerkmal: Claude bepreist einen 4K-Frame mit 4.784 Visual-Tokens auf der High-Resolution-Tier gegenüber 1.560 auf Standard, ungefähr 23,92 $ pro tausend 4K-Frames bei Opus 5s Input-Preis von 5 $/M (Claude-Vision-Dokumentation).
Welches Audioformat soll ich von einem Text-zu-Sprache-Schritt an einen Videoeditor übergeben?
Unkomprimiertes 48-kHz-WAV oder PCM – bei ElevenLabs also wav_48000 oder pcm_48000 und ein Pro-Abo oder höher (ElevenLabs Create-Speech-Referenz). Einem Editor ein 128-kbps-MP3 zu übergeben backt Kompressions-Artefakte ein, die jede spätere Kodierung überleben. Wenn das Ziel YouTube ist, ist das finale Lieferziel AAC-LC, Opus oder Eclipsa bei 48 kHz und 384 kbps Stereo (YouTube-Upload-Kodierungseinstellungen), und wenn es ein Podcast-Feed ist, verlangt Apple eine Lautstärke-Vorkonditionierung auf -16 dB LKFS ±1 dB mit True Peak bei oder unter -1 dB FS, gemessen nach ITU-R BS.1770-5, bevor Sie kodieren (Apple Podcasts-Audioanforderungen). Von einem verlustbehafteten Zwischenformat aus können Sie keines dieser Ziele zuverlässig erreichen.
Warum schlägt meine Podcast-Transkription bei vollen Episoden fehl?
Der Transkriptionsendpunkt von OpenAI begrenzt Uploads auf 25 MB und akzeptiert mp3, mp4, mpeg, mpga, m4a, wav und webm, also muss alles, was länger als etwa eine halbe Stunde bei ordentlicher Bitrate ist, in Teile von maximal 25 MB aufgeteilt werden (OpenAI Sprache-zu-Text-Dokumentation). Deshalb leiten Langform-Pipelines die Transkription in der Regel vom LLM-Anbieter weg: AssemblyAI akzeptiert bis zu 5 GB pro Anfrage auf /v2/transcript (2,2 GB für lokale Uploads) und Dateien von 160 ms bis 10 Stunden – ungefähr das 200-Fache von OpenAIs Obergrenze (AssemblyAI Pre-Recorded-Audio-Dokumentation). Zwei weitere Fehlerquellen sehen aus wie Erfolg: Sprecherdiarisierung gibt stillschweigend unbeschrifteten Text zurück, wenn Sie chunking_strategy nicht für Audio über 30 Sekunden auf 'auto' setzen, und SRT/VTT-Ausgabe plus timestamp_granularities[] funktionieren nur mit whisper-1, nicht mit gpt-transcribe oder gpt-4o-transcribe (OpenAI Sprache-zu-Text-Dokumentation). Wenn Sie wortgenaue Zeitstempel für automatisches Clip-Cutting brauchen, liefert ElevenLabs Scribe v2 diese in über 90 Sprachen zusammen mit Diarisierung (ElevenLabs-Modelle).
Soll ich eine KI-Content-Pipeline in n8n oder Zapier bauen oder den Code selbst schreiben?
Schreiben Sie Code für jeden Schritt, der binäre Mediendaten verschiebt, und nutzen Sie eine Automatisierungsplattform für die Trigger, Freigaben und Benachrichtigungen drum herum. Zapiers Stärke ist Breite: vom Anbieter angegebene über 9.000 App-Integrationen plus Zaps, Tables, Forms und Zapier MCP (Zapier-Entwicklerplattform), was genau das ist, was Sie für „neue Zeile in Airtable, Rendering anstoßen, Link in Slack posten“ wollen. Für eine 200-MB-MP4 mit einer ablaufenden URL von einer Stunde ist es die falsche Ebene. n8n liegt dazwischen: seine Agent-Knoten und die binäre Passthrough-Verarbeitung erlauben es, Dateien im Workflow zu halten (n8n-Tools-Agent-Dokumentation), und es gibt ein echtes Infrastrukturargument dafür, die Kette in Stufen statt in einen Monolithen aufzuteilen: Das OnePiece-Paper berichtet von einem 16-fachen Rückgang des GPU-Verbrauchs durch die Zerlegung einer AIGC-Pipeline in Staged-Microservices für Wan2.1 Image-to-Video (arXiv).
Was ersetzt Sora in einer Video-Pipeline nach der Abschaltung im September 2026?
OpenAI hat am 24. März 2026 angekündigt, dass die Videos API und die Modelle sora-2 und sora-2-pro (Snapshots sora-2-2025-10-06, sora-2-2025-12-08 und sora-2-pro-2025-10-06) am 24. September 2026 abgeschaltet werden, ohne empfohlenes Nachfolgemodell (OpenAI-Abkündigungen). Ab dem 5. September 2026 sind das noch 19 Tage, also ist der praktische Schritt, Ihren Video-Schritt heute hinter eine dünne Schnittstelle zu stecken und auf einen anderen Anbieter zu zeigen, wobei Runways API der direkteste Wechsel zum Evaluieren ist (Runway-Modelldokumentation). Planen Sie auch ein Umschreiben Ihrer Chunking-Logik ein, da Soras Limits viele Pipelines geformt haben: 16- und 20-Sekunden-Clips, bis zu 20 Sekunden pro Erweiterung und maximal 120 Sekunden über bis zu sechs Erweiterungen, was ein zweiminütiges nariertes Segment zu sechs verketteten Aufrufen machte (OpenAI-Videogenerierungsdokumentation). Wenn Sie nach Alternativen suchen, verfolgt unser Verzeichnis derzeit 452 Tools unter KI-Videogeneratoren.