

Deine Ausgaben sind mittelmäßig, weil deine Eingaben aufgebläht, veraltet oder schlecht geordnet sind. Nicht weil du den Prompt falsch formuliert hast. Anthropics eigene Dokumentation sagt es direkt: „Mehr Kontext ist nicht automatisch besser. Mit wachsender Token-Anzahl nehmen Genauigkeit und Recall ab – ein Phänomen, das als Context Rot bekannt ist“ (Claude Platform-Dokumentation). Context Engineering ist die Lösung, und Anthropic definiert es als die Kuratierung „des optimalen Satzes von Tokens (Informationen) während der LLM-Inferenz“ (Anthropic Engineering).
Die Zahlen sind für die Maximalist-Gewohnheit ungünstig. Beim NoLiMa-Benchmark lagen 11 von 13 Modellen, die alle 128K-plus-Kontext versprechen, bei 32K Token unter der Hälfte ihres Kurzkontext-Scores (arXiv:2502.05167).
Das ist ein Playbook für Menschen, die ChatGPT, Claude, Gemini und Copilot nutzen, anstatt Agent-Frameworks zu bauen: welchen Regler man wo dreht und was er bringt.
Context Engineering hat Prompt-Magie abgelöst
Wenn deine Ausgaben mittelmäßig sind, liegt es selten an der Formulierung deines Prompts. Context Engineering ist die Praxis, die das behoben hat: Anthropic definiert es als „die Gesamtheit der Strategien zur Kuratierung und Pflege des optimalen Token-Satzes (Informationen) während der LLM-Inferenz, einschließlich aller anderen Informationen, die dort außerhalb der Prompts landen können“, und nennt es die natürliche Weiterentwicklung des Prompt Engineerings (Anthropic Engineering). Die Frage verschob sich von „Wie formuliere ich das?“ zu „Welche Kontextkonfiguration erzeugt am wahrscheinlichsten das gewünschte Verhalten des Modells?“
Von „Wie formuliere ich das?“ zu „Was soll im Fenster stehen?“
Die Formulierung ist am Rand noch wichtig. Sie ist nur nicht mehr der Hebel, an dem die Wirkung sitzt. Eine perfekt formulierte Frage gegen ein aufgeblähtes, halb relevantes Fenster verliert gegen eine direkte Frage gegen ein sauberes – und der Rest dieses Artikels ist im Wesentlichen ein Beleg dafür.
Die meisten der 212 Prompt-Engineering-Tools, die wir verfolgen, optimieren den Satz, den du eintippst. Fast keines davon berührt die anderen fünf Dinge, die sich das Fenster mit ihm teilen.
Die fünf Eingaben, die du tatsächlich kontrollierst
Jede Anfrage baut ein Fenster aus Teilen zusammen, die du sehen und ändern kannst:
- Die Systemanweisungen – ob das das Anweisungsfeld eines Custom GPTs, die Beschreibung eines Claude-Projekts oder eine CLAUDE.md-Datei in deinem Repository ist.
- Speicher: was das Produkt über dich über Sitzungen hinweg gespeichert hat, meist ohne dir den vollständigen Text zu zeigen.
- Angehängte Dokumente und deren Parsing-Qualität – das ist die am meisten unterschätzte Variable im gesamten Stack.
- Abgerufene Chunks, wenn das Tool Retrieval durchführt, plus was immer der Retriever als relevant eingestuft hat.
- Vorherige Gesprächsrunden, einschließlich jeder Sackgasse, die du vor zwanzig Nachrichten aufgegeben hast.
- Tool-Definitionen, die Token kosten, unabhängig davon, ob ein Tool tatsächlich aufgerufen wird.
Das sind sechs, und du kontrollierst sie alle über die Produktoberfläche. Kein Framework, kein API-Schlüssel.
Das ist also ein eingabeseitiges Playbook, geschrieben für Menschen, die ChatGPT, Claude, Gemini und Copilot nutzen, anstatt Agent-Systeme darüber zu bauen. Welchen Regler man wo dreht und was die Zahlen für 2026 dazu sagen.
KI-Kontextfenster erklärt: beworbene Größe vs. nutzbare Größe
Die Zahl auf dem Datenblatt ist ein Speicherlimit, keine Leistungsgarantie. Ein Modell, das eine Million Token akzeptiert, tut das gerne – und antwortet dann schlechter, als wenn es mit 3.000 gearbeitet hätte. Betrachte das beworbene Fenster als die Decke eines Zimmers, nicht als die Größe des Schreibtischs, auf dem du arbeiten kannst.
Was wirklich auf das Fenster angerechnet wird
Mehr als du denkst. Jeder Teil einer API-Anfrage belegt dasselbe Budget: der System-Prompt, jede Nachricht im Thread einschließlich Tool-Ergebnissen, Bilder und PDFs, die Tool-Definitionen selbst und die eigene Ausgabe des Modells einschließlich Extended Thinking (Claude Platform-Dokumentation). Gecachte Präfixe belegen das Fenster ebenfalls. Prompt-Caching ändert, was du für diese Token zahlst, nicht ob sie zählen.
So kann ein kurz wirkender Chat 40.000 Token aus angehängten PDFs, Tool-Schemata und vorherigem Reasoning tragen, die du nie siehst. Das ist der Teil, den die Lexikonartikel weglassen.
Die 32K-Klippe, die niemand ins Datenblatt schreibt
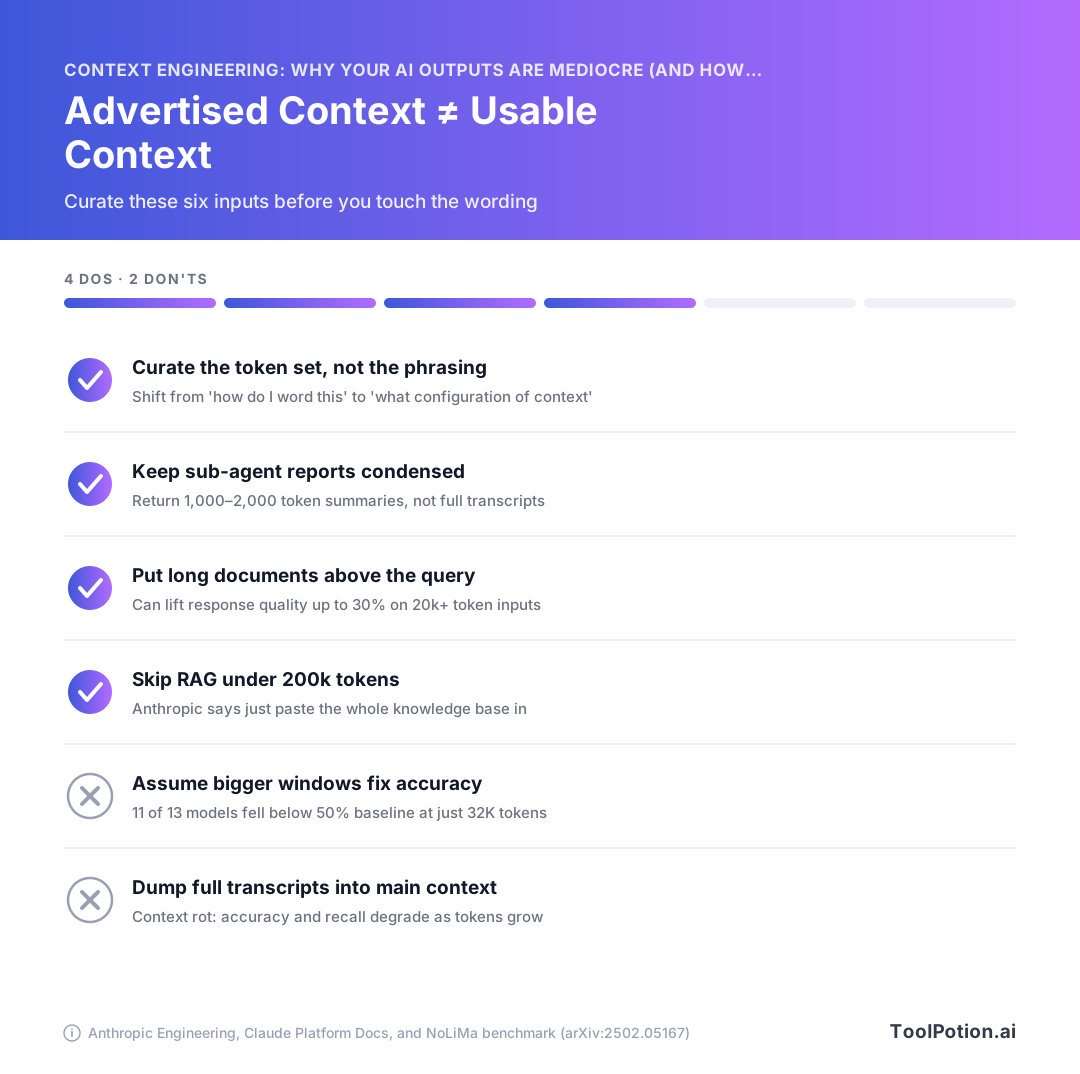
Der NoLiMa-Benchmark eliminierte wörtliche Wortüberschneidungen zwischen der Frage und der im Heuhaufen vergrabenen Antwort und testete dann 13 Modelle, die alle 128K Kontext oder mehr beanspruchen. Unter 1K Token schnitten sie gut ab. Bei 32K waren 11 von 13 unter die Hälfte ihrer Kurzkontext-Baseline gefallen, und Llama 3.1 70B sank von 94,3 % auf 42,7 % (NoLiMa, arXiv:2502.05167). Dieser Preprint stammt vom Februar 2025 und ist damit älter als jedes Modell in der Tabelle unten. Die Aussage des Befunds hat sich in neueren Arbeiten bestätigt, aber die konkreten Prozentzahlen sind alternde Belege, keine aktuelle Rangliste.
Was heutige Fenster wirklich sind (Zahlen für 2026)
| Modell | Kontextfenster | Maximale Ausgabe | Bilder/PDF-Seiten pro Anfrage |
|---|---|---|---|
| Claude Fable 5.1, Opus 5, Sonnet 5 (und Mythos 5.1, Opus 4.8/4.7/4.6, Sonnet 4.6) | 1M Token, Standard, Standardpreise | 128k | 600 |
| Claude Sonnet 4.5 und älter | 200k | — | 100 |
| OpenAI GPT-5.4 | 1.050.000 Token | 128.000 | — |
Anthropic liefert dieses 1M-Fenster ohne Beta-Header und ohne Aufpreis (Claude Platform-Dokumentation). Das von OpenAI ist nominell größer und anders bepreist: Wer bei GPT-5.4 über 272K Eingabe-Token geht, wird für die gesamte Sitzung mit 2x Eingabe und 1,5x Ausgabe abgerechnet (OpenAI API-Dokumentation). Aufblähung ist dort ein Rechnungsposten, nicht nur eine Qualitätssteuer.
Wenn du Kapazitäten über Anbieter hinweg vergleichst, schau lieber auf die eigene Spec-Seite des Modells als auf eine Zusammenfassung: Fenster haben sich allein im Jahr 2026 zweimal geändert, und veraltete Tabellen gibt es überall. Unser Verzeichnis mit 324 KI-Modellen ist ein Ausgangspunkt, um die richtige Seite zu finden.
Context Rot: Warum mehr Kontext die Ausgaben meist verschlechtert
Der Abbau hat einen Mechanismus, und er ist nicht rätselhaft. Ein Transformer muss n² Paarbeziehungen über n Token modellieren, also lässt jedes hinzugefügte Token jeden anderen Token ein wenig härter um die Aufmerksamkeit des Modells konkurrieren. Anthropics Engineering-Team nennt das ein begrenztes Aufmerksamkeitsbudget, analog zum menschlichen Arbeitsgedächtnis, und sagt, die Aufmerksamkeit werde „dünn verteilt“, wenn der Kontext wächst. Ihre Empfehlung ist klar: Finde „den kleinstmöglichen Satz hochrelevanter Token, der die Wahrscheinlichkeit eines gewünschten Ergebnisses maximiert“.
Das Problem des Aufmerksamkeitsbudgets
Anthropics eigene Produktdokumentation räumt den Punkt ein, anstatt ihn zu beschönigen. „Mehr Kontext ist nicht automatisch besser“, sagt die Plattformdokumentation. „Mit wachsender Token-Anzahl nehmen Genauigkeit und Recall ab – ein Phänomen, das als Context Rot bekannt ist.“ Das ist der Anbieter, der dir ein 1M-Token-Fenster verkauft und dir sagt, es nicht zu füllen.
Gleiche Frage, gleiche Antwort, 375-faches Rauschen
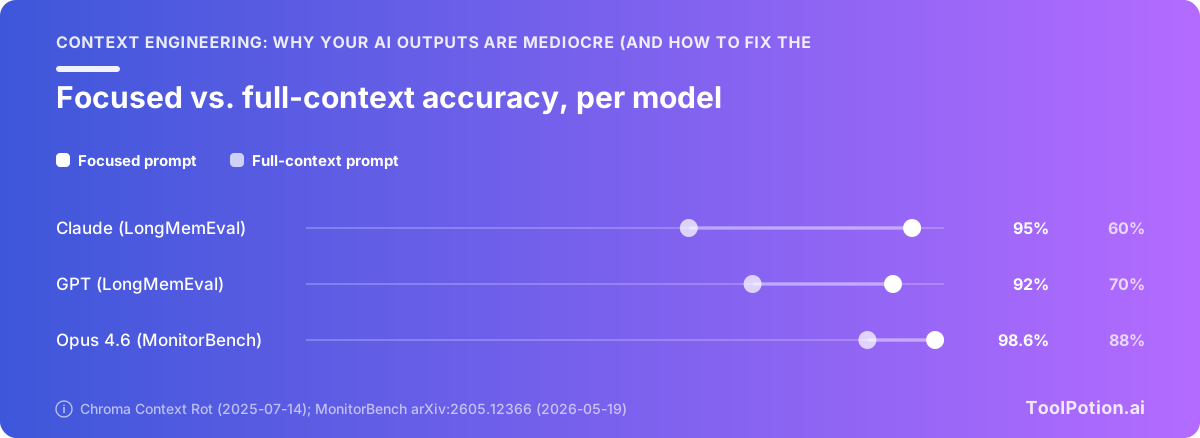
Chroma testete 18 Modelle, darunter GPT-4.1, Claude 4, Gemini 2.5 und Qwen3, und stellte fest, dass die Zuverlässigkeit bei längeren Eingaben selbst bei trivialen Aufgaben wie Retrieval und Wortwiedergabe sinkt (Chroma). Der LongMemEval-Durchlauf ist der entscheidende. Jede Modellfamilie schnitt bei fokussierten Prompts von etwa 300 Token mit nur den relevanten Runden deutlich besser ab als bei vollständigen Prompts von etwa 113k Token mit der gesamten Gesprächshistorie, wobei Claude-Modelle die größte Lücke zeigten. Gleiche Frage. Gleiche Antwort im Kontext beide Male. Die einzige Variable war, wie viel irrelevantes Material sie umgab.
Chroma stellte außerdem fest, dass Modelle bei gemischten Heuhaufen besser abschnitten als bei logisch kohärenten Dokumenten – bei allen 18. Kohärenter umgebender Text gibt dem Modell mehr plausibel aussehende Stellen zum Landen. Dieser Bericht erschien am 14.07.2025 und ist damit über ein Jahr alt und stammt aus der Zeit vor der aktuellen Modellgeneration.
Der Effekt ist nicht veraltet. Beim MonitorBench senkte das Voranstellen von 800k Token harmloser, irrelevanter Aktionen den Recall von Opus 4.6 von 98,6 % auf 88 % (arXiv:2605.12366). An der Aufgabe änderte sich nichts. Nur das Padding.
Wo es dich im normalen Gebrauch trifft
Du hast das schon erlebt, ohne es so zu nennen. Der Chat, der dein Briefing bei Nachricht 12 traf und bei Nachricht 90 generischen Füller produziert, weil das Briefing nun unter 78 Nachrichten halb aufgegebener Entwürfe begraben ist. Das NotebookLM-Notizbuch, in das du 40 Quellen der Vollständigkeit halber eingefügt hast und das bei acht Quellen vagere Antworten liefert. Die Coding-Session, in der das Modell eine vor einer Stunde genannte Bedingung vergisst und selbstbewusst drumherum umschreibt.
Nichts davon liegt daran, dass das Modell nachlässig wird. Du gibst das Aufmerksamkeitsbudget für Token aus, die ihren Platz nicht verdienen.
Dokumentenvorbereitung: der Schritt, den fast alle überspringen
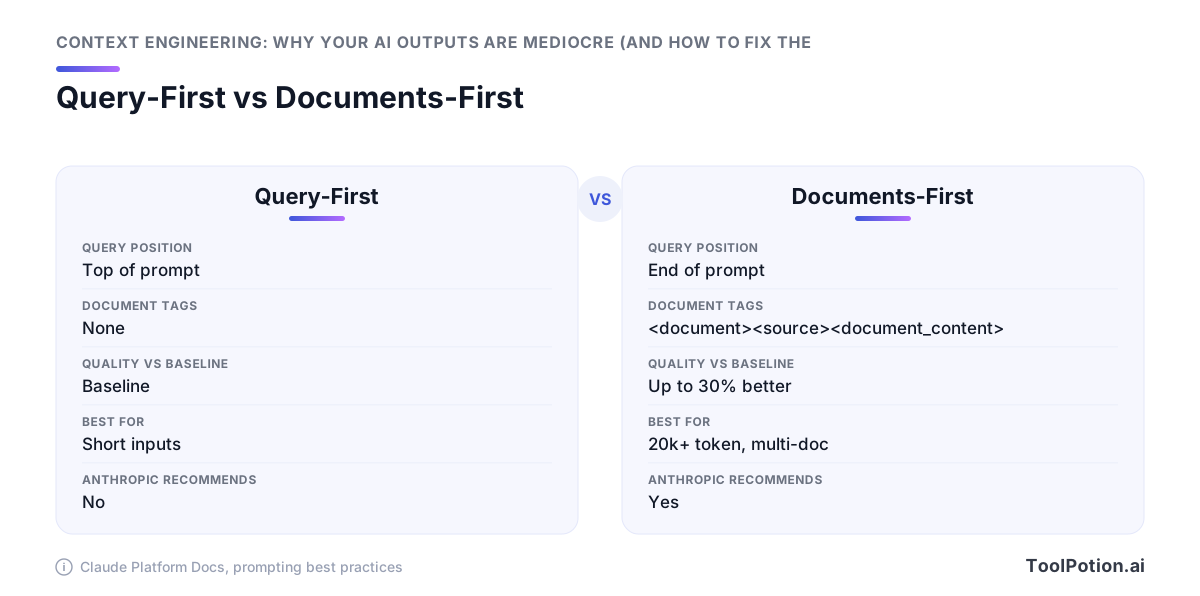
Wo du ein Dokument im Prompt platzierst, beeinflusst die Antwort, die du zurückbekommst. Bei Eingaben über 20.000 Token empfehlen Anthropics Prompting-Dokumente, Langformdaten ganz oben zu platzieren, über deiner Anfrage, deinen Anweisungen und deinen Beispielen: „Anfragen am Ende können die Antwortqualität in Tests um bis zu 30 Prozent verbessern, besonders bei komplexen, mehrdokumentigen Eingaben“ (Claude Platform-Dokumentation). Die meisten Leute machen das Gegenteil. Sie tippen die Frage und fügen den Bericht darunter ein.
Das lange Material an den Anfang
Dieselben Dokumente geben dir ein Gerüst, das es sich lohnt, wörtlich zu übernehmen: Verpacke jedes Dokument in <document>-Tags mit <source>- und <document_content>-Untertags, damit das Modell erkennen kann, wo eine Datei endet und die nächste beginnt (Claude Platform-Dokumentation). Bitte es dann, die relevanten Passagen zu zitieren, bevor es antwortet. Diese eine Zeile zwingt das Modell, Belege im Text zu lokalisieren, anstatt sie aus dem halb Erinnerten zu rekonstruieren, und gibt dir etwas Überprüfbares, wenn die Antwort falsch aussieht.
<document>
  <source>Q3-board-deck.pdf</source>
  <document_content>...full text here...</document_content>
</document>
<document>
  <source>renewal-contract-2026.pdf</source>
  <document_content>...full text here...</document_content>
</document>

Before answering, quote the passages you relied on.
Question: which renewal terms conflict with the Q3 revenue plan?
Quellen taggen, damit das Modell sie zitieren kann
Ein Vorbehalt, bevor du das standardisierst: Die Anbieter sind sich uneinig. Anthropic stellt lange Daten zuerst; Googles Leitfaden zeigt in die andere Richtung und empfiehlt, mit den Anweisungen zu schließen. Ein von einem Gemini-Tutorial übernommenes Prompt-Template kann in Claude deshalb schwächere Ergebnisse liefern, ohne dass es je offensichtlich kaputt wirkt. Teste dasselbe Dokument-Set in beiden Reihenfolgen auf dem Modell, das du tatsächlich bezahlst – zehn Fragen jeweils – und behalte die Reihenfolge, die gewinnt. Das ist zwanzig Minuten Arbeit gegen einen behaupteten 30-%-Unterschied.
Die Parser-Wahl entscheidet, was das Modell überhaupt sieht
Nichts davon rettet eine verstümmelte Extraktion. Eine gescannte Rechnungstabelle, die als eine einzige zusammenhängende Zeile ankommt, ein zweispaltiges Paper, das zeilenweise verschachtelt ist, eine mittendrin eingefügte Fußnote: Das Modell liest diesen Datenmüll treu und antwortet daraus. Dein Extraktionsschritt setzt die Genauigkeitsgrenze, und alles nachgelagerte ist daran gedeckelt. Behandle den Parser als Qualitätsentscheidung und teste zwei oder drei an deiner hässlichsten echten Datei, bevor du dich festlegst. Unser Verzeichnis listet 217 KI-Dokumenten- und PDF-Tools, und der Unterschied zwischen guten und schlechten zeigt sich in deinen Ausgaben, nicht in deren Marketingtexten.
Retrieval-Hygiene: Weniger, bessere Chunks schlagen mehr Chunks
Bevor du eine Retrieval-Schicht aufbaust, prüfe, ob du überhaupt eine brauchst. Anthropics eigene Leitlinien besagen, dass du, wenn deine Wissensbasis kleiner als 200.000 Token (etwa 500 Seiten) ist, einfach alles in den Prompt aufnehmen kannst, ohne jegliches Retrieval (Anthropic Engineering). Die meisten internen Wikis, Produkthandbücher und Richtliniensammlungen liegen unter dieser Grenze.
Brauchst du überhaupt Retrieval?
Wenn dein Korpus passt, überspringe die Vektordatenbank. Du vermeidest Chunking-Entscheidungen, Embedding-Drift und eine ganze Klasse stiller Fehler, bei denen der richtige Absatz nie in den Prompt gelangt. Kombiniere das mit Prompt-Caching, damit du nicht für dieselben 200k Token bei jedem Aufruf den vollen Preis zahlst.
Oberhalb dieser Größe ist Retrieval nicht mehr optional, und Qualität wird zu einem Stapel kleiner Korrekturen, die sich summieren.
Die drei Korrekturen, die sich summieren
Anthropic hat sie einzeln gemessen. Das Voranstellen von chunk-spezifischem Kontext vor dem Einbetten senkte die Top-20-Retrieval-Fehler von 5,7 % auf 3,7 %, eine Reduktion von etwa 35 %. Das Hinzufügen von kontextuellem BM25-Hybridsuche brachte die Fehler auf 2,9 %, eine Reduktion von 49 %. Ein Reranking-Durchlauf darüber brachte sie auf 1,9 %, eine Gesamtreduktion von 67 % (Anthropic Engineering). Jeder Schritt ist für sich unglamourös, und die drei zusammen verdreifachen ungefähr die Verbesserung des ersten.
Auch das Kürzen von Tool-Definitionen zählt
Tool-Schemata sind Kontext. Wenn du einem Modell vierzig Tool-Definitionen gibst und es zwei braucht, hast du für achtunddreißig Ablenkungen bezahlt. Die RAG-MCP-Arbeit rief nur die relevanten Schemata ab, anstatt alle aufzulisten, und reduzierte die Prompt-Token um mehr als die Hälfte, während die Tool-Auswahlgenauigkeit von 13,62 % auf 43,13 % stieg (arXiv:2505.03275). Das ist dieselbe Disziplin wie bei der Chunk-Selektion, eine Ebene höher angewendet.
Anthropics Sub-Agenten-Muster erweitert das nochmals: Spezialisierte Agenten erledigen die Recherche und geben verdichtete Zusammenfassungen von etwa 1.000 bis 2.000 Token an einen koordinierenden Agenten zurück, sodass der Hauptkontext die rohen Suchtranskripte nie sieht (Anthropic Engineering). Wenn du Komponenten auswählst statt sie zu schreiben, listet unser Verzeichnis 550 KI-Agenten und eine Reihe von Retrieval- und Agent-Frameworks, die diese Muster out of the box implementieren.
Speicherfunktionen: Welchen Regler man in welchem Tool dreht
Jedes Consumer-KI-Produkt injiziert mittlerweile Dinge in deinen Kontext, die du nicht getippt hast. Gespeicherte Fakten, frühere Chats, App-Aktivität, hochgeladene Projektdateien. Du kannst kein Context Engineering in einer Chat-App betreiben, bis du weißt, was schon im Fenster sitzt, bevor du das erste Wort tippst.
Eine falsche Erinnerung kostet mehr als keine Erinnerung. Es ist hochrelevant wirkender Text, den das Modell als Tatsache behandelt, und er sitzt nahe bei deinen Anweisungen, wo die Aufmerksamkeit am stärksten ist. Veraltete Berufsbezeichnungen, ein alter Kundenname, eine Präferenz, die du einmal für eine einmalige Aufgabe gesetzt hast: Jede davon verzerrt still jede folgende Antwort.
ChatGPT: Zwei unabhängige Schalter
ChatGPTs Speicher besteht aus zwei Mechanismen, nicht einem. Gespeicherte Erinnerungen sind diskrete gespeicherte Fakten, die du einzeln lesen und löschen kannst, während die Chat-Historienverweis-Funktion über einen separaten Retrieval-Pfad auf frühere Gespräche zugreift (Embrace The Red). Einer ausschalten lässt den anderen weiterlaufen. Wenn deine Ausgaben nach dem Löschen gespeicherter Erinnerungen immer noch nach dem Projekt des letzten Monats riechen, ist der Historien-Schalter der, den du verpasst hast.
Claude: Projektwissen und Speicher-Schreibvorgänge mitten im Gespräch
Seit der Cowork-Vereinheitlichung am 25. August 2026 schreibt Claude Erinnerungen mitten im Gespräch, nicht mehr nur an Sitzungsgrenzen, sodass was du im Chat sagst, in spätere Sitzungen einfließt (TechCrunch). Das bedeutet, ein beiläufiger Kommentar kann zu dauerhaftem Kontext werden.
Projektwissen ist der bessere Hebel, weil es ein Korpus ist, den du selbst gewählt hast. Halte ihn unter Anthropics Faustregel von 200.000 Token (etwa 500 Seiten), und er kann vollständig mitgenommen werden, ohne dass eine Retrieval-Schicht raten muss, welche Chunks wichtig sind (Anthropic). Pflege es wie eine Leseliste, nicht wie ein Archiv.
Gemini: Drei überlappende Systeme, bei denen „aus“ nicht „gelöscht“ bedeutet
Gemini schichtet persönlichen Kontext, selbst geschriebene gespeicherte Informationen und Aktivitäten aus verbundenen Google-Apps. Eine Quelle deaktivieren stoppt neue Schreibvorgänge. Es entfernt nicht, was bereits gespeichert ist – ein Audit bedeutet also, jede Steuerung separat aufzurufen und zu löschen, nicht nur Dinge auszuschalten.
NotebookLM: Die quellengebundene Alternative
NotebookLM begrenzt, wie viele Quellen ein Notizbuch enthalten kann, und das Limit wirkt zu deinen Gunsten. Es erzwingt die Kuratierung, die die anderen drei dir erlauben zu überspringen – dieselbe Disziplin, die Anthropic vorschreibt: Finde den kleinsten Satz hochrelevanter Token, der das gewünschte Ergebnis liefert (Anthropic). Wenn eine Frage acht Dokumente braucht und nicht achtzig, fang dort an.
Wähle ein Tool als deinen speichertragenden Assistenten und halte die anderen sauber. Unter den 13.174 KI-Apps in unserem Verzeichnis sind die, die Speicher pro Element auditierbar machen, mehr wert als die, die versprechen, sich an alles zu erinnern.
Anweisungen auf Projektebene sind wiederverwendbarer Kontext
Der günstigste Kontext, den du je schreiben wirst, ist der, den du einmal schreibst. Jedes ernsthafte KI-Tool hat mittlerweile einen Slot für ständige Anweisungen, die in jede Sitzung injiziert werden: AGENTS.md und CLAUDE.md in einem Repository, Claude-Projekte, benutzerdefinierte ChatGPT-Anweisungen, Copilot-Anweisungsdateien. Die meisten Leute lassen diese Slots leer und tippen dann dieselben drei Absätze Hintergrund in jeden neuen Chat.
Warum eine stehende Anweisungsdatei das Erklären übertrifft
Eine Studie über 10 Repositories und 124 Pull Requests maß, was eine AGENTS.md-Datei auf Repository-Ebene am Verhalten eines Agenten bewirkt, und das Ergebnis betrifft nicht nur Korrektheit. Die mittlere Laufzeit sank um 28,64 %, von 98,57 Sekunden auf 70,34 Sekunden, und die Ausgabe-Token gingen bei vergleichbaren Abschlussraten um 16,58 % zurück (arXiv:2601.20404). Der Agent hörte auf, Dinge zu erkunden, die du bereits wusstest.
Das ist das Argument in einem Satz. Guter stehender Kontext macht das Modell schneller und günstiger, nicht nur genauer, weil der Großteil der Token, die ein Agent verbrennt, darin besteht, deine Konventionen neu zu entdecken. Wenn du unter den 260 KI-Coding-Assistenten in unserem Verzeichnis wählst, ist die Frage, ob das Tool eine Projektanweisungsdatei liest, ein besseres Kriterium als die meisten Feature-Vergleiche.
Was wirklich hineingehört
Halte es kurz genug, dass du es selbst lesen würdest. Fünf Dinge verdienen ihren Platz:
- Konventionen, die der Code nicht ankündigt – zum Beispiel welcher Test-Runner real ist und welcher tot.
- Dein Vokabular. Wenn „account“ und „tenant“ hier unterschiedliche Bedeutungen haben, sag es einmal.
- Die Ausgabeform, die du zurückhaben möchtest, in dem Format, das du möchtest (ein Diff, eine Tabelle, fünf Stichpunkte).
- Eine kurze Verbotsliste. Generierte Dateien nicht anfassen, keine Abhängigkeiten ohne Nachfrage hinzufügen.
- Wo die Wahrheitsquelle liegt, damit das Modell sie abfragt statt zu raten.
Lass weg, was das Tool selbst lesen kann. Verzeichnisbäume, Dateilisten, neu formulierte Funktionssignaturen, eine Zusammenfassung deiner README. Das sind Token, die etwas duplizieren, was der Agent in einem Aufruf abrufen kann, und sie konkurrieren um Aufmerksamkeit mit den Anweisungen, die zählen. Schreibe die Datei neu, wenn sie anfängt, ignoriert zu werden – was meist bedeutet, dass sie zu lang geworden ist.
Kontext-Aufblähung hat einen Preisaufschlag
Schlampiger Kontext kostet Geld auf der Rechnung, nicht nur Qualität in der Ausgabe. Zwei Preismechanismen machen das konkret, und beide belohnen dieselbe Disziplin: ein kleines, stabiles, geordnetes Präfix.
Die 272K-Stufenfunktion bei GPT-5.4
OpenAIs GPT-5.4 bietet ein Kontextfenster von 1.050.000 Token mit bis zu 128.000 Ausgabe-Token, aber Prompts über 272K Eingabe-Token werden „für die gesamte Sitzung mit 2x Eingabe und 1,5x Ausgabe berechnet“ (OpenAI API-Dokumentation). Lies das sorgfältig. Die Grenze einmal zu überschreiten kostet nicht ein bisschen extra auf dem Überschuss. Es bepreist die gesamte Sitzung neu, Ausgabe inbegriffen – sodass ein einziges unachtsames Einfügen eines 300K-Token-Dumps deine Eingaberechnung für jeden folgenden Turn verdoppelt.
Du zahlst doppelt für die Token, die am wahrscheinlichsten deine Antwort verschlechtern.
Caching belohnt ein stabiles Präfix
Die Claude-API bepreist Cache-Lesevorgänge mit 0,1x des Basis-Eingabepreises, einem Rabatt von 90 %, während Cache-Schreibvorgänge 1,25x beim 5-Minuten-TTL oder 2x beim 1-Stunden-TTL kosten (Claude Platform-Dokumentation). Ihr Rechenbeispiel: 100k Token, zehnmal wiederverwendet, kostet 1,075 $ gegenüber 5,00 $ ungecacht – eine Ersparnis von 78,5 %.
Dieser Rabatt greift nur, wenn das Präfix byte-für-byte übereinstimmt. Caching basiert auf einem exakten Präfix – wenn du also deine Dokumente umsortierst, einen Zeitstempel in den System-Prompt einfügst oder Tool-Definitionen zwischen Turns shuffelst, zahlst du wieder den Schreibpreis statt des Lesepreises. Die Gewohnheit, die den Cache warm hält, ist dieselbe, die den Recall hochhält: Stelle das stabile Material zuerst in fester Reihenfolge, und lass nur die Anfrage am Ende wechseln.
Ein Kontext-Audit, das du diese Woche durchführen kannst
Nichts davon erfordert einen API-Schlüssel oder ein Engineering-Ticket. Jeder Punkt ist ein Regler, den du schon hast.
Sechs Überprüfungen vor deiner nächsten langen Sitzung
- Öffne einen neuen Chat statt den von gestern zu verlängern. Chromas fokussierte Prompts (~300 Token relevanter Runden) schlugen vollständige 113k-Token-Historien bei jeder getesteten Modellfamilie, wobei Claude die größte Lücke zeigte (Chroma).
- Lies deine gespeicherten Erinnerungen und lösche die veralteten. Gespeicherte Fakten werden injiziert, ob sie helfen oder nicht.
- Hänge drei gute Dokumente statt zwölf mittelmäßige an und verpacke jedes in
<document>-Tags mit einem<source>-Untertag, damit das Modell sie auseinanderhalten kann (Claude-Dokumentation). - Stelle das lange Material über deine Frage. Bei Eingaben von 20k+ Token ist diese Reihenfolge laut Anthropics Tests bis zu 30 % bessere Antworten wert (Claude-Dokumentation).
- Schreibe die stehenden Anweisungen einmalig auf. Eine AGENTS.md auf Repository-Ebene senkte die mittlere Laufzeit um 28,64 % und die Ausgabe-Token um 16,58 % über 124 PRs (arXiv).
- Halte dieses Präfix von Turn zu Turn identisch. Stabile Präfixe treffen den Cache zum 0,1x-Eingabepreis (Claude-Dokumentation).
Die eine Gewohnheit, die die meisten schlechten Ausgaben behebt
Bevor du den Prompt umschreibst, schau, was schon im Fenster ist, und nimm etwas heraus. Anthropics eigene Dokumentation sagt es: „Mehr Kontext ist nicht automatisch besser“ (Claude-Dokumentation). Ändere, was du dem Modell gibst, bevor du änderst, wie du fragst.
Häufig gestellte Fragen
Was ist Context Engineering, und wie unterscheidet es sich von Prompt Engineering?
Anthropic definiert Context Engineering als „die Gesamtheit der Strategien zur Kuratierung und Pflege des optimalen Token-Satzes (Informationen) während der LLM-Inferenz, einschließlich aller anderen Informationen, die dort außerhalb der Prompts landen können“ (Anthropic Engineering). Prompt Engineering fragt, wie man eine Anfrage formuliert. Context Engineering fragt, welche Kontextkonfiguration am wahrscheinlichsten das gewünschte Verhalten erzeugt, und umfasst alles, was das Fenster belegt: den System-Prompt, jede Nachricht einschließlich Tool-Ergebnissen, Bilder und PDFs, die Tool-Definitionen selbst und die eigene Ausgabe des Modells einschließlich Extended Thinking (Claude Platform-Dokumentation). Anthropic stellt es als natürliche Weiterentwicklung des Prompt Engineerings dar, nicht als Ersatz dafür.
Bedeutet ein größeres Kontextfenster immer bessere KI-Ausgaben?
Nein. Beworbener Kontext und nutzbarer Kontext sind zwei verschiedene Zahlen: Der NoLiMa-Benchmark testete 13 Modelle, die alle 128K-Unterstützung oder mehr beanspruchen, und bei 32K Token lagen 11 von 13 unter der Hälfte ihrer eigenen Kurzkontext-Baseline, wobei Llama 3.1 70B von 94,3 % auf 42,7 % fiel (arXiv:2502.05167, Februar 2025). Anthropics eigene Plattformdokumentation sagt es klar: „Mehr Kontext ist nicht automatisch besser. Mit wachsender Token-Anzahl nehmen Genauigkeit und Recall ab“ (Claude Platform-Dokumentation). Das Fenster zu füllen kostet auch Geld in Stufen statt in einer Linie, da OpenAI GPT-5.4-Prompts über 272K Eingabe-Token für die gesamte Sitzung mit 2x Eingabe und 1,5x Ausgabe berechnet (OpenAI API-Dokumentation).
Was ist Context Rot und wie vermeide ich sie?
Context Rot ist der Abbau von Genauigkeit und Recall, wenn die Token-Anzahl in einer Anfrage wächst, und Anthropic benennt sie in der eigenen Dokumentation (Claude Platform-Dokumentation). Chromas Context-Rot-Studie testete 18 Modelle, darunter GPT-4.1, Claude 4, Gemini 2.5 und Qwen3, und stellte fest, dass die Zuverlässigkeit bei längeren Eingaben selbst bei trivialen Retrieval- und Wortwiedergabe-Aufgaben sinkt; in ihrem LongMemEval-Test schnitt jede Modellfamilie bei einem fokussierten ~300-Token-Prompt besser ab als bei derselben Frage, die in ~113k Token Gesprächshistorie begraben war, wobei Claude-Modelle die größte Lücke zeigten (Chroma, Juli 2025). Vermeide sie, indem du nur die relevanten Passagen einfügst, für neue Themen neue Chats startest statt alte zu verlängern, und spezialisierte Agenten verdichtete 1.000- bis 2.000-Token-Zusammenfassungen an einen koordinierenden Agenten zurückgeben lässt statt vollständige Transkripte (Anthropic Engineering).
Soll ich den Speicher von ChatGPT, Claude oder Gemini deaktivieren?
Das hängt von der Aufgabe ab, weil Speicher Token, die du nicht gewählt hast, in ein Fenster injiziert, in dem alles gegen das Gesamtlimit zählt (Claude Platform-Dokumentation). Bei routinemäßigem Verfassen, bei dem das Modell deine Rolle, deinen Stil und deinen Stack kennen sollte, um das erneute Eintippen zu ersparen, lass ihn an. Bei einer hochriskanten Analyse eines bestimmten Dokuments starte einen sauberen Chat mit deaktiviertem Speicher, da Chroma feststellte, dass jede Modellfamilie bei einem fokussierten ~300-Token-Prompt besser antwortete als bei derselben Antwort, umgeben von ~113k Token nicht zusammenhängender Historie (Chroma). Behandle Speicher als einen stehenden Prompt, für den du bei jedem Turn zahlst, und pflege ihn, wie du einen System-Prompt pflegen würdest.
Brauche ich RAG, oder kann ich meine Dokumente einfach in den Prompt einfügen?
Anthropics Leitlinien besagen, dass Retrieval im kleinen Maßstab oft unnötig ist: „Wenn deine Wissensbasis kleiner als 200.000 Token (etwa 500 Seiten Material) ist, kannst du die gesamte Wissensbasis einfach in den Prompt aufnehmen“ (Anthropic Engineering, September 2024). Darüber hinaus summiert sich Retrieval-Hygiene in Anthropics Benchmark: Das Voranstellen von chunk-spezifischem Kontext vor dem Einbetten senkte die Top-20-Retrieval-Fehler von 5,7 % auf 3,7 %, das Hinzufügen von kontextuellem BM25-Hybridsuche auf 2,9 %, und ein Reranking-Durchlauf auf 1,9 %, eine Gesamtreduktion von 67 %. Wenn dein Korpus passt, ist Einfügen der bessere Standard, und Prompt-Caching macht die Wiederverwendung günstig bei Cache-Lesevorgängen zum 0,1x-Basis-Eingabepreis (Claude Platform-Dokumentation).
Wo soll ich lange Dokumente im Prompt platzieren – vor oder nach meiner Frage?
Bei Claude stelle die Langformdaten an den Anfang, über deine Anfrage, Anweisungen und Beispiele. Anthropics Prompting-Dokumentation gibt das als konkrete Regel für Eingaben von 20k Token oder mehr und sagt: „Anfragen am Ende können die Antwortqualität in Tests um bis zu 30 Prozent verbessern, besonders bei komplexen, mehrdokumentigen Eingaben“ (Claude Platform-Dokumentation). Dieselben Dokumentation empfiehlt, jedes Dokument in <document>-Tags mit <source>- und <document_content>-Untertags zu verpacken und das Modell zu bitten, die relevanten Passagen vor der Antwort zu zitieren. Anbieter sind sich bei der Reihenfolge nicht einig, sodass ein Template aus dem Kochbuch eines Anbieters beim Modell eines anderen schwächer abschneiden kann – und es lohnt sich, beide Reihenfolgen einmal bei der eigenen Aufgabe zu testen.