

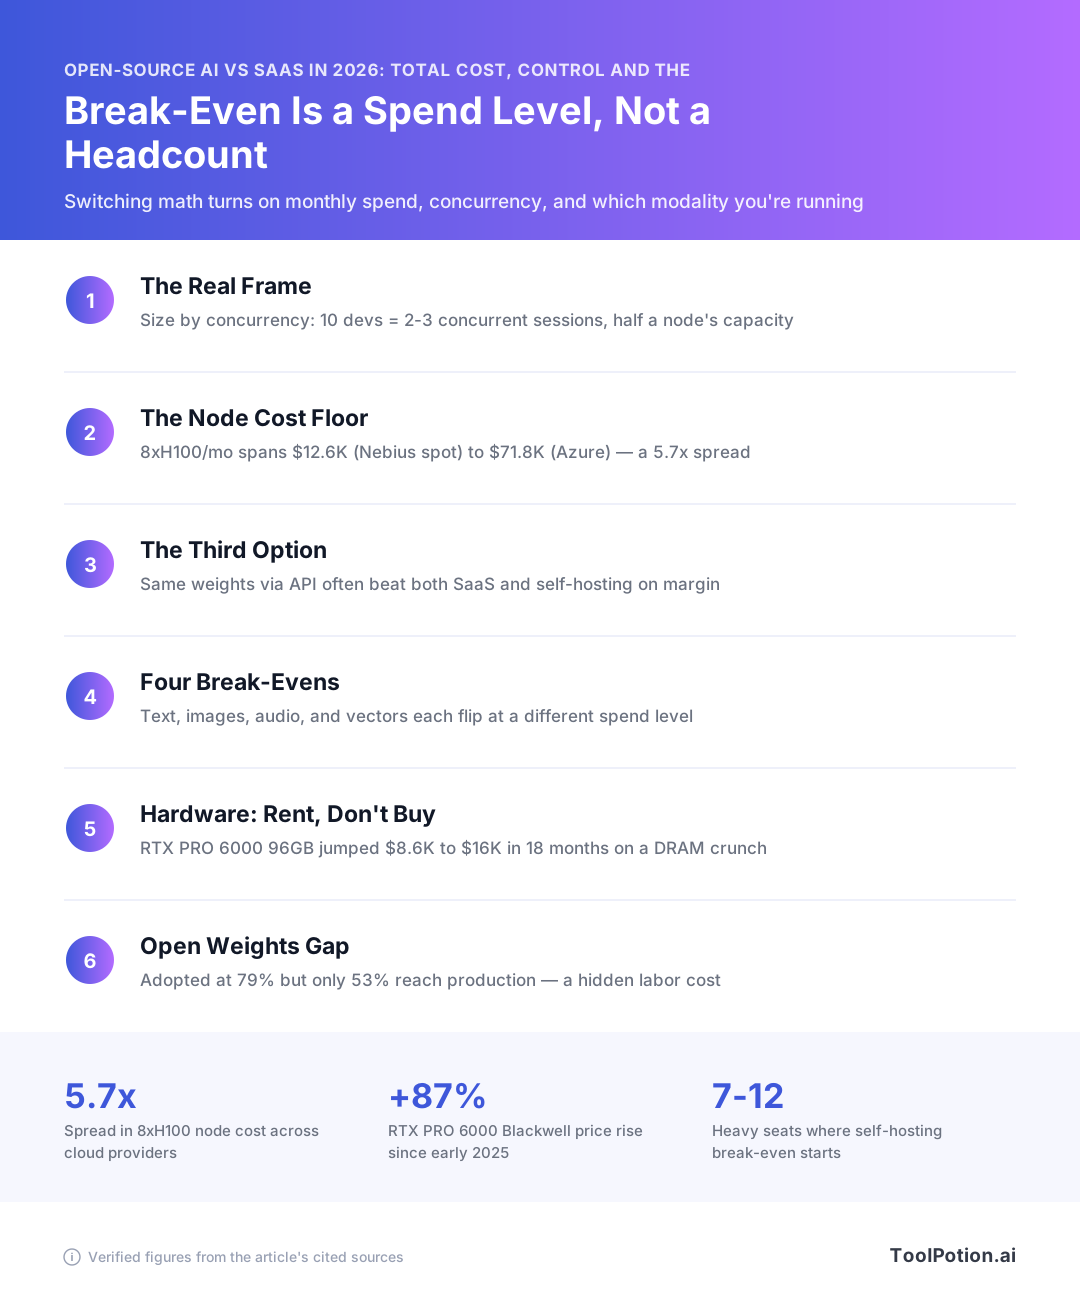
Die Entscheidung zwischen Open-Source-KI und SaaS hängt von zwei Zahlen ab: Ihrem monatlichen Verbrauch und Ihrem Gleichzeitigkeitsprofil. Mitarbeiterzahl ist ein schlechter Näherungswert für beides. DoiTs eigene Ingenieure kommen im Schnitt auf $2.200 pro Entwickler pro Monat bei nutzungsbasiertem Claude Code, was einen 15.000–25.000-Dollar-Node bei ungefähr 7 bis 12 intensiven Seats in die Diskussion bringt. Aber nur 10–20 % eines Teams hat gleichzeitig eine Anfrage in Bearbeitung, sodass zehn Entwickler zwei oder drei parallele Sessions bedeuten – und ein halber Node im Leerlauf liegt.
Und bevor Sie überhaupt GPU-Preise kalkulieren, prüfen Sie die dritte Option, gegen die niemand benchmarkt: DeepInfra liefert Llama-3.3-70B für $0,10 Input / $0,32 Output pro Million Tokens. Identische Gewichte, Multi-Tenant-Margen, die Sie nicht toppen können. Die folgende Rechnung wird viermal durchgeführt – für Text, Bilder, Transkription und die Vektorschicht.
Break-even ist ein Ausgabenniveau und ein Gleichzeitigkeitsprofil
Zwei Zahlen entscheiden, ob Sie selbst hosten sollten – und die Teamgröße ist keine davon. Die erste: Was Sie derzeit monatlich für KI ausgeben. Die zweite: Wie viele Anfragen gleichzeitig in Bearbeitung sind. Alles andere – auch die Modellwahl – ist diesen beiden nachgelagert.
Die zwei Zahlen, die vor jeder Modellwahl entscheiden
Ein GPU-Node kostet dasselbe, egal ob Sie ihn auslasten oder nachts um 3 Uhr im Leerlauf lassen. Das ist die Asymmetrie, auf der der gesamte Vergleich beruht: SaaS berechnet pro Token, ein Node pro Stunde. Die Frage ist also, ob Ihre Monatsrechnung die Fixkosten eines Servers übersteigt, den Sie ausgelastet halten können.
DoiTs Engineering-Team kommt im Schnitt auf etwa $2.200 pro Entwickler pro Monat bei nutzungsbasiertem Claude Code Enterprise Pricing, was einen Break-even von $15.000–$25.000/Monat für Self-Hosting bei etwa 7 bis 12 intensiven KI-Seats ergibt. Das ist eine deutlich niedrigere Schwelle als die "Sie brauchen Hunderte von Ingenieuren"-Aussage, die die meisten TCO-Leitfäden wiederholen. Es ist eine Ausgabenschwelle, keine Personalschwelle. Zwölf Entwickler, die einen Assistenten kaum nutzen, kommen nicht ans Ziel, während sieben, die täglich Agenten laufen lassen, es schaffen.
Gleichzeitigkeit ist die zweite Zahl – und die, bei der Teams regelmäßig falsch liegen. DoiTs Argument: Zu jedem gegebenen Zeitpunkt hat nur 10–20 % eines Entwicklerteams eine Anfrage in Bearbeitung, sodass zehn Entwickler zwei oder drei parallele Sessions bedeuten – bestenfalls die halbe Kapazität eines Nodes. Sie bezahlen für acht H100 und nutzen drei oder vier. Dimensionieren Sie nach maximalen parallelen Anfragen und Ziel-Token-Durchsatz, und prüfen Sie dann, ob das auf einen Node passt – bevor Sie irgendetwas kalkulieren.
Warum '50 Ingenieure im Team' der falsche Auslöser ist
Mitarbeiterzahl korreliert nur dann mit Ausgaben, wenn die Nutzung pro Person einheitlich ist – und das ist sie nie. Ein 50-köpfiges Team, bei dem 8 Personen Coding-Agenten dauerhaft laufen lassen und 42 gelegentlich den Chat nutzen, hat denselben Node-Bedarf wie ein 8-köpfiges Team aus Intensivnutzern – und in etwa dieselbe Rechnung. Zählen Sie die intensiven Seats.
Ermitteln Sie diese zwei Zahlen, bevor Sie die im Verzeichnis gelisteten Open-Weight-Modelle mit irgend etwas vergleichen. Wählen Sie das Modell, nachdem Sie wissen, ob ein Node ausgelastet bleiben kann, denn ein Modell, das 6 Punkte hinter der Frontier liegt, ist ein guter Tausch auf einem ausgelasteten Server – und ein teurer Fehler auf einem, der bei einem Viertel Auslastung läuft.
Open-Source-KI vs. SaaS: Was Self-Hosting 2026 kostet
Beginnen Sie mit der Preisliste – denn das ist die einzige Zahl, die Sie direkt nachschlagen können. Alles andere im Self-Hosting-Budget ist eine Schätzung, die Sie in einer Tabelle verteidigen müssen.
Gemietete GPU-Preislisten: ~7-fache Spanne bei inferenzfähigem Silizium
RunPods öffentliche Preisliste führt H100 SXM 80GB mit $3,29/Std. (Secure Cloud) und $2,69/Std. (Community Cloud), H200 141GB mit $4,59/$3,59, A100 PCIe 80GB mit $1,39/$1,19, L40S 48GB mit $0,99/$0,79 und B200 180GB mit $6,79/$5,98 (RunPod). Das ist grob ein 7-facher Unterschied zwischen der günstigsten und teuersten Karte, die Inferenz leisten kann. Wenn Ihre Workload ein 7B- oder 8B-Modell mit moderatem Kontext ist, sollten Sie die L40S-Linie bepreisen – die meisten TCO-Beiträge erwähnen sie nie.
Lambda berechnet $4,29/Std. für einen einzelnen H100 SXM on-demand, mit $3,99/Std. pro GPU auf einem 8x-Node, H100 PCIe bei $3,29/Std. und B200 SXM6 bei $6,69–$6,99/Std. (Lambda). Ein 8xH100-Node zu diesem Preis kostet ca. $31,92/Std. – oder rund $23.300 für einen 730-Stunden-Monat bei 100 % Betriebszeit. Niemand läuft bei 100 % Betriebszeit, was der Kern der nächsten Zahl ist.
Der Commitment-Rabatt ist der größte einzelne Hebel, den Sie kontrollieren. Together AI berechnet $3,99/GPU-Std. on-demand für HGX H100 und $3,19–$3,69/GPU-Std. zu reservierten Konditionen von 7 bis 180+ Tagen (Together AI). Nennen wir es 20 % Rabatt – verfügbar nur, wenn Sie von Ihrer Auslastung überzeugt genug sind, um die Laufzeit zu unterschreiben.
Der Anbietermultiplikator: $12.600 bis $71.800 für denselben 8xH100-Monat
DoiT hat einen identischen 8xH100-Node für einen 730-Stunden-Monat über verschiedene Anbieter bepreist: etwa $12.600 bei Nebius Spot, $22.500 bei Nebius On-Demand, $40.200 bei AWS, $64.100 bei GCP und $71.800 bei Azure (DoiT). Gleiches Silizium, 5,7-fache Spanne. Ihre Anbieterwahl verändert die Wechselrechnung stärker als Ihre Modellwahl. Wenn Sie diese Evaluation mit Hyperscaler-Listenpreisen durchführen, weil dort Ihr gebundenes Budget liegt, vergleichen Sie die schlechteste Version von Self-Hosting mit SaaS.
| Anbieter / Karte | Stundensatz | Hinweise |
|---|---|---|
| RunPod L40S 48GB | $0,99 / $0,79 | Secure vs. Community Cloud |
| RunPod H100 SXM 80GB | $3,29 / $2,69 | Secure vs. Community Cloud |
| Lambda H100 SXM (8x-Node) | $3,99 pro GPU | ~$23.300 / 730-Std.-Monat |
| Together AI HGX H100 | $3,99 on-demand, $3,19–$3,69 reserviert | 7–180+ Tage Laufzeit |
Die Positionen, die niemand bepreist: Leerlaufstunden, Redundanz und Wartungsaufwand
Ein gemieteter Node wird nach Wanduhr abgerechnet. Ihre API-Rechnung erfasst Token, Ihre GPU-Rechnung Stunden, die Sie möglicherweise nie nutzen. Wenn Ihr Traffic auf Geschäftszeiten und Werktage beschränkt ist, zahlen Sie für rund 168 nutzbare Stunden von 730 und tragen den Rest, also multiplizieren Sie Ihre effektiven Token-Kosten mit vier, bevor Sie sie mit einer API-Rechnung vergleichen. Fügen Sie einen zweiten Node oder einen Fallback-API-Key hinzu, wenn der Dienst kundenseitig genutzt wird, da ein einzelner Node kein Failover hat. Rechnen Sie den Ingenieur ein, der vLLM patcht, Modellversionen rotiert, den KV-Cache-Druck überwacht und nachts um 2 Uhr angerufen wird. Anbieter in unserem Verzeichnis für Machine-Learning-Plattformen übernehmen einen Teil davon gegen eine Marge – was meist günstiger ist als die halbe Stelle, die Sie sonst einsetzen würden.
Eine vertretbare monatliche Zahl ist also: Node-Stunden zum tatsächlichen Anbietertarif, geteilt durch Ihre tatsächliche Betriebszeit, plus Redundanz, plus belasteter Engineering-Zeit. Führen Sie alle vier durch, bevor Sie irgendetwas vergleichen.
Die dritte Option, die die meisten Self-Hosting-Fälle entkräftet
Fast jeder Artikel, der Open Source mit SaaS vergleicht, stellt eine GPU-Rechnung neben eine Frontier-API-Rechnung und erklärt einen Gewinner. Dieser Vergleich überspringt die Option, für die sich die meisten Teams entscheiden sollten: Jemand anderes betreibt die Open Weights für Sie, multi-tenant, und berechnet pro Token.
DeepInfra liefert Llama-3.3-70B-Instruct-Turbo für $0,10 Input / $0,32 Output pro Million Tokens und Meta-Llama-3.1-8B für $0,02/$0,04 (DeepInfra). Dieselben Checkpoints, die Sie herunterladen würden. Dieselben Lizenzbedingungen. Der Unterschied: Ihre H100s laufen nahe der Kapazität über tausende Kunden, und Ihre laufen bei welchem Traffic auch immer Sie sonntags um 3 Uhr haben.
Identische Open Weights, die Auslastungskurve eines anderen
Rechnen Sie gegen DeepInfras eigenen Dedicated-Tier nach, und die Lücke wird peinlich. Ein dedizierter H100 80GB kostet dort $2,20/Std. (DeepInfra), also $1.606 für einen 730-Stunden-Monat. Bei $0,32 pro Million Output-Token kauft dieselbe Summe von $1.606 rund fünf Milliarden Output-Token am Serverless-Endpunkt. Verteilt über die 43.800 Minuten dieses Monats müsste Ihr einzelner H100 kontinuierlich etwa 115.000 Output-Token pro Minute erzeugen – nur um preislich mit der API gleichzuziehen. Ein realer Betrieb verbringt einen großen Teil dieser Minuten im Leerlauf.
Dedizierte Kapazität kauft man aus anderen Gründen als dem Stückpreis: Datenresidenz, keine Drittanbieter-Datenhaltung, Latenz-Untergrenzen, die Sie kontrollieren, eigene LoRAs, Modelle, die niemand hostet. Das sind echte Gründe. Es sind Beschaffungsgründe, keine Tabellengründe – und das sollten Sie laut sagen, wenn Sie das Vorhaben pitchen.
Wann das Mieten der Weights aufhört, günstiger zu sein
Das untere Ende des Kleinmodellmarkts hat sich zusammengezogen. GPT-5-nano kostet $0,05/$0,40 pro Million Tokens und GPT-5 $1,25/$10,00 (OpenAI), was bedeutet, dass ein proprietäres Modell jetzt günstiger ist als das, was Sie zahlen würden, um ein 8B-Open-Modell auf eigener Hardware warm zu halten. Günstige Open-Weight-APIs und günstige proprietäre APIs konkurrieren auf derselben Achse – und Self-Hosting verliert gegen beide.
Wählen Sie Ihren Benchmark sorgfältig, denn er entscheidet das Ergebnis. Anthropics Spektrum reicht von $10/$50 pro Million für Fable 5.1 bis $1/$5 für Haiku 4.5 (Anthropic). Vergleichen Sie Self-Hosting mit dem oberen Ende dieses Spektrums, sieht es wie ein Schnäppchen aus. Vergleichen Sie es mit Haiku oder DeepInfras Llama, muss sich der GPU-Node durch Kontrolle rechtfertigen – nicht durch Kosten.
Vier Modalitäten, vier völlig verschiedene Break-even-Punkte
Ein Team, das Transkription selbst hostet, hostet Text-Inferenz fast nie selbst – und der Grund ist Arithmetik. Jede Workload hat ihren eigenen SaaS-Mindestpreis, ihr eigenes GPU-Lastmuster und ihre eigenen Lizenzregeln. Wenden Sie ein Break-even-Modell auf alle vier an, und Sie erhalten dreimal die falsche Antwort.
Text-Inferenz: der breiteste und am wenigsten vorhersehbare Kippunkt
Dies ist die Modalität, bei der der Kippunkt am stärksten variiert, weil der API-Preis, mit dem Sie vergleichen, eine Größenordnung überspannt. Anthropic berechnet $2/$10 pro Million Input/Output-Token für Sonnet 5 und $1/$5 für Haiku 4.5 (Claude-Preise), während OpenAI GPT-5-mini mit $0,25/$2,00 und GPT-5-nano mit $0,05/$0,40 listet (OpenAI API-Preise). Wählen Sie Ihre Benchmark-Stufe, und der Break-even schwankt von einigen hundert Millionen Token pro Monat bis zu mehreren Milliarden.
Ein dedizierter H100 bei $2,20/Std. auf DeepInfra läuft bei Vollzeitbetrieb für ca. $1.606 pro Monat (DeepInfra-Preise). Gegenüber GPT-5-nanos gemischtem Tarif bräuchten Sie ein Volumen, das die meisten Teams nie erreichen. Gegenüber Fable 5.1 bei $10/$50 pro Million (Claude-Preise) amortisiert sich derselbe Node viel früher. Entscheiden Sie, welche Stufe Ihre Workload braucht, bevor Sie irgendwas modellieren – und schauen Sie sich die Modell- und LLM-Listings an, wenn Sie Open Weights noch in der engeren Wahl haben.
Bildgenerierung: Die Lizenz entscheidet, bevor es die GPU tut
Hier ist die GPU-Rechnung der einfache Teil – und die Lizenz die Falle. Es wird weitläufig berichtet, dass FLUX.1 [dev]-Weights unter einer nicht-kommerziellen Lizenz ausgeliefert werden, was eine bezahlte Black Forest Labs-Lizenz zwischen Sie und ein kommerzielles Produkt stellen würde. Lesen Sie die Bedingungen selbst, bevor Sie die Hardware budgetieren. Niemand, der Open-Image-Modelle mit Midjourney vergleicht, erwähnt das – dabei ist es die Position, die die Entscheidung kippen kann.
Stoßweise anfallende Bildarbeit ist das, was den Test nicht besteht. Ein Marketing-Team, das dienstags in Schüben generiert, lässt die Karte für den Rest der Woche leer laufen – und Leerlaufstunden werden zum gleichen Tarif berechnet wie Arbeitsstunden. Ein L40S bei $0,79/Std. auf RunPod Community Cloud (RunPod-Preise) ist günstig genug, dass kontinuierliche Batch-Jobs die Hürde problemlos nehmen – deshalb sind geplante Pipelines die Form, die hier funktioniert. Es gibt 727 Bildgenerierungs-Tools in unserem Verzeichnis, und die Lizenzbedingungen variieren stärker als die Ausgabequalität.
Transkription: die Modalität, die am schnellsten kippt
Außer dass sie es meistens nicht tut – und der Grund ist AssemblyAI. OpenAI berechnet $0,006/Minute für Whisper und gpt-4o-transcribe sowie $0,003/Minute für gpt-4o-mini-transcribe, also $0,36 und $0,18 pro Audio-Stunde (OpenAI API-Preise). Gegenüber $0,36/Stunde erreicht ein L40S bei $0,79/Std. den Break-even bei grob einigen hundert Audio-Stunden pro Monat – vorausgesetzt, schnellerer-als-Echtzeit-Batch-Durchsatz. Das ist eine echte niedrige Schwelle. Dann bepreist AssemblyAI Universal-2 bei $0,15/Stunde und Universal-3.5 Pro bei $0,21/Stunde (AssemblyAI-Preise) – und Ihr Break-even verschiebt sich um mehr als das 2-fache nach oben.
Der einzige Bereich, in dem Self-Hosting klar gewinnt, ist Streaming. AssemblyAI berechnet Streaming pro WebSocket-Sitzungsdauer, einschließlich Leerlaufverbindungszeit (AssemblyAI-Preise). Wenn Sie Sockets für Meetings offen halten, in denen niemand spricht, zahlen Sie für Stille. Ein selbst gehosteter Endpunkt berechnet GPU-Sekunden statt Wanduhr.
RAG und die Vektorschicht laufen auf Abfragevolumen
Der Break-even bei der Vektorsuche wird in Abfragen pro Monat gemessen, und die Faustregel liegt irgendwo bei 60 bis 80 Millionen Abfragen, bevor Self-Hosting Managed Pricing schlägt. Behandeln Sie das als Daumenregel und nicht als Preisliste, da sie sich mit Indexgröße, Replikatanzahl und Ihrem Latenzbudget verändert. Unterhalb dieser Schwelle bezahlen Sie einen Ingenieur dafür, einen Index zu hüten, den ein Managed Service für weniger als sein Gehalt betreiben würde. Embedding-Generierung ist eine separate Kalkulation – und das günstigste, was von allem hier Genannten selbst zu hosten ist, weil das Modell klein ist und die Arbeit perfekt in Batches läuft.
Vier Workloads, vier Schwellenwerte – und kein Grund, alle auf einmal zu verschieben.
Hardware kaufen? Die Speicherkrise 2026 sagt: Mieten
Jede Amortisationsrechnung, die vor Mitte 2026 geschrieben wurde, rechnet mit Preisen, die es nicht mehr gibt. Der Rat war damals vernünftig: Kaufen Sie einen Server, amortisieren Sie ihn über drei Jahre, schlagen Sie den Mietpreis ab Monat 14. Dann brach der Speichermarkt zusammen.
Rund 87 % Preissteigerung bei unveränderter GPU
NVIDIAs RTX PRO 6000 Blackwell 96GB ist das deutlichste Beispiel, weil sich das Produkt nicht verändert hat. Es wurde Anfang 2025 bei einem Händler für $8.565 gelistet (mit einem Vorbestellungs-Tief von $7.673), erreichte im Juni 2026 $13.250 und im August 2026 $16.000 (igor'sLAB). Das sind rund 87 % in etwa 18 Monaten – und NVIDIA hat keine offizielle Erklärung veröffentlicht.
Rechnen Sie das durch eine Tabellenkalkulation aus dem Jahr 2025, und der Amortisationsmonat verdoppelt sich in etwa. Ein Einzelkarten-Workstation-Build, den Sie mit $12.000 veranschlagt hatten, kommt jetzt vor dem RAM auf annähernd $20.000.
Warum HBM das DRAM-Angebot aufgefressen hat
GPU-Nachfrage ist nur die halbe Geschichte. Entscheidend ist, was diese Nachfrage mit den Speicher-Fabs gemacht hat: High-Bandwidth-Memory beansprucht nun schätzungsweise 23 % der weltweiten DRAM-Wafer-Kapazität, gegenüber 8 % im Jahr 2024, weil HBM das 3- bis 5-fache des Umsatzes pro Wafer im Vergleich zu konventionellem DDR5 erzielt (DatacenterDisk). Die Fabs haben die Wafer dorthin verschoben, wo das Geld ist. Server-DDR5-ECC-RDIMM-Preise stiegen infolgedessen zwischen Q1 2025 und Q1 2026 um rund 100 bis 116 %, sodass der Hostspeicher rund um Ihre GPUs genauso hart getroffen wurde wie die Beschleuniger. Das spüren Sie zweimal in einem Build: bei der Karte und beim 1 TB Systemspeicher darunter.
Was ein 2026 geschriebener Abschreibungsplan annehmen sollte
Gehen Sie davon aus, dass die Verzerrung Ihre Kaufentscheidung überdauert. Goldman Sachs prognostizierte im Mai 2026 ein globales DRAM-Defizit von 4,9 % für das Jahr – das größte in 15 Jahren – sowie eine HBM-Angebotslücke von 5,1 %, und die meisten Analysten erwarten keine nennenswerte Entspannung vor Ende 2027 (Wccftech). Ein heute begonnener Drei-Jahres-Abschreibungsplan verbringt seine ersten zwei Jahre innerhalb der Knappheit.
Bepreisen Sie den Kauffall daher mit den Anschaffungskosten vom August 2026 und nicht mit den Zahlen aus 2025, die auf Ranking-Seiten noch stehen – und rechnen Sie nicht mit einer günstigeren Neuauflage in Jahr zwei. Wenn die Zahlen nur mit Hardware-Preisen aus 2025 aufgehen: Mieten. Mieten ist der Weg, um sich die Option offenzuhalten, 2028 zu kaufen.
Kontrolle und Compliance: Der Teil, den die Tabelle nicht erfasst
Manche Garantien bekommen Sie nur, wenn Sie die Weights selbst betreiben. Die meisten, die Teams als Grund für Self-Hosting anführen, können Sie inzwischen kaufen.
Was Self-Hosting wirklich bringt – und was es nur zu bringen scheint
Wenn Sie eigene Inferenz betreiben, erhalten Sie vier Dinge, die kein Vertragsklausel repliziert: Modellgewichte, die sich nicht unter Ihnen aufgrund eines Vendor-Deprecation-Zeitplans ändern, keine pro-Anfrage ausgehenden Daten aus Ihrer VPC, keine Rate Limits, die durch fremde Kapazitätsplanung auferlegt werden, und die Möglichkeit, ohne Genehmigung zu feintunen oder zu quantisieren. Wenn Ihr Risikoregister eine Zeile über ein während eines Audits zurückgezogenes Modell enthält, ist das ein echtes Argument dafür, das Artefakt zu besitzen.
Die Liste der Dinge, die Self-Hosting nur zu bieten scheint, ist länger. Datenresidenz, Verschlüsselung im Ruhezustand, Verpflichtungen zu keiner Trainingsnutzung Ihrer Daten, SOC-2-Nachweise, Audit-Logs, regionale Verarbeitung: All das ist als Vertragsbedingung plus Regionsauswahl käuflich – und das ist es schon eine Weile. Dafür eine GPU-Prämie zu zahlen bedeutet, zweimal zu kaufen. Das Risiko, das diese Diskussionen antreibt, ist die Strafmathe – und die interessiert sich nicht dafür, wer die Hardware rackt. Regulatoren haben bis Anfang 2026 €7,1 Milliarden in 2.245 DSGVO-Bußgeldern verhängt, mit DSGVO-Haftung von bis zu 4 % des weltweiten Umsatzes und KI-Gesetz-Haftung von bis zu 7 %. Ein selbst gehostetes Modell, das falsch konfiguriert ist, schlägt ein Audit genauso schnell fehl wie ein gehostetes.
Das regulatorische Reset von 2026 hat die Fristen verändert, gegen die Sie planen
Überprüfen Sie das Datum der Compliance-Zeitlinie, mit der Ihr Team arbeitet. Die Hochrisiko-Verpflichtungen des EU KI-Acts wurden durch das Digital Omnibus 2026 verschoben, sodass die Frist vom 2. August 2026, die mehrere weit zitierte Vergleichsseiten noch drucken, überholt ist – und Sie sollten die aktuellen Termine mit Ihrem eigenen Rechtsbeistand bestätigen, bevor Sie dagegen investieren. Wenn Sie Anfang 2026 ein Self-Hosting-Budget genehmigt haben, um dieses Datum zu schlagen, ist die Dringlichkeit, auf der es aufgebaut war, weg – und die Ausgaben verdienen einen zweiten Blick.
Das betrifft am stärksten regulierte Branchen. Teams, die Healthcare- und Life-Sciences-KI-Tools einkaufen, haben am wahrscheinlichsten eine private Bereitstellung gegen eine Frist kalkuliert, die sich verschoben hat.
Souveräne Managed Cloud ist der mittlere Weg
Das Residenz-Argument wurde 2026 schwächer. Souveräne Cloud-Regionen, die innerhalb der EU betrieben und verwaltet werden, sind nun eine Managed-Option, die es nicht gab, als die meisten Open-Source-vs.-SaaS-Vergleiche geschrieben wurden – prüfen Sie also, was Ihr bevorzugter Hyperscaler in der Region anbietet, bevor Sie einen Node bepreisen. Sie können eine EU-exklusive Datenverarbeitung erhalten, ohne jemanden einzustellen, der vLLM nachts um 2 Uhr betreut.
Die Reihenfolge, die Bestand hat, lautet so: Wenn Ihr Bedarf Residenz ist, kaufen Sie Sovereign Managed. Wenn es Gewichtspermanenz oder unbeschränktes Finetuning ist, hosten Sie selbst. Wenn es eine Zeile in einem Fragebogen ist, die besagt, dass Daten Ihre Kontrolle nicht verlassen dürfen, lesen Sie zuerst, was Ihr Prüfer akzeptiert, bevor Sie einen Node unterzeichnen.
Wie weit hinten liegen Open Weights wirklich?
Vier Monate. Das ist der gemessene Rückstand – und das ist die Zahl, die ersetzen sollte, was Sie derzeit über Open Models glauben, die eine Generation zurückliegen.
Vier Monate und sechs Indexpunkte
Epoch AI hat das quantifiziert, indem sie das beste Open-Weight-Release gegen die geschlossene Frontier auf dem Epoch Capabilities Index zwischen dem 1. Januar und dem 28. Mai 2026 verfolgt haben: ein 4-Monats-Rückstand, bzw. 8 ECI-Punkte mit einem 90-%-Konfidenzintervall von 7 bis 11. Artificial Analysis misst dasselbe auf andere Weise und kommt zu demselben Ergebnis. Open-Leader erzielen 52 bis 54 auf dem Intelligence Index gegenüber GPT-5.5's 60 – eine Lücke von 6 Punkten, die vor zwölf Monaten noch 13 Punkte betrug.
Die Lücke ist also real und schließt sich. Für die meisten Produktions-Workloads (Klassifizierung, Extraktion, Zusammenfassung, retrieval-augmentierte Antworten, erster Code-Entwurf) ist eine vier Monate alte Frontier in Ordnung. Für das schwere Reasoning am Ende nicht – und kein Prompt-Engineering schließt 8 ECI-Punkte. Wählen Sie Ihre Workload, bevor Sie Ihre Seite des Arguments wählen. Die im Verzeichnis erfassten Open-Weight-Releases wechseln schnell genug, dass ein Modell, das Sie im März benchmarkten, nicht das ist, das Sie heute deployen würden.
Die Adoptions-zu-Produktions-Lücke, die Teams echtes Geld kostet
Open Models verlieren beim Ausliefern, nicht bei den Fähigkeiten. Die State of Open Source AI-Umfrage 2026 (N=1.410) ergab, dass 79 % der KI-Entwickler Open Models adoptieren, aber nur 53 % sie in die Produktion bringen, gegenüber 71 % Adoption und 63 % Produktion bei Closed Models. Sie werden öfter ausprobiert und seltener ausgeliefert.
Dieser 26-Punkte-Rückgang ist Engineering-Zeit, die Sie bezahlen und nicht in Ihrer TCO-Tabelle erfassen. Er verschlimmert sich auch mit der Größe, anstatt besser zu werden: Closed-Model-Produktionsraten steigen von 54 % bei kleinen Unternehmen auf 73 % bei Enterprises, während Open bei 53 % bis 57 % nahezu stagniert. Die Organisationen mit den meisten Platform-Engineers geben Open-Deployments am häufigsten auf – das Gegenteil von dem, was die Self-Hosting-Argumentation vorhersagt. Budgetieren Sie für die Versuche, die nicht zum Ziel kommen.
Migrationspfade: Was der Wechsel wirklich kostet
Der Wechsel selbst ist günstig. Was Sie kostet, ist die Eval-Arbeit, die Sie vor dem Wechsel übersprungen haben – und die Sie dann mit Produktionsvorfällen bezahlen.
Der Base-URL-Tausch und die dokumentierten Ausnahmen, die es wert sind, benannt zu werden
vLLM liefert einen OpenAI-kompatiblen Server – für eine einfache Chat-Completion besteht die Migration also aus einer Base-URL und einem Modell-Alias. Richten Sie Ihren bestehenden Client auf Ihren Endpunkt, ändern Sie model von gpt-5-mini auf das, was Sie ausliefern, behalten Sie den Rest des Codes. Das ist der Teil, den jeder Konkurrent als Black Box behandelt – und es ist ehrlich gesagt die einfache Hälfte.
Die Ausnahmen sind dort, wo Teams eine Woche verlieren. Strukturierte Ausgaben und strikte JSON-Schema-Durchsetzung verhalten sich über verschiedene Serving-Stacks unterschiedlich, sodass alles, was auf garantiert gültige Funktionsargumente angewiesen ist, mit echten Payloads getestet werden muss – nicht mit einem Smoke-Test. Parallele Tool-Calls sind eine häufige Lücke. Prompt-Caching ist anbieterspezifisch, und wenn Ihr Kostenmodell gecachte Eingaberaten auf der SaaS-Seite einberechnet hatte, folgt Ihnen dieser Rabatt nicht. Langkontext-Verhalten degradiert an anderen Punkten als das Kontextfenster ankündigt, und Tokenizer unterscheiden sich ebenfalls – was bedeutet, dass Ihre Token-zählbasierten Budgets und Ihre Abschneideslogik beide neu kalibriert werden müssen.
Bauen Sie das Eval-Harness vor der Umstellung auf – nicht danach
Wenn Sie Qualität auf Ihrem eigenen Traffic nicht messen können, können Sie nicht beurteilen, ob ein vier Monate alter Fähigkeitsrückstand für Ihren Use Case wichtig ist oder nicht. Erfassen Sie einige hundert echte Produktionsanfragen mit ihren Ausgaben, bewerten Sie sie so, wie Ihr Unternehmen sie bewertet, und führen Sie dann das kandidatenhafte Open Model gegen denselben Satz aus. Tun Sie das, bevor Sie eine GPU bereitstellen.
- Protokollieren Sie 200 bis 500 echte Anfragen mit Antworten und allen nachgelagerten Signalen, die Sie bereits erfassen (Daumen, Bearbeitungen, Wiederholungen, Eskalationen).
- Bewerten Sie die SaaS-Ausgabe des bisherigen Systems, um Ihre Baseline zu etablieren. Sie brauchen die Zahl, die Sie verteidigen, nicht ein Bauchgefühl.
- Führen Sie den Open-Weight-Kandidaten zunächst über eine API aus – DeepInfra liefert Llama-3.3-70B für $0,10 Input / $0,32 Output pro Million Tokens (DeepInfra) und kostet Sie nichts an Infrastruktur zum Testen.
- Erst wenn die Qualität hält und das Volumen es rechtfertigt, wechseln Sie zu dedizierter Kapazität.
Der hybride Standard: Routing nach Request-Klasse statt vollständigem Ersatz
Verteilen Sie Traffic danach, was jede Anfrage wert ist. Klassifizierung, Extraktion, Zusammenfassung und Retrieval-Reformulierung laufen gut auf einem 8B-Modell für $0,02/$0,04 pro Million Tokens (DeepInfra), und das schwere Reasoning-Ende geht an Sonnet 5 für $2/$10 (Anthropic). Wenn 80 % Ihrer Aufrufe die günstige Klasse sind, haben Sie den größten Teil der Rechnung reduziert, ohne die Qualität auf ein einzelnes Modell zu setzen.
Routing gibt Ihnen auch einen Fallback-Pfad, den ein vollständiger Ersatz nicht bietet. Serving-Stacks und Router machen einen guten Teil der 128 KI-Frameworks in unserem Verzeichnis aus – und die Open-Source-KI-Repos, mit denen man anfangen sollte, sind die mit einer OpenAI-kompatiblen Oberfläche, weil das bedeutet, dass Ihr Rollback eine einzige Config-Änderung ist.
Wer 2026 wechseln sollte – und wer nicht
Drei Profile haben die Arithmetik auf ihrer Seite. Drei nicht – und kein Enthusiasmus Ihres Platform-Teams ändert das.
Drei Profile, bei denen Self-Hosting klar gewinnt
Hochvolumige Transkription bei gleichmäßiger Last. Wenn Sie mehr als einige tausend Audio-Stunden pro Monat durch eine geplant laufende Pipeline schicken, können Sie eine Karte auslasten und den AssemblyAI-Mindestpreis von $0,15/Stunde schlagen (AssemblyAI). Batch-Arbeit ist die ideale Form hier, weil Sie kontrollieren, wann die Warteschlange abgearbeitet wird – so wird die Karte zu einem Scheduling-Problem statt zu einer Hoffnung.
Regulierte Daten, die Ihre Grenzen nicht verlassen dürfen, wenn die Anforderung vertraglich ist und keine Präferenz. Kostenoptimierung ist in diesem Fall nicht das Ziel. Sie kaufen eine Audit-Antwort – und die GPU-Rechnung ist ihr Preis.
Fünfzig oder mehr Entwickler mit nutzungsbasierten Coding-Assistenten. Bei rund 50 Entwicklern landet die Rechnung bei ca. $110.000 pro Monat gegenüber einem Node, den Sie ausgelastet halten können – eine 3- bis 9-fache Prämie. Bei ~100 Entwicklern (~$220.000/Monat) amortisiert sich eigene Hardware in etwa einem Jahr (DoiT).
Drei, bei denen es allein an der Arithmetik scheitert
Teams mit weniger als rund 10 Entwicklern. Bei ~$22.000/Monat ist die Assistentenrechnung gleichauf mit einem Node, den diese 10 Personen nicht auslasten können (DoiT) – und gleichauf lohnt keine Rufbereitschaft.
Jeder, dessen Workload stoßweiser Consumer-Traffic ist. Leerlauf-GPUs werden zum vollen Tarif abgerechnet, und eine ungleichmäßige tageszeitliche Kurve bedeutet, dass Sie für den Peak zahlen, während Sie vielleicht 20 % davon im Schnitt nutzen. Serverlose Open-Model-APIs fressen dieses Profil auf.
Teams, deren Qualitätslatte an der Frontier liegt. Wenn Ihre Evals nur mit Fable 5.1 bei $10/$50 pro Million Tokens bestehen (Anthropic), ist ein selbst gehostetes Open Model ein anderes Produkt auf einem anderen Qualitätsniveau – und die Einsparungen erkaufen Ihnen eine Herabstufung.
Der 90-Tage-Test, den Sie vor einer Kapitalverpflichtung durchführen sollten
- Wochen 1–2: Messen Sie Gleichzeitigkeit, nicht Ausgaben. Protokollieren Sie Anfragen in Bearbeitung pro Minute und ermitteln Sie Ihr p95. Wenn es unter 4 liegt, hören Sie hier auf.
- Wochen 3–6: Leiten Sie 10 % des Traffics an DeepInfras Open-Weights-Endpunkte weiter und führen Sie Ihre bestehende Eval-Suite dagegen aus. Das ist ein Base-URL-Wechsel und ein Modell-Alias für die meisten Stacks.
- Wochen 7–12: Mieten, nicht kaufen. Ein H100 bei $2,20/Std. dediziert (DeepInfra) liefert Ihnen eine echte Auslastungszahl für unter $1.700 pro Monat – die Zahl, nach der Ihr CFO fragen wird.
Wenn die Karte am Ende dieser Zeit mehr als 60 % der Zeit leer läuft, ist die Antwort die verwaltete Open-Weights-API – und Sie haben ein Quartal damit verbracht, es zu lernen, statt drei Jahre lang abzuschreiben.
Häufig gestellte Fragen
Ist Self-Hosting von Open-Source-KI wirklich günstiger als ChatGPT Business oder Claude Team Seats?
Zu Listenpreisen: Nein. Claude Team kostet $20 pro Seat pro Monat bei Jahresabrechnung ($25 monatlich), mit Premium Seats bei $100/$125, und Enterprise liegt bei $20 pro Seat jährlich plus Nutzung zu API-Tarifen (Anthropic-Preise). Kein gemieteter GPU kommt in die Nähe von $20 pro Kopf – Flatrate-Abonnements sind das Schwierigste in der KI, mit eigener Hardware zu schlagen. Self-Hosting beginnt erst dann wettbewerbsfähig zu werden, wenn Ihr Team nutzungsbasiert abgerechnet wird, wo DoiTs eigene Ingenieure im Schnitt etwa $2.200 pro Entwickler pro Monat erreichen (DoiT).
Bei welchen monatlichen Ausgaben erreicht Self-Hosting eines LLM 2026 den Break-even?
Grob bei $15.000 bis $25.000 monatlichen nutzungsbasierten API-Ausgaben – was bei DoiTs beobachteten $2.200 pro Entwickler pro Monat ungefähr 7 bis 12 intensive Seats ergibt (DoiT). Die Zahl variiert stärker mit Ihrem Cloud-Anbieter als mit Ihrem Modell: Derselbe 8xH100-Node für einen 730-Stunden-Monat kostet etwa $12.600 bei Nebius Spot, $22.500 bei Nebius On-Demand, $40.200 bei AWS und $71.800 bei Azure (DoiT). Mitarbeiterzahl ist sowieso die falsche Einheit. Zu jedem gegebenen Zeitpunkt hat nur 10 bis 20 % eines Entwicklerteams eine Anfrage in Bearbeitung – zehn Entwickler sind also zwei oder drei parallele Sessions, bestenfalls die halbe Kapazität eines Nodes (DoiT).
Wie viele GPU-Stunden brauche ich, um den Whisper-API-Tarif von $0,36 pro Audio-Stunde zu schlagen?
Durchsatz entscheidet das – Stunden spielen nur durch den Tarif eine Rolle, zu dem sie abgerechnet werden. OpenAI berechnet $0,006/Minute für Whisper und gpt-4o-transcribe, also $0,36 pro Audio-Stunde, und $0,003/Minute ($0,18/Stunde) für gpt-4o-mini-transcribe (OpenAI). Auf einem RunPod L40S 48GB bei $0,79/Std. Community Cloud (RunPod) brauchen Sie besser als etwa 2,2-fache Echtzeit-Durchsatz, um $0,36 zu schlagen, etwa 4,4-fach für den Mini-Tarif und etwa 5,3-fach für AssemblyAIs Universal-2-Tarif von $0,15/Stunde (AssemblyAI). GPU-Leerlaufzeit zählt gegen Sie – das Deployment gewinnt also nur mit einer stetigen Warteschlange statt stoßweisem Tagesverkehr.
Ist Open-Source-KI frei für die kommerzielle Nutzung?
Nein – und bei Image-Modellen werden Teams oft erwischt. FLUX.1 [dev]-Weights sollen unter einer nicht-kommerziellen Lizenz stehen, was eine kostenpflichtige Black Forest Labs-Lizenz zwischen Sie und eine kommerzielle Bereitstellung stellen würde – lesen Sie die Bedingungen, bevor Sie darauf planen. Selbst bei vollständig freizügigen Weights ist die Rechenleistung nicht kostenlos: DeepInfra liefert Llama-3.3-70B-Instruct-Turbo für $0,10 Input und $0,32 Output pro Million Tokens sowie Meta-Llama-3.1-8B für $0,02/$0,04 (DeepInfra) – günstiger als die meisten Teams dieselben Weights selbst auf einem dedizierten H100 für $2,20/Std. betreiben können.
Muss ich selbst hosten, um DSGVO- und EU-KI-Gesetz-konform zu sein?
Nein. Compliance betrifft Datenspeicherort, Verarbeitungsvereinbarungen und Dokumentation – keines davon erfordert, dass Sie den Inferenz-Stack besitzen. Die Einsätze sind real (Regulatoren haben bis Anfang 2026 €7,1 Milliarden in 2.245 DSGVO-Bußgeldern verhängt, und die Haftung reicht bis zu 4 % des weltweiten Umsatzes unter der DSGVO sowie bis zu 7 % unter dem KI-Gesetz, laut Kiteworks), aber EU-Regionen für Managed und Sovereign Hosting decken inzwischen das meiste ab, was ein Datenschutzbeauftragter verlangt. Hosten Sie selbst, wenn ein Vertrag oder eine Behörde ausdrücklich die Drittverarbeitung untersagt – nicht als allgemeine Absicherung.
Sollte ich GPUs kaufen oder mieten während des Speichermangels 2026?
Mieten – es sei denn, Sie haben eine mehrjährige Workload, die die Karten ausgelastet hält. NVIDIAs RTX PRO 6000 Blackwell 96GB stieg von einer Händlerlistung bei $8.565 Anfang 2025 auf $13.250 im Juni 2026 und $16.000 im August 2026 – rund 87 % mehr für ein unverändertes Produkt (igor'sLAB). Der Grund ist der Speicher: HBM beansprucht nun schätzungsweise 23 % der weltweiten DRAM-Wafer-Kapazität gegenüber 8 % im Jahr 2024, und Server-DDR5-ECC-RDIMM-Preise stiegen zwischen Q1 2025 und Q1 2026 um rund 100 bis 116 % (DataCenterDisk). Goldman Sachs prognostizierte ein DRAM-Defizit von 4,9 % für 2026 – das größte seit 15 Jahren – mit Entspannung wohl erst Ende 2027 (Wccftech). Planen Sie mit erhöhten Kaufpreisen und nutzen Sie die Spanne des Mietmarkts – von $2,20/Std. für einen dedizierten H100 bei DeepInfra bis zu $4,29/Std. bei Lambda.