描述
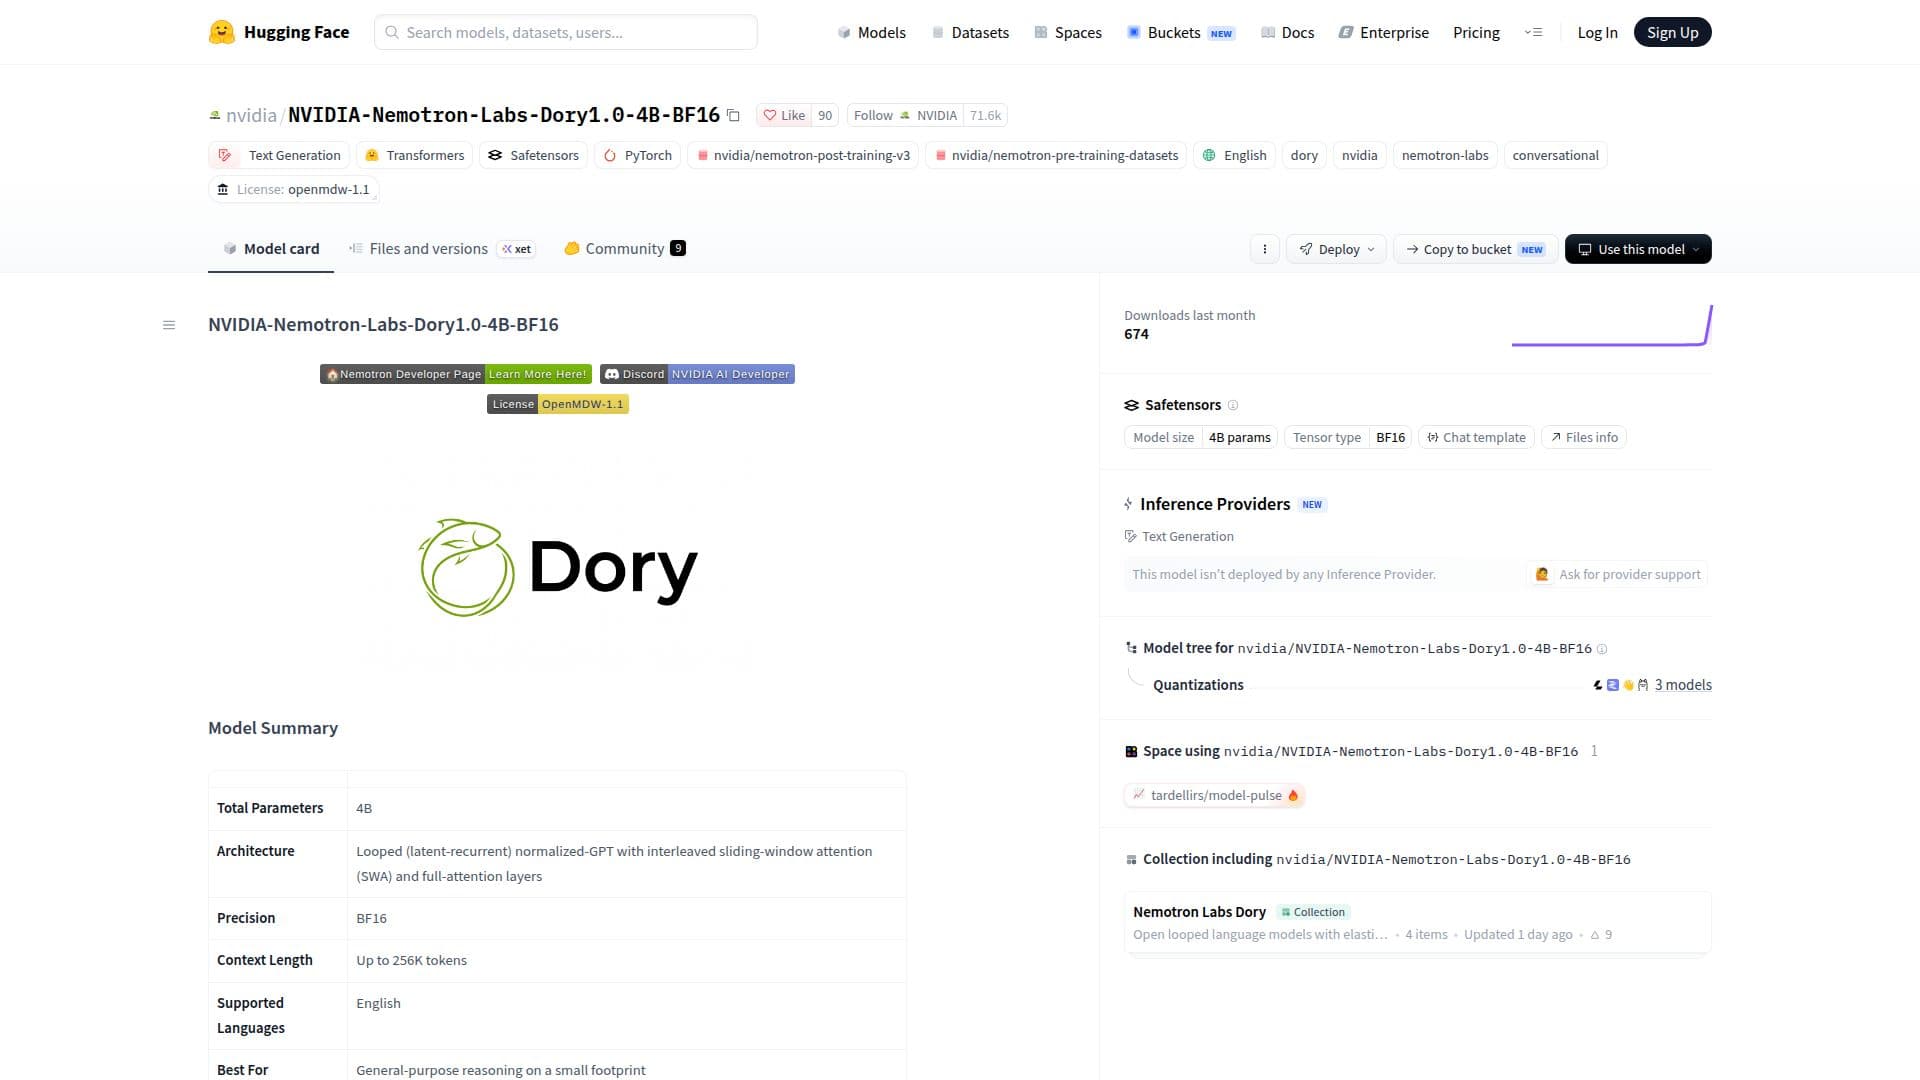
NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16 是由 NVIDIA 开发的大型语言模型,采用循环(潜在递归)标准化 GPT 架构。该模型旨在处理通用推理任务,同时保持较小的计算占用。它具有交错的滑动窗口注意力(SWA)和全注意力层,能够高效处理上下文长度高达 256K 的令牌。
阅读更多
该模型由 40 亿个参数构成,并采用 BF16 精度,适用于商业和非商业应用。它支持英语语言处理,最适合需要通用推理能力的任务。模型的架构允许弹性推理计算,使用户能够调整循环次数,以在计算效率和准确性之间取得平衡,而无需重新训练。
Dory1.0-4B-BF16 在继续使用 BF16 之前,采用 NVIDIA 的 NVFP4 格式进行预训练,确保在 NVIDIA GPU 加速系统上具有高性能。它提供多种格式,包括 BF16、MXFP8、NVFP4 和 Q5_K_M,提供在不同硬件配置中部署的灵活性。
该模型的训练涉及 6 万亿个令牌,重点关注数学、科学和一般知识等多样化领域。它经过监督微调和强化学习,以增强其在多步骤工具使用、指令跟随和结构化输出环境中的性能。模型的基准测试显示其在编码、推理和指令跟随等各种任务中的竞争力表现。
NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16 受 OpenMDW 许可证协议第 1.1 版的约束,并于 2026 年 10 月 16 日发布。它设计为在 NVIDIA 的 Hopper 和 Blackwell 架构上最佳运行,并支持 Linux 操作系统。
- 类别AI 模型与大语言模型
- 定价模式开源
- 部署云端
- 平台Linux
NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16亮点
循环潜在递归架构
交错滑动窗口注意力
256K 令牌上下文长度
BF16 精度
弹性推理计算
原生 NVFP4 预训练
内存高效循环
OpenMDW 许可证协议
NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16入门
访问模型页面:访问 NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16 的 Hugging Face 模型页面。
身份验证:确保您拥有访问模型所需的凭据。
配置:设置模型参数,包括循环次数和 KV 缓存设置。
发送提示:输入文本序列以供模型处理。
微调:根据需要调整模型设置以适应特定任务。
NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16的使用案例
- 通用推理
- 编码任务
- 指令跟随
- 长上下文处理
- 科学研究