跳转到主要内容
ToolPotion
AI 顾问
提交(免费)

DeepSeek-V4-Pro

精选

DeepSeek-V4-Pro是一个先进的AI模型,旨在实现高效的百万标记上下文智能。它具有混合注意力架构,并在超过32万亿个标记上进行了预训练,适用于复杂推理任务和编码基准。

访问URL
分享
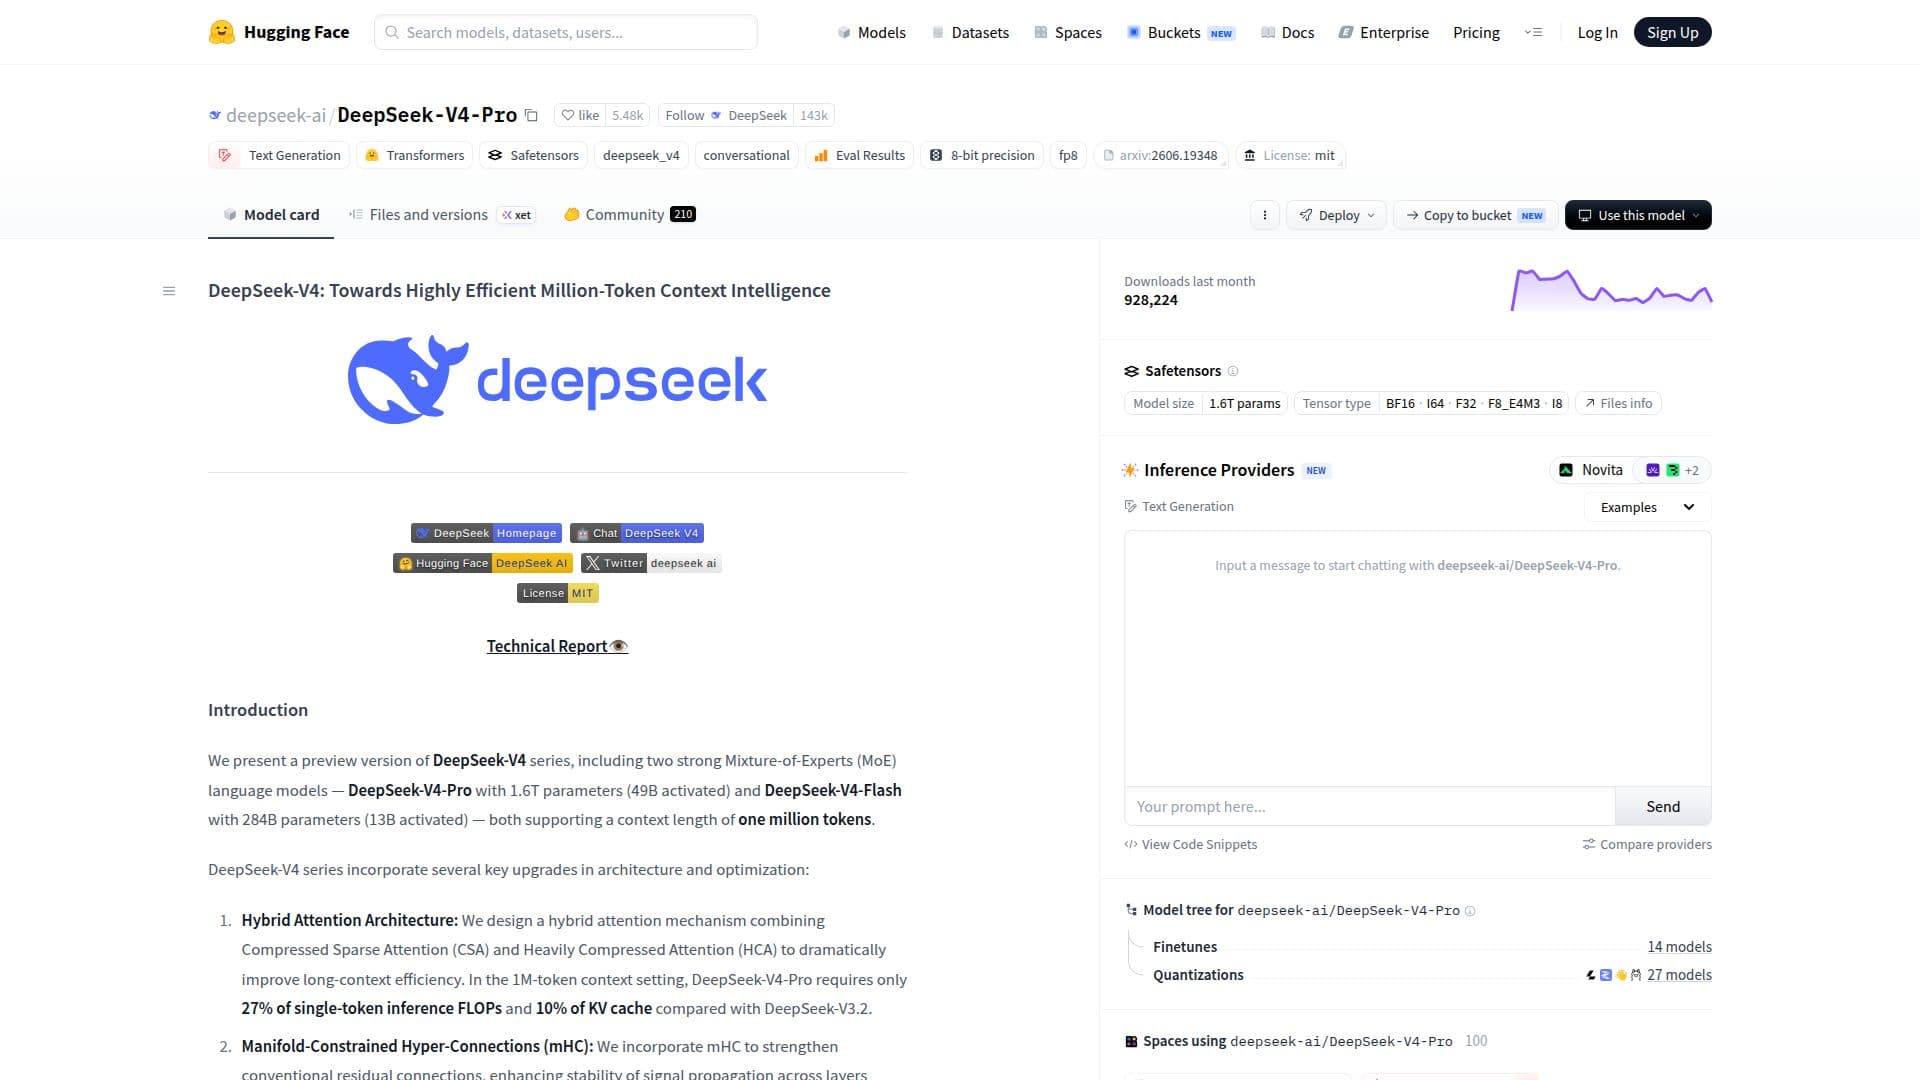
DeepSeek-V4-Pro 截图
DeepSeek-V4-Pro 截图

DeepSeek-V4-Pro是DeepSeek-V4系列的一部分,旨在通过开源和开放科学推动和普及人工智能。该模型结合了两个强大的专家混合(MoE)语言模型,DeepSeek-V4-Pro拥有1.6万亿个参数,并支持一百万个标记的上下文长度。

阅读更多

DeepSeek-V4-Pro的架构包括几个关键升级,例如结合压缩稀疏注意力(CSA)和重压缩注意力(HCA)的混合注意力机制。该设计显著提高了长上下文的效率,与其前身DeepSeek-V3.2相比,仅需27%的单标记推理FLOPs和10%的KV缓存。此外,该模型采用流形约束超连接(mHC)来增强信号在层间传播的稳定性,同时保持模型的表现力。

为了确保更快的收敛和更大的训练稳定性,采用了Muon优化器。该模型在超过32万亿个多样化标记的数据集上进行了预训练,随后进行了全面的后训练流程,包括独立培养领域特定专家和通过在线蒸馏进行统一模型整合。

DeepSeek-V4-Pro-Max是DeepSeek-V4-Pro的最大推理努力模式,显著增强了开源模型的知识能力。它在编码基准中实现了顶级性能,并有效弥补了与领先的闭源模型在推理和自主任务上的差距。该模型的能力使其适用于广泛的应用,包括复杂问题解决和规划任务,是AI领域开发者和研究人员的宝贵工具。

  • 类别AI 模型与大语言模型
  • 定价模式开源
  • 部署云端
  • 平台网页版

  • 模型类型:专家混合

  • 总参数:1.6T

  • 激活参数:49B

  • 上下文长度:1M标记

  • 混合注意力架构:是

  • Muon优化器:是

  • 预训练于:32T标记

  • 许可证:MIT

  1. 访问模型:访问DeepSeek-V4-Pro的Hugging Face页面。

  2. 身份验证:如有必要,创建一个账户。

  3. 设置环境:确保您拥有所需的库和依赖项。

  4. 通过API集成:使用提供的API文档连接到模型。

  5. 优化:调整采样参数以获得最佳性能。

  • 复杂问题解决
  • 编码基准
  • 研究应用
  • 自然语言处理
  • 自主任务

DeepSeek 旗下产品

DeepSeek 中的模型。

DeepSeek-V4-Pro 评价

加载中...

与 DeepSeek-V4-Pro 类似的热门AI工具

DeepSeek-V3

大语言模型

DeepSeek-V3 是一个具有 6710 亿参数的专家混合语言模型,旨在实现高效推理和经济实惠的训练。它在各种基准测试中表现出色,展示了在自然语言处理任务中的强大性能。

AI 模型与大语言模型

大语言模型 排名第 31 位

查看工具

大语言模型

具有 6710 亿参数的专家混合语言模型,旨在实现高效推理和经济实惠的训练。它在各种基准测试中表现出色,展示了在自然语言处理任务中的强大性能。DeepSeek-V3 是一个具有 6710 亿参数的专家混合语言模型,旨在实现高效推理和经济实惠的训练。它在各种基准测试中表现出色,展示了在自然语言处理任务中的强大性能。

精选AI 模型与大语言模型
大语言模型 排名第 31 位

MiMo-V2.5-Pro

AI 模型

MiMo-V2.5-Pro 是一个先进的开源混合专家语言模型,旨在处理复杂任务。它具有混合注意力架构,支持最长 100 万个标记的上下文长度,非常适合要求高的软件工程和长时间跨度的任务。

AI 模型与大语言模型
查看工具

AI 模型

先进的开源混合专家语言模型,旨在处理复杂任务。它具有混合注意力架构,支持最长 100 万个标记的上下文长度,非常适合要求高的软件工程和长时间跨度的任务。MiMo-V2.5-Pro 是一个先进的开源混合专家语言模型,旨在处理复杂任务。它具有混合注意力架构,支持最长 100 万个标记的上下文长度,非常适合要求高的软件工程和长时间跨度的任务。

AI 模型与大语言模型
查看 AI 模型 Top 5

DeepSeek-V3

AI GitHub 仓库

DeepSeek-V3 是 DeepSeek 发布的开放权重混合专家语言模型,拥有 6710 亿个参数,总共每个令牌激活 370 亿个参数。该模型在 14.8 万亿个令牌上进行预训练,具有 128K 的上下文长度,代码和权重已在 GitHub 和 Hugging Face 上发布,供自托管或通过 DeepSeek 的聊天网站使用。

AI 模型与大语言模型
查看工具

AI GitHub 仓库

DeepSeek 发布的开放权重混合专家语言模型,拥有 6710 亿个参数,总共每个令牌激活 370 亿个参数。该模型在 14.8 万亿个令牌上进行预训练,具有 128K 的上下文长度,代码和权重已在 GitHub 和 Hugging Face 上发布,供自托管或通过 DeepSeek 的聊天网站使用。DeepSeek-V3 是 DeepSeek 发布的开放权重混合专家语言模型,拥有 6710 亿个参数,总共每个令牌激活 370 亿个参数。该模型在 14.8 万亿个令牌上进行预训练,具有 128K 的上下文长度,代码和权重已在 GitHub 和 Hugging Face 上发布,供自托管或通过 DeepSeek 的聊天网站使用。

AI 模型与大语言模型
查看 AI GitHub 仓库 Top 250

Kimi-K2-Instruct 是一款先进的混合专家语言模型,专为高级人工智能任务而设计。它在推理、编码和工具使用方面表现出色,提供了32亿激活参数的强大性能。

AI 模型与大语言模型

大语言模型 排名第 44 位

查看工具

先进的混合专家语言模型,专为高级人工智能任务而设计。它在推理、编码和工具使用方面表现出色,提供了32亿激活参数的强大性能。Kimi-K2-Instruct 是一款先进的混合专家语言模型,专为高级人工智能任务而设计。它在推理、编码和工具使用方面表现出色,提供了32亿激活参数的强大性能。

AI 模型与大语言模型
大语言模型 排名第 44 位

DeepSeek-v3 提供即时 AI 解决方案,由先进的 MoE 架构和最先进的语言模型驱动。通过这款稳定、免费且无限制的模型体验尖端 AI 功能,该模型专为各种硬件部署的高效推理和多语言支持而设计。

AI 模型与大语言模型
查看工具

提供即时 AI 解决方案,由先进的 MoE 架构和最先进的语言模型驱动。通过这款稳定、免费且无限制的模型体验尖端 AI 功能,该模型专为各种硬件部署的高效推理和多语言支持而设计。DeepSeek-v3 提供即时 AI 解决方案,由先进的 MoE 架构和最先进的语言模型驱动。通过这款稳定、免费且无限制的模型体验尖端 AI 功能,该模型专为各种硬件部署的高效推理和多语言支持而设计。

AI 模型与大语言模型
查看 AI 应用 Top 250

DeepSeek

大语言模型

DeepSeek是一家专注于开发通用人工智能的AI研究公司。它提供开源前沿大型语言模型(LLM),如DeepSeek-V4、DeepSeek-R1和DeepSeek-Coder,使用户能够与AI聊天或通过API集成以实现各种应用。

AI 模型与大语言模型

大语言模型 排名第 2 位

查看工具

大语言模型

专注于开发通用人工智能的AI研究公司。它提供开源前沿大型语言模型(LLM),如DeepSeek-V4、DeepSeek-R1和DeepSeek-Coder,使用户能够与AI聊天或通过API集成以实现各种应用。DeepSeek是一家专注于开发通用人工智能的AI研究公司。它提供开源前沿大型语言模型(LLM),如DeepSeek-V4、DeepSeek-R1和DeepSeek-Coder,使用户能够与AI聊天或通过API集成以实现各种应用。

精选AI 模型与大语言模型
大语言模型 排名第 2 位

SmolLM3语言模型

大语言模型

SmolLM3是一个拥有30亿参数的语言模型,旨在推动小型模型的边界。它支持双模式推理、六种语言和长上下文处理,在30亿到40亿规模上提供强大的性能。

AI 模型与大语言模型

大语言模型 排名第 45 位

查看工具

大语言模型

拥有30亿参数的语言模型,旨在推动小型模型的边界。它支持双模式推理、六种语言和长上下文处理,在30亿到40亿规模上提供强大的性能。SmolLM3是一个拥有30亿参数的语言模型,旨在推动小型模型的边界。它支持双模式推理、六种语言和长上下文处理,在30亿到40亿规模上提供强大的性能。

AI 模型与大语言模型
大语言模型 排名第 45 位

DeepSeek-V3.2是一个先进的AI模型,旨在高效推理和代理任务。它具有DeepSeek稀疏注意力、可扩展的强化学习和大规模代理任务合成管道。

AI 模型与大语言模型
查看工具

先进的AI模型,旨在高效推理和代理任务。它具有DeepSeek稀疏注意力、可扩展的强化学习和大规模代理任务合成管道。DeepSeek-V3.2是一个先进的AI模型,旨在高效推理和代理任务。它具有DeepSeek稀疏注意力、可扩展的强化学习和大规模代理任务合成管道。

AI 模型与大语言模型
查看 AI 模型 Top 5
1/8