跳转到主要内容
ToolPotion
AI 顾问
提交(免费)

DeepSeek-V3

精选

DeepSeek-V3 是一个具有 6710 亿参数的专家混合语言模型,旨在实现高效推理和经济实惠的训练。它在各种基准测试中表现出色,展示了在自然语言处理任务中的强大性能。

访问URL
分享
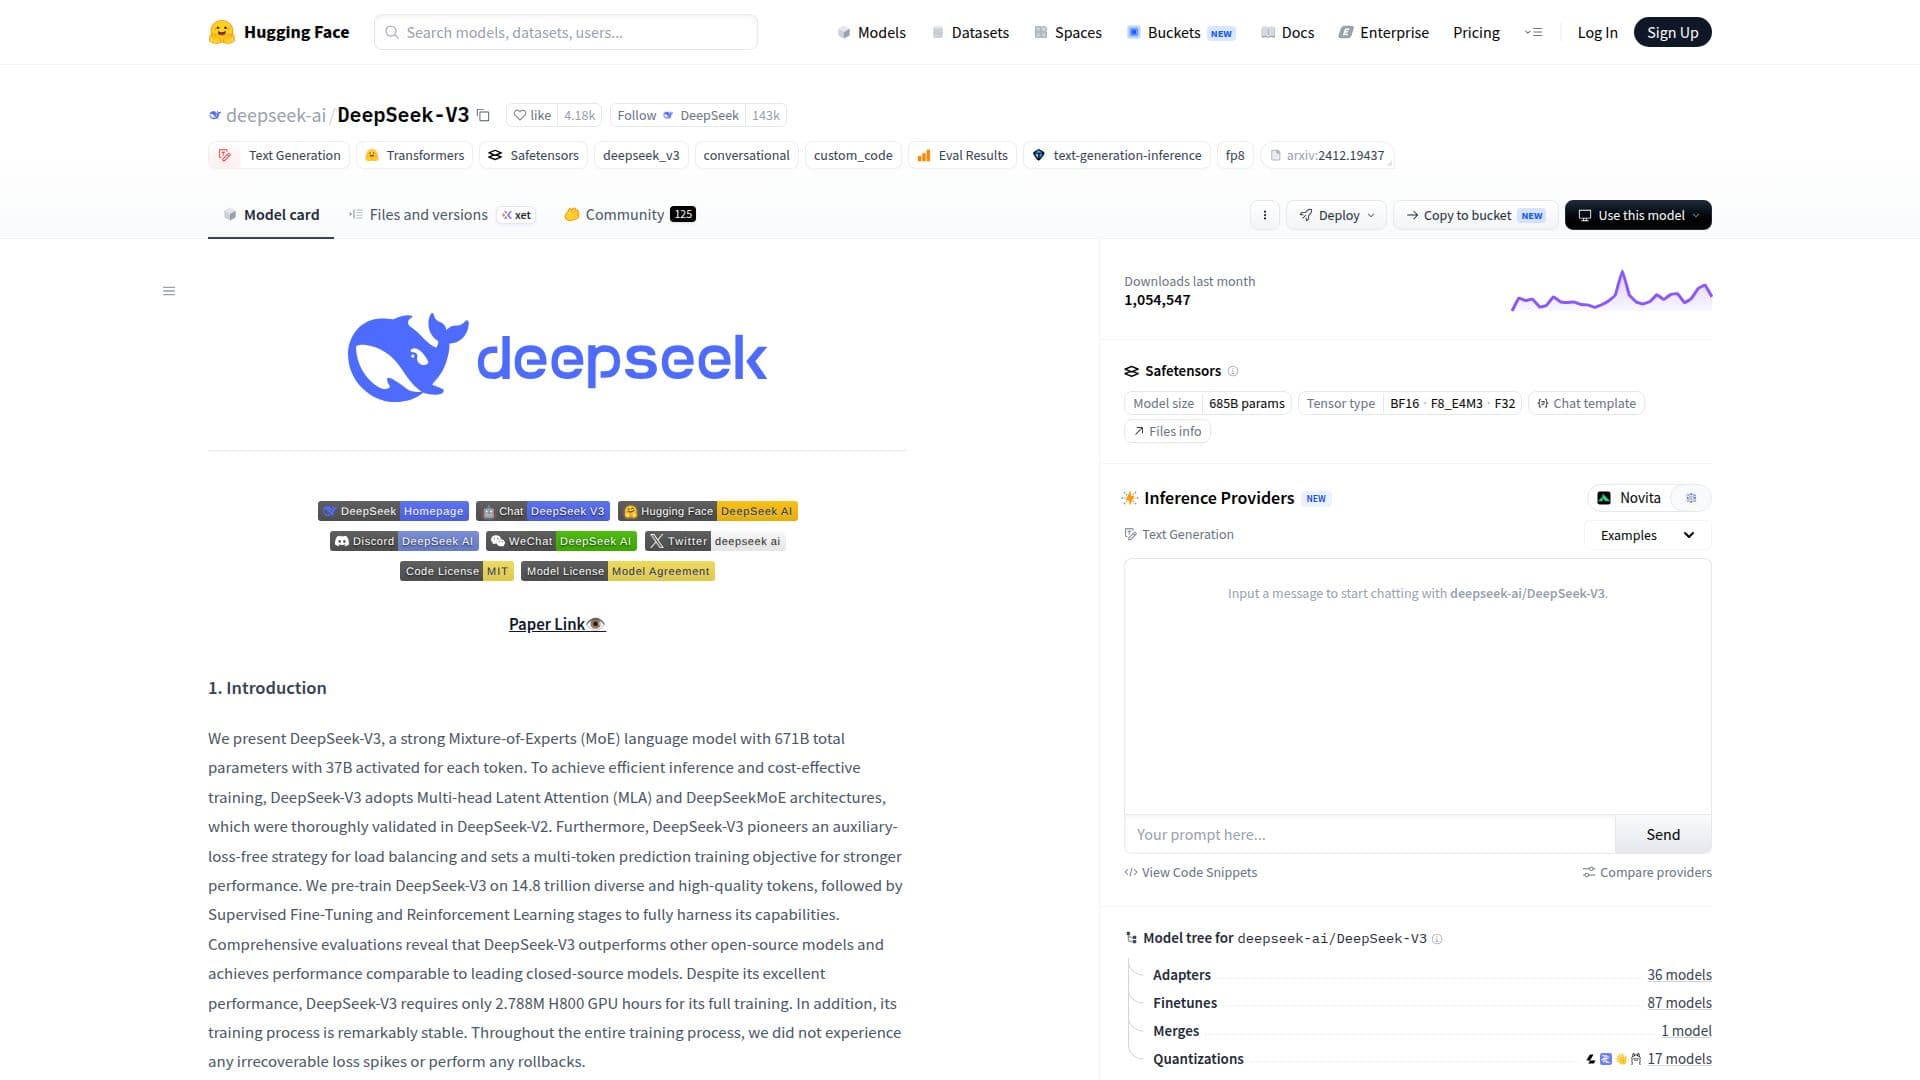
DeepSeek-V3 截图
DeepSeek-V3 截图

DeepSeek-V3 是一个强大的专家混合 (MoE) 语言模型,旨在通过开源方法推动和普及人工智能。它总共有 6710 亿参数,其中每个令牌激活 370 亿参数,DeepSeek-V3 被设计为实现高效推理和经济实惠的训练。该模型采用了创新的架构,如多头潜在注意力 (MLA) 和 DeepSeekMoE,这些架构在其前身 DeepSeek-V2 中得到了验证。

阅读更多

DeepSeek-V3 的一个关键进展是其无辅助损失的负载平衡策略,该策略在鼓励负载平衡的同时最小化性能下降。此外,它引入了一种多令牌预测训练目标,增强了整体性能。该模型在令人印象深刻的 14.8 万亿多样化和高质量的令牌上进行了预训练,随后进行了监督微调和强化学习阶段,以充分发挥其能力。

全面评估表明,DeepSeek-V3 超越了其他开源模型,并达到了与领先的闭源模型相当的性能水平。值得注意的是,它仅需 278.8 万 H800 GPU 小时即可完成全面训练,训练过程极为稳定,避免了不可恢复的损失峰值或回滚。

DeepSeek-V3 适用于多种应用,包括自然语言理解、生成和推理任务。它支持多种本地运行模型的方式,为开发者和研究人员提供灵活性。该模型可在 Hugging Face 上下载,并提供详细的本地部署指南。凭借在众多基准测试中的强大表现,DeepSeek-V3 在人工智能领域中脱颖而出,成为领先的开源模型。

  • 类别AI 模型与大语言模型
  • 定价模式开源
  • 部署云端, 自托管
  • 平台网页版

  • 总参数:6710 亿

  • 激活参数:370 亿

  • 上下文长度:128K

  • 训练时间:278.8 万 H800 GPU 小时

  • 开源:是

  • 多令牌预测:是

  • 负载平衡策略:无辅助损失

  • 微调支持:是

  1. 访问页面:访问 Hugging Face 上的 DeepSeek-V3 页面。

  2. 加载模型:从 Hugging Face 下载模型权重。

  3. 配置环境:设置推理所需的软件和硬件。

  4. 集成:使用提供的框架,如 SGLang 或 LMDeploy 进行集成。

  5. 微调:可选择在您的特定数据集上微调模型。

  • 自然语言理解
  • 文本生成
  • 推理任务
  • 聊天机器人开发
  • 内容创作

DeepSeek 旗下产品

DeepSeek-V3 评价

加载中...

与 DeepSeek-V3 类似的热门AI工具

DeepSeek-V4-Pro

大语言模型

DeepSeek-V4-Pro是一个先进的AI模型,旨在实现高效的百万标记上下文智能。它具有混合注意力架构,并在超过32万亿个标记上进行了预训练,适用于复杂推理任务和编码基准。

AI 模型与大语言模型
查看工具

大语言模型

先进的AI模型,旨在实现高效的百万标记上下文智能。它具有混合注意力架构,并在超过32万亿个标记上进行了预训练,适用于复杂推理任务和编码基准。DeepSeek-V4-Pro是一个先进的AI模型,旨在实现高效的百万标记上下文智能。它具有混合注意力架构,并在超过32万亿个标记上进行了预训练,适用于复杂推理任务和编码基准。

精选AI 模型与大语言模型
查看 大语言模型 Top 50

DeepSeek-V3

AI GitHub 仓库

DeepSeek-V3 是 DeepSeek 发布的开放权重混合专家语言模型,拥有 6710 亿个参数,总共每个令牌激活 370 亿个参数。该模型在 14.8 万亿个令牌上进行预训练,具有 128K 的上下文长度,代码和权重已在 GitHub 和 Hugging Face 上发布,供自托管或通过 DeepSeek 的聊天网站使用。

AI 模型与大语言模型
查看工具

AI GitHub 仓库

DeepSeek 发布的开放权重混合专家语言模型,拥有 6710 亿个参数,总共每个令牌激活 370 亿个参数。该模型在 14.8 万亿个令牌上进行预训练,具有 128K 的上下文长度,代码和权重已在 GitHub 和 Hugging Face 上发布,供自托管或通过 DeepSeek 的聊天网站使用。DeepSeek-V3 是 DeepSeek 发布的开放权重混合专家语言模型,拥有 6710 亿个参数,总共每个令牌激活 370 亿个参数。该模型在 14.8 万亿个令牌上进行预训练,具有 128K 的上下文长度,代码和权重已在 GitHub 和 Hugging Face 上发布,供自托管或通过 DeepSeek 的聊天网站使用。

AI 模型与大语言模型
查看 AI GitHub 仓库 Top 250

DeepSeek-v3 提供即时 AI 解决方案,由先进的 MoE 架构和最先进的语言模型驱动。通过这款稳定、免费且无限制的模型体验尖端 AI 功能,该模型专为各种硬件部署的高效推理和多语言支持而设计。

AI 模型与大语言模型
查看工具

提供即时 AI 解决方案,由先进的 MoE 架构和最先进的语言模型驱动。通过这款稳定、免费且无限制的模型体验尖端 AI 功能,该模型专为各种硬件部署的高效推理和多语言支持而设计。DeepSeek-v3 提供即时 AI 解决方案,由先进的 MoE 架构和最先进的语言模型驱动。通过这款稳定、免费且无限制的模型体验尖端 AI 功能,该模型专为各种硬件部署的高效推理和多语言支持而设计。

AI 模型与大语言模型
查看 AI 应用 Top 250

MiMo-V2.5-Pro

AI 模型

MiMo-V2.5-Pro 是一个先进的开源混合专家语言模型,旨在处理复杂任务。它具有混合注意力架构,支持最长 100 万个标记的上下文长度,非常适合要求高的软件工程和长时间跨度的任务。

AI 模型与大语言模型
查看工具

AI 模型

先进的开源混合专家语言模型,旨在处理复杂任务。它具有混合注意力架构,支持最长 100 万个标记的上下文长度,非常适合要求高的软件工程和长时间跨度的任务。MiMo-V2.5-Pro 是一个先进的开源混合专家语言模型,旨在处理复杂任务。它具有混合注意力架构,支持最长 100 万个标记的上下文长度,非常适合要求高的软件工程和长时间跨度的任务。

AI 模型与大语言模型
查看 AI 模型 Top 5

Kimi-K2-Instruct 是一款先进的混合专家语言模型,专为高级人工智能任务而设计。它在推理、编码和工具使用方面表现出色,提供了32亿激活参数的强大性能。

AI 模型与大语言模型

大语言模型 排名第 44 位

查看工具

先进的混合专家语言模型,专为高级人工智能任务而设计。它在推理、编码和工具使用方面表现出色,提供了32亿激活参数的强大性能。Kimi-K2-Instruct 是一款先进的混合专家语言模型,专为高级人工智能任务而设计。它在推理、编码和工具使用方面表现出色,提供了32亿激活参数的强大性能。

AI 模型与大语言模型
大语言模型 排名第 44 位

DeepSeek

大语言模型

DeepSeek是一家专注于开发通用人工智能的AI研究公司。它提供开源前沿大型语言模型(LLM),如DeepSeek-V4、DeepSeek-R1和DeepSeek-Coder,使用户能够与AI聊天或通过API集成以实现各种应用。

AI 模型与大语言模型

大语言模型 排名第 2 位

查看工具

大语言模型

专注于开发通用人工智能的AI研究公司。它提供开源前沿大型语言模型(LLM),如DeepSeek-V4、DeepSeek-R1和DeepSeek-Coder,使用户能够与AI聊天或通过API集成以实现各种应用。DeepSeek是一家专注于开发通用人工智能的AI研究公司。它提供开源前沿大型语言模型(LLM),如DeepSeek-V4、DeepSeek-R1和DeepSeek-Coder,使用户能够与AI聊天或通过API集成以实现各种应用。

精选AI 模型与大语言模型
大语言模型 排名第 2 位

Mixtral-8x7B-Instruct-v0.1 是一个预训练的生成稀疏专家混合模型,旨在用于高级人工智能应用。它在各种基准测试中优于 Llama 2 70B,为自然语言处理中的微调和推理任务提供了强大的解决方案。

AI 模型与大语言模型
查看工具

预训练的生成稀疏专家混合模型,旨在用于高级人工智能应用。它在各种基准测试中优于 Llama 2 70B,为自然语言处理中的微调和推理任务提供了强大的解决方案。Mixtral-8x7B-Instruct-v0.1 是一个预训练的生成稀疏专家混合模型,旨在用于高级人工智能应用。它在各种基准测试中优于 Llama 2 70B,为自然语言处理中的微调和推理任务提供了强大的解决方案。

精选AI 模型与大语言模型
查看 AI 模型 Top 5

SmolLM3语言模型

大语言模型

SmolLM3是一个拥有30亿参数的语言模型,旨在推动小型模型的边界。它支持双模式推理、六种语言和长上下文处理,在30亿到40亿规模上提供强大的性能。

AI 模型与大语言模型

大语言模型 排名第 45 位

查看工具

大语言模型

拥有30亿参数的语言模型,旨在推动小型模型的边界。它支持双模式推理、六种语言和长上下文处理,在30亿到40亿规模上提供强大的性能。SmolLM3是一个拥有30亿参数的语言模型,旨在推动小型模型的边界。它支持双模式推理、六种语言和长上下文处理,在30亿到40亿规模上提供强大的性能。

AI 模型与大语言模型
大语言模型 排名第 45 位
1/8