跳转到主要内容
ToolPotion
AI 顾问
提交(免费)

DeepSeek-V4-Pro-DSpark

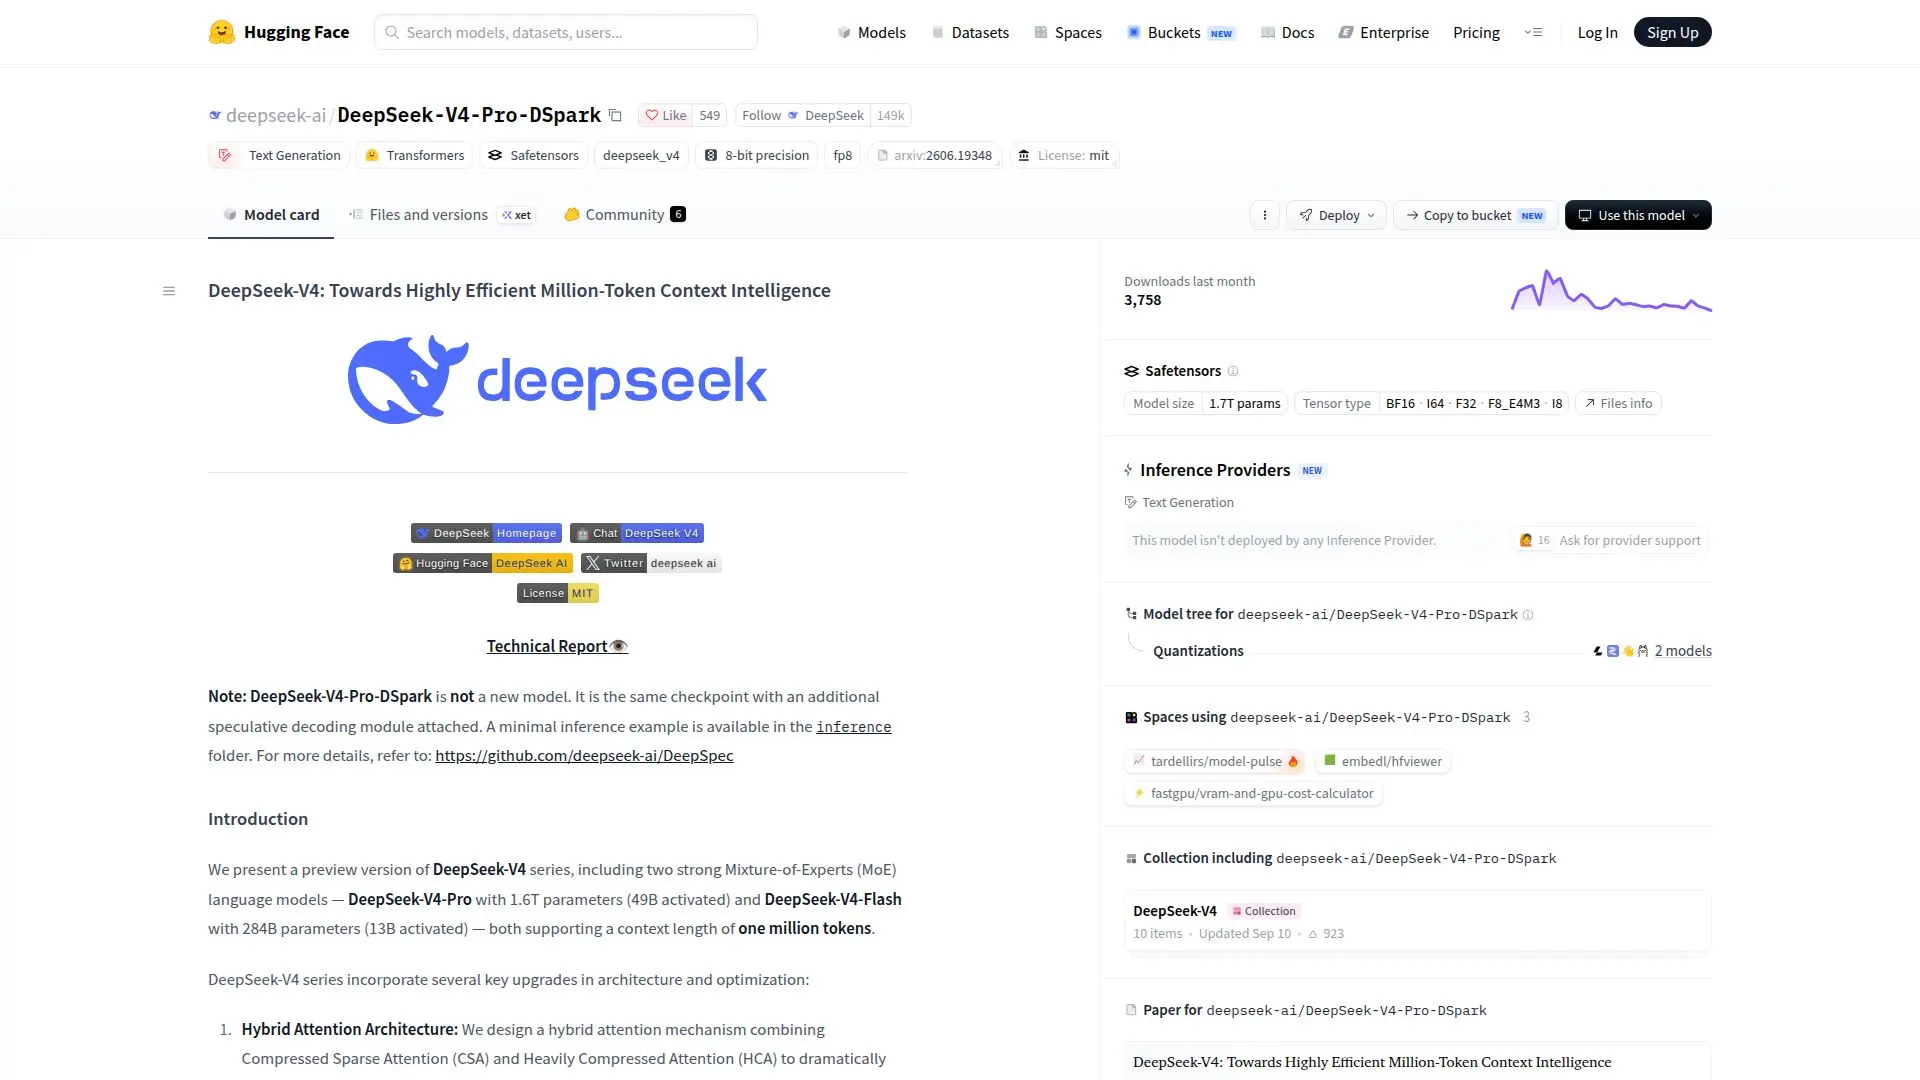
DeepSeek-V4-Pro-DSpark 是一款先进的语言模型,具有混合注意力架构和多样约束超连接。它支持一百万个标记的上下文长度,并针对高效的长上下文处理进行了优化。

访问URL
分享
DeepSeek-V4-Pro-DSpark 截图

DeepSeek-V4-Pro-DSpark 是 DeepSeek-V4 系列的一部分,该系列包括高效的专家混合(MoE)语言模型。该模型旨在处理长达一百万个标记的广泛上下文长度,使其适用于复杂的语言任务。混合注意力架构结合了压缩稀疏注意力(CSA)和重压缩注意力(HCA),以提高长上下文的效率。此外,该模型还结合了多样约束超连接(mHC),以改善跨层信号传播的稳定性。

阅读更多

DeepSeek-V4-Pro-DSpark 模型在超过 32 万亿个多样且高质量的标记上进行了预训练,随后经过全面的后训练流程。该流程包括通过监督微调(SFT)和带指导策略优化(GRPO)的强化学习独立培养领域特定专家,最后通过在线蒸馏进行统一模型整合。

DeepSeek-V4-Pro-DSpark 在各种基准测试中表现出色,在编码和推理任务中取得了顶级性能。它在推理和代理任务上显著缩小了与领先的闭源模型之间的差距。该模型支持三种推理努力模式:非思考、高思考和最大思考,满足从常规任务到复杂问题解决的不同用例。

该模型可在 Hugging Face 和 ModelScope 等平台上下载,并根据 MIT 许可证进行授权。用户可以根据推理文件夹中提供的详细说明在本地运行该模型,其中包括模型权重转换和交互式聊天演示。

  • 类别AI 模型与大语言模型
  • 定价模式免费
  • 部署云端, 自托管
  • 平台网页版

  • 混合注意力架构

  • 多样约束超连接

  • Muon 优化器

  • 百万标记上下文长度

  • 专家混合模型

  • 开源

  • 三种推理努力模式

  • 全面的后训练流程

  1. 访问模型页面:访问 Hugging Face 模型页面

  2. 身份验证:登录您的 Hugging Face 账户

  3. 配置:设置模型及所需参数

  4. 发送提示:输入您的文本提示进行处理

  5. 微调:调整模型设置以适应特定任务

  • 长上下文处理
  • 复杂问题解决
  • 常规任务
  • 编码基准测试
  • 推理任务

DeepSeek-V4-Pro-DSpark 评价

加载中...

与 DeepSeek-V4-Pro-DSpark 类似的热门AI工具

DeepSeek-V4-Pro

大语言模型

DeepSeek-V4-Pro是一个先进的AI模型,旨在实现高效的百万标记上下文智能。它具有混合注意力架构,并在超过32万亿个标记上进行了预训练,适用于复杂推理任务和编码基准。

AI 模型与大语言模型
查看工具

大语言模型

先进的AI模型,旨在实现高效的百万标记上下文智能。它具有混合注意力架构,并在超过32万亿个标记上进行了预训练,适用于复杂推理任务和编码基准。DeepSeek-V4-Pro是一个先进的AI模型,旨在实现高效的百万标记上下文智能。它具有混合注意力架构,并在超过32万亿个标记上进行了预训练,适用于复杂推理任务和编码基准。

精选AI 模型与大语言模型
查看 大语言模型 Top 50

DeepSeek-V3

大语言模型

DeepSeek-V3 是一个具有 6710 亿参数的专家混合语言模型,旨在实现高效推理和经济实惠的训练。它在各种基准测试中表现出色,展示了在自然语言处理任务中的强大性能。

AI 模型与大语言模型

大语言模型 排名第 31 位

查看工具

大语言模型

具有 6710 亿参数的专家混合语言模型,旨在实现高效推理和经济实惠的训练。它在各种基准测试中表现出色,展示了在自然语言处理任务中的强大性能。DeepSeek-V3 是一个具有 6710 亿参数的专家混合语言模型,旨在实现高效推理和经济实惠的训练。它在各种基准测试中表现出色,展示了在自然语言处理任务中的强大性能。

精选AI 模型与大语言模型
大语言模型 排名第 31 位

MiMo-V2.5-Pro

AI 模型

MiMo-V2.5-Pro 是一个先进的开源混合专家语言模型,旨在处理复杂任务。它具有混合注意力架构,支持最长 100 万个标记的上下文长度,非常适合要求高的软件工程和长时间跨度的任务。

AI 模型与大语言模型
查看工具

AI 模型

先进的开源混合专家语言模型,旨在处理复杂任务。它具有混合注意力架构,支持最长 100 万个标记的上下文长度,非常适合要求高的软件工程和长时间跨度的任务。MiMo-V2.5-Pro 是一个先进的开源混合专家语言模型,旨在处理复杂任务。它具有混合注意力架构,支持最长 100 万个标记的上下文长度,非常适合要求高的软件工程和长时间跨度的任务。

AI 模型与大语言模型
查看 AI 模型 Top 5

Hy4 预览

大语言模型

Hy4 预览是腾讯 Hy 团队开发的新一代专家混合模型。它具有7700亿个参数,旨在提高软件工程、游戏开发和科学研究等多个领域的生产力。

AI 模型与大语言模型

大语言模型 排名第 35 位

查看工具

大语言模型

腾讯 Hy 团队开发的新一代专家混合模型。它具有7700亿个参数,旨在提高软件工程、游戏开发和科学研究等多个领域的生产力。Hy4 预览是腾讯 Hy 团队开发的新一代专家混合模型。它具有7700亿个参数,旨在提高软件工程、游戏开发和科学研究等多个领域的生产力。

AI 模型与大语言模型
大语言模型 排名第 35 位

Solar Open 2

大语言模型

Solar Open 2 是 Upstage 开发的大型语言模型,专为办公生产力和编码等代理性用例设计。它采用混合注意力专家混合架构,提供高效推理和多语言支持。

AI 模型与大语言模型

大语言模型 排名第 18 位

查看工具

大语言模型

Upstage 开发的大型语言模型,专为办公生产力和编码等代理性用例设计。它采用混合注意力专家混合架构,提供高效推理和多语言支持。Solar Open 2 是 Upstage 开发的大型语言模型,专为办公生产力和编码等代理性用例设计。它采用混合注意力专家混合架构,提供高效推理和多语言支持。

AI 模型与大语言模型
大语言模型 排名第 18 位

Laguna M.1

大语言模型

Laguna M.1 是一个拥有 2250 亿参数的专家混合模型,旨在进行自主编码和长时间任务。它具有高容量的专家路由和全局注意力架构,在各种基准测试中表现出色。

AI 模型与大语言模型

大语言模型 排名第 36 位

查看工具

大语言模型

拥有 2250 亿参数的专家混合模型,旨在进行自主编码和长时间任务。它具有高容量的专家路由和全局注意力架构,在各种基准测试中表现出色。Laguna M.1 是一个拥有 2250 亿参数的专家混合模型,旨在进行自主编码和长时间任务。它具有高容量的专家路由和全局注意力架构,在各种基准测试中表现出色。

AI 模型与大语言模型
大语言模型 排名第 36 位

MiniMax M3 是一个先进的 AI 模型,在编码和自主任务方面表现出色。它具有 1M 的上下文窗口和原生的多模态理解,基于 MSA 架构。该模型提供开放权重功能,使其成为开发者和研究人员的多功能工具。

AI 模型与大语言模型

大语言模型 排名第 49 位

查看工具

先进的 AI 模型,在编码和自主任务方面表现出色。它具有 1M 的上下文窗口和原生的多模态理解,基于 MSA 架构。该模型提供开放权重功能,使其成为开发者和研究人员的多功能工具。MiniMax M3 是一个先进的 AI 模型,在编码和自主任务方面表现出色。它具有 1M 的上下文窗口和原生的多模态理解,基于 MSA 架构。该模型提供开放权重功能,使其成为开发者和研究人员的多功能工具。

AI 模型与大语言模型
大语言模型 排名第 49 位

Ling-3.0-tiny

大语言模型

Ling-3.0-tiny 是一个轻量级的混合推理模型,具有 79 亿个参数,旨在实现高效的本地部署。它支持快速响应和多步骤推理,适合资源受限的环境。

AI 模型与大语言模型
查看工具

大语言模型

轻量级的混合推理模型,具有 79 亿个参数,旨在实现高效的本地部署。它支持快速响应和多步骤推理,适合资源受限的环境。Ling-3.0-tiny 是一个轻量级的混合推理模型,具有 79 亿个参数,旨在实现高效的本地部署。它支持快速响应和多步骤推理,适合资源受限的环境。

AI 模型与大语言模型
查看 大语言模型 Top 50
1/8