描述
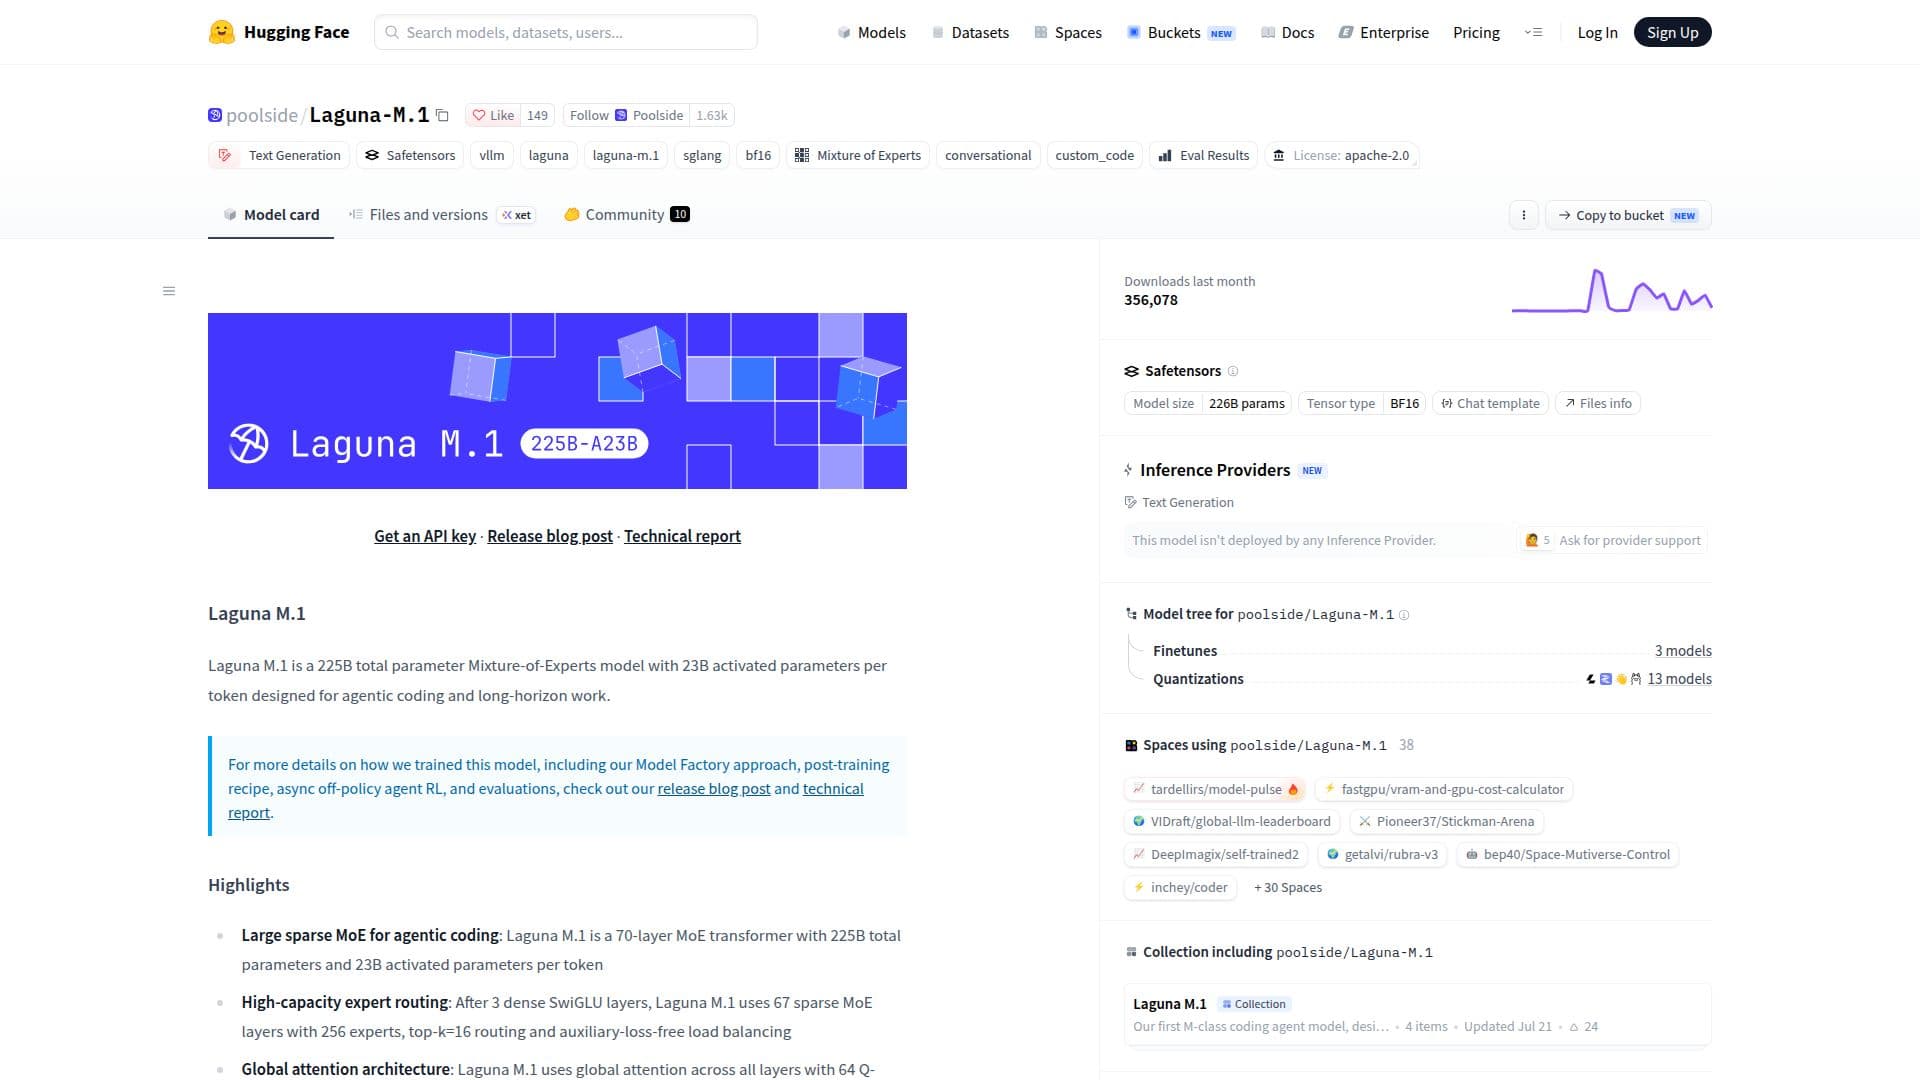
Laguna M.1 是一个复杂的专家混合(MoE)模型,专为自主编码和长时间任务而开发。它总共有 2250 亿参数,每个令牌激活 230 亿参数,旨在高效处理复杂的计算任务。该模型由 70 层组成,包括 67 层稀疏 MoE 层和 256 个专家,并利用高容量的专家路由机制。此设计允许 top-k=16 路由和无辅助损失的负载均衡,从而提高其计算效率。
阅读更多
该模型在所有层中采用全局注意力架构,具有 64 个 Q 头和 8 个 KV 头,并使用 softplus 注意力输出门控。此设置支持原生推理能力,使得工具调用之间的交错思维成为可能,可以根据请求启用或禁用。Laguna M.1 在多个基准测试中表现出色,包括 SWE-bench Verified、SWE-bench Multilingual、SWE-Bench Pro 和 Terminal-Bench 2.0,使其在与最先进模型的竞争中具有优势。
Laguna M.1 在 Apache 2.0 许可证下授权,允许在商业和非商业目的下自由使用和修改。得益于与 NVIDIA 的合作,该模型得到了 vLLM、SGLang、Transformers 和 TRT-LLM 等多个平台的支持。该模型专为软件工程和自主编码用例而设计,重点在于保留消息历史中的推理,以优化性能。
用户可以使用 vLLM 或 SGLang 在本地部署 Laguna M.1,支持工具调用、流式响应和推理解析。该模型还提供量化格式,如 FP8 和 NVFP4,以满足不同的部署需求。对于那些希望探索其能力的用户,Laguna M.1 可以通过 vLLM 和 SGLang 等平台访问,并在各自的文档中提供详细的部署指南。
- 类别AI 模型与大语言模型
- 定价模式开源
- 部署云端, 自托管
- 平台网页版, macOS, Linux
Laguna M.1亮点
2250 亿总参数
每个令牌 230 亿激活参数
70 层 MoE 变换器
256 个专家,top-k=16 路由
全局注意力架构
原生推理支持
Apache 2.0 许可证
强大的基准性能
Laguna M.1入门
访问模型页面:访问 Laguna M.1 的 Hugging Face 页面
身份验证:获取 API 密钥以进行访问
配置:根据所需参数设置模型
发送提示:使用模型进行文本到文本任务
微调:根据特定用例调整模型
Laguna M.1的使用案例
- 自主编码
- 长时间任务
- 基准测试
- 工具集成
- 研究与开发