

开源权重模型现在已经逼近最好的闭源模型,对很多工作来说,真正的问题不再是质量,而是谁来运行模型、你的数据去了哪里,以及许可证允许你做什么。Bloomberg Intelligence 的数据显示,在一项主流基准测试上,中国头部模型与美国领先模型的差距约为 3%,今年早些时候还是约 15%(AI Weekly,引用 Bloomberg)。
如果你是开发者、创业公司,或者有隐私合规要求的团队,这个变化对你影响最大。现在你可以从 Hugging Face 拉下一个模型,在自己掌控的硬件上运行,拿到一年前只有付费 API 才有的编码和 agent 效果。或者干脆不碰硬件,通过便宜的托管服务调用同样的权重。
但并非只有好处。"开源"这个词涵盖的许可证从随便用到必须细读条款不等,一些最大的模型需要整机架的 GPU,还有几个存在实实在在的安全和内容审查问题。本文梳理当前的领先模型,给出成本,并附上选型规则。如果你想看闭源和开源模型的整体格局,可以看我们的 Top 25 LLMs 榜单。
差距缩小了,阵容也变了
基准差距是头条,下面说说背后的情况。按 Bloomberg 的数据,今年早些时候中国头部模型落后约 15%,年中落后约 9%,一个月后落后约 6%,当时创下历史新低(The Next Web)。最新数据是约 3%。最新的数据点来自 DeepSeek V4.1 Flash:它在 LiveBench 上得分 81.1,Anthropic 一款领先模型是 83.4;在该基准的 agentic coding 子测试中,它以 77.3 对 66.1 领先。
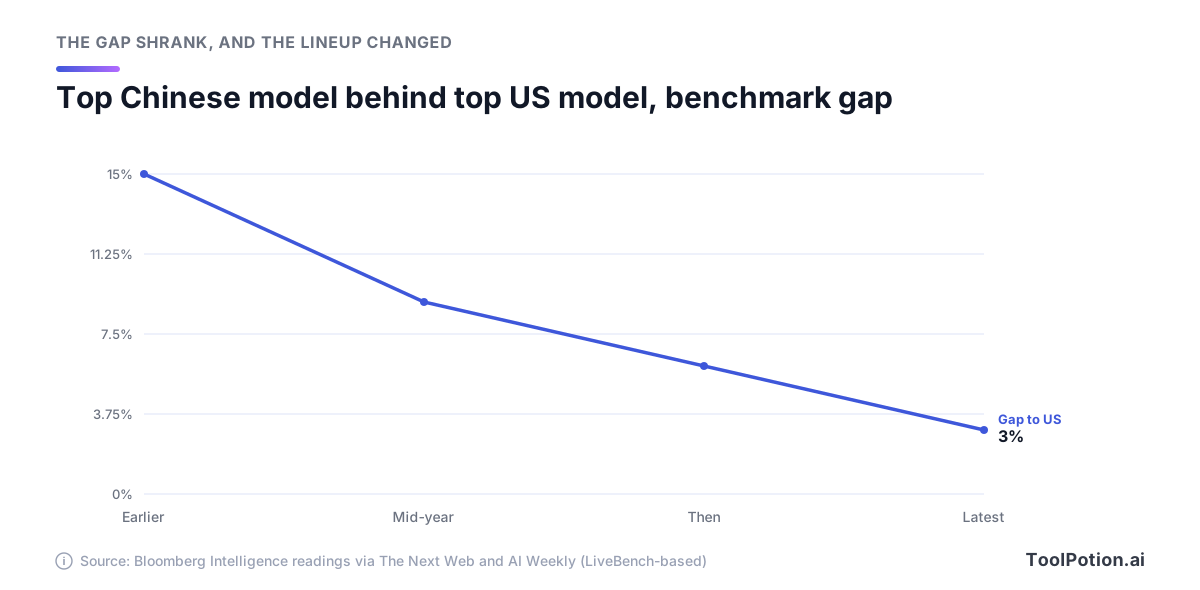
这里有几点要注意。LiveBench 前 15 名里只有三个是中国模型,所以这说的是前沿边缘的追赶,而不是全面压制。这个差距也只是一项基准下、双方各自最佳模型的对比,两个来源都没说它仅限于开源模型。不过方向很明确,而且缩小差距的 DeepSeek V4.1 Flash 就是开源权重模型。
今年还有两件事变了。第一,据 Qwen3.8-2.4T-A95B 自己的 model card,Qwen 首次以开源权重发布了 Max 级模型。第二,Meta 的开源发布有变化。Meta 的 Hugging Face 页面上最新的 Llama 模型仍是 2025 年的 Llama 4 系列,例如 Llama 4 Scout。Meta 的开发者网站现在主推其托管的 Muse Spark 模型,开源的则列出了 Muse Glimmer,一款面向本地 agent 的 30B 开源权重模型。
Mistral 是另一条新闻。它刚刚宣布了 Mistral Large 4,总参数 1 万亿、激活 520 亿,并在 API 上推出了预览版。Mistral 表示权重会在月底前放出(Mistral)。本文写作时还无法下载,Mistral 也没有公布许可证,所以 Large 4 只能算承诺,不算已发布。在权重和许可证上线 Hugging Face 之前,别围绕它做规划。
值得了解的开源权重模型
下面是当前领先模型的概览。规模和许可证来自各模型的 Hugging Face 页面,价格来自各厂商自己的定价页。"激活"指混合专家(MoE)模型每个 token 实际调用的参数量,它决定了速度。
| 模型 | 许可证 | 规模(激活) | 上下文 | 厂商 API,每百万 token 输入 / 输出(美元) |
|---|---|---|---|---|
| DeepSeek V4.1 Flash | MIT | 763B(8B 至 16B) | 1M | 高峰 0.30 / 1.20 |
| DeepSeek V4-Pro | MIT | 1.7T | 1M | 高峰 1.32 / 3.96 |
| Kimi K3 | Kimi K3 License | 2.8T(104B) | 1M | 3.00 / 15.00 |
| GLM-5.3 | GLM-5.3 License | 753B | 1M | 1.40 / 4.40 |
| Qwen3.8-27B | Apache 2.0 | 27B 稠密 | 262K | 托管版即将推出 |
| gpt-oss-120b | Apache 2.0 | 117B(5.1B) | 暂无 | 厂商未列出 API |
| Gemma 4 31B | Apache 2.0 | 31B 稠密 | 256K | 厂商未列出 API |
| Muse Glimmer | Apache 2.0 | 30B 稠密 | 131K+ | 厂商未列出 API |
| Mistral Large 4 | 未公布 | 1T(52B) | 暂无 | 预览版 1.36 / 4.18 |
论成本,DeepSeek 是稳妥的默认选择。V4.1 Flash 的权重采用 MIT 许可证,API 价格是大模型里最低的,非高峰时段还有半价(DeepSeek 文档)。别被名字骗了,这个"Flash"是一个 763B 的模型,下载量 510 GB(model card)。V4-Pro-0813 更大,约 1.7T。
Kimi K3 是最抢眼的一个。它总参数 2.8 万亿、激活 1040 亿,在自己的 model card 上给出 GPQA Diamond 93.5、BrowseComp 91.2。这些是 Moonshot 自己的数字,只能当作厂商宣称。Moonshot 自家 API 也是开源阵营里最贵的,很多人想不到(下文详述)。
Z.ai 的 GLM-5.3 是编码专精型。它与 GLM-5.2 共用基座模型,Z.ai 称所有提升都来自后训练,包括在其内部编码基准上提升了 50%(model card)。这是厂商自己的测量。它便宜的 Flash 版本 GLM-5.3-Flash 标价为输入 $0.15、输出 $0.50。
Qwen 的产品线覆盖最广。Qwen3.8-27B 是 Apache 2.0 许可的 27B 稠密模型,支持视觉,原生上下文 262K,据称 SWE-bench Pro 得分 61.7(model card)。对单台工作站来说,它是做编码和 agent 工作最值得先试的模型,对大多数小团队也是起步首选。大号的 Qwen3.8-2.4T 使用另一份许可证,下一节会讲。你也可以通过它的 app 试用 Qwen。
OpenAI 的 gpt-oss-120b 现在算老模型了,但依然好用。它是 Apache 2.0,激活参数 5.1B,据 OpenAI 称,一块 80 GB 的 GPU 就能跑(model card)。它发布于 2025 年,OpenAI 的 Hugging Face 页面上没有更新的 gpt-oss 版本。Gemma 4 是 Google 当前的系列;31B 模型采用 Apache 2.0,窗口 256K,并提供适用于 Ollama 和 llama.cpp 的量化版本(model card)。Muse Glimmer 是小个头的那个:Meta 称其约 4-bit 的版本不到 20 GB,可在 24 GB 或 32 GB 的显存范围内运行,较紧的设置下质量损失约 1%(model card)。
欧洲目前有两个选择。Mistral Medium 3.5 是 128B 稠密模型,窗口 256K,采用修改版 MIT 许可证,Mistral 的说法是可商用,但营收较大的公司除外。Mistral Small 4(119B)和较早的 Mistral Large 3 在 Hugging Face 上是 Apache 2.0。
"开源"也可能带附加条件
只有 Apache 2.0 和 MIT 的模型,才是多数开发者心目中的那种开源。最强的几个并不是。要看许可证文件,别只看标题。
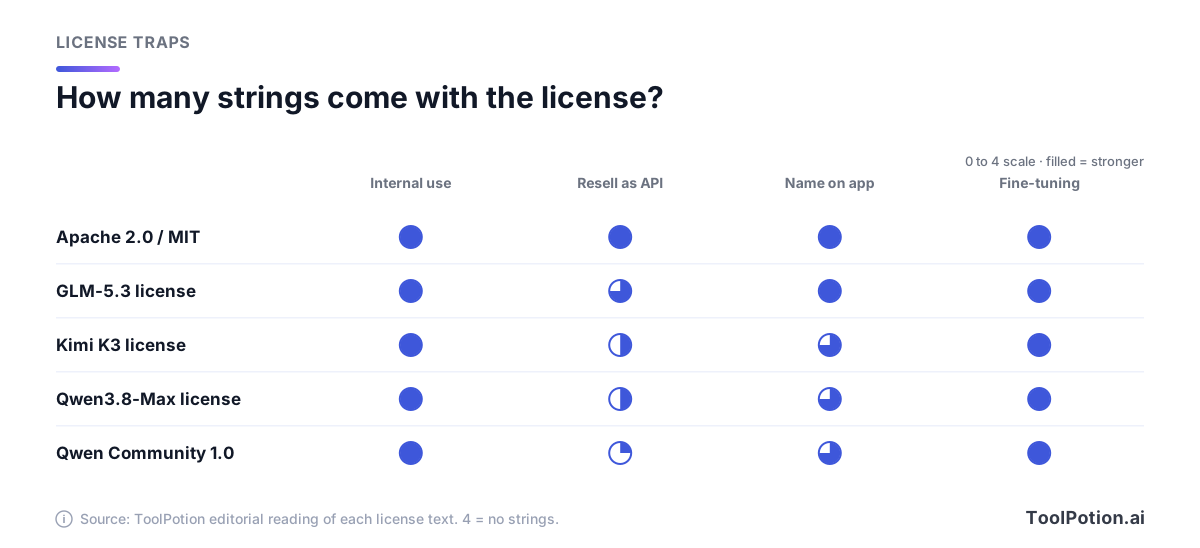
各个自定义许可证的规律是一样的:你可以自由使用、修改和微调,限制都落在把模型卖给别人上,通常是做成 API 且营收超过某条线之后。比如 Moonshot 的许可证规定,12 个月内营收超过 2000 万美元的"Model as a Service"运营方,商用前需要另行签订协议。月活 1 亿用户或月营收 2000 万美元的产品,必须在界面中标明"Kimi K3"(许可证原文)。内部使用不受限。
Z.ai 的许可证更宽松,唯一的门槛是对营收超过 100 亿美元的 Model-as-a-Service 运营方做安全审查。Qwen 的许可证是这几家里最严的。Qwen3.8-Flash-Next 的 Qwen Community License 规定,任何经营 Model-as-a-Service 或"AI Work Assistant"业务的公司,必须先从 Qwen 获得单独许可,内部使用除外(许可证原文)。2.4T 模型的 Max 许可证把这条线提高到了 5000 万美元营收。
如果你是在这些模型之上做应用,基本不会有问题。如果你的产品就是"提供这个模型的 API",上线前请和律师一起读许可证。想要毫无疑虑,就坚持用 Apache 2.0 或 MIT,也就是 DeepSeek、Qwen3.8-27B、gpt-oss、Gemma 4 和 Muse Glimmer。
托管 API 的价格
开源权重不等于 API 便宜。谁来托管模型,价格就不一样。
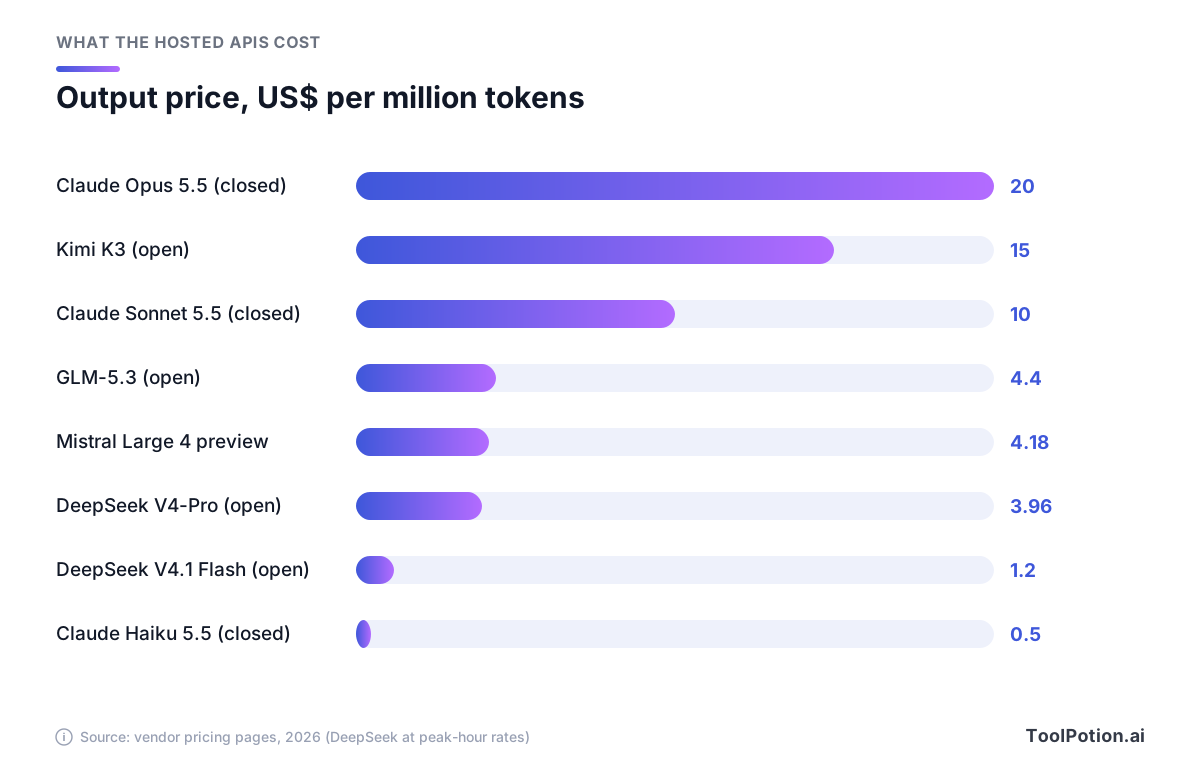
据 Moonshot 定价页,Kimi K3 每百万 token 输入 $3、输出 $15。这比 Anthropic 的 Claude Sonnet 5.5($2 和 $10)还贵,而 Sonnet 是闭源模型。DeepSeek 则相反:V4-Pro 的输出高峰期 $3.96,非高峰 $1.98。Z.ai 的 GLM-5.3 是输入 $1.40、输出 $4.40。
闭源的小模型比大多数开源旗舰还便宜。按各厂商定价页,Claude Haiku 5.5 标价为输入 $0.10、输出 $0.50,OpenAI 的 GPT-6 Luna 也一样。所以"选开源能省钱"只有在对比昂贵的闭源档位时才成立,而且前提是你选了便宜的开源托管方。
最便宜的路线往往是第三方托管同样的权重。OpenRouter 的公开模型列表显示 gpt-oss-120b 大约是每百万 token 输入 $0.04、输出 $0.17,不同服务商价格不同,变动也频繁。OpenRouter、Together AI、Fireworks AI 和 Groq 都用统一的 API 格式转售开源模型,所以换服务商只需要改一下 base URL。
自己跑,还是用托管
运行开源模型有四种方式,每往下一级,你拿到的控制权多一点,要做的活也多一点。
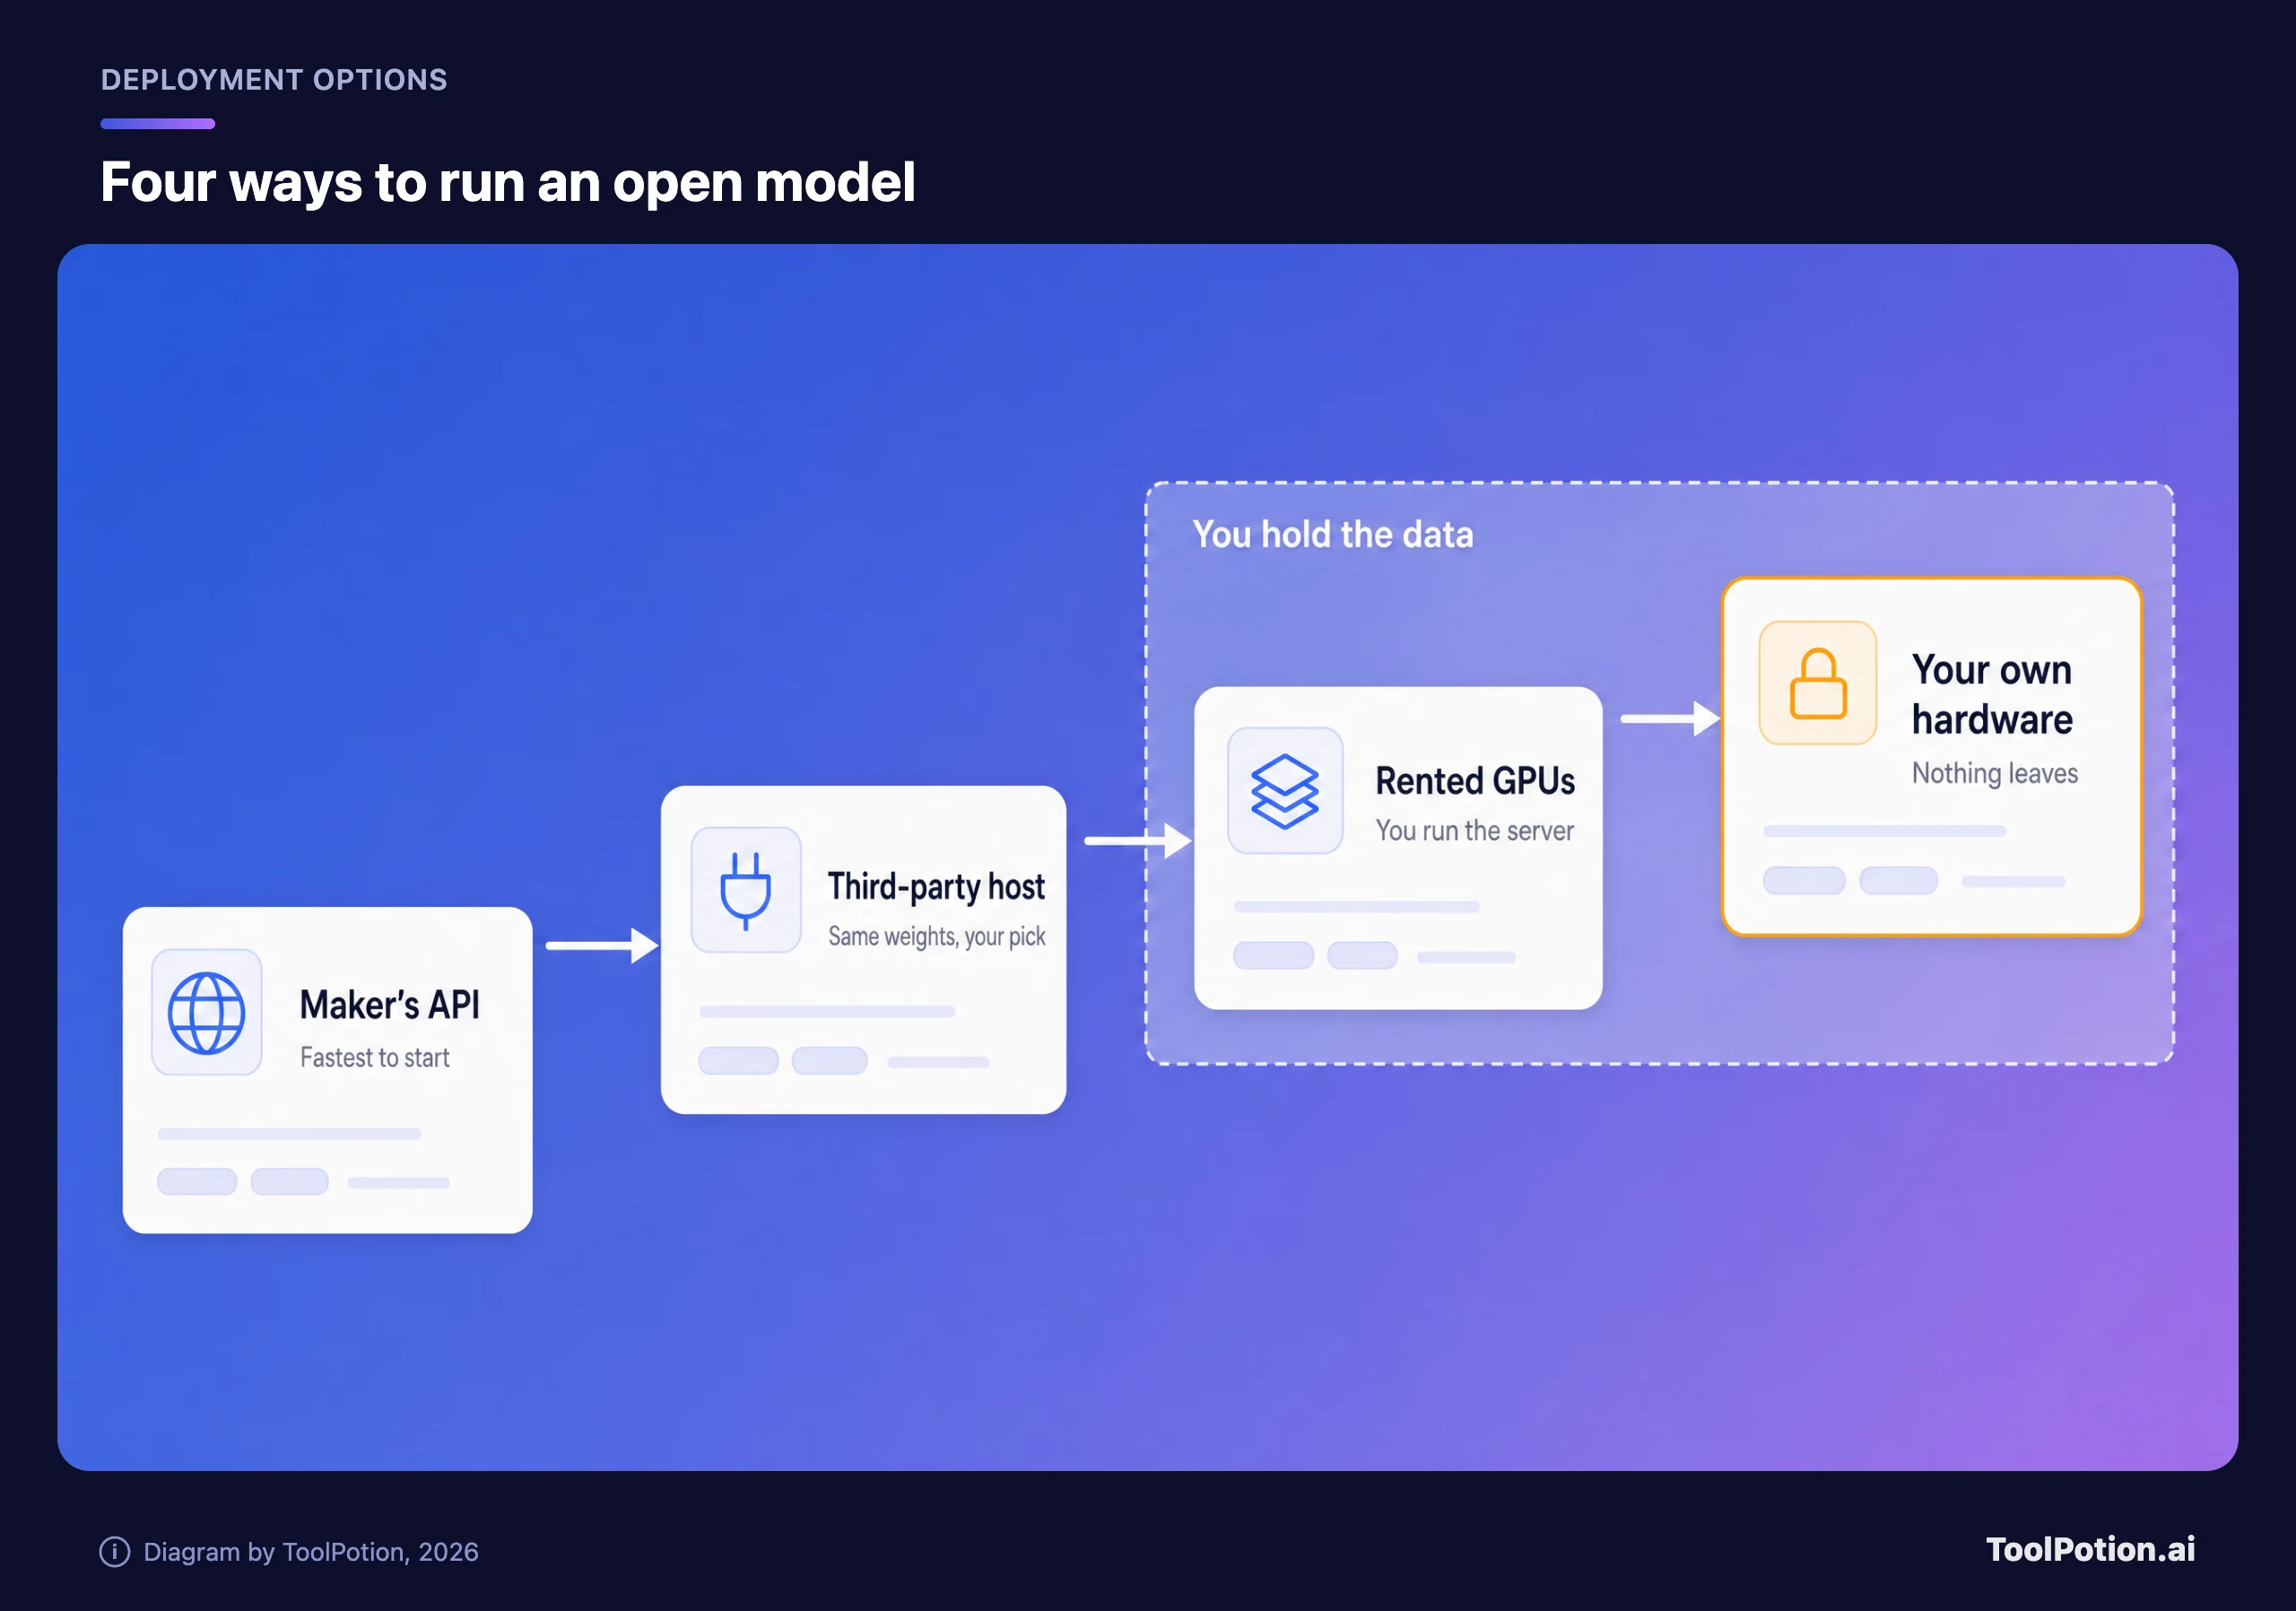
前两种是托管式的。你把 token 发给厂商或托管方,数据要经过别人的网络。后两种把模型放在你掌控的机器上,如果合同或监管要求数据不能出境,这就是关键。常见的拦路虎是权重装不进你的硬件,所以先看体积。
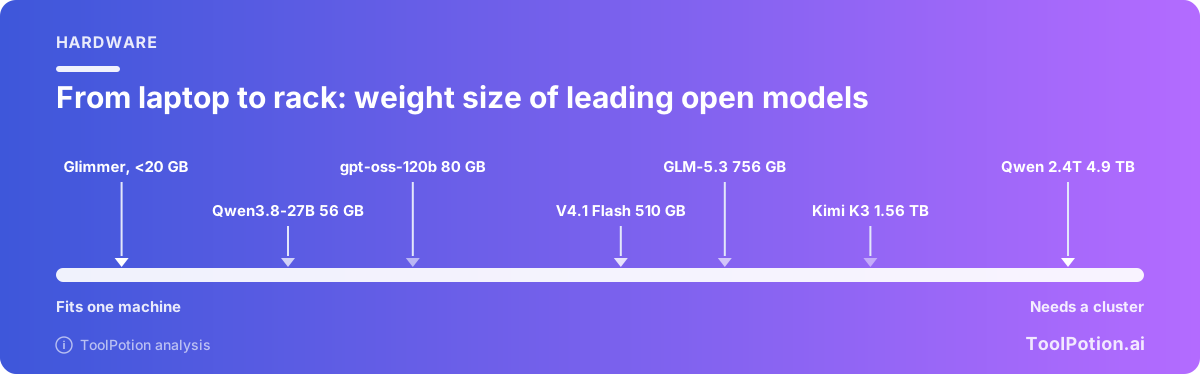
大多数头条模型对单台机器来说都太大了。Kimi K3 光权重就有 1.56 TB,超过八块 180 GB B200 显卡节点的 1.44 TB。DeepSeek V4-Pro 和 GLM-5.3 各需要几百 GB。能装进单机的是 20B 到 120B 这一档。用估算器对照你的硬件,检查模型和精度是否合适。
试试默认设置。gpt-oss-120b 在 4-bit 下加上开销大约需要 70 GB,所以一块 80 GB GPU 就够。换成 Kimi K3,同一个估算器要求十块 180 GB GPU,也就是两个八卡节点。按 Lambda 定价页上的按需价格,每块 B200 每小时 $6.69,这 16 块 GPU 整月运行大约要 $78,000。这就是自托管一个前沿开源模型的成本,还没算人力。
小模型这一端就友好得多。Lambda 的 80 GB GPU 起价每小时 $3.99,全天候运行一个月约 $2,900。这比 API 划不划算,完全取决于用量。
每月 3 亿输出 token、API 价格 $10 时,两边账单大致持平。低于这个量,API 更划算;高于这个量,租 GPU 更划算,前提是 GPU 一直有活干,而且模型对这份工作足够好。不过老实说,真正该比的是便宜的托管方。按 gpt-oss-120b 托管方约每百万输出 token $0.17 的标价,$2,900 能买到大约 170 亿输出 token,所以光看成本,单块租来的 GPU 几乎不可能赢过托管服务。租 GPU 是为了隐私、控制权和可预测的延迟,别为了在小模型上省钱而租。
举个例子,用量是编的,但比较合理。假设一个客服团队每天总结 20,000 张工单,每张输入 1,500 token、输出 300 token,一个月大约是 9 亿输入 token 和 1.8 亿输出 token。用 Claude Sonnet 5.5(每百万 $2 和 $10),账单是 $3,600。用 DeepSeek V4.1 Flash 按高峰价最多 $486,非高峰再减半。用 gpt-oss-120b 按托管方标价约 $64。租一块 80 GB GPU 不管你发多少请求都是 $2,913。便宜的托管方大幅胜出,而按厂商自己的价格,闭源模型比开源模型贵约七倍。
花钱之前有两个捷径。笔记本或工作站上,Ollama 和 llama.cpp 一条命令就能跑 Gemma 4、Qwen3.8-27B 和 Muse Glimmer 的量化版本。生产服务器上,vLLM 是 Kimi K3 和 Qwen3.8 的 model card 都列为支持的推理引擎。
如何选择
从你的约束条件出发,别从排行榜出发。三个问题能解决大部分情况。
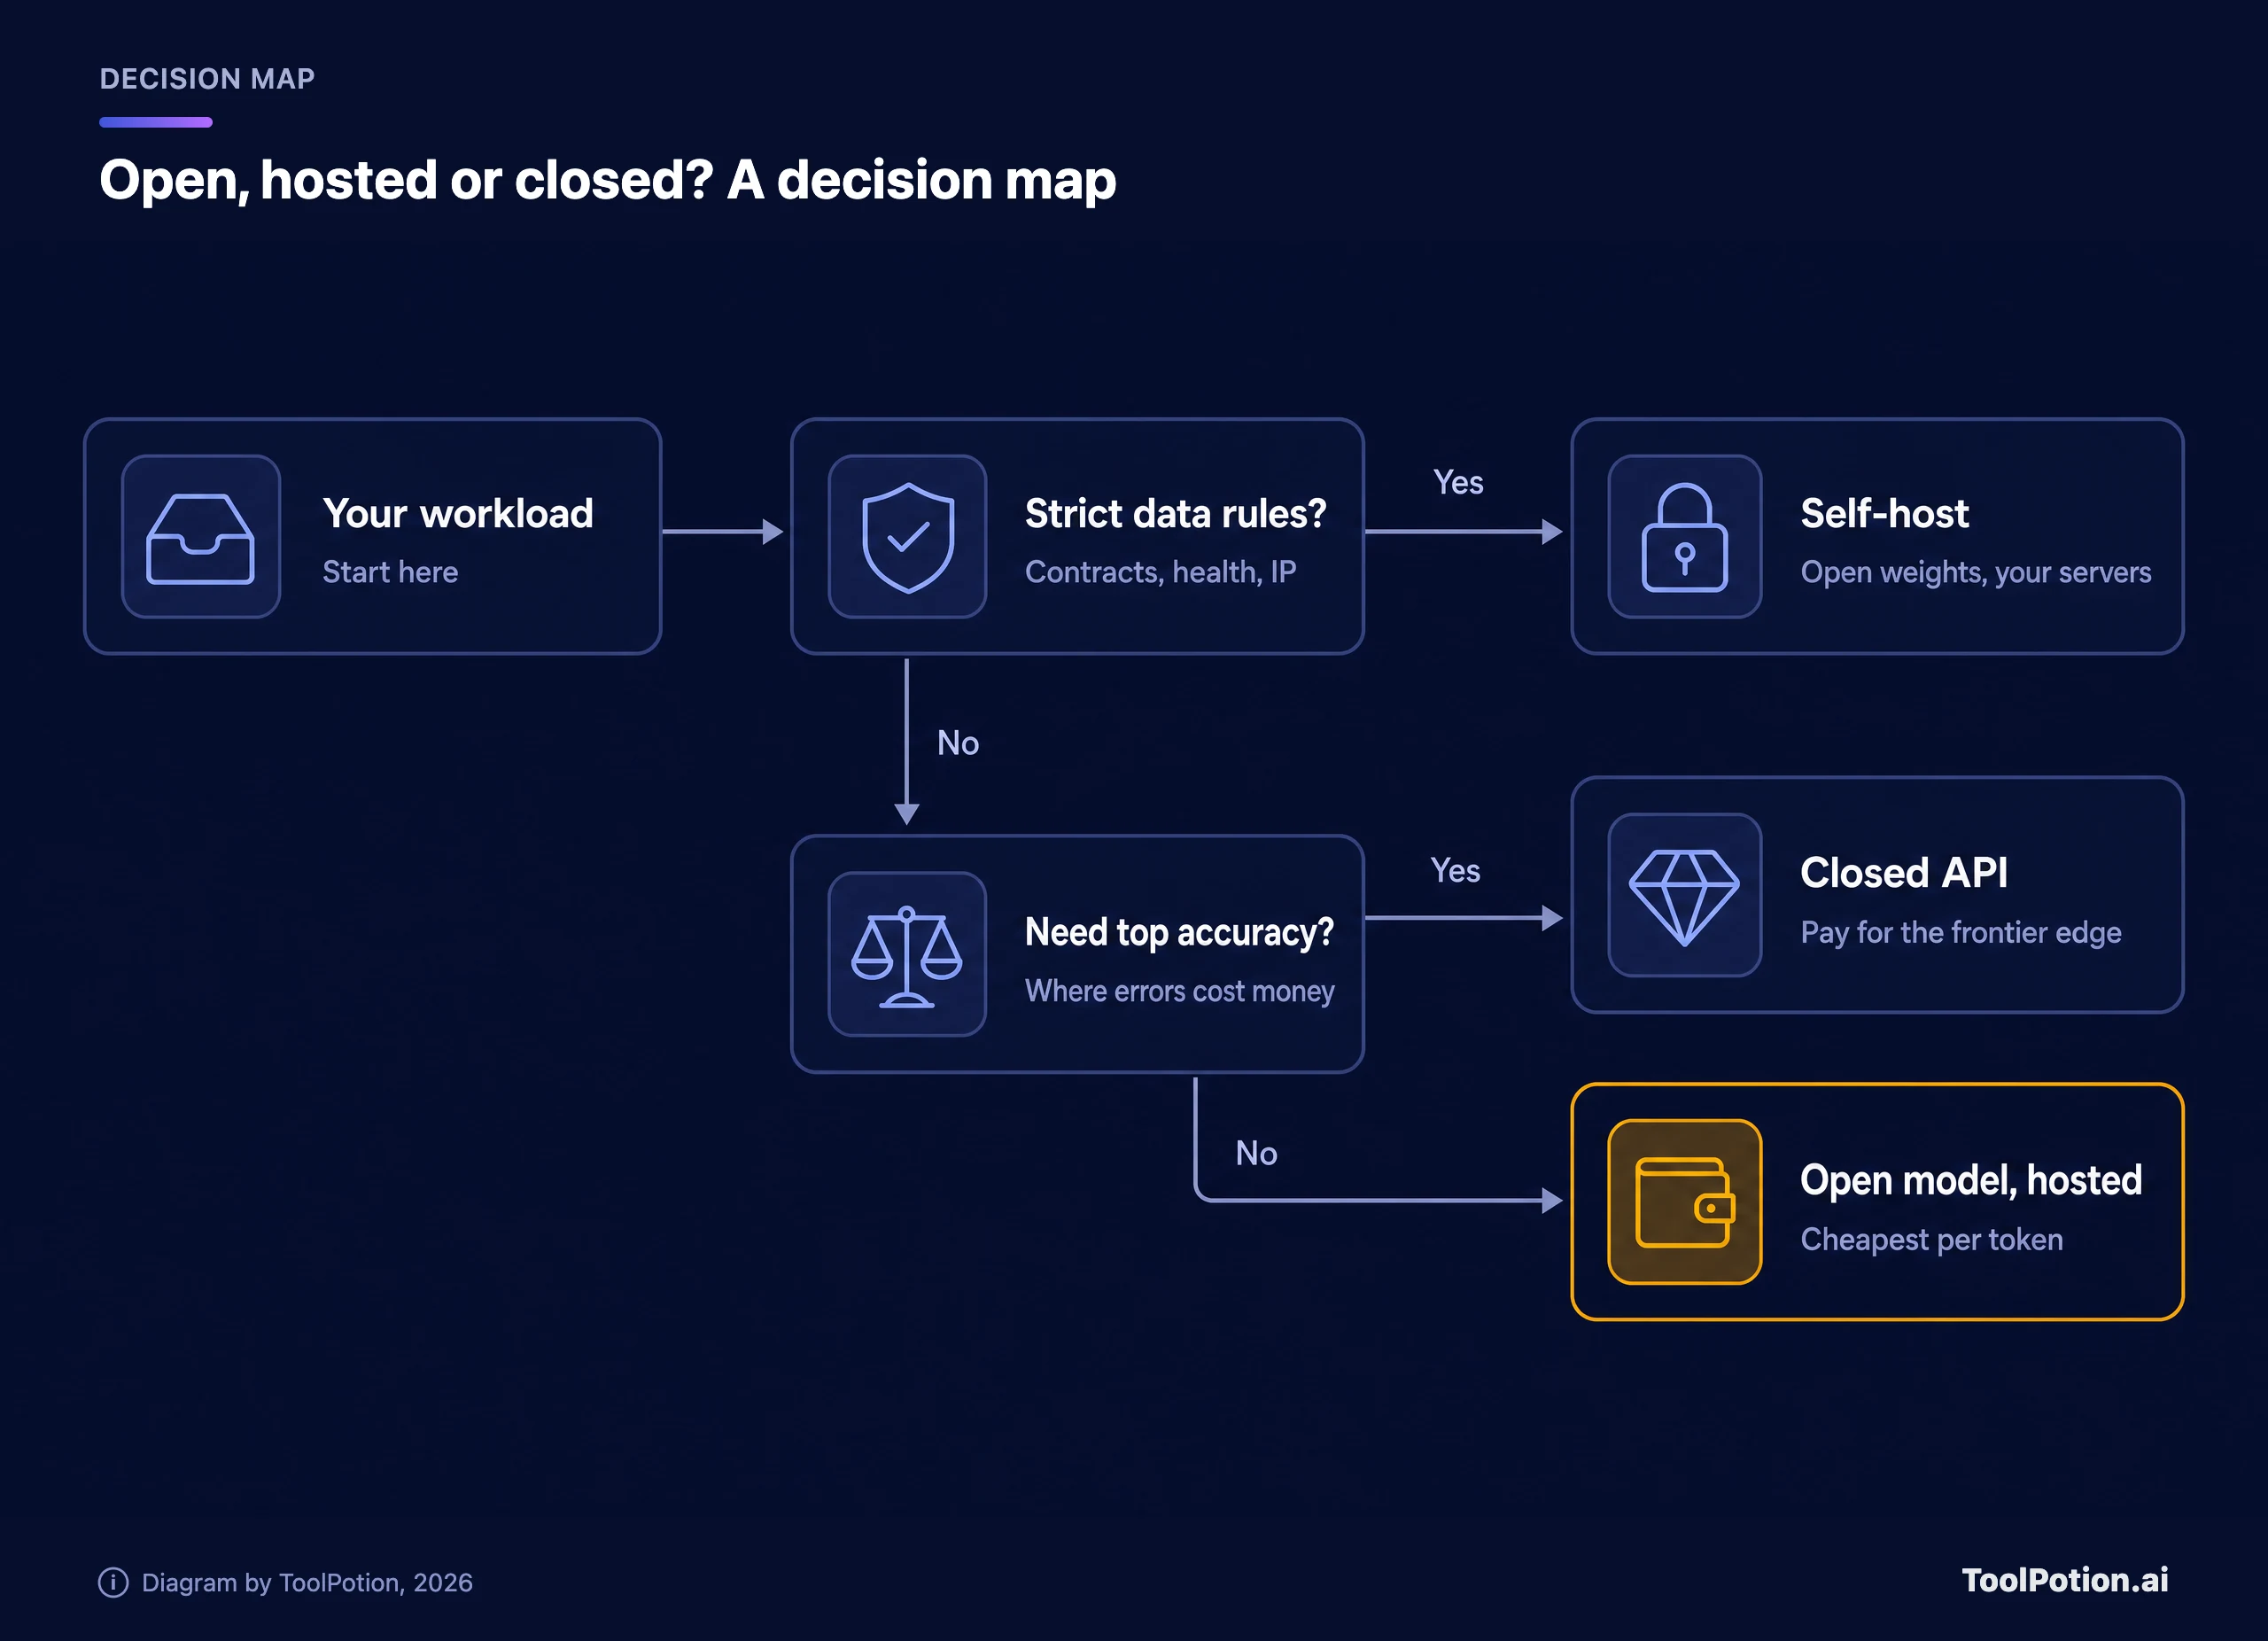
如果你的数据不能离开你的掌控,那就是自托管,模型必须装得进你的硬件。在这个约束下:
- 一块 GPU 或一台工作站:编码和 agent 选 Qwen3.8-27B,想要西方厂商的模型选 gpt-oss-120b,笔记本选 Muse Glimmer 或 Gemma 4。
- 多卡服务器:如果你买得起八块大卡,也放得下几百 GB 权重,选 DeepSeek V4.1 Flash 或 GLM-5.3。
- 集群:Kimi K3 或 Qwen3.8-2.4T,但前提是你有一支以跑推理为生的团队。
如果你的数据可以出去,就问问出错的代价高不高。代价高的场景(法律文书草稿、财务分析、不经审查就上线的代码),付费用闭源前沿模型,并用你自己的样例去验证。代价不高的场景(摘要、打标签、信息抽取、内部搜索、代码初稿),通过便宜的托管方用开源模型,是你能找到的最优价格。
选之前按顺序过一遍这份清单:
1. 写下不能动的约束:数据位置、每月预算,或者质量底线。
2. 对照你的用法检查许可证。基于模型做产品,几乎到处都没问题。转售模型才是有附加条件的地方。
3. 检查显存:权重的 GB 数对比你实际会买或租的硬件。
4. 把同一个工作负载放到厂商 API、第三方托管和租用 GPU 上分别算价。
5. 拿 50 个你自己的任务跑两三个候选模型,留下表现最好的。
承诺之前先测试。这里的基准都是厂商自己跑的,用的测试集也不同,所以一个榜单上的 90 分和另一个榜单上的 88 分说明不了什么。从你的工作负载里取 50 个真实任务,跑两三个候选模型,给结果打分。这样花一个下午,胜过读一周 model card。
model card 上没人会写的风险
安全。开源权重不代表模型安全。在 2025 年对较早 DeepSeek 模型的评估中,美国政府的 NIST 发现,其中最好的 R1-0528 在常见越狱手法下,对 94% 的明显恶意请求照做,美国参照模型是 8%。DeepSeek 的 agent 遵循隐藏在所处理内容中的恶意指令的可能性也高出 12 倍(NIST CAISI)。这些是比现在 V4 系列更早的模型,本文所依据的资料里也没找到对当前版本的同类公开评估。把它当作需要测试的理由,尤其是在给模型工具和写权限之前。
内容审查。NIST 还发现,DeepSeek 模型复述不准确的中共叙事的次数是美国参照模型的四倍。NIST 另一份关于 Kimi K2 Thinking 的报告发现,该模型在中文下审查严重,但在英语、西班牙语和阿拉伯语下相对不受审查。如果你的用户会用中文问政治或历史,就直接测一测。如果是代码和表格,这几乎不会碰到。
数据驻留。谁来托管模型,决定了你的数据去哪里。DeepSeek 的隐私政策称,它在中华人民共和国境内收集、处理和存储个人数据(DeepSeek 隐私政策)。这适用于它自己的 app 和 API,不适用于你在别处运行的 MIT 许可权重。Mistral 的卖点正相反:它称 Large 4 在欧洲自己的数据中心训练,预览版作为欧洲部署运行,受欧洲法律约束。无论哪家托管方,发送客户数据之前,都要问清楚推理在哪里跑、记录了什么日志。
过时。开源模型几个月就会过时。gpt-oss 的权重已有一年,Meta 最新的 Llama 来自 2025 年,Qwen 和 DeepSeek 仅在 2026 年就都发布了多个版本。把你测试过的模型版本固定下来,升级时重新测试。
哪些人还是该为闭源 API 付费
那 3% 的差距只是一项基准的读数。闭源模型在最顶端仍然领先,卖它们的实验室还在不断增加工具和托管功能,这些是开源权重没有的。
如果你需要在困难、高风险的工作上拿到最高准确率,如果没人能维护基础设施,或者用量小到任何托管方案都无关紧要,就付费用 Claude 或 ChatGPT。一个每天只调用几千次的团队,在工程师时间上花的钱会比省下的 token 费用更多。另外,如果你希望由一家供应商对可用性、安全和支持负责,也值得付费。
混着用,别全换。常见的做法是把日常的大头交给通过托管方调用的开源模型,困难的情况升级给闭源模型。我们那篇按任务匹配模型档位的指南里的路由规则可以直接套用:默认走便宜的,失败再升级。
常见问题
开源权重和开源有什么区别?
开源权重指你可以下载训练好的模型。严格意义上的开源,还应包含在认可的许可证下发布的训练数据和代码。这份清单里几乎没有模型达到这个标准。实际中 Apache 2.0 和 MIT 的模型最接近。Kimi 和 Qwen 这样的自定义许可证则附加了条件。
我可以商用这些模型吗?
可以,这里涉及的所有许可证都允许基于模型构建产品。条件主要在你把模型本身作为服务出售时才起作用,个别情况下也包括你的产品体量特别大时。Apache 2.0 和 MIT 的模型完全没有营收条件。
哪个开源模型最适合写代码?
按厂商公布的数字,GLM-5.3、Kimi K3 和 DeepSeek V4.1 Flash 领先,三者都需要服务器级硬件。单机的话,Qwen3.8-27B 是实用之选。基准测试集各不相同,所以请在你自己的代码库上跑自己的测试。
用 DeepSeek 处理公司数据安全吗?
取决于你怎么运行它。DeepSeek 的 app 和 API 按上述政策把数据存储在中国。MIT 许可的权重如果跑在你自己的服务器或你信任的托管方上,不会向 DeepSeek 发送任何数据。NIST 早期评估中提到的、模型行为方面的风险依然存在。
我需要多少 GPU 显存?
大致是参数量乘以位数再除以 8,再加约 20% 给缓存和运行时。27B 模型 8-bit 加开销约 33 GB。117B 模型 4-bit 约 70 GB。上面的估算器会帮你算好。
Mistral Large 4 什么时候开放权重?
Mistral 承诺在公告后不久放出权重,但还没有公布许可证条款。规划之前先去它的 Hugging Face 页面确认。