跳转到主要内容
ToolPotion
AI 顾问
提交(免费)

Juice Labs

AI 应用AI DevOps 与云工具免费增值 · Windows,Linux

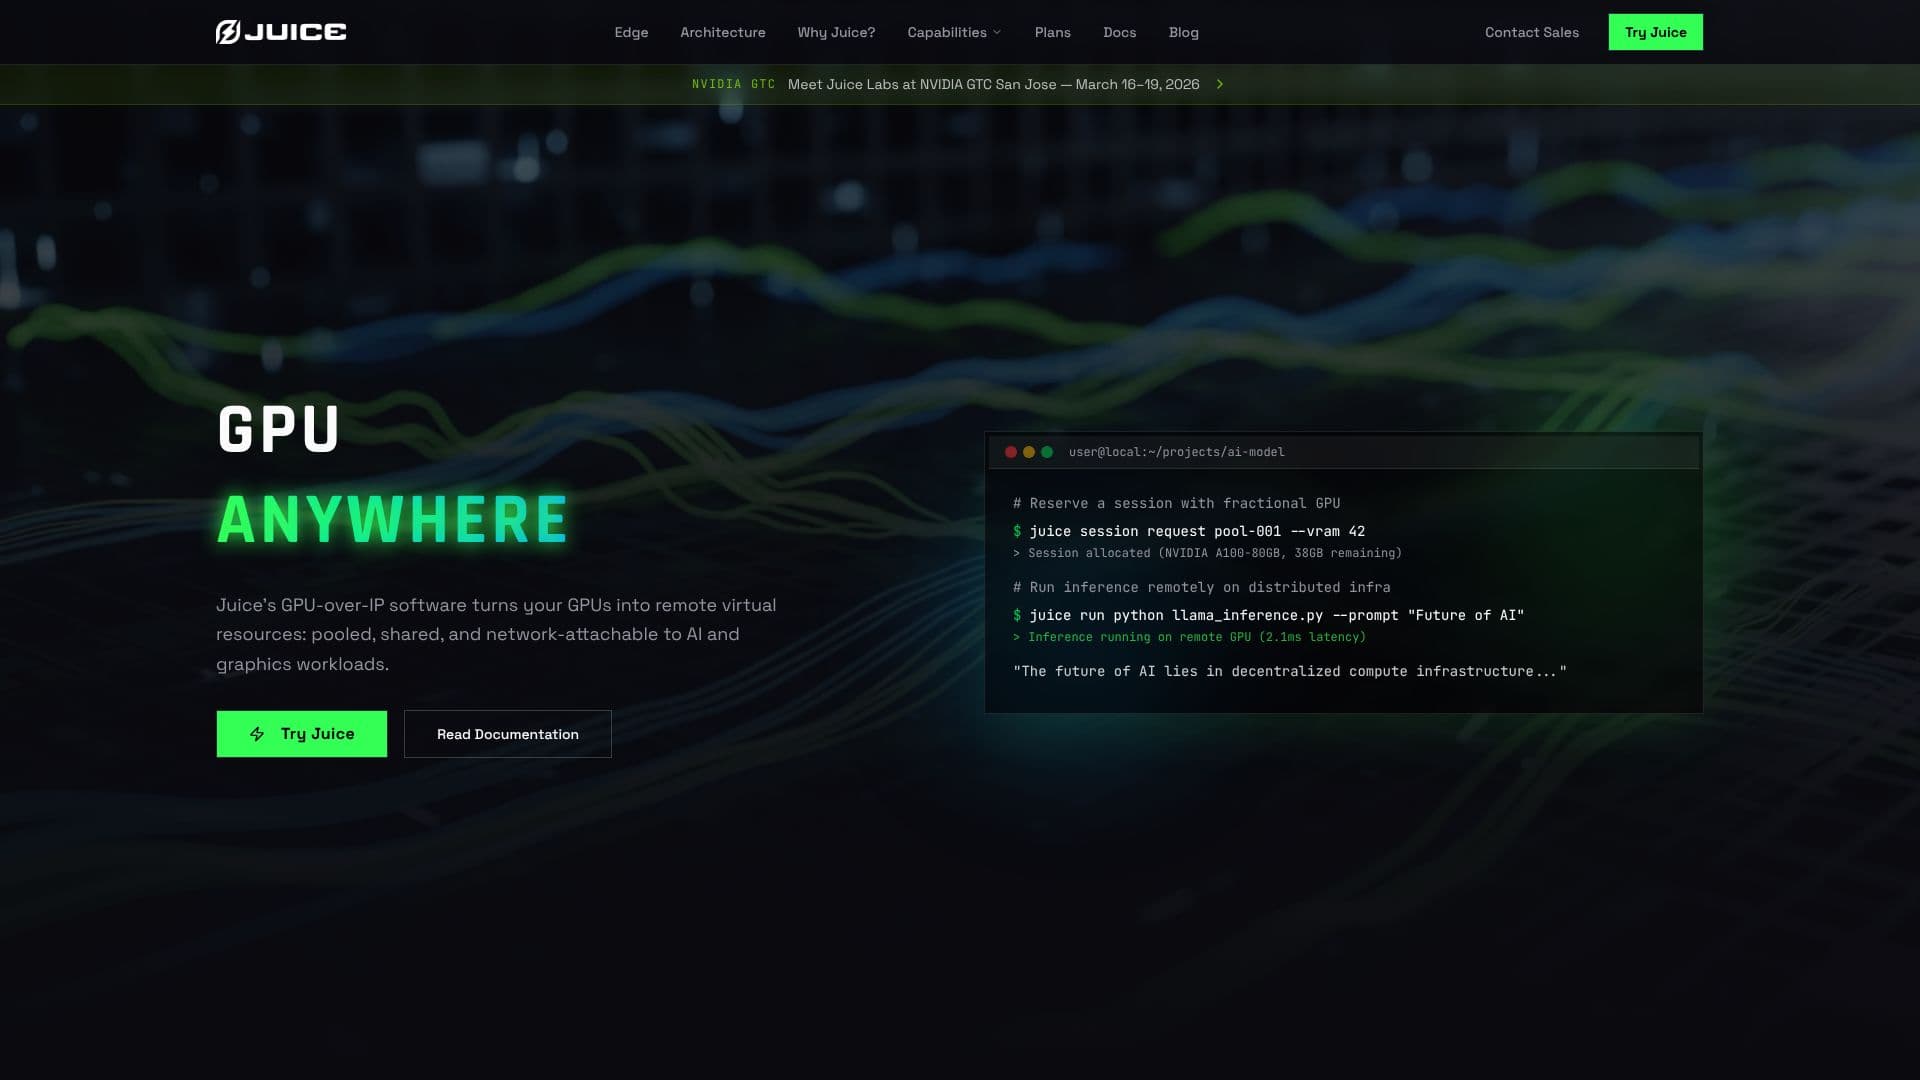
Juice Labs 提供 GPU-over-IP 软件,可将您的 GPU 转换为网络可连接的虚拟资源。它支持 AI 和图形工作负载的 GPU 分数共享,最大限度地提高利用率和投资回报率。此解决方案将应用程序与物理硬件分离,允许通过标准网络进行远程访问,而无需更改代码。

访问URL
分享
Juice Labs 截图
Juice Labs 截图

Juice Labs 提供革命性的 GPU-over-IP 软件解决方案,旨在将 GPU 作为远程虚拟资源进行访问。该技术汇集、共享和网络化 GPU,使其能够连接到 AI 和图形工作负载。通过将应用程序进程与物理 GPU 分离,Juice Labs 允许应用程序在通过标准网络连接的独立计算机上运行,有效地将任何 GPU 转换为网络附加资源。

阅读更多

这种架构对于希望释放边缘能力并快速推向市场的电信运营商和 ISP 尤其有利。它允许快速部署 GPU 服务器,而无需额外的系统、工具或基础设施开销。现有的接入点 (POP) 可以通过 GPU 进行增强,为高价值资产分配空间和电力。核心优势在于通过分数共享最大限度地提高 GPU 利用率,从而为每张部署的显卡带来更高的投资回报率 (ROI)。此外,Juice Labs 可确保数据主权,因为客户数据永远不会驻留在提供商系统上,从而将数据引力和合规性保留在用户控制之下。

Juice Labs 在传统基础设施(如 VDI、批处理和硬件分区)方面具有显著优势。其设置复杂度低,仅需安装客户端,而 VDI 或 K8s 的复杂度则很高。资源池是动态且细粒度的,与 MIG 或 vGPU 的静态分区形成对比。数据局部性保留在本地磁盘上,并且该解决方案与硬件无关,支持任何 NVIDIA GPU,包括消费级 RTX 卡。提供完整的 Windows 支持,支持广泛的创意和工程软件生态系统。

该平台支持 VRAM 和计算的动态分配,可实现真正的超额订阅和更高的利用率,而静态分区则无法做到。它同时支持重度图形工作负载 (DirectX/Vulkan) 和 ML 计算 (CUDA),这是其他解决方案通常受限的功能。Juice Labs 还可与 SLURM 等 HPC 环境无缝集成,允许 CPU 节点按需通过网络访问 GPU 算力。数据仍可从 CPU 节点上的原始位置访问,并且可以利用现有的 CPU 群集进行 GPU 加速工作负载,通过并行作业执行来最大限度地提高 CPU 的投资回报率并提高吞吐量。

Juice Labs 提供跨平台自由度,充当通用翻译层,允许应用程序访问最佳可用计算资源,而无论底层平台如何。这包括在 Linux 云 GPU 上运行仅限 Windows 的软件,以及将基于 ARM 的边缘设备连接到 x86 数据中心 GPU。对于超大规模用户,它提供了多云套利能力,使他们能够通过突发到成本效益高的云来摆脱 GPU 短缺和定价问题,同时将其数据和控制平面保留在其首选云提供商中。通过仅将数据流式传输到 GPU 主机进行传输中处理来解决数据引力问题,避免治理风险。来自 CoreWeave、Nebius 或 Lambda 等提供商的高端 GPU 的即时可用性也是一项关键优势,无需进行任何重构。

  • 类别AI DevOps 与云工具
  • 定价模式免费增值
  • 部署云端、本地部署
  • 平台Windows,Linux

  • GPU-over-IP 软件,用于远程虚拟 GPU 资源

  • AI 和图形工作负载的 GPU 分数共享

  • 最大限度地提高 GPU 利用率和投资回报率

  • 将应用程序与物理 GPU 分离

  • 通过标准网络实现远程 GPU 访问

  • GPU 服务器部署的快速上市时间

  • 动态且细粒度的资源池

  • 支持任何 NVIDIA GPU,包括消费级显卡

  • 完整的 Windows 和跨操作系统兼容性

  • 与 HPC 集群(例如 SLURM)无缝集成

  • 数据主权和合规性功能

  • 跨架构 GPU 访问(ARM 到 x86)

  • GPU 资源的多云套利

  • 云突发零重构

  1. 下载和安装:下载适用于您操作系统的 Juice 客户端二进制文件。

  2. 身份验证:使用您的组织凭据安全登录以访问 GPU 池。

  3. 配置:设置您的远程 GPU 代理并定义资源池。

  4. 运行应用程序:在应用程序前加上“juice run”前缀来附加远程 GPU。

  • 远程 AI 推理
  • 边缘计算
  • 最大限度地提高 GPU 投资回报率
  • HPC 工作负载加速
  • 跨平台开发
  • 云 GPU 套利
  • 虚拟桌面基础设施
  • 数据主权
  • 图形工作负载
  • 电信和 ISP 边缘解决方案

Juice Labs 评价

加载中...

与 Juice Labs 类似的热门AI工具

Thunder Compute 提供世界上最便宜的 GPU,以具有竞争力的每小时费率提供 NVIDIA H100 的访问权限。其云平台利用先进的 GPU 虚拟化技术,使计算资源变得丰富,旨在显著提高数据中心容量并降低与传统云提供商相比的成本。

MLOps 与模型部署

MLOps 与模型部署 排名第 59 位

查看工具

提供世界上最便宜的 GPU,以具有竞争力的每小时费率提供 NVIDIA H100 的访问权限。其云平台利用先进的 GPU 虚拟化技术,使计算资源变得丰富,旨在显著提高数据中心容量并降低与传统云提供商相比的成本。Thunder Compute 提供世界上最便宜的 GPU,以具有竞争力的每小时费率提供 NVIDIA H100 的访问权限。其云平台利用先进的 GPU 虚拟化技术,使计算资源变得丰富,旨在显著提高数据中心容量并降低与传统云提供商相比的成本。

MLOps 与模型部署
MLOps 与模型部署 排名第 59 位

Salad 提供分布式 GPU 云服务,拥有超过 60,000 个日活跃 GPU,起价仅为 $0.02/小时。它为 AI/ML 生产模型、推理、批处理等提供低成本、高扩展性的计算能力,为用户节省高达 90% 的成本。

MLOps 与模型部署
查看工具

提供分布式 GPU 云服务,拥有超过 60,000 个日活跃 GPU,起价仅为 $0.02/小时。它为 AI/ML 生产模型、推理、批处理等提供低成本、高扩展性的计算能力,为用户节省高达 90% 的成本。Salad 提供分布式 GPU 云服务,拥有超过 60,000 个日活跃 GPU,起价仅为 $0.02/小时。它为 AI/ML 生产模型、推理、批处理等提供低成本、高扩展性的计算能力,为用户节省高达 90% 的成本。

MLOps 与模型部署
查看 AI 应用 Top 250

Massed Compute 提供按需的 NVIDIA 云 GPU,从 B300 到 A30,预装 CUDA 且无带宽限制。按小时付费,无合同,分钟内即可部署 AI 工作负载。他们提供多种计算选项,包括按需、裸金属、集群以及用于自动化的程序化 API。

机器学习平台
查看工具

提供按需的 NVIDIA 云 GPU,从 B300 到 A30,预装 CUDA 且无带宽限制。按小时付费,无合同,分钟内即可部署 AI 工作负载。他们提供多种计算选项,包括按需、裸金属、集群以及用于自动化的程序化 API。Massed Compute 提供按需的 NVIDIA 云 GPU,从 B300 到 A30,预装 CUDA 且无带宽限制。按小时付费,无合同,分钟内即可部署 AI 工作负载。他们提供多种计算选项,包括按需、裸金属、集群以及用于自动化的程序化 API。

机器学习平台
查看 AI 应用 Top 250

Cirrascale 提供私有 AI 云,用于训练和推理,支持 NVIDIA、AMD 和 Qualcomm 等多种加速器。它具有高带宽网络、无出口费用和托管服务,为企业和研究机构提供安全高效的 AI 工作流。

AI DevOps 与云工具
查看工具

提供私有 AI 云,用于训练和推理,支持 NVIDIA、AMD 和 Qualcomm 等多种加速器。它具有高带宽网络、无出口费用和托管服务,为企业和研究机构提供安全高效的 AI 工作流。Cirrascale 提供私有 AI 云,用于训练和推理,支持 NVIDIA、AMD 和 Qualcomm 等多种加速器。它具有高带宽网络、无出口费用和托管服务,为企业和研究机构提供安全高效的 AI 工作流。

AI DevOps 与云工具
查看 AI 应用 Top 250

TAHO

AI 应用

TAHO是来自TAHO Labs的即插即用软件,可以充分利用您现有的AI和HPC硬件。它将工作负载分解为适合您处理器的线程级任务,在您现有的调度器(Kubernetes、SLURM)和服务栈(vLLM、SGLang、TensorRT-LLM)之下运行,无需代码更改。

AI DevOps 与云工具

AI DevOps 与云工具 排名第 123 位

查看工具

AI 应用

来自TAHO Labs的即插即用软件,可以充分利用您现有的AI和HPC硬件。它将工作负载分解为适合您处理器的线程级任务,在您现有的调度器(Kubernetes、SLURM)和服务栈(vLLM、SGLang、TensorRT-LLM)之下运行,无需代码更改。TAHO是来自TAHO Labs的即插即用软件,可以充分利用您现有的AI和HPC硬件。它将工作负载分解为适合您处理器的线程级任务,在您现有的调度器(Kubernetes、SLURM)和服务栈(vLLM、SGLang、TensorRT-LLM)之下运行,无需代码更改。

AI DevOps 与云工具
AI DevOps 与云工具 排名第 123 位

Vast.ai以低成本提供高性能云GPU租用服务。非常适合人工智能、机器学习、深度学习和渲染,提供灵活的定价、快速的设置和全球可用性,是开发者寻找GPU资源的首选平台。

机器学习平台
查看工具

Vast.ai以低成本提供高性能云GPU租用服务。非常适合人工智能、机器学习、深度学习和渲染,提供灵活的定价、快速的设置和全球可用性,是开发者寻找GPU资源的首选平台。

精选机器学习平台
查看 AI 平台 Top 150

SkyPilot是一个全面的AI计算平台,使团队能够管理、扩展和优化跨多个基础设施的AI工作负载。它提供了一个统一的作业管理界面、先进的调度和资源共享,提升了效率并降低了成本。

MLOps 与模型部署
查看工具

全面的AI计算平台,使团队能够管理、扩展和优化跨多个基础设施的AI工作负载。它提供了一个统一的作业管理界面、先进的调度和资源共享,提升了效率并降低了成本。SkyPilot是一个全面的AI计算平台,使团队能够管理、扩展和优化跨多个基础设施的AI工作负载。它提供了一个统一的作业管理界面、先进的调度和资源共享,提升了效率并降低了成本。

MLOps 与模型部署
查看 AI 应用 Top 250

ClearML 的 AI 基础设施平台可大规模简化从开发到生产的 AI/ML 工作流。它管理 GPU 集群,增强 AI 开发,并简化 GenAI 模型部署,从而最大限度地提高 AI 构建者的性能和可扩展性。

MLOps 与模型部署

AI 平台 排名第 78 位

查看工具

ClearML 的 AI 基础设施平台可大规模简化从开发到生产的 AI/ML 工作流。它管理 GPU 集群,增强 AI 开发,并简化 GenAI 模型部署,从而最大限度地提高 AI 构建者的性能和可扩展性。

精选MLOps 与模型部署
AI 平台 排名第 78 位
1/8