跳转到主要内容
ToolPotion
AI 顾问
提交(免费)

Salad 分布式 GPU 云

AI 应用MLOps 与模型部署按用量计费 · 网页版

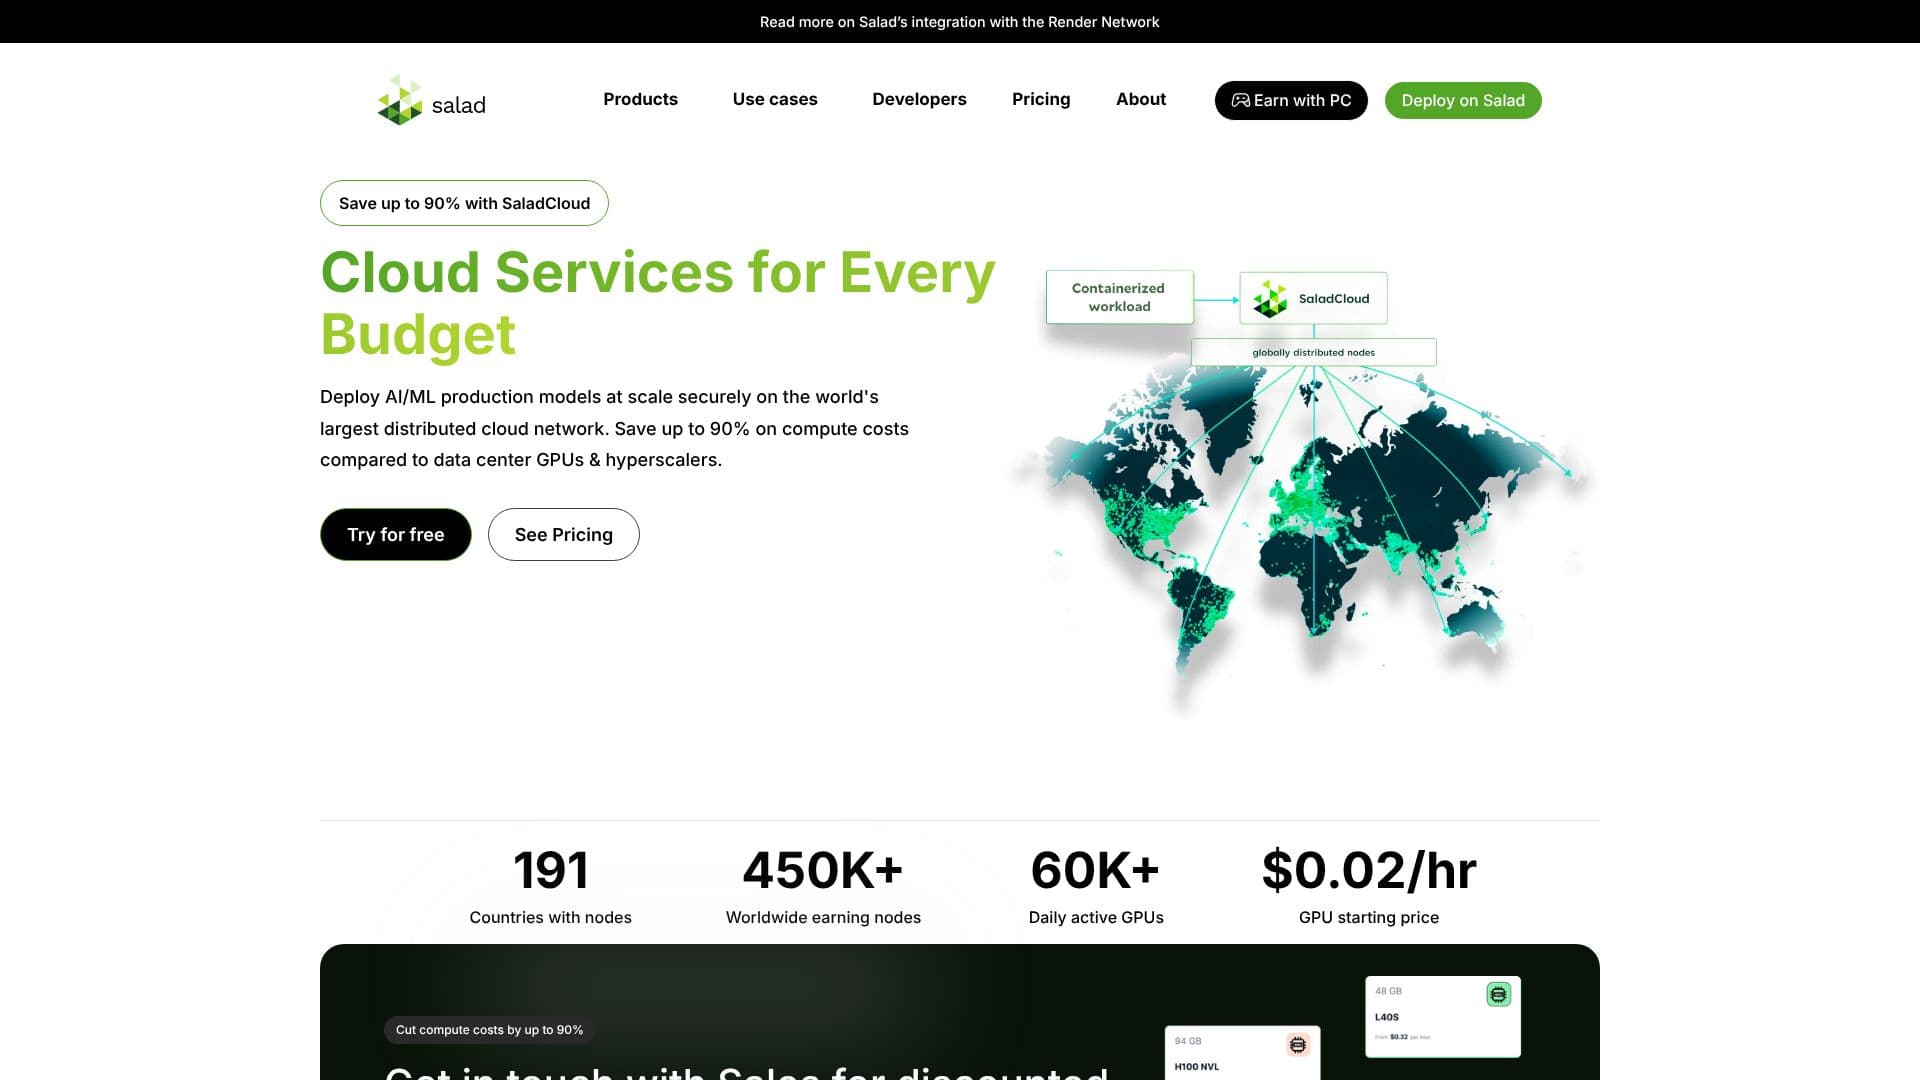
Salad 提供分布式 GPU 云服务,拥有超过 60,000 个日活跃 GPU,起价仅为 $0.02/小时。它为 AI/ML 生产模型、推理、批处理等提供低成本、高扩展性的计算能力,为用户节省高达 90% 的成本。

访问URL
分享
Salad 分布式 GPU 云 截图
Salad 分布式 GPU 云 截图

Salad 通过释放全球最大的 AI 计算能力,重新定义了云计算。该能力分布在全球超过 60,000 个日活跃 GPU 的网络中。这个社区驱动的云服务提供了显著更低的成本,起价低至每小时 $0.02,与传统超大规模云服务相比,可节省高达 90%。

阅读更多

Salad 专为无缝扩展 AI 项目而构建,使企业能够以无与伦比的成本效益部署 AI/ML 生产模型、执行 AI 推理、处理批处理以及运行分子动力学等高要求工作负载。该平台利用支持 AI 的消费级 GPU,为许多用例提供了比数据中心 GPU 更优越的成本效益比。

Salad 容器引擎 (SCE) 允许用户轻松部署工作负载,而无需管理虚拟机或单个实例。这个完全托管的容器服务确保了按需弹性,允许工作负载通过动态资源分配轻松扩展,以满足不断变化的需求。Salad 的全球边缘网络将计算能力带到离用户更近的地方,并在全球范围内提供低延迟节点,从而提高性能和可靠性。

Salad 非常适合广泛的 GPU 密集型工作负载,包括文本到图像生成、文本到语音、语音到文本、计算机视觉和语言模型。该平台拥有多云兼容性等功能,可与现有的混合或多云配置集成,并通过透明的按使用量付费定价和无预付合同或承诺来优化使用费用。

安全性是重中之重,其专利方法可在整个网络中隔离客户环境和数据。SaladCloud 获得 SOC2 认证,确保了安全可靠的部署环境。通过利用未使用的、潜在的 GPU 资源,Salad 促进了可持续的计算方法,使计算能力民主化,并减少了对环境的影响。

Civitai、Blend 和 Klyne.ai 等客户报告称,通过切换到 SaladCloud,成本显著降低,可扩展性得到提高。该平台在可负担性、可扩展性和客户友好性方面的承诺,使其成为寻求优化其云计算支出的初创公司和企业的有吸引力的选择。

  • 类别MLOps 与模型部署
  • 定价模式按用量计费
  • 部署云端
  • 平台网页版

  • 拥有超过 60,000 个日活跃 GPU 的分布式 GPU 云

  • 低成本 GPU 实例,起价 $0.02/小时

  • 与超大规模云服务相比,成本节省高达 90%

  • 无缝扩展 AI 项目

  • 支持 AI 推理、批处理和 HPC 工作负载

  • 具有低延迟节点的全球边缘网络

  • Salad 容器引擎 (SCE) 便于部署

  • 按需弹性与动态资源分配

  • 多云兼容

  • 按使用量付费,无合同或承诺

  • SOC2 认证,安全可靠

  • 无入站/出站数据费用

  • 完全托管的容器服务

  • 无限扩展 GPU 访问能力

  1. 部署:容器化您的应用程序并定义资源需求。

  2. 配置:选择您想要的 GPU 资源和部署设置。

  3. 启动:在分布式 GPU 网络上启动您的工作负载。

  4. 监控:通过 Salad 仪表板跟踪性能和成本。

  5. 扩展:根据实时需求动态调整资源。

  • AI 推理
  • 文本到图像生成
  • 文本到语音
  • 语音到文本
  • 计算机视觉
  • 语言模型
  • 批处理
  • HPC 工作负载
  • 渲染

Salad 分布式 GPU 云 评价

加载中...

与 Salad 分布式 GPU 云 类似的热门AI工具

Thunder Compute 提供世界上最便宜的 GPU,以具有竞争力的每小时费率提供 NVIDIA H100 的访问权限。其云平台利用先进的 GPU 虚拟化技术,使计算资源变得丰富,旨在显著提高数据中心容量并降低与传统云提供商相比的成本。

MLOps 与模型部署

MLOps 与模型部署 排名第 59 位

查看工具

提供世界上最便宜的 GPU,以具有竞争力的每小时费率提供 NVIDIA H100 的访问权限。其云平台利用先进的 GPU 虚拟化技术,使计算资源变得丰富,旨在显著提高数据中心容量并降低与传统云提供商相比的成本。Thunder Compute 提供世界上最便宜的 GPU,以具有竞争力的每小时费率提供 NVIDIA H100 的访问权限。其云平台利用先进的 GPU 虚拟化技术,使计算资源变得丰富,旨在显著提高数据中心容量并降低与传统云提供商相比的成本。

MLOps 与模型部署
MLOps 与模型部署 排名第 59 位

Massed Compute 提供按需的 NVIDIA 云 GPU,从 B300 到 A30,预装 CUDA 且无带宽限制。按小时付费,无合同,分钟内即可部署 AI 工作负载。他们提供多种计算选项,包括按需、裸金属、集群以及用于自动化的程序化 API。

机器学习平台
查看工具

提供按需的 NVIDIA 云 GPU,从 B300 到 A30,预装 CUDA 且无带宽限制。按小时付费,无合同,分钟内即可部署 AI 工作负载。他们提供多种计算选项,包括按需、裸金属、集群以及用于自动化的程序化 API。Massed Compute 提供按需的 NVIDIA 云 GPU,从 B300 到 A30,预装 CUDA 且无带宽限制。按小时付费,无合同,分钟内即可部署 AI 工作负载。他们提供多种计算选项,包括按需、裸金属、集群以及用于自动化的程序化 API。

机器学习平台
查看 AI 应用 Top 250

通用计算

AI 应用

一个高速AI推理提供商,通过专门构建的ASIC基础设施提供模型,采用与OpenAI兼容的API,针对编码代理和实时语音等对延迟敏感的工作负载,提供低的首次令牌时间和高吞吐量。

MLOps 与模型部署
查看工具

AI 应用

一个高速AI推理提供商,通过专门构建的ASIC基础设施提供模型,采用与OpenAI兼容的API,针对编码代理和实时语音等对延迟敏感的工作负载,提供低的首次令牌时间和高吞吐量。

MLOps 与模型部署
查看 AI 应用 Top 250

SkyPilot是一个全面的AI计算平台,使团队能够管理、扩展和优化跨多个基础设施的AI工作负载。它提供了一个统一的作业管理界面、先进的调度和资源共享,提升了效率并降低了成本。

MLOps 与模型部署
查看工具

全面的AI计算平台,使团队能够管理、扩展和优化跨多个基础设施的AI工作负载。它提供了一个统一的作业管理界面、先进的调度和资源共享,提升了效率并降低了成本。SkyPilot是一个全面的AI计算平台,使团队能够管理、扩展和优化跨多个基础设施的AI工作负载。它提供了一个统一的作业管理界面、先进的调度和资源共享,提升了效率并降低了成本。

MLOps 与模型部署
查看 AI 应用 Top 250

GPUX

AI 应用

GPUX 提供 AI 模型无服务器 GPU 推理,支持快速部署和执行机器学习工作负载。它提供快速冷启动,支持 Stable Diffusion XL 和 Whisper 等多种 AI 模型,并允许用户运行推理或在私有模型上出售请求,使 AI 更加易于访问和高效。

MLOps 与模型部署
查看工具

AI 应用

提供 AI 模型无服务器 GPU 推理,支持快速部署和执行机器学习工作负载。它提供快速冷启动,支持 Stable Diffusion XL 和 Whisper 等多种 AI 模型,并允许用户运行推理或在私有模型上出售请求,使 AI 更加易于访问和高效。GPUX 提供 AI 模型无服务器 GPU 推理,支持快速部署和执行机器学习工作负载。它提供快速冷启动,支持 Stable Diffusion XL 和 Whisper 等多种 AI 模型,并允许用户运行推理或在私有模型上出售请求,使 AI 更加易于访问和高效。

MLOps 与模型部署
查看 AI 应用 Top 250

Cirrascale 提供私有 AI 云,用于训练和推理,支持 NVIDIA、AMD 和 Qualcomm 等多种加速器。它具有高带宽网络、无出口费用和托管服务,为企业和研究机构提供安全高效的 AI 工作流。

AI DevOps 与云工具
查看工具

提供私有 AI 云,用于训练和推理,支持 NVIDIA、AMD 和 Qualcomm 等多种加速器。它具有高带宽网络、无出口费用和托管服务,为企业和研究机构提供安全高效的 AI 工作流。Cirrascale 提供私有 AI 云,用于训练和推理,支持 NVIDIA、AMD 和 Qualcomm 等多种加速器。它具有高带宽网络、无出口费用和托管服务,为企业和研究机构提供安全高效的 AI 工作流。

AI DevOps 与云工具
查看 AI 应用 Top 250

Together AI

AI 平台

Together AI 提供全栈 AI 平台,即 AI 原生云,用于推理、微调和 GPU 集群。它由前沿研究提供支持,提供更快的推理、更低的成本和加速的预训练。该平台支持 AI 发展的每个阶段,从实验到大规模部署。

机器学习平台

AI 平台 排名第 17 位

查看工具

AI 平台

提供全栈 AI 平台,即 AI 原生云,用于推理、微调和 GPU 集群。它由前沿研究提供支持,提供更快的推理、更低的成本和加速的预训练。该平台支持 AI 发展的每个阶段,从实验到大规模部署。Together AI 提供全栈 AI 平台,即 AI 原生云,用于推理、微调和 GPU 集群。它由前沿研究提供支持,提供更快的推理、更低的成本和加速的预训练。该平台支持 AI 发展的每个阶段,从实验到大规模部署。

精选机器学习平台
AI 平台 排名第 17 位

Runpod

AI 平台

Runpod提供按需GPU和无服务器计算的AI基础设施,使开发者能够高效地在云中运行训练、推理和批量工作负载。仅为您使用的部分付费,按毫秒计费。

机器学习平台

AI 平台 排名第 63 位

查看工具

AI 平台

提供按需GPU和无服务器计算的AI基础设施,使开发者能够高效地在云中运行训练、推理和批量工作负载。仅为您使用的部分付费,按毫秒计费。Runpod提供按需GPU和无服务器计算的AI基础设施,使开发者能够高效地在云中运行训练、推理和批量工作负载。仅为您使用的部分付费,按毫秒计费。

精选机器学习平台
AI 平台 排名第 63 位
1/8