描述
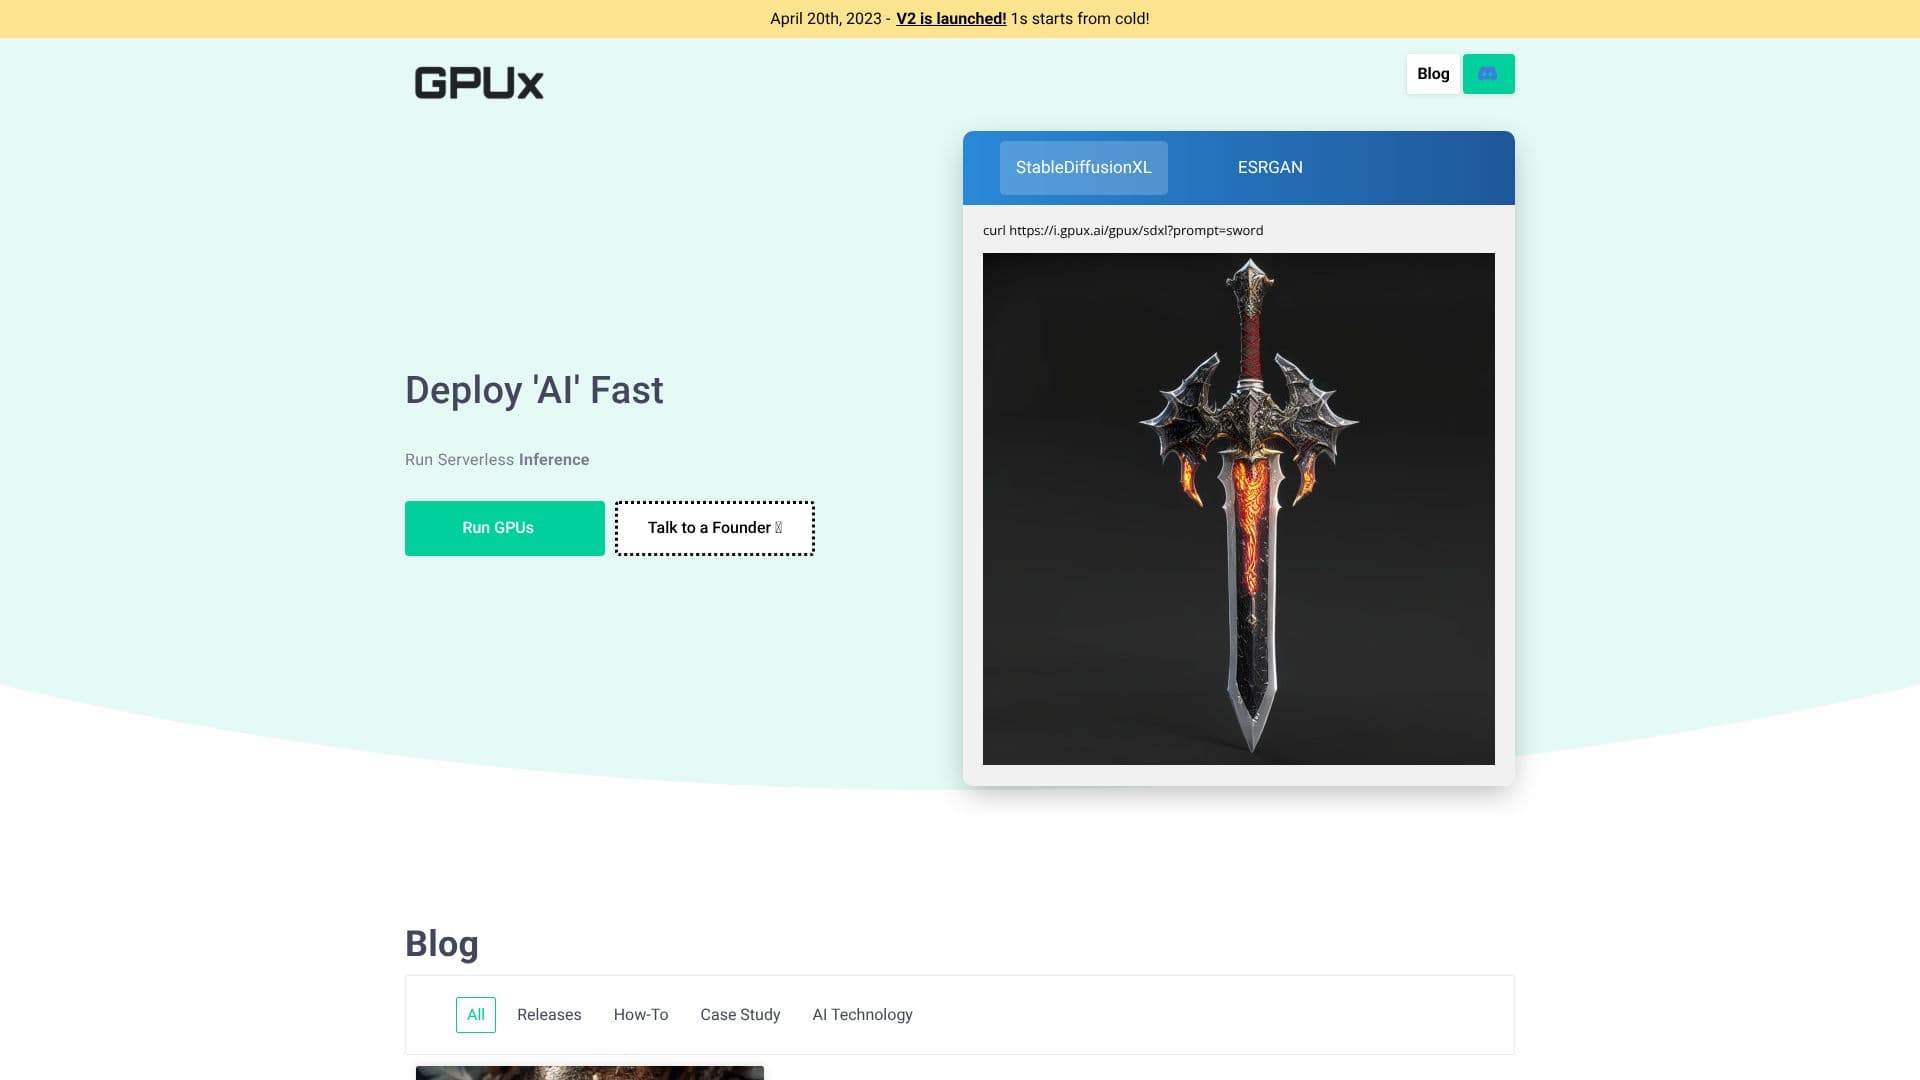
GPUX 是一个无服务器推理平台,旨在加速 AI 和机器学习模型的部署和执行。GPUX 于 2023 年 4 月 20 日发布 V2 版本,专注于提供快速冷启动,实例启动时间仅需 1 秒。此功能对于需要即时响应能力的应用至关重要。
阅读更多
该平台支持一系列流行的 AI 模型,包括 Stable Diffusion XL (SDXL)、ESRGAN 和 WHISPER,使其能够灵活地用于各种 AI 任务,如图像生成、放大和语音转文本。GPUX 允许用户部署其 AI 模型并运行无服务器推理,从而抽象化基础设施管理的复杂性。
除了运行推理,GPUX 还提供了一个独特的 AI 模型货币化功能。用户可以在其私有模型上向其他组织出售推理请求,从而创建一个 AI 能力的市场。这种点对点 (P2P) 模型可以为模型所有者带来收入,同时为其他企业提供专业 AI 的访问权限。
GPUX 强调“量身定制”对机器学习工作负载的重要性,这与耐克如何打造专业女子足球鞋的方式类似。这意味着根据 AI 任务的具体需求定制基础设施和部署。该平台支持 ReadWrite Volumes 等功能,增强了推理过程中数据处理的灵活性。
GPUX 的目标受众包括开发人员、数据科学家以及希望在不管理底层硬件的情况下高效部署和扩展 AI 模型的组织。该平台旨在普及 GPU 计算在 AI 推理中的应用,使其更快、更具成本效益。GPUX 团队包括 Annie(市场营销)、Ivan(技术)和 Henry(运营),并提供了联系信息和 LinkedIn 个人资料以供互动。
GPUX 还提供博客等资源,其中包含有关 AI 技术、操作指南和案例研究的文章。最近的博客文章强调了性能改进,例如使 Stable Diffusion XL 在 RTX 4090 上的速度提高了 50%,这表明了对优化和用户教育的承诺。
该平台注重易用性和性能,使用户能够“快速部署‘AI’”。
- 类别MLOps 与模型部署
- 部署无服务器
- 平台网页版
GPUX的核心功能
无服务器 GPU 推理
1 秒冷启动
支持 Stable Diffusion XL
支持 WHISPER
支持 ESRGAN
在已部署模型上运行推理
在私有模型上出售推理请求
支持 ReadWrite Volumes
推理请求的点对点模型
AI 模型快速部署
可扩展的推理基础设施
如何使用 GPUX?
部署模型:将您训练好的 AI 模型上传到 GPUX 平台。
配置推理:设置运行模型推理的参数。
运行推理:按需执行推理任务,利用无服务器 GPU。
优化性能:利用各项功能提高模型速度和效率。
货币化模型(可选):向其他用户提供私有模型的推理服务。
GPUX的使用案例
- AI 模型部署
- 无服务器推理
- 图像生成
- 语音转文本
- 模型货币化
- AI 性能优化
- GPU 计算访问