描述
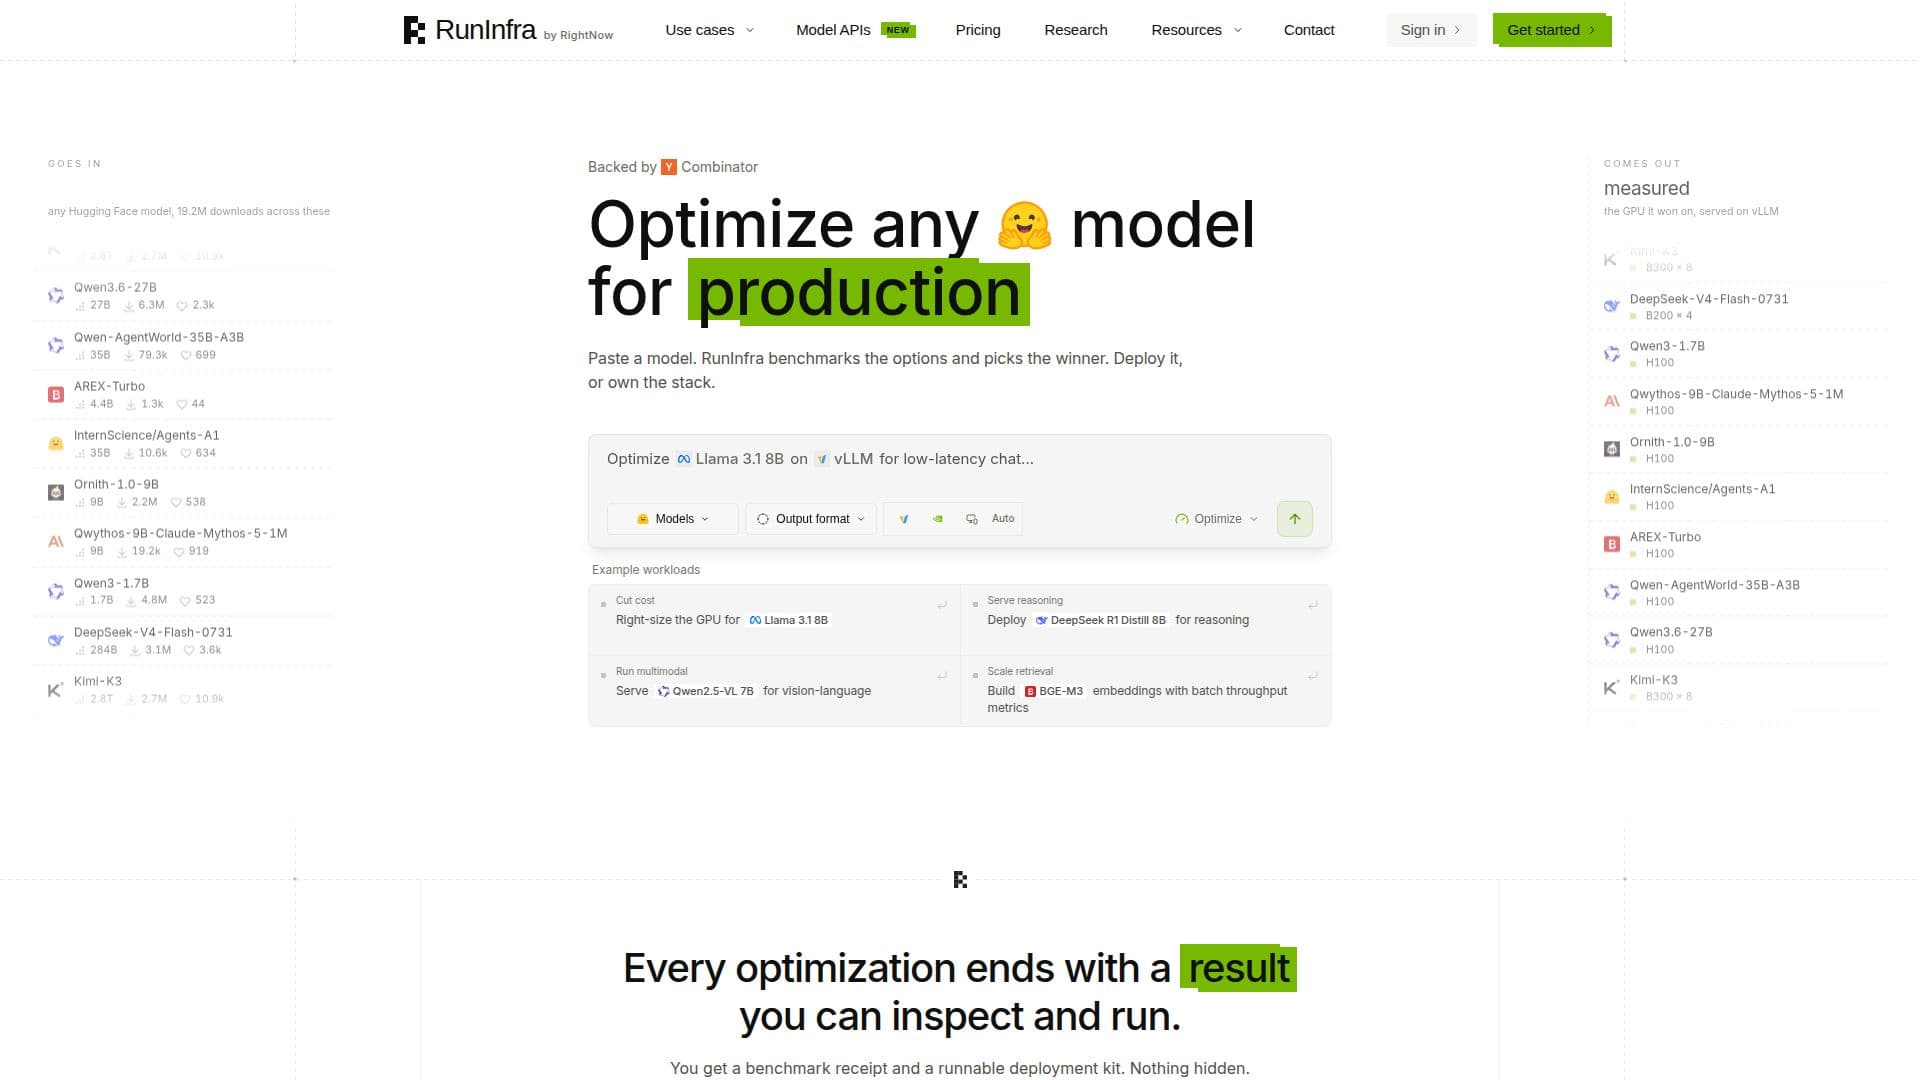
RunInfra 让开发者通过一个与 OpenAI 和 Anthropic 兼容的 API 调用开源 AI 模型,而无需自己托管和优化模型基础设施。
阅读更多
RunInfra 托管了一小部分开源模型,包括 Nemotron 3.5 Lightning 30B、Qwen3.8 27B 和 Ornith 1.5 35B,在撰写时,这些模型都在一个网关后面,可以通过将基础 URL 指向 RunInfra 的 API,使用 OpenAI 或 Anthropic 的 Python 和 Node SDK 进行访问。请求按输入和输出令牌计费,缓存输入令牌的价格较低。为了提高缓存命中率,RunInfra 使用会话感知路由:它将给定代理会话固定在同一个后端副本上,以便在重复调用中,已经加载的上下文保持温暖,而不是每次都落在随机副本上。缓存命中率按模型测量并发布,在最近的 24 小时窗口内,某些模型的命中率超过 95%,命中按缓存价格计费,尽管公司将缓存命中描述为尽力而为。
主要功能包括与 OpenAI 和 Anthropic 兼容的聊天完成 API;按模型定价,发布缓存命中率和输出速度基准;根据模型的工具调用、JSON 模式、流式传输和图像输入支持;一个将 RunInfra 托管模型连接到包括 Claude Code、Codex、OpenCode、Cline、Droid 和 Grok Build 的编码代理的 CLI;以及一个请求模型的选项,适用于尚未托管的模型。
模型使用按令牌计费,例如,托管模型的每百万输入令牌收费 0.05 美元,每百万输出令牌收费 0.15 美元,缓存输入按较低的费率单独计费,最低可达每百万缓存令牌 0.01 美元。编码代理计划的起价为每月 10 美元。
在安全性方面,RunInfra 表示其托管的模型 API 默认不存储提示(零数据保留),在传输中使用 TLS 加密数据,在静态时使用 AES-256 加密,提供具有角色和行级安全性的工作区,不会在客户提示或完成上进行训练,并持有 SOC 2 Type II 认证。
RunInfra 是为开发者和构建 AI 代理或编码代理工作流的团队而设计的,他们希望在不管理自己 GPU 基础设施的情况下进行开源模型推理;该公司是 RightNow 的一部分,获得了 Y Combinator 的支持。其托管模型库较小,研究时有三个模型,尽管存在请求模型的选项,适用于需要其他模型的团队。
- 类别MLOps 与模型部署
- 定价模式按量付费
- 部署托管和自托管
- 平台云端
RunInfra的核心功能
一个与 OpenAI 和 Anthropic SDK 兼容的 API 密钥
托管开源模型,包括 Nemotron、Qwen 和 Ornith
会话感知路由,保持重复代理调用在同一个温暖副本上
发布的按模型定价、缓存命中率和输出速度基准
根据模型支持工具调用、JSON 模式、流式传输和图像输入
与包括 Claude Code、Codex、OpenCode、Cline、Droid 和 Grok Build 的编码代理的 CLI 集成
默认不保留提示,持有 SOC 2 Type II 认证
具有角色和行级安全性的工作区
如何使用 RunInfra?
获取 API 密钥:在 RunInfra 上注册并生成网关 API 密钥
将您的 SDK 指向 RunInfra:在 OpenAI 或 Anthropic SDK 中将基础 URL 设置为 RunInfra 的端点
选择模型:根据能力和价格从托管模型库中选择
调用模型:使用您现有的 SDK 代码发送聊天完成请求
连接编码代理:安装 RunInfra CLI,将代理如 Claude Code 或 Cline 路由到 RunInfra 托管的模型
监控成本和缓存命中:检查发布的定价和每个模型的缓存命中率以管理支出
RunInfra的使用案例
- 开源模型 API 访问
- AI 代理推理
- 编码代理后端