

"Se o seu trabalho não se beneficia das ferramentas de IA atuais, isso é uma constatação, não uma falha", disse a Amazon aos seus engenheiros de software em um memorando noticiado pela CNBC. É uma frase incomum vinda de uma empresa que vende IA para outras empresas, e é fácil resumi-la numa manchete: a Amazon manda engenheiros usarem menos IA.
O memorando é mais cuidadoso do que essa manchete, e a discussão em torno dele importa mais do que o documento em si. Tokens agora são uma linha no orçamento de engenharia, e gestores em todo lugar estão sendo questionados sobre o que a Amazon acabou de responder em público: como você sabe que esse gasto está trazendo algum retorno? A seguir, o que o memorando diz e o que deixa de fora, quanto uma licença realmente custa em quatro grandes ferramentas e onde um limite ajuda ou atrapalha.
Tokenmaxxing é um problema de ranking
A CNBC define tokenmaxxing como desenvolvedores usando IA "o máximo possível, sem muita preocupação com o resultado". A palavra tem uma pequena história na Amazon. Segundo a CNBC, a empresa desativou um ranking interno no início do ano depois de descobrir que funcionários estavam fazendo tokenmaxxing para subir de posição. O relato do I-Programmer, que se apoia em reportagem do Financial Times, diz que o ranking se chamava Kirorank, funcionou por apenas algumas semanas e nunca foi oficialmente autorizado. As pessoas inventavam tarefas banais para agentes de IA executarem, e a Amazon pagava pelos tokens.
A Amazon não estava sozinha. A mesma reportagem diz que a Meta encerrou, no início do ano, um ranking criado por funcionários em que a equipe competia por títulos como Token Legend, ordenados pela quantidade de tokens queimados no Claude Code. Ela também lembra uma mensagem anterior vazada do vice-presidente sênior da Amazon, Dave Treadwell, pedindo à equipe que parasse de "usar IA só por usar IA".
Ninguém precisou ser desonesto para isso acontecer. Coloque um número numa tela, ranqueie as pessoas por ele, e o número sobe.
O que o memorando diz e o que não diz
Segundo a CNBC, o memorando circulou internamente antes de a Amazon publicá-lo em seu site. Ele revisa a forma como a Amazon descreve o trabalho dos engenheiros de desenvolvimento de software e de seus gestores. A conclusão central é sobre medição. Uso de tokens, taxa de adoção de ferramentas de IA e contagem de alterações de código ou revisões continuam sendo formas "profundamente falhas" de avaliar o uso de IA por uma equipe, diz o memorando, porque podem elevar custos e gerar complexidade demais.
Ele não chega a proibir os números. Eles devem ser lidos "com cuidado e bom senso" ao lado de outros dados, e a métrica preferida do memorando é dita com clareza: "Acreditamos que o melhor é medir, e ser medido, por resultados de longo prazo."
Um porta-voz da Amazon disse à CNBC que a empresa não instituiu limites de uso de tokens. Isso importa, porque "use menos IA" vai além do que foi noticiado. Nada na cobertura que lemos descreve uma cota, um orçamento por engenheiro ou um valor em dólares. A Amazon não disse quanto gasta, e nenhuma das reportagens soube dizer.
Marc Brooker, vice-presidente e engenheiro distinto da AWS, explicou a lógica à CNBC em duas partes. A empresa olha para coisas como velocidade de entrega de funcionalidades (quantos lançamentos, quantas mudanças bem-sucedidas em produção) e trata o gasto como investimento. O que ela não quer, disse ele, é "esforço desperdiçado" em problemas que não importam, e admitiu que às vezes é difícil saber quais são esses problemas, então continua havendo espaço para experimentação.
Lido assim, o memorando se parece mais com uma política de avaliação de desempenho do que de corte de custos. A frase que sublinharíamos é a citada no início. Um engenheiro que sabe explicar onde a IA ainda não ajuda está, nas palavras do memorando, "demonstrando o discernimento que esperamos". É uma empresa dizendo aos gestores para não punirem quem desliga uma ferramenta.
Por que uma empresa que vende IA seguraria o uso
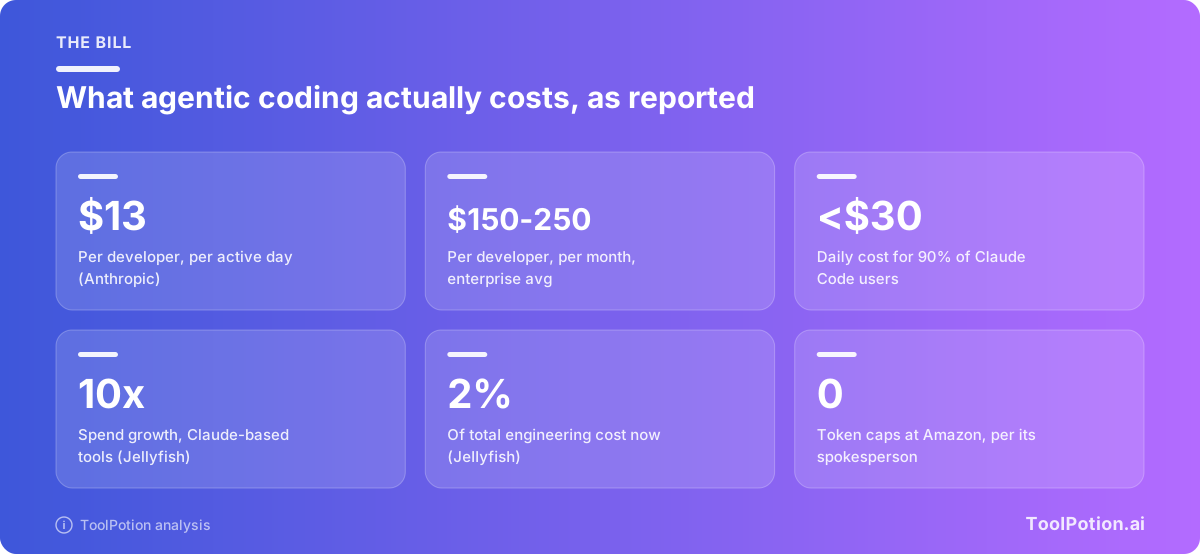
A resposta óbvia é custo, e os números crescem mais rápido que os orçamentos. A Jellyfish, que faz ferramentas para times de engenharia, publicou um relatório sobre ferramentas de código agênticas que o TechCrunch comentou. Entre os clientes da Jellyfish, o gasto com Claude Code e outras ferramentas baseadas em modelos da Anthropic cresceu 10x desde o início do ano e hoje equivale a cerca de 2% do custo total de engenharia. Dois por cento é pouco, mas o cientista-chefe da Jellyfish, Nicholas Arcolano, disse ao TechCrunch que "esse crescimento de 10x é um crescimento que a maioria dos CFOs não planejou".
A própria documentação da Anthropic estabelece um piso para o número individual. Em implantações corporativas, o custo médio do Claude Code fica em torno de US$ 13 por desenvolvedor por dia ativo e de US$ 150 a US$ 250 por desenvolvedor por mês, e 90% dos usuários ficam abaixo de US$ 30 por dia (documentação do Claude Code). É uma média dos próprios clientes do fornecedor, então trate o seu piloto como o número real.
Outras duas razões são inferência nossa, e nada na cobertura as menciona. Uma métrica baseada em alterações de código e revisões pode soterrar revisores com uma produção que ninguém pediu. E um engenheiro atrás de um número de uso tem pouco motivo para perguntar se a tarefa precisava mesmo de um modelo. Nem a cobertura do memorando nem as reportagens ao redor citam segurança como motivação, então não vamos fingir que foi.
As demissões voluntárias da Microsoft e um fornecedor vendendo o medidor
O memorando da Amazon saiu na mesma semana de outras notícias sobre empresas conciliando IA com as contas, e não são a mesma história. A Microsoft ofereceu programas de demissão voluntária a um grupo de cerca de 60.000 funcionários elegíveis, aproximadamente 27% de sua força de trabalho, enquanto equilibra uma cara expansão de infraestrutura de IA com eficiência de capital. A CNBC associa isso a infraestrutura e fluxo de caixa, não ao uso de tokens de ninguém. A mesma matéria diz que a Microsoft tenta cobrar os clientes conforme o quanto de IA eles realmente usam, que é o medidor virado ao contrário.
Depois há a empresa que mais tem a ganhar com você gastando mais. A Anthropic lançou ferramentas de relatório que permitem a um gestor ver o que um time produziu num intervalo de datas, quanto custou e onde os fluxos de trabalho falharam, além de orçamentos coletivos para que os times administrem o gasto com tokens. O TechCrunch chama isso de uma tentativa clara de provar retorno sobre o investimento. Pense o que quiser do motivo, o produto mostra o que os compradores passaram a exigir: custo por resultado, e não custo por licença.
Descubra quanto uma licença realmente custa
Comece com um grupo-piloto e uma linha de base, e faça isso antes de alguém escrever um limite. Todos os fornecedores migraram para cobrança por uso, então o preço de tabela de uma licença diz cada vez menos. Veja o que cada ferramenta mede, segundo as páginas dos próprios fornecedores.
| Ferramenta | O que é medido | Onde limitar |
|---|---|---|
| GitHub Copilot | Tokens, convertidos em créditos de IA a US$ 0,01 cada. O Business reúne 1.900 créditos por usuário por mês; o Enterprise, 3.900 | Orçamentos em dólares por usuário, centro de custo e organização |
| Cursor (Teams) | Pool semanal por licença paga para os modelos próprios do Cursor. Modelos de terceiros são cobrados de um saldo pré-pago compartilhado | Limite mensal do time, mais limites padrão e por membro |
| Claude Code | Tokens de API. Teams e Enterprise usam as franquias das licenças | Limites de gasto nas configurações de administração, ou limites de workspace no Console |
| Codex (ChatGPT) | Franquia compartilhada com o ChatGPT Work, depois créditos | Créditos que você compra e o painel de uso para acompanhar o ritmo |
Alguns detalhes que encontramos na documentação e que uma página de preços não conta. A política de uso pago do Copilot vem ativada por padrão no Business e no Enterprise, então o gasto além dos créditos do pool continua, a menos que um administrador a desative explicitamente (documentação do GitHub). As sugestões inline continuam ilimitadas mesmo com orçamento de US$ 0. A revisão de código do Copilot é precificada por nível de esforço: o GitHub estima de US$ 0,05 a US$ 1 para o Lite e de US$ 1,50 a US$ 25 para o Max, cerca de US$ 10 em média, com minutos do Actions à parte (modelos e preços do GitHub). São estimativas, e a documentação diz que o tamanho do pull request as altera.
Se você está comparando os próprios editores, Cursor vs GitHub Copilot vs Windsurf cobre isso. O plano Teams do Cursor vende licenças Premium, Super e Ultra a US$ 30, US$ 100 e US$ 200 por mês, cada uma com seu próprio pool semanal para os modelos do Cursor, que não é transferível entre colegas. Modelos de terceiros, Claude inclusive, ficam fora do pool: são cobrados de um saldo pré-pago compartilhado ao preço de tabela da API mais uma taxa do Cursor de US$ 0,25 por milhão de tokens (documentação do Cursor). O plano Enterprise do Claude custa US$ 20 por licença por mês, mais o uso cobrado pelas tarifas da API (preços do Claude). A página de preços do Codex deixa claro que os preços de tokens da API são separados do uso da assinatura e não devem ser usados para estimar as tarefas incluídas.
Direcione o trabalho de rotina para um modelo mais barato
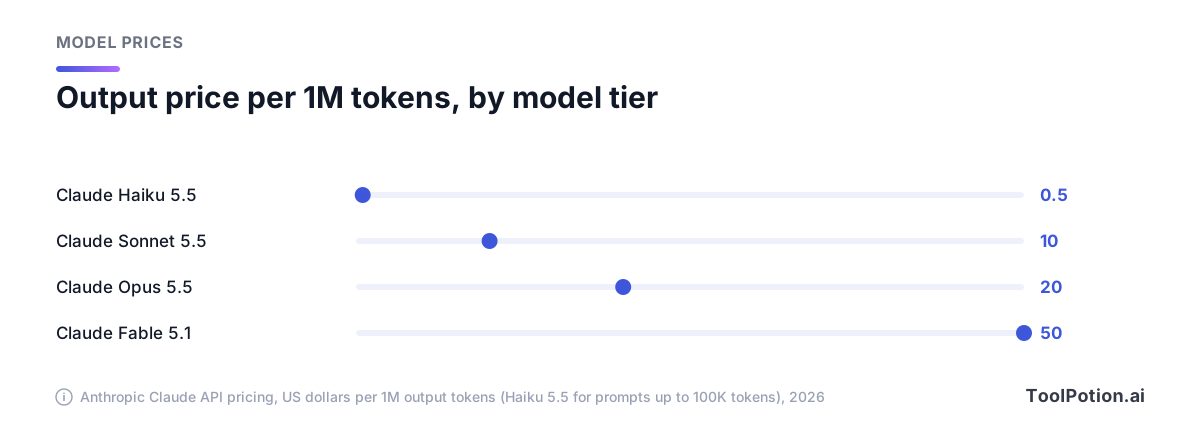
A maior alavanca na documentação não é um limite. É o modelo. Na tabela de preços da API da Anthropic, o Claude Haiku 5.5 cobra US$ 0,50 por milhão de tokens de saída para prompts de até 100.000 tokens (sobe para US$ 2,50 acima disso), o Sonnet 5.5 cobra US$ 10, o Opus 5.5 US$ 20 e o Fable 5.1 US$ 50. É uma diferença de 100x entre a base e o topo de uma mesma linha, e as tabelas do GitHub e do Cursor listam os mesmos preços de saída.
A orientação de custos da própria Anthropic concorda com a conta. O Sonnet "lida bem com a maioria das tarefas de código e custa menos que o Opus", diz ela, com o Opus reservado para decisões de arquitetura ou raciocínio em várias etapas, e model: haiku para tarefas simples de subagentes (documentação do Claude Code). Nossa análise mais completa sobre combinar níveis e tarefas está em qual nível de modelo de IA usar para cada tarefa, e os agentes de terminal são comparados em Claude Code vs Codex vs Gemini CLI.
Aqui está a economia a preços de tabela, com a parcela do trabalho que um modelo pequeno pode assumir como palpite seu. Os preços são os de tabela da Anthropic para prompts curtos.
Tokens de saída são só parte da conta, e a parcela do modelo pequeno é uma suposição que você terá de validar com suas próprias tarefas. Renomear variáveis e escrever esqueletos de teste provavelmente se qualificam. Um plano de migração de um serviço de pagamentos provavelmente não.
Limites, na ordem em que os definiríamos
- Ative o relatório de uso para um grupo-piloto e analise duas semanas de dados antes de escolher qualquer número.
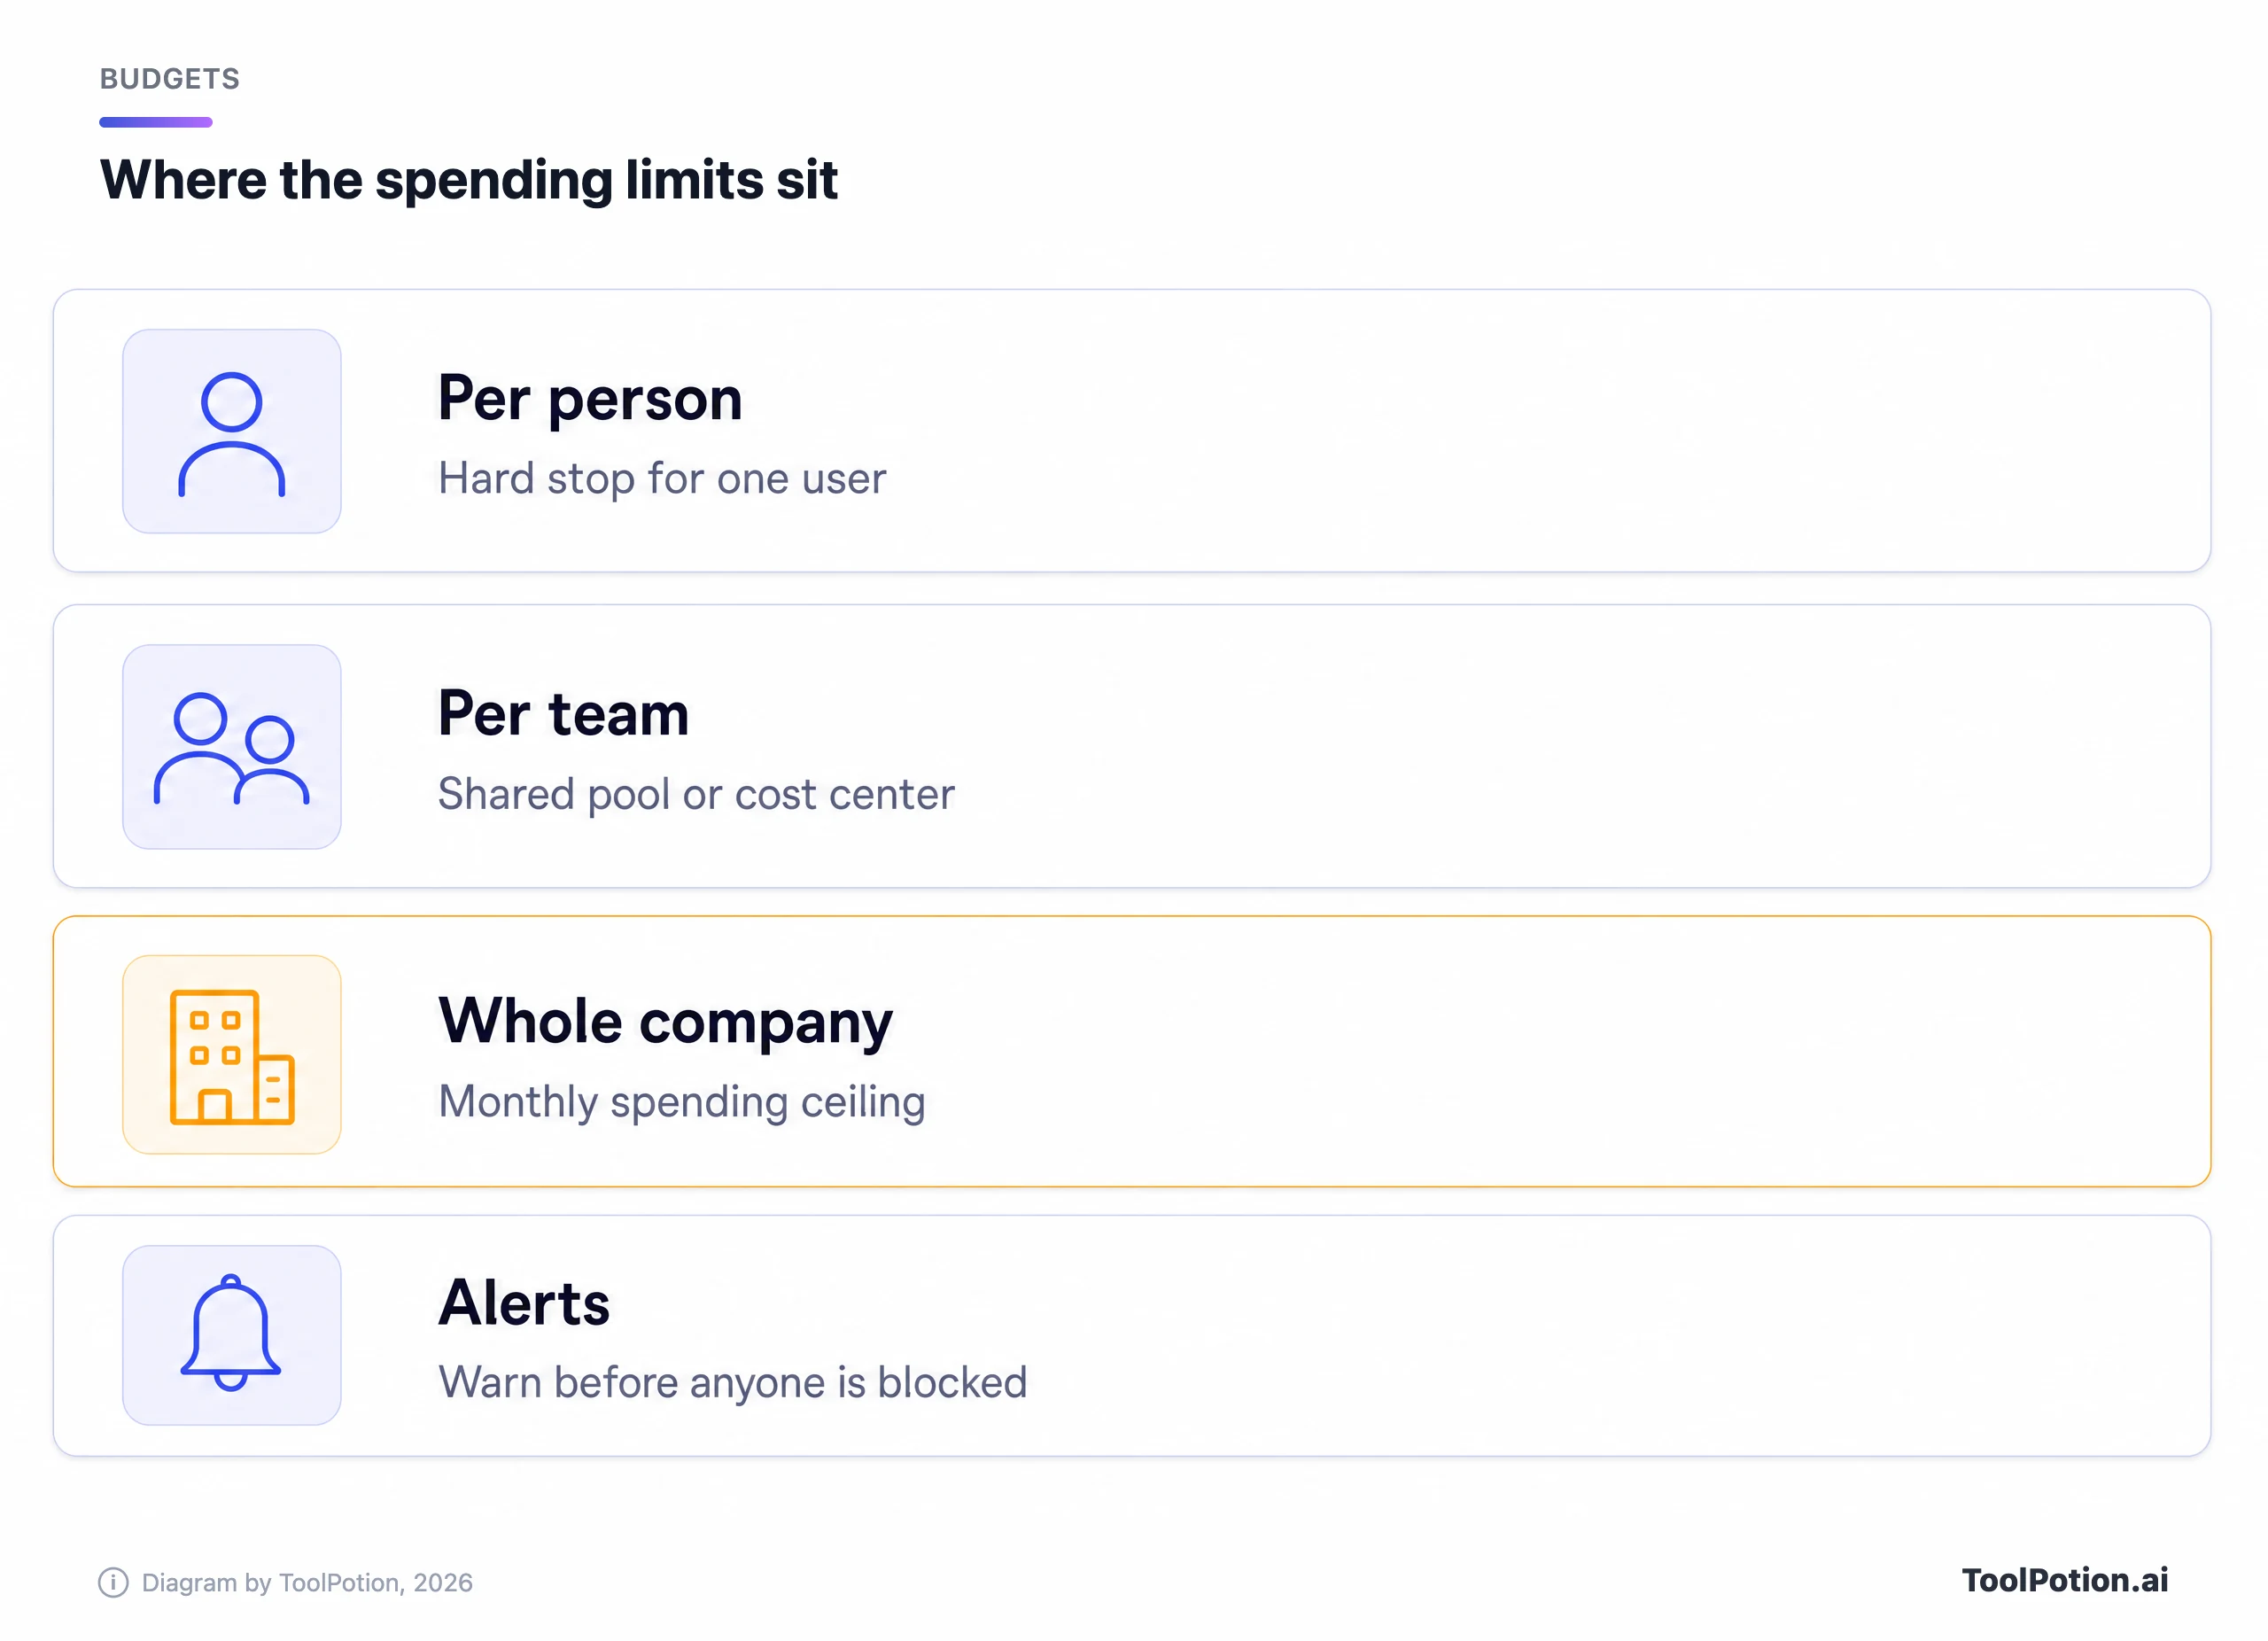
- Configure alertas primeiro. O GitHub pode enviar e-mail e exibir um banner em 75%, 90% e 100% de um orçamento (documentação do GitHub).
- Adicione um teto mensal para a empresa toda que você aguentaria se todas as licenças fossem usadas ao máximo, de modo que um loop descontrolado de agente custe um valor conhecido.
- Só então adicione limites por time ou por pessoa, e deixe-os flexíveis onde a ferramenta permitir. O orçamento por usuário do GitHub sempre bloqueia de vez, e a documentação avisa que orçamentos sobrepostos podem impedir as pessoas de usar uma ferramenta da qual dependem.
- Rebaixe um nível o modelo padrão para o trabalho de rotina e faça do modelo premium uma escolha deliberada.
A documentação do Claude Code também traz pontos de partida de rate limit por usuário conforme o tamanho do time, por exemplo de 15.000 a 20.000 tokens por minuto por usuário para 100 a 500 usuários. São limitadores de vazão, não orçamentos, e a documentação os chama de recomendações a ajustar.
Quando racionar é inteligente e quando é falsa economia
Racionaríamos o desperdício e nunca as tentativas. Um limite que faz o desenvolvedor pensar duas vezes antes de colar um repositório inteiro no modelo de topo está cumprindo seu papel. Um limite que faz o mesmo desenvolvedor pular a execução de testes gerados por IA, ou evitar o agente no refactor difícil, onde ele mais compensa, custa mais do que economiza.
Faça as contas. Se as ferramentas agênticas equivalem a cerca de 2% do custo de engenharia, como a Jellyfish relata, cortar a conta pela metade economiza 1% do custo de engenharia. Um engenheiro que fique 1% mais lento devolve tudo isso. Racionar só compensa quando elimina gasto que não produziu nada, que é exatamente o argumento da Amazon sobre esforço desperdiçado.
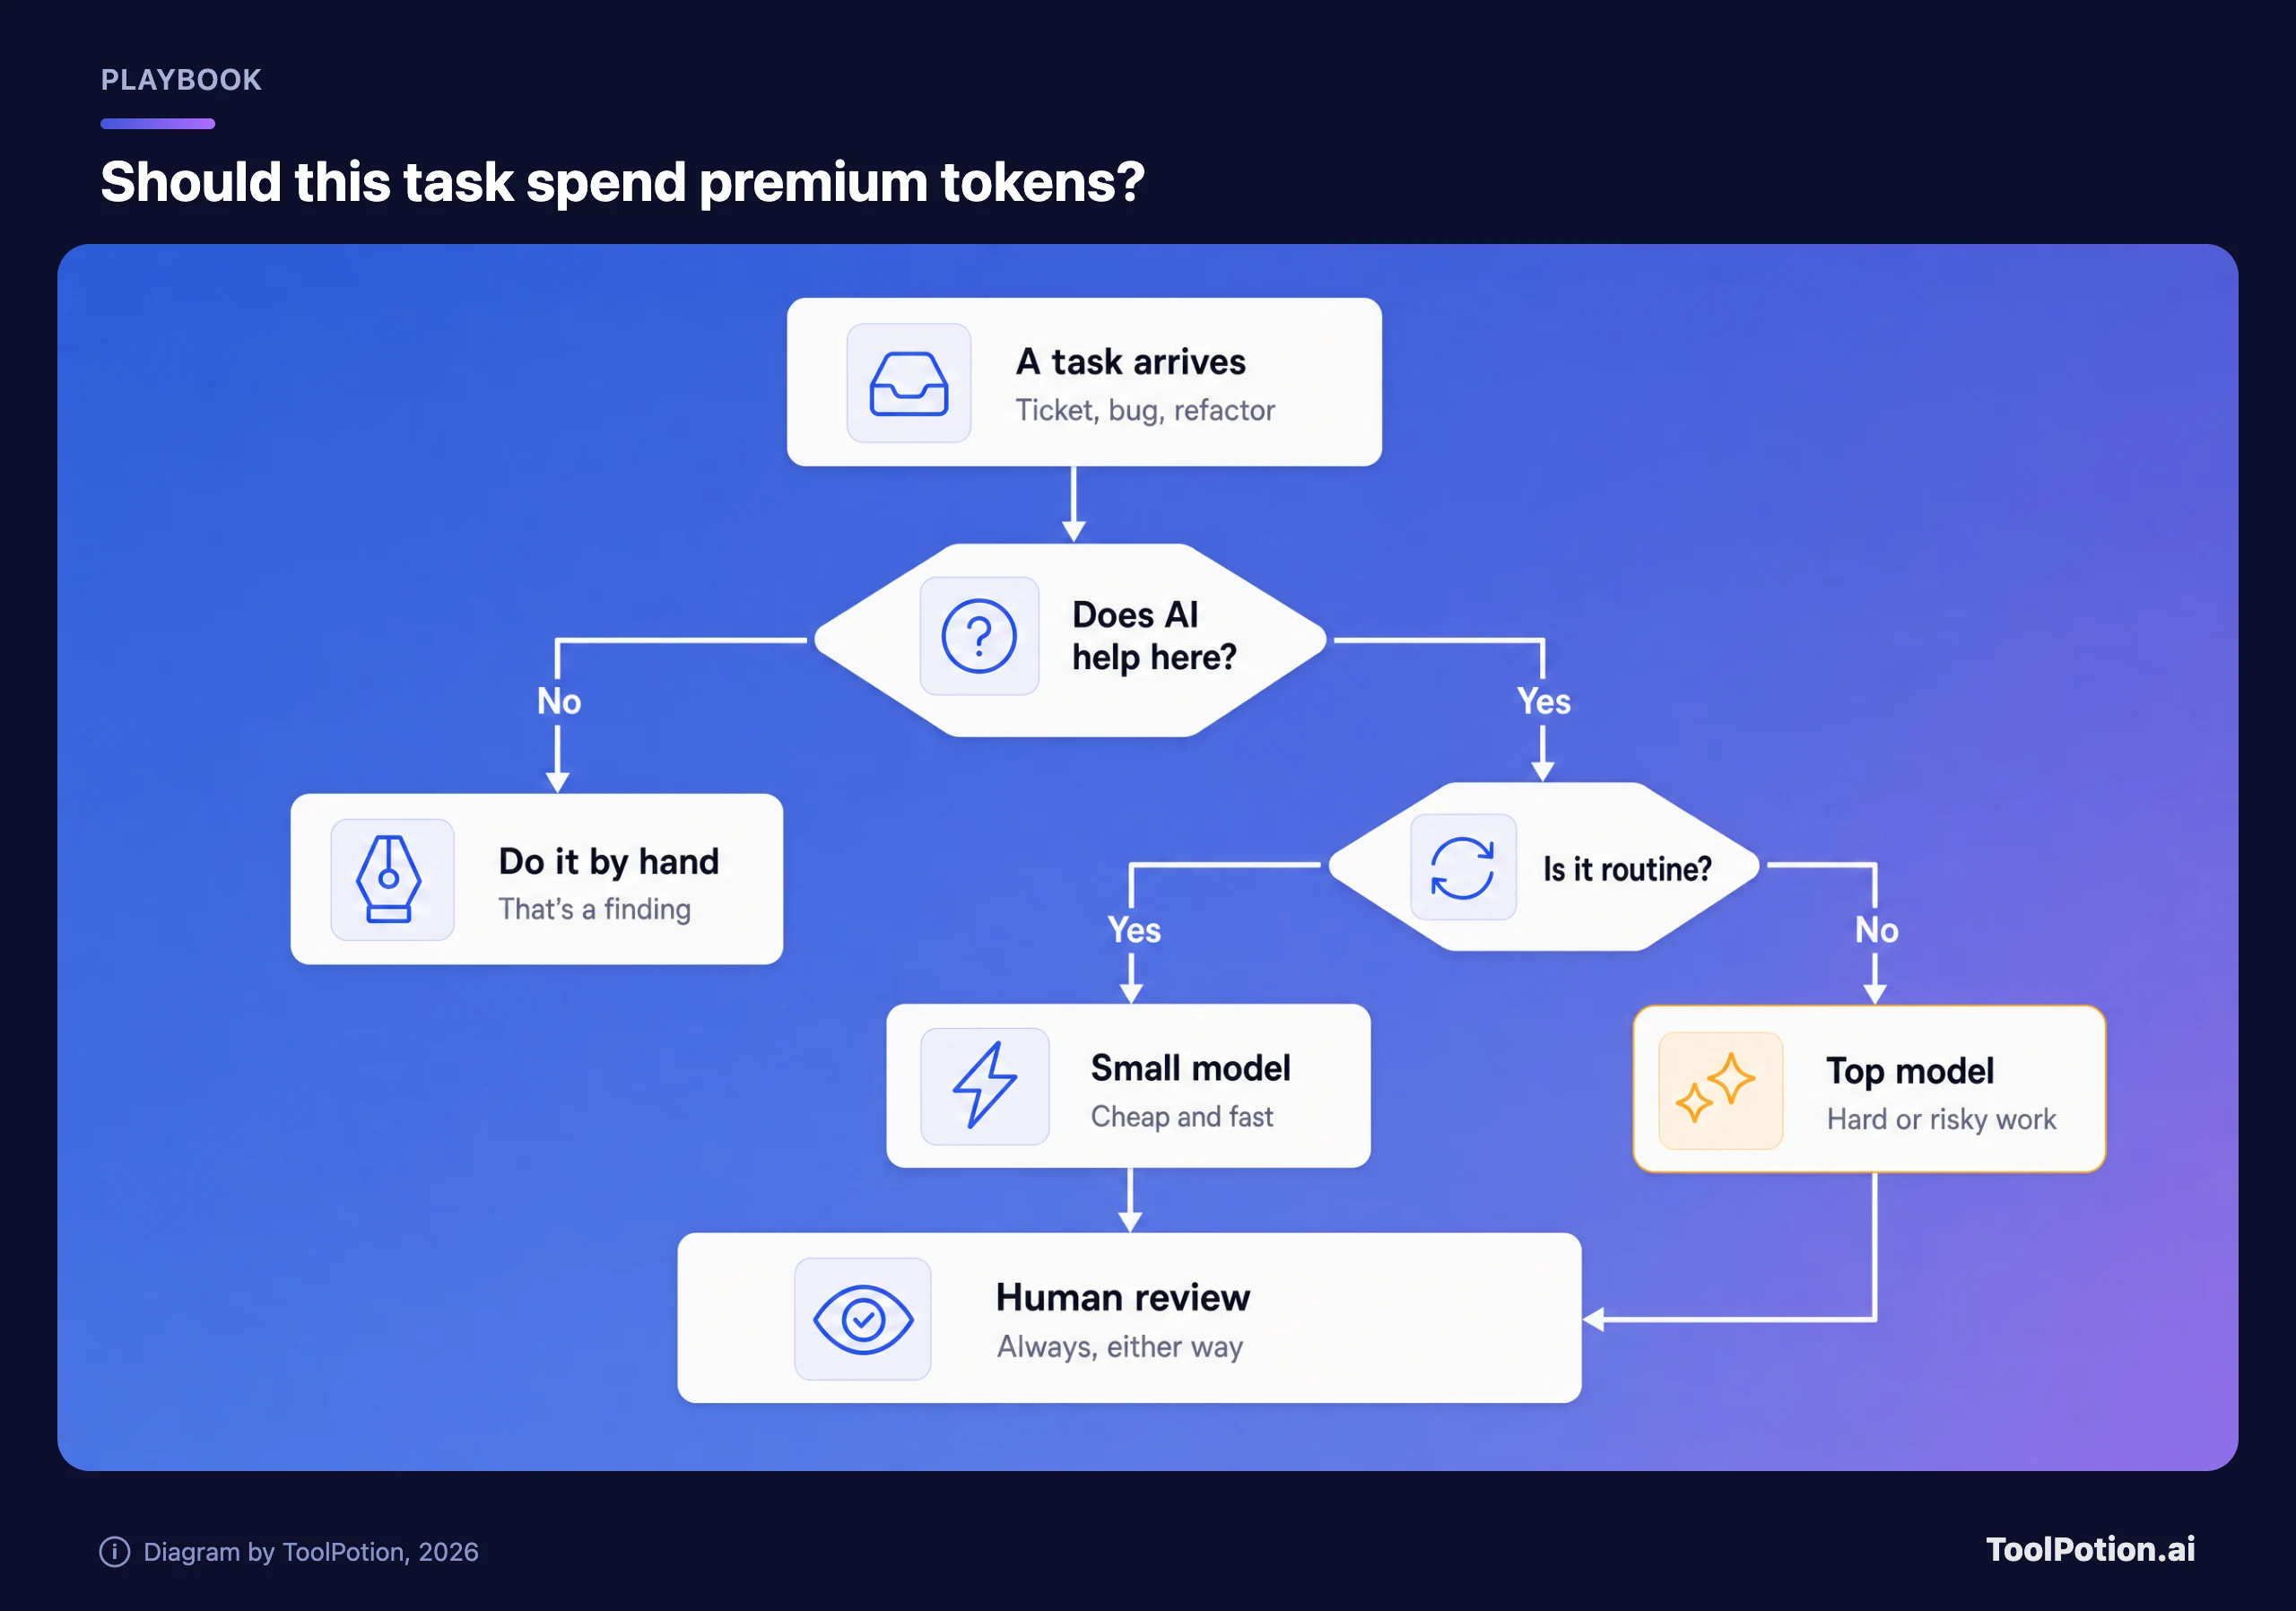
Racionar é inteligente para automação em segundo plano que ninguém lê, para o modelo de topo em tarefas de rotina e para rankings por pessoa. É falsa economia em revisão de código, testes e onboarding. Se a etapa de revisão por IA é o que pega o merge ruim, estrangulá-la é apostar contra a sua própria rede de proteção, e nosso guia de ferramentas de revisão de código com IA e o ranking do ToolRank para revisão e testes mostram quantas alternativas existem antes de você cortar qualquer coisa.
O que não cortaríamos
A revisão humana permanece, seja qual for o modelo que escreveu o código. O memorando da Amazon alerta contra medir a contagem de revisões, mas não sugere pular revisões. O treinamento também permanece, já que quem sabe quando recorrer ao modelo barato é quem aprendeu para que serve cada modelo. E a experimentação permanece, porque o próprio Brooker admite que ninguém consegue dizer de antemão quais problemas importam.
Acompanhe resultados como o memorando faz: lançamentos, mudanças bem-sucedidas em produção, tempo entre a solicitação e o merge. Tokens brutos pertencem à coluna de custo, e jamais a uma avaliação de desempenho. Se você ainda não definiu por escrito o que seu time pode e não pode enviar a essas ferramentas, nosso modelo de política de uso de IA é um bom começo, e o guia sobre modelos de preço e a auditoria da stack cobrem o lado das assinaturas.
Ler as páginas de preços do GitHub Copilot, do Cursor, do Claude Code e do Codex nos deixa com uma regra: o preço da licença é só a taxa de entrada. Puxe um mês recente de uso por pessoa da ferramenta que você usa, ordene e olhe as cinco primeiras linhas. Se forem seus melhores engenheiros, deixe-os em paz. Se for um único script em loop, você achou o seu limite.