

O GitHub afirma que, no Artificial Analysis Coding Agent Index, o Copilot Fusion Max "scored 60, within two points of Claude Code with Opus 5.5 Max" (changelog do GitHub). A manchete do The New Stack transformou isso em um sistema que "beats Claude Code for half the API cost" (The New Stack). São frases diferentes, e é na distância entre elas que um time deve concentrar a análise.
O Fusion está disponível para todos no GitHub Copilot como uma nova opção no seletor de modelos. Você não escolhe um modelo. Escolhe um nível de esforço, e o Copilot decide quais modelos rodam, em que ordem, para cada prompt. É uma boa ideia com uma base de evidências fina, e nós a trataríamos primeiro como um recurso de controle de custo e só depois como uma promessa de qualidade.
Sessenta não é sessenta e dois
Releia o texto do próprio GitHub. O Fusion Max chegou a dois pontos do Claude Code com Opus 5.5 Max, por cerca de metade do custo médio de API por tarefa, cerca de metade dos tokens e cerca de 40% menos tempo (changelog). É um resultado respeitável e um argumento de venda justo. Mas não é uma vitória, e o próprio corpo do texto do New Stack diz "comparable" sob uma manchete que diz "beats". O GitHub repetiu a alegação no seu resumo do Universe, em que "metade do custo" é a versão que se espalha.
A Artificial Analysis publica o índice que o GitHub cita. Ele combina três benchmarks, FrontierCode, Terminal-Bench 4.0 e SWE-Atlas-QnA-AA, com pesos iguais (Artificial Analysis). A visualização padrão da página mostra o Claude Code com Opus 5.5 Max em 62 e nenhuma entrada do Fusion. Ao ativar o toggle "Router models", o GitHub Copilot - Copilot Fusion (Max) aparece com 60, então o número é real e está onde o GitHub disse. O mesmo toggle mostra o Devin Fusion CLI, da Cognition, que combina Opus 5.5 Max com GPT-6 Luna e empata com o Claude Code em 62. Isso indica que os roteadores como classe estão alcançando os demais, não que o do GitHub seja o que se deve bater. Não comparamos as colunas de custo da página com o número de "metade do custo" do GitHub, então essa parte continua sendo palavra do GitHub.
Três caminhos atrás de uma única opção de menu
A documentação descreve o Fusion como "an intelligent runtime model router and orchestrator" (GitHub Docs). Para cada prompt, ele escolhe um de três padrões de execução, e prompts diferentes na mesma sessão podem seguir caminhos diferentes.
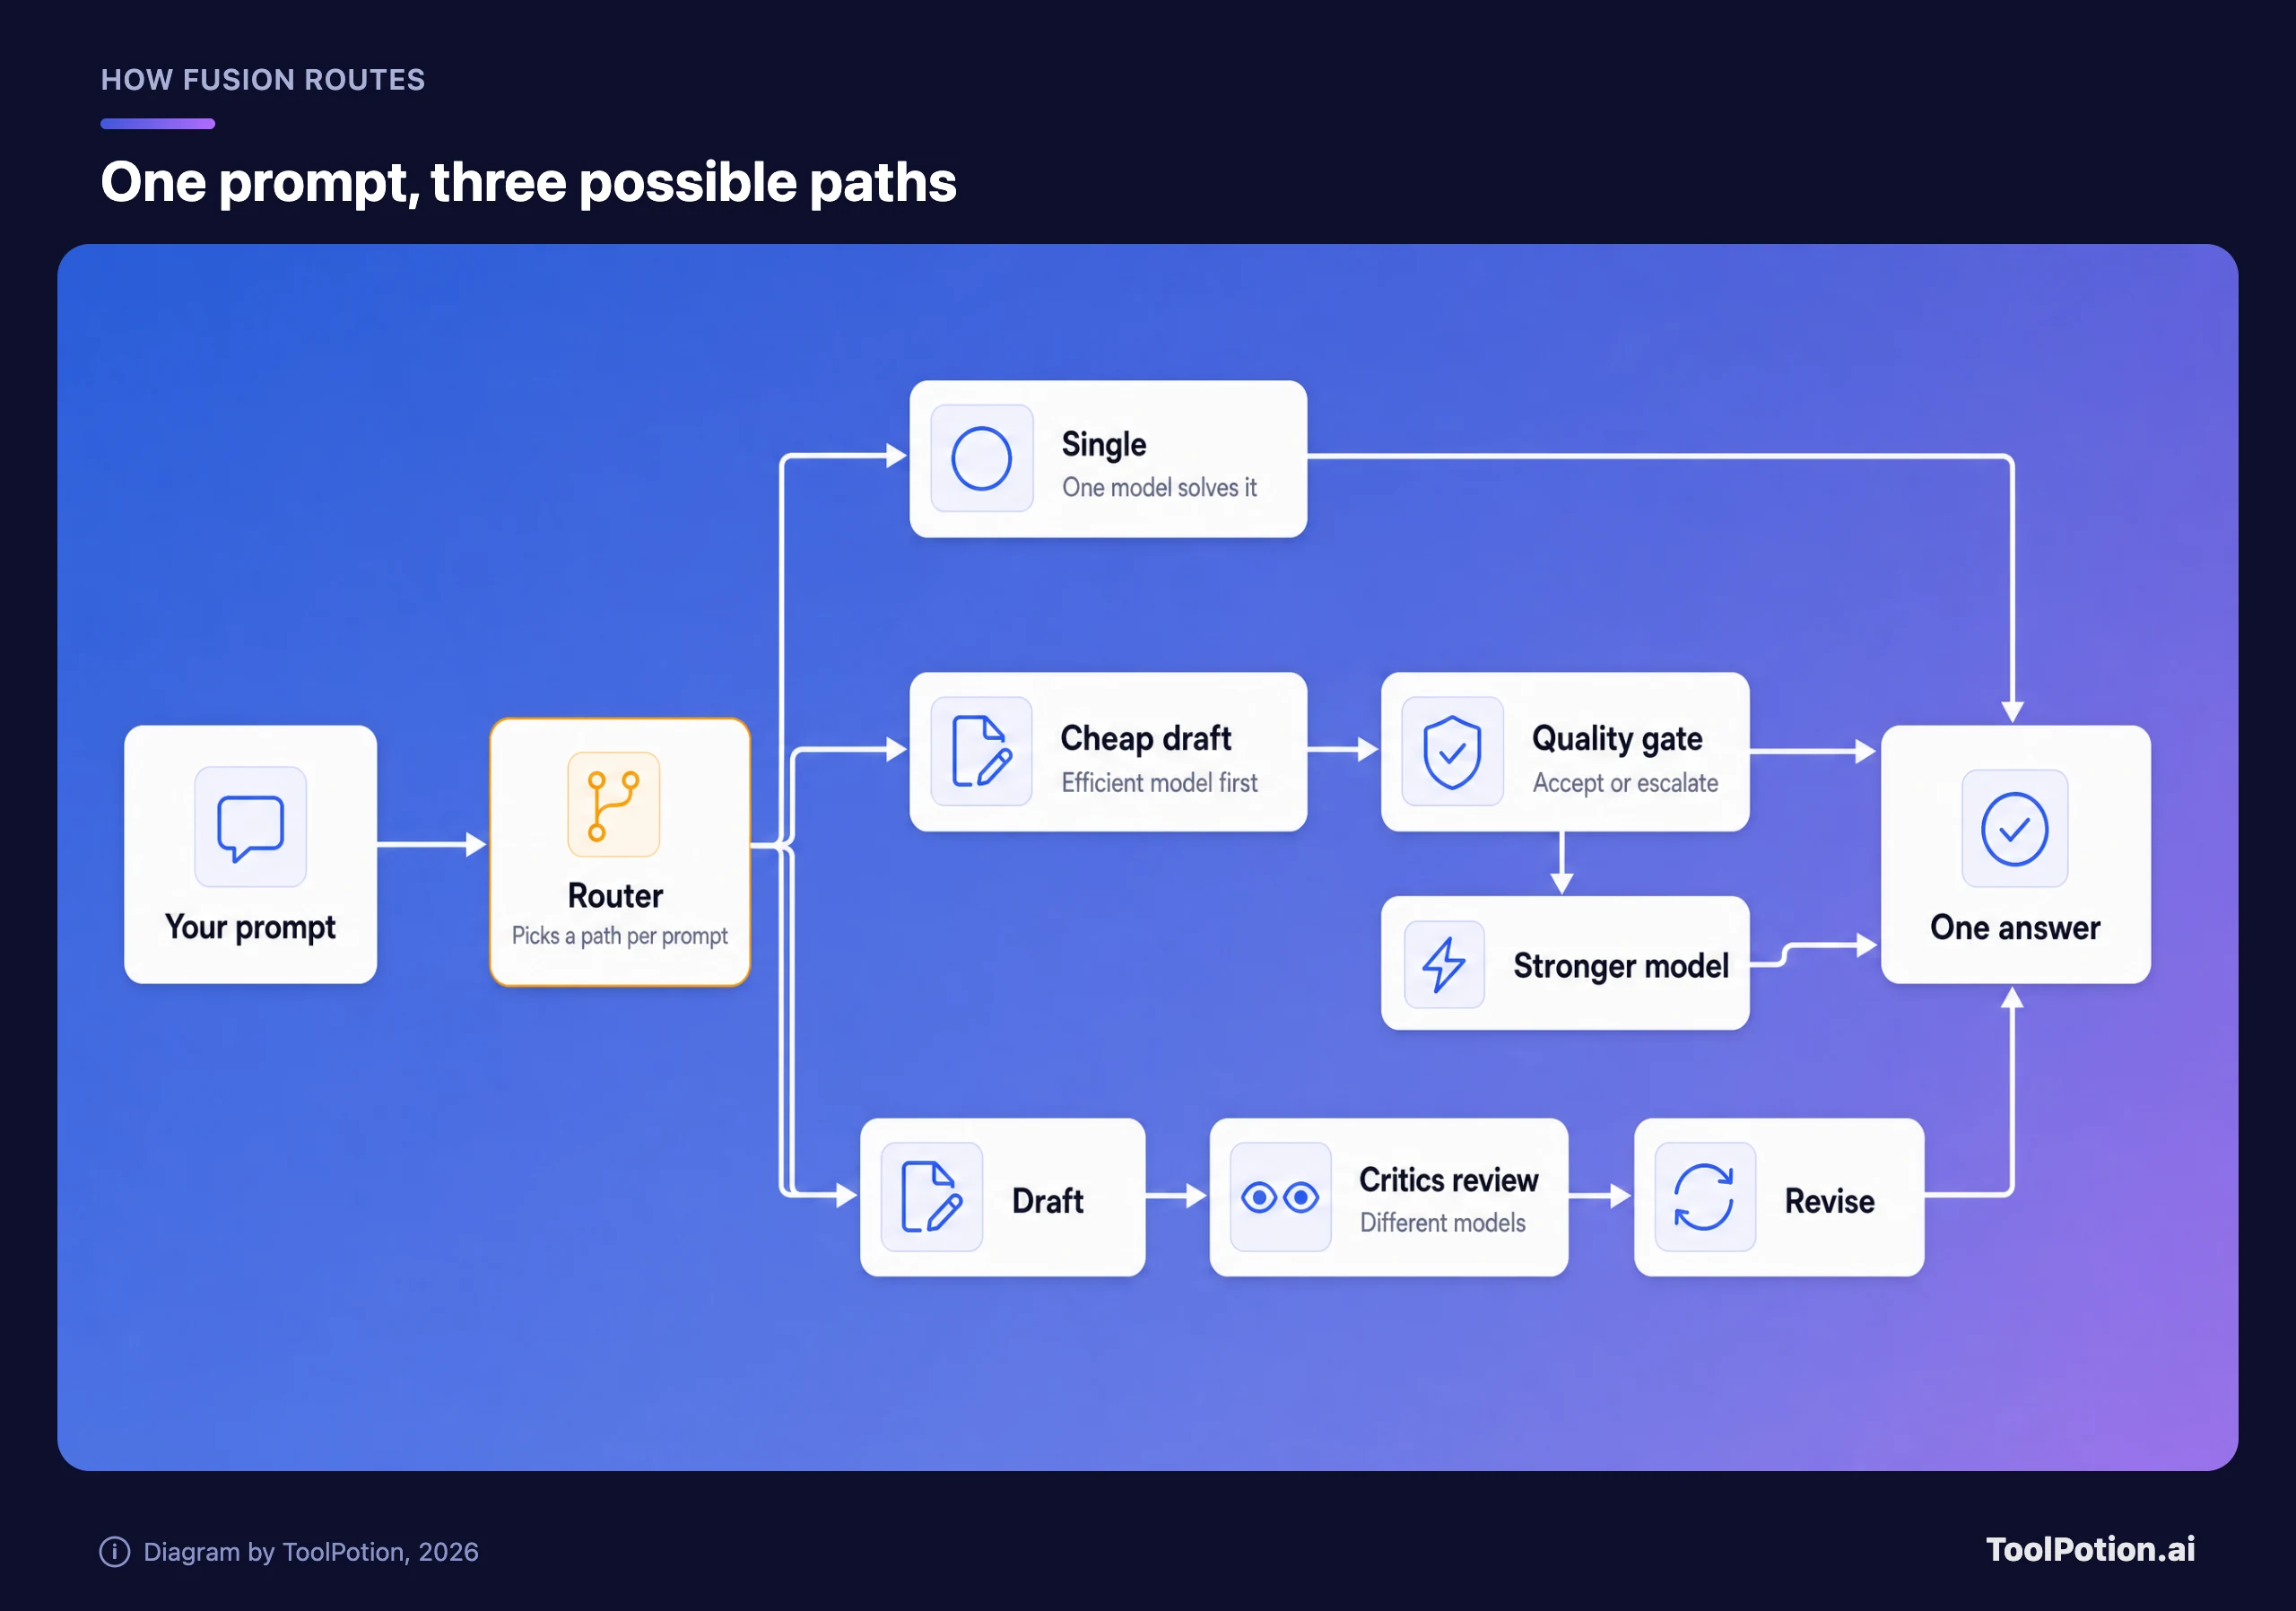
Single é um modelo respondendo diretamente. Cascade deixa um modelo eficiente fazer o rascunho, e então um juiz decide se aceita o rascunho ou escala para um modelo mais forte. Critique faz um modelo escrever o rascunho enquanto outros modelos o revisam, e o autor do rascunho o refaz. Os níveis de esforço definem o quão agressivo é o roteamento: Standard para o trabalho do dia a dia, High para tarefas substanciais, Max para o raciocínio mais difícil.
Um detalhe mudou entre o preview e o lançamento. O post anterior do GitHub sobre o research preview descrevia "an independent read-only critic from a different model family" (blog do GitHub). O changelog do lançamento diz "another model reviews it", enquanto a documentação diz que vários modelos fazem a crítica em paralelo e o feedback é agregado. Nossa leitura é que a etapa de crítica passou de um revisor para vários, mas o GitHub não diz isso, e o changelog não sinaliza a diferença.
Todos os planos têm acesso, e você paga por modelo
O changelog diz que o Fusion está disponível em todos os planos do Copilot no VS Code, no app do Copilot, no Copilot CLI e nas IDEs JetBrains, com mais clientes a caminho. Você é cobrado por cada modelo que ele usa, pela tarifa padrão daquele modelo, sem cobrança separada pelo Fusion. Os planos pagos recebem 30% de desconto nos custos dos modelos por tempo limitado, e a documentação situa o fim desse desconto ainda neste ano (docs).
Duas pontas soltas. A documentação do Fusion diz que ele está "available with all GitHub Copilot plans". A página de planos diz que, nos planos Free e Student, o acesso aos modelos é apenas por seleção automática de modelo. O GitHub não concilia as duas informações. A tabela de níveis de esforço por plano na documentação marca a disponibilidade com ícones que apareceram como células vazias quando a lemos, então não sabemos dizer quais níveis os assentos Free e Student recebem. Confira no seu próprio seletor. E, como High e Max podem chamar vários modelos, a própria documentação avisa que uma tarefa pode consumir mais créditos de IA do que no Standard. Metade do custo por tarefa é uma afirmação sobre o Max contra o Claude Code, não uma promessa sobre o seu saldo de créditos.
O benchmark é o GitHub avaliando o GitHub
O post anterior sobre o HydraFusion é mais franco que o do lançamento. Os testes rodaram no mesmo nível médio de raciocínio para todos os modelos, usaram custos estimados com premissas de preço compartilhadas e compararam com o Opus 5 e o GPT-5.6 Sol. O GitHub também diz que ajustou a política de roteamento por beam search nos mesmos três benchmarks que reportou (blog do GitHub).
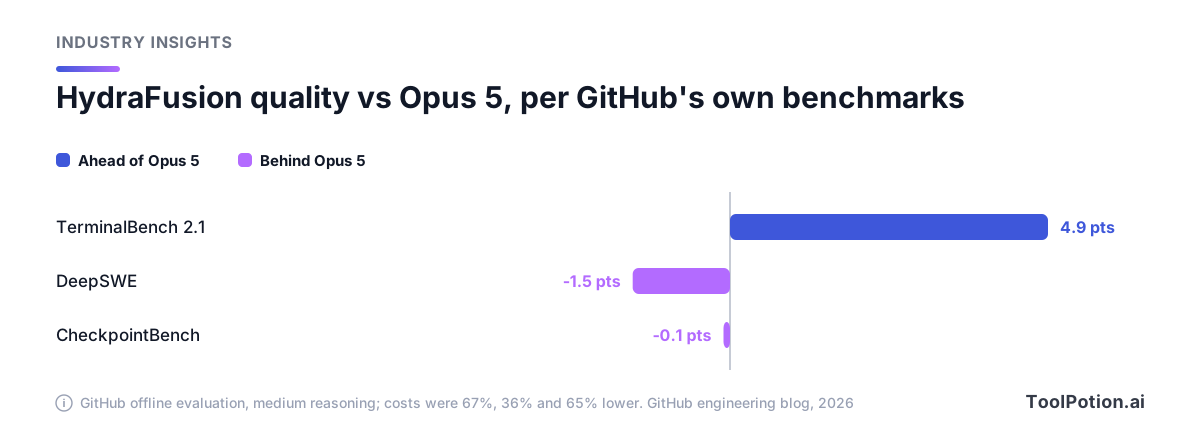
Olhe o formato. Um benchmark mostra ganho de 4,9 pontos. Os outros dois mostram perdas pequenas, com custos de 36% a 67% menores. É uma história de custo com a qualidade mais ou menos mantida, que é também o que o texto do lançamento acabou dizendo.
Desenvolvedores no Hacker News atacaram a baseline. Um comentarista escreveu que "Opus 5 (in practice) is not a good baseline to compare against" (HN). Outro duvidou do resultado, dizendo "It doesn't take much to beat the frontier in single benchmarks if one puts extra software between the model and the harness" (HN). Um usuário do Copilot CLI na mesma discussão disse que o modo auto "only changes models at the start of a session or after compaction" (HN), e outro chamou a seleção automática de "basically unusable" para ele (HN). São comentaristas isolados, não estudos. Mas mostram onde está o ceticismo.
Há também uma diferença de cobrança a ter em mente. O índice e a comparação do GitHub usam custo de API por token. Um desenvolvedor com uma assinatura fixa do Claude Code nunca vê esse número, então "metade do custo" tem outro peso para um usuário solo do que para um time que mede o gasto com API. A própria Artificial Analysis observa que muitos usuários acessam essas ferramentas por assinaturas, e não por pagamento por token. A conclusão é inferência nossa, não uma afirmação do GitHub, mas ela muda a quem a manchete se dirige.
A única voz de cliente que o GitHub apresenta é a de Hari Pokhrel, da AT&T, citada no próprio changelog do GitHub: "Previously, developers would often choose a more powerful model for a complex task and forget to switch back for everyday activities." Esse é o argumento honesto a favor do Fusion: ele evita que as pessoas deixem um modelo caro ligado em tarefas de rotina.
Sua política decide quem lê o seu diff
Esta é a parte que leríamos antes do benchmark. O Fusion só usa modelos habilitados nas políticas da sua empresa e da sua organização. Admins podem desabilitar modelos individuais para o Fusion sem desabilitá-los em todo lugar, e modelos excluídos por políticas de residência de dados ou FedRAMP ficam de fora (docs).
A revisão por um segundo modelo é a aposta de design, e o post do preview diz que esse revisor vem de uma família de modelos diferente. Se isso significar outro fornecedor, ele vê o seu diff, e essa é uma decisão de tratamento de dados que alguém do seu time deve tomar de forma deliberada. Depois de uma resposta, você pode passar o mouse sobre o rótulo de esforço para ver quais modelos rodaram.
A seção de limitações também importa. Se o Fusion descarta um rascunho, as edições de arquivo que esse rascunho já fez não são desfeitas automaticamente, então revise o diff antes de fazer commit. O Fusion também não tem janela de contexto própria: o valor exibido é o menor entre os modelos que ele usa.
Onde nós o colocaríamos em um teste de time
Rodaríamos o Fusion Standard como padrão para um time de Copilot e pularíamos o Max como padrão. O 60 no índice independente é respeitável, mas o Max é o nível que chama mais modelos e gasta mais créditos. O Standard é onde mora a história da AT&T e onde o roteamento mais economiza. Para times que já usam o Claude Code ou o Codex, a questão do lock-in corre no sentido oposto: essas ferramentas estão presas aos modelos de um único fornecedor, enquanto o Fusion é um roteador que o GitHub controla e pode reorganizar. Nenhuma das opções está livre de dependência.
Nossas comparações existentes cobrem as ferramentas em si: agentes de código para terminal, Cursor contra Copilot e Windsurf, como combinar níveis de modelo com tarefas e a lista mais ampla de ferramentas de código. O Fusion muda a coluna de custo nelas, não a ferramenta que você escolheria. Usuários do Cursor ainda não têm um veredito equivalente, e o ranking de assistentes de código do ToolRank é o lugar para ver como o setor está ordenado hoje.
O teste que resolve a questão é barato. Pegue dez tickets reais, rode no Fusion Standard e na sua configuração atual, e conte as mudanças aceitas e os créditos gastos. O desconto do GitHub acaba ainda neste ano, então meça antes disso. Depois, confira de novo a visualização Router models na Artificial Analysis, já que as entradas de roteadores ali são as que provavelmente vão mudar.