

Para a maioria dos desenvolvedores em 2026, a escolha real é entre o Claude Code e o Codex, e no benchmark público mais difícil para trabalho em terminal os dois estão empatados dentro da margem de erro. O Gemini CLI, o terceiro nome em toda comparação do ano passado, saiu de cena para usuários gratuitos e individuais: o Google o substituiu no início deste ano por uma ferramenta de código fechado chamada Antigravity CLI.
Isso muda a decisão. Os dois primeiros alternam a liderança a cada lançamento, então a qualidade do modelo é um critério de desempate fraco. O que separa essas ferramentas hoje é o que o agente pode fazer na sua máquina sem pedir permissão, como você paga por ele e se um líder de equipe consegue controlar as duas coisas. O Codex traz os padrões mais seguros e um cliente open source. O Claude Code tem o kit mais completo para quem quer criar scripts e estender a ferramenta. O CLI do GitHub Copilot serve a organizações que já vivem no GitHub e querem modelos de vários laboratórios numa só fatura, e o OpenCode é a escolha para quem quer open source e o modelo que preferir.
Os preços e recursos abaixo vêm da documentação e das páginas de preços dos fornecedores, e cada número de benchmark cita sua fonte.
O que mudou nos agentes de terminal este ano
Quatro mudanças importam se você olhou esta categoria pela última vez há um ano.
O Google aposentou o Gemini CLI para a maioria das pessoas. No Google I/O, a empresa anunciou que o Gemini CLI deixaria de atender requisições de usuários gratuitos e de assinantes do Google AI Pro e Ultra, com as extensões de IDE desligadas no mesmo dia (Google Developers Blog). O substituto, o Antigravity CLI, é escrito em Go e roda sobre o mesmo núcleo de agente do novo app desktop Antigravity 2.0, do Google. Organizações no Gemini Code Assist Standard ou Enterprise, e desenvolvedores que pagam via chaves da API Gemini, continuam com o Gemini CLI.
O GitHub lançou o Copilot CLI em disponibilidade geral e depois migrou todos os planos do Copilot para créditos de IA baseados em uso, de modo que as sessões no terminal agora consomem uma franquia medida, com cada crédito valendo US$ 0,01 (GitHub Docs).
A Anthropic mudou o que acontece quando você abre uma sessão. A partir do Claude Code v2.1.283, as sessões interativas no terminal começam em modo auto, em que um segundo modelo, chamado pela Anthropic de classifier, revisa as ações em vez de pedir sua confirmação a cada uma (documentação do Claude Code).
A OpenAI atualizou o Codex CLI esta semana com controle por voz, uma visualização /agents para acompanhar tarefas paralelas e ambientes reutilizáveis na nuvem que uma equipe pode compartilhar com configurações e permissões aprovadas (TechCrunch). Enquanto isso, o Aider, opção open source veterana, não lançou nada desde um patch menor no início do ano, e sua última versão com novos recursos é do ano passado (PyPI).
O loop que todo agente de terminal executa
Tirando a marca, todas essas ferramentas fazem o mesmo trabalho. Você descreve uma tarefa em linguagem natural. O agente lê os arquivos relevantes, monta um plano, edita quantos arquivos forem necessários, roda seu build e seus testes e repete o ciclo a cada falha até conseguir mostrar um diff.
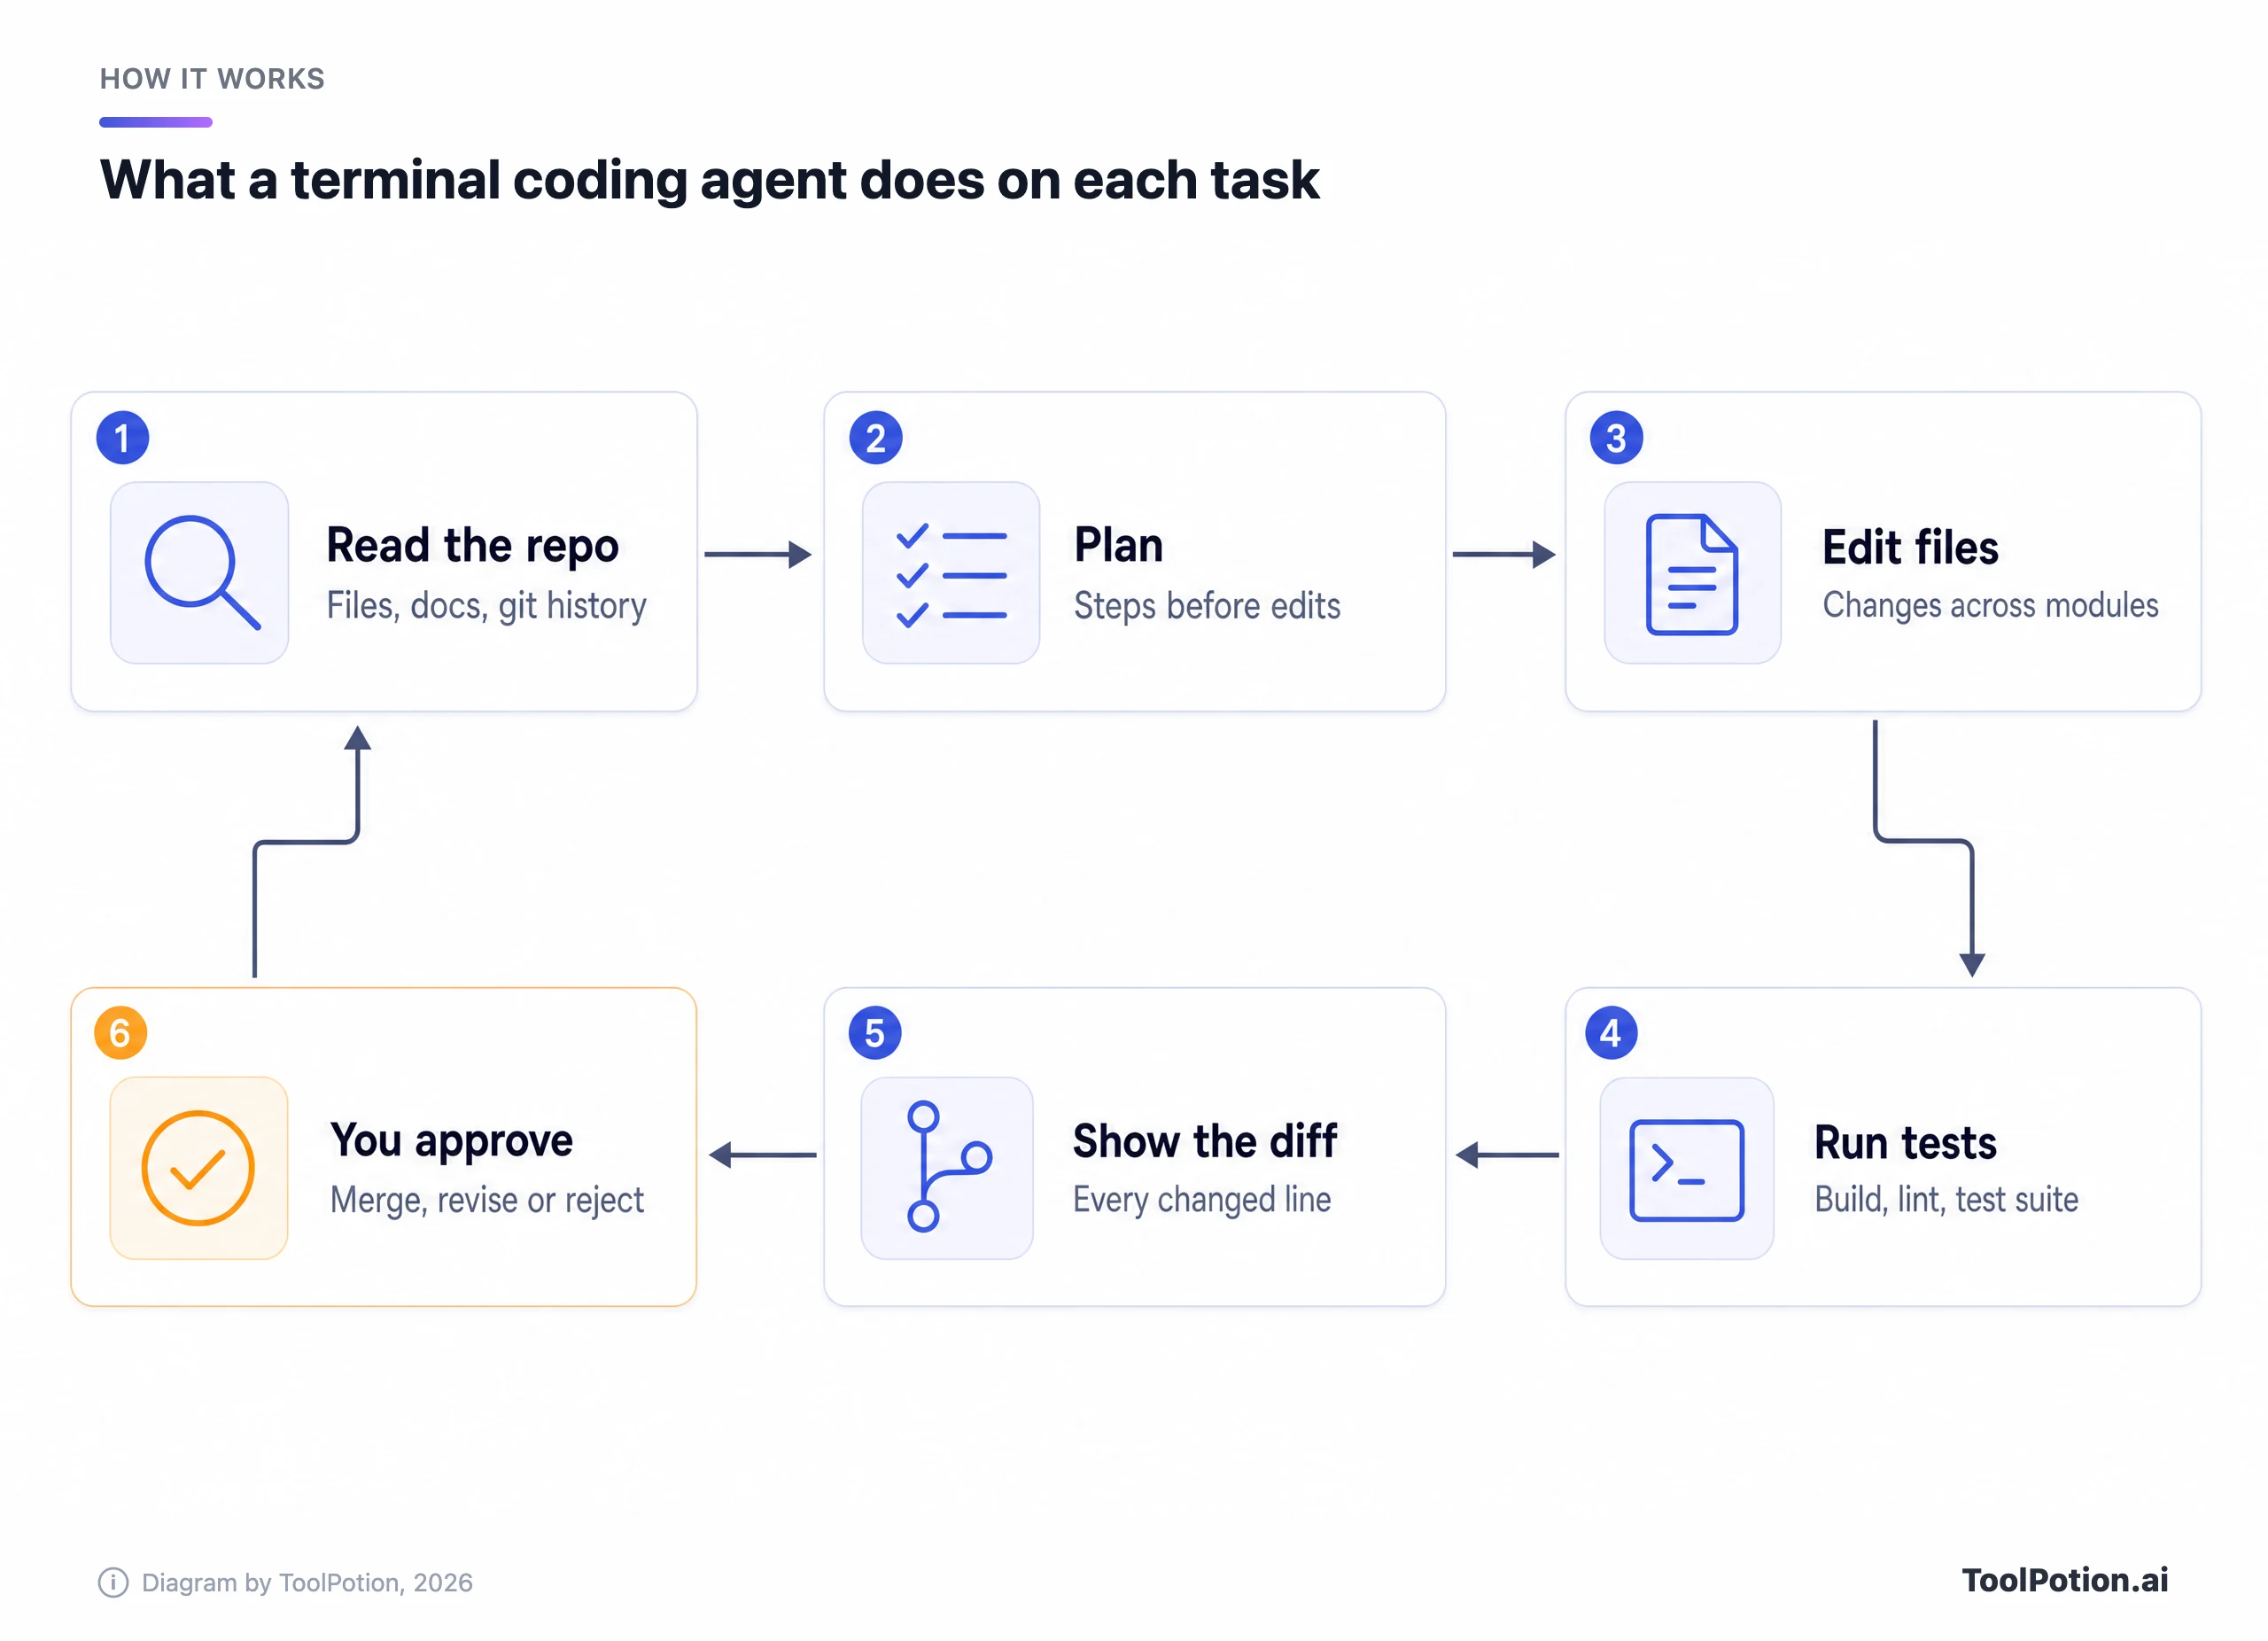
A etapa em destaque é aquela em torno da qual você deve projetar o processo, porque a aprovação é onde ficam o seu julgamento e a sua política de segurança. As ferramentas diferem em três pontos desse loop: quais modelos o movem, o que o agente pode fazer antes de você aprovar e onde ele roda (no seu notebook, num sandbox do SO ou na nuvem do fornecedor). Os modelos ficam com as manchetes, mas os outros dois fatores decidem se uma equipe inteira consegue usar a ferramenta.
Claude Code vs Codex, frente a frente
Esses dois são os padrões por bons motivos. Ambos rodam em macOS, Linux e Windows, leem um arquivo AGENTS.md, aceitam servidores MCP, skills, hooks, plugins e subagentes, conseguem mandar uma tarefa para a nuvem e vêm com um plano de US$ 20 por mês. As diferenças estão nos detalhes.
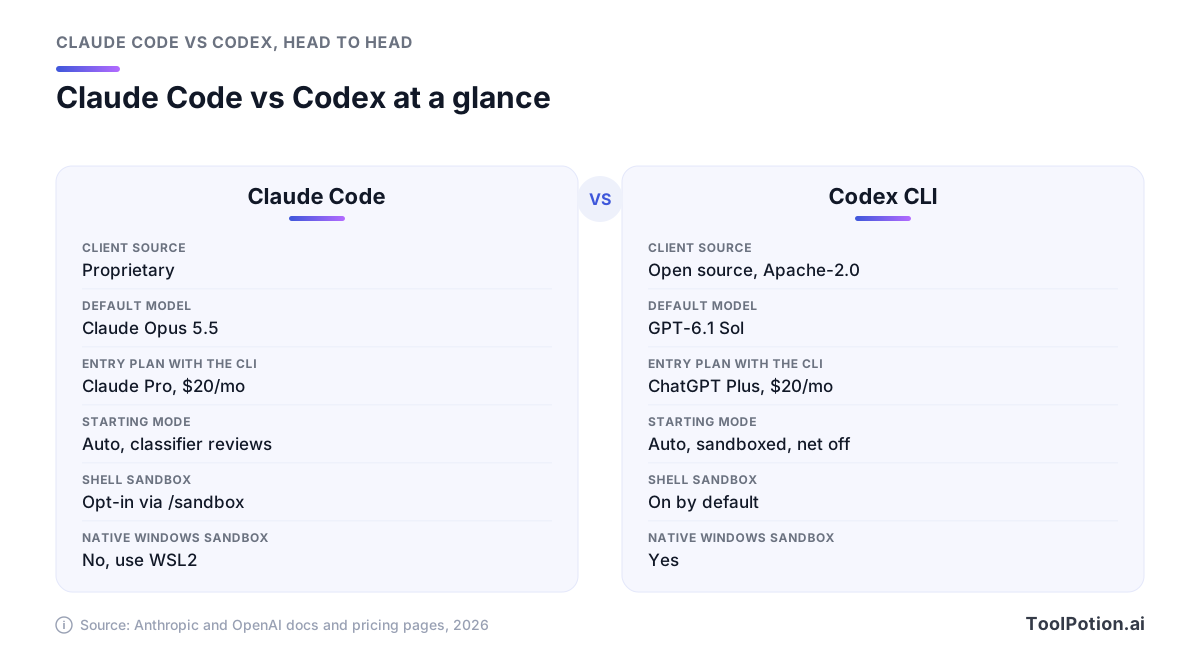
Comecemos pelos modelos. O Claude Code roda apenas modelos da Anthropic e usa o Claude Opus 5.5 como padrão em todos os planos, com Sonnet 5.5 e Haiku como opções mais baratas e o Fable 5.1, o modelo mais capaz do Claude Code, como opt-in explícito que alguns planos cobram em créditos de uso extra. O Codex usa o GPT-6.1 Sol como padrão, que segundo a OpenAI chega perto do carro-chefe GPT-6 Astra em programação agêntica por um quinto do preço da API. O cliente do Codex é open source sob Apache-2.0 (o repositório openai/codex é escrito em Rust), enquanto a licença do Claude Code diz "todos os direitos reservados".
Os padrões de segurança são a divisão mais nítida. Dentro de um repositório git, o Codex começa num preset chamado Auto: ele pode ler, editar e executar comandos no workspace, mas um sandbox do SO (Seatbelt no macOS, bubblewrap mais seccomp no Linux, um sandbox nativo no Windows) bloqueia o acesso à rede e a qualquer coisa fora do projeto até você aprovar (documentação da OpenAI). Fora de um repositório git, ele volta para somente leitura.
O Claude Code segue o caminho oposto. Seu sandbox de shell vem desligado por padrão, e a primeira linha de defesa é o classifier do modo auto mais as regras de negação, que bloqueiam em qualquer modo. Quando você liga o sandbox, ele envolve apenas comandos de shell, e os comandos em sandbox ainda conseguem ler boa parte da máquina, incluindo ~/.ssh e ~/.aws/credentials, até você adicionar regras de negação (documentação do Claude Code). No Windows nativo não há sandbox algum, e a Anthropic indica o WSL2.
O Claude Code vence em profundidade. Plugins reúnem skills, subagentes, hooks e servidores MCP e são instalados a partir de marketplaces que os admins podem liberar ou bloquear. Routines executam jobs agendados na nuvem da Anthropic, as integrações com GitHub Actions e GitLab CI/CD cuidam de revisão e triagem, e o Agent SDK permite criar agentes com as mesmas ferramentas. O Codex cobre boa parte do mesmo terreno com menos cerimônia (hooks, skills, plugins, codex exec para scripts, uma GitHub Action), e sua revisão automática de código atende pull requests do GitHub e merge requests do GitLab.
Então, onde cada um é mais fraco? O Claude Code prende você a um único laboratório e, até você mudar uma configuração, apoia-se no julgamento de um modelo em vez de uma fronteira do SO, o que algumas equipes de segurança não vão aceitar. O Codex também prende você a um laboratório, e o modelo de ponta é muito racionado no plano de US$ 20: a OpenAI estima de 5 a 45 mensagens locais a cada cinco horas com o GPT-6 Astra no Plus, contra 15 a 160 com o GPT-6.1 Sol (preços da OpenAI).
O Antigravity CLI substituiu o Gemini CLI para a maioria das pessoas
Se você pesquisar Gemini CLI hoje, ainda vai encontrar o repositório Apache-2.0, que continua recebendo releases (a v0.62.0 saiu esta semana). A documentação, porém, agora traz um aviso dizendo a usuários gratuitos e do Google One que o Gemini CLI foi substituído. Quem pode continuar usando são organizações com licenças Gemini Code Assist Standard ou Enterprise e desenvolvedores com chaves de API pagas do Gemini ou do Gemini Enterprise Agent Platform.
O CLI que o substituiu dentro do Google Antigravity é um tipo diferente de produto. É de código fechado, e o Tech Times informa que o repositório público não tem código-fonte nenhum, um ponto sensível para um projeto que, pela contagem do próprio Google, incorporou 6.000 pull requests. O Google admite que ainda não há paridade 1:1 de recursos, embora skills, hooks, subagentes e extensões (agora chamadas de plugins) tenham migrado.
Também há vantagens reais. O menu de modelos do Antigravity lista Gemini 3.8 Flash e Gemini 3.1 Pro ao lado de Claude Sonnet 5.5, Claude Opus 5.5 e do GPT-OSS-120b, de pesos abertos, então uma assinatura do Google alcança modelos de dois laboratórios, embora a disponibilidade varie por plano. O preset padrão no macOS e no Linux também é, no papel, pelo menos tão rígido quanto o do Codex: comandos de terminal rodam num sandbox sem rede, o acesso a arquivos para no workspace e nas pastas temporárias, ~/.ssh e arquivos .env são bloqueados, e ações de MCP e web pedem confirmação antes (documentação do Antigravity). No Windows, esse sandbox vem desligado por padrão.
A cota é o porém. O plano Individual gratuito lista limites semanais básicos, bem longe das 1.000 requisições gratuitas por dia que o Gemini CLI dava a contas pessoais. A capacidade paga vem com os planos Google AI Pro e Ultra, e o Google reorganizou esses planos quando lançou o Antigravity, então confira os limites atuais na página de planos do próprio Google antes de se comprometer. Escolha o Antigravity CLI se você vive no Google Cloud, quer modelos Claude sem um contrato separado com a Anthropic ou quer padrões de sandbox rígidos de fábrica. Deixe de lado se um cliente open source é importante para você.
Copilot CLI, Cursor, OpenCode e o resto
O Copilot CLI é a opção mais subestimada para empresas. Ele roda modelos da Anthropic, da OpenAI e do Google numa só fatura e tem o kit moderno: modo de plano, modo autopilot, agentes embutidos para explorar e revisar código, MCP, plugins, skills, hooks e um prefixo & que entrega a tarefa ao agente de código na nuvem do GitHub (GitHub Changelog). Todo plano o inclui: Free, Pro a US$ 10 por mês, Pro+ a US$ 39 e Max a US$ 100, além de Business a US$ 19 e Enterprise a US$ 39 por usuário (GitHub Docs).
O ponto fraco são as permissões. O Copilot pede que você confie numa pasta e depois aprova ferramentas uma a uma ou para a sessão inteira, e a própria documentação do GitHub avisa que aprovar rm para uma sessão permite que ele apague qualquer arquivo daquela árvore de diretórios sem perguntar. O sandbox local é opt-in via /sandbox enable, e uma flag --yolo desliga todas as verificações.
Veja como os quatro maiores nomes se comparam em atributos que você confere na documentação e nas licenças, não no marketing.
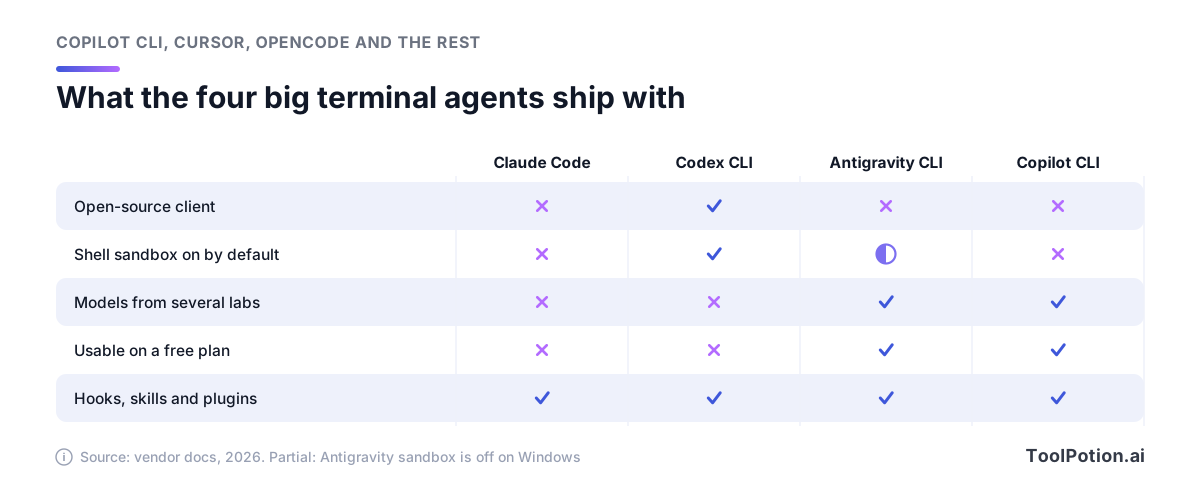
Só o Codex combina um cliente open source com um sandbox ativo por padrão em todo lugar. Antigravity e Copilot são os dois que misturam modelos de laboratórios diferentes sem gambiarra. A extensibilidade convergiu: os quatro aceitam hooks, skills e plugins.
O Cursor leva seu agente de editor para o terminal, com modos agent, plan e ask, um modo print para scripts e CI e o mesmo handoff com & para um agente na nuvem. É o complemento óbvio se sua equipe já paga pelo Cursor (Individual a partir de US$ 20 por mês, Teams a US$ 40 por usuário) e uma venda difícil se não paga.
O OpenCode é o destaque open source: licença MIT, mais de 211.000 estrelas no GitHub e integração com mais de 75 provedores de modelos, incluindo modelos locais. Você pode entrar com uma conta GitHub Copilot ou ChatGPT Plus ou Pro em vez de pagar duas vezes. Fique atento aos padrões, porém. O OpenCode deixa o agente editar arquivos e executar comandos de shell sem perguntar, a menos que você escreva regras, não tem sandbox de SO, e suas proteções embutidas cobrem apenas arquivos .env, caminhos fora do projeto e um agente preso repetindo a si mesmo (documentação do OpenCode).
Mais três merecem uma linha cada. O Amp repassa os custos de modelo a preço de provedor, sem margem para indivíduos, mistura GPT-5.6 e Claude Fable 5.1 por baixo dos panos e tem um plano gratuito e outro de US$ 20. O Warp agora é um terminal agêntico com licença AGPL e agente próprio, com preços do gratuito ao Build de US$ 20 e ao Max de US$ 200, e diz funcionar com qualquer agente de código compatível com MCP. O Aider ainda tem a melhor história com git, fazendo commit de cada mudança com uma mensagem que você pode comparar e desfazer, mas o ritmo de lançamentos travou, então confirme que ele suporta o modelo que você quer antes de se comprometer. Para um panorama maior, nosso ranking de assistentes de código com IA e o ranking de agentes de IA acompanham as posições conforme mudam.
Os benchmarks colocam Claude Code e Codex em empate técnico
A régua pública mais útil para esta categoria é o Terminal-Bench, mantido por Stanford, Harbor e Laude Institute, que pontua pares de agente e modelo em tarefas difíceis dentro de um terminal real. No leaderboard atual 4.0, o Codex com GPT-6 Astra em esforço de raciocínio máximo lidera com 58,2%, e o Claude Code com Fable 5.1 em esforço máximo aparece com 57,9% (Terminal-Bench). Cada entrada roda 330 tentativas, com intervalo de confiança de cerca de três pontos para mais ou para menos, então considere um empate.
O mais interessante é o botão de esforço. Compare cada par na configuração de raciocínio mais baixa e na mais alta.
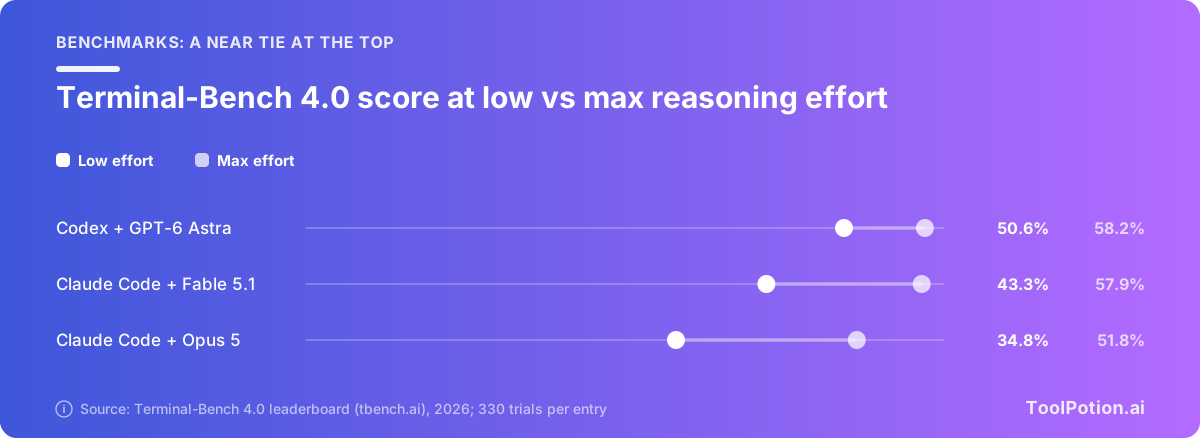
Cair do esforço máximo para o baixo custa ao Codex com Astra menos de 8 pontos e ao Claude Code com Fable 5.1 quase 15. O Claude Code com o Opus 5, mais antigo, perde 17. A configuração que você deixa no padrão pode pesar tanto quanto a marca na caixa.
O custo conta uma segunda história. O leaderboard registra quanto cada execução gastou: US$ 3.267 para o Codex com Astra em esforço máximo contra US$ 6.244 para o Claude Code com Fable 5.1, cerca de US$ 9,90 contra US$ 18,90 por tarefa para a mesma pontuação. São custos a preço de API para tarefas longas e difíceis, não o que um assinante paga. Nenhum agente do Google aparece no ranking, então a melhor entrada rodando um modelo Gemini é um agente de terceiros com Gemini 3.8 Flash, com 19,1%. Afirmações dos fornecedores, como a da Anthropic de que o Sonnet 5.5 supera o Opus 5.5 em programação agêntica, vêm dos testes dos próprios fornecedores.
Modos de permissão, de somente leitura a totalmente automático
Hoje toda ferramenta oferece a mesma escada de autonomia com nomes diferentes. O degrau que você escolhe define quantas vezes você é interrompido e quanto estrago uma instrução ruim (ou um prompt injection escondido num README) pode causar.
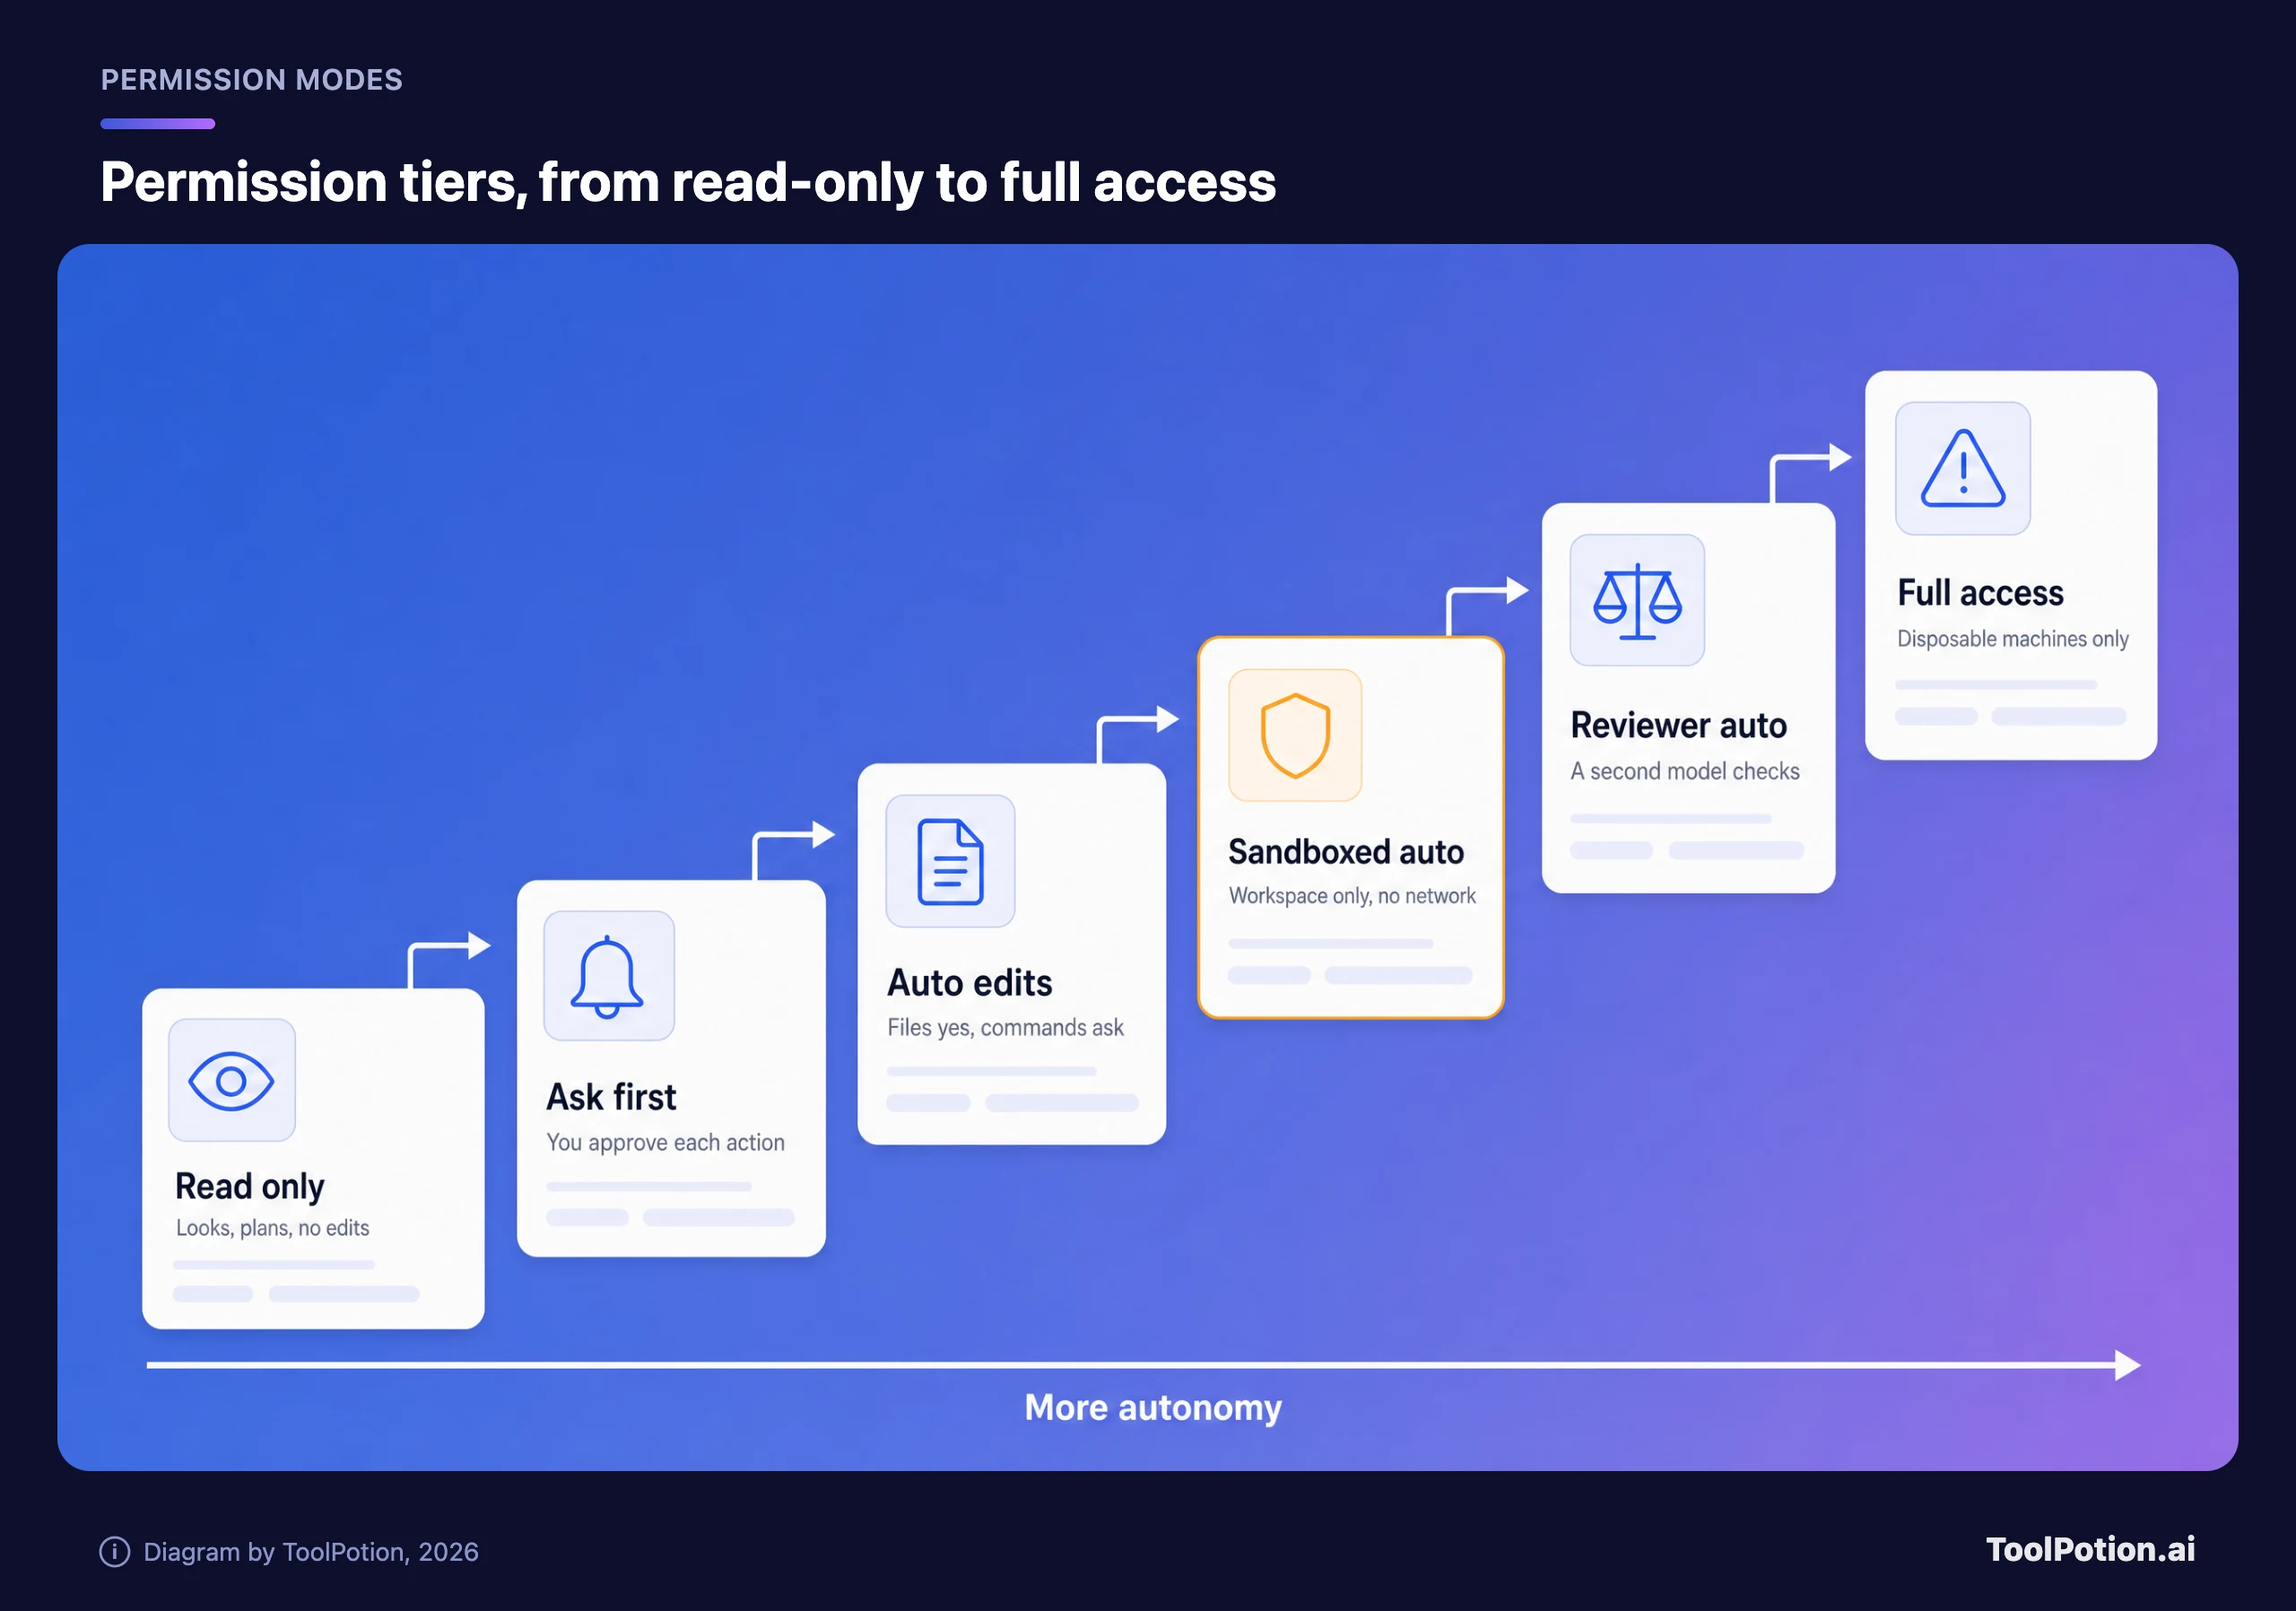
O auto em sandbox é o padrão certo para o dia a dia. O agente edita e executa comandos livremente dentro do projeto, sem rede e sem alcance ao seu diretório home. O auto com revisor reduz ainda mais as confirmações, mas confia no julgamento de um modelo. O acesso total pertence a containers e VMs descartáveis, e é o que a documentação da Anthropic também diz sobre o bypassPermissions. Veja como cada degrau se chama nas quatro principais ferramentas.
| Nível | Claude Code | Codex CLI | Antigravity CLI | Copilot CLI |
|---|---|---|---|---|
| Somente leitura | plan | read-only | Plan mode | Plan mode |
| Perguntar antes | default (Manual) | Aprovações granulares | Request Review | Confirmação por ferramenta |
| Edições automáticas | acceptEdits | Nenhum | Accept-Edits | Aprovar ferramenta na sessão |
| Auto em sandbox | /sandbox auto-allow | Auto (padrão em repositórios git) | Preset padrão | /sandbox enable |
| Auto com revisor | auto (padrão) | Auto-review (opt-in) | Nenhum | Nenhum |
| Acesso total | bypassPermissions | danger-full-access | Turbo | --yolo |
Dois padrões se destacam. Codex e Antigravity começam você dentro de um sandbox, enquanto Claude Code e Copilot começam em modos que dependem de confirmações ou da revisão de um modelo. Se você usa o Claude Code, ligar o sandbox é a mudança de configuração mais útil que você pode fazer.
Planos vs chaves de API: quanto você vai pagar
Cada fornecedor vende dois caminhos de entrada. Um plano mensal fixo limita sua fatura, mas mede o uso com limites de cinco horas e semanais que os fornecedores descrevem como multiplicadores, não como contagem de tokens. Uma chave de API cobra cada token a preço de tabela, sem teto.
| Agente | Plano de entrada | Planos superiores | Equipes |
|---|---|---|---|
| Claude Code | Claude Pro, US$ 20/mês (US$ 17 no plano anual) | Max 5x US$ 100, Max 20x US$ 200 | Team: assentos de US$ 25 ou US$ 125/mês; Enterprise: assento de US$ 20 mais uso a preço de API |
| Codex | ChatGPT Plus, US$ 20/mês (o CLI não está no Free nem no Go) | Pro a US$ 100, US$ 200 ou US$ 500 | Business US$ 20/usuário (anual) |
| Copilot CLI | Pro US$ 10/mês (o Free tem uma franquia pequena) | Pro+ US$ 39, Max US$ 100 | Business US$ 19, Enterprise US$ 39 por usuário |
| Antigravity CLI | Plano Individual gratuito | Google AI Pro e Ultra | Business a partir de US$ 30/usuário via Google Cloud |
| Cursor CLI | Individual US$ 20/mês | Planos individuais superiores | Teams US$ 40/usuário |
Os preços vêm da página de preços de cada fornecedor, incluindo a da Anthropic. Se a conta dos planos confunde você, nosso guia sobre modelos de preço de ferramentas de IA explica créditos, assentos e tokens.
O caminho da API importa mais para quem usa muito e para CI. A Anthropic cobra US$ 4 por milhão de tokens de entrada e US$ 20 por milhão de saída no Opus 5.5, e US$ 2 e US$ 10 no Sonnet 5.5. A OpenAI cobra US$ 2 e US$ 10 pelo GPT-6.1 Sol e US$ 10 e US$ 50 pelo GPT-6 Astra (preços da OpenAI). O cache mexe mais na fatura do que as tarifas de tabela, porque os loops de agente reenviam o mesmo contexto o tempo todo. Na execução do Terminal-Bench acima, cerca de 96% dos tokens de entrada do Codex foram leituras de cache, que a OpenAI cobra a um décimo da tarifa de entrada do Astra.
Coloque seus próprios números abaixo. Os valores padrão copiam o mix de tokens de uma dessas tarefas do benchmark (cerca de US$ 10 por tarefa no Astra), e execuções de benchmark são longas e difíceis, então substitua-os por números do seu painel de uso antes de montar um orçamento.
Com os valores padrão, um desenvolvedor que rode 40 dessas tarefas por mês no Opus 5.5 gastaria cerca de US$ 126 via chave de API, então Claude Pro e Max 5x saem mais baratos se os limites aguentarem. Troque o modelo para o GPT-6 Astra e a mesma carga custa cerca de US$ 401. Essa diferença é o motivo de usuários do Codex deverem reservar o modelo de ponta para os problemas que realmente o exigem e deixar o GPT-6.1 Sol com o resto.
Como escolher um e fazer o rollout com segurança
Comece por onde seu código e seus contratos já estão e deixe os padrões de segurança desempatarem.
- Se sua equipe já paga pelo ChatGPT, ou você quer um cliente open source com sandbox ativo por padrão, comece pelo Codex.
- Se você quer a maior personalização e está bem com modelos Claude, escolha o Claude Code e ligue o sandbox antes de qualquer outra coisa.
- Se sua organização roda no GitHub e quer modelos Claude, GPT e Gemini sob um só orçamento, com limites por usuário, o Copilot CLI dá menos atrito.
- Empresas que usam Google Cloud devem testar o Antigravity CLI.
- Escolha o OpenCode quando precisar de open source de ponta a ponta ou de modelos locais, e aceite que você mesmo vai escrever as proteções.
Ainda em dúvida? Pese abaixo o que importa para você. As notas são nossa leitura editorial da documentação e dos preços de cada fornecedor, não resultados de testes.
Com segurança no peso mais alto, o Codex lidera e o Copilot CLI vem em segundo. Se você puxar administração de equipe e tetos de gasto para o topo, o Copilot assume a frente, e se maximizar escolha de modelos e open source, o OpenCode fica em primeiro. O Claude Code sobe sempre que extensibilidade pesa mais que padrões seguros.
Um rollout seguro para a equipe
- Faça um piloto com um agente, com poucos desenvolvedores num único repositório, para comparar resultados e não ferramentas.
- Defina o padrão de permissões de forma centralizada. No Claude Code, isso significa managed settings com o sandbox ligado e regras de negação para pushes e deploys, e os admins podem desligar o modo auto para a organização inteira. No Codex, mantenha workspace-write com a rede desligada e reserve danger-full-access para runners de CI descartáveis.
- Mantenha os segredos fora de alcance. Não rode agentes em shells que guardam credenciais de produção, negue leitura de ~/.ssh, de arquivos de credenciais de nuvem e de .env, e lembre que os hooks e os servidores MCP locais do Claude Code rodam fora do sandbox, com todo o seu acesso.
- Revise os diffs do agente como o pull request de um novo contratado. Agentes podem abrir branches e PRs, mas quem faz o merge é uma pessoa. Um revisor automatizado, como o Claude Code Security Review ou a revisão de código do Codex, é uma segunda checagem, nunca um substituto.
- Limite o gasto antes de escalar. O Copilot aceita orçamentos por usuário e por centro de custo, e o uso adicional vem ligado por padrão, então defina um teto ou desligue. O plano Enterprise da Anthropic cobra o uso a preço de API além do assento, e os planos empresariais do Antigravity oferecem tetos de gasto para uso de API e de assinatura.
- Avalie plugins e servidores MCP como dependências. A documentação da Anthropic diz que um plugin instalado executa código com os privilégios do seu usuário, então libere marketplaces por allowlist em vez de deixar cada pessoa adicionar o seu.
- Dê ao CI uma allowlist exata. O modo dontAsk do Claude Code com ferramentas nomeadas, ou o Codex num sandbox read-only ou workspace-write, mantém as execuções sem supervisão previsíveis.
Equipes que já usam agentes em outras áreas do negócio vão reconhecer boa parte disso em nosso texto sobre agentes de IA em produção. Para um panorama mais amplo das ferramentas centradas em editor, veja nosso guia de assistentes de código com IA.
Perguntas frequentes
O Gemini CLI ainda está disponível?
Sim, para organizações no Gemini Code Assist Standard ou Enterprise e para desenvolvedores com chaves pagas da API Gemini. Usuários Free, Google AI Pro e Ultra foram migrados para o Antigravity CLI. O código Apache-2.0 continua no GitHub, então qualquer pessoa ainda pode fazer um fork.
Posso usar o Claude Code com uma assinatura do ChatGPT, ou o Codex com um plano Claude?
Não. Cada plano cobre o agente do seu próprio fornecedor. Se você quer um cliente único para vários fornecedores, o OpenCode aceita login com contas ChatGPT Plus ou Pro e GitHub Copilot, enquanto o Copilot CLI e o Antigravity CLI reúnem modelos de vários laboratórios numa só assinatura.
Qual agente de terminal é o mais barato para um desenvolvedor solo?
O Copilot Pro, a US$ 10 por mês, é a entrada paga mais barata. O ChatGPT Go, a US$ 8, não inclui o Codex CLI, que começa no Plus. O Copilot Free e o plano gratuito do Antigravity não custam nada, mas vêm com franquias pequenas. Para uso mais pesado, compare Claude Pro e ChatGPT Plus, a US$ 20, com a sua fatura projetada de API.
Preciso de sandbox se reviso todo diff?
Sim. A revisão de diff pega código ruim, mas acontece depois que o agente já executou comandos. Um sandbox limita no que esses comandos podem mexer enquanto rodam, incluindo chamadas de rede que poderiam enviar um segredo para onde não deveria.
O Terminal-Bench é uma forma confiável de escolher?
É a melhor régua pública para trabalho em terminal, mas mede pares de agente e modelo em configurações de esforço fixas, em tarefas difíceis. Diferenças de poucos pontos ficam dentro dos intervalos de confiança, então trate-as como empate e faça um piloto curto nos seus próprios repositórios.