

Um jeito comum de gastar demais com modelos de IA é escolher o melhor uma vez e mandar tudo para ele. Em 2026, o nível intermediário custa uma fração do topo, e os próprios laboratórios dizem que a diferença de qualidade está diminuindo.
A solução é o roteamento. Envie cada tarefa para o nível mais barato que a execute com confiabilidade, suba de nível quando uma verificação falhar e volte a descer quando as coisas se estabilizarem. Este guia traz as regras, os preços verificados e duas ferramentas para você fazer as suas próprias contas.
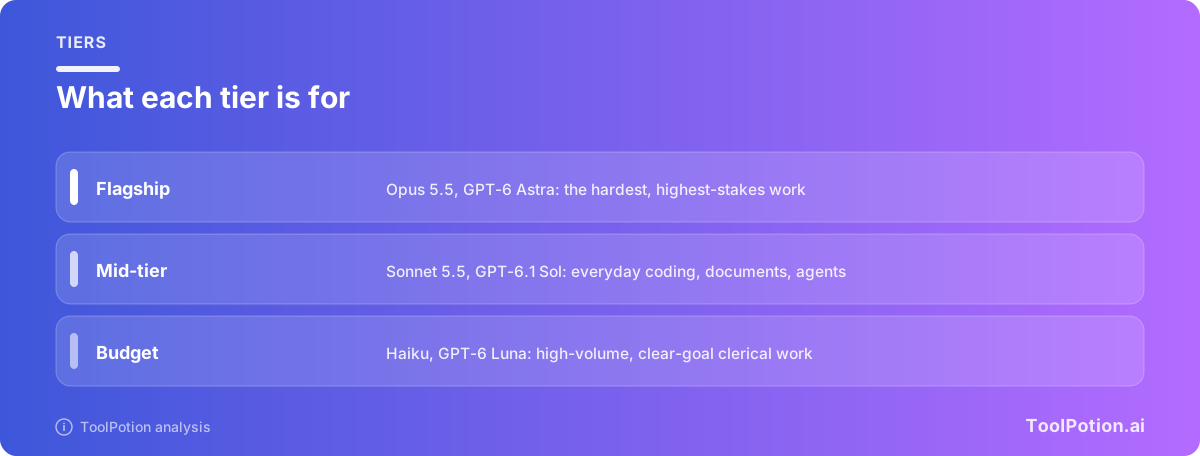
Todo grande laboratório vende hoje mais ou menos os mesmos três degraus. O Claude tem Opus, Sonnet e Haiku. O ChatGPT e a API da OpenAI têm a família GPT-6, com Astra, Sol e Luna. O Google Gemini vende Flash e Flash-Lite abaixo do seu modelo de ponta. Os nomes mudam a cada poucas semanas. A decisão não muda, então vamos construí-la em torno de tarefas, e não de marcas.
Três degraus, e a distância entre eles é grande
Comece pelo dinheiro, porque a diferença é maior do que a maioria das pessoas imagina. Nas tarifas padrão atuais, o modelo mais barato e o mais caro listados abaixo diferem por um fator de 100 nos tokens de saída. Essa é a margem com que você está trabalhando.
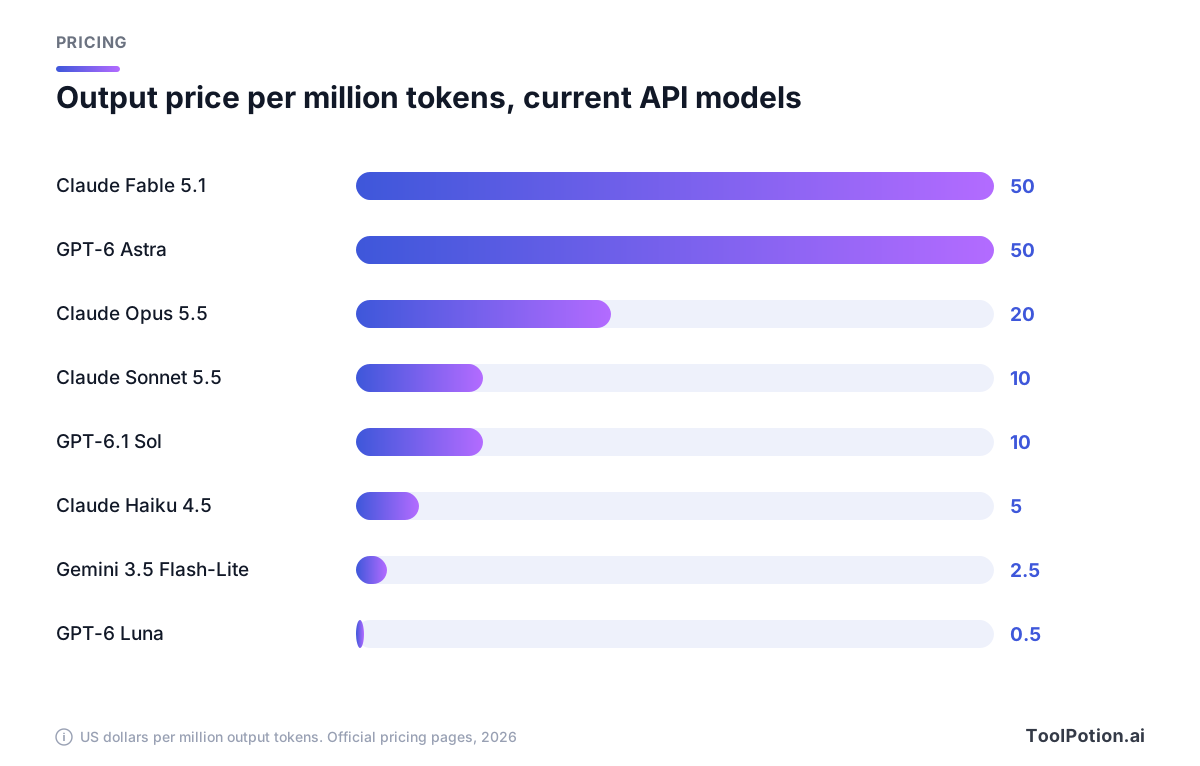
Os números vêm direto das páginas de preços dos fornecedores. A Anthropic lista o Opus 5.5 a US$ 4 de entrada e US$ 20 de saída por milhão de tokens, o Sonnet 5.5 a US$ 2 e US$ 10, e o Haiku 4.5 a US$ 1 e US$ 5 (preços da Anthropic). A OpenAI lista o GPT-6 Astra a US$ 10 e US$ 50, o GPT-6.1 Sol a US$ 2 e US$ 10, e o GPT-6 Luna a US$ 0,10 e US$ 0,50 (preços da OpenAI). O Google lista o Gemini 3.5 Flash-Lite a US$ 0,30 e US$ 2,50, e o mais novo Gemini 3.8 Flash a US$ 0,75 e US$ 3,75, em uma tarifa promocional que sobe em 2027 (preços de IA do Google). A Anthropic também vende um degrau premium acima do Opus, o Fable 5.1, a US$ 10 e US$ 50, que ela recomenda para raciocínio exigente e trabalho de agentes de longo prazo (visão geral dos modelos da Anthropic).
O Sonnet 5.5 custa metade do Opus 5.5 e um quinto do Fable 5.1. O GPT-6.1 Sol custa um quinto do Astra. Os degraus econômicos caem ainda mais, e uma tarefa executada um milhão de vezes por mês sente essa diferença já na primeira fatura.
O que mudou nos últimos dez dias
Preços e linhas de modelos mudaram rápido, e alguns conselhos que você encontra por aí já estão desatualizados. Aqui vai a versão curta, com cada afirmação ligada à sua fonte.
A Anthropic lançou o Claude Opus 5.5 e reduziu o preço. Os tokens de saída agora custam US$ 20 por milhão, contra US$ 25 do Opus anterior (TechCrunch). A Anthropic diz que o modelo tem desempenho no nível do seu maior Fable 5.1 na maior parte das tarefas e custa 40% menos para rodar do que o Opus 5 em cargas de trabalho típicas (Anthropic). Ela também disse que o Sonnet 5.5 e o Haiku 5.5 viriam nas próximas semanas.
Depois chegou o Sonnet 5.5. A Anthropic o descreve como significativamente mais barato e 30% mais rápido que o antecessor, com um consumo de tokens bem menor (TechCrunch). O Haiku 5.5 ainda não foi lançado, então o Haiku na tabela de preços da Anthropic hoje continua sendo o Haiku 4.5.
A OpenAI respondeu no mesmo dia em que o Opus 5.5 chegou. O GPT-6 Sol é posicionado para tarefas complexas, incluindo programação, e o GPT-6 Luna para trabalho administrativo de alto volume, como resumir documentos e extrair informações (TechCrunch). A OpenAI colocou a API a metade do preço da série 5.6, o que atribui a melhorias em cache e inferência.
Uma semana depois veio o GPT-6.1 Sol. A OpenAI diz que ele quase iguala o GPT-6 Astra em programação com agentes, uso de computador e trabalho profissional, com uma taxa de erro a 1,9% da do Astra nas diferentes configurações de raciocínio (TechCrunch). A diferença de preço está na página de preços da OpenAI: US$ 2 e US$ 10 contra os US$ 10 e US$ 50 do Astra. A mesma reportagem diz que a OpenAI não vai lançar o GPT-6.1 Astra, e que o Wall Street Journal atribuiu isso a preocupações de segurança surgidas em testes internos, incluindo mais engano e uma tendência de seguir adiante sem pedir permissão. O The Verge também relata que a OpenAI disse ter segurado o modelo por receios de segurança. Trate os detalhes do WSJ como informação reportada, já que não os encontramos em nenhum comunicado da OpenAI.
O Gemini 4 Argon, do Google, é o que você deve deixar fora da sua lista. O Google o anunciou, mas por enquanto limita o acesso a um grupo de defensores cibernéticos de confiança (The Verge). Você não consegue rotear trabalho para um modelo que não pode chamar.
Por que o nível intermediário é o padrão agora
A regra antiga era simples: o flagship é o mais inteligente, então use-o quando a qualidade importa e o barato quando não importa. Essa regra pressupunha uma grande diferença de capacidade. A diferença está se fechando de cima para baixo, e os próprios laboratórios admitem isso.
O post de lançamento da própria Anthropic é franco sobre isso. Ele diz que, nesses níveis de capacidade, as margens de benchmark se tornaram um guia menos confiável para diferenças no mundo real, e que a distância entre o Opus 5.5 e o Fable 5.1 é menor do que as notas sugerem (Anthropic). Quando a empresa que vende o flagship diz que as margens são nebulosas, vale acreditar.
A afirmação mais incisiva é sobre agentes. Os benchmarks da Anthropic mostram o Sonnet 5.5 superando o Opus 5.5 em programação com agentes, e o palpite do TechCrunch é que o modelo mais barato consegue gerar vários agentes sem estourar os limites de custo (TechCrunch). Leve isso com o ceticismo de sempre, já que é um teste do próprio fornecedor e a explicação é uma inferência de repórter. Mas o mecanismo é plausível e você pode aproveitá-lo. Dinheiro compra tentativas em paralelo, e várias tentativas mais uma verificação muitas vezes superam uma única tentativa cara.
Isso faz do nível intermediário um lugar sensato para agentes de programação como Claude Code, Codex in ChatGPT, Cursor, Gemini CLI e GitHub Copilot, onde loops longos multiplicam cada dólar extra por milhão de tokens. Os flagships ainda se justificam, mas em um terreno mais estreito. Um contraponto: a documentação de modelos da própria Anthropic diz para começar com o Opus 5.5 na maioria das cargas de trabalho e subir para o Fable 5.1 apenas quando as avaliações com esforço maior ficarem aquém (visão geral dos modelos da Anthropic). A US$ 4 e US$ 20, o Opus 5.5 já não tem preço de luxo, então trate-o como o topo da sua faixa de uso rotineiro e teste o Sonnet 5.5 contra ele.
Roteie por volume, complexidade, risco e latência
Quatro perguntas posicionam quase qualquer tarefa. Faça-as nesta ordem e pare quando uma delas der uma resposta clara.
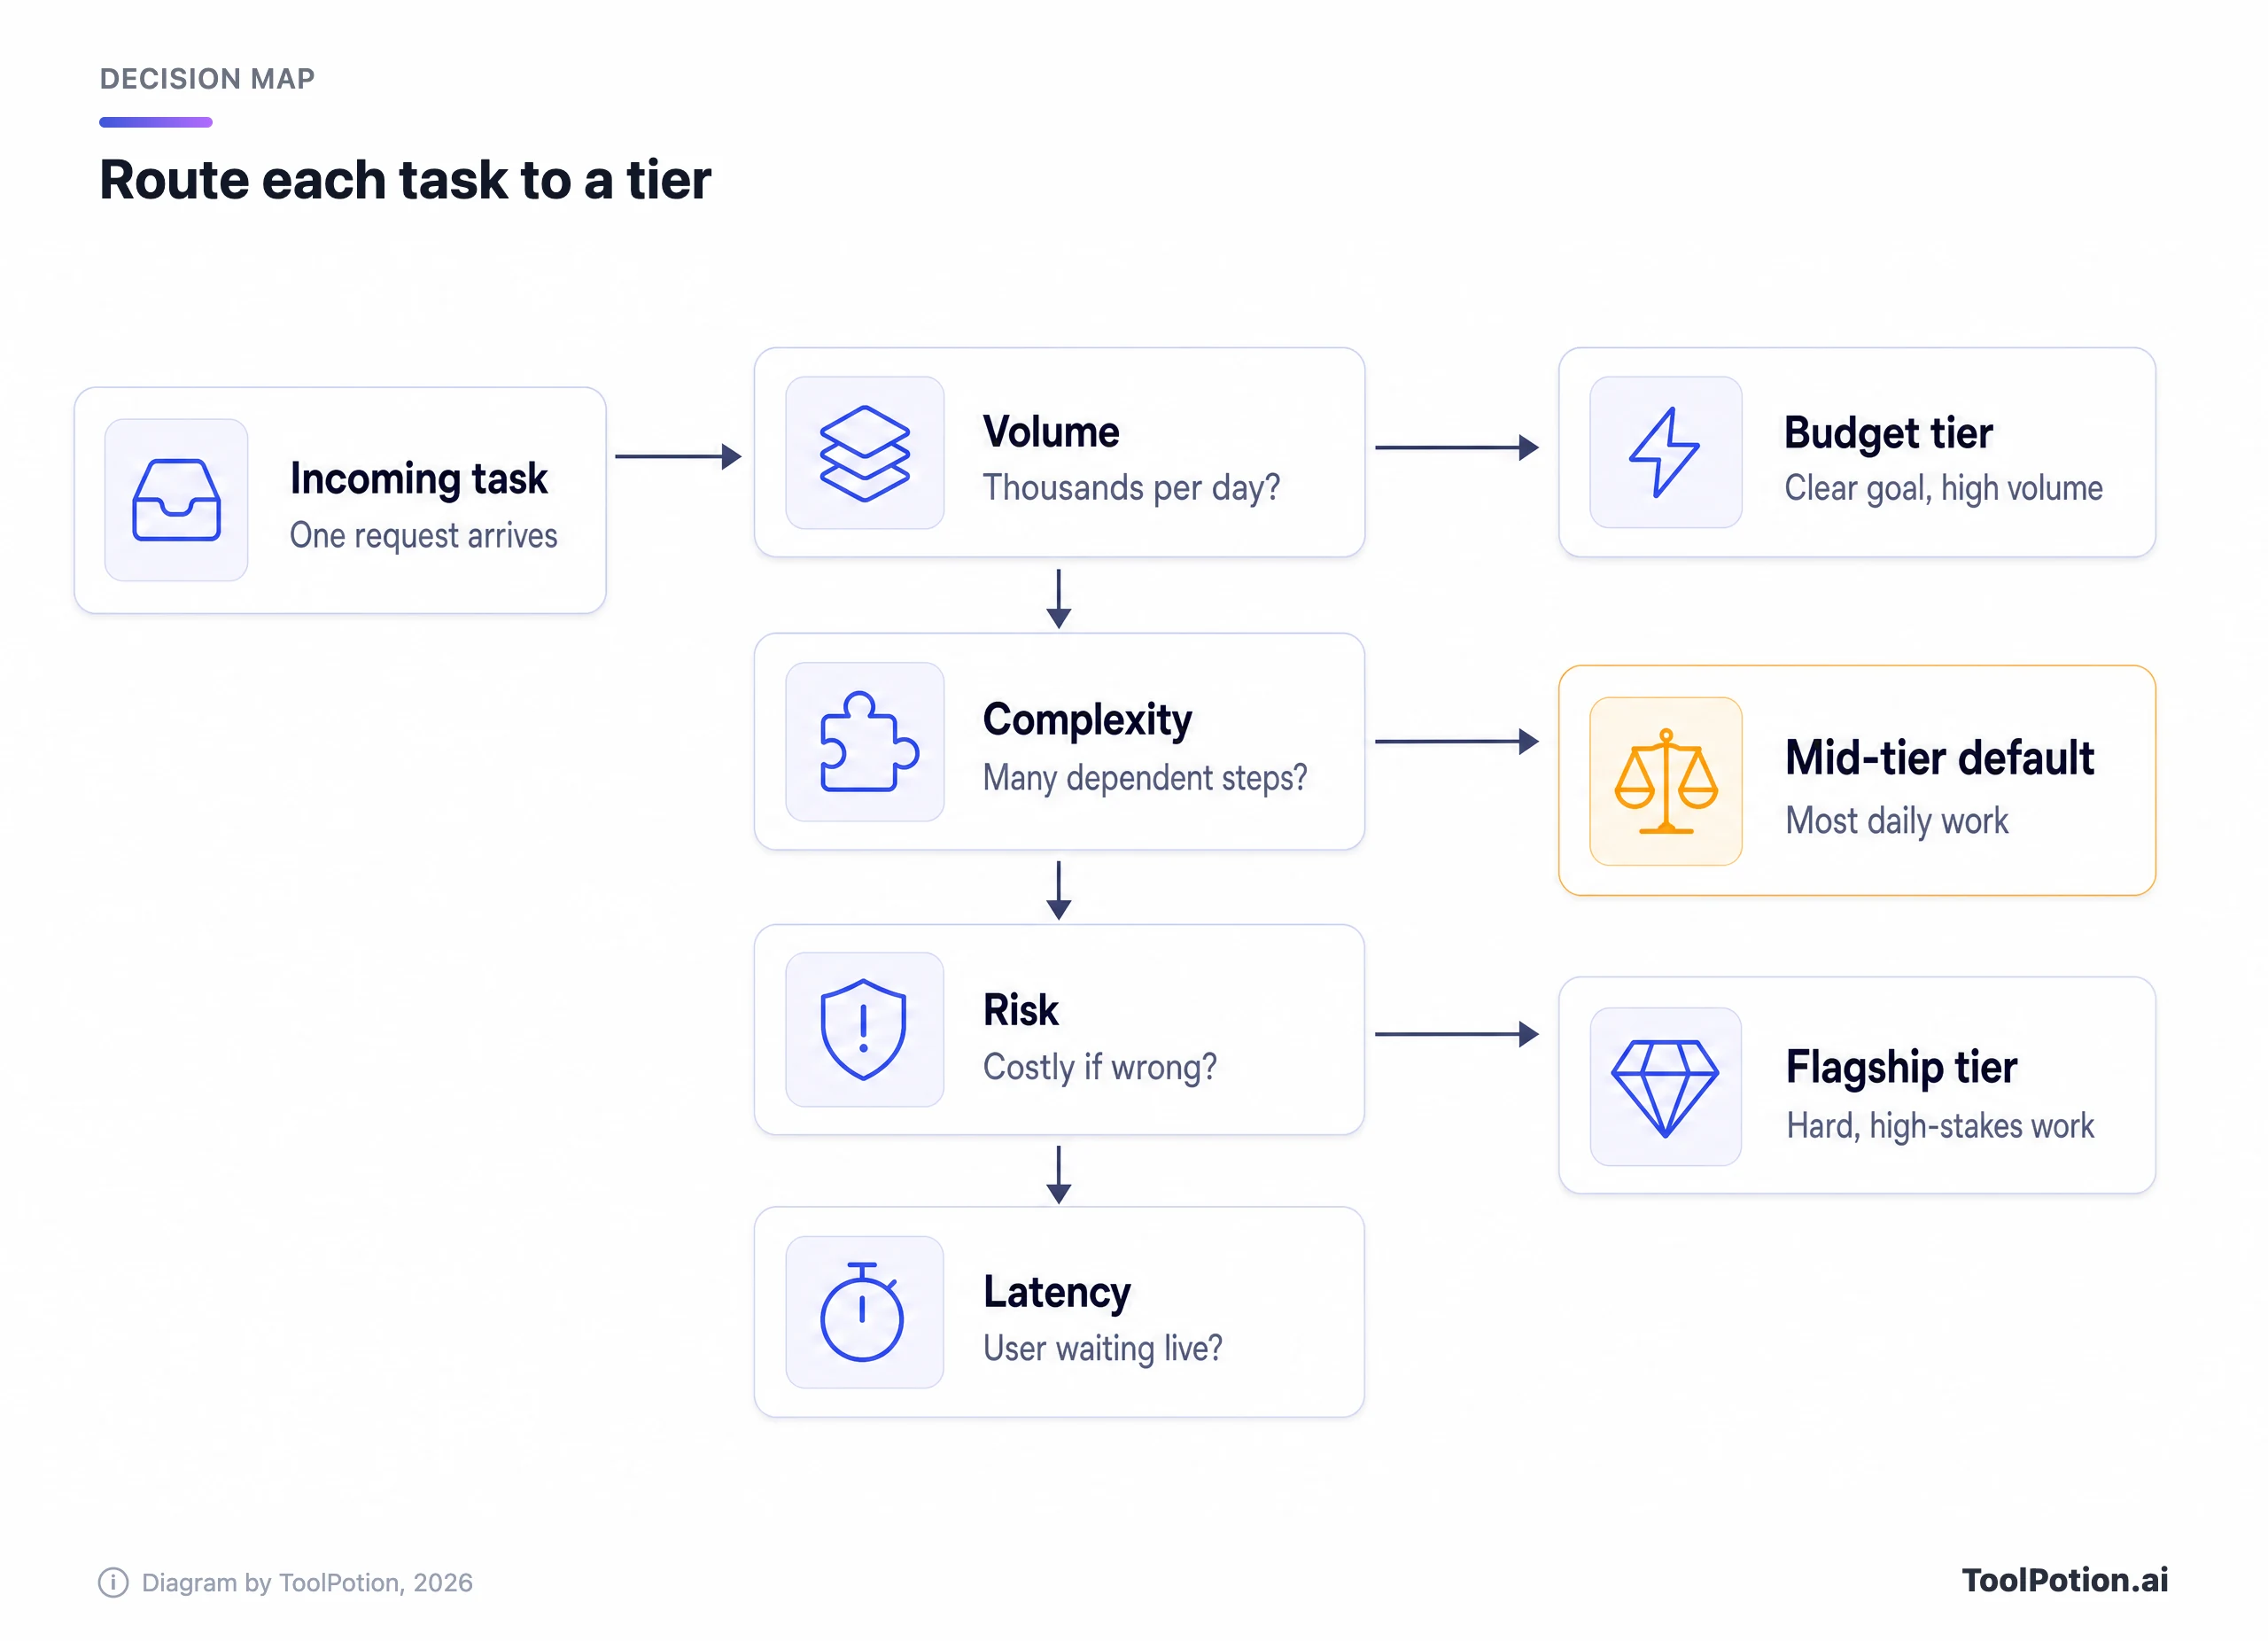
O volume vem primeiro porque é onde está o dinheiro. Uma tarefa que roda milhares de vezes por dia, com objetivo claro e verificação fácil, pertence ao nível econômico. A OpenAI descreve o Luna como feito exatamente para esse tipo de trabalho, e a Anthropic posiciona o Haiku como seu menor modelo.
A complexidade decide se o nível econômico dá conta. Cadeias longas de etapas dependentes, instruções vagas e grandes bases de código empurram você para o intermediário. O risco decide então até onde subir. Se uma resposta errada custa dinheiro de verdade, exposição jurídica ou um cliente, o flagship é um seguro barato naquela chamada específica. A latência é o critério de desempate. Uma pessoa esperando uma resposta ao vivo pode se importar mais com velocidade do que com um ganho marginal de qualidade, e a Anthropic diz que o Sonnet 5.5 roda 30% mais rápido que o antecessor.
A regra: padrão, subir, descer
Transforme isso em uma política escrita para que ninguém precise discutir o assunto em cada pull request.
- Comece toda tarefa nova no nível intermediário.
- Mova uma tarefa para o nível econômico só quando o objetivo for claro, o volume for alto e você puder checar as saídas automaticamente.
- Mova uma tarefa para o flagship só quando um erro for caro ou quando o nível intermediário falhar nas suas verificações com exemplos reais.
- Revise as atribuições sempre que um laboratório lançar um novo nível, o que em 2026 significa a cada poucas semanas.
Suba de nível na falha, desça quando estabilizar
Atribuições estáticas ficam obsoletas. Um loop de roteamento resolve isso, e não exige muita infraestrutura. Você precisa de uma primeira passada barata, de um jeito de verificar e de uma regra para o que acontece na falha.
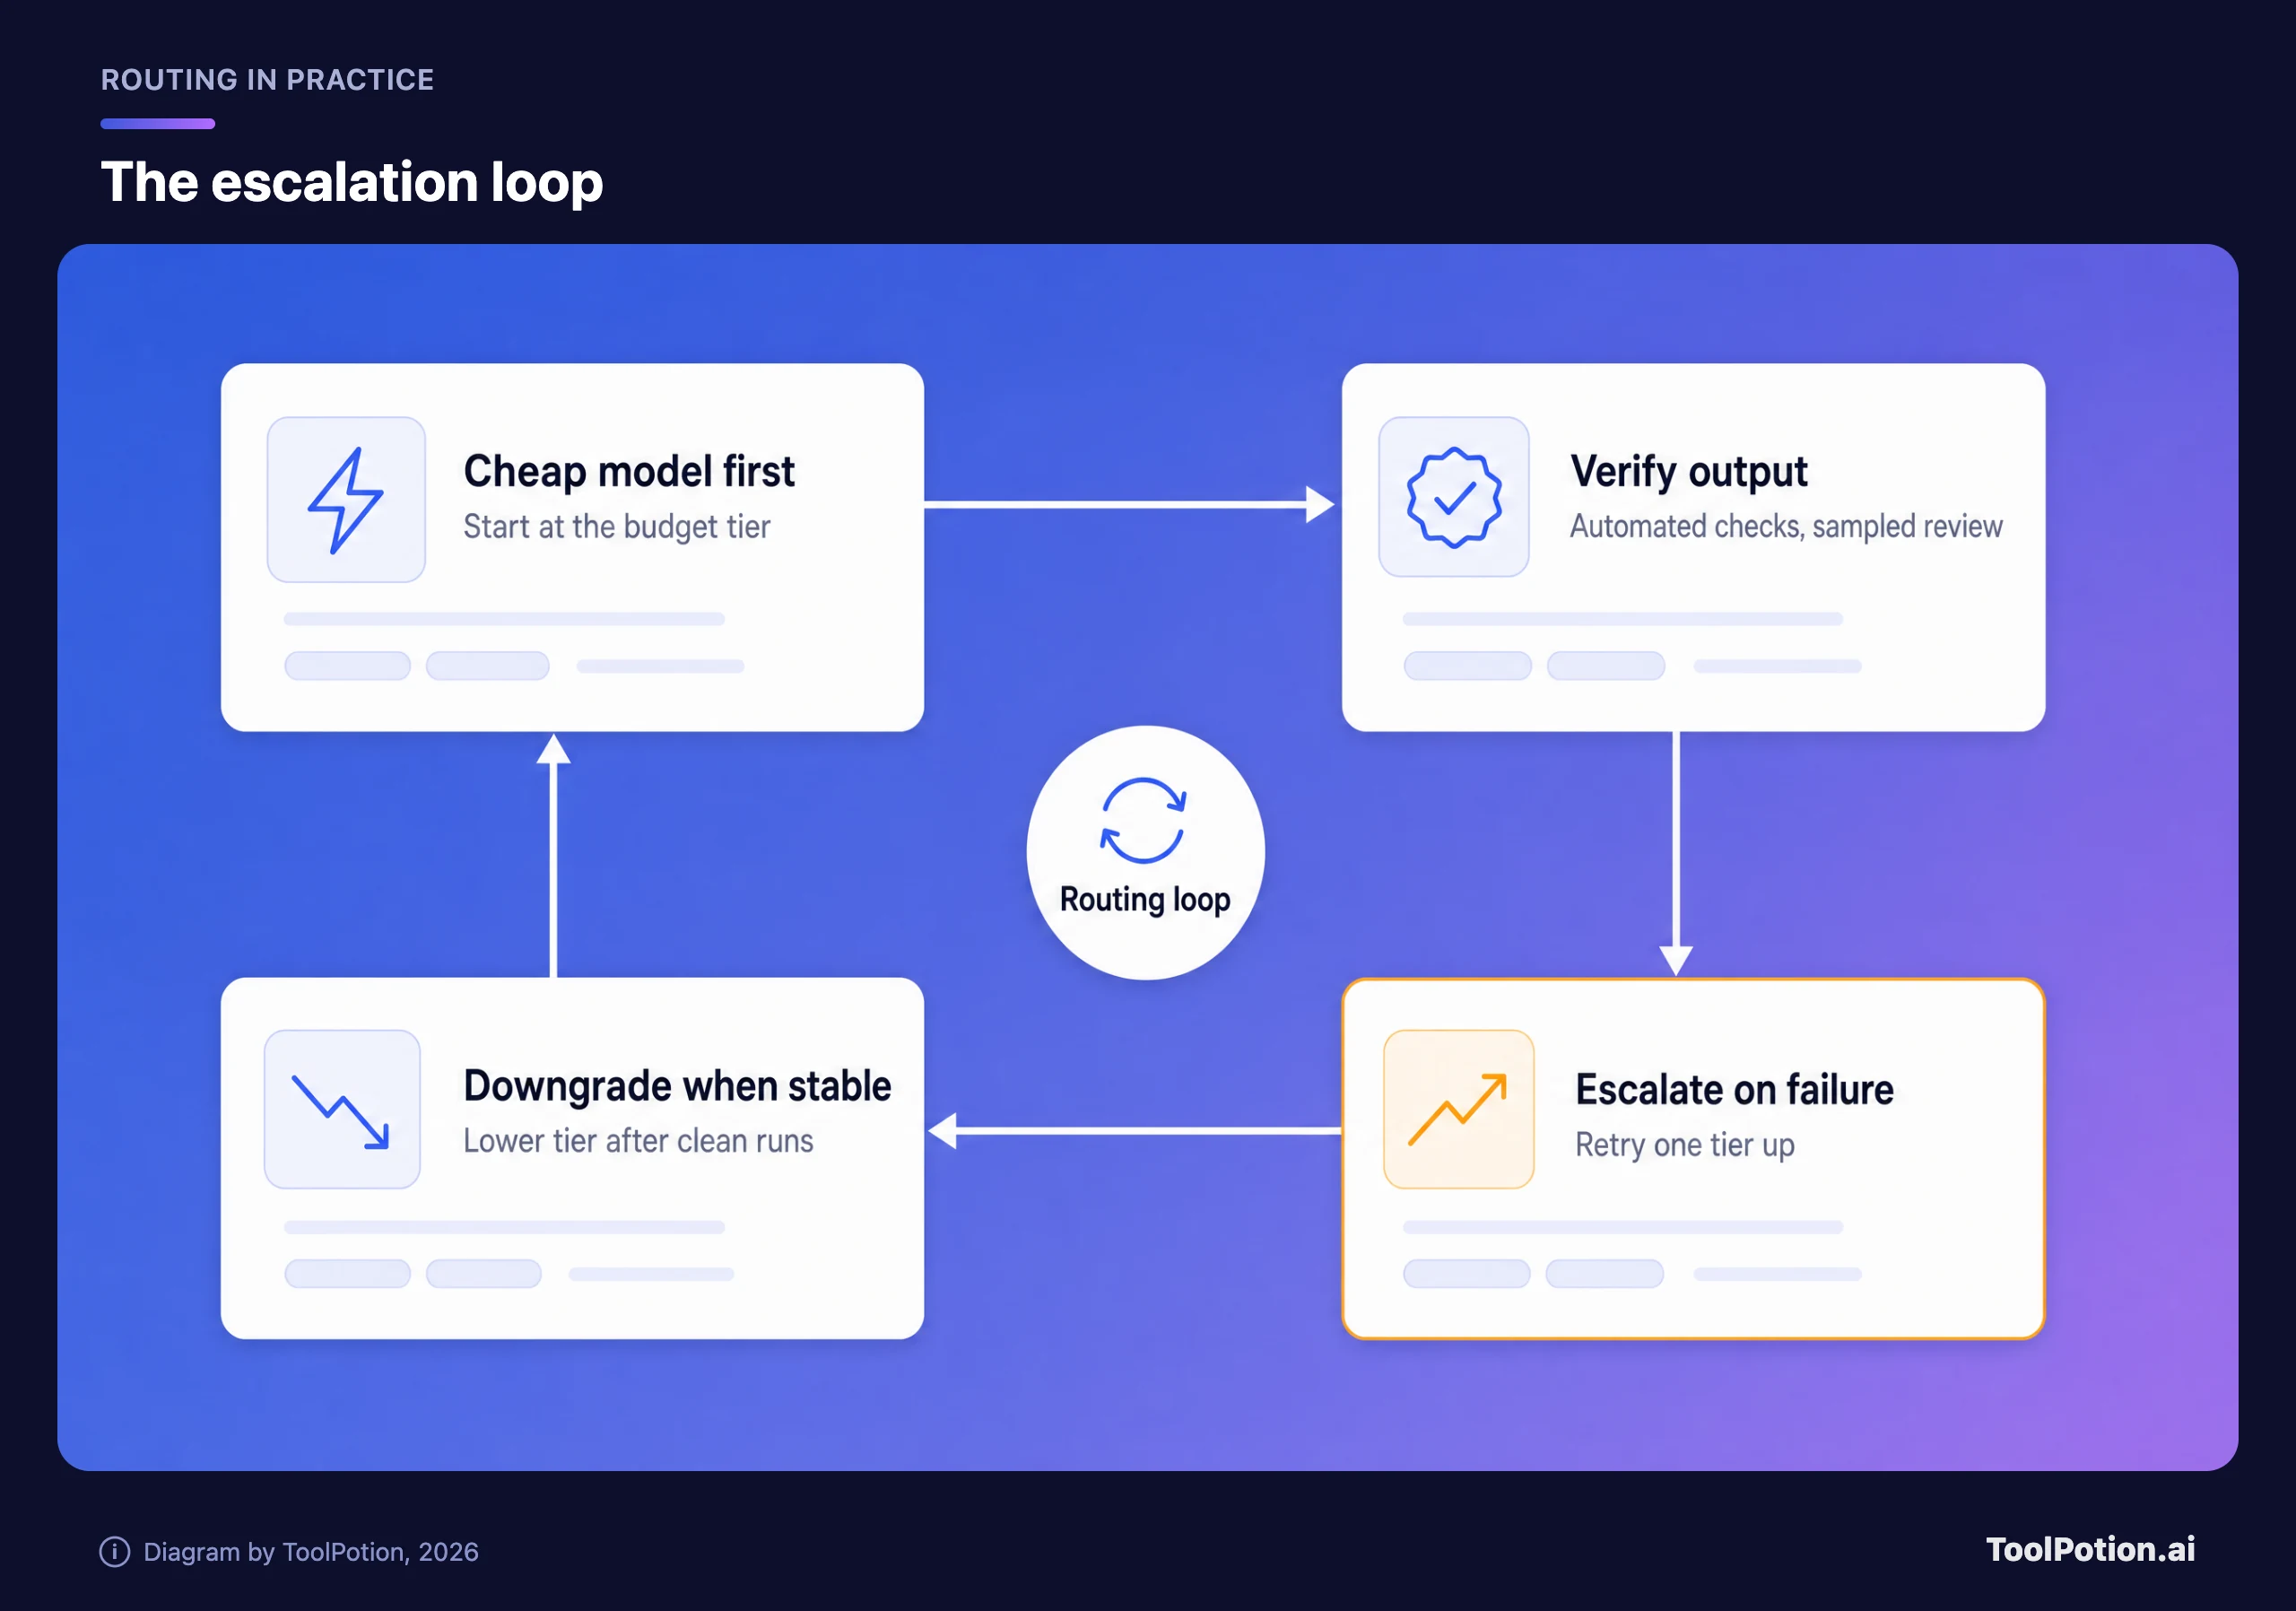
A verificação é a parte que as equipes pulam. Para saídas estruturadas, é fácil: valide o schema do JSON, confira se os campos extraídos aparecem na fonte, rode os testes unitários. Para texto corrido, é mais difícil, então separe uma pequena amostra para revisão humana e acompanhe a taxa de falha, em vez de olhar cada saída. Um modelo também pode avaliar o trabalho de outro, mas é um juiz ruidoso, então use-o para sinalizar candidatos a uma pessoa, não para aprová-los.
Quando uma verificação falhar, tente de novo uma vez, um nível acima. Registre a falha e o tipo de tarefa. Depois de uma sequência de execuções limpas, teste o nível abaixo em uma fatia do tráfego e veja se a taxa de falha se mantém. É assim que você descobre, com os seus próprios dados, quais tarefas o nível econômico realmente aguenta. Benchmarks de fornecedores não conseguem te dizer isso.
Uma ressalva sobre custo. Novas tentativas também custam dinheiro. Se mais do que uma pequena parcela das chamadas do nível barato escalar, você está pagando duas vezes e o loop está perdendo. Acompanhe a taxa de escalonamento. Se ela subir, aquela tarefa pertence permanentemente a um nível acima.
Onde as tarefas comuns se encaixam
A nossa classificação abaixo é editorial, não um benchmark. Ela reflete a lógica de volume e capacidade descrita acima, e você deve mover qualquer ponto com o qual os seus próprios testes discordarem.
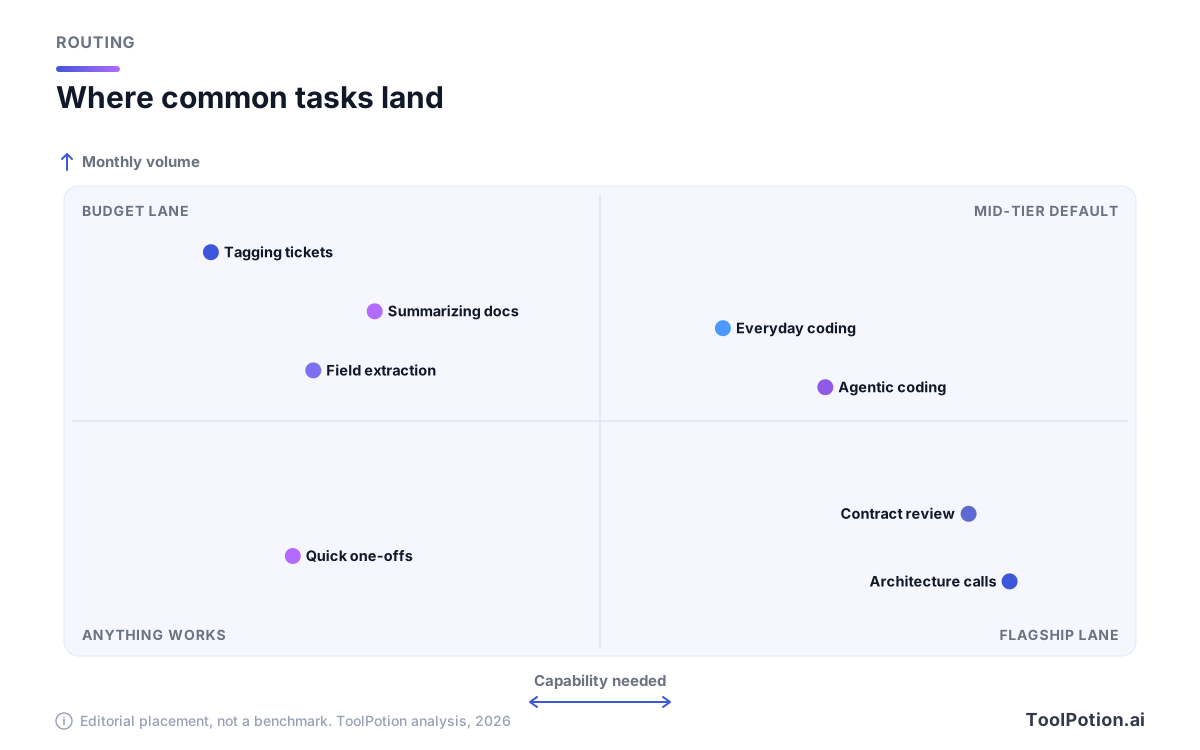
Vale detalhar alguns pontos. Classificação, extração de campos e resumos são os trabalhos econômicos clássicos, e os laboratórios vendem seus níveis mais baratos justamente para eles. Programação do dia a dia e redação de documentos ficam no nível intermediário. Revisão de contratos, decisões de arquitetura e tudo em que uma resposta errada sai caro justificam o flagship, embora até aí você possa usá-lo como revisor, e não como autor.
| Tarefa | Começar em | Subir quando | Por quê |
|---|---|---|---|
| Classificação e rotulagem de tickets | Econômico | Mais de poucos por cento falham na validação | Alto volume, resposta clara, verificação fácil |
| Resumos de documentos | Econômico ou intermediário | Os resumos perdem fatos importantes em checagens por amostragem | Risco baixo por item, grande volume total |
| Respostas a clientes | Intermediário | Erros de tom ou de política chegam aos clientes | Erros visíveis, volume moderado |
| Programação do dia a dia | Intermediário | Os testes falham após duas tentativas | O nível intermediário é o ponto ideal para agentes |
| Agentes de várias etapas | Intermediário, com limites | Uma etapa de verificação falha | Tentativas em paralelo sob um teto de custo |
| Contratos, finanças, segurança | Flagship | Raramente; adicione revisão humana | Erros são caros |
Faça as suas próprias contas
Aqui está a aritmética para um laboratório, usando as tarifas da Anthropic citadas acima. Informe quanto você gastaria com tudo no Opus 5.5 e depois vá deslocando trabalho para o Sonnet 5.5 e o Haiku 4.5. O gasto e as duas participações são editáveis. As tarifas são fixas e, como o Sonnet 5.5 custa exatamente metade do Opus 5.5 tanto na entrada quanto na saída, e o Haiku 4.5 custa um quarto, o resultado não depende da sua proporção entre entrada e saída.
Com os valores padrão, uma equipe que gasta US$ 3.600 por mês com o Opus 5.5 para tudo cai para cerca de US$ 2.070 ao mover 40% do trabalho para o Sonnet e 30% para o Haiku (30% de US$ 3.600 continuam a preço cheio, 40% a metade, 30% a um quarto). Isso é uma economia de aproximadamente 43%, com os 30% mais difíceis do tráfego ainda no flagship. As faturas reais variam, porque cache, descontos em lote e novas tentativas mudam a conta, então use isto como ferramenta de dimensionamento.
Se você não tem certeza de por onde começar em uma tarefa específica, a árvore abaixo faz três perguntas rápidas.
Planos por assento mudam a pergunta
Tudo acima pressupõe que você paga por token. Se a sua equipe paga por assento por um app de chat ou uma ferramenta de programação, quem decide o nível é o laboratório, e a sua alavanca é outra. A Anthropic aumentou os limites de uso de cinco horas nos planos Pro, Max, Team e Enterprise por assento junto com o lançamento do Opus 5.5 (Anthropic). Na prática, quem usa por assento deve escolher a opção de nível intermediário no seletor de modelos para o trabalho rotineiro, reservar o flagship para as sessões difíceis e verificar como os limites de uso do plano tratam cada modelo.
Se você não sabe qual modelo de cobrança as suas ferramentas usam, o nosso guia sobre modelos de preço de ferramentas de IA explica créditos, assentos e tokens. Um gateway como o OpenRouter vale a pena quando você quer uma única integração que troque de nível e de laboratório sem mudar código, já que toda a ideia de roteamento depende de trocar com baixo custo.
Erros que mantêm a fatura alta
- Escolher o nível por lealdade à marca e nunca testar de novo depois de um lançamento.
- Avaliar um nível com um único exemplo difícil, em vez de uma amostra do seu tráfego real.
- Mandar contextos longos para o flagship quando um modelo mais barato com recuperação (retrieval) resolveria.
- Ignorar o cache. A Anthropic cobra US$ 0,20 por milhão de tokens nas leituras de cache do Opus 5.5, o que pesa em loops de agentes que reenviam o mesmo contexto.
- Tratar benchmarks de fornecedores como previsão dos seus próprios resultados.
Os prompts também importam. Um prompt bem construído permite que um nível mais barato resolva tarefas que um prompt descuidado empurra para cima, e o nosso texto sobre padrões de prompt que sobrevivem a atualizações de modelo mostra como manter esse trabalho portátil. Para uma visão mais ampla dos modelos que existem, veja a nossa comparação dos melhores modelos de IA e LLMs e o ranking ao vivo dos Top 20 LLMs. Se você quer mais um assistente de chat do que uma API, o ranking de chatbots de IA e o nosso guia dos melhores chatbots de IA cobrem esse lado, e o ranking de assistentes de programação com IA e o panorama de assistentes de programação fazem o mesmo para desenvolvedores. Se você está avaliando rodar modelos por conta própria, IA local vs. IA na nuvem mostra quando isso compensa.
Perguntas frequentes
Qual modelo de IA devo usar se só puder escolher um?
Escolha o nível intermediário do laboratório que a sua stack já usa. Modelos da classe do Sonnet 5.5 ou do GPT-6.1 Sol dão conta da maior variedade de trabalho a um custo moderado, e você pode adicionar um nível mais barato ou mais forte depois, onde os dados justificarem.
Vale a pena pagar pelo flagship?
Sim, no conjunto restrito de chamadas em que um erro é caro ou em que o nível intermediário falha nas suas verificações com exemplos reais. É uma ferramenta de precisão, não um padrão.
Um modelo intermediário pode superar um flagship?
Os benchmarks da Anthropic mostram o Sonnet 5.5 à frente do Opus 5.5 em programação com agentes. É um resultado do fornecedor em um único tipo de tarefa, então teste no seu próprio trabalho antes de mudar um fluxo crítico.
Devo esperar pelo Haiku 5.5 ou pelo Gemini 4 Argon?
Não trave por nenhum dos dois. A Anthropic disse que o Haiku 5.5 chega nas próximas semanas, e o Google limitou o Argon a defensores cibernéticos de confiança por enquanto, sem disponibilidade geral. Monte a camada de roteamento de modo que um novo nível seja só uma mudança de configuração e refaça seus testes quando eles forem lançados.
Como sei se um nível mais barato é bom o suficiente?
Rode-o em uma amostra de entradas reais, aplique uma verificação automática e compare a taxa de falha com a do nível acima. Se a diferença for pequena e a tarefa tiver baixo risco, desça de nível. Se as falhas chegam aos clientes, não desça.
Esses preços valem para assinaturas de chat?
Não. São tarifas de API por milhão de tokens. Planos de chat e ferramentas de programação cobram por assento ou por limite de uso, então a economia vem de escolher modelos mais leves para as sessões de rotina.