

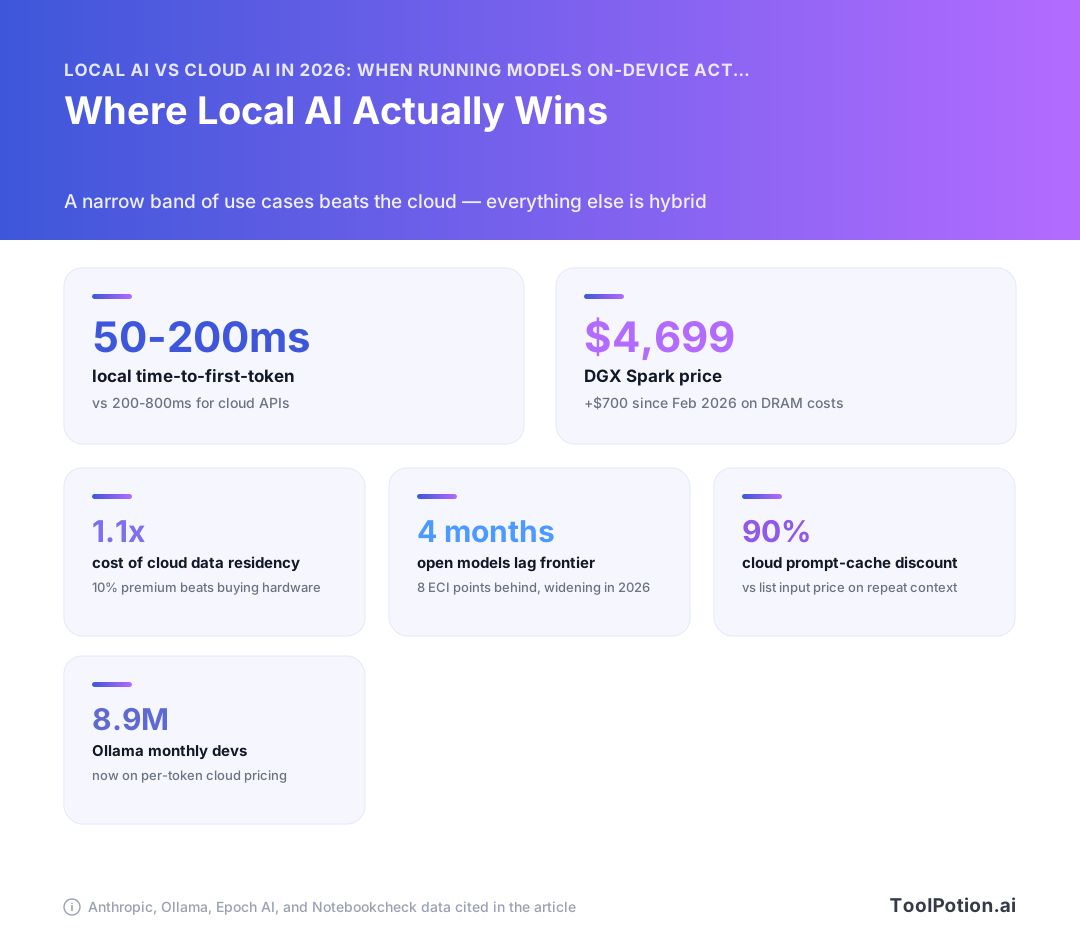
Compre a GPU apenas se você vai mantê-la ocupada. Essa é a resposta curta sobre IA local vs IA na nuvem em 2026: acima de aproximadamente 26% de uso diário sustentado, um equipamento local supera o pagamento por token. Abaixo disso, você está financiando silício ocioso nos preços de memória de 2026, e esses preços são ruins: a NVIDIA aumentou o DGX Spark de $3.999 para $4.699 em fevereiro de 2026, culpando os custos de DRAM e armazenamento (Notebookcheck).
Enquanto isso, o lado da nuvem ficou mais barato de formas que a maioria das comparações ignora. Leituras de cache de prompt custam 0,1x do preço de entrada, e o desconto de 50% do Batch se acumula por cima, levando o Claude Haiku 4.5 a $0,50 de entrada / $2,50 de saída por milhão de tokens (Anthropic).
Veja como essa matemática funciona, o que 24GB consegue rodar e onde está a linha divisória para o seu caso.
IA local vs IA na nuvem: o manual de 2026 quebrou em quatro pontos
A matemática do ponto de equilíbrio que você leu está errada, e não por um erro de arredondamento. Está errada porque o hardware ficou mais caro, a estatística de capacidade foi mal interpretada, as ferramentas mudaram de lado e a tabela de preços da nuvem caiu silenciosamente abaixo da planilha de todo mundo.
As três premissas que toda comparação ainda adota
Quase todo guia de local vs nuvem na primeira página de resultados se apoia nas mesmas três afirmações, todas datadas de 2024. Uma: o hardware tem custo fixo e decrescente, então você amortiza uma GPU de $1.999 em 18 meses e compara com o gasto por token. Duas: modelos de pesos abertos ficam três a seis meses atrás dos modelos de fronteira fechados, então o que você roda em casa está alguns trimestres defasado. Três: "local" significa Ollama na sua máquina e "nuvem" significa uma API de fronteira — uma disputa direta entre dois lados.
As três eram razoáveis em 2024. Nenhuma sobrevive ao contato com 2026.
O que mudou de 2024 até agora
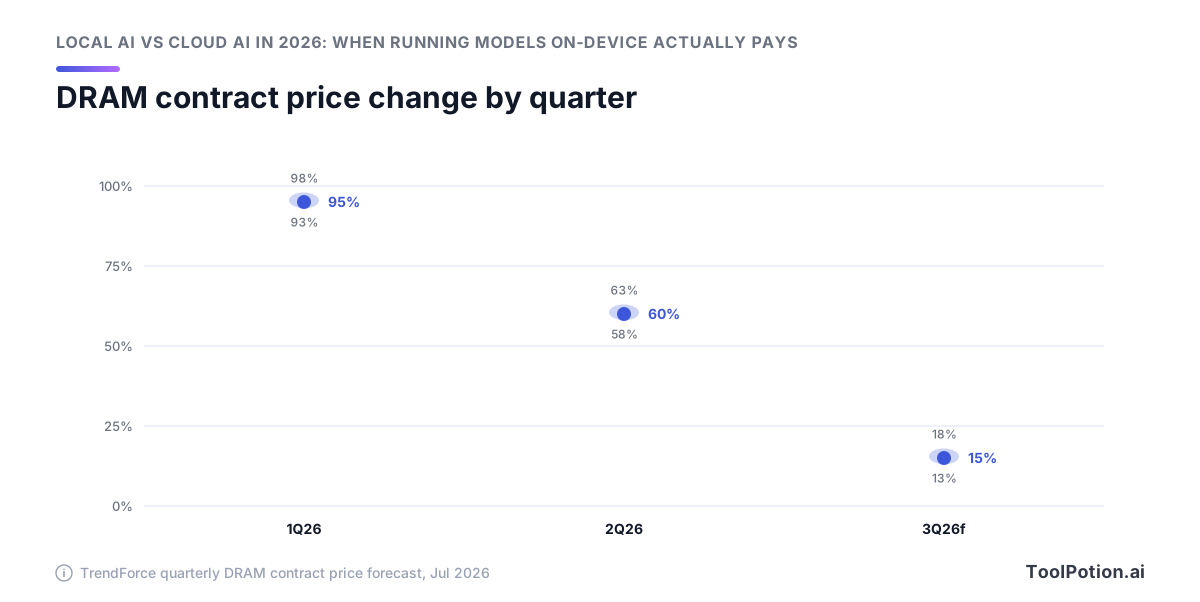
Comece pelo piso do hardware, porque ele se moveu na direção errada. A NVIDIA aumentou o DGX Spark de $3.999 para $4.699 em fevereiro de 2026, um aumento de $700 que atribuiu a custos em disparada de DRAM e armazenamento. Os preços de contrato de DRAM convencional subiram aproximadamente 93-98% trimestre a trimestre no 1T26 e ainda estão subindo 13-18% no 3T26. Qualquer calculadora citando MSRP está subestimando seu CapEx em quatro dígitos.
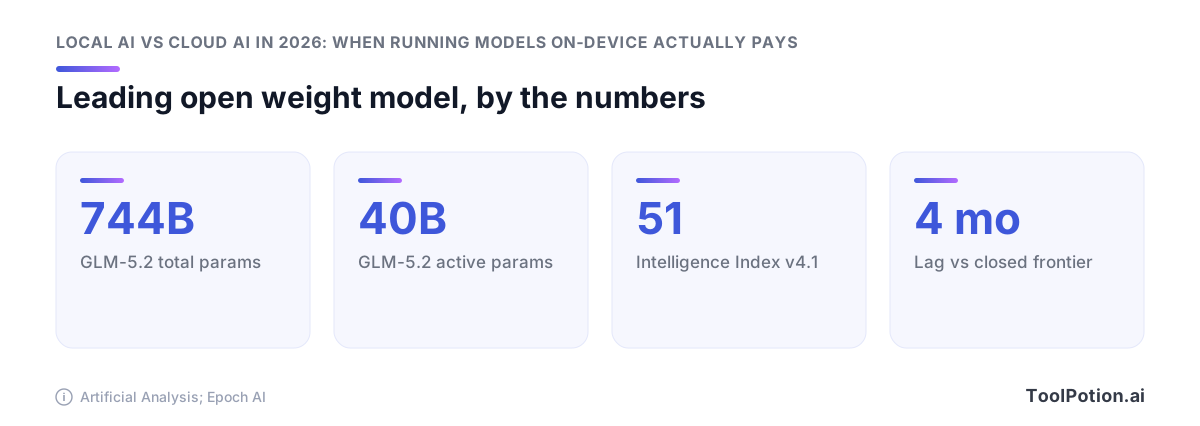
Depois, a lacuna de capacidade. O Epoch AI coloca o atraso em 4 meses, ou 8 pontos ECI desde janeiro de 2026, maior do que a média de 3 meses medida de janeiro de 2023 a outubro de 2025. O que ninguém cita: o modelo que sustenta essa afirmação, o GLM-5.2, tem 744B de parâmetros totais e 40B ativos. Isso é hardware de datacenter, não laptop.
A terceira ruptura é a mais estranha. Em 31 de agosto de 2026, o Ollama migrou os planos Pro, Max e Team para precificação de nuvem por token: $20, $100 e $500 por mês. A ferramenta padrão de "rodar localmente" agora vende tokens, o que transforma a comparação numa corrida de três vias entre sua GPU, pesos abertos hospedados baratos e APIs de fronteira. Se você está avaliando opções entre os modelos de IA que acompanhamos, o corredor do meio é o que deve precificar primeiro.
E o lado da nuvem ficou mais barato de formas que nenhuma calculadora publicada modela: leituras de cache de prompt a 0,1x do preço base de entrada, um desconto de 50% da API Batch que se acumula por cima, e fixação de inferência somente nos EUA por um multiplicador de 1,1x. Este último vende a propriedade de residência de dados que as pessoas compram hardware para ter, com um prêmio de 10% em vez de $4.699.
O que os modelos locais realmente fazem em 2026
Uma placa de 24GB em 2026 roda um bom modelo mixture-of-experts de 20-30B, e esse modelo vai rascunhar, resumir, classificar e raciocinar sobre problemas estruturados com uma qualidade que a maioria das equipes considera aceitável. Ele também vai inventar fatos com confiança sobre qualquer coisa fora de seus dados de treinamento. Essas duas frases são o mapa de capacidades, e a maioria dos guias de ponto de equilíbrio pula a segunda.
O teto do hardware para consumidor é a classe MoE de 20-30B
gpt-oss-20b e Qwen3-30B-A3B são o teto prático para uma única GPU de consumidor. Ambos são designs MoE esparsos, então a contagem de parâmetros ativos permanece pequena o suficiente para que uma placa de 24GB acomode os pesos e ainda tenha espaço para o contexto. Abaixo disso ficam os modelos densos Llama, Mistral e Phi de 7-14B, que cabem com mais conforto e sacrificam capacidade por isso. Nossas listagens de LLMs de pesos abertos se concentram fortemente nessa faixa, porque é o que as pessoas conseguem rodar em casa.
Forte em raciocínio, fraco em conhecimento de mundo
Passe a um modelo local de 30B um documento e peça para extrair campos, seguir um esquema ou percorrer uma cadeia de passos — ele se sai bem. Pergunte quem adquiriu quem em 2024 e você recebe ficção plausível.
A contagem de parâmetros é o que compra fatos memorizados, e um modelo de tamanho para consumidor descartou a maioria desses parâmetros. A recuperação (retrieval) fecha a lacuna: coloque os fatos no contexto e deixe o modelo local fazer a parte estruturada. Qualquer coisa que precise de amplo recall sem uma camada de recuperação por trás pertence a uma API de fronteira.
Por que a manchete de que os modelos abertos estão alcançando é sobre hardware que você não possui
O Epoch AI coloca a lacuna em 4 meses, ou 8 pontos ECI, desde janeiro de 2026, ligeiramente maior do que a média de 3 meses medida de janeiro de 2023 a outubro de 2025 (Epoch AI). O número é sólido e não diz nada sobre o seu laptop. O modelo que carrega a coroa de pesos abertos, o GLM-5.2, pontua 51 no Intelligence Index v4.1 da Artificial Analysis com 744B de parâmetros totais e 40B ativos (Artificial Analysis). Isso é hardware de datacenter. A mesma medição tem o GLM-5.2 consumindo 43.000 tokens de saída por tarefa, 37.000 deles tokens de raciocínio, o que resulta em aproximadamente $0,46 por tarefa contra $0,18 para o MiniMax-M3.
O que a quantização custa
Q4_K_M é o padrão por uma boa razão. No Mistral-7B-Instruct-v0.2 com llama.cpp em um Apple M1 Pro, levou o modelo de 7,2GB para 4,1GB — 43,1% menor — com 0,51% de perda de perplexidade (dasroot). Q2_K é onde a curva quebra, com 7,94% de perda de perplexidade, e você sente isso no seguimento de instruções muito antes de ver em um benchmark. Quantize para 4 bits, pare aí e gaste a memória economizada em comprimento de contexto.
O piso do hardware subiu, e subiu na direção errada
Toda calculadora de ponto de equilíbrio que você encontrar pressupõe que você pode comprar a máquina pelo preço de tabela. Em 2026, na maior parte das vezes você não consegue, e o próprio preço de tabela subiu.
A crise de memória, em preços que você pode verificar
Os preços de contrato de DRAM convencional subiram aproximadamente 93-98% trimestre a trimestre no 1T26, mais 58-63% no 2T26, e o TrendForce prevê mais 13-18% no 3T26 (TrendForce). Isso é desaceleração, não alívio. Os preços ainda estão subindo a partir de uma base que já dobrou. A demanda não vem de você: os datacenters estão absorvendo até 70% da produção mundial de memória em 2026, contra cerca de 20-30% em 2022, e o HBM sozinho consumiu 23% dos wafers de DRAM neste ano, contra 8% em 2024 (IDC). A inferência local é uma compra de capacidade de memória competindo com as pessoas que estão construindo as nuvens que você tenta evitar.
DGX Spark, RTX 5090 e a diferença entre MSRP e preço de mercado
A NVIDIA aumentou o DGX Spark de $3.999 para $4.699 em fevereiro de 2026, um aumento de $700 que a empresa atribuiu aos custos em disparada de DRAM e armazenamento (Notebookcheck). Seus 128GB de LPDDR5X são a razão pela qual ele é interessante para modelos locais, e também é a razão pela qual seu preço acompanha um mercado de commodities que você não controla.
Trate qualquer MSRP de 2025 citado em uma publicação comparativa como ficção. Verifique o que a peça está vendendo nessa semana e então faça seus cálculos com esse número.
A eletricidade é o item de custo que todo mundo esquece
Uma GPU é uma compra única que te envia uma conta todo mês. A eletricidade residencial dos EUA teve média de 18,34 ¢/kWh em junho de 2026, alta de 5,0% ano a ano, com estados variando de 8,96¢ no Novo México a 28,50¢ na Califórnia (EIA). O mesmo equipamento tem um custo operacional que varia mais de 3x dependendo de onde está plugado. Se você está na Califórnia, só a energia pode rivalizar com o que os tokens hospedados equivalentes custariam. No Novo México, o cálculo é diferente o suficiente para mudar a resposta.
O que um equipamento defensável em 2026 custa
Calcule o preço atual de mercado da máquina, adicione o consumo de energia à sua tarifa de energia real e adicione as horas que você gastará em frameworks de inferência local e ajuste de quantização que um endpoint hospedado não exige. Um número de CapEx de quatro dígitos com uma cauda de OpEx anual de três dígitos é o ponto de partida honesto, e ambas as metades pioraram neste ano por razões que não têm nada a ver com a qualidade dos modelos.
Ollama vs API na nuvem: a comparação agora é de três vias
Três preços importam agora: a GPU que você compra, pesos abertos hospedados e uma API de fronteira. A opção do meio vence para a maioria das cargas de trabalho, e é a que quase nenhuma fórmula publicada de ponto de equilíbrio inclui.
O próprio Ollama se tornou uma API na nuvem em 31 de agosto de 2026
A ferramenta que ensinou uma geração de desenvolvedores a rodar modelos em suas próprias máquinas agora vende tokens. Em 31 de agosto de 2026, o Ollama migrou os planos Pro, Max e Team para precificação de nuvem por token: $20/mês incluindo $60 de uso, $100/mês incluindo $300 e $500/mês incluindo $1.000 compartilhados entre usuários ilimitados, com zero retenção de dados e hospedagem nos EUA e Europa (Ollama). Portanto, "Ollama vs a nuvem" não descreve mais uma escolha real.
Pesos abertos hospedados: a opção do meio que ninguém modela
| Modelo | Entrada / saída por MTok | Fonte |
|---|---|---|
| nemotron-3-super (Ollama Cloud) | $0.015 / $0.60 | Ollama |
| deepseek-v4-flash (Ollama Cloud) | $0.22 / $0.66 | Ollama |
| qwen3.5:397b (Ollama Cloud) | $0.60 / $3.60 | Ollama |
| Claude Haiku 4.5 | $1.00 / $5.00 | Anthropic |
| Claude Sonnet 5 | $2.00 / $10.00 | Anthropic |
Leia as letras miúdas antes de construir uma previsão com esses números. A maioria das tarifas do Ollama Cloud dobra entre 12h00 e 18h00 UTC nos dias úteis (Ollama), o que transforma sua conta em uma questão de agendamento. Empurre trabalhos em lote para noites e fins de semana e você mantém a tarifa anunciada. Rode um produto interativo para usuários europeus no período da tarde e você paga a tarifa dobrada todos os dias úteis. Essa variável de horário merece mais atenção do que a escolha entre dois provedores de hospedagem com preços semelhantes.
APIs de fronteira são mais baratas do que seu preço de tabela sugere
Leituras de cache cobram 0,1x do preço base de entrada, a API Batch desconta 50% de entrada e saída, e os dois descontos se acumulam (Anthropic). O Haiku 4.5 em batch chega a $0,50 de entrada e $2,50 de saída por milhão de tokens, e o Sonnet 5 manteve seu preço introdutório de $2/$10 em vez de migrar para o programado $3/$15 em 1º de setembro de 2026 (Anthropic). O trabalho em lote assíncrono é exatamente para o que os equipamentos locais são anunciados, e é a carga de trabalho onde os descontos da nuvem mordem com mais força.
A nota de rodapé do tokenizador que vai na direção contrária
O Claude 4.7 e versões posteriores usam um tokenizador mais novo que produz aproximadamente 30% mais tokens para o mesmo texto (Anthropic). Sua conta real do Sonnet 5 em um corpus fixo fica cerca de 30% acima do que o cartão de $2/$10 implica ao comparar com um modelo local com tokenizador mais antigo. Conte os tokens no seu próprio texto com ambos antes de se comprometer.
Calculando o ponto de cruzamento: em que volume sua GPU vence?
O hardware próprio começa a superar os pesos abertos hospedados em torno de 26% de utilização diária sustentada da GPU — aproximadamente seis horas por dia de trabalho real todo dia — amortizado contra os preços de hardware de 2026 e sua tarifa de energia local. Abaixo dessa linha, a placa fica ociosa enquanto o relógio de depreciação corre. Calcule seu volume contra a tarifa hospedada antes de comprar: o deepseek-v4-flash roda a $0,22 de entrada e $0,66 de saída por milhão de tokens no Ollama Cloud (Ollama).
Onde o local vence (uma lista curta e nomeável)
Quatro casos resistem ao escrutínio. Todo o restante é uma configuração híbrida onde você direciona as consultas fáceis para um modelo local e escala o resto.
Trabalho em lote de alto volume sustentado que mantém a placa ocupada
Se sua GPU fica ociosa 90% do dia, você comprou um aquecedor de ambiente. O caso para compra exige que a placa trabalhe mais de um quarto do dia, todo dia, e precisa sobreviver à comparação com a API Batch do Claude, que corta tokens de entrada e saída em 50% e se acumula com o cache de prompt (Anthropic). Isso coloca o trabalho em lote do Haiku 4.5 a $0,50 por milhão de tokens de entrada e $2,50 de saída. Seu equipamento local tem que superar isso com hardware amortizado mais eletricidade, e a 18,34 ¢/kWh de média residencial dos EUA em junho de 2026 (EIA), uma placa com carga real também não é gratuita. Faça os cálculos com seu volume real de tokens antes de fazê-los com uma ficha técnica.
Soberania de dados rígida, CLOUD Act e não apenas GDPR
Existe uma categoria real aqui, e ela é mais estreita do que a maioria das pessoas afirma. A conformidade com o GDPR é um problema contratual. Um requisito de que nenhuma entidade sob jurisdição dos EUA possa ser compelida a produzir seus dados é um problema físico, e problemas físicos são resolvidos com hardware que você controla.
Loops interativos onde o tempo para o primeiro token é o produto
A inferência local entrega 50-200ms de tempo para o primeiro token contra 200-800ms para a nuvem, com o Claude Haiku 4.5 medido em 597ms e o GPT-4.1 Mini em torno de 2.400ms (Eden AI). Para uma janela de chat, ninguém nota. Para completar código inline, ou um agente multi-etapas encadeando oito chamadas, essa diferença se acumula em algo que os usuários sentem. Se você está construindo nesse formato, navegue pelos agentes de IA no nosso diretório e veja quantos deles fazem uma viagem de ida e volta por tecla pressionada.
Operação offline e air-gapped
Sem argumento a fazer. Ou a rede está lá ou não está.
O argumento de privacidade que a nuvem agora vende de volta para você
O contra-argumento mais forte ao caso dois é que a Anthropic vende a propriedade diretamente. No Claude 4.6 e versões posteriores, fixar a inferência somente nos EUA com inference_geo: "us" custa um multiplicador de 1,1x em todas as categorias de token (Anthropic). Isso é um prêmio de 10% em vez de $4.699 do DGX Spark. Os planos pagos do Ollama, por sua vez, anunciam zero retenção de dados hospedados nos EUA e Europa a partir de 31 de agosto de 2026 (Ollama). Se o seu requisito de privacidade é satisfeito por uma garantia contratual e um pin geográfico, você não tem um requisito de hardware.
A configuração híbrida em que a maioria dos profissionais acaba
Direcione por dificuldade, não por princípio. Um modelo MoE de 20-30B na sua própria placa lida com aproximadamente sete de cada dez consultas em uma carga de trabalho típica de assistente ou processamento de documentos, e as três restantes vão para uma API de fronteira. Essa divisão é a arquitetura. Todo o restante é ajuste.
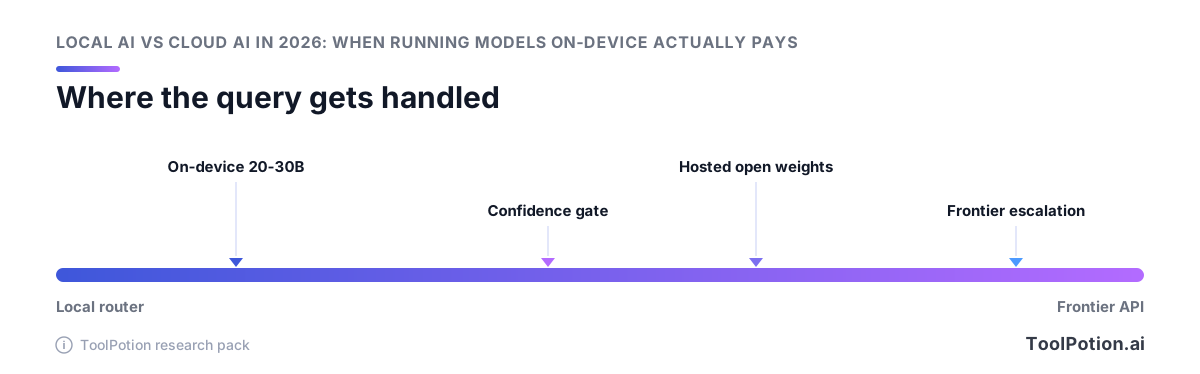
Três sinais decidem a escalação, e você pode calcular todos antes do modelo local terminar: a própria confiança do modelo (margem de log-prob ou uma auto-verificação barata), se a consulta precisa de conhecimento de mundo que os pesos locais não têm, e o comprimento do contexto. O de conhecimento pega a maioria das suas falhas. Um modelo de classe 24GB raciocina bem e recorda mal, então qualquer coisa que pareça com "quem adquiriu quem em 2025" deve pular o local completamente.
Uma stack concreta que funciona
Ollama ou LM Studio na frente, uma API de fronteira atrás e um roteador fino no meio que registra cada decisão.
Envie o tráfego escalado para o Claude Haiku 4.5 a $1/MTok de entrada e $5/MTok de saída primeiro, e só recorra ao Sonnet 5 a $2/$10 quando a resposta do Haiku falhar na sua verificação (preços Anthropic). Se o trabalho escalado for assíncrono, coloque em batch: a API Batch reduz ambos os lados pela metade, então o Haiku chega a $0,50/$2,50. A maioria das equipes pula isso e paga o preço de tabela em trabalho que poderia ter esperado vinte minutos.
Instrumente a taxa de escalação ou você está voando às cegas
Registre quatro números por requisição: qual nível a atendeu, a confiança do modelo local, contagens de tokens e se um humano tentou novamente a resposta. A taxa de novas tentativas é seu sinal real de qualidade. Se a escalação ficar abaixo de cerca de 20%, seu modelo local está respondendo coisas que não deveria e você vai ver isso nas novas tentativas. Acima de 45% e a GPU não está ganhando sua depreciação.
Por que o limite muda todo trimestre
Os preços de ambos os lados se movem mais rápido do que sua arquitetura. O Ollama ajustou os preços dos planos Pro, Max e Team para cobrança de nuvem por token em 31 de agosto de 2026 (Ollama), as tarifas do Ollama Cloud dobram entre 12h00 e 18h00 UTC nos dias úteis (preços Ollama), e a capacidade dos modelos de pesos abertos fica cerca de 4 meses atrás dos modelos de fronteira fechados em média desde janeiro de 2026 (Epoch AI). Recalcule seus limites de roteamento com números atualizados uma vez por trimestre. Coloque no calendário.
A camada de ferramentas é estável o suficiente para construir sobre ela
O Ollama roda com 8,9 milhões de desenvolvedores ativos mensalmente com uma equipe de 14 pessoas, está dentro de 85% da Fortune 500 e captou $65M liderado pela Theory Ventures em julho de 2026 (TechCrunch). Esse não é um projeto que desaparece no próximo ano. O roteador ao redor é a parte que você possui, e você pode aproveitar a maior parte dele dos repositórios open-source de IA que já publicam esse padrão.
Decida em cinco perguntas
Responda nessa ordem. A primeira que der um sim definitivo decide sua configuração, e você pode parar aí.
Você tem um requisito rígido de soberania?
Rígido significa air-gapped, exposição ao CLOUD Act que o jurídico colocou por escrito, ou um contrato que nomeia a máquina. Se for seu caso, compre o hardware e pare de ler a seção de custos. Se seu requisito for mais flexível do que isso, a Anthropic vai fixar a inferência somente nos EUA com inference_geo: "us" no Claude 4.6 e versões posteriores por um multiplicador de 1,1x em todas as categorias de token (documentação de preços Anthropic), e os planos pagos do Ollama rodam com zero retenção de dados nos EUA e Europa (Ollama). Um prêmio de 10% supera $4.699 de hardware para quase todo mundo.
Seu trabalho é limitado por latência ou por throughput?
Loops interativos onde uma pessoa espera por cada token favorecem o local: 50-200ms até o primeiro token contra 200-800ms para a nuvem, com o Claude Haiku 4.5 medido em 597ms (Eden AI). O trabalho de throughput vai na direção contrária. Coloque em batch e aproveite o desconto de 50%, que coloca o Haiku 4.5 a $0,50/MTok de entrada e $2,50 de saída (Anthropic).
A GPU vai ficar ocupada mais de um quarto de cada dia?
Abaixo dessa linha, sua placa está depreciando ociosa e os pesos abertos hospedados vencem em custo. Acima disso, a matemática local começa a funcionar. Seja honesto com o denominador, já que noites e fins de semana contam.
Sua tarefa precisa de conhecimento de mundo ou apenas de raciocínio?
Raciocinar sobre texto que você fornece funciona bem em um modelo MoE de 20-30B. Perguntas que dependem de fatos que o modelo precisa já saber pertencem a uma API de fronteira, ou ao GLM-5.2 hospedado, que tem 744B de parâmetros totais e nunca cabe no seu laptop (Artificial Analysis).
Você consegue tolerar reajustes todo trimestre?
A lacuna entre aberto e fechado está em 4 meses e saiu de uma média de 3 meses (Epoch AI), então seu limite de roteamento tem prazo de validade. Equipes que não vão revisitá-lo devem usar por padrão uma API de fronteira com cache ativo e não direcionar nada. Equipes que vão podem consultar estudos de caso reais de implantação para ver em que limites outras pessoas chegaram.
O que mudaria esse veredicto em 2027
Este conselho tem prazo de validade, e há três números específicos que o definem.
Os preços de memória estão desacelerando, não caindo
Os preços de contrato de DRAM convencional subiram aproximadamente 93-98% trimestre a trimestre no 1T26, depois 58-63% no 2T26, com previsão de 13-18% para o 3T26. Essa curva está se achatando. Ainda aponta para cima. Uma taxa de aumento menor não devolve os $700 que a NVIDIA adicionou ao DGX Spark em fevereiro de 2026, e nada na previsão indica que os preços de mercado cairão no próximo ano. Planeje que o caso para hardware continuará fraco até 2027, a menos que a demanda dos datacenters alivie.
Observe a lacuna aberto/fechado, não o benchmark da manchete
Dois sinais importam mais do que qualquer posição no leaderboard. O primeiro é a lacuna ECI do Epoch AI, que estava em 4 meses, ou 8 pontos, desde janeiro de 2026. O segundo é a contagem de parâmetros ativos: o GLM-5.2 lidera em pesos abertos com 40B ativos de 744B totais, então o dia que um modelo com menos de 30B ativos chegar a poucos pontos ECI da fronteira, a placa de 24GB ficará interessante novamente. Também observe se a duplicação de horário de pico do Ollama (12h00-18h00 UTC nos dias úteis) se mantém ou se normaliza. Nossos relatórios de tendências de IA acompanham os lançamentos de modelos que mudariam qualquer um desses pontos.
Perguntas Frequentes
É mais barato rodar um LLM localmente ou usar uma API na nuvem em 2026?
Para a maioria das pessoas, a nuvem, e a diferença aumentou em 2026. O Claude Haiku 4.5 custa $1 por milhão de tokens de entrada e $5 por milhão de saída, cai para $0,50/$2,50 pela API Batch, e os hits de cache de prompt cobram 0,1x da tarifa base de entrada (preços Anthropic). Do outro lado, um NVIDIA DGX Spark subiu de $3.999 para $4.699 em fevereiro de 2026 por causa dos custos de DRAM e armazenamento (Notebookcheck), e você ainda paga energia a uma média residencial dos EUA de 18,34 ¢/kWh em junho de 2026 (EIA). O local ganha dinheiro em trabalho em lote de alto volume sustentado que mantém a placa ocupada boa parte de cada dia, em operação air-gapped e em loops sensíveis à latência.
Qual hardware preciso para rodar um LLM localmente em 2026?
Uma GPU de 24GB é o piso prático para consumidor, e te limita à classe mixture-of-experts de 20-30B, bem longe da fronteira de pesos abertos. Acima disso, você está comprando uma caixa de 128GB LPDDR5X como o DGX Spark, que agora custa $4.699 (Notebookcheck). Calcule preços de memória que continuam subindo: os preços de contrato de DRAM convencional subiram cerca de 93-98% trimestre a trimestre no 1T26 e 58-63% no 2T26, com mais 13-18% previstos para o 3T26 (TrendForce). A quantização estica o que cabe, e 4 bits é quase gratuito: Q4_K_M encolheu o Mistral-7B-Instruct-v0.2 de 7,2 GB para 4,1 GB com 0,51% de perda de perplexidade, enquanto Q2_K degradou significativamente a 7,94% (comparação de quantizações).
Quão bons são os modelos locais comparados ao Claude ou GPT?
A lacuna amplamente citada é real, mas descreve hardware que você provavelmente não possui. O Epoch AI mediu modelos de pesos abertos ficando em média 4 meses, ou 8 pontos ECI, atrás dos modelos de fronteira fechados desde janeiro de 2026, ligeiramente maior do que a média de 3 meses de janeiro de 2023 a outubro de 2025 (Epoch AI). O modelo que sustenta essa afirmação, o GLM-5.2, pontua 51 no Intelligence Index v4.1 da Artificial Analysis com 744B totais e 40B parâmetros ativos, que é hardware de datacenter (Artificial Analysis). O que realmente cabe em um laptop ou em uma única GPU é forte em raciocínio estruturado e fraco em conhecimento de mundo, então trate a figura de 4 meses como um teto que você não consegue alcançar em casa.
O Ollama ainda é gratuito e como os preços do Ollama Cloud se comparam às APIs de fronteira?
A distinção local-versus-Ollama deixou de fazer sentido em 31 de agosto de 2026, quando o Ollama migrou seus planos Pro, Max e Team para precificação de nuvem por token: $20/mês incluindo $60 de uso, $100/mês incluindo $300 e $500/mês incluindo $1.000 compartilhados entre usuários ilimitados, com zero retenção de dados hospedados nos EUA e Europa (blog Ollama). Os pesos abertos hospedados são baratos lá: o deepseek-v4-flash roda a $0,22 de entrada e $0,66 de saída por milhão de tokens, o nemotron-3-super a $0,015/$0,60, o qwen3.5:397b a $0,60/$3,60, embora a maioria das tarifas dobre durante o horário de pico de 12h00 a 18h00 UTC nos dias úteis (preços Ollama). Compare isso com o Claude Haiku 4.5 a $1/$5 (preços Anthropic) e a decisão real é de três vias, com pesos abertos hospedados superando sua própria GPU em custo para a maioria das cargas de trabalho. O Ollama tem escala para ser levado a sério de qualquer forma, com 8,9 milhões de desenvolvedores ativos mensalmente e 85% da Fortune 500 (TechCrunch).
Rodar um modelo localmente realmente torna meus dados mais privados do que uma API na nuvem?
Te dá uma propriedade que nada mais oferece: os bytes nunca saem da sua máquina, e isso importa para trabalho air-gapped e para requisitos rígidos de soberania de dados como o CLOUD Act. Para tudo menos rigoroso do que isso, os provedores agora vendem a mesma garantia a baixo custo. No Claude 4.6 e versões posteriores, fixar a inferência somente nos EUA com inference_geo: "us" custa um multiplicador de 1,1x em todas as categorias de token (preços Anthropic), e os planos pagos do Ollama rodam com zero retenção de dados nos EUA e Europa (blog Ollama). Um prêmio de 10% é um compromisso muito menor do que $4.699 de hardware (Notebookcheck).
Qual modelo local devo começar com uma GPU de 24GB?
Comece com um modelo mixture-of-experts de 20-30B como o Qwen3-30B-A3B ou o gpt-oss-20b, quantizado para Q4_K_M. Essa classe pontua 73-87% no AIME 2024 em um único RTX 5090, então o raciocínio se mantém bem, enquanto o recall factual sobre o mundo é onde fica aquém. Q4_K_M é o ponto certo de quantização: reduziu um modelo de 7,2 GB para 4,1 GB com 0,51% de perda de perplexidade, e Q2_K degradou significativamente a 7,94% (comparação de quantizações). Rode-o como o primeiro salto e escale consultas com uso intenso de conhecimento para um modelo na nuvem.