

Os padrões de engenharia de prompt que sobrevivem a uma atualização de modelo são aqueles que carregam informações que o modelo não consegue inferir: um papel que define o público, contexto que ele não possui, uma tarefa com uma regra de decisão e um contrato de saída aplicado fora do prompt. Todo o resto é folclore com prazo de validade.
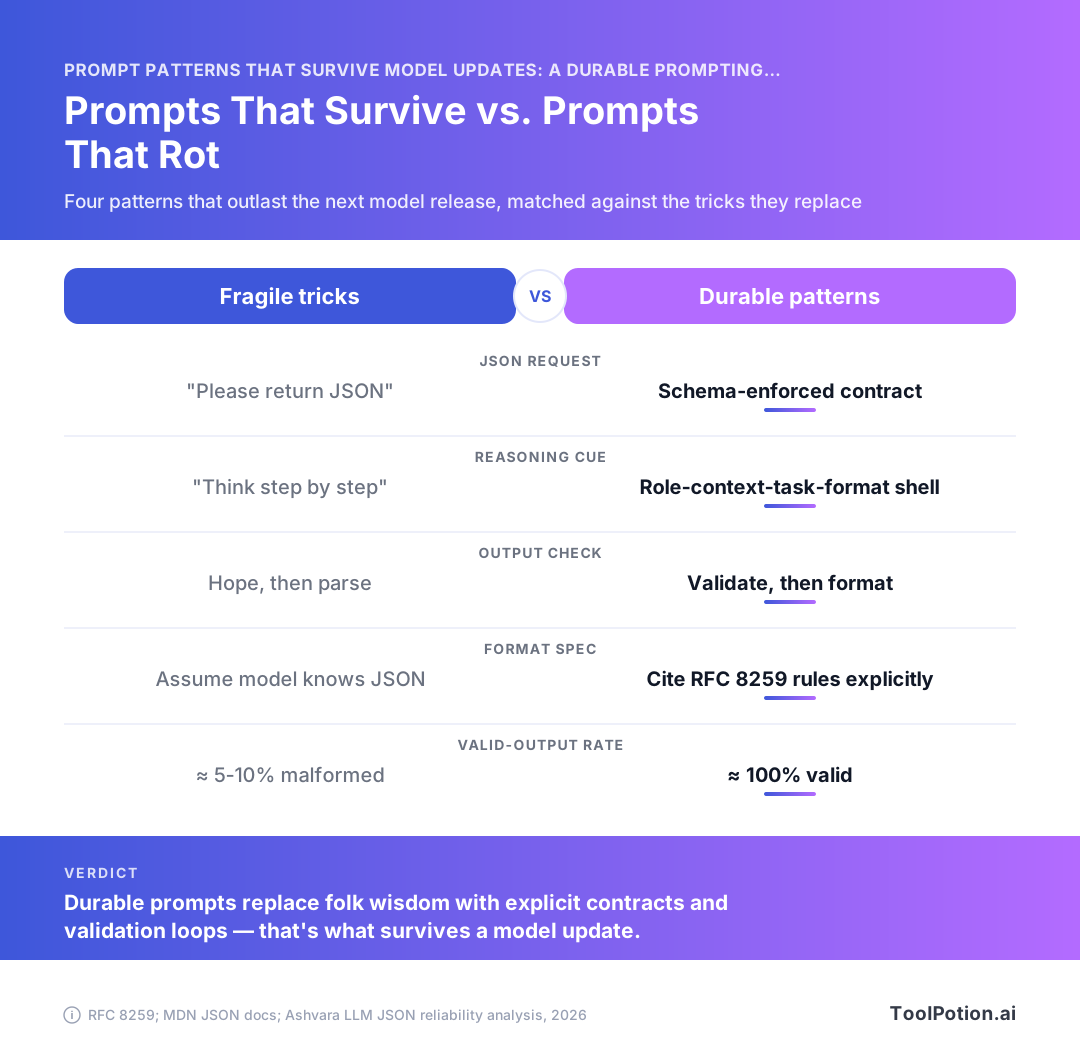
Você consegue ver essa divisão com mais clareza no JSON. Pedir educadamente ao modelo para retornar JSON deixa cerca de 5 a 10% das saídas malformadas, o modo JSON chega a aproximadamente 95-99% de saídas válidas, e a decodificação restrita a um schema é efetivamente 100% (Ashvara). A mesma intenção, três camadas de aplicação, taxas de falha completamente diferentes no dia do lançamento.
Este playbook cobre quatro padrões que continuam funcionando no Claude, no GPT e no Gemini, os truques frágeis que valem a pena remover da sua biblioteca, e um pequeno conjunto de avaliações que transforma o próximo lançamento de modelo em um diff em vez de um incidente.
Por que os prompts apodrecem: o modo de falha que ninguém versiona
Prompts não decaem aleatoriamente. Eles decaem ao longo de uma costura previsível: as partes que dependem de como um modelo específico se comportava são invalidadas pelo próximo checkpoint, e as partes que declaram o que você quer sobrevivem a isso.
Dois tipos de prompt: os que descrevem intenção e os que exploram uma peculiaridade
Um prompt de intenção diz o que a saída precisa ser, quem a lê e o que conta como erro. Um prompt de peculiaridade diz o que por acaso funcionou na última terça-feira. APENAS RETORNE JSON em caixa alta. Três repetições da mesma instrução porque duas não foram suficientes. Um preâmbulo mágico copiado de um fórum. Esses truques foram ajustados ao comportamento de decodificação de um checkpoint específico, e nada neles diz a um modelo futuro o que você realmente precisa.
A abordagem ingênua de "por favor retorne JSON" ainda produz uma estimativa de 5 a 10% de saídas malformadas (Ashvara), e esse número é uma propriedade do modelo, não do seu prompt. Troque o modelo e o número muda. Você nunca registrou o contrato, então não tem nada para cobrar do novo modelo.
O que realmente quebra no dia do lançamento
A quebra raramente é barulhenta. Seu parser começa a falhar em uma vírgula final (cerca de 40% dos erros de JSON em uma análise vêm exatamente disso, Flying Fish Space), ou o modelo fica mais conversacional e envolve uma saída limpa em uma frase de preâmbulo. Enquanto isso, o ritmo de novos lançamentos de modelos significa que o checkpoint que você ajustou pode não ser o que estará servindo tráfego no próximo trimestre.
Compare isso a uma chamada restrita por schema, onde a geração é limitada ao formato que você forneceu e a validade sintática é essencialmente 100% (Ashvara). A aplicação vive fora do texto do prompt. Uma atualização de modelo pode mudar tom, verbosidade e profundidade de raciocínio sem tocá-la.
O teste de durabilidade: este prompt ainda faria sentido para um modelo mais capaz?
Uma pergunta, feita a cada prompt que você possui: se o modelo ficasse duas vezes mais capaz de um dia para o outro, essa instrução ainda estaria fazendo um trabalho útil?
"Retorne um objeto com as chaves id, status e confidence, onde status é um dos três valores literais" passa. A RFC 8259 já fixa o vocabulário que você está usando: quatro tipos primitivos, dois tipos estruturados, e exatamente três nomes literais em minúsculo (RFC 8259). Essa instrução é legível para qualquer modelo, agora ou no futuro. "Respire fundo e pense passo a passo" falha, porque está compensando uma fraqueza que o próximo lançamento pode não ter. Delete as compensações e mantenha os contratos.
Padrões de engenharia de prompt que se transferem: papel, contexto, tarefa, formato
Reestruture cada prompt ad-hoc em quatro slots e coloque apenas informações que o modelo não consegue inferir em cada um deles. Papel, contexto, tarefa, formato. O shell sobrevive a atualizações de modelos porque cada slot carrega fatos sobre seu problema, não folclore sobre como o checkpoint do trimestre passado respondia a elogios.
Os quatro slots e o que pertence a cada um
Papel é para quem a saída se destina e qual expertise a resposta pressupõe. "Você é um especialista de classe mundial" define um clima e não carrega nenhuma informação. "Você está escrevendo para um engenheiro de pagamentos que já sabe o que é uma chave de idempotência" diz ao modelo quais explicações ele pode omitir.
Contexto é tudo que o modelo não tem como saber: o schema, o sistema upstream, os casos extremos que você já enfrentou em produção, o fato de que seu parser rejeita um BOM UTF-8. Tarefa é o verbo único e seu objeto. Formato é o contrato de saída, e deve ser específico o suficiente para validação mecânica.
Um slot de formato que diz "retorne JSON" é um desejo. Um slot de formato que nomeia as chaves, seus tipos e o que acontece quando um valor é desconhecido é um contrato que você pode testar. JSON oferece quatro tipos primitivos (string, number, boolean, null) e dois tipos estruturados, objetos e arrays (RFC 8259), então há um vocabulário pequeno e finito para ser preciso. Diga null em vez de "deixe em branco", porque os nomes literais true, false e null são em minúsculo e nada mais é válido (RFC 8259).
Por que o shell se transfere entre Claude, GPT e Gemini
Nada nos quatro slots depende de um tokenizador, de uma peculiaridade do system prompt ou de uma flag de recurso do provedor. Todo modelo precisa ser informado sobre quais campos você quer e o que seu código downstream faz com eles, então o mesmo shell se encaixa no Claude, no GPT e no Gemini sem nenhuma reescrita. Essa portabilidade é também o que o torna atualizável: quando um novo checkpoint é lançado, o slot de contexto ainda é verdadeiro e o slot de formato ainda é o contrato que seu validador aplica. Você troca o modelo, reexecuta as avaliações e o diff está vazio.
A maioria das 212 ferramentas de engenharia de prompt que modela essa estrutura em nosso diretório está vendendo os slots como um formulário. Você pode obter o mesmo efeito com um heredoc e quatro comentários.
Escrevendo restrições como fatos, não como encantamentos
Há um teste para saber se uma linha pertence ao seu prompt: um contratado competente conseguiria agir com base nela sem fazer uma pergunta de acompanhamento? "Seja minucioso" falha. "Nomes de propriedades são entre aspas duplas, sem vírgula final após o último elemento" passa, e mapeia modos de falha reais, já que vírgulas finais sozinhas respondem por cerca de 40% dos erros de JSON em uma análise (Flying Fish Space).
Um encantamento para de ganhar seus tokens sem nunca falhar em voz alta, enquanto um fato declarado mantém seu significado em todos os checkpoints para os quais você o aponta.
Uma reescrita antes/depois trabalhada
| Antes (ad-hoc) | Depois (quatro slots) |
|---|---|
| "Você é um analista de dados especialista. Extraia cuidadosamente os detalhes da fatura e retorne JSON. Seja preciso!" | Papel: a saída é consumida por uma chamada json.loads em Python, nenhum humano a lê. Contexto: as faturas são PDFs com OCR; nomes de fornecedores são frequentemente truncados; valores podem conter símbolo de moeda. Tarefa: extrair vendor, invoice_number, total_cents, issued_date. Formato: um objeto JSON, chaves exatamente como listadas, total_cents um inteiro sem zeros à esquerda, valores desconhecidos como null, sem texto antes ou depois. |
A versão depois não diz nada sobre a personalidade do modelo e tudo sobre seus dados. Note que null e {} são ambos JSON válido, mas significam coisas diferentes (Jsonic), então escolha um e registre. Zeros à esquerda também não são válidos em números JSON (MDN), por isso o slot de formato especifica explicitamente a regra de inteiro em vez de confiar que o modelo se lembre da gramática.
Scaffolds de few-shot ajustados para transferência
Escolha exemplos pela ambiguidade que eles resolvem. Um bloco de few-shot que demonstra quatro casos em que um humano hesitaria ensina algo que o próximo modelo ainda precisa. Um bloco que mostra quatro casos fáceis em um estilo de escrita ensina tom, e tom é a coisa que cada checkpoint fica melhor em adivinhar por conta própria.
Exemplos que ensinam a fronteira de decisão, não o vocabulário
Antes de colar um exemplo, pergunte o que mudaria se você o deletasse. Se a resposta for "a saída soa um pouco menos como nós", delete-o. Se a resposta for "o modelo classificaria um reembolso com envio parcial como devolução em vez de disputa", mantenha-o, porque essa decisão não é derivável da descrição da tarefa.
O mesmo teste se aplica ao formato de saída. Um exemplo mostrando um resultado vazio como [] em vez de null vale mais do que cinco exemplos de resultados preenchidos, já que um array vazio e null são ambos JSON válido e significam coisas diferentes (Jsonic). Os modelos adivinham de forma diferente sobre isso, e um exemplo resolve a questão de vez.
Casos extremos e negativos justificam seu custo em tokens
Dois ou três dos seus shots devem ser casos que você errou em produção. O campo ausente. O input que já está no formato alvo. O registro onde a resposta correta é "dados insuficientes" e um modelo prestativo inventará um valor.
Negativos funcionam quando você os emparelha com a correção em vez de declarar uma proibição. Mostre a saída malformada e a corrigida lado a lado, e a fronteira fica concreta. Instruções simples como "não use aspas simples" envelhecem mal, e aspas simples são um dos infratores recorrentes por trás do JSON malformado, ao lado de vírgulas finais, que respondem por cerca de 40% dos erros em uma análise (Flying Fish Space).
Quantos shots, e quando reduzir a zero
Comece com zero. Adicione shots apenas quando um caso de avaliação falhar, e adicione o menor exemplo que corrige aquele caso. A maioria dos prompts de classificação e extração se estabiliza entre três e seis; depois de oito, você geralmente está compensando por uma descrição de tarefa que nunca escreveu direito.
Reduza a zero sempre que um schema fizer o trabalho. A decodificação restrita a um schema fornecido fornece essencialmente 100% de JSON sintaticamente válido (Ashvara), então exemplos de formato são peso morto aí. Reserve os shots para julgamento, gaste o schema na estrutura.
O cheiro de overfitting: exemplos que o próximo modelo imitará literalmente demais
Fique atento a shots cujos recursos superficiais são acidentais. Se cada input de exemplo tem cerca de 40 palavras, um modelo mais robusto pode tratar o comprimento como um sinal. Se todos os quatro exemplos caem no mesmo rótulo, você viés o prior. Se seus exemplos usam nomes de espaço reservado como Acme Corp, espere que esses nomes apareçam em saída real eventualmente.
Reexecute seu conjunto de few-shot em um novo checkpoint na semana em que ele for lançado e compare as saídas em casos que os exemplos não cobrem. É aí que a imitação vaza. Equipes que publicam relatos reais de implantação tendem a manter o conjunto de exemplos sob controle de versão exatamente por esse motivo: um exemplo que você não consegue comparar é um exemplo que você não consegue aposentar.
Contratos de saída que sobrevivem ao modelo
Empurre a aplicação para baixo na pilha até que o formato pare de depender de como um checkpoint se sente naquele dia. Pedir educadamente por JSON é a camada mais fraca disponível, e é aquela em que a maioria dos códigos de produção ainda funciona.
Três níveis de confiabilidade: solicitação em prosa, modo JSON, decodificação restrita
| Nível | Como você pede | O que retorna |
|---|---|---|
| 1 | "Por favor retorne JSON" no texto do prompt | Uma estimativa de 5 a 10% das saídas são malformadas (Ashvara) |
| 2 | Modo JSON do provedor ativado | Aproximadamente 95-99% sintaticamente válido em observações de produção (Ashvara) |
| 3 | Geração restrita a um schema fornecido | Essencialmente 100% sintaticamente válido (Ashvara) |
Use o nível 3 sempre que seu provedor o suportar. A validade então vem do decodificador em vez dos pesos, então uma troca de modelo não pode regredi-la. Mantenha o contrato no nível do prompt mesmo assim, porque a decodificação restrita garante a forma e não diz nada sobre se os valores estão corretos. Se preferir não escrever o código de integração, os frameworks que encapsulam a aplicação de schema em nosso diretório somam 128 listagens.
O que um contrato deve especificar além de "retorne JSON"
Nomeie as chaves, o tipo por trás de cada chave e o comportamento quando o modelo não tem nada para colocar lá.
- Cada chave escrita exatamente como seu parser espera, com um tipo extraído dos seis tipos JSON: quatro primitivos (string, number, boolean, null) e dois tipos estruturados, objeto e array (RFC 8259).
- Apenas literais em minúsculo. A gramática permite exatamente três deles: false, null, true (RFC 8259).
- Nomes de chave únicos dentro de cada objeto, o que a RFC 8259 recomenda para que todos os parsers concordem com o mesmo mapeamento de nome-valor.
- Se chaves opcionais são omitidas ou emitidas com valor null, e qualquer enum que você espera, escrito como strings literais.
Os modos de falha que valem a pena codificar: vírgulas finais, aspas simples, strings sem escape
Uma análise coloca as vírgulas finais em cerca de 40% de todos os erros de JSON, com aspas simples, aspas sem escape dentro de strings, vírgulas faltando e caracteres BOM UTF-8 ocultos cobrindo a maior parte do restante (Flying Fish Space). Essas cinco falhas custam talvez 25 tokens para proibir explicitamente no slot de formato, e a proibição permanece correta em todos os modelos que você apontará para elas. Combine isso com uma etapa de validar-depois-formatar do seu lado em vez de confiar na string (QuickTinyData).
Objeto vazio, array vazio, null: três respostas diferentes
É aqui que os contratos vazam entre versões de modelos sem que ninguém perceba. Um objeto vazio e um array vazio são ambos JSON válido, e ambos significam algo diferente de null (Jsonic). Um checkpoint retorna [] para nenhuma correspondência, o próximo retorna null, e seu código downstream trata um deles como erro.
Escolha a representação, declare-a no contrato e valide para ela. Seu parser também precisa sobreviver a um valor simples no nível superior, já que qualquer valor JSON único conta como um documento completo, incluindo uma string isolada ou o número 42 (Jsonic).
Os truques frágeis que morrem a cada lançamento
Abra sua biblioteca de prompts e procure por esses quatro padrões. Cada ocorrência é candidata à exclusão, porque cada uma estava compensando uma fraqueza do modelo que ou foi corrigida ou foi movida.
O genérico 'pense passo a passo' como complemento
Acrescentar "pense passo a passo" a um prompt fazia sentido quando os modelos pulavam diretamente para uma resposta. Os modelos de raciocínio atuais já decompõem por padrão, então a frase adiciona tokens e às vezes arrasta uma tarefa curta de classificação para três parágrafos de narração que você precisa remover depois.
Mantenha instruções de raciocínio apenas quando forem específicas para a tarefa: "liste as cláusulas conflitantes antes de escolher uma" diz ao modelo sobre o que raciocinar. A substituição durável é o slot de tarefa do seu shell papel-contexto-tarefa-formato, especificando o artefato intermediário que você quer. O encantamento genérico vai para o lixo.
Ameaças, subornos e pressão de roleplay
"Você será demitido se errar isso." "Vou te dar uma gorjeta de R$200." "Você é o maior analista do mundo." Esses dependiam de peculiaridades de checkpoints RLHF específicos, e peculiaridades não sobrevivem ao retreinamento. Pior, são infalsificáveis: você não consegue escrever um teste que prove que a gorjeta foi o que corrigiu sua saída, então a linha permanece no prompt para sempre, incontestada.
Substitua a pressão por restrição. Um rubric que o modelo usa para se avaliar, ou uma lista explícita do que conta como falha, faz o mesmo trabalho e continua funcionando quando o checkpoint muda.
Hacks de formatação que lutam contra o tokenizador
Preencher prompts com exigências em CAIXA ALTA, pontos de exclamação triplos ou longas sequências de delimitadores como ##### é folclore. A parte do delimitador tinha um núcleo de verdade (limites claros de seção ajudam), mas a escalada não ajuda. Duas quebras de linha e uma tag XML-ish batem quarenta hashtags.
O mesmo vale para "sem blocos de código, sem preâmbulo, sem explicação, retorne APENAS JSON" empilhados três vezes. Diga uma vez no slot de formato e então coloque a garantia onde as garantias realmente vivem: restringir a geração a um schema fornecido é o que leva você a essencialmente 100% de JSON sintaticamente válido (Ashvara), e nenhuma pilha de proibições no lado do prompt chega perto desse número.
Súplica no nível do prompt onde deveria haver um parser
Os modos de falha são entediantes e estruturais: vírgulas finais após o último item, chaves sem aspas, caracteres de aspas inválidos, vírgulas faltando, chaves sem correspondência (QuickTinyData). Vírgulas finais sozinhas respondem por cerca de 40% dos erros de JSON em um conjunto de dados de erros (Flying Fish Space), e são proibidas pelo próprio formato (MDN). Nenhuma quantidade de pedidos educados fecha essa lacuna.
Delete a súplica. Coloque um schema e um validador no lugar, e deixe o prompt dizer o que os campos significam.
Loops de avaliação tratam prompts como artefatos versionados
Construa vinte casos de teste antes de construir qualquer coisa sofisticada. Um prompt sem um conjunto de avaliação é um prompt que você não consegue atualizar, porque não há como saber se o novo modelo o melhorou ou quebrou o único caso que importa para seu maior cliente sem te avisar.
Vinte não é um número de compromisso. É suficiente para capturar as classes de falha que você já conhece, pequeno o suficiente para escrever em uma tarde, e barato o suficiente para reexecutar em cada checkpoint sem pensar na conta.
A avaliação mínima viável: 20 casos, uma asserção cada
Uma asserção por caso, e faça-a booleana: a saída foi parseada, ela continha o campo obrigatório, ela recusou quando deveria ter recusado. Rubricas, modelos de julgamento e scores de similaridade podem vir depois, uma vez que o booleano esteja verde. Casos com três asserções se tornam casos que você não consegue depurar, e uma execução vermelha não te diz nada sobre qual das três quebrou.
Escolha seus vinte a partir do tráfego real, com peso para o extremo feio. Cinco caminhos felizes, cinco inputs que são ambíguos, cinco que são adversariais ou vazios, cinco que quebraram em produção em algum momento. Armazene-os ao lado do prompt no mesmo repositório, no mesmo commit. Se o prompt mudar e os casos não mudarem, isso é um comentário de revisão.
Valide primeiro, depois formate: emprestando o fluxo de trabalho de depuração de JSON
O mundo do JSON resolveu esse debate anos atrás. O guia de solução de problemas do QuickTinyData recomenda validar primeiro e formatar depois, porque a formatação de um documento quebrado oculta o erro estrutural exato que você está caçando: vírgulas finais, chaves sem aspas, caracteres de aspas errados, vírgulas faltando, chaves sem correspondência (QuickTinyData).
Execute sua avaliação da mesma forma. Asserte validade antes de assertar qualidade. Uma saída de modelo que falha em json.loads não deve avançar para a verificação semântica, e não deve receber crédito parcial também. Seu conjunto de avaliação precisa de duas colunas, taxa de parse e taxa de aprovação, e a segunda só conta linhas onde a primeira foi bem-sucedida.
Conhecer a distribuição de erros diz o que assertar. Uma análise coloca vírgulas finais em cerca de 40% dos erros de JSON, com aspas simples, aspas sem escape dentro de strings, vírgulas faltando e caracteres BOM UTF-8 ocultos compondo a maior parte do restante (Flying Fish Space). Aquele do BOM vale uma asserção dedicada, já que é invisível em todos os editores que você usará para inspecionar a saída.
Execuções de regressão no dia do lançamento
Um novo checkpoint é lançado. Você executa os vinte, obtém um diff, decide. Esse é o procedimento completo, e leva cerca de quatro minutos se você construiu o conjunto corretamente.
- Fixe o modelo antigo e reexecute o conjunto para confirmar que sua linha de base ainda se reproduz. Se não reproduzir, o problema está na sua configuração de teste, não no lançamento.
- Execute o conjunto contra o novo checkpoint e registre a taxa de parse e a taxa de aprovação separadamente.
- Leia cada caso que mudou, em ambas as direções. Um caso que começou a passar pode ser sorte, e merece tanta atenção quanto uma regressão.
- Lance, faça rollback ou corrija o prompt. Depois faça commit dos novos números de linha de base ao lado do arquivo de prompt.
Isso importa mais em pilhas de agentes onde um único parse ruim causa cascata, porque a falha aparece três chamadas de ferramenta depois como algo que não parece nada com um bug de formatação.
Fixando versões, e o que fazer quando não é possível
Fixe IDs de modelos datados em todos os lugares que puder, e trate um alias como uma dependência flutuante que você escolheu não travar. Alguns provedores não te darão um pin, ou vão deprecar o que você está usando com uma janela curta. Quando isso acontecer, seu conjunto de avaliação é o que está entre uma mudança silenciosa de comportamento e um ticket de suporte que você não consegue reproduzir.
Execute o conjunto em um agendamento contra o endpoint não fixado. Semanal está ótimo. Você encontrará o desvio antes que seus usuários o narrem de volta para você em um relatório de bug.
Portando um prompt entre Claude, GPT e Gemini
Aproximadamente 80% de um prompt bem construído é portado sem alterações. O restante é uma camada de adaptação que você escreve uma vez por provedor e depois esquece principalmente. Se você está reescrevendo tudo para cada fornecedor, seu prompt estava carregando comportamento específico do provedor que nunca precisou carregar.
O que permanece idêntico: o shell, os exemplos, o contrato
O shell de quatro slots se move entre fornecedores com zero edições. Papel, contexto, tarefa, formato descrevem o trabalho, e o trabalho não muda quando você troca os checkpoints. O mesmo vale para seu bloco de few-shot: exemplos que resolvem ambiguidade genuína em seu domínio ensinam a cada modelo a mesma coisa, porque a ambiguidade vive nos seus dados, não no decodificador.
Seu contrato de saída permanece idêntico também, e precisa ser assim. O que quer que um provedor retorne precisa satisfazer o mesmo parser: nomes de propriedades entre aspas duplas, sem vírgulas finais, sem NaN ou Infinity, e apenas quatro caracteres de espaço em branco legais (espaço, tab, avanço de linha, retorno de carro) (MDN). Escreva o schema uma vez. Valide as três saídas com o mesmo validador, e compare as falhas.
Mantenha seu conjunto de avaliação neutro em relação ao fornecedor também. Vinte casos que passam no Claude e falham no Gemini dizem algo útil. Vinte casos escritos contra as peculiaridades do Claude não dizem nada.
O que você reajusta por provedor: peso do system message, delimitadores, API de aplicação
Três coisas recebem um adaptador. Quanto da sua instrução vai no system message versus no turno do usuário, já que os provedores ponderam esses de forma diferente. O que você usa para delimitar blocos, tags XML-ish ou cabeçalhos markdown. E qual API de aplicação você chama.
Essa última é a parte complicada. O modo JSON de qualquer tipo garante sintaxe e para por aí: observações de produção o colocam em cerca de 95-99% sintaticamente válido, enquanto restringir a geração a um schema fornecido é essencialmente 100% (Ashvara). Nenhum dos dois níveis diz nada sobre se as chaves são as que você pediu, então a verificação de schema fica no seu código independentemente do fornecedor. Se você está escolhendo alvos, vale a pena dar uma passada para comparar os modelos em si antes de se comprometer, e as plataformas multi-provedor em nosso diretório absorverão parte desse trabalho de adaptação para você.
Uma lista de verificação de portabilidade antes de lançar
- Remova cada frase que menciona um modelo, uma versão ou um comportamento conhecido de algum. Essas são as linhas que quebram primeiro.
- Execute o mesmo conjunto de avaliação contra os três provedores e registre taxas de aprovação por caso, não apenas uma média.
- Confirme que o validador de schema roda em cada resposta independentemente de o provedor afirmar decodificação restrita.
- Releia a documentação de aplicação de cada provedor ao conectar o adaptador, e mantenha qualquer texto ou flag que ele exige dentro do adaptador, não no prompt compartilhado.
- Registre qual adaptador foi acionado. Quando um checkpoint for lançado e a qualidade mudar, você quer saber se foi o prompt ou o adaptador que mudou por baixo.
Se um prompt falha nessa lista de verificação apenas em um fornecedor, o bug está quase sempre no adaptador, não no shell.
Perguntas frequentes
Preciso reescrever meus prompts toda vez que um novo modelo é lançado?
Não, e se você fizer isso, seu prompt provavelmente estava carregando hacks específicos do modelo em vez de instruções. As partes que sobrevivem a atualizações são aquelas vinculadas a algo fora do modelo: uma descrição de tarefa, dados de entrada e um contrato de saída como um schema JSON. A decodificação restrita a um schema fornecido produz essencialmente 100% de JSON sintaticamente válido independentemente do modelo por trás, porque a restrição vive no decodificador. O que você deve reescrever em uma mudança de modelo é nada. O que você deve reexecutar é seu conjunto de avaliação.
'Pense passo a passo' ainda funciona nos modelos atuais?
É basicamente peso morto agora. Essa frase era uma solução alternativa para modelos que pulavam direto para uma resposta, e os modelos atuais já decompõem trabalho em múltiplas etapas sem precisar ser instruídos. Pior, acrescentá-la a um prompt que exige saída JSON estrita convida o modelo a emitir prosa de raciocínio em torno do objeto, que é exatamente a classe de falha que empurra prompts ingênuos para uma estimativa de 5 a 10% de taxa de JSON malformado. Se você quer raciocínio, dê a ele um campo nomeado no seu schema e deixe o parser mantê-lo separado do payload.
O modo JSON é suficiente, ou preciso de um schema?
Use o schema. O modo JSON leva você a aproximadamente 95 a 99% de saída sintaticamente válida, o que parece ótimo até você estar executando dez mil chamadas por dia e absorvendo cem falhas. A decodificação restrita por schema leva a validade sintática a essencialmente 100%, e também fixa seus nomes de chave, o que importa porque a RFC 8259 trata um objeto JSON como uma coleção desordenada de pares nome-valor e apenas recomenda nomes únicos. A validade sintática não é correção semântica, então continue validando o objeto parseado contra suas próprias regras de qualquer forma.
Quantos exemplos de few-shot um prompt durável deve incluir?
De dois a quatro, e escolha-os pela cobertura de casos extremos, não pelo volume. Exemplos que mostram o mesmo caminho feliz repetidamente não ensinam ao modelo nada que ele ainda não faça; exemplos que fixam os casos difíceis são os que se transferem entre modelos. Para saída estruturada, gaste pelo menos um exemplo na distinção entre um container vazio e um valor ausente, já que [um objeto vazio {} e um array vazio [] são ambos JSON válido, mas semanticamente diferentes de null](https://jsonic.io/guides/json-examples). Se seus exemplos contêm formatação que um parser estrito rejeitaria, você está ensinando a falha: vírgulas finais sozinhas respondem por cerca de 40% dos erros de JSON em uma análise.
Qual o tamanho mínimo que um conjunto de avaliação de prompt precisa ter para ser útil?
Trinta a cinquenta casos rotulados capturarão a maioria das regressões, e vinte é melhor do que o zero com que a maioria das equipes trabalha. Tamanho importa menos do que composição: pondere o conjunto para os modos de falha que você realmente viu em produção, como chaves sem aspas, aspas simples, aspas sem escape dentro de strings, vírgulas faltando e caracteres BOM UTF-8 ocultos, todos os quais aparecem em análises documentadas de erros de JSON. Execute a validação antes da formatação para capturar quebras estruturais em vez de mascará-las, que é o fluxo de trabalho que o QuickTinyData recomenda. Versione o conjunto ao lado do prompt e reexecute-o no dia em que um novo modelo for lançado.
O mesmo prompt realmente pode rodar sem alterações no Claude, GPT e Gemini?
O corpo da instrução porta de forma limpa. A camada de aplicação de saída não porta, porque o modo JSON e a decodificação restrita por schema são configurados de forma diferente por provedor, então planeje um prompt e três adaptadores finos. Manter o contrato em um formato com o qual todo provedor já concorda ajuda: a RFC 8259 é independente de linguagem e define quatro tipos primitivos mais objetos e arrays, com true, false e null em minúsculo como os únicos nomes literais. Se você está procurando ferramentas para gerenciar prompts entre provedores, nosso diretório lista 212 ferramentas de engenharia de prompt e 324 entradas em modelos de IA.