

A decisão entre IA open source vs SaaS depende de dois números: seu gasto mensal e seu perfil de concorrência. Headcount é um péssimo proxy para ambos. Os próprios engenheiros da DoiT chegam a uma média de $2.200 por desenvolvedor por mês com o Claude Code baseado em uso, o que coloca um nó de $15K–$25K em jogo com aproximadamente 7 a 12 assentos pesados. Mas apenas 10–20% de uma equipe tem uma requisição em andamento ao mesmo tempo, então dez desenvolvedores representam duas ou três sessões simultâneas e metade de um nó parado.
E antes de precificar GPUs, verifique a terceira opção que ninguém usa como referência: a DeepInfra serve o Llama-3.3-70B por $0,10 de entrada / $0,32 de saída por milhão de tokens. Pesos idênticos, margens multilocatárias que você não consegue igualar. O cálculo abaixo é executado quatro vezes: para texto, imagens, transcrição e a camada vetorial.
O ponto de equilíbrio é um nível de gasto e um perfil de concorrência
Dois números decidem se você deve auto-hospedar, e o tamanho da equipe não é nenhum deles. O primeiro é quanto você gasta por mês em IA agora. O segundo é quantas requisições estão em andamento ao mesmo tempo. Todo o resto, incluindo a escolha do modelo, é consequência desses dois.
Os dois números que decidem antes de qualquer escolha de modelo
Um nó de GPU custa o mesmo independentemente de você utilizá-lo ao máximo ou deixá-lo ocioso às 3h da manhã. Essa é a assimetria em que toda a comparação se baseia: o SaaS cobra por token, um nó cobra por hora. Portanto, a questão é se sua conta mensal já ultrapassou o custo fixo de um servidor que você consegue manter ocupado.
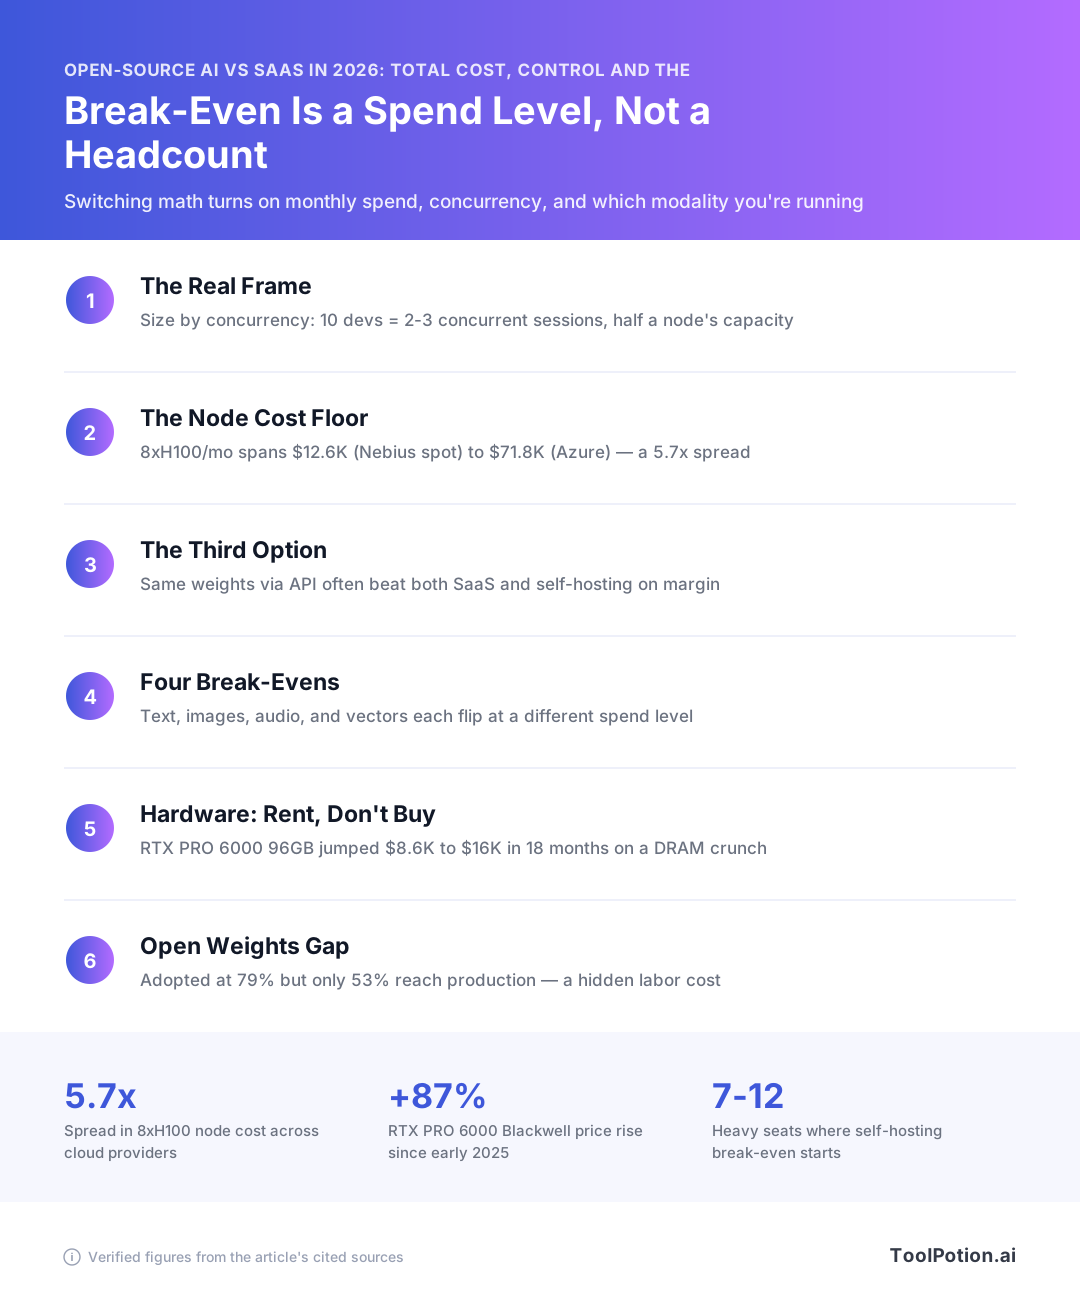
A equipe de engenharia da DoiT tem uma média de cerca de $2.200 por desenvolvedor por mês com preços Enterprise do Claude Code baseados em uso, o que coloca um ponto de equilíbrio de auto-hospedagem de $15K–$25K/mês em torno de 7 a 12 assentos pesados de IA. Esse é um limite muito mais baixo do que a frase "você precisa de centenas de engenheiros" que a maioria dos guias de TCO repete. É um limite de gasto, não de pessoal. Doze desenvolvedores que mal usam um assistente não chegam lá, enquanto sete que rodam agentes o dia todo chegam.
A concorrência é o segundo número, e é o que as equipes erram. O argumento da DoiT é que, em qualquer momento, apenas 10–20% de uma equipe de desenvolvedores tem uma requisição em andamento, então dez desenvolvedores representam duas ou três sessões simultâneas, o que é, na melhor das hipóteses, metade da capacidade de um nó. Você está pagando por oito H100s e usando três ou quatro. Dimensione pelo pico de requisições simultâneas e pela taxa de tokens alvo, depois verifique se isso cabe em um nó antes de precificar qualquer coisa.
Por que 'temos 50 engenheiros' é o gatilho errado
O headcount só se correlaciona com o gasto quando o uso por pessoa é uniforme, e nunca é. Uma equipe de 50 pessoas em que 8 rodam agentes de codificação continuamente e 42 usam o chat ocasionalmente tem o mesmo requisito de nó que uma equipe de 8 usuários intensivos, e praticamente a mesma conta. Conte os assentos pesados.
Execute esses dois números antes de comparar os modelos open-weight catalogados em nosso diretório com qualquer coisa. Escolha o modelo depois de saber se um nó consegue ficar ocupado, porque um modelo que está 6 pontos atrás da fronteira é uma troca razoável em um servidor saturado e um erro caro em um rodando a um quarto da carga.
IA open source vs SaaS: quanto custa a auto-hospedagem em 2026
Comece pela tabela de preços, porque é o único número que você pode consultar. Todo o resto em um orçamento de auto-hospedagem é uma estimativa que você defende em uma planilha.
Tabelas de preços de GPU alugada: uma variação de ~7x em silicon com capacidade de inferência
Os preços públicos da RunPod listam H100 SXM 80GB a $3,29/hr na Nuvem Segura e $2,69/hr na Nuvem Comunitária, H200 141GB a $4,59/$3,59, A100 PCIe 80GB a $1,39/$1,19, L40S 48GB a $0,99/$0,79 e B200 180GB a $6,79/$5,98 (RunPod). É uma variação de cerca de 7x entre a placa mais barata e a mais cara que consegue servir inferência. Se sua carga é um modelo de 7B ou 8B com contexto modesto, a linha L40S é a que você deve precificar, e a maioria dos posts de TCO nunca a menciona.
A Lambda cobra $4,29/hr por um único H100 SXM sob demanda, caindo para $3,99/hr por GPU em um nó de 8x, com H100 PCIe a $3,29/hr e B200 SXM6 a $6,69–$6,99/hr (Lambda). Um nó 8xH100 a esse preço custa cerca de $31,92/hr, ou aproximadamente $23.300 para um mês de 730 horas com 100% de uptime. Ninguém roda com 100% de uptime, o que justifica o próximo número.
O desconto por compromisso é a maior alavanca individual que você controla. A Together AI cobra $3,99/GPU-hr sob demanda para HGX H100 e $3,19–$3,69/GPU-hr em termos reservados de 7 a 180+ dias (Together AI). Cerca de 20% de desconto, disponível apenas se você tiver confiança suficiente na sua carga para assinar pelo período.
O multiplicador do provedor: $12.600 a $71.800 pelo mesmo mês de 8xH100
A DoiT precificou um nó 8xH100 idêntico para um mês de 730 horas em vários provedores: cerca de $12.600 na Nebius spot, $22.500 na Nebius sob demanda, $40.200 na AWS, $64.100 na GCP e $71.800 na Azure (DoiT). Mesmo silício, variação de 5,7x. Sua escolha de provedor impacta mais o cálculo de migração do que sua escolha de modelo, então se você estiver rodando essa avaliação com preços de tabela de hyperscaler porque é onde seu gasto comprometido está, você está comparando a pior versão da auto-hospedagem com o SaaS.
| Provedor / placa | Taxa por hora | Notas |
|---|---|---|
| RunPod L40S 48GB | $0,99 / $0,79 | Nuvem Segura vs Nuvem Comunitária |
| RunPod H100 SXM 80GB | $3,29 / $2,69 | Nuvem Segura vs Nuvem Comunitária |
| Lambda H100 SXM (nó 8x) | $3,99 por GPU | ~$23.300 / mês de 730 horas |
| Together AI HGX H100 | $3,99 sob demanda, $3,19–$3,69 reservado | Termos de 7–180+ dias |
Os itens que ninguém precifica: horas ociosas, redundância e mão de obra de manutenção
Um nó alugado cobra pelo relógio de parede. Sua fatura de API rastreia tokens, enquanto sua fatura de GPU rastreia horas que você pode nunca usar. Se seu tráfego é durante o horário comercial e dias úteis, você está pagando por cerca de 168 horas de capacidade útil em 730 e absorvendo o resto, então multiplique seu custo efetivo de token por quatro antes de compará-lo com uma fatura de API. Adicione um segundo nó ou uma chave de API de fallback se o serviço for voltado ao cliente, porque um único nó não tem failover. Adicione o engenheiro que corrige o vLLM, rotaciona versões do modelo, monitora a pressão do cache KV e é chamado às 2h da manhã. Fornecedores em nosso diretório de plataformas de machine learning gerenciam parte disso por uma margem, o que geralmente é mais barato do que o meio-período que você gastaria de outra forma.
Então um número mensal defensável é: horas de nó à taxa real do seu provedor, divididas pelo seu uptime real, mais redundância, mais tempo de engenharia carregado. Execute os quatro antes de comparar qualquer coisa.
A terceira opção que destrói a maioria dos casos de auto-hospedagem
Quase todo artigo comparando open source com SaaS coloca uma fatura de GPU ao lado de uma fatura de API de fronteira e declara um vencedor. Essa comparação pula a opção que a maioria das equipes deveria escolher: outra empresa roda os pesos abertos para você, multilocatário, e cobra por token.
A DeepInfra serve o Llama-3.3-70B-Instruct-Turbo a $0,10 de entrada / $0,32 de saída por milhão de tokens, e o Meta-Llama-3.1-8B a $0,02/$0,04 (DeepInfra). Os mesmos checkpoints que você baixaria. Os mesmos termos de licença. A diferença é que os H100s deles rodam perto da capacidade máxima com milhares de clientes, enquanto os seus rodam com o que quer que seja seu tráfego às 3h da manhã de um domingo.
Pesos abertos idênticos, curva de ocupação de outra pessoa
Execute a aritmética contra o próprio nível dedicado da DeepInfra e a diferença fica embaraçosa. Um H100 80GB dedicado custa $2,20/hr lá (DeepInfra), então $1.606 por um mês de 730 horas. A $0,32 por milhão de tokens de saída, esse mesmo $1.606 compra cerca de cinco bilhões de tokens de saída no endpoint serverless. Distribuído pelos 43.800 minutos desse mês, seu único H100 teria que sustentar aproximadamente 115.000 tokens de saída por minuto, todo minuto, só para empatar com a API no preço. Uma implantação real passa grande parte desses minutos ociosa.
Você compra capacidade dedicada por razões além do preço unitário: residência de dados, sem retenção por terceiros, pisos de latência que você controla, LoRAs personalizados, modelos que ninguém hospeda. Isso é real. São razões de procurement em vez de razões de planilha, e você deve dizer isso abertamente quando apresentar o projeto.
Quando alugar os pesos deixa de ser mais barato
A ponta de modelos pequenos do mercado entrou em colapso sobre si mesma. O GPT-5-nano roda a $0,05/$0,40 por milhão de tokens e o GPT-5 a $1,25/$10,00 (OpenAI), o que significa que um modelo proprietário agora é mais barato do que você pagaria para manter um modelo open de 8B funcionando em seu próprio hardware. APIs open-weight baratas e APIs proprietárias baratas estão competindo no mesmo eixo, e a auto-hospedagem está perdendo para as duas.
Escolha seu benchmark com cuidado, porque ele decide a resposta. A variação da Anthropic vai de $10/$50 por milhão para Fable 5.1 até $1/$5 para Haiku 4.5 (Anthropic). Faça benchmark da auto-hospedagem contra o topo dessa faixa e parece uma pechincha. Faça benchmark contra o Haiku, ou contra o Llama da DeepInfra, e o nó de GPU precisa se justificar pelo controle em vez do custo.
Quatro modalidades, quatro pontos de equilíbrio completamente diferentes
Uma equipe que auto-hospeda transcrição quase nunca auto-hospeda inferência de texto, e o motivo é aritmético. Cada carga de trabalho tem seu próprio preço mínimo de SaaS, seu próprio padrão de carga de GPU e suas próprias regras de licenciamento. Rode um modelo de equilíbrio único em todas as quatro e você vai obter uma resposta errada três vezes.
Inferência de texto: o ponto de inversão mais amplo e imprevisível
Esta é a modalidade em que o ponto de inversão mais oscila, porque o preço de API que você está comparando abrange uma ordem de magnitude. A Anthropic cobra $2/$10 por milhão de tokens de entrada/saída para Sonnet 5 e $1/$5 para Haiku 4.5 (preços Claude), enquanto a OpenAI lista GPT-5-mini a $0,25/$2,00 e GPT-5-nano a $0,05/$0,40 (preços API OpenAI). Escolha seu nível de benchmark e o ponto de equilíbrio oscila de algumas centenas de milhões de tokens por mês para vários bilhões.
Um H100 dedicado a $2,20/hr na DeepInfra roda cerca de $1.606 por mês com uptime integral (preços DeepInfra). Contra a taxa mista do GPT-5-nano, você precisaria de um volume que a maioria das equipes nunca alcança. Contra Fable 5.1 a $10/$50 por milhão (preços Claude), o mesmo nó se paga muito mais rápido. Decida qual nível sua carga precisa antes de modelar qualquer coisa, e navegue pelos modelos e LLMs no diretório se ainda estiver selecionando pesos abertos.
Geração de imagens: a licença decide antes da GPU
Aqui a matemática de GPU é a parte fácil e a licença é a armadilha. Os pesos FLUX.1 [dev] são amplamente reportados como sendo distribuídos sob uma licença não comercial, o que colocaria uma licença paga da Black Forest Labs entre você e um produto comercial, portanto leia os termos antes de orçar o hardware. Ninguém comparando modelos de imagem abertos com o Midjourney menciona isso, e é o item que pode inverter a decisão.
Trabalho de imagem em rajadas é o que falha no teste. Uma equipe de marketing gerando imagens em lotes às terças-feiras deixa a placa ociosa pelo resto da semana, e horas ociosas cobram à mesma taxa que horas produtivas. Um L40S a $0,79/hr na RunPod Community Cloud (preços RunPod) é barato o suficiente para que jobs de lote em estado estacionário compensem confortavelmente, o que é por isso que pipelines agendados são o formato que funciona aqui. Há 727 ferramentas de geração de imagens em nosso diretório, e os termos de licença variam mais do que a qualidade da saída.
Transcrição: a modalidade que inverte mais cedo
Exceto que geralmente não inverte, e o motivo é a AssemblyAI. A OpenAI cobra $0,006/minuto pelo Whisper e gpt-4o-transcribe, e $0,003/minuto pelo gpt-4o-mini-transcribe, o que equivale a $0,36 e $0,18 por hora de áudio (preços API OpenAI). Contra $0,36/hora, um L40S a $0,79/hr atinge o equilíbrio em cerca de algumas centenas de horas de áudio por mês, assumindo throughput de lote mais rápido que o tempo real. Esse é um limite genuinamente baixo. Então a AssemblyAI precifica o Universal-2 a $0,15/hora e o Universal-3.5 Pro a $0,21/hora (preços AssemblyAI), e seu ponto de equilíbrio sobe mais de 2x.
O único lugar em que a auto-hospedagem ainda vence claramente é no streaming. A AssemblyAI cobra o streaming por duração da sessão WebSocket, incluindo o tempo de conexão ociosa (preços AssemblyAI). Se você mantém sockets abertos para reuniões onde as pessoas não estão falando, você está pagando pelo silêncio. Um endpoint auto-hospedado cobra por segundos de GPU em vez de relógio de parede.
RAG e a camada vetorial operam com volume de consultas
O ponto de equilíbrio da busca vetorial é contado em consultas por mês, e o número que circula cai em torno de 60 a 80 milhões de consultas antes que a auto-hospedagem supere os preços gerenciados. Trate isso como uma regra prática em vez de uma tabela de preços, já que ele varia com o tamanho do índice, o número de réplicas e o orçamento de latência que você está disposto a gastar. Abaixo dessa faixa, você está pagando um engenheiro para tomar conta de um índice que um serviço gerenciado rodaria por menos do que a linha salarial dele. A geração de embeddings é um cálculo separado, e é a coisa mais barata para auto-hospedar de tudo que foi discutido aqui, porque o modelo é pequeno e o trabalho é perfeitamente paralelizável em lotes.
Quatro cargas de trabalho, quatro limites, e nenhum motivo para movê-los todos de uma vez.
Comprar o hardware? A crise de memória de 2026 diz para alugar
Qualquer cálculo de payback que você leu escrito antes de meados de 2026 está rodando com preços que não existem mais. O conselho era razoável na época: compre um servidor, amortize em três anos, supere a taxa de aluguel no mês 14. Então o mercado de memória quebrou.
Uma alta de ~87% em uma GPU inalterada
A NVIDIA RTX PRO 6000 Blackwell 96GB é o exemplo mais claro porque o produto não mudou. Estava listada a $8.565 em um varejista no início de 2025 (com um mínimo de pré-venda de $7.673), chegou a $13.250 em junho de 2026 e atingiu $16.000 em agosto de 2026 (igor'sLAB). Isso é cerca de 87% em aproximadamente 18 meses, e a NVIDIA não publicou nenhuma explicação oficial.
Execute isso em uma planilha de 2025 e o mês de payback praticamente dobra. Um build de workstation de placa única que você havia estimado em $12.000 no total agora está mais perto de $20.000 antes de comprar RAM.
Por que o HBM consumiu o fornecimento de DRAM
A demanda por GPU é apenas metade da história. O que importa é o que essa demanda fez com as fábricas de memória: a memória de alta largura de banda agora ocupa uma estimativa de 23% da capacidade global de wafers de DRAM, acima de 8% em 2024, porque o HBM gera 3–5x a receita por wafer que o DDR5 convencional gera (DatacenterDisk). As fábricas moveram os wafers para onde está o dinheiro. Os preços do DDR5 ECC RDIMM de servidor subiram cerca de 100% a 116% entre o primeiro trimestre de 2025 e o primeiro trimestre de 2026 como resultado, então a memória do host ao redor de suas GPUs foi atingida tão duramente quanto os aceleradores. Você sente isso duas vezes em um build: a placa e o 1TB de RAM do sistema embaixo dela.
O que um cronograma de depreciação escrito em 2026 deve assumir
Assuma que a distorção sobrevive à sua decisão de compra. A Goldman Sachs previu em maio de 2026 um déficit global de DRAM de 4,9% para o ano, o maior em 15 anos, mais uma lacuna de fornecimento de HBM de 5,1%, e a maioria dos analistas não espera alívio significativo antes do final de 2027 (Wccftech). Um cronograma de depreciação de três anos iniciado hoje passa seus primeiros dois anos dentro da escassez.
Então precifique o caso de compra com custos de aquisição de agosto de 2026 em vez dos números de 2025 ainda presentes nas páginas de ranking, e não assuma uma atualização mais barata no segundo ano. Se os números só funcionam com os preços de hardware de 2025, alugue. Alugar é como você mantém a opção de comprar em 2028.
Controle e compliance: a parte que a planilha perde
Algumas garantias você só obtém rodando os pesos você mesmo. A maioria das que as equipes citam como razão para auto-hospedar, você agora pode comprar.
O que a auto-hospedagem realmente compra, e o que ela apenas parece comprar
Rodar sua própria inferência te dá quatro coisas que nenhuma cláusula contratual replica: pesos de modelo que não mudam sob você no cronograma de descontinuação de um fornecedor, nenhum dado por requisição saindo da sua VPC, sem limites de taxa impostos pelo planejamento de capacidade de outra pessoa, e a capacidade de fazer fine-tuning ou quantização sem pedir permissão. Se seu registro de riscos tem uma linha sobre uma versão de modelo sendo aposentada durante uma auditoria, esse é um argumento real para possuir o artefato.
A lista de coisas que a auto-hospedagem apenas parece comprar é mais longa. Residência de dados, criptografia em repouso, compromissos de não treinamento com seus dados, evidências SOC 2, logs de auditoria, processamento regional: tudo isso é adquirível como termos contratuais mais um seletor de região, e assim tem sido por um tempo. Pagar um prêmio de GPU por eles é comprar duas vezes. A exposição que impulsiona essas conversas é a matemática das penalidades, e a matemática das penalidades não se importa com quem instala o hardware. Os reguladores emitiram €7,1 bilhões em 2.245 multas do GDPR até o início de 2026, com exposição ao GDPR chegando a 4% do faturamento global e exposição à Lei de IA até 7%. Um modelo auto-hospedado mal configurado falha em uma auditoria tão rapidamente quanto um hospedado.
O reset regulatório de 2026 mudou os prazos que você está planejando
Verifique a data em qualquer cronograma de compliance que sua equipe está seguindo. As obrigações de alto risco da Lei de IA da UE foram adiadas pelo Omnibus Digital de 2026, então o prazo de 2 de agosto de 2026 que várias páginas de comparação amplamente citadas ainda publicam foi superado, e você deve confirmar as datas atuais com seu próprio advogado antes de gastar com base nelas. Se você aprovou um orçamento de auto-hospedagem no início de 2026 para cumprir essa data, a urgência em que foi construído sumiu e o gasto merece uma segunda avaliação.
Isso importa mais em setores regulamentados. Equipes comprando ferramentas de IA para saúde e ciências da vida são as mais propensas a ter precificado uma implantação privada contra um prazo que se moveu.
Nuvem gerenciada soberana é o caminho do meio
O argumento de residência ficou mais fraco durante 2026. Regiões de nuvem soberana estruturadas e governadas dentro da UE agora são uma opção gerenciada que não existia quando a maioria das comparações open-source-versus-SaaS que você encontrará foram escritas, então verifique o que seu hyperscaler preferido oferece na região antes de precificar um nó. Você pode obter tratamento de dados exclusivamente da UE sem contratar ninguém para tomar conta do vLLM às 2h da manhã.
A ordem que se sustenta é esta. Se seu requisito é residência, compre gerenciado soberano. Se for permanência de pesos ou fine-tuning irrestrito, auto-hospede. Se for uma linha em um questionário que diz "os dados não devem sair do nosso controle", vá ler o que seu auditor aceitará antes de assinar por um nó.
O quanto os pesos abertos ficam atrás, de verdade?
Quatro meses. Esse é o atraso medido, e é o número que deve substituir o que você acredita atualmente sobre modelos abertos estarem uma geração atrás.
Quatro meses e seis pontos de índice
A Epoch AI colocou um número nisso rastreando o melhor lançamento open-weight contra a fronteira fechada no Epoch Capabilities Index entre 1 de janeiro e 28 de maio de 2026: um atraso de 4 meses, ou 8 pontos de ECI com intervalo de confiança de 90% de 7 a 11. A Artificial Analysis mede a mesma coisa de forma diferente e chega ao mesmo lugar. Os líderes abertos pontuam 52 a 54 no seu Índice de Inteligência contra 60 do GPT-5.5, uma diferença de 6 pontos que era de 13 pontos doze meses antes.
Então a diferença é real e está diminuindo. Para a maioria das cargas de trabalho de produção (classificação, extração, sumarização, respostas com recuperação aumentada, código de primeiro rascunho), uma fronteira de quatro meses atrás é aceitável. Para a cauda de raciocínio difícil, não é, e nenhuma quantidade de trabalho de prompt fecha 8 pontos de ECI. Escolha sua carga de trabalho antes de escolher seu lado do argumento. Os lançamentos open-weight rastreados em nosso diretório se renovam rapidamente o suficiente para que um modelo que você avaliou em março não seja o que você implantaria hoje.
A lacuna de adoção-para-produção que custa dinheiro real às equipes
Os modelos abertos perdem no envio e não na capacidade. A pesquisa State of Open Source AI de 2026 (N=1.410) descobriu que 79% dos desenvolvedores de IA adotam modelos abertos, mas apenas 53% os levam à produção, versus 71% de adoção e 63% de produção para modelos fechados. Eles são mais testados e menos implantados.
Essa queda de 26 pontos é tempo de engenharia que você está pagando e não está capturando em sua planilha de TCO. Ela também piora com escala em vez de melhorar: as taxas de produção de modelos fechados sobem de 54% em pequenas empresas para 73% em enterprises, enquanto os abertos ficam quase estáveis de 53% a 57%. As organizações com mais engenheiros de plataforma são as que mais frequentemente abandonam implantações abertas, o que é o oposto do que o argumento de auto-hospedagem prevê. Orçe para as tentativas que não chegam ao envio.
Caminhos de migração: o que a troca realmente exige
A troca em si é barata. O que custa é o trabalho de avaliação que você pulou antes da troca, que você então paga em incidentes de produção.
A troca de URL base, e as exceções documentadas que valem mencionar
O vLLM inclui um servidor compatível com OpenAI, então para um chat completion simples a migração é uma URL base e um alias de modelo. Aponte seu cliente existente para o seu endpoint, mude model de gpt-5-mini para o que você está servindo, mantenha o restante do código. Essa é a parte que todo concorrente trata como caixa preta e é honestamente a metade fácil.
As exceções são onde as equipes perdem uma semana. Saídas estruturadas e aplicação estrita de esquema JSON se comportam de forma diferente entre pilhas de serviço, então qualquer coisa que dependa de argumentos de função garantidamente válidos precisa de testes com payloads reais em vez de um smoke test. Chamadas de ferramentas paralelas são uma lacuna comum. O cache de prompt é específico do provedor, e se seu modelo de custo assumiu taxas de entrada em cache no lado SaaS, esse desconto não te acompanha. O comportamento de contexto longo degrada em pontos diferentes do que a janela de contexto anuncia, e os tokenizadores também diferem, o que significa que seus orçamentos baseados em contagem de tokens e sua lógica de truncamento precisam de recalibração.
Construa o harness de avaliação antes da virada, não depois
Se você não consegue medir qualidade no seu próprio tráfego, não pode dizer se uma lacuna de capacidade de quatro meses importa para o seu caso de uso ou não. Capture algumas centenas de requisições de produção reais com suas saídas, pontue-as da maneira que seu negócio as pontua, depois rode o modelo aberto candidato contra o mesmo conjunto. Faça isso antes de provisionar uma GPU.
- Registre 200 a 500 requisições reais com respostas e qualquer sinal downstream que você já rastreia (curtidas, edições, novas tentativas, escalações).
- Pontue a saída do SaaS incumbente para estabelecer sua linha de base. Você precisa do número que está defendendo, não de uma impressão.
- Rode o candidato open-weight por uma API primeiro, já que a DeepInfra serve o Llama-3.3-70B a $0,10 de entrada / $0,32 de saída por milhão de tokens (DeepInfra) e não custa nada em infraestrutura para testar.
- Somente se a qualidade se mantiver e o volume justificar, migre para capacidade dedicada.
O padrão híbrido: roteie por classe de requisição em vez de substituir tudo
Divida o tráfego pelo valor de cada requisição. Classificação, extração, sumarização e reformulação de recuperação rodam bem em um modelo de 8B a $0,02/$0,04 por milhão de tokens (DeepInfra), e a cauda de raciocínio difícil vai para o Sonnet 5 a $2/$10 (Anthropic). Se 80% das suas chamadas são da classe barata, você cortou a maior parte da fatura sem apostar a qualidade em um único modelo.
O roteamento também te dá um caminho de fallback, o que uma substituição total não dá. Pilhas de serviço e roteadores compõem uma boa parte dos 128 frameworks de IA em nosso diretório, e os repositórios de IA open-source que valem começar são os que têm uma superfície compatível com OpenAI, porque é isso que mantém seu rollback a uma mudança de configuração.
Quem deve migrar em 2026 — e quem não deve
Três perfis têm a aritmética a seu favor. Três não têm, e nenhuma quantidade de entusiasmo da sua equipe de plataforma conserta isso.
Três perfis em que a auto-hospedagem vence claramente
Transcrição de alto volume com carga constante. Se você está processando mais de alguns milhares de horas de áudio por mês por um pipeline que roda em um cronograma, você consegue manter uma placa ocupada e superar o piso de $0,15/hora da AssemblyAI (AssemblyAI). O trabalho em lote é o formato ideal aqui porque você controla quando a fila é drenada, então manter a placa alimentada se torna um problema de agendamento em vez de uma esperança.
Dados regulamentados que não podem sair do seu perímetro, onde o requisito é contratual e não uma preferência. Otimização de custo não é o objetivo nesse caso. Você está comprando uma resposta de auditoria, e a fatura de GPU é seu preço.
Cinquenta ou mais desenvolvedores com assistentes de codificação baseados em uso. Com cerca de 50 devs, a fatura chega perto de $110.000 por mês contra um nó que você consegue manter saturado, um prêmio de 3–9x, e com ~100 devs (~$220.000/mês) o hardware próprio se paga em cerca de um ano (DoiT).
Três em que ela perde apenas pela aritmética
Equipes com menos de cerca de 10 desenvolvedores. Com ~$22.000/mês, a fatura do assistente empata com um nó que essas 10 pessoas não conseguem manter ocupado (DoiT), e um empate não justifica uma escala de plantão.
Qualquer equipe cujas carga de trabalho é tráfego de consumidores em rajadas. GPUs ociosas cobram à taxa cheia, e uma curva diurna irregular significa que você está pagando pelo pico enquanto tem em média talvez 20% dele. APIs open-model serverless destroem esse perfil.
Equipes cujo nível de qualidade está na fronteira. Se suas avaliações só passam com Fable 5.1 a $10/$50 por milhão de tokens (Anthropic), um modelo aberto auto-hospedado é um produto diferente em um nível de qualidade diferente, e a economia compra um downgrade.
O teste de 90 dias para executar antes de comprometer capital
- Semanas 1–2: instrumente a concorrência, não o gasto. Registre as requisições em andamento por minuto e encontre seu p95. Se for menos de 4, pare aqui.
- Semanas 3–6: direcione 10% do tráfego para os endpoints open-weights da DeepInfra e rode seu conjunto de avaliações existente contra eles. Para a maioria das pilhas, isso é uma mudança de URL base e um alias de modelo.
- Semanas 7–12: alugue, não compre. Um H100 a $2,20/hr dedicado (DeepInfra) te dá um número real de utilização por menos de $1.700 por mês, que é o número que seu CFO vai pedir.
Se a placa ficar ociosa mais de 60% do tempo no final disso, a resposta é a API open-weights gerenciada, e você passou um trimestre aprendendo isso em vez de três anos depreciando hardware.
Perguntas Frequentes
A auto-hospedagem de IA open-source é realmente mais barata do que assentos do ChatGPT Business ou Claude Team?
Com preços de tabela por assento, não. O Claude Team custa $20 por assento por mês com cobrança anual ($25 mensal), com assentos premium a $100/$125, e o Enterprise é $20 por assento anualmente mais uso a taxas de API (preços Anthropic). Nenhuma GPU alugada chega perto de $20 por pessoa, então assinaturas de taxa fixa são a coisa mais difícil em IA para vencer com seu próprio hardware. A auto-hospedagem começa a competir apenas quando sua equipe está em cobrança baseada em uso, onde os próprios engenheiros da DoiT chegam a uma média de cerca de $2.200 por desenvolvedor por mês (DoiT).
Em que gasto mensal a auto-hospedagem de um LLM atinge o equilíbrio em 2026?
Aproximadamente $15.000 a $25.000 por mês de gasto de API baseado em uso, que com os $2.200 por desenvolvedor por mês observados pela DoiT equivale a cerca de 7 a 12 assentos pesados (DoiT). O número muda mais com seu provedor de nuvem do que com seu modelo: o mesmo nó 8xH100 para um mês de 730 horas custa cerca de $12.600 na Nebius spot, $22.500 na Nebius sob demanda, $40.200 na AWS e $71.800 na Azure (DoiT). Headcount é a unidade errada de qualquer forma. Apenas 10 a 20% de uma equipe de desenvolvedores tem uma requisição em andamento em qualquer momento, então dez desenvolvedores representam duas ou três sessões simultâneas, na melhor das hipóteses metade da capacidade de um nó (DoiT).
Quantas horas de GPU preciso para superar os $0,36 por hora de áudio da API Whisper?
O throughput resolve isso, e as horas só importam pela taxa que cobram. A OpenAI cobra $0,006/minuto pelo Whisper e gpt-4o-transcribe, o que equivale a $0,36 por hora de áudio, e $0,003/minuto ($0,18/hora) pelo gpt-4o-mini-transcribe (OpenAI). Em um RunPod L40S 48GB a $0,79/hr Community Cloud (RunPod), você precisa de melhor que cerca de 2,2x o throughput em tempo real para superar $0,36, cerca de 4,4x para superar o nível mini e cerca de 5,3x para superar a taxa de $0,15/hora Universal-2 da AssemblyAI (AssemblyAI). O tempo ocioso da GPU conta contra você, então a implantação só ganha com uma fila constante em vez de tráfego diurno em rajadas.
A IA open-source pode ser usada comercialmente gratuitamente?
Não, e é nos modelos de imagem que as equipes se enredam. Os pesos FLUX.1 [dev] são reportados como tendo uma licença não comercial, o que colocaria uma licença paga da Black Forest Labs entre você e uma implantação comercial, portanto leia os termos antes de planejar com base neles. Mesmo com pesos totalmente permissivos, o compute não é gratuito: a DeepInfra serve o Llama-3.3-70B-Instruct-Turbo a $0,10 de entrada e $0,32 de saída por milhão de tokens, e o Meta-Llama-3.1-8B a $0,02/$0,04 (DeepInfra), o que é mais barato do que a maioria das equipes consegue rodar os pesos idênticos em um H100 dedicado a $2,20/hr.
Preciso auto-hospedar para estar em conformidade com o GDPR e a Lei de IA da UE?
Não. Compliance é sobre localização de dados, acordos de processamento e documentação, nenhum dos quais exige que você possua a pilha de inferência. As apostas são reais (os reguladores emitiram €7,1 bilhões em 2.245 multas do GDPR até o início de 2026, e a exposição chega a 4% do faturamento global sob o GDPR mais até 7% sob a Lei de IA, conforme Kiteworks), mas as opções de hospedagem gerenciada e soberana na região da UE agora cobrem a maioria do que um encarregado de proteção de dados solicita. Auto-hospede quando um contrato ou regulador proibir especificamente o processamento por terceiros, não como uma cobertura geral.
Devo comprar GPUs ou alugá-las durante a escassez de memória de 2026?
Alugue, a menos que você tenha uma carga de trabalho de vários anos que mantenha as placas ocupadas. A NVIDIA RTX PRO 6000 Blackwell 96GB passou de um preço varejista de $8.565 no início de 2025 para $13.250 em junho de 2026 e $16.000 em agosto de 2026, cerca de 87% a mais por um produto inalterado (igor'sLAB). A causa é a memória: o HBM agora ocupa uma estimativa de 23% da capacidade global de wafers de DRAM versus 8% em 2024, e os preços do DDR5 ECC RDIMM de servidor subiram cerca de 100 a 116% entre o primeiro trimestre de 2025 e o primeiro trimestre de 2026 (DataCenterDisk). A Goldman Sachs previu um déficit de DRAM de 4,9% para 2026, o maior em 15 anos, com alívio improvável antes do final de 2027 (Wccftech), então planeje preços de compra elevados e aproveite o spread do mercado de aluguel, de $2,20/hr para um H100 dedicado na DeepInfra até $4,29/hr na Lambda.