

Seu pipeline multimodal não vai falhar por causa de alucinação de um modelo. Vai falhar porque a URL de download do Sora expirou 61 minutos após o término do render, ou porque o seu podcast de 90 minutos bateu no limite de 25 MB de transcrição do OpenAI enquanto a AssemblyAI teria aceito o arquivo de 5 GB inteiro em uma única requisição.
Cada salto entre modelos tem um contrato: um formato de arquivo exato, um plano que o desbloqueia, uma janela de expiração e um fallback para quando o fornecedor descontinuar o modelo. A maioria dos guias pula os quatro.
Este guia traz os contratos, três pipelines completos e o plano de substituição que você precisa ter antes que o OpenAI encerre a Videos API e os dois modelos Sora 2 em 24 de setembro de 2026 sem nenhum substituto listado. Faltam 19 dias.
Por que pipelines multimodais quebram nas transferências, não nos modelos
Cada modelo da sua cadeia funciona. A transcrição é precisa, a imagem ficou certa, a voz soa humana, o vídeo renderizou. O que quebra é o momento em que a saída de um modelo precisa virar a entrada do próximo, e ninguém documentou como essa saída deveria ser.
Um exemplo concreto: as URLs de download de ativos gerados pelo Sora ficam válidas por no máximo uma hora após a geração, e a saída chega como um MP4 mais uma miniatura WebP e um spritesheet JPG (OpenAI). Se o seu pipeline enfileira o render e chega à etapa de cópia 90 minutos depois, o render sumiu. O modelo fez seu trabalho perfeitamente.
O contrato de transferência: formato, plano, expiração, fallback
Trate cada salto como um contrato com quatro cláusulas que você anota antes de construir qualquer coisa.
Formato é a especificação exata de arquivo que o próximo salto exige, até a taxa de amostragem e as dimensões em pixels, não uma proporção de tela e uma esperança. Plano é o nível de assinatura ou o parâmetro de API que desbloqueia esse formato, porque muitos dos formatos necessários ficam travados atrás de uma assinatura paga ou de um nome de modelo legado. Expiração é por quanto tempo o artefato fica disponível no fornecedor antes que a perda seja sua. Fallback é o que você troca quando o fornecedor encerra o modelo, o que agora não é hipotético.
Documente essas quatro linhas por salto e a maior parte do debugging desaparece antes mesmo de você começar.
Quatro modos de falha que matam um pipeline no meio da execução
- O salto anterior emite um formato que o próximo silenciosamente rebaixa ou rejeita por completo.
- Uma funcionalidade que você assumiu estar na API está, na verdade, atrás de um plano superior ou de uma versão de modelo mais antiga.
- O artefato expira no armazenamento do fornecedor enquanto seu job ainda está na fila.
- O modelo sobre o qual você construiu recebe uma data de encerramento e o fornecedor não lista nenhum substituto recomendado.
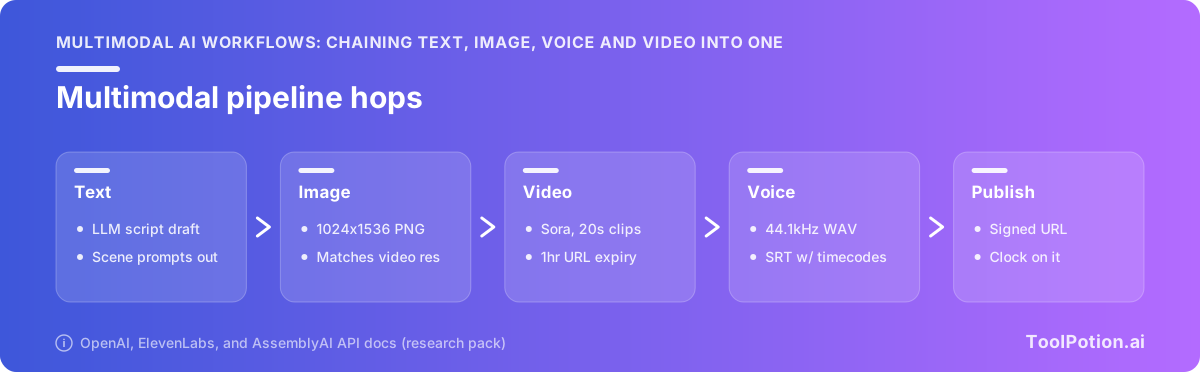
Os três pipelines a seguir são todos instâncias do mesmo contrato: podcast em notas de episódio, roteiro em vídeo narrado e foto de produto em conjunto de campanha. Cada um nomeia o formato, o plano, a expiração e o fallback em cada salto.
Este guia é escrito para quem está entregando um produto, não para quem está comparando arquiteturas de fusão. Você pode escolher as ferramentas individuais entre as 18.982 ferramentas de IA ativas em nosso diretório. Conectá-las é a parte que ninguém documenta.
Pipeline 1: post de blog em vídeo narrado
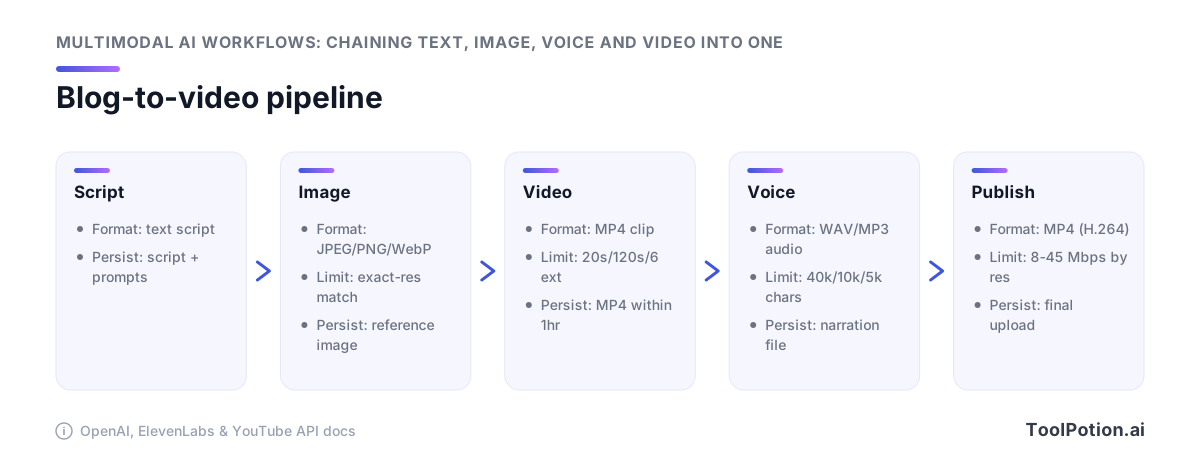
Você tem um artigo de 1.200 palavras e quer um vídeo narrado de dois minutos no final. Quatro saltos: dividir o texto, gerar imagens fixas, animá-las, narrar por cima. Cada um desses saltos tem uma especificação que o salto anterior precisa satisfazer, e você define a maioria dessas especificações antes de fazer uma única chamada de API.
Segmentação do roteiro antes de qualquer chamada de geração
Segmentação não é uma etapa de formatação que você faz no final. É o parâmetro que tudo o que vem depois herda, porque o modelo de voz que você escolhe limita o que pode ser enviado por requisição. O Eleven Flash v2.5 aceita 40.000 caracteres, o Multilingual v2 aceita 10.000 e o v3 para em 5.000 (ElevenLabs). Escolha o v3 para narração expressiva e seu roteiro de 1.200 palavras cabe em uma chamada. Escolha-o para um explicativo de 9.000 palavras e você está dividindo em dois, com uma costura que precisa esconder.
Segmente nas fronteiras de cena, não na contagem de frases. Cada segmento precisa de uma ideia visual, uma duração-alvo em segundos e uma resolução em pixels-alvo anexada como metadado. Esse último campo é o que o salto de imagem lê.
Salto de imagem: respeite as dimensões exatas em pixels do salto de vídeo
O caminho de imagem para vídeo do Sora exige que a imagem de referência corresponda exatamente à resolução do vídeo de destino, em image/jpeg, image/png ou image/webp (OpenAI). Exatamente significa pixels, não "16:9". Um gerador de imagens instruído a produzir um still widescreen vai felizmente entregar 1792x1024 quando a chamada de vídeo quer 1280x720, e o job falha na submissão e não no render. Por isso, o template de prompt de imagem carrega largura e altura como inteiros literais extraídos da configuração do salto de vídeo, e você valida as dimensões e o tipo MIME do arquivo retornado antes de enfileirar qualquer outra coisa. Entre os 324 modelos de IA rastreados em nosso diretório, os que permitem especificar dimensões em pixels arbitrárias em vez de presets nomeados são os que vale a pena integrar aqui.
Salto de vídeo: clipes de 16 e 20 segundos, encadeados
Tanto o sora-2 quanto o sora-2-pro geram clipes de 16 ou 20 segundos. Cada extensão adiciona até 20 segundos, limitada a seis extensões e 120 segundos no total (OpenAI). Seu segmento de dois minutos são seis chamadas encadeadas.
A continuidade entre essas seis é problema seu. O modelo não lembra o arco narrativo entre a extensão 3 e a extensão 4, então o prompt de cada chamada precisa reafirmar o cenário, o sujeito e o comportamento da câmera. Planeje retentativas nas costuras.
Salto de voz e o mux
Gere narração por segmento, não por vídeo, para que uma tomada ruim custe apenas uma chamada. Depois alinhe: o áudio do segmento 4 precisa caber no clipe de 20 segundos que você renderizou para o segmento 4, o que normalmente significa cortar o texto do roteiro em vez de esticar o áudio. Faça o mux com ffmpeg, um segmento de cada vez, depois concatene.
Pipeline 2: episódio de podcast em clipes e notas de episódio
Entra um WAV de 58 minutos. Saem uma transcrição, capítulos com timestamps, seis clipes verticais com legendas gravadas e uma página de notas de episódio. O áudio nunca muda de formato após o primeiro salto, o que torna esse pipeline mais fácil do que o de vídeo. O que decide se funciona é para qual fornecedor de transcrição você roteia e quais três parâmetros você define na requisição.
O muro dos 25 MB e como contorná-lo
O endpoint de transcrição do OpenAI limita uploads a 25 MB e aceita mp3, mp4, mpeg, mpga, m4a, wav e webm (OpenAI). Um WAV a 48kHz de 58 minutos tem aproximadamente 300 MB. Então você ou transcode para um MP3 de baixo bitrate e torce, ou divide o arquivo, e dividir áudio em limites arbitrários de bytes corta palavras ao meio e desloca todos os timestamps após a costura.
A AssemblyAI aceita até 5 GB por requisição em /v2/transcript (2,2 GB se você estiver fazendo upload de arquivos locais via /v2/upload) e lida com durações de 160 ms a 10 horas (AssemblyAI). Isso é cerca de 200x o limite. Para áudio de longa duração, envie o episódio inteiro para lá e reserve seu fornecedor de LLM para os saltos de raciocínio a seguir.
Timestamps em nível de palavra são o primitivo para cortar clipes
Você não consegue cortar clipes automaticamente de uma transcrição que só tem fronteiras de parágrafo. Você precisa saber que a palavra "bom" começa em 00:41:12.340 para o corte cair antes dela, não no meio.
Dois pontos de atenção no lado do OpenAI. A saída SRT e VTT mais o parâmetro timestamp_granularities[] só funcionam no whisper-1, não no gpt-transcribe ou gpt-4o-transcribe (OpenAI). Se o seu pipeline grava legendas ou corta em timecode, você mantém o modelo mais antigo na cadeia de propósito e para de tratá-lo como dívida técnica. O ElevenLabs Scribe v2 entrega timestamps em nível de palavra, diarização e detecção de entidades em mais de 90 idiomas em uma única resposta (ElevenLabs), o que é a escolha mais limpa se você já está pagando por eles para o salto de TTS.
Diarização só funciona se você pedir
Os rótulos de locutor precisam que chunking_strategy seja definido como auto para qualquer áudio com mais de 30 segundos, e o gpt-4o-transcribe-diarize faz apenas identificação de locutor (OpenAI). Omita o parâmetro e a requisição tem sucesso. Você recebe de volta uma parede de texto limpa, fluente e completamente sem rótulos, e nada na resposta avisa que uma entrevista com dois hosts colapsou em uma única voz. Verifique os campos de locutor na sua etapa de validação, não a olho.
Transcrição em notas de episódio, capítulos e texto para redes sociais
Uma transcrição com timings de palavras se desdobra em quatro artefatos sem nenhum processamento de áudio adicional: marcadores de capítulo a partir de mudanças de tema, um parágrafo de resumo mais lista de links para a página de notas, candidatos a clipes ranqueados por densidade de citações e os cortes verticais renderizados a partir desses pontos de entrada e saída. Alimente a mesma transcrição para cada um, em paralelo, com prompts diferentes. Se você estiver procurando referências de formato antes de construir, há 201 podcasts de IA em nosso diretório publicando nessa stack.
Pipeline 3: fotos de produto em variantes de anúncio
Uma foto de estúdio de um tênis se torna doze imagens com identidade visual, depois quatro anúncios de movimento de 8 segundos para social pago. Os saltos são imagem de entrada, imagem de saída, vídeo de saída, e a engenharia interessante fica entre os saltos dois e três, onde um modelo de visão analisa o que o gerador de imagens produziu e decide se vai para produção.
Revisão por modelo de visão como porta de controle de qualidade
Imagens de produto geradas falham de formas previsíveis. Logo no lugar errado, seis ilhós em vez de cinco, uma sombra que contradiz a luz principal. Você não quer um humano conferindo 120 variantes, então você as envia a um modelo de visão com a foto original e uma especificação de marca escrita, pedindo aprovação/reprovação mais uma string de motivo.
O Claude aceita até 100 imagens por requisição em modelos de contexto 200k e 600 em outros modelos, com 20 por mensagem no claude.ai, limitado a 8000x8000 px e 10 MB por imagem (Claude Docs). Esses não são os números que vão te pegar.
O limite padrão de tamanho de requisição de 32 MB vai. Doze PNGs 4K estouram esse limite muito antes de você chegar a 100 imagens, motivo pelo qual a Anthropic recomenda fazer upload via Files API e referenciar cada imagem por file_id em vez de incorporar base64 (Claude Docs). Construa o salto de revisão dessa forma desde o primeiro dia. Adaptá-lo depois que os tamanhos de lote crescerem significa reescrever o construtor de requisições e a lógica de retentativa juntos.
Amostragem de frames é um alavancador direto de custo
O Claude cobra imagens como tokens visuais de 28x28 pixels, calculados como ⌈largura/28⌉ × ⌈altura/28⌉. Um frame de 3840x2160 custa 4.784 tokens visuais no nível de alta resolução e 1.560 após redimensionamento no nível padrão, cerca de $23,92 por mil frames 4K à taxa de $5/M de entrada do Claude Opus 5 (Claude Docs). Redimensione antes de enviar, a menos que a verificação de controle de qualidade dependa de detalhes finos como costuras ou texto pequeno.
A mesma matemática governa o salto de análise de vídeo. Revisar quatro anúncios de 8 segundos a 24fps são 768 frames se você for ingênuo. Amostre a 2fps, verifique 64, e sua conta de revisão cai por um fator de doze sem perder uma única mudança de cena.
Agrupamento de imagens sem atingir o teto da requisição
Agrupe por bytes de payload, não por contagem de imagens. Organize as variantes em grupos que fiquem abaixo de cerca de 25 MB de referências, mantenha a foto original em cada lote como âncora de comparação e reenvie falhas individualmente em resolução total para que a string de motivo valha a pena ler. Nosso diretório lista 727 geradores de imagem e 342 editores de foto entre as ferramentas de imagem e foto com IA em nosso diretório, e quase nenhuma delas expõe as mecânicas de lote que você precisa aqui. Essa parte fica no seu código.
A planilha de especificações de transferência: o que exigir em cada salto
Escreva o contrato antes de escrever o código. Cada salto em uma cadeia tem três coisas que você precisa definir: o formato exato de saída que está pedindo, o plano ou parâmetro que o desbloqueia e por quanto tempo o artefato existe antes de sumir. Erre essas e a falha aparece dois saltos depois como uma reclamação de qualidade que ninguém consegue rastrear.
Áudio: o plano que bloqueia a saída em qualidade broadcast
O ElevenLabs coloca pcm_44100, pcm_48000, wav_44100 e wav_48000 atrás de uma assinatura Pro, e mp3_44100_192 atrás do Creator (referência da API ElevenLabs). Então em um plano gratuito ou básico, seu editor de vídeo recebe MP3 com perdas a 128kbps ou menos, não importa quão bom seja o modelo de voz. Esse é um teto de qualidade definido pelo faturamento, não pela inferência.
Se o seu entregável é um podcast que precisa atingir -16 LKFS com pico verdadeiro em ou abaixo de -1 dBFS (Apple Podcasts), você quer sem perdas na entrada e uma única codificação no final. Normalizar um MP3 de 128kbps e recodificá-lo empilha duas gerações com perdas. Inclua o plano Pro como custo de produção, não como upgrade.
Vídeo: URLs com expiração e ativos auxiliares
O Sora não entrega um único arquivo. Um render concluído fornece um MP4, uma miniatura WebP e um spritesheet JPG, e as URLs de download ficam válidas por no máximo uma hora (guia de vídeo do OpenAI). Seu job nesse salto é uma cópia para seu próprio object store, disparada pelo evento de conclusão, não por um batch noturno. Perca a janela e o render é irrecuperável.
Texto e timing: os campos que as etapas seguintes exigem
As etapas seguintes exigem campos específicos de forma rígida, e os que precisam de timing são os que quebram silenciosamente. A saída SRT e VTT mais timestamp_granularities[] só funcionam no whisper-1, não nos modelos de transcrição mais novos (fala para texto do OpenAI). Qualquer coisa que corte clipes ou grave legendas precisa de timestamps em nível de palavra no contrato.
| Salto | Exija esta saída | O que o desbloqueia | Expiração |
|---|---|---|---|
| Texto para voz | wav_48000 ou pcm_44100 | Plano Pro; Creator para mp3_44100_192 | Sem expiração, armazene na escrita |
| Voz para texto | Timestamps em nível de palavra, rótulos de locutor | whisper-1 para SRT/VTT; chunking_strategy: auto acima de 30s para diarização | Sem expiração |
| Imagem para vídeo | MP4 mais miniatura e spritesheet | Imagem de referência correspondendo exatamente à resolução do vídeo | 1 hora nas URLs de download |
| Vídeo para texto | Frames amostrados a uma taxa fixa | Nível padrão vs. alta resolução muda o custo de token visual ~3x | Sem expiração |
Qualquer orquestrador que você escolher entre os 128 frameworks de IA em nosso diretório, teste-o contra os saltos binários primeiro. Passar JSON entre modelos é a parte fácil.
Plataforma de automação ou cola manual
A regra é simples: deixe a plataforma decidir o que acontece e quando, e deixe seu próprio código mover os bytes. Qualquer coisa que toque um arquivo grande ou dispute uma janela de expiração pertence a um script com object storage por trás.
Onde uma plataforma vence
Triggers, retentativas em etapas baratas, portas de aprovação e o fan-out no final. O Zapier anuncia mais de 9.000 integrações de aplicativos conectadas em Zaps, Tables, Forms e Zapier MCP, e esse catálogo é o motivo real para usá-lo. Colocar as notas de episódio finalizadas no seu CMS e os links de clipes em um calendário de conteúdo é trabalho de conector, e escrever esses conectores você mesmo não agrega nada.
Revisão humana no loop também pertence aqui. Um Zap que posta quatro variantes de anúncio no Slack, aguarda uma aprovação, depois libera a etapa de publicação são vinte minutos de configuração e a única coisa entre uma afirmação de produto alucinada e seu orçamento de social pago.
Onde mídia binária a derrota
Nós de no-code passam JSON bem e arquivos mal. Um WAV de 58 minutos precisa ser dividido em pedaços de 25 MB ou menos antes que o endpoint de transcrição do OpenAI o aceite (OpenAI). Um render do Sora de dois minutos são até seis chamadas de extensão encadeadas de 20 segundos cada (OpenAI), e a URL de download é válida por no máximo uma hora após a geração (OpenAI). Lógica de retry em seis chamadas com uma contagem regressiva rodando no artefato é um programa, não um canvas.
Duas plataformas lidam com mídia. O n8n mantém arquivos como dados binários entre nós em vez de forçar conversões base64, e seu nó de código fica ao lado dos nós de agente (n8n). O Descript expõe transcrição, clipes e legendas via API em vez de via interface gráfica (Descript).
O caminho do meio: plataforma para fluxo de controle, código para bytes
Cada salto escreve no seu próprio bucket e retorna uma chave. A plataforma passa chaves e códigos de status, nunca o arquivo. Organizar o trabalho dessa forma também reduz o processamento: o sistema OnePiece relata uma diminuição de 16x no consumo de GPU para Wan2.1 image-to-video ao decompor um pipeline monolítico em serviços em estágios (arXiv).
Se você está escolhendo componentes, nosso diretório rastreia 550 agentes de IA e ferramentas de orquestração ao lado de 301 repositórios de IA open-source. Os repos são onde a cola para mover bytes geralmente vive, porque nenhum fornecedor vende essa parte.
Especificações de entrega: chegando onde a plataforma publica
Seu último salto não é o render. É o upload, e o upload também tem uma planilha de especificações.
Vídeo: metas de bitrate e áudio para upload
O YouTube publica bitrates de entrega recomendados por resolução: 8 Mbps para 1080p SDR, 16 Mbps em 1440p e 35–45 Mbps em 4K, com áudio entregue como AAC-LC, Opus ou Eclipsa a 48 kHz e 384 kbps estéreo (YouTube Help). Se o seu salto de vídeo entrega um arquivo bem abaixo desses números, não aumente o bitrate na exportação. Você vai gastar tempo de codificação preenchendo artefatos de compressão. O que você deve fazer é fazer a etapa de codificação ler a resolução de origem e escolher o alvo correspondente, para que um render do Sora em 1080p não seja forçado a escalar para 4K porque alguém codificou isso fixo em uma config há seis meses.
A meta de áudio importa mais do que a de vídeo para conteúdo narrado. Uma faixa AAC a 48 kHz e 384 kbps de uma fonte a 44,1 kHz significa uma reamostragem em algum lugar, e você quer que essa reamostragem aconteça uma vez, na sua própria chamada ffmpeg, onde você possa vê-la.
Áudio: precondicionamento de loudness antes da codificação
O Apple Podcasts pede -16 dB LKFS ±1 dB com pico verdadeiro em ou abaixo de -1 dB FS, medido conforme ITU-R BS.1770-5, e é explícito que o áudio deve ser precondicionado para esse alvo antes da codificação (Apple Podcasts for Creators). Ordem das operações, não uma preferência. Normalizar um MP3 finalizado significa empurrar ganho através de artefatos com perdas que foram incorporados em um nível diferente, e o pico verdadeiro em um MP3 decodificado já pode exceder o que o codificador viu. Aplique o passe de loudness no WAV, depois codifique.
É por isso que o nível do formato TTS do início da cadeia continua importando. Entregar ao seu normalizador um MP3 de 128 kbps é um ponto de partida pior do que entregar PCM, e nenhum cuidado posterior corrige isso.
Proveniência e rotulagem de ativos gerados
Decida sobre proveniência enquanto você está desenhando o pipeline, não depois que uma plataforma perguntar. O SynthID do Google marca mídia gerada no momento da criação, o que significa que ela viaja com o ativo apenas se o seu pipeline não a remover ou recodificá-la. Cada passe de ffmpeg entre a geração e o upload é uma chance de perder esse sinal, então registre qual salto introduziu o arquivo e mantenha um registro de modelo, prompt e timestamp no seu próprio armazenamento de metadados em vez de confiar que o container vai carregá-lo.
Construa para a troca: o abismo de depreciação embaixo de cada salto de vídeo
Se o seu salto de vídeo chama o Sora, você tem 19 dias. O OpenAI anunciou em 24 de março de 2026 que a Videos API e os dois modelos sora-2 e sora-2-pro serão encerrados em 24 de setembro de 2026, snapshots sora-2-2025-10-06, sora-2-2025-12-08 e sora-2-pro-2025-10-06 incluídos, sem nenhum modelo substituto recomendado listado (depreciações do OpenAI). Uma coluna de substituição vazia significa que você escolhe o sucessor por conta própria, e você escolhe antes do prazo, não depois.
Abstraindo o salto para que uma troca seja uma mudança de configuração
A solução é um adaptador fino por salto generativo. Seu pipeline entrega ao adaptador um job normalizado: prompt, caminho da imagem de referência, resolução alvo, duração em segundos, chave do bucket de saída. O adaptador é dono de tudo que tem forma de fornecedor. A regra do Sora de que a imagem de referência deve corresponder exatamente à resolução do vídeo, seus clipes de 16 e 20 segundos estendidos em passos de 20 segundos até um teto de 120 segundos, sua expiração de download em 1 hora (geração de vídeo do OpenAI). Nada disso vaza para o seu código de orquestração.
Então trocar de fornecedor é um valor de configuração, não uma reescrita. Valide um segundo adaptador contra a documentação de modelos do Runway agora, rode ambos nos mesmos dez prompts e mantenha o perdedor aquecido.
As famílias de imagem e áudio carregam suas próprias datas, então trate isso como manutenção recorrente em vez de uma correria única. Nosso diretório existe parcialmente para deixar você acompanhar lançamentos e encerramentos de modelos entre 324 modelos listados.
Um checklist de migração para pipelines rodando hoje
- Faça grep em todos os repositórios e JSONs de workflow por
sora-2,sora-2-proe o caminho base da Videos API. Inclua cron jobs e scripts avulsos, que é onde as chamadas esquecidas vivem. - Envolva cada ocorrência em um adaptador com seu próprio schema de job antes de mudar de fornecedor, para que a troca e a refatoração não sejam o mesmo commit.
- Rode o fornecedor alternativo em dez prompts reais e compare as saídas em resolução, duração do clipe e qualidade de movimento.
- Configure um lembrete de calendário duas semanas antes de cada data de encerramento publicada, por fornecedor, por família de modelo.
- Registre o ID do modelo e o snapshot em cada render para que você consiga responder 'o que gerou esse ativo' depois que o modelo for descontinuado.
Perguntas Frequentes
O que é um workflow de IA multimodal, em termos práticos?
É uma cadeia de chamadas de API onde o arquivo de saída de um modelo se torna o arquivo de entrada do próximo, e cada salto tem um contrato de formato que você precisa satisfazer. Uma cadeia típica vai de transcrição para roteiro para imagem estática para vídeo para narração para render final, e cada seta é um lugar onde uma resolução ou codec errado quebra a execução. O salto de imagem para vídeo do Sora é um bom exemplo de como esses contratos são literais: a imagem de referência precisa corresponder exatamente à resolução do vídeo de destino e ser image/jpeg, image/png ou image/webp, então a etapa de imagem upstream precisa das dimensões em pixels da etapa de vídeo, não apenas de uma proporção (docs de geração de vídeo do OpenAI). Pense no pipeline como um conjunto de transferências em vez de um conjunto de ferramentas.
Como encadeio ferramentas de IA sem perder qualidade entre as etapas?
Defina a especificação de saída em cada salto com base no que a última etapa da cadeia precisa, depois trabalhe de trás para frente. A perda de qualidade geralmente vem de um nível de preço ou de um parâmetro padrão, não do modelo: o ElevenLabs coloca pcm_44100, pcm_48000, wav_44100 e wav_48000 atrás de uma assinatura Pro e mp3_44100_192 atrás do nível Creator, então uma conta básica entrega ao seu editor um MP3 com perdas independentemente do que você queria (referência de criação de fala do ElevenLabs). Copie cada artefato gerado para seu próprio object store imediatamente, porque as URLs de download do Sora são válidas por no máximo uma hora após a geração (docs de geração de vídeo do OpenAI). A taxa de amostragem também é um alavancador de custo, não apenas de qualidade: o Claude precifica um frame 4K em 4.784 tokens visuais no nível de alta resolução versus 1.560 no padrão, cerca de $23,92 por mil frames 4K à taxa de $5/M de entrada do Opus 5 (docs de visão do Claude).
Qual formato de áudio devo entregar de uma etapa de texto para voz a um editor de vídeo?
WAV ou PCM sem compressão a 48 kHz, o que no ElevenLabs significa wav_48000 ou pcm_48000 e uma assinatura Pro ou superior (referência de criação de fala do ElevenLabs). Entregar ao editor um MP3 de 128 kbps incorpora artefatos de compressão que sobrevivem a cada codificação posterior. Se o destino é o YouTube, a meta de entrega final é AAC-LC, Opus ou Eclipsa a 48 kHz e 384 kbps estéreo (configurações de codificação de upload do YouTube), e se for um feed de podcast, o Apple quer loudness precondicionado para -16 dB LKFS ±1 dB com pico verdadeiro em ou abaixo de -1 dB FS, medido conforme ITU-R BS.1770-5, antes de você codificar (requisitos de áudio do Apple Podcasts). Você não consegue atingir nenhum dos dois alvos de forma confiável a partir de um intermediário com perdas.
Por que a transcrição do meu podcast falha em episódios completos?
O endpoint de transcrição do OpenAI limita uploads a 25 MB e aceita mp3, mp4, mpeg, mpga, m4a, wav e webm, então qualquer coisa mais longa do que cerca de meia hora em bitrate decente precisa ser dividida em pedaços de 25 MB ou menos (docs de fala para texto do OpenAI). É por isso que pipelines de longa duração geralmente roteiam a transcrição para fora do fornecedor de LLM: a AssemblyAI aceita até 5 GB por requisição em /v2/transcript (2,2 GB para uploads locais) e arquivos de 160 ms a 10 horas, cerca de 200x o limite do OpenAI (docs de áudio pré-gravado da AssemblyAI). Dois outros modos de falha parecem sucesso: a diarização de locutor retorna silenciosamente texto sem rótulos a menos que você defina chunking_strategy como 'auto' para áudio mais longo que 30 segundos, e a saída SRT/VTT mais timestamp_granularities[] só funciona no whisper-1, não no gpt-transcribe ou gpt-4o-transcribe (docs de fala para texto do OpenAI). Se você precisar de timestamps em nível de palavra para corte automático de clipes, o ElevenLabs Scribe v2 os entrega em mais de 90 idiomas junto com diarização (modelos ElevenLabs).
Devo construir um pipeline de conteúdo de IA no n8n ou Zapier, ou escrever o código eu mesmo?
Escreva código para qualquer salto que mova mídia binária, e use uma plataforma de automação para os triggers, aprovações e notificações ao redor disso. O ponto forte do Zapier é a amplitude, com mais de 9.000 integrações de aplicativos declaradas pelo fornecedor mais Zaps, Tables, Forms e Zapier MCP (plataforma de desenvolvedor Zapier), que é exatamente o que você quer para "nova linha no Airtable, inicie o render, poste o link no Slack." É a camada errada para um MP4 de 200 MB com URL de expiração de uma hora. O n8n fica no meio, já que seus nós de agente e o tratamento de passagem binária permitem manter arquivos dentro do workflow (docs do Tools Agent n8n), e há um argumento de infraestrutura real para dividir a cadeia em estágios em vez de um monolito: o paper OnePiece relata uma diminuição de 16x no consumo de GPU ao decompor um pipeline AIGC em microsserviços em estágios para Wan2.1 image-to-video (arXiv).
O que substitui o Sora em um pipeline de vídeo após o encerramento de setembro de 2026?
O OpenAI anunciou em 24 de março de 2026 que a Videos API e os modelos sora-2 e sora-2-pro (snapshots sora-2-2025-10-06, sora-2-2025-12-08 e sora-2-pro-2025-10-06) serão encerrados em 24 de setembro de 2026, e não lista nenhum modelo substituto recomendado (depreciações do OpenAI). A partir de 5 de setembro de 2026 faltam 19 dias, então a medida prática é colocar seu salto de vídeo atrás de uma interface fina hoje e apontá-la para outro fornecedor, com a API do Runway como a troca mais direta a avaliar (docs de modelos do Runway). Planeje também uma reescrita da sua lógica de divisão, já que os limites do Sora moldaram muitos pipelines: clipes de 16 e 20 segundos, até 20 segundos adicionados por extensão e um máximo de 120 segundos em até seis extensões, o que fez de um segmento narrado de dois minutos seis chamadas encadeadas (docs de geração de vídeo do OpenAI). Se você estiver pesquisando alternativas, nosso diretório atualmente rastreia 452 ferramentas em Geradores de Vídeo com IA.