

Seus resultados são mediocres porque suas entradas estão infladas, desatualizadas ou mal ordenadas. Não porque você formulou o prompt errado. A própria documentação da Anthropic é direta: "mais contexto não é automaticamente melhor. À medida que a contagem de tokens aumenta, a precisão e o recall degradam, um fenômeno conhecido como context rot" (Claude Platform docs). O context engineering é a solução, e a Anthropic o define como a curadoria de "o conjunto ideal de tokens (informações) durante a inferência de LLM" (Anthropic Engineering).
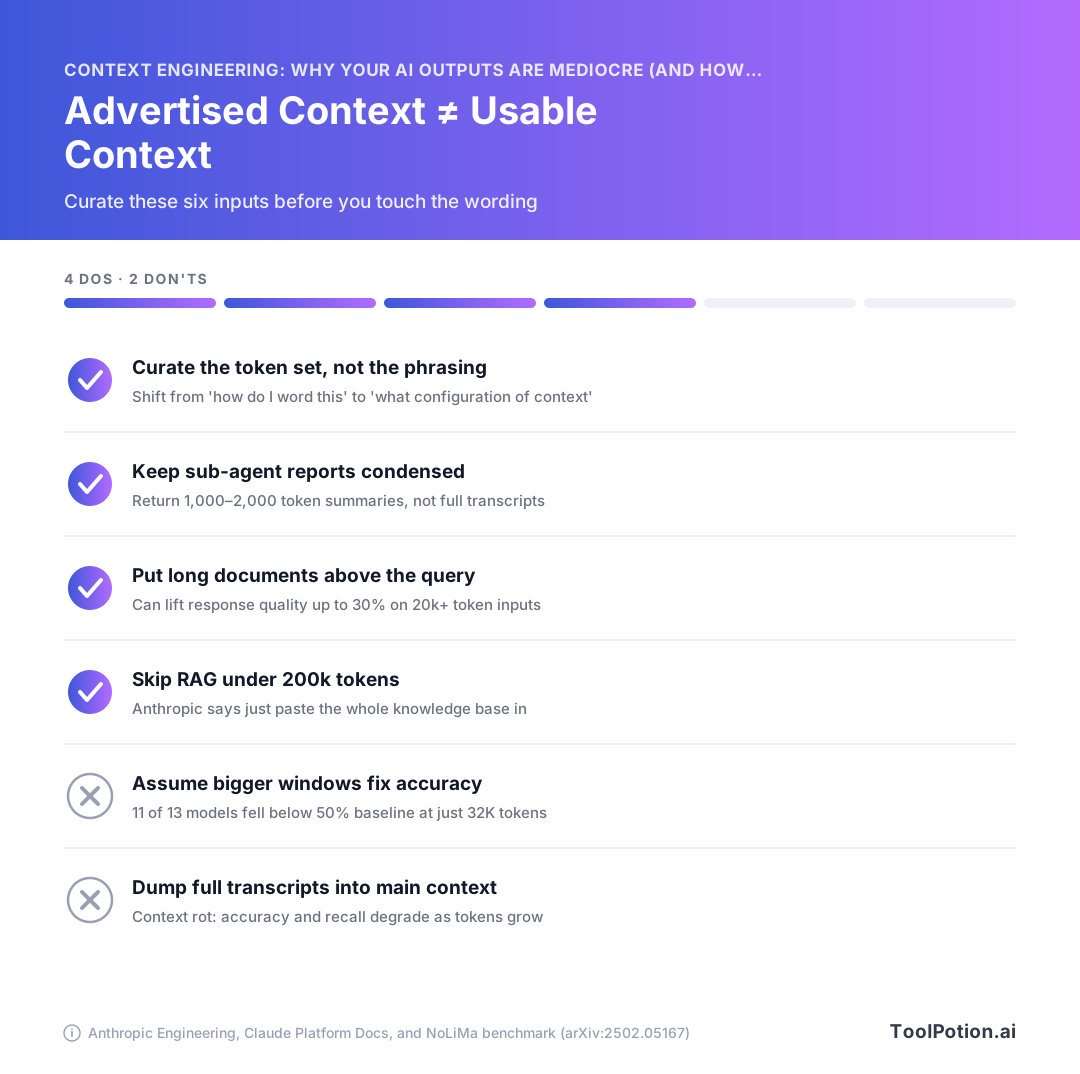
Os números não são gentis com o hábito maximalista. No NoLiMa, 11 de 13 modelos que anunciam contexto de 128K ou mais caíram abaixo de metade de sua pontuação com contexto curto aos 32K tokens (arXiv:2502.05167).
Este é um guia prático para quem usa ChatGPT, Claude, Gemini e Copilot em vez de construir frameworks de agentes: qual ajuste fazer, em qual produto, e o que vale a pena.
Context engineering é o que substituiu a magia do prompt
Se seus resultados são mediocres, a formulação do seu prompt raramente é o problema. O context engineering é a prática que corrigiu isso: a Anthropic o define como "o conjunto de estratégias para curar e manter o conjunto ideal de tokens (informações) durante a inferência de LLM, incluindo todas as outras informações que podem aparecer ali além dos prompts", e o chama de progressão natural do prompt engineering (Anthropic Engineering). A pergunta mudou de "como eu formulo isso?" para "qual configuração de contexto tem maior probabilidade de gerar o comportamento desejado do nosso modelo?"
De "como eu formulo isso?" para "o que deve estar na janela?"
A formulação ainda importa nas margens. Ela simplesmente deixou de ser onde está a alavancagem. Uma pergunta perfeitamente formulada contra uma janela inflada e meio relevante perde para uma pergunta direta contra uma janela limpa, e o restante deste artigo é principalmente evidência dessa afirmação.
A maioria das 212 ferramentas de prompt engineering que acompanhamos otimiza a frase que você digita. Quase nenhuma delas toca nas outras cinco coisas que compartilham a janela com ela.
As cinco entradas que você realmente controla
Cada requisição monta uma janela a partir de partes que você pode ver e alterar:
- As instruções do sistema, seja o campo de instruções de um GPT personalizado, a descrição de um Projeto Claude, ou um arquivo CLAUDE.md no seu repositório.
- Memória: o que o produto salvou sobre você entre sessões, geralmente sem mostrar o texto completo.
- Documentos anexados e sua qualidade de extração, que é a variável mais subestimada de toda a pilha.
- Chunks recuperados, se a ferramenta faz recuperação, mais o que o recuperador decidiu ser relevante.
- Turnos anteriores da conversa, incluindo cada beco sem saída que você abandonou vinte mensagens atrás.
- Definições de ferramentas, que consomem tokens independentemente de qualquer ferramenta ser chamada.
São seis, e você controla todas elas pela interface do produto. Sem framework, sem chave de API.
Portanto, este é um guia prático do lado das entradas, escrito para quem usa ChatGPT, Claude, Gemini e Copilot em vez de construir sistemas de agentes sobre eles. Qual ajuste fazer, em qual produto, e o que os números de 2026 dizem que vale.
Janela de contexto de IA explicada: tamanho anunciado vs. tamanho utilizável
O número na ficha técnica é um limite de armazenamento, não uma garantia de desempenho. Um modelo que aceita um milhão de tokens os aceitará com prazer e depois responderá pior do que teria com 3.000. Trate a janela anunciada como o teto de uma sala, não o tamanho da mesa em que você pode trabalhar.
O que realmente conta contra a janela
Mais do que você imagina. Cada parte de uma requisição de API ocupa o mesmo orçamento: o system prompt, cada mensagem no thread incluindo resultados de ferramentas, imagens e PDFs, as próprias definições de ferramentas, e a saída do modelo incluindo raciocínio estendido (Claude Platform docs). Prefixos em cache ainda ocupam a janela também. O prompt caching muda o que você paga por esses tokens, não se eles contam.
Assim, uma conversa que parece curta pode estar carregando 40.000 tokens de PDF anexado, esquemas de ferramentas e raciocínio anterior que você nunca vê. Essa é a parte que as páginas de enciclopédia deixam de fora.
O penhasco dos 32K que ninguém coloca na ficha técnica
O benchmark NoLiMa eliminou a sobreposição literal de palavras entre a pergunta e a resposta enterrada na pilha de palheiro, depois executou 13 modelos que todos alegam contexto de 128K ou mais. Abaixo de 1K tokens eles se saíram bem. Aos 32K, 11 dos 13 haviam caído abaixo de metade de sua própria linha de base de contexto curto, e o Llama 3.1 70B passou de 94,3% para 42,7% (NoLiMa, arXiv:2502.05167). Esse preprint é de fevereiro de 2025, portanto é anterior a todos os modelos na tabela abaixo. A forma da descoberta se sustentou em trabalhos mais recentes, mas as porcentagens específicas são evidências que estão envelhecendo, não um placar atual.
O que as janelas de hoje realmente são (números de 2026)
| Modelo | Janela de contexto | Saída máxima | Imagens/páginas de PDF por requisição |
|---|---|---|---|
| Claude Fable 5.1, Opus 5, Sonnet 5 (and Mythos 5.1, Opus 4.8/4.7/4.6, Sonnet 4.6) | 1M tokens, padrão, preço padrão | 128k | 600 |
| Claude Sonnet 4.5 e versões anteriores | 200k | — | 100 |
| OpenAI GPT-5.4 | 1.050.000 tokens | 128.000 | — |
A Anthropic oferece essa janela de 1M sem header beta e sem adicional (Claude Platform docs). A da OpenAI é nominalmente maior e tem precificação diferente: ultrapasse 272K tokens de entrada no GPT-5.4 e toda a sessão é cobrada a 2x na entrada e 1,5x na saída (OpenAI API docs). O excesso de tokens é uma linha de custo concreto ali, não apenas um imposto de qualidade.
Se você está comparando capacidades entre fornecedores, verifique a página de especificações do próprio modelo em vez de um comparativo: as janelas mudaram duas vezes só em 2026, e tabelas desatualizadas estão por toda parte. Nosso diretório de 324 modelos de IA é um ponto de partida para encontrar a página certa.
Context rot: por que adicionar mais geralmente piora os resultados
A degradação tem um mecanismo, e não é misterioso. Um transformer precisa modelar n² relacionamentos por pares em n tokens, portanto cada token adicionado faz todos os outros tokens competirem um pouco mais pela atenção do modelo. A equipe de engenharia da Anthropic chama isso de orçamento de atenção finito, análogo à memória de trabalho humana, e diz que a atenção fica "diluída" conforme o contexto cresce. A prescrição deles é direta: encontrar "o menor conjunto possível de tokens de alto sinal que maximize a probabilidade de algum resultado desejado."
O problema do orçamento de atenção
A própria documentação de produto da Anthropic admite o ponto em vez de tentar disfarçá-lo. "Mais contexto não é automaticamente melhor", diz a documentação da plataforma. "À medida que a contagem de tokens aumenta, a precisão e o recall degradam, um fenômeno conhecido como context rot." Isso é o fornecedor que te vende uma janela de 1M de tokens dizendo para você não preenchê-la.
Mesma pergunta, mesma resposta, 375x mais ruído
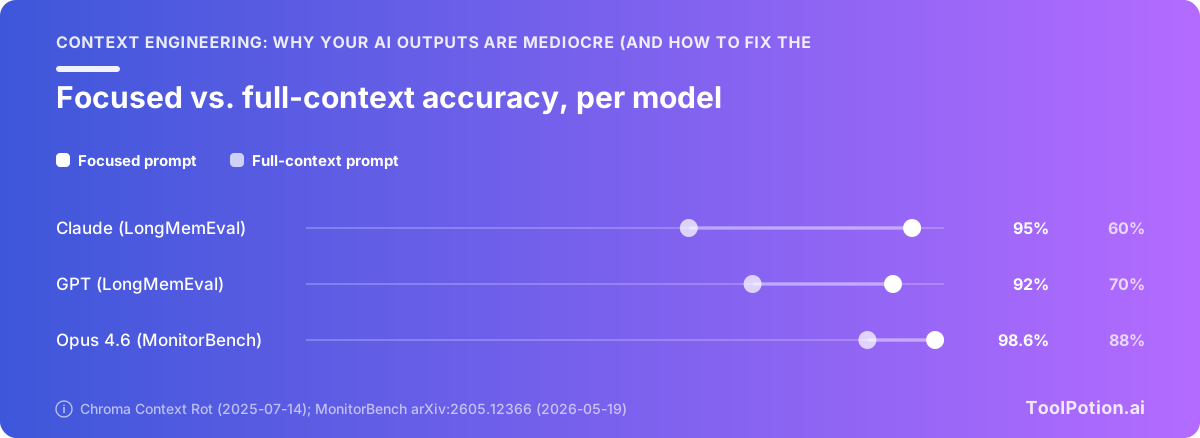
A Chroma testou 18 modelos, incluindo GPT-4.1, Claude 4, Gemini 2.5 e Qwen3, e descobriu que a confiabilidade cai com entradas mais longas mesmo em tarefas triviais como recuperação e replicação de palavras (Chroma). O teste LongMemEval é o que vale lembrar. Cada família de modelos teve desempenho significativamente melhor em prompts focados de aproximadamente 300 tokens contendo apenas os turnos relevantes do que em prompts completos de cerca de 113k tokens carregando todo o histórico da conversa, com os modelos Claude mostrando a maior diferença. Mesma pergunta. Mesma resposta presente no contexto nos dois casos. A única variável era a quantidade de material irrelevante ao redor.
A Chroma também descobriu que os modelos tiveram pontuações melhores em palheiros embaralhados do que em documentos logicamente coerentes, em todos os 18. O texto ao redor coerente dá ao modelo mais lugares de aterrissagem com aparência plausível. Esse relatório foi publicado em 14/07/2025, portanto tem mais de um ano e é anterior à geração atual de modelos.
O efeito não desapareceu com o tempo. No MonitorBench, adicionar 800k tokens de ações benignas e irrelevantes como prefixo reduziu o recall do Opus 4.6 de 98,6% para 88% (arXiv:2605.12366). Nada sobre a tarefa mudou. Apenas o preenchimento.
Onde isso te prejudica no uso normal
Você já viu isso sem nomear. O chat que acertou seu briefing na mensagem 12 e está produzindo conteúdo genérico na mensagem 90, porque o briefing agora está enterrado sob 78 mensagens de rascunhos meio abandonados. O notebook do NotebookLM onde você adicionou 40 fontes por precaução e começou a receber respostas mais vagas do que recebia com oito. A sessão de código onde o modelo esquece uma restrição que você declarou há uma hora e reescreve com confiança em torno dela.
Nada disso é o modelo ficando preguiçoso. É você gastando o orçamento de atenção em tokens que não justificam seu lugar.
Preparação de documentos: o passo que quase todo mundo pula
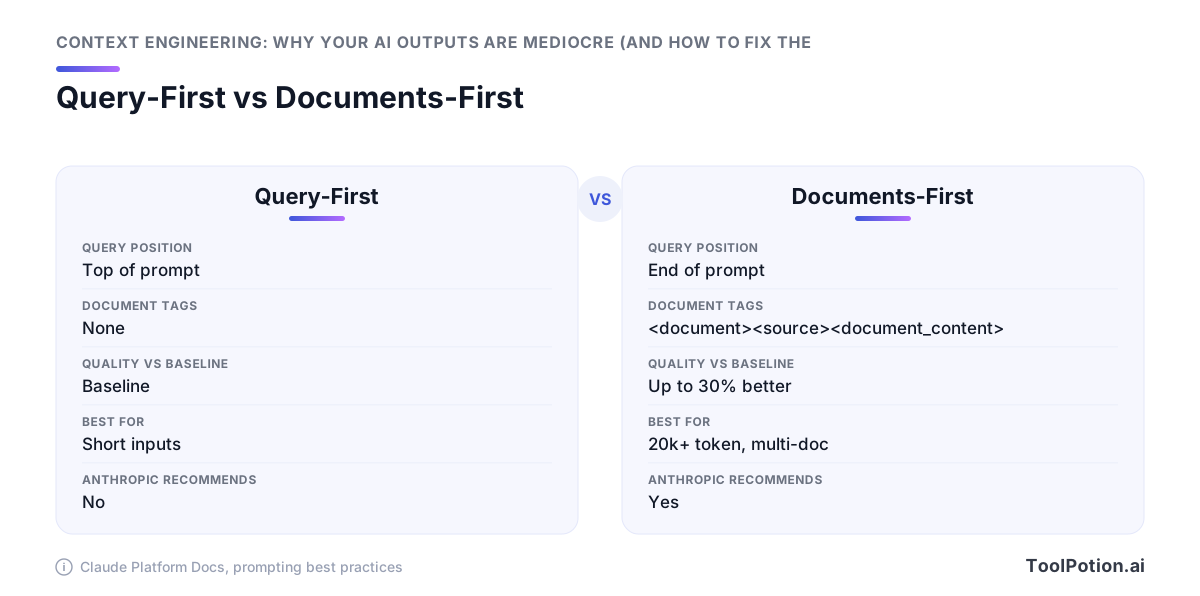
Onde você coloca um documento no prompt muda a resposta que você recebe. Para entradas acima de 20.000 tokens, a documentação de prompting da Anthropic diz para colocar dados extensos no topo, acima da sua consulta, instruções e exemplos: "consultas no final podem melhorar a qualidade das respostas em até 30 por cento nos testes, especialmente com entradas complexas de múltiplos documentos" (Claude Platform docs). A maioria das pessoas faz o oposto. Elas digitam a pergunta e depois colam o relatório embaixo.
Coloque o conteúdo longo no topo
Os mesmos documentos fornecem um modelo que vale copiar literalmente: envolva cada documento em tags <document> com subtags <source> e <document_content>, para que o modelo possa identificar onde um arquivo termina e o próximo começa (Claude Platform docs). Depois peça que ele cite as passagens relevantes antes de responder. Essa única linha força o modelo a localizar evidências no texto em vez de reconstruí-las do que ele meio que se lembra, e fornece algo verificável quando a resposta parece errada.
<document>
  <source>Q3-board-deck.pdf</source>
  <document_content>...full text here...</document_content>
</document>
<document>
  <source>renewal-contract-2026.pdf</source>
  <document_content>...full text here...</document_content>
</document>

Before answering, quote the passages you relied on.
Question: which renewal terms conflict with the Q3 revenue plan?
Marque suas fontes para que o modelo possa citá-las
Uma ressalva antes de padronizar nisso: os fornecedores discordam. A Anthropic coloca dados longos primeiro; a orientação do Google aponta para o caminho oposto, dizendo para fechar com suas instruções. Portanto, um template de prompt retirado de um tutorial do Gemini e colado no Claude pode ter desempenho inferior sem nunca parecer quebrado. Execute o mesmo conjunto de documentos das duas maneiras no modelo que você realmente paga, dez perguntas cada, e mantenha a ordem que vencer. É vinte minutos de trabalho contra uma diferença alegada de 30%.
A escolha do parser decide o que o modelo realmente vê
Nada disso salva uma extração corrompida. Uma tabela de nota fiscal digitalizada que sai como uma linha contínua, um artigo de duas colunas intercalado linha por linha, uma nota de rodapé emendada no meio de uma frase: o modelo lê esse lixo fielmente e responde a partir dele. Sua etapa de extração define o teto da precisão, e tudo downstream é limitado por ela. Trate o parser como uma decisão de qualidade e teste dois ou três no seu arquivo real mais feio antes de se comprometer. Nosso diretório lista 217 ferramentas de IA para documentos e PDF, e a diferença entre as boas e as ruins aparece nos seus resultados, não nas páginas de marketing delas.
Higiene de recuperação: menos chunks melhores superam mais chunks
Antes de construir uma camada de recuperação, verifique se você precisa de uma. A própria orientação da Anthropic diz que se sua base de conhecimento for menor que 200.000 tokens (cerca de 500 páginas), você pode simplesmente incluir tudo no prompt sem nenhuma recuperação (Anthropic Engineering). A maioria das wikis internas, manuais de produto e conjuntos de políticas cabem abaixo dessa linha.
Você realmente precisa de recuperação?
Se seu corpus cabe, pule o banco de dados vetorial. Você evitará decisões de chunking, deriva de embedding e toda uma classe de falhas silenciosas onde o parágrafo certo nunca chegou ao prompt. Combine isso com prompt caching para não pagar o preço total pelos mesmos 200k tokens em cada chamada.
Acima desse tamanho, a recuperação deixa de ser opcional e a qualidade se torna uma pilha de pequenas correções que se somam.
As três correções que se somam
A Anthropic as testou uma de cada vez. Adicionar contexto específico do chunk a cada chunk antes do embedding reduziu as falhas de recuperação top-20 de 5,7% para 3,7%, uma redução de aproximadamente 35%. Adicionar busca híbrida BM25 contextual levou as falhas para 2,9%, uma redução de 49%. Adicionar uma passagem de reranking em cima trouxe para 1,9%, uma redução total de 67% (Anthropic Engineering). Cada etapa é pouco glamorosa por si só e as três juntas triplicam aproximadamente a melhoria da primeira.
Aparar definições de ferramentas também conta
Esquemas de ferramentas são contexto. Se você passa quarenta definições de ferramentas para um modelo e ele precisa de duas, você pagou por trinta e oito distratores. O trabalho RAG-MCP recuperou apenas os esquemas relevantes em vez de listar todos eles e cortou os tokens do prompt em mais da metade, enquanto a precisão de seleção de ferramentas passou de 13,62% para 43,13% (arXiv:2505.03275). Essa é a mesma disciplina da seleção de chunks, aplicada um nível acima.
O padrão de sub-agentes da Anthropic estende isso ainda mais: agentes especializados fazem a pesquisa e retornam resumos condensados de cerca de 1.000 a 2.000 tokens para um agente coordenador, de modo que o contexto principal nunca vê as transcrições brutas de pesquisa (Anthropic Engineering). Se você está escolhendo componentes em vez de escrevê-los, nosso diretório lista 550 agentes de IA e um conjunto de frameworks de recuperação e agentes que implementam esses padrões prontos para uso.
Recursos de memória: qual ajuste fazer em cada ferramenta
Todo produto de IA para consumidores agora injeta coisas no seu contexto que você não digitou. Fatos salvos, conversas anteriores, atividade de aplicativos, arquivos de projeto enviados. Você não pode fazer context engineering em um app de chat até saber o que já está na janela antes da sua primeira palavra.
Uma memória errada custa mais do que nenhuma memória. É texto de aparência de alto sinal que o modelo trata como fato, e fica próximo das suas instruções onde a atenção é mais forte. Títulos de cargo desatualizados, um nome de cliente antigo, uma preferência que você definiu uma vez para uma tarefa pontual: cada um silenciosamente enviesa cada resposta depois dele.
ChatGPT: dois controles independentes
A memória do ChatGPT são dois mecanismos, não um. As memórias salvas são fatos armazenados discretos que você pode ler e excluir individualmente, enquanto a referência ao histórico de chat busca nas suas conversas anteriores por um caminho de recuperação separado (Embrace The Red). Desligar um deixa o outro funcionando. Se seus resultados ainda cheiram ao projeto do mês passado depois de limpar as memórias salvas, o controle de histórico é o que você perdeu.
Claude: conhecimento de projetos e gravações de memória no meio da conversa
Desde a unificação Cowork em 25 de agosto de 2026, o Claude grava memórias no meio da conversa em vez de apenas nos limites de sessão, portanto o que você diz no chat persiste em sessões posteriores (TechCrunch). Isso significa que um aparte casual pode se tornar contexto duradouro.
O conhecimento de projeto é a alavanca melhor, porque é um corpus que você escolheu. Mantenha-o abaixo da regra de 200.000 tokens da Anthropic (aproximadamente 500 páginas) e ele pode acompanhar inteiro sem uma camada de recuperação adivinhando quais chunks importam (Anthropic). Pode-o como uma lista de leitura, não como um arquivo.
Gemini: três sistemas sobrepostos onde 'desligar' não significa 'deletar'
O Gemini combina contexto pessoal, informações salvas que você mesmo escreveu e atividade de aplicativos Google conectados. Desabilitar uma fonte para novas gravações. Não remove o que já está armazenado, portanto uma auditoria significa visitar cada controle separadamente e excluir, não apenas desligar as coisas.
NotebookLM: a alternativa limitada por fontes
O NotebookLM limita quantas fontes um notebook pode conter, e o limite trabalha a seu favor. Ele força a curadoria que os outros três deixam você pular, o que é a mesma disciplina que a Anthropic prescreve: encontrar o menor conjunto de tokens de alto sinal que produz o resultado que você quer (Anthropic). Quando uma pergunta precisa de oito documentos e não de oitenta, comece por aí.
Escolha uma ferramenta como seu assistente com memória e mantenha as demais limpas. Entre os 13.174 apps de IA em nosso diretório, os que tornam a memória auditável por item valem mais do que os que prometem lembrar de tudo.
Instruções de nível de projeto são contexto reutilizável
O contexto mais barato que você já escreverá é o contexto que você escreve uma vez. Toda ferramenta séria de IA agora tem um slot para instruções permanentes que são injetadas em cada sessão: AGENTS.md e CLAUDE.md em um repositório, Claude Projects, instruções personalizadas do ChatGPT, arquivos de instrução do Copilot. A maioria das pessoas deixa esses slots vazios e depois redigita os mesmos três parágrafos de contexto em cada novo chat.
Por que um arquivo de instrução permanente supera a re-explicação
Um estudo em 10 repositórios e 124 pull requests mediu o que um arquivo AGENTS.md em nível de repositório faz ao comportamento de um agente, e o resultado não é apenas sobre correção. O tempo de execução mediano caiu 28,64%, de 98,57 segundos para 70,34 segundos, e os tokens de saída caíram 16,58% com taxas de conclusão comparáveis (arXiv:2601.20404). O agente parou de explorar para descobrir coisas que você já sabia.
Esse é o argumento em uma frase. Um bom contexto permanente torna o modelo mais rápido e mais barato, não apenas mais preciso, porque a maior parte do que um agente gasta tokens é redescobrir suas convenções. Se você está escolhendo entre os 260 assistentes de código de IA em nosso diretório, saber se a ferramenta lê um arquivo de instrução de projeto é um filtro melhor do que a maioria das comparações de recursos.
O que realmente pertence a um
Mantenha-o curto o suficiente para que você mesmo o leria. Cinco coisas justificam seu lugar:
- Convenções que o código não anuncia, como qual test runner é real e qual está morto.
- Seu vocabulário. Se "conta" e "tenant" significam coisas diferentes aqui, diga isso uma vez.
- A forma de saída que você quer de volta, no formato que você quer (um diff, uma tabela, cinco bullets).
- Uma lista curta de proibições. Não toque em arquivos gerados, não adicione dependências sem perguntar.
- Onde fica a fonte da verdade, para que o modelo a consulte em vez de adivinhar.
Deixe de fora qualquer coisa que a ferramenta possa ler por si mesma. Árvores de diretórios, listagens de arquivos, assinaturas de funções reafirmadas, um resumo do seu README. Esses são tokens gastos duplicando algo que o agente pode buscar em uma chamada, e eles competem pela atenção com as instruções que importam. Reescreva o arquivo quando ele começar a ser ignorado, o que geralmente significa que ficou longo demais.
O excesso de contexto tem um preço
Contexto descuidado custa dinheiro na fatura, não apenas qualidade no resultado. Dois mecanismos de precificação tornam isso concreto, e ambos recompensam a mesma disciplina: um prefixo pequeno, estável e ordenado.
A função degrau de 272K no GPT-5.4
O GPT-5.4 da OpenAI aceita uma janela de contexto de 1.050.000 tokens com até 128.000 tokens de saída, mas prompts acima de 272K tokens de entrada são "cobrados a 2x na entrada e 1,5x na saída para toda a sessão" (OpenAI API docs). Leia isso com cuidado. Cruzar a linha uma vez não custa um pouco a mais no excedente. Ela reprecia toda a sessão, saída incluída, então uma única colagem descuidada de um dump de 300K tokens dobra sua fatura de entrada para cada turno que se segue.
Você está pagando o dobro pelos tokens com maior probabilidade de degradar sua resposta mesmo assim.
O caching recompensa um prefixo estável
A API Claude cobra leituras de cache a 0,1x da entrada base, um desconto de 90%, enquanto as gravações de cache custam 1,25x no TTL de 5 minutos ou 2x no TTL de 1 hora (Claude Platform docs). O exemplo trabalhado deles: 100k tokens reutilizados dez vezes gera $1,075 contra $5,00 sem cache, uma economia de 78,5%.
Esse desconto só se aplica se o prefixo corresponder byte a byte. O caching é baseado em um prefixo exato, então se você reordenar seus documentos, inserir um timestamp no system prompt ou embaralhar definições de ferramentas entre os turnos, você paga o preço de gravação novamente em vez do preço de leitura. O hábito que mantém o cache aquecido é o mesmo que mantém o recall alto: coloque o material estável primeiro em uma ordem fixa, e deixe apenas a consulta mudar no final.
Uma auditoria de contexto que você pode fazer esta semana
Nada aqui precisa de uma chave de API ou de um ticket de engenharia. Cada item é um controle que você já tem.
Seis verificações antes da sua próxima sessão longa
- Abra um novo chat em vez de estender o de ontem. Os prompts focados da Chroma (~300 tokens de turnos relevantes) superaram históricos completos de 113k tokens em todas as famílias de modelos testadas, com o Claude mostrando a maior diferença (Chroma).
- Leia suas memórias salvas e exclua as desatualizadas. Os fatos salvos são injetados independentemente de ajudarem ou não.
- Anexe três documentos bons em vez de doze mediocres, e envolva cada um em tags
<document>com uma subtag<source>para que o modelo possa diferenciá-los (Claude docs). - Coloque o material longo acima da sua pergunta. Em entradas com 20k+ tokens, essa ordenação vale até 30% melhores respostas nos testes da Anthropic (Claude docs).
- Escreva as instruções permanentes uma vez. Um AGENTS.md em nível de repositório reduziu o tempo de execução mediano em 28,64% e os tokens de saída em 16,58% em 124 PRs (arXiv).
- Mantenha esse prefixo idêntico turno a turno. Prefixos estáveis atingem o cache a 0,1x do preço de entrada (Claude docs).
O único hábito que corrige a maioria dos resultados ruins
Antes de reescrever o prompt, olhe o que já está na janela e retire algo. A própria documentação da Anthropic diz: "mais contexto não é automaticamente melhor" (Claude docs). Mude o que você alimenta o modelo antes de mudar como você pergunta.
Perguntas Frequentes
O que é context engineering e como é diferente do prompt engineering?
A Anthropic define context engineering como "o conjunto de estratégias para curar e manter o conjunto ideal de tokens (informações) durante a inferência de LLM, incluindo todas as outras informações que podem aparecer ali além dos prompts" (Anthropic Engineering). O prompt engineering pergunta como formular uma solicitação. O context engineering pergunta qual configuração de contexto tem maior probabilidade de produzir o comportamento que você quer, e cobre tudo que ocupa a janela: o system prompt, cada mensagem incluindo resultados de ferramentas, imagens e PDFs, as próprias definições de ferramentas, e a saída do modelo incluindo raciocínio estendido (Claude Platform docs). A Anthropic o enquadra como a progressão natural do prompt engineering em vez de uma substituição para ele.
Uma janela de contexto maior sempre significa melhor saída de IA?
Não. Contexto anunciado e contexto utilizável são dois números diferentes: o benchmark NoLiMa testou 13 modelos que todos alegam suporte de 128K ou mais, e aos 32K tokens 11 dos 13 marcaram abaixo de metade de sua própria linha de base de contexto curto, com o Llama 3.1 70B caindo de 94,3% para 42,7% (arXiv:2502.05167, fevereiro de 2025). A própria documentação de plataforma da Anthropic coloca claramente: "mais contexto não é automaticamente melhor. À medida que a contagem de tokens aumenta, a precisão e o recall degradam" (Claude Platform docs). Preencher a janela também custa dinheiro em degraus em vez de em linha, já que a OpenAI cobra prompts do GPT-5.4 acima de 272K tokens de entrada a 2x na entrada e 1,5x na saída para toda a sessão (OpenAI API docs).
O que é context rot e como evitá-lo?
Context rot é a degradação da precisão e do recall conforme a contagem de tokens em uma requisição cresce, e a Anthropic o nomeia em sua própria documentação (Claude Platform docs). O estudo Context Rot da Chroma testou 18 modelos incluindo GPT-4.1, Claude 4, Gemini 2.5 e Qwen3, e encontrou quedas de confiabilidade com entradas mais longas mesmo em tarefas triviais de recuperação e replicação de palavras; em seu teste LongMemEval, cada família de modelos teve desempenho melhor em um prompt focado de ~300 tokens do que na mesma pergunta enterrada em ~113k tokens de histórico de conversa, com os modelos Claude mostrando a maior diferença (Chroma, julho de 2025). Evite-o colando apenas as passagens que importam, iniciando chats novos para novos tópicos em vez de estender os antigos, e tendo agentes especializados retornando resumos condensados de 1.000 a 2.000 tokens para um agente coordenador em vez de transcrições completas (Anthropic Engineering).
Devo desligar a memória do ChatGPT, Claude ou Gemini?
Depende da tarefa, porque a memória injeta tokens que você não escolheu em uma janela onde tudo conta para o total (Claude Platform docs). Para rascunhos de rotina onde o modelo saber seu cargo, estilo e stack economiza a redigitação, deixe-a ligada. Para análise de alto risco de um documento específico, inicie um chat limpo com a memória desligada, já que a Chroma descobriu que cada família de modelos respondeu melhor a partir de um prompt focado de ~300 tokens do que com a mesma resposta cercada por ~113k tokens de histórico não relacionado (Chroma). Trate a memória como um system prompt pelo qual você está pagando em cada turno, e pode-a da mesma forma que podaria um system prompt.
Preciso de RAG ou posso simplesmente colar meus documentos no prompt?
A orientação da Anthropic é que a recuperação muitas vezes é desnecessária em pequena escala: "Se sua base de conhecimento for menor que 200.000 tokens (cerca de 500 páginas de material), você pode simplesmente incluir toda a base de conhecimento no prompt" (Anthropic Engineering, setembro de 2024). Acima disso, a higiene de recuperação se soma no benchmark da Anthropic: adicionar contexto específico do chunk antes do embedding reduziu as falhas de recuperação top-20 de 5,7% para 3,7%, adicionar busca híbrida BM25 contextual levou para 2,9%, e uma passagem de reranking levou para 1,9%, uma redução de 67% no total. Se seu corpus cabe, colar é o padrão melhor, e o prompt caching torna a reutilização barata com leituras de cache cotadas a 0,1x da entrada base (Claude Platform docs).
Onde devo colocar documentos longos em um prompt — antes ou depois da minha pergunta?
Para o Claude, coloque os dados extensos no topo, acima da sua consulta, instruções e exemplos. A documentação de prompting da Anthropic fornece isso como uma regra concreta para entradas de 20k tokens ou mais e diz "consultas no final podem melhorar a qualidade das respostas em até 30 por cento nos testes, especialmente com entradas complexas de múltiplos documentos" (Claude Platform docs). Os mesmos documentos recomendam envolver cada documento em tags <document> com subtags <source> e <document_content>, e pedir ao modelo que cite as passagens relevantes antes de responder. Os fornecedores não concordam sobre a ordenação, portanto um template copiado do cookbook de um fornecedor pode ter desempenho inferior no modelo de outro, e vale a pena executar as duas ordenações uma vez na sua própria tarefa.