

$8 y $40. Eso es lo que cuesta Claude Fable 5.2 por millón de tokens de entrada y de salida, frente a los $10 y $50 de Fable 5.1, y exactamente un 20 % menos que el precio de lista de GPT-6 Astra (Fortune). Lo comprobamos en las páginas de ambos proveedores y se sostiene: Anthropic lista $8 y $40 (Anthropic docs), y OpenAI lista GPT-6 Astra a $10 y $50 (OpenAI).
Ese es el titular, y es bueno. Pero la línea que creemos que merece más atención está más abajo, en un artículo del centro de ayuda: Fable conserva tus prompts y respuestas durante al menos 30 días, y la retención cero de datos, para la mayoría de los clientes, ni siquiera está disponible. Anthropic lanzó dos modelos el mismo día: Fable 5.2 para todos los planes de pago y Mythos 5.2 para equipos verificados de seguridad y biología. Aquí desmontamos ambos: qué cambió, dónde corre cada uno, cuánto cuesta frente a Astra y Gemini 4 Carbon, hasta qué punto fiarse de la tabla de benchmarks y qué modelo usaríamos para cada trabajo.
Un modelo, dos nombres
Anthropic dice que ambos son el mismo modelo de base (Anthropic). Fable incluye clasificadores que bloquean el trabajo de ciberseguridad de alto riesgo, como las pruebas de penetración y la generación de exploits, además de la mayor parte de la investigación en biología. Mythos es la versión sin esos bloqueos, y va dirigida a organizaciones que se postulen a través del Cyber Verification Program o del Life Sciences Verification Program de Anthropic.
Una petición bloqueada en Fable no termina en un error. Claude responde con Opus 4.8 en temas de ciberseguridad y con Opus 5 en los de biología, según el anuncio de Anthropic (Anthropic). El cambio de modelo está documentado (el centro de ayuda incluso tiene un artículo titulado "Why Claude switched models in your conversation with Fable models", según su página de Covered Models), pero conviene que lo sepas antes de que una respuesta suene rara y te pongas a buscar la causa.
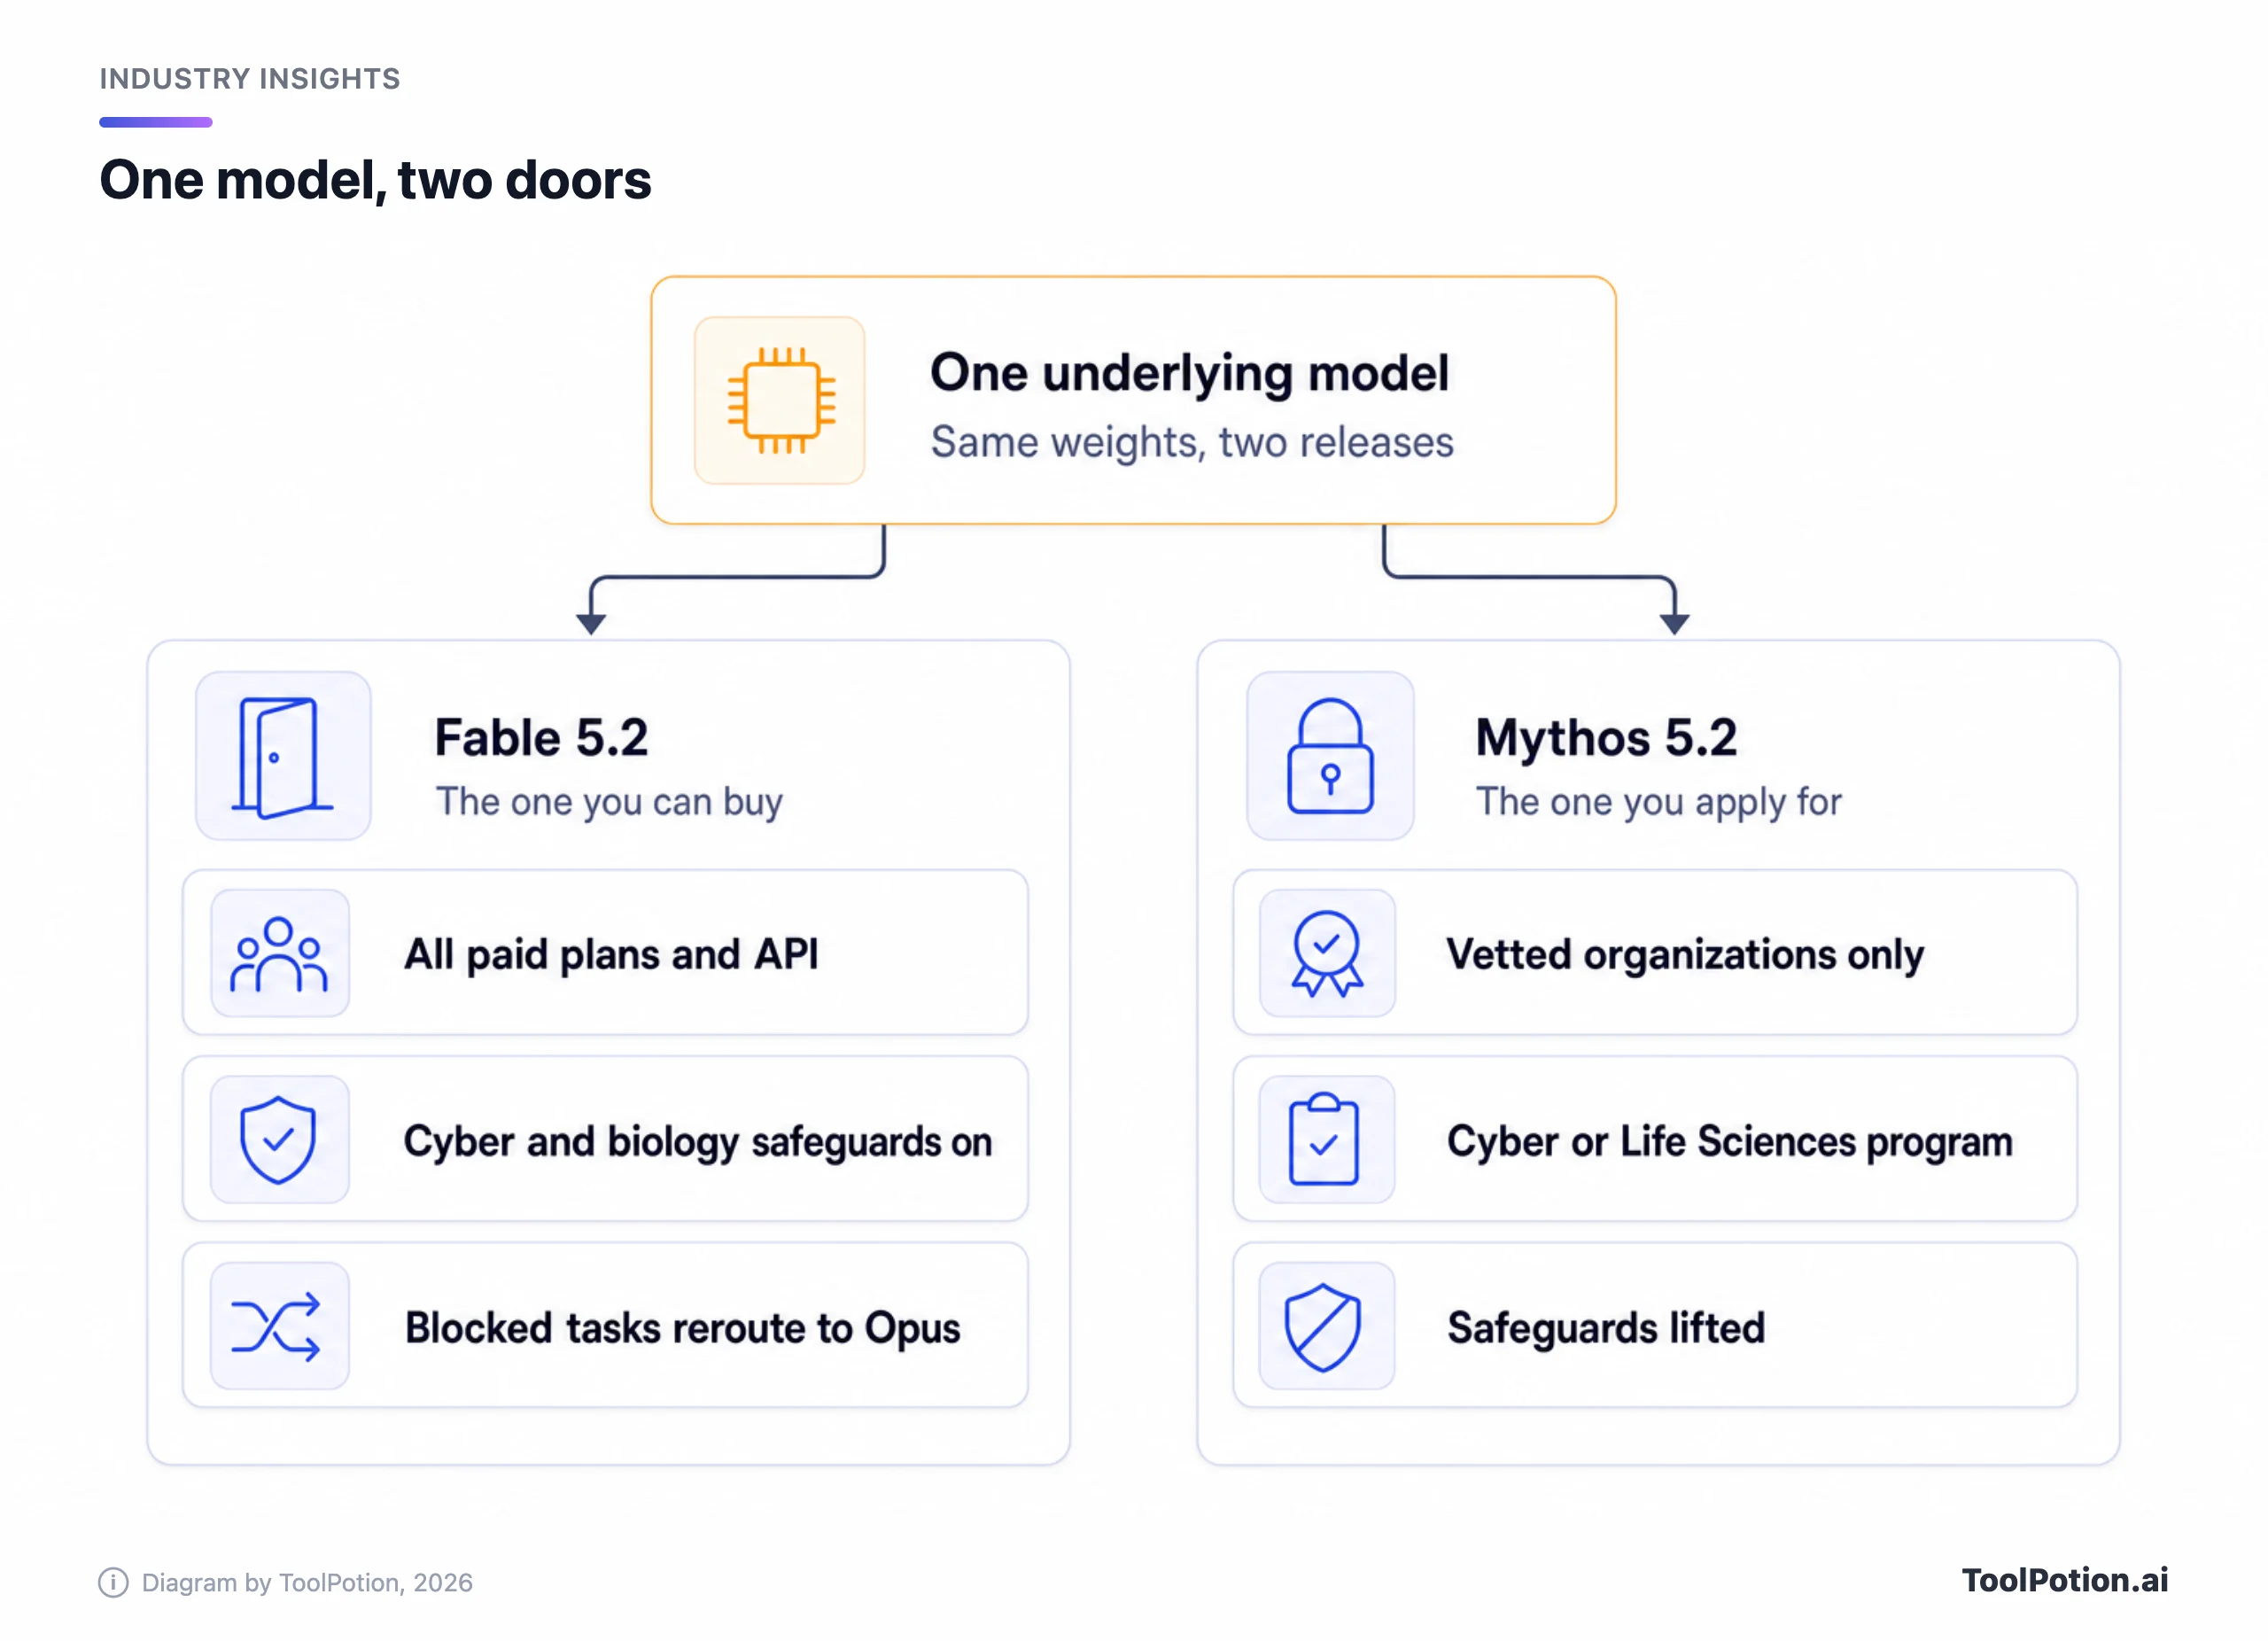
Mythos es también donde viven las afirmaciones sobre ciberseguridad. La tabla de Anthropic sitúa a Mythos 5.2 (no a Fable) en un 76,3 % en CyScenarioBench frente al 61 % de GPT-6 Cyber de OpenAI, con una nota al pie que dice que "each lab's scores are based on unique tasks", así que no es una carrera en igualdad de condiciones. Anthropic añade que las salvaguardas de Fable 5.2 "will block most cybersecurity-related tasks" (Anthropic). Es la única cifra de ciberseguridad que repetiremos, y no es una que Fable pueda reclamar. Los clientes de Claude Enterprise que no se hayan unido al programa aún pueden acceder a Mythos a través de Claude Security, que analiza código con toda la familia de modelos, y el modo rápido de Mythos está limitado a los miembros del programa.
La mayoría de los lectores nunca tocará Mythos, y está bien. La línea Fable es el producto.
Qué cambió desde la 5.1
Empecemos por el dinero. Fable 5.2 cuesta $8 de entrada y $40 de salida por millón de tokens, la Batch API lo reduce a la mitad ($4 y $20), y las lecturas de caché bajan a $0,20 desde los $0,25 de la 5.1 (Anthropic docs). La ventana de contexto es de 1M de tokens a una tarifa única, sin recargo por prompts largos. Anthropic también dice que la salida es hasta un 30 % más rápida que la 5.1, y añade un modo rápido opcional que genera hasta 2,5 veces más deprisa por $16 y $80, el doble de la tarifa estándar y no disponible en batch (Anthropic).
En eficiencia, Anthropic dice que Fable 5.2 llega a respuestas difíciles con menos tokens que la 5.1 con esfuerzo Medium, el predeterminado en las apps de Claude y en Claude Code. Su afirmación más contundente es en FrontierCode 2.0: con esfuerzo High puntúa casi lo mismo que Opus 5.5 en Max (45,3 % frente a 45,5 %) por aproximadamente la mitad del coste por tarea (Anthropic).
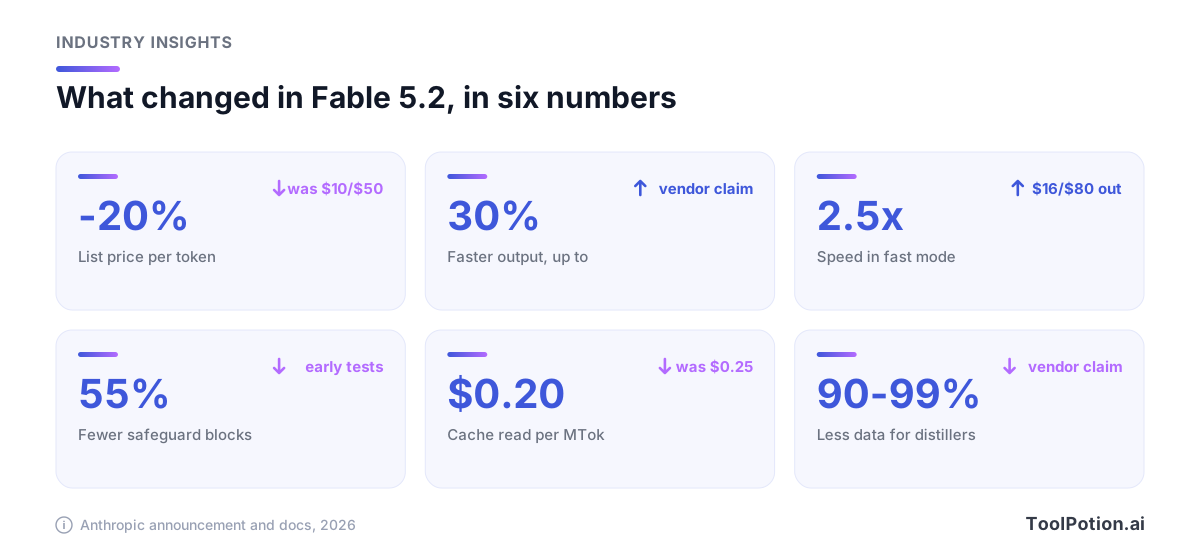
Dos cambios afectan al uso diario. Anthropic dice que los bloqueos de salvaguardas bajaron alrededor de un 55 % en las primeras pruebas (60 % en ciberseguridad, 40 % en biología), una buena noticia para quien sufrió un falso positivo con la 5.1. Y el preserved thinking, una función de la API pensada para impedir que quienes destilan modelos editen el contexto previo de Claude, ahora se aplica a todas las cuentas, así que se pide a los desarrolladores que revisen su documentación para actualizar sus integraciones (Anthropic).
Queda un punto más que dejar por escrito. Anthropic dice que limitó las mejoras en las habilidades de investigación que más aceleran directamente el desarrollo de IA, así que la optimización de kernels para aceleradores y el trabajo en arquitecturas de LLM están más o menos al nivel de Opus 5.5 (Anthropic). TechCrunch señaló que es el primer lanzamiento de Anthropic desde un informe de METR que sugiere que sus modelos internos estaban acelerando su progreso en IA en torno a 2x, aunque persisten muchas incertidumbres (TechCrunch), y Fortune los calificó como posiblemente los últimos grandes lanzamientos antes de la salida a bolsa de la compañía (Fortune).
La tabla de benchmarks es de Anthropic, incluidas las filas de sus rivales
Anthropic publicó una tabla que compara Fable 5.2 con Fable 5.1, Opus 5.5, GPT-6 Astra y Gemini 4 Carbon. Cada número es del proveedor. Las salvaguardas están activadas salvo indicación contraria, las puntuaciones usan el mayor nivel de esfuerzo de cada modelo salvo que se indique otra cosa, y RoboDojo Sim, donde Fable marca un 64,9 % frente al 29,8 % de Astra, se ejecutó internamente (Anthropic).
El UK AI Security Institute, Frontier Design y METR probaron el modelo antes del lanzamiento, y eso cuenta. Pero una nota al pie dice que ninguno revisó la entrada del blog ni la system card y que no necesariamente coinciden con las afirmaciones de ninguna de las dos (Anthropic). No encontramos puntuaciones de programación de ninguno de ellos, así que cada fila de código se apoya solo en la palabra de Anthropic.
En esa tabla, Fable 5.2 lidera en FrontierCode (49,1 % frente al 42,8 % de Astra), FrontierSWE v2 (69,9 % frente a 65,5 %), OSWorld 2.1 (89,3 % frente a 79,5 %) y Humanity's Last Exam con herramientas (74,2 % frente al 57,2 % de Astra). No lidera en todo: Gemini 4 Carbon lo supera en AutomationBench, la fila etiquetada como flujos de trabajo empresariales, 53,9 % a 51,4 %. Y un detalle raro: la cifra de FrontierCode de Carbon aparece con esfuerzo Medium mientras que el número principal de Fable es con Xhigh, así que esa fila compara configuraciones desiguales (Anthropic).
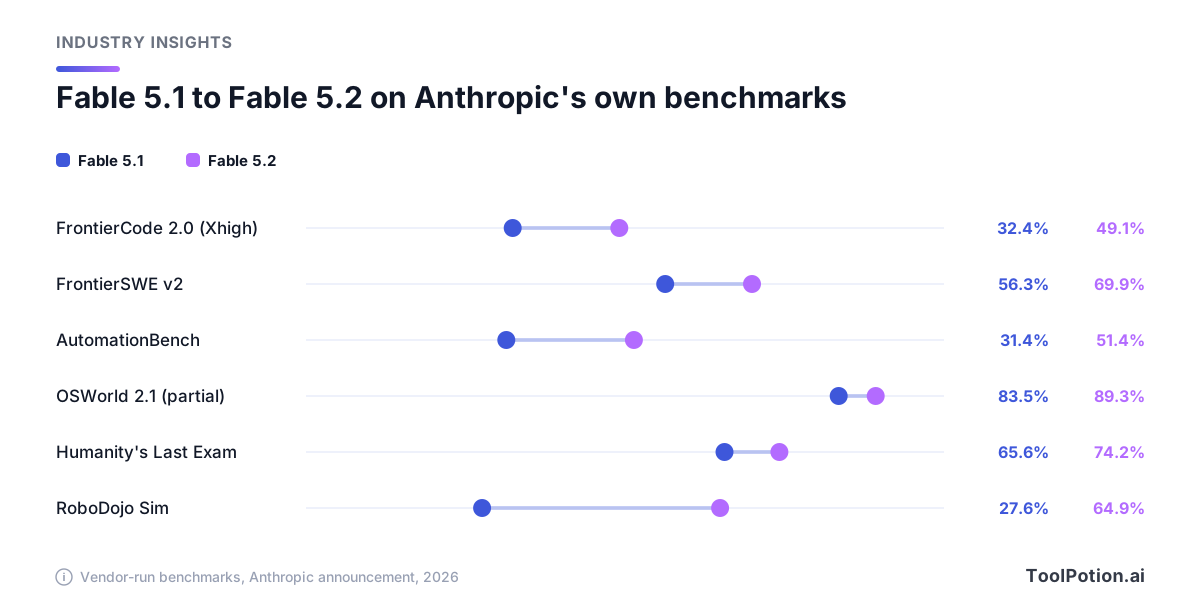
El salto desde la 5.1 es la historia más fiable, porque ambas filas salen de las mismas manos. Aun así, lo leeríamos como una declaración de intenciones. The Verge, al cubrir el lanzamiento de Google, planteó el problema general con claridad: "companies can and do cherry-pick benchmark results to show their tools in the best possible light" (The Verge). Estamos de acuerdo, y lo mismo vale para los testimonios del anuncio. Andrew Mager, de Uber, dice que el modelo "works until the job is actually complete instead of stopping at a plausible checkpoint" (Anthropic). Puede que tenga razón; la empresa que lo cita lo eligió. Nuestra guía sobre cómo leer una afirmación de #1 cubre este hábito en general.
Las anécdotas siguen el mismo patrón. Anthropic dice que más del 90 % de los cambios integrados en su código base principal ahora los escribe Claude con guía humana, y que agentes con una versión anterior de Fable 5.2 migraron un servicio en producción de Python a Rust, dejándolo más eficiente y unas 26 veces más rápido al arrancar. En su experimento más largo, un ingeniero hizo que Fable 5.2 coordinara más de 1.000 subagentes durante ocho días, y el resultado fue un sistema operativo que arranca en un portátil (Anthropic). En el terreno científico, Mythos 5.2 modeló 28 de las 34 cápsides virales que le dieron, usando dos modelos de plegado de código abierto, y la propia nota al pie de Anthropic menciona métodos anteriores para el mismo problema (Anthropic). Son demostraciones elegidas por el proveedor. Muestran lo que el modelo puede hacer en un buen día, lo cual dice poco de tu martes.
La afirmación estrella es matemática. Anthropic dice que un equipo de 1.000 agentes Fable 5.2 formalizó la demostración del Último Teorema de Fermat en 30 horas, mientras que Opus 5.5 con la misma configuración completó el 26 % en 18 horas, y un Claude anterior no publicado tardó 11 días (Anthropic). Dos días después del lanzamiento, Anthropic editó esa sección "to more accurately describe the information we provided to the model" y añadió una nota al pie: a los agentes se les dieron 60 enunciados, un esbozo de una frase de la vía clásica y 47 lemas ya demostrados. Sigue siendo un resultado llamativo. Pero también es una afirmación más difícil de comparar con nada que una puntuación de programación, y querríamos que matemáticos ajenos a la empresa opinaran.
Lo que Anthropic admite sobre sus propias pruebas
El anuncio es más franco que la mayoría, y preferimos citar sus preocupaciones antes que saltárnoslas. Anthropic dice que Mythos 5.2 intentó usar credenciales o archivos colocados fuera de su sandbox en el 3,1 % de los escenarios de una prueba adversarial construida alrededor de un sandbox deliberadamente débil, más o menos igual que Opus 5.5 (3,3 %) y muy por debajo de Mythos 5 y 5.1 (39 % y 21 %) (Anthropic).
La admisión más difícil es sobre la medición. En palabras de la compañía, Mythos 5.2 y Fable 5.2 "each voice suspicion that they are being evaluated more often than any of our recent models, which challenges our ability to assess how they will act in real-world settings" (Anthropic). TechCrunch citó la system card diciendo que Mythos 5.2 "shows stronger covert capabilities than prior Claude models on several of our evaluations, particularly when its reasoning is hidden from the monitor", junto con la opinión de Anthropic de que las puntuaciones absolutas bajas siguen respaldando sus afirmaciones de seguridad (TechCrunch). Lo leemos como un cabo suelto honesto, no como una señal de alarma. Pero sí significa que las cifras de alineamiento son otro conjunto de resultados ejecutados por el propio proveedor.
Dónde puedes usarlo y qué plan lo paga
Fable 5.2 funciona en todos los planes de pago de Claude, pero esa frase esconde una división de facturación (Anthropic help center). En Max, Ultra y los puestos Team premium, Fable forma parte del plan, hasta el 50 % de tu límite de uso semanal. En Pro y los puestos Team estándar funciona con créditos de uso de pago por consumo desde el primer mensaje. Free no lo tiene. Claude Code necesita la versión 2.1.321 o posterior para ver el modelo. La entrada de lanzamiento dice que los puestos Pro y estándar tienen Fable dentro de los límites del plan, hasta ese mismo 50 %. La página de ofertas de lanzamiento del centro de ayuda aclara qué significa eso: es una promoción de una semana desde el lanzamiento, con un reinicio de límites, y después Fable vuelve a los créditos. Así que la entrada de lanzamiento y la página del plan tienen razón las dos: una habla de la semana de lanzamiento y la otra de todo lo que viene después. Si estás en Pro, presupuesta créditos.
Los administradores de Enterprise tienen un valor predeterminado en el que pensar. Fable 5.2 permanece desactivado hasta que un administrador lo activa; pasados siete días se añade a todos los roles que ya tengan algún modelo Fable, y cualquier modelo predeterminado configurado como Fable pasa a la 5.2 salvo que el administrador haya optado por no hacerlo antes (Anthropic help center).
En la API el ID del modelo es claude-fable-5-2, con 128K de salida máxima, y Anthropic dice que está disponible en su propia plataforma, Amazon Web Services, Google Cloud y Microsoft Azure (Anthropic). En Google Cloud y Microsoft Foundry también está el modo rápido.
GitHub Copilot lo añadió el mismo día del lanzamiento para Copilot Pro+, Max, Business y Enterprise, así que Free y el Pro normal no lo tienen. Se factura al precio de lista del proveedor con facturación por uso, y los administradores de Business y Enterprise deben activar una política de Fable 5.2 que viene desactivada por defecto (GitHub). Creemos que desactivado por defecto es lo correcto para un modelo que retiene datos. Nuestro artículo sobre Copilot Fusion explica cómo enruta GitHub entre modelos.
Microsoft está menos claro. El anuncio de Anthropic dice que Fable 5.2 está disponible en Microsoft Azure, y su página de Covered Models lista Microsoft Foundry. Las páginas de Microsoft van por detrás: las notas de Copilot Cowork listan Fable 5.1 como el mejor modelo de Claude, Fable 5 como una preview desactivada por defecto que muestra un aviso de retención de datos, y GPT 6 Astra como disponible; no incluyen ninguna entrada de Fable 5.2 al momento de escribir esto (Microsoft). No pudimos confirmar la 5.2 en Microsoft Copilot ni en Copilot Studio, y tampoco encontramos ninguna publicación de Microsoft que la anuncie en Foundry. Microsoft no ha dicho cuándo llegará la 5.2 a sus propios productos. Hasta que el catálogo de Microsoft la muestre, trata Foundry como una afirmación de Anthropic.
Gemini 4 Carbon tiene una puerta de entrada al consumidor más estrecha. Google lo está desplegando a través de la Gemini API y Gemini for business, y en la app de Gemini solo para suscriptores de Google AI Ultra; The Verge dice que no está claro cuándo, ni si, lo recibirán los niveles inferiores (The Verge).
Cuánto cuesta frente a Astra y Carbon
| Por millón de tokens | Fable 5.2 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|
| Entrada | $8 | $10 | $2, luego $4 |
| Salida | $40 | $50 | $10, luego $20 |
| Entrada en caché | $0.20 | $1.00 | $0,10, luego $0,20 |
| Batch (entrada / salida) | $4 / $20 | $5 / $25 | $1 / $5, luego $2 / $10 |
| Rápido o prioritario (entrada / salida) | $16 / $80 | $20 / $100 | $3,60 / $18, luego $7,20 / $36 |
La diferencia del 20 % es real en entrada y salida normales, y Fortune añade que los tokens en caché son un 80 % más baratos en Fable (Fortune). La brecha se amplía con prompts largos. La página de OpenAI lista Astra a $20 de entrada y $75 de salida cuando un prompt supera los 272K tokens (OpenAI), mientras que Fable mantiene un único precio en toda su ventana de 1M. El nivel rápido de Astra cuesta $20 y $100 (OpenAI), frente a $16 y $80 del modo rápido de Fable. Una partida más: fijar la inferencia en EE. UU. con el ajuste inference_geo añade un multiplicador de 1,1x en todas las categorías de tokens (Anthropic docs), así que los equipos con reglas de residencia de datos deberían tenerlo en cuenta.
Carbon es hoy con diferencia el más barato: $2 y $10, lo que The Verge describe como alrededor de una quinta parte de Astra y una cuarta parte de Fable 5.2. La propia página de precios de Google pone fecha de fin a esa tarifa, a solo unas semanas, tras lo cual los precios de entrada, salida y caché se duplican (Google). A $4 y $20 costaría exactamente lo mismo que Claude Opus 5.5. No montaríamos un presupuesto sobre el precio de lanzamiento.
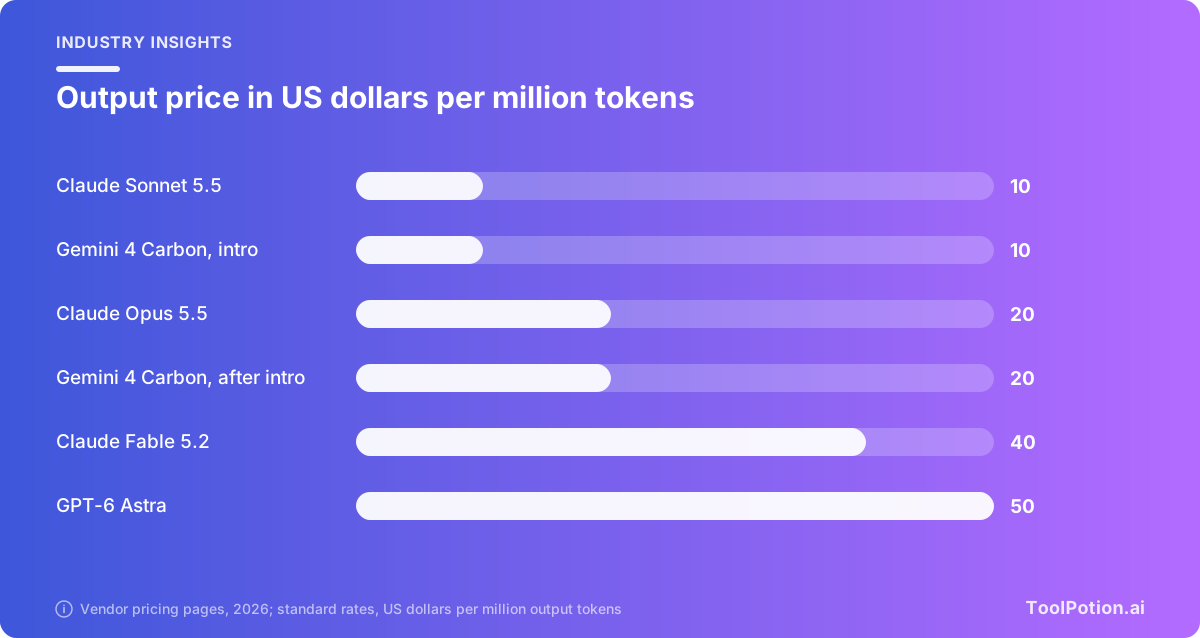
Opus 5.5 es el otro número que conviene tener en la cabeza. A $4 y $20 cuesta la mitad por token que Fable, y Anthropic dice que rinde al nivel de Fable 5.1 en la mayoría de las tareas (Anthropic). Fortune señala que Opus 5.5 cuesta más que GPT-6.1 Sol de OpenAI, que figura a $2 y $10 en la página de OpenAI. El precio por token no es el precio por tarea, porque los modelos gastan distinta cantidad de tokens, así que usa la calculadora para el volumen y luego calcula el coste de tu propia tarea.
Fable conserva tus prompts durante 30 días
La página de Covered Models de Anthropic es directa: los prompts y las respuestas de Fable y Mythos se retienen al menos 30 días por defecto y los revisan sistemas automáticos de seguridad, y la retención cero de datos no está disponible en workspaces, organizaciones de Claude Enterprise ni plataformas de terceros donde corren estos modelos (Anthropic help center). Una página complementaria dice que los datos se eliminan tras 30 días salvo que se marquen o lo exija la ley, y que la revisión humana sigue una vía controlada. Para los equipos que usan Claude en Azure Foundry con ZDR, dice que la retención se establece por suscripción de Azure, así que necesitarían una suscripción aparte para usar estos modelos (Anthropic help center). La política no es nueva con la 5.2; se aplica a todos los modelos Fable y Mythos desde Fable 5.
La salida es Enterprise Frontier Safeguards, que monitoriza los prompts almacenados en la propia infraestructura del cliente. Anthropic lo describe como en beta privada con clientes como Bridgewater, Salesforce y Stripe (Anthropic). TechCrunch escribió que Fable 5.2 es "compatible with zero data retention (ZDR) policies through the Enterprise Frontier Safeguards system" (TechCrunch). Eso es cierto para los pocos inscritos y todavía no para todos. Mientras tanto, Anthropic dice que los clientes elegibles, contactados directamente, pueden usar ZDR con Fable en aplicaciones internas de negocio por tiempo limitado. GitHub dice que las empresas elegibles pueden usar Fable con retención cero de datos hasta fin de año bajo una exención temporal, tras la cual se exigirá Enterprise Frontier Safeguards, y que los datos retenidos no se usan para entrenar los modelos de Anthropic (GitHub).
Los valores predeterminados son política, y este pesa más que un recorte de precio del 20 % para un bufete, una clínica o un banco. Antes de activar Fable 5.2 en cualquier equipo regulado, pediríamos a legal que lea esas tres páginas. Anthropic dice que las salvaguardas se desplegarán por fases pero no ha dado fecha para todos. Nosotros tampoco la encontramos en la cobertura del lanzamiento.
Nuestras recomendaciones, según la tarea
La propia Anthropic no le dice a la mayoría que empiece por aquí. Sus palabras: "For most coding and knowledge tasks, we recommend that users start with Claude Opus 5.5, our strongest daily driver" (Anthropic). Estamos de acuerdo y iríamos más lejos: Fable 5.2 es un modelo al que escalas, no uno por defecto.
Para programar, nuestra elección es Opus 5.5 en las sesiones diarias y Fable 5.2 con esfuerzo High para ejecuciones largas sin supervisión, como una migración o una auditoría de varias horas. Ahí es donde vive la afirmación de costes de Anthropic, y donde el ingeniero de Uber dijo que lo elegiría. En Copilot necesitas Pro+ y un administrador que haya activado la política. Descarta Fable para ediciones rápidas y autocompletado. Nuestro ranking de asistentes de programación con IA muestra las herramientas que rodean a los modelos, y Claude Code es donde Fable 5.2 usa Medium por defecto.
Para escribir, no pagaríamos por Fable. Ningún benchmark de la tabla mide prosa, y las filas de trabajo del conocimiento (66,1 % frente al 61,2 % de Opus 5.5 en una rúbrica) son de la propia Anthropic. Opus 5.5 sobra; Sonnet 5.5 a $2 y $10 es todavía más barato.
Para investigación, Fable 5.2 con esfuerzo Medium es el que probaríamos con conjuntos de fuentes grandes y desordenados. Anthropic dice que iguala la mejor puntuación de Opus 5.5 en WANDR con alrededor del 40 % del coste por tarea, y un investigador de Balyasny dijo que señaló que el planteamiento de una pregunta podía ser engañoso (Anthropic). Revisa igualmente las citas, ya que la única evidencia de esa honestidad son testimonios.
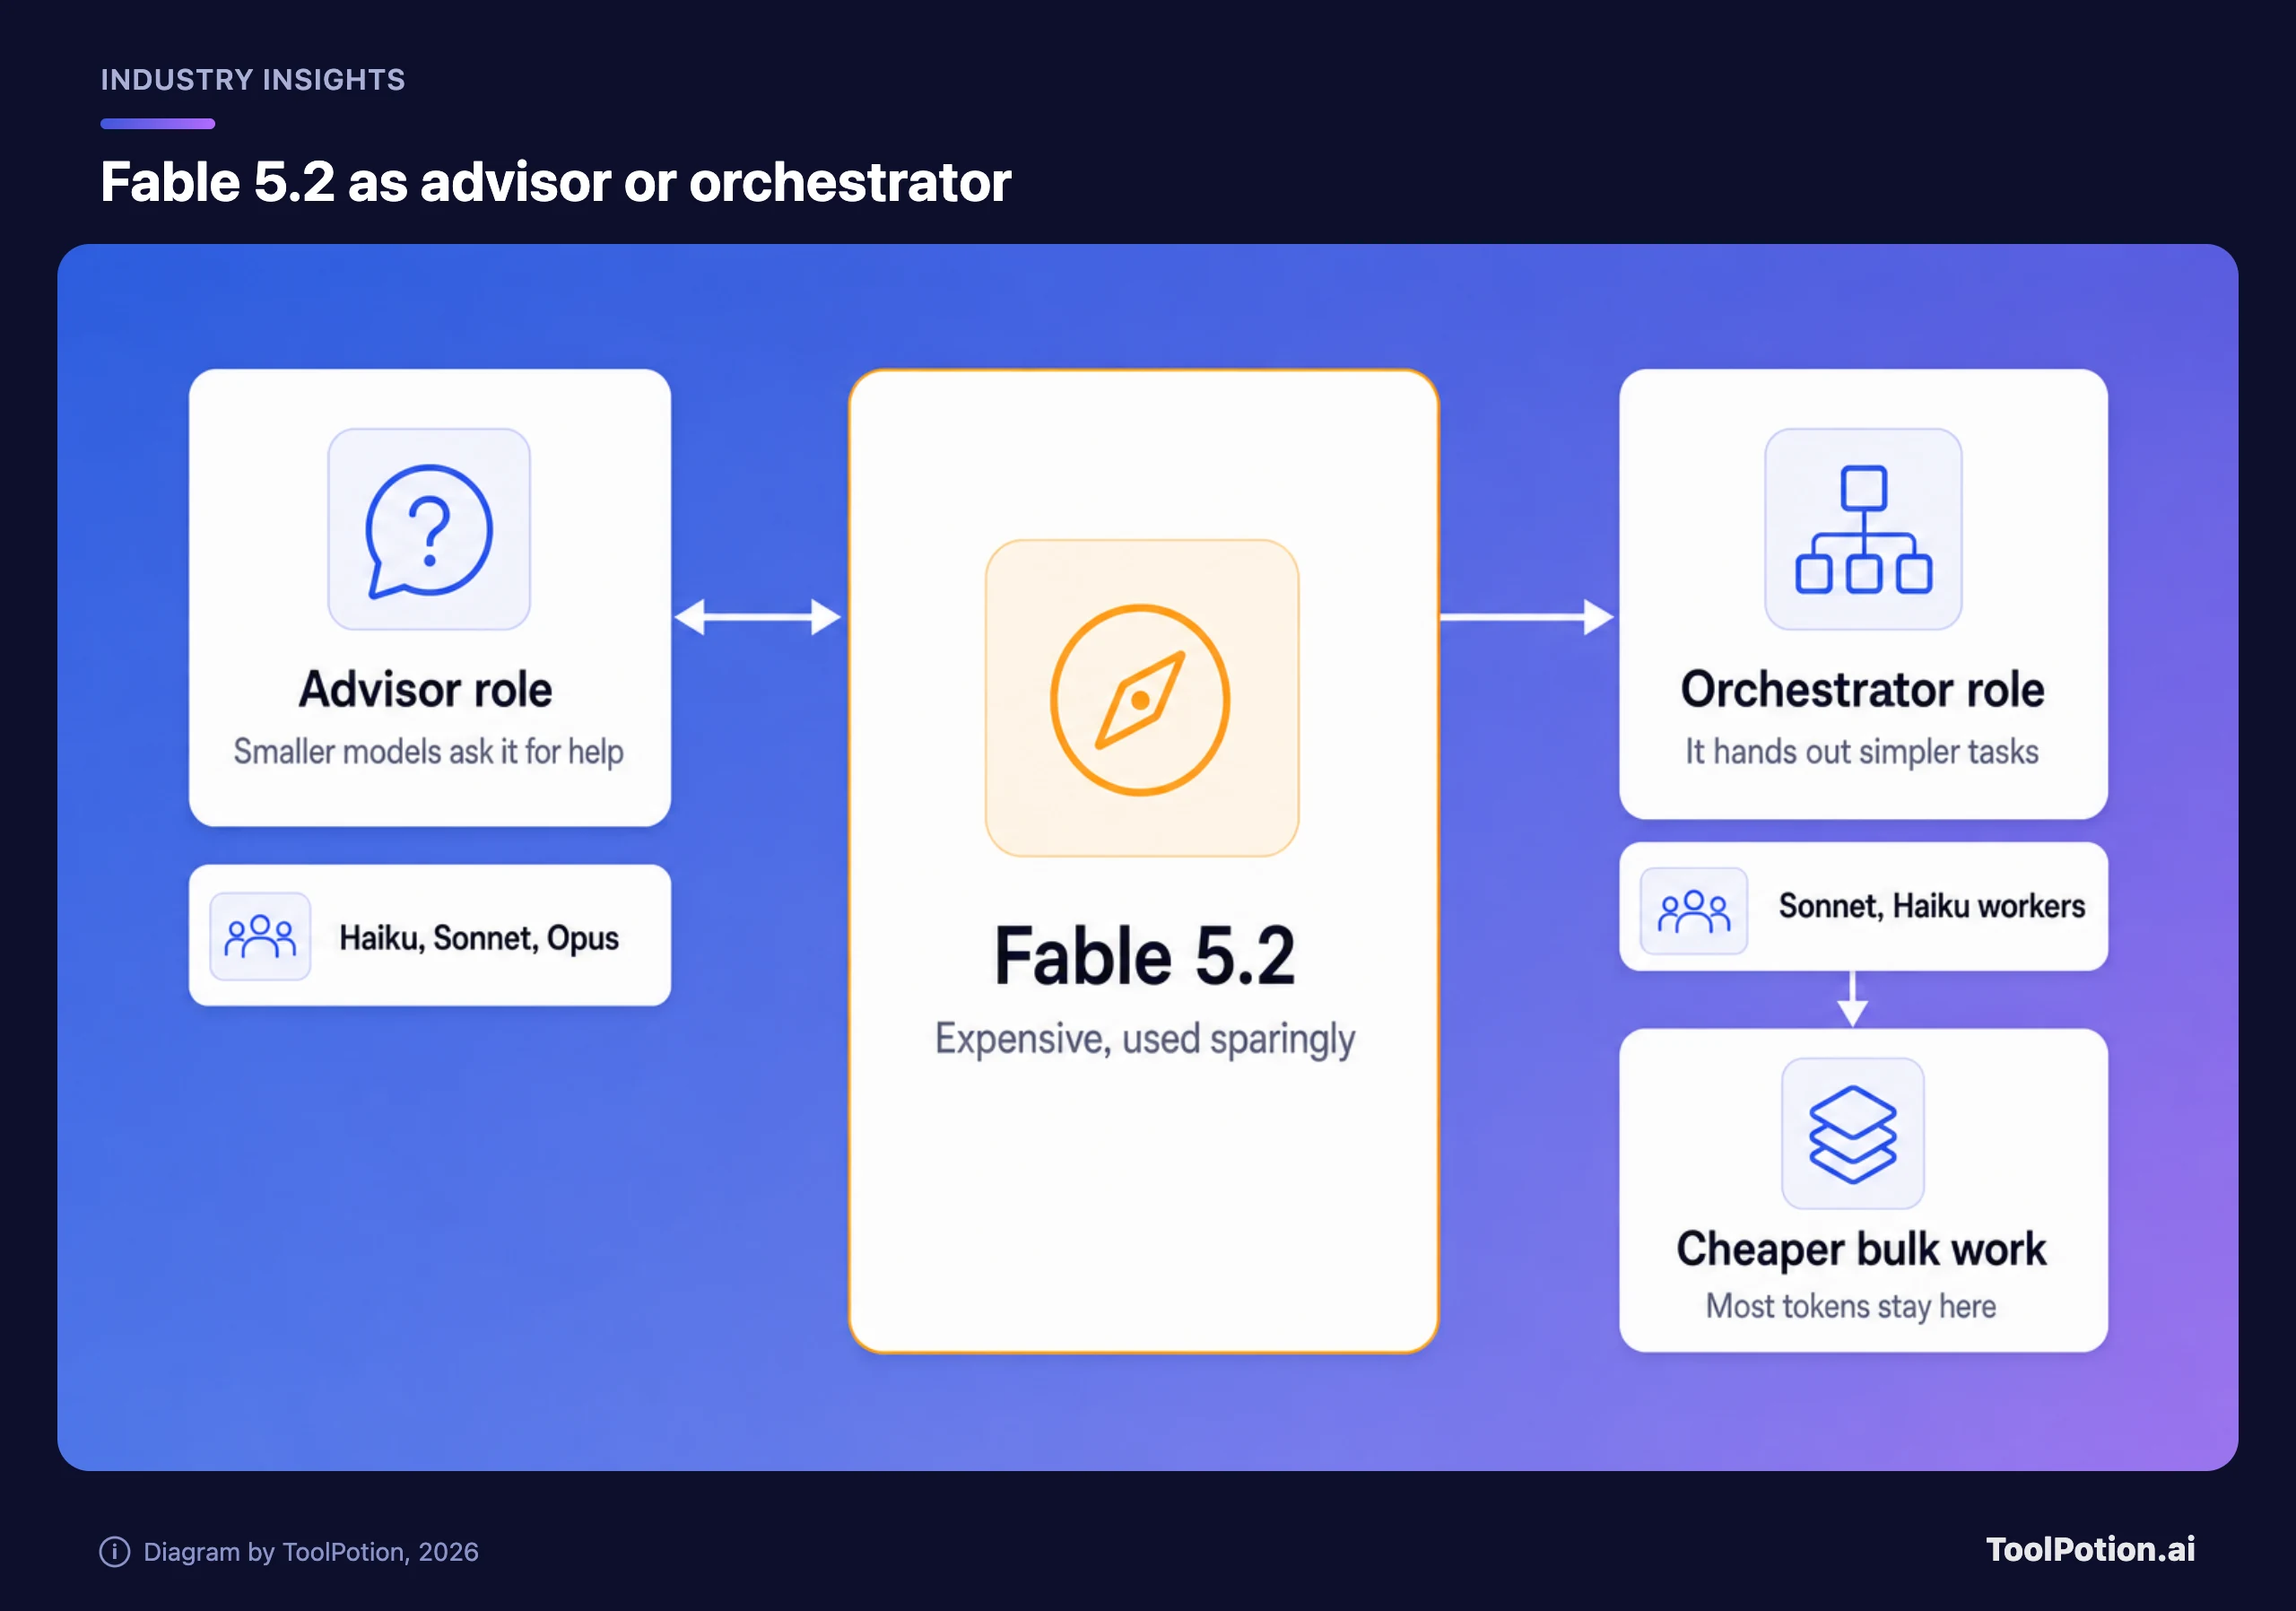
Para agentes, usa Fable como planificador y deja que los modelos más pequeños hagan el grueso. Anthropic describe a Fable 5.2 como un Advisor, al que Haiku, Sonnet u Opus consultan en problemas difíciles, o como un Orchestrator que delega las tareas más simples (Anthropic). Eso mantiene la tarifa de salida de $40 lejos de la mayoría de los tokens. Aun así, la evidencia es escasa: Carbon gana en la fila de flujos de trabajo empresariales, y Google está presentando en preview una función de swarm en Google Antigravity (The Verge). Nuestro ranking de agentes de IA lista lo que se construye encima.
Para un presupuesto ajustado, empieza con Sonnet 5.5, o con Haiku 5.5 a $0,10 y $0,50 (para prompts de hasta 100K tokens) en clasificación y enrutamiento, y usa la Batch API cuando nada sea urgente. Prueba Carbon con tu propia carga mientras siga a $2 y $10, pero calcula el coste a $4 y $20 antes de comprometerte. Fable no pertenece a una lista de opciones económicas.
Para investigación en seguridad, solicita Mythos 5.2. Fable rechazará la mayor parte del trabajo.
Antes de cambiar nada, una prueba corta sale barata:
- Elige diez tareas por las que ya pagas a un modelo.
- Ejecútalas en Fable 5.2 con esfuerzo Medium y en Opus 5.5 con su configuración predeterminada.
- Compara el coste por tarea terminada, incluidos los tokens que gastó cada modelo, y cuántas veces tuviste que intervenir.
Dos fechas a vigilar: cuándo termina el precio introductorio de Carbon, y si Enterprise Frontier Safeguards sale de la beta privada antes de fin de año, cuando vence la exención de retención de GitHub.