

La página de precios de Google lista Gemini 4 Carbon a $2 por millón de tokens de entrada y $10 por millón de tokens de salida. Unas líneas más abajo, esa misma página dice que ambas cifras se duplican cuando termina el periodo introductorio, algo que ocurrirá en cuestión de semanas (Google AI developer pricing). El post de lanzamiento de Google destaca la cifra más baja. Nosotros presupuestaríamos con la más alta.
Carbon es el modelo top de la línea Gemini 4 de Google. Llegó al público unas dos semanas después de una fase limitada para equipos de seguridad (Google), y lo hizo con una función en preview llamada /swarm dentro de Google Antigravity. Abajo están las preguntas que querríamos ver respondidas antes de tocar nada: qué es un swarm, quién puede lanzar uno, cuánto cuesta, dónde flaquea y cómo se compara con Claude Fable 5.2 y GPT-6 Astra. Todo sale de las páginas de Google, el changelog de GitHub, Artificial Analysis y la prensa. Nosotros no hemos probado Carbon.
Un swarm es un coordinador, varios workers y un verificador en un mismo tablero
La documentación de Antigravity de Google lo explica sin rodeos. Cuando escribes /swarm y una tarea, tu conversación actual se convierte en el coordinador. Este divide el trabajo en piezas que no chocan entre sí (un worker por archivo o paquete, por ejemplo), da a cada worker un briefing público y un contexto limpio, y normalmente añade un verificador por cada dos a cuatro workers. El verificador lee los diffs, ejecuta los tests e informa de los problemas al worker que escribió el código (documentación de Antigravity).
Todos hablan en un único tablero compartido. Los workers no se envían mensajes privados. Un worker sin nada que hacer se duerme y no consume tokens hasta que alguien lo menciona, y un worker monitor solo interviene si todo el equipo se ha quedado callado antes de terminar el trabajo. El post de lanzamiento de Google resume la propuesta en una frase: es "turning a single prompt into a coordinated team of agents you can track in real time".
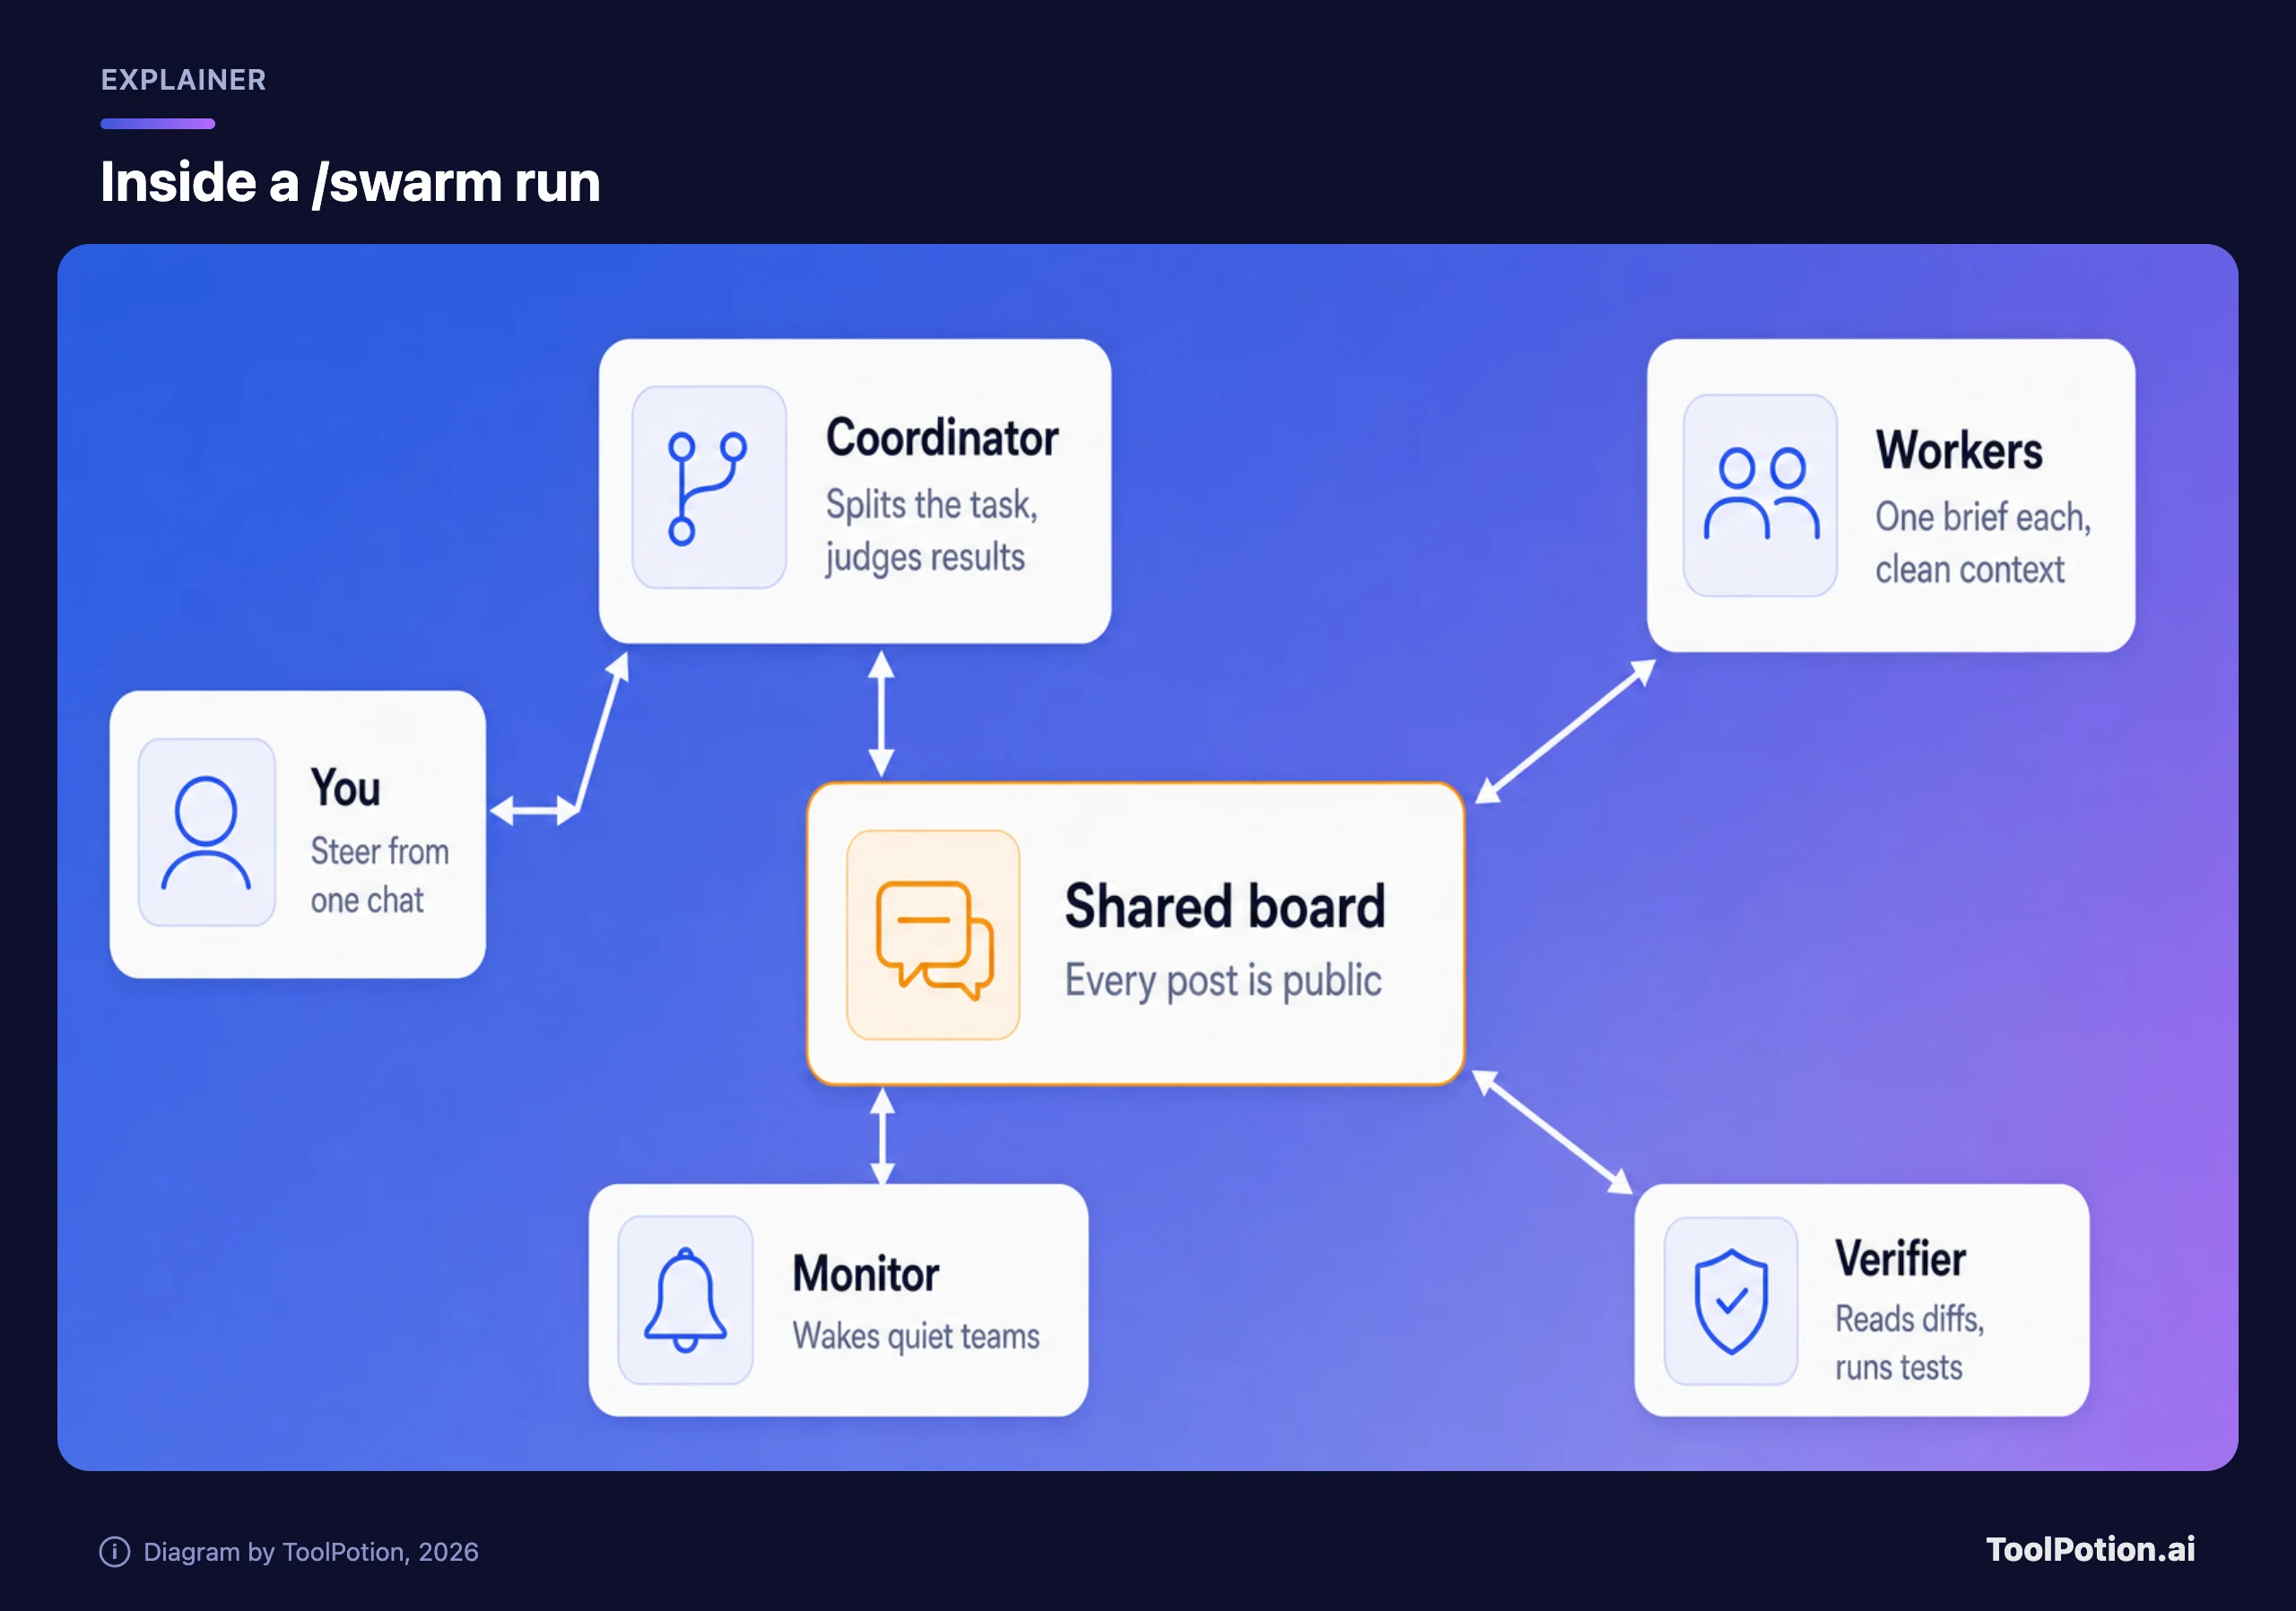
Los workers usan el mismo modelo que tu conversación salvo que pidas otro, y la documentación incluye un prompt de ejemplo que pone al verificador en un modelo distinto al de los workers. El post de lanzamiento de Google sugiere Carbon para los roles que exigen el razonamiento más profundo (arquitectura, coordinación, auditoría), con modelos más rápidos y ligeros haciendo el trabajo en paralelo. Cuando varios workers editan a la vez, el coordinador puede darle a cada uno su propia copia de tu repositorio.
Google también distingue swarm de sus hermanos. Los subagentes se ocupan de una tarea secundaria. /boost es para problemas difíciles más que grandes. /teamwork gestiona proyectos de varios hitos tras una entrevista de alcance y con puertas de auditoría. /swarm es para trabajo "large but divides cleanly" (grande pero que se divide limpiamente). Esa última frase es el criterio que llevaríamos siempre encima. Cinco workers en una tarea que no se puede dividir son cinco agentes esperándose entre sí, y pagas por todos.
Swarm está abierto a Pro, Carbon sobre todo a Ultra
Swarm está en preview, y Google dice que funciona en los planes Google AI Pro y AI Ultra, tanto en la Antigravity App como en la Antigravity CLI. Carbon es más restringido. Según el post de lanzamiento de Google, la API está abierta a todos los desarrolladores y empresas de pago a través de Google AI Studio y Gemini for business (la Gemini Enterprise app es la puerta de entrada para empresas). En el lado de consumo se está desplegando para los suscriptores de Google AI Ultra en Antigravity, la app de Gemini y AI Mode en Search.
La página de suscripciones de Google en EE. UU. lista a Argon, el hermano más ligero, en AI Pro a $19,99 al mes, y a Carbon en Ultra, que parte de $99,99 al mes por cinco veces los límites de uso de Pro y llega a $199,99 por veinte veces (Google). Si juntas ambas páginas, un suscriptor de Pro puede lanzar un swarm, pero no con Carbon, y la tabla de modelos de Antigravity lo confirma: Carbon aparece marcado para Ultra y Enterprise, no para Pro (documentación de Antigravity). Ni el post de lanzamiento ni la página de suscripciones dicen cuándo, o si, Pro lo recibirá. Los usuarios gratuitos se quedan sin nada: la página de precios marca Carbon como "Not available" en el nivel gratuito de la API, y Business Insider dice que Carbon y Argon están limitados a usuarios de pago.
GitHub Copilot es la otra vía. Carbon está disponible de forma general para Copilot Pro+, Max, Business y Enterprise, seleccionable en el selector de modelos de VS Code, Visual Studio, los IDE de JetBrains, Xcode, Eclipse, el Copilot CLI, el coding agent, github.com y las apps móviles, con un despliegue gradual (changelog de GitHub). El changelog no menciona swarm, así que trataríamos GitHub Copilot y el Copilot CLI como formas de usar el modelo, no la función.
Si administras un equipo, hay un valor por defecto al que conviene echar un vistazo. Con la habilitación de modelos por defecto, dice GitHub, los modelos nuevos se activan automáticamente a menos que un administrador haya desactivado el valor global o desactive el modelo de forma explícita. Carbon se factura al precio de lista del proveedor, así que un desarrollador que lo elige en el desplegable gasta tu dinero a la tarifa del modelo. Fable 5.2 funciona al revés: su política sigue desactivada hasta que un administrador la habilita (changelog de GitHub). Revisa la política de Carbon antes de que el despliegue llegue a tu organización.
El precio se duplica en cuestión de semanas
En la API de Gemini, la tarifa estándar de Carbon es de $2 de entrada y $10 de salida por millón de tokens mientras dure el periodo introductorio, y luego $4 y $20. Los thinking tokens cuentan como salida. La entrada en caché cuesta $0,10 ahora y $0,20 después, y solo funciona el caching implícito (el explícito no está soportado). Batch y Flex funcionan a la mitad de la tarifa estándar, y Priority a $3,60 y $18 ahora. El grounding con Google Search da 5.000 solicitudes gratis al mes (compartidas entre Gemini 3 y los modelos más nuevos), y después cuesta $14 por cada 1.000. Argon tiene los mismos precios por token, así que su ahorro está en los tokens, no en las tarifas (página de precios).
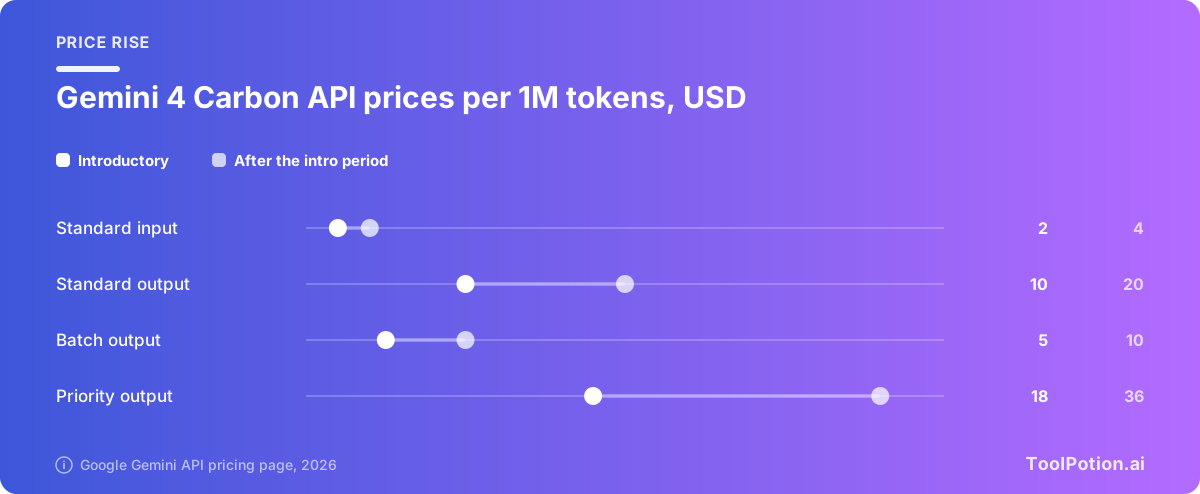
Incluso duplicado, Carbon sigue siendo más barato por token que los dos rivales de abajo. Pero por token no es por trabajo, porque cada modelo gasta un número distinto de tokens en la misma tarea, y las cifras medidas de la siguiente sección van en contra del titular.
Un swarm es más difícil de presupuestar. Con una suscripción pagas en cuota, y la documentación es tajante: "Every worker is its own agent, so a swarm uses quota much faster than a single conversation." Un worker que se queda sin cuota se pausa y sigue pausado hasta que alguien publica en el tablero, se cambia su modelo o le escribes tú. No se reinicia cuando se renueva tu cuota (documentación de Antigravity). Google no dice cuántos tokens consume una ejecución típica de swarm. Una cuota que se rellena según un calendario, sin ninguna cifra por ejecución, es justo el tipo de coste que no nos gusta. Hasta que Google publique una, trataríamos un swarm como un multiplicador de lo que te cueste un solo agente.
Dentro de Copilot el panorama es más simple. El modelo se factura a precio de lista con facturación por uso, y la tabla de precios de GitHub recoge los mismos $2 y $10, con la misma duplicación al final del periodo introductorio (GitHub Docs).
¿Dónde se queda corto Carbon?
Google es transparente sobre el principal problema. Carbon gasta más thinking tokens que Argon para explorar y verificar, lo que "increases per-turn token use and latency" (Google AI docs). Las notas de migración dicen que los prompts difíciles "can take several minutes" y piden a los desarrolladores timeouts de cliente de al menos 15 minutos, subir el máximo de tokens de salida a 32.768 o más porque Carbon puede dedicar más del límite a pensar, y dejar de enviar temperature, top_p y top_k, que se ignoran.
Artificial Analysis, una firma independiente de benchmarking, midió el mismo rasgo. Su página llama al modelo "notably slow per task and very verbose". Carbon escribió 205 millones de tokens a lo largo del Intelligence Index frente a una mediana de 72,8 millones en modelos comparables, y tardó 25,3 minutos por tarea frente a una mediana de 12,7 minutos (Artificial Analysis).
La página del modelo lista solo salida de texto. Sin generación de imágenes, sin generación de audio, sin Live API (página del modelo). La prompt injection es el otro cabo suelto. Google reporta una tasa de éxito de ataque del 0 % en el benchmark de inyección indirecta de Gray Swan, y luego añade que sabe que "prompt injection robustness remains an area for continued improvement" (Google). Creemos que esa frase merece más peso que el 0 %, porque los agentes que leen páginas web y PDF son el caso de uso que Google está vendiendo, y un swarm lee más de ellos a la vez.
Luego está la evidencia. Casi todos los elogios del post de lanzamiento vienen de empresas que Google eligió citar. Un cliente menciona "16 real bug fixes" en su código como base de una tasa de resolución del 94 %, una muestra tan pequeña que un fallo más cambiaría la cifra en seis puntos. Kit Langton, de OpenCode, llama a Carbon "a preferred planning model for our hardest tasks", un respaldo útil de alguien que construye herramientas de código, pero es una sola voz en un post escrito por el proveedor. Tampoco nos convencen las demos: la reconstrucción de una oficina con 906.000 triángulos y la exposición de la Torre Eiffel son ejecuciones del propio Google. Esperaríamos a ver resultados de gente que no salga en la nota de prensa.
Más barato por token que Fable 5.2 y Astra, pero no siempre por tarea
A precio de lista, Carbon gana por goleada. Con la tarifa introductoria, Carbon cuesta una quinta parte de GPT-6 Astra por token y una cuarta parte de Claude Fable 5.2, que llegó a GitHub Copilot un día antes que Carbon (changelog de GitHub). Tras la duplicación, son dos quintos y la mitad. Las páginas de los propios proveedores (OpenAI, Anthropic) dan las cifras de la tabla de abajo.
| Modelo | Entrada / salida por 1M de tokens | Dónde puedes usarlo | Coste medido por tarea |
|---|---|---|---|
| Gemini 4 Carbon | $2 / $10 ahora, $4 / $20 después | Gemini API de pago, Google AI Ultra, Antigravity (Ultra), Copilot Pro+, Max, Business, Enterprise | $7.76 |
| GPT-6 Astra | $10 / $50 (entradas de hasta 272K) | API de OpenAI, GitHub Copilot | $6.24 |
| Claude Fable 5.2 | $8 / $40 | API de Claude, Copilot Pro+, Max, Business, Enterprise | $26.54 |
La última columna es el coste medio de Artificial Analysis para ejecutar su Intelligence Index, y para Carbon usa la tarifa duplicada. Por tarea, Carbon ($7,76) cuesta más que Astra ($6,24) pese al menor precio por token, porque escribe muchos más tokens. Fable 5.2 es bastante más caro, con $26,54, y el más lento de los tres, con 48 minutos por tarea, pero también lidera el gráfico comparativo de la página con una puntuación de 65 frente a los 60 de Carbon y los 57 de Astra (Artificial Analysis). Una salvedad: el índice lista a Carbon con thinking alto y a los otros dos en máximo. Con el precio introductorio, la cifra de Carbon se reduciría más o menos a la mitad, a unos $3,90 según nuestras cuentas, lo que lo dejaría por debajo de Astra mientras dure el descuento.
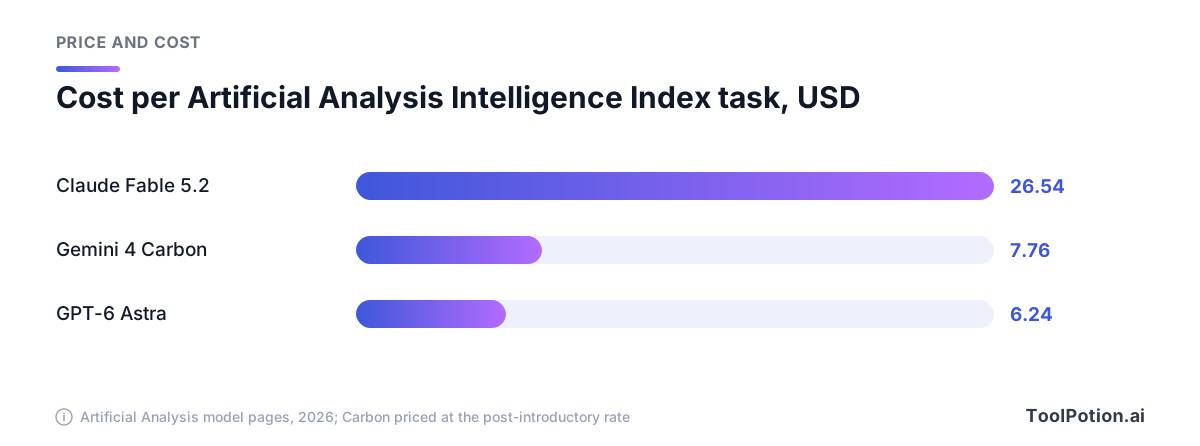
La afirmación de Google es otra. Dice que Carbon es el primero en el CursorBench 4.0 de Cursor, en WANDR de Perplexity y en AutomationBench de Zapier, a menos de la mitad de coste por tarea que el siguiente mejor modelo externo (Google). Son tareas distintas de las de Artificial Analysis, y Google eligió cuáles citar. Ambas cosas pueden ser ciertas. Dudamos de que el ahorro se traslade a tu repositorio sin hacer una prueba.
Las condiciones de datos también difieren. El changelog de GitHub dice que Claude Fable 5.2 "requires data retention by default" para ejecutar los clasificadores de seguridad de Anthropic, y que la retención cero de datos solo está disponible para ciertos clientes enterprise elegibles (changelog de GitHub). La página de precios de Google dice que el contenido enviado en el nivel de pago de la Gemini API no se usa para mejorar sus productos. Los valores por defecto son política, y en este punto el de Google es más amable.
La calculadora de abajo usa precios de lista. Introduce recuentos de tokens de tus propias ejecuciones, no de las nuestras, ya que los tres modelos gastan cantidades muy distintas en el mismo trabajo.
¿Cuándo recurriríamos a él?
Nuestra elección para el trabajo diario es Argon. Lo dice la propia Google: Argon "remains the ideal choice for the majority of software engineering and knowledge work", mientras que Carbon está "built for tasks that test the limits of a model's intelligence" (Google). Carbon se gana sus tokens en migraciones de varios paquetes, búsquedas de causa raíz entre subsistemas y auditorías de seguridad, los trabajos que nombra la documentación. Un swarm se gana su cuota solo cuando la tarea se divide en piezas que no se tocan entre sí.
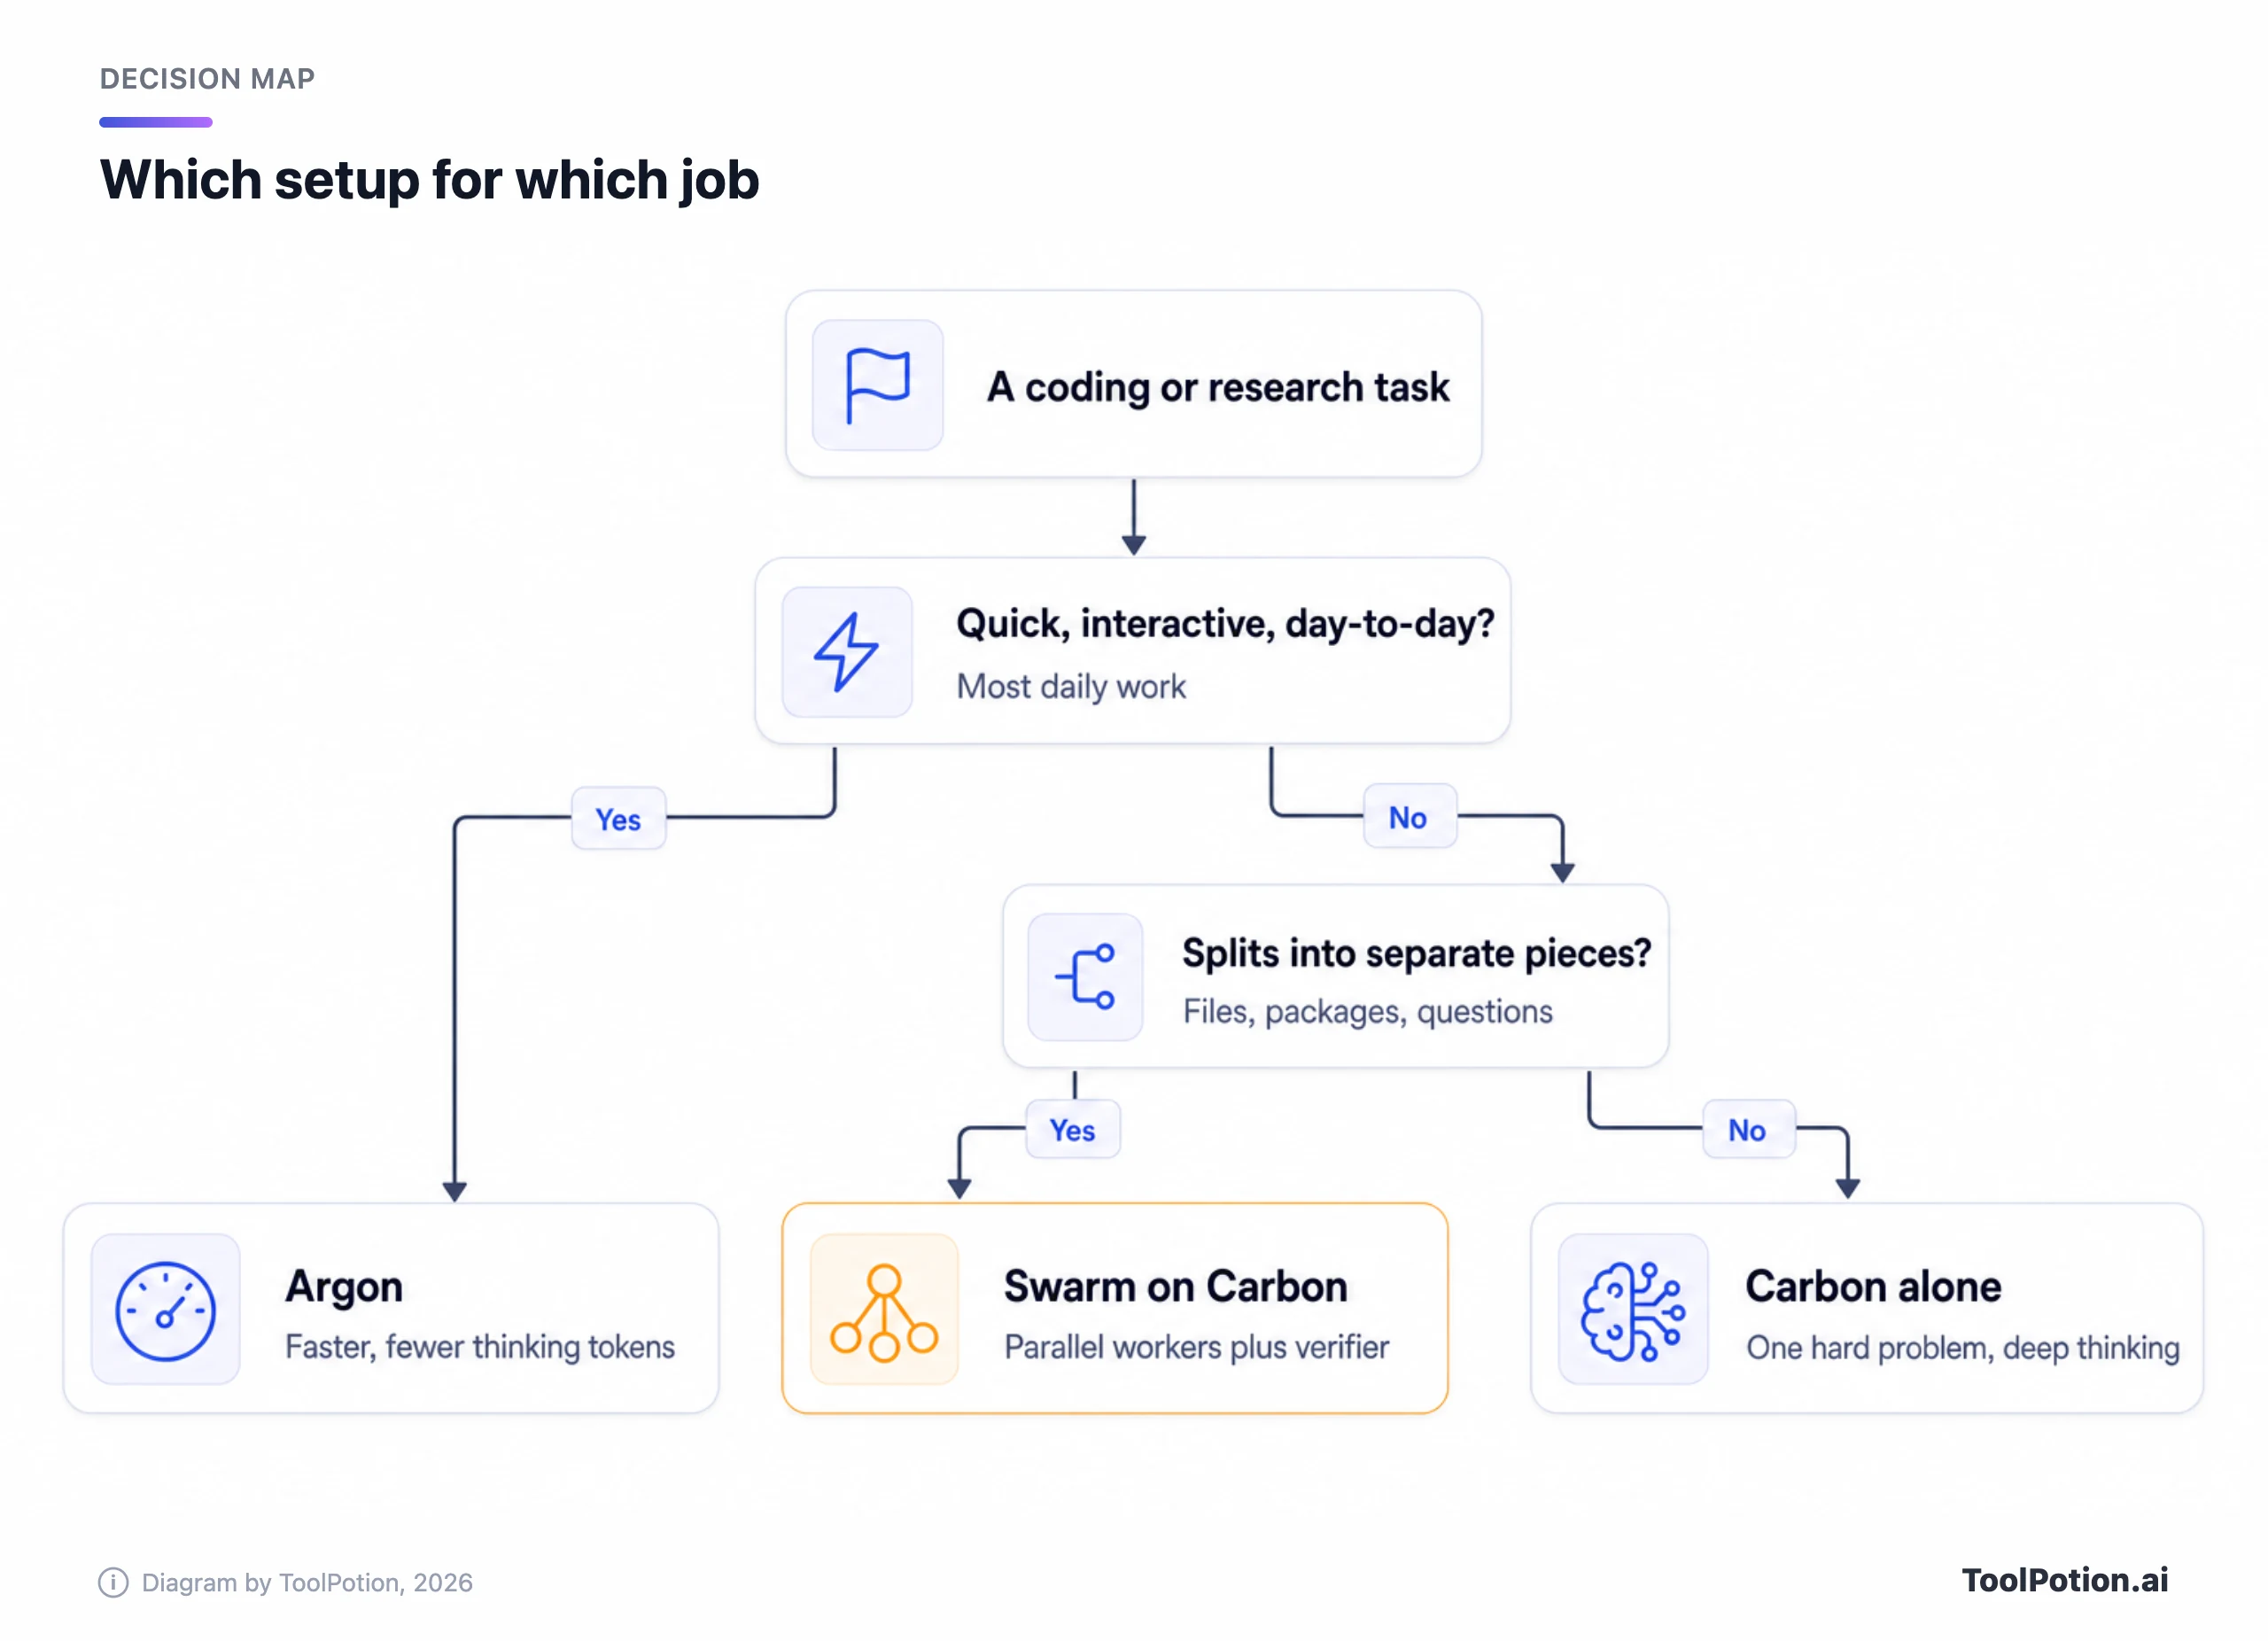
- Lanza primero el trabajo en Argon. La mayoría no necesitará más.
- Si Argon se queda corto, prueba Carbon con el nivel de thinking medio por defecto, y luego con el alto. El propio consejo de Google es probar los tres niveles y elegir el más bajo que cumpla tu listón (Google AI docs).
- Lanza /swarm solo para trabajo que se divida por archivo, paquete o pregunta, y pide el verificador en un modelo distinto al de los workers.
- Presupuesta con $4 y $20, no con $2 y $10.
En cuanto al dinero, nos saltaríamos Ultra si Carbon es el único motivo para comprarlo. Desde $99,99 al mes, es mucho pagar por un solo modelo cuando la API lo vende por token con saldo prepago. Pruébalo ahí con un presupuesto pequeño, y vuelve a mirarlo si te ves ejecutando agentes todo el día. Si tu equipo vive en un editor, el selector de Copilot es la prueba con menos fricción; nuestro artículo sobre Copilot Fusion cubre qué significa el enrutamiento de modelos ahí para el coste, y nuestra comparativa de Cursor, Copilot y Windsurf cubre los editores en sí. Si estás buscando herramientas de agentes, puedes explorar todos los rankings de ToolRank para agentes de IA o el hub de agentes de IA.
Hydrogen es un rumor, no un producto
Puede que Google tenga algo más ligero en camino, pero por ahora es solo un reporte y nada más. Business Insider dice que Google está dejando que su personal pruebe un modelo rápido llamado Hydrogen, citando un mensaje interno en el que un ingeniero lo calificó de "very capable, fast and efficient". Un empleado dijo al medio que se parece a los modelos Flash de Google, los caballos de batalla más baratos. BI afirma que no está claro si un lanzamiento público sería gratuito o de pago, y que Google declinó comentar (Business Insider). No hay nombre, precio ni fecha anunciados. Si tu factura se iría en los workers más ligeros de un swarm, Hydrogen es el modelo a vigilar. Nosotros no planificaríamos en torno a él.
Preguntas frecuentes
¿Se puede probar Gemini 4 Carbon gratis?
No. La página de precios de Google lo marca como no disponible en el nivel gratuito de la API, y en la app de Gemini requiere Google AI Ultra. La forma más barata de entrar es un saldo de API de pago.
¿Google entrena con los datos de mi API?
La página de precios de Google dice que el contenido del nivel de pago no se usa para mejorar sus productos. El nivel gratuito es otra cosa para otros modelos, pero Carbon no se ofrece ahí.
¿Puede Carbon generar imágenes o voz?
No. Acepta entrada de texto, imagen, vídeo, audio y PDF y devuelve solo texto; la generación de imágenes, la generación de audio y la Live API figuran como no soportadas en la página del modelo.
¿Qué tamaño tiene la ventana de contexto?
Una única ventana compartida de 1.048.576 tokens para entrada, thinking y salida. Una respuesta normal está limitada por defecto a 65.536 tokens, y la ejecución en segundo plano con long decode permite que una sola respuesta llegue hasta la ventana menos tu entrada.
¿Funciona /swarm en la app de Gemini?
La documentación de Google solo lista la Antigravity App y la Antigravity CLI.
¿Qué deberíamos hacer antes de que termine el precio introductorio?
Vuelve a ejecutar una de tus propias tareas en Carbon con los tres niveles de thinking y luego calcula el coste de los recuentos de tokens a $4 y $20. Esa segunda cifra es con la que vas a convivir.