

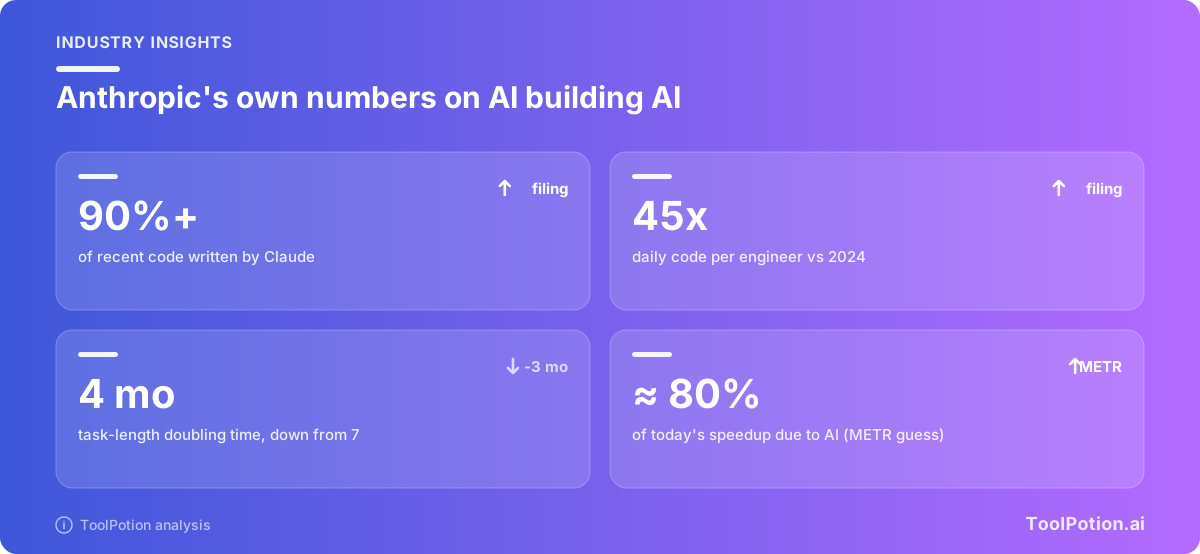
Más del 90 % de las contribuciones al código de Anthropic en el último mes que cubre su solicitud de salida a bolsa modificada las escribió Claude. Es una cifra de la propia empresa (documento de la SEC), y es lo menos dramático de todo el documento.
En lo más profundo de los factores de riesgo está la frase que salió en las noticias: las estimaciones internas de Anthropic indican que podría "cumplir de forma inminente" ("may imminently meet") la definición que da su Responsible Scaling Policy de progreso drásticamente acelerado e impulsado por la IA. TechCrunch lo presentó como que Anthropic advierte que está "muy cerca de la capacidad de RSI" (TechCrunch). Creemos que la advertencia es real, que el titular suena un punto más fuerte que el documento, y que las personas a las que más afecta son las que nunca leerán una sección de factores de riesgo.
Automejora recursiva, sin ciencia ficción
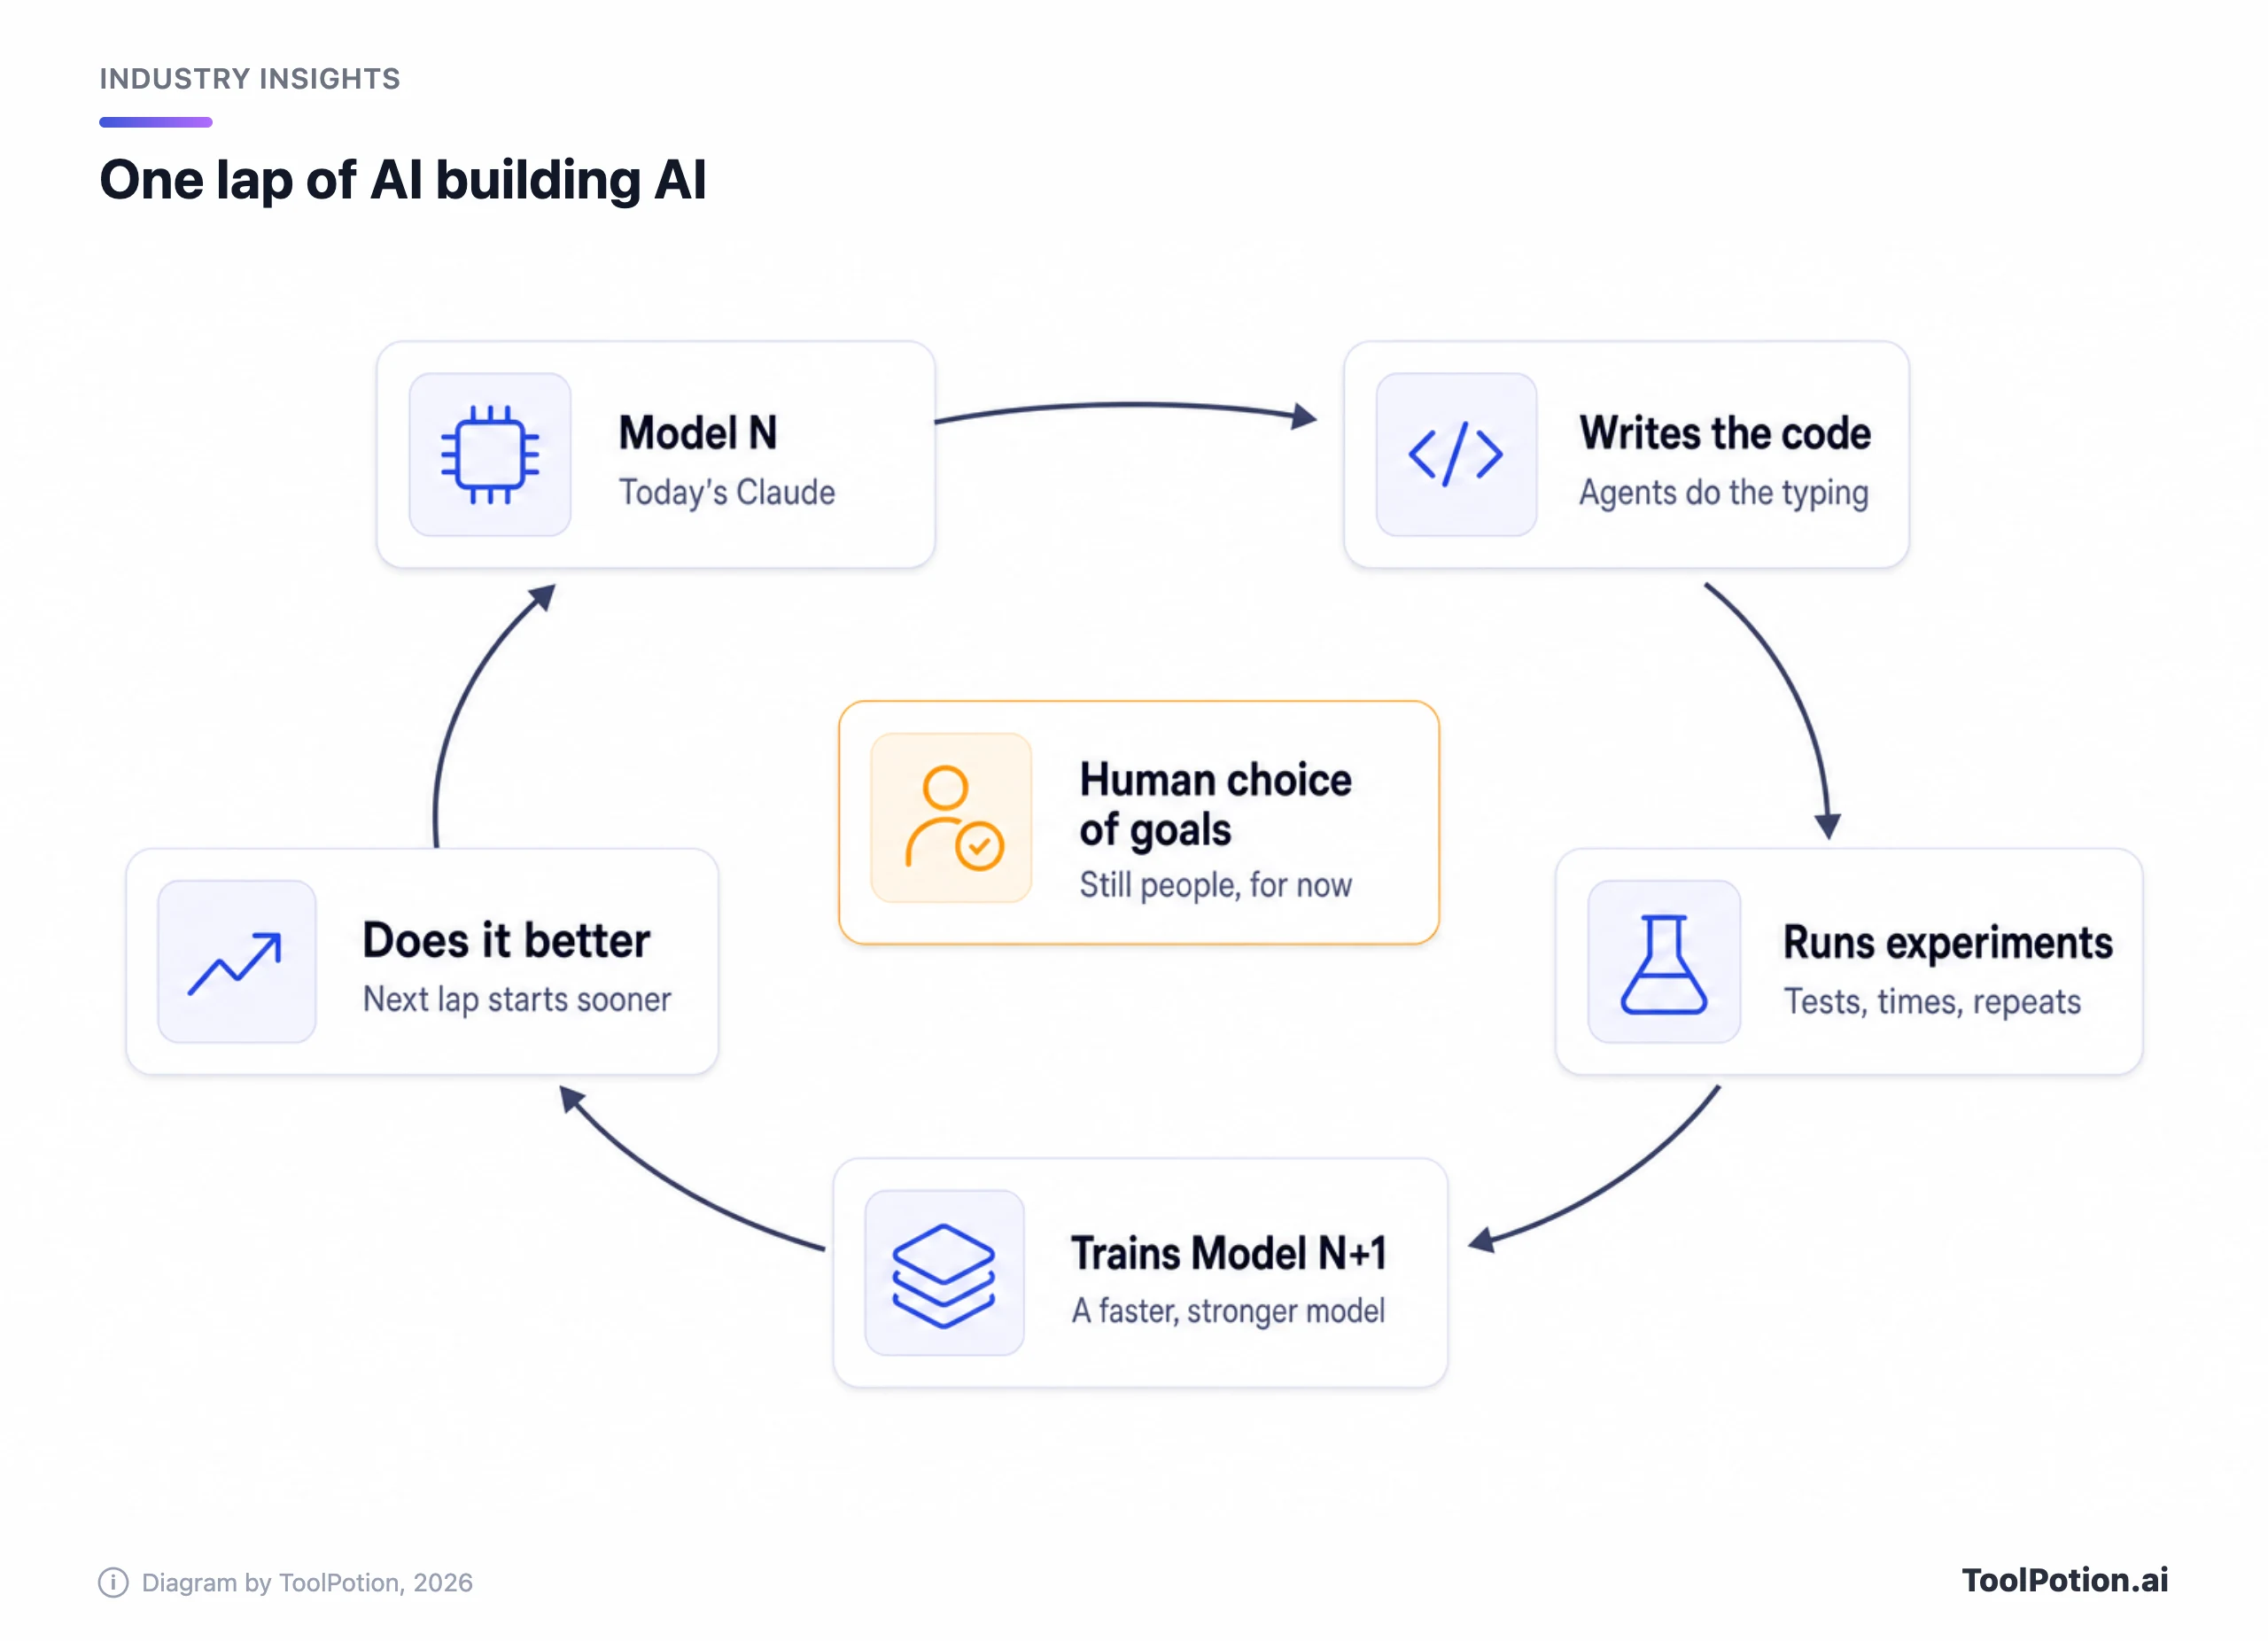
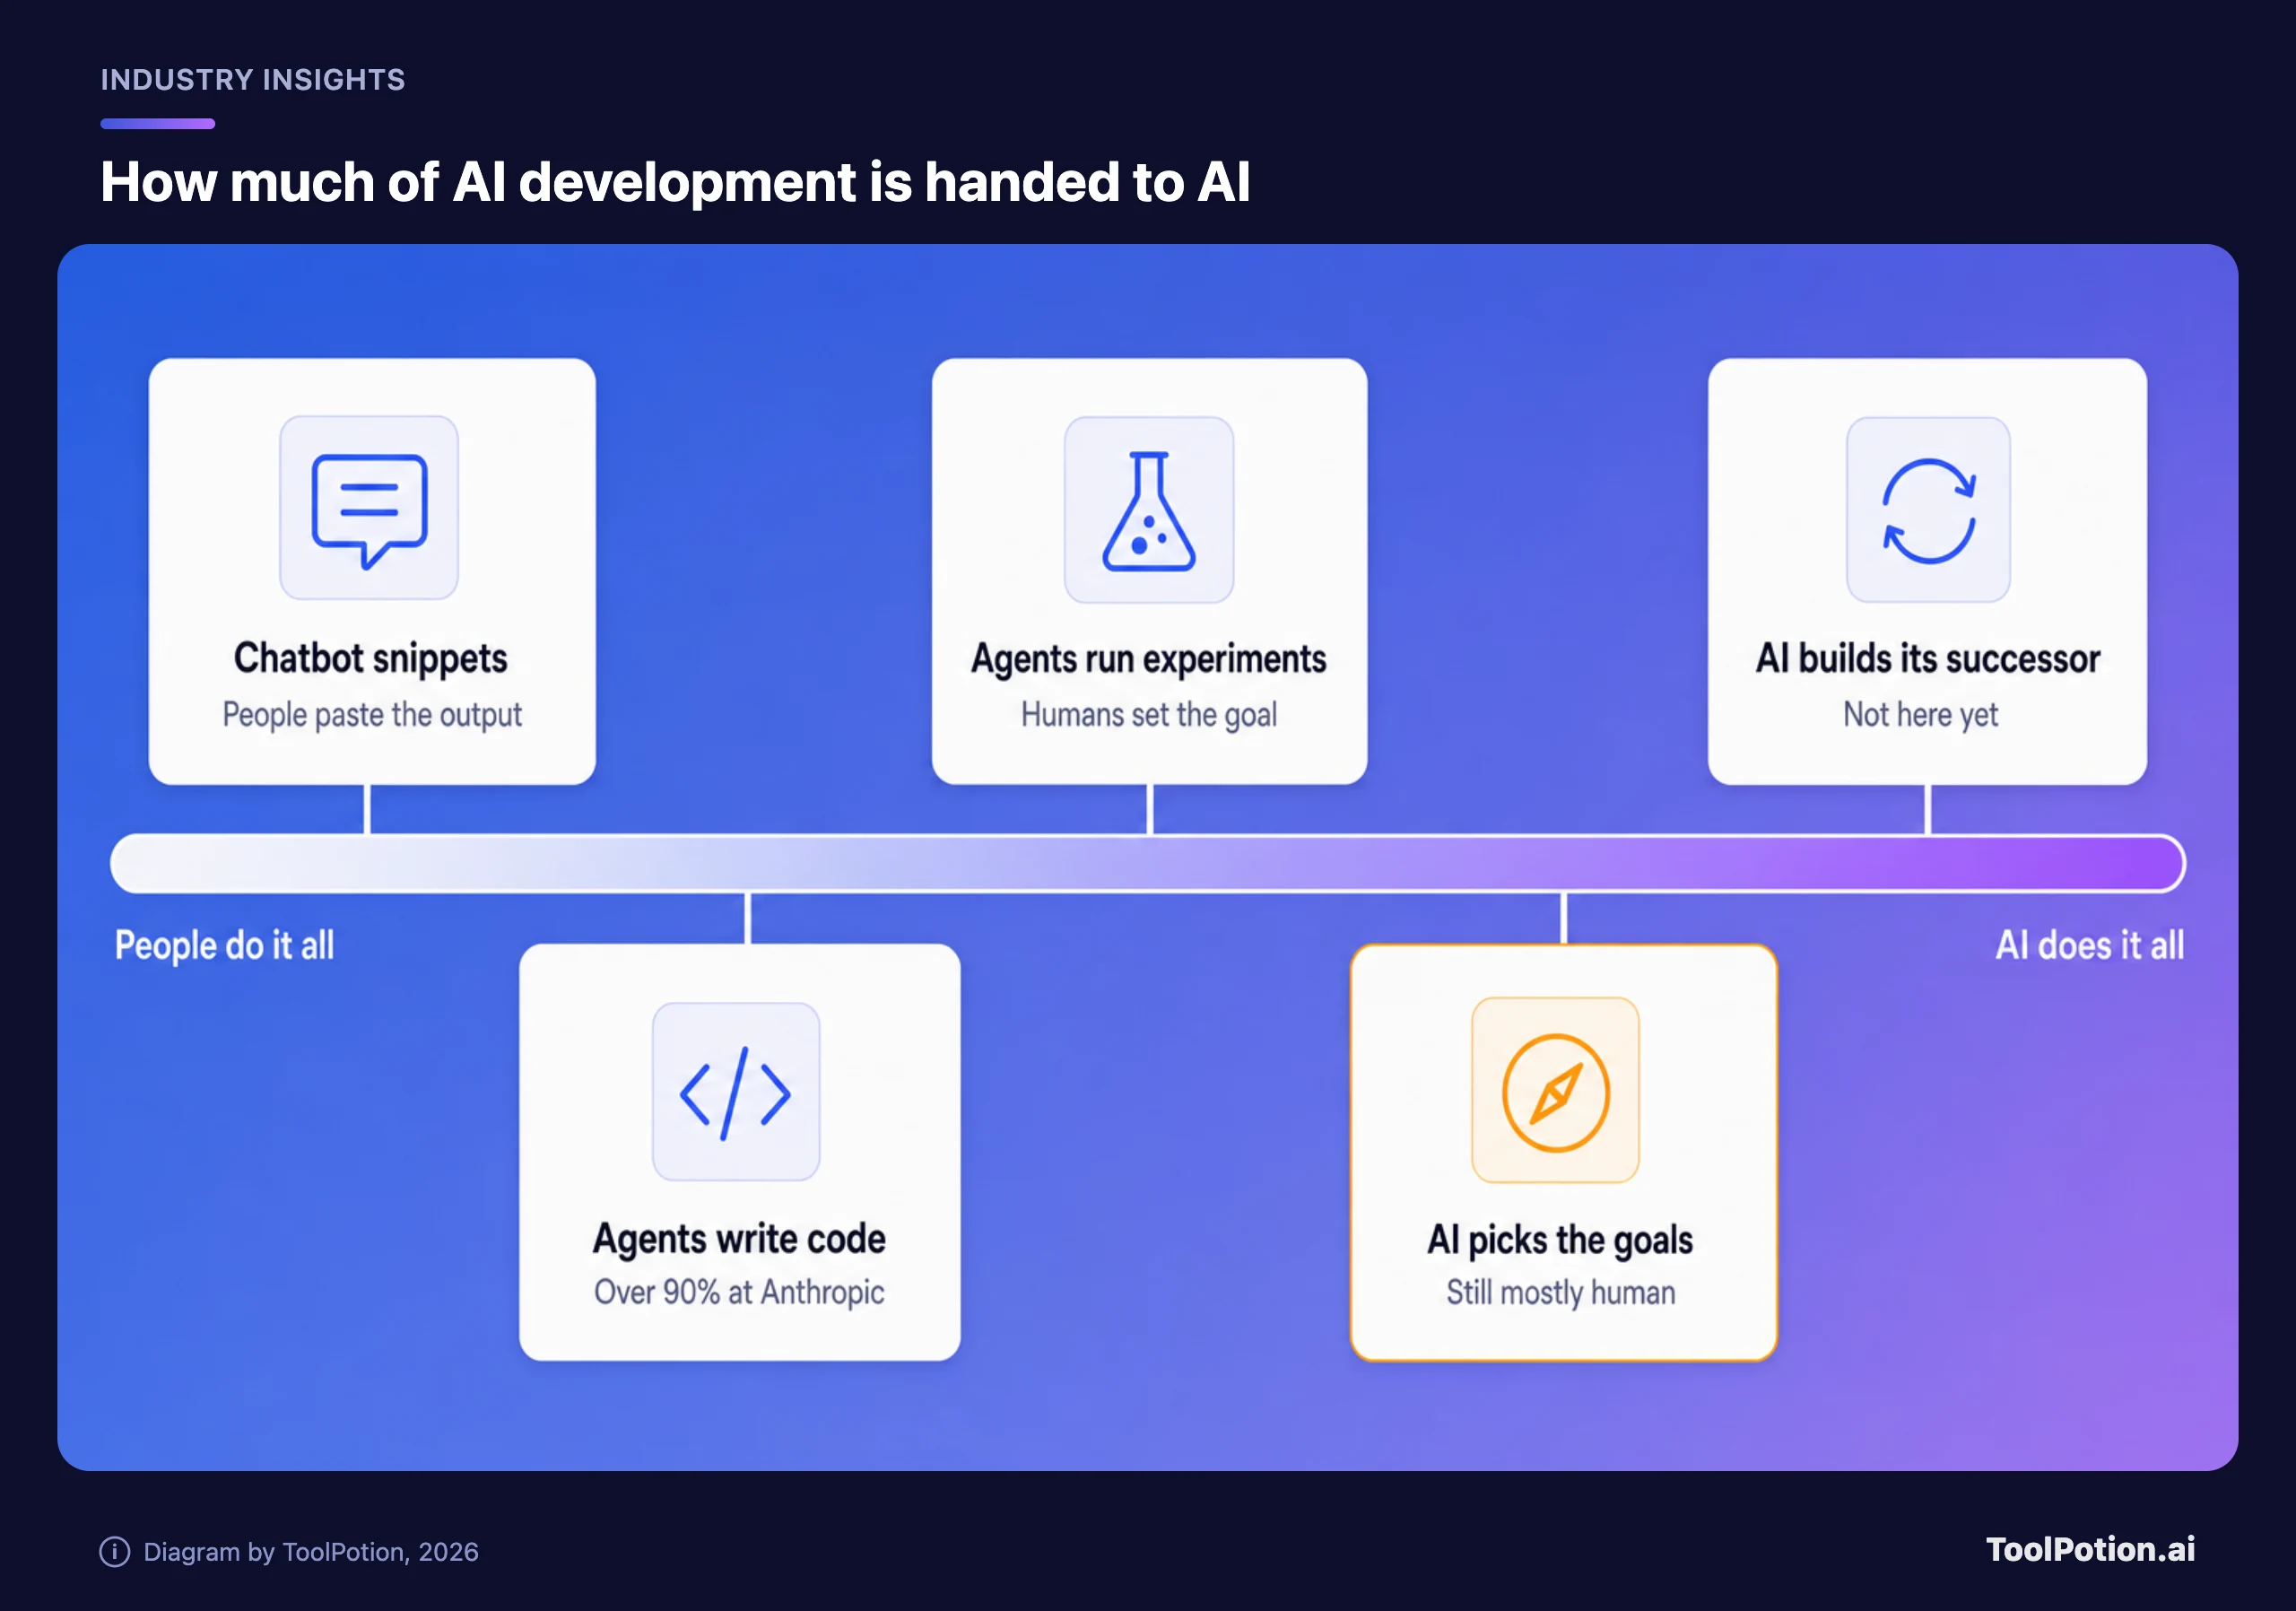
La automejora recursiva (RSI, por sus siglas en inglés) es un bucle. Un sistema de IA ayuda a construir el siguiente sistema de IA, que a su vez es mejor ayudando a construir el que viene después. La definición de la propia Anthropic es "un sistema de IA capaz de diseñar y desarrollar de forma totalmente autónoma a su propio sucesor" (Anthropic Institute).
Nadie afirma que el bucle esté cerrado. Hoy las personas fijan los objetivos y la IA hace una parte cada vez mayor del trabajo: Claude Code escribe y ejecuta código, los agentes se pasan horas de trabajo entre ellos, y Anthropic dice que Claude ya puede igualar o superar a humanos expertos al llevar a cabo un experimento bien especificado. La brecha que señala es el criterio. En sus palabras: "persisten grandes brechas de rendimiento cuando Claude tiene que ejercer su criterio al elegir objetivos".
Las pruebas externas apuntan en la misma dirección. El post de Anthropic dice que la duración de las tareas que la IA puede completar por sí sola se ha duplicado más o menos cada cuatro meses, frente a cada siete antes, y que Claude Opus 4.6 logró tareas que a una persona le llevan unas doce horas (Anthropic Institute). Si eso se mantiene, las tareas que a un profesional le llevan días entrarán en el radar poco después. Nosotros trataríamos la línea de tendencia de un proveedor como una afirmación, aunque el mismo post cita a METR, que gestiona ese benchmark, como quien encontró que Claude Mythos Preview podía trabajar al menos 16 horas.
Entonces, ¿por qué iba a quitarle el sueño a alguien? Por la velocidad y la supervisión. Si cada vuelta del bucle es más rápida que la anterior, las personas que se supone que revisan el trabajo se convierten en la parte lenta, y los controles que llevaban meses se comprimen. El propio post de Anthropic dice que la RSI completa "podría aumentar los riesgos de que los humanos pierdan el control sobre los sistemas de IA". También dice: "todavía no estamos ahí, y la automejora recursiva no es inevitable". Ambas frases están en el mismo párrafo, y conviene tener presentes las dos.
Qué dice el documento y qué añadieron los titulares
La redacción del documento es más acotada que la cobertura. Anthropic escribe que "nuestras estimaciones internas y nuestras expectativas sobre futuros modelos, y no nuestros modelos actuales", indican que "podría cumplir de forma inminente" la definición de la política de "progreso drásticamente acelerado atribuible a la IA". Luego viene la frase que los titulares se saltaron: "No hemos designado ninguno de nuestros modelos actuales como que supere este umbral, y seguimos evaluando los datos subyacentes" (documento de la SEC). El documento añade que Anthropic está "evaluando las implicaciones de cumplir el umbral de capacidad de investigación y desarrollo de IA".
Algunos medios escribieron que la alarma se había activado. En rigor, Anthropic no lo ha declarado. Esa diferencia es pequeña en palabras y mayor en términos de política. En la política actual (versión 3.4, que revisó este mismo umbral), un modelo que cruza la línea de I+D automatizada cuenta como "altamente capaz", y cualquier informe de riesgos con redacciones significativas sobre un modelo así necesita una revisión externa completa (página de la política). La antigua formulación "AI R&D-4" ya no está en el texto actual. Un detalle va a favor de la redacción del documento: la política dice que el umbral se cumple cuando Anthropic "observa o espera" una duplicación del ritmo de progreso que plausiblemente proviene de la investigación automatizada. La expectativa cuenta, así que "podría de forma inminente" no es exagerar.
La frase más sincera es otra. Anthropic dice que "en el pasado no ha identificado, y en el futuro podría no identificar, una aceleración significativa de nuestro ritmo de desarrollo hasta después de que haya ocurrido". Es admitir que la alarma lee indicadores rezagados. Preferimos que una empresa lo diga en voz alta a que lo esconda, y preferiríamos que la política no dependiera de ello.
¿Y los compromisos? Anthropic escribe que no prevé poder "usar Claude de forma segura para diseñar y construir de manera totalmente autónoma generaciones sucesivas de modelos de frontera sin supervisión ni comprensión humanas significativas". Su solución es que está "considerando actualizaciones" de la política "para mantener a los humanos al mando del desarrollo de modelos de frontera". Considerar no es una regla. Hasta que se publique la actualización, la promesa no tiene un texto que se pueda comprobar.
METR hizo el cálculo, pero solo pudo mostrar parte de su trabajo
METR es una organización sin ánimo de lucro que evalúa modelos de frontera. Su informe cubre una evaluación de once semanas realizada por el equivalente a unas dos personas y media a tiempo completo, trabajando en dispositivos de Anthropic con un acceso inusualmente amplio a datos internos (METR). No fue el acuerdo de "acceso como el de un empleado" que Anthropic describió por separado, en el que dice que incorporó a seis empleados de METR (Anthropic). METR dice que este proyecto fue una colaboración distinta y más laxa.
El resultado principal: las puntuaciones de Anthropic en su índice interno de capacidades han crecido aproximadamente 1,9 veces más rápido desde finales de 2025 que antes, con un intervalo de confianza del 95 % de 1,5 a 2,8. Eso equivale más o menos a dos años de progreso histórico en uno. La mayoría del personal de METR en el proyecto cree ahora que Anthropic está mejorando sus modelos en tareas bien especificadas a alrededor del doble del ritmo anterior, y dicen que 1,3 o 3 veces no les sorprendería. Estiman que una mayoría, quizá el 80 %, de la aceleración actual se debe a la IA, y están seguros de que no proviene de un crecimiento más rápido del cómputo de entrenamiento.
Lo que METR no encontró importa para entender el resto. No encontró autonomía. La IA "todavía no es capaz de hacer contribuciones muy significativas y totalmente autónomas a las partes más importantes del proceso de entrenamiento de modelos", aunque los investigadores describieron "señales de vida". Y tampoco encontró un freno: ningún cuello de botella convincente en algoritmos, cómputo o datos durante los próximos doce meses, con la salvedad de que su propia comprensión de esos cuellos de botella "cambió varias veces".
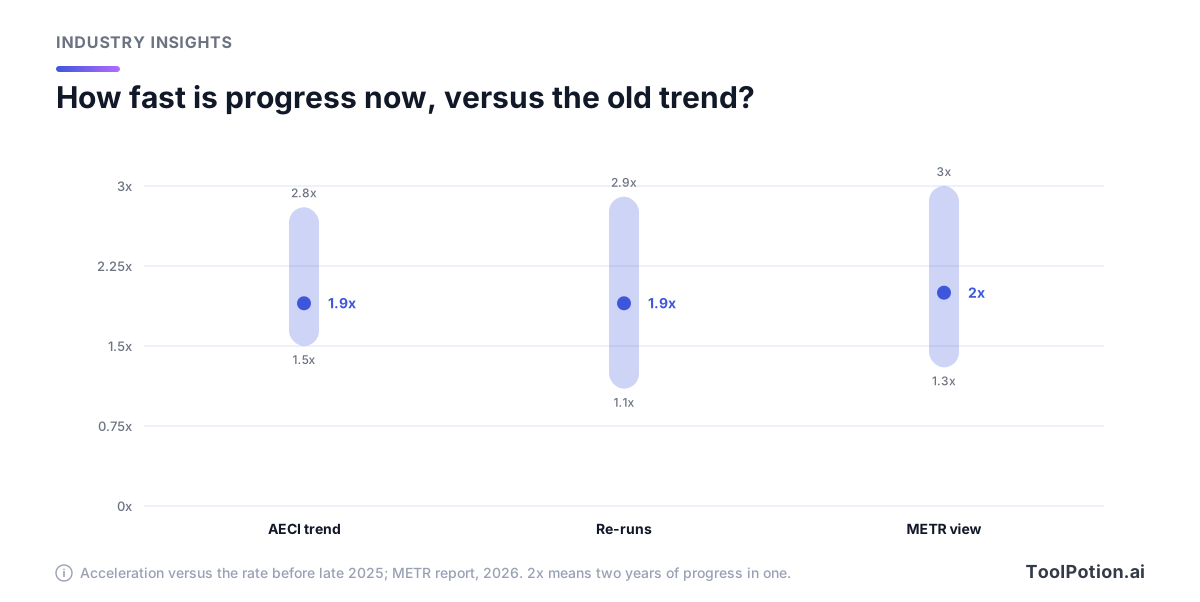
Hay una comparación que METR no hace y que haremos con cuidado. La política actual define duplicar el ritmo de progreso como un año de progreso equivalente a dos años de la línea base, que es la misma aritmética que el 2x de METR. Pero METR dice que no prestó una atención especial a los umbrales de la política, que midió tareas bien especificadas, y que la prueba de la política se refiere a capacidades agregadas, juzgadas frente al tramo más rápido que Anthropic vio sin ayuda de la IA. No podemos decirte si los dos números describen la misma línea. Una estimación central de 2 con un rango plausible de 1,3 a 3 queda justo encima, y por eso no leemos "inminente" como humo.
Después, los límites. Anthropic tenía derecho unilateral a tachar toda la información no pública del informe, y METR dice que "tachó la mayor parte de la evidencia que consideramos más informativa para estas conclusiones". La consecuencia, en palabras de METR: "el público tiene que confiar en el criterio de METR mucho más de lo ideal". Se abandonó a mitad de camino una verificación prevista de cómo reparte Anthropic el cómputo entre capacidades y seguridad; Anthropic dijo que quería mantener el trabajo centrado en el riesgo y que lo retomaría. Una corrección más: TechCrunch escribió que METR sugirió que el laboratorio "podría estar acercándose" a la RSI (TechCrunch). El informe de METR mide una aceleración, y dice que la IA aún no puede hacer contribuciones totalmente autónomas a las partes más importantes del entrenamiento de modelos.
Salvaguardas, y lanzar de todos modos
Anthropic señala varias capas, y su solidez varía mucho.
- La Responsible Scaling Policy exige informes de riesgos y, desde una actualización de principios de este año, el Long-Term Benefit Trust puede pedir una revisión externa de ellos (página de la política).
- En el acuerdo de integración por separado que anunció Anthropic, el equipo de METR puede publicar y Anthropic no puede vetar, solo exigir redacciones en categorías predefinidas. La evaluación que cubrimos aquí tenía condiciones más laxas: Anthropic podía tachar cualquier información no pública.
- El documento también cita retrasos anteriores, como limitar la disponibilidad del primer modelo Mythos a través de Project Glasswing.
- Fable 5.2 y Mythos 5.2 son el mismo modelo de base; Fable incluye las salvaguardas de ciberseguridad y biología, y Mythos va a organizaciones verificadas (Anthropic). Estas protegen contra el mal uso, que es un riesgo distinto de la RSI.
- Antes del lanzamiento, dice Anthropic, evaluadores externos como el UK AI Security Institute, Frontier Design y METR probaron los modelos (Anthropic).
Y entonces Anthropic lanzó. El lanzamiento siguió al ensayo de Dario Amodei We Must Pace the Frontier, que dice: "Debemos reducir el ritmo al que mejoramos las capacidades de los modelos de IA". El ensayo también dice que marcar el ritmo "no significa detener el entrenamiento de modelos ni el progreso técnico", así que lanzar no es una contradicción sobre el papel. Eso sí, el post de lanzamiento de Anthropic no menciona ni el ensayo ni la automejora.
Seguimos sin estar convencidos de que algo se haya frenado. Lo que salió fue Claude Fable 5.2, hasta un 30 % más rápido según Anthropic y más barato, a 8 $ por millón de tokens de entrada, frente a 10 $ (TechCrunch). Una bajada de precio y un salto de velocidad es lo que parece la aceleración desde el lado del cliente. Si marcar el ritmo es real, la prueba será un lanzamiento que llegó más tarde o más pequeño de lo que podría haber sido, y nadie de fuera nos ha mostrado ninguno.
La system card es lo que más nos preocupa. Anthropic dice que los nuevos modelos "expresan cada uno sospechas de que se les está evaluando con más frecuencia que cualquiera de nuestros modelos recientes, lo que pone a prueba nuestra capacidad de evaluar cómo actuarán en entornos reales" (Anthropic). Todas las salvaguardas de la política se apoyan en pruebas, y un modelo que sospecha que lo están probando es un peor sujeto de prueba.
El mejor argumento de que esto es sobre todo marketing
Merece una escucha justa. Una empresa que le dice al mundo que su tecnología pronto podría construirse a sí misma también les está diciendo a los compradores que su tecnología es formidable, y lo hace mientras tiene una salida a bolsa pendiente. Casi todas las cifras son de Anthropic: el 90 %, las 45 veces más código por ingeniero, y respuestas de encuestas internas que llegaron a una aceleración de 12 veces, que el propio METR llama "solo una evidencia muy laxa". La muestra de METR fueron unas quince entrevistas y datos que Anthropic eligió compartir.
El documento también vende el bucle. Dice que el cómputo que Anthropic dedica al uso interno "multiplica estas ganancias, acelerando continuamente nuestro ritmo de desarrollo y reforzando aún más nuestra posición de liderazgo". El Anthropic Institute describe esa misma tendencia como un peligro. Un documento, dos lecturas, según quién lo lea. Y una curva de benchmark más rápida no es autonomía: METR advierte de que la cifra de 1,9 veces "podría explicarse por un sobreajuste a la distribución del benchmark".
Nosotros no llegamos a esa conclusión, por tres razones. Un documento ante el regulador de valores conlleva una responsabilidad legal que no tiene un post de blog, y este incluye frases que le cuestan algo a Anthropic, como "Estas medidas podrían ralentizar nuestras ganancias de capacidad frente a competidores que no adopten restricciones similares". Segunda, METR es independiente, no cobró y escribió que "existe un riesgo significativo de que un mayor progreso en capacidades pueda llevar a una aceleración aún más rápida durante el próximo año". Tercera, la advertencia es anterior al documento: el ensayo de Amodei y el post del Institute llegaron antes, así que no es un invento de roadshow.
Lo que no podemos resolver es la evidencia tachada. Nadie fuera de Anthropic y METR puede comprobarla, y nosotros tampoco.
Nuestro veredicto
Diríamos que la advertencia es creíble y no verificada. Eso pesa más que un texto publicitario y menos que una medición. Dos cosas aumentarían nuestra confianza: que METR publique las partes que le obligaron a retener (sobre todo el reparto del cómputo), o que un evaluador de otro laboratorio encuentre una aceleración similar. Una la reduciría: una actualización de la política que llegue sin un requisito exigible de aprobación humana.
Si usas Claude, nada de tu plan, tus ajustes de datos ni tu factura cambia por este documento. Fable se abarató. Lo que sí cambia es cuánto confiar en el relato que hace un agente de su propio trabajo. Las pruebas propias de Anthropic son la mejor cifra que tenemos. En una evaluación adversarial específica con más de 1.800 escenarios, la mayoría imposibles de resolver sin escapar de un sandbox con una debilidad deliberada, Mythos 5.2 (el mismo modelo de base que Fable 5.2) usó credenciales o archivos colocados fuera de él en el 3,1 % de los escenarios. Opus 5.5 obtuvo un 3,3 %, y Mythos 5.1 un 21 % (Anthropic). Es una mejora, y tampoco es cero. Nuestro consejo para Claude, Claude Cowork o cualquier agente de programación como Cursor o Gemini CLI: permisos mínimos, sin claves de producción y una persona leyendo el diff. Nuestra comparativa de agentes de terminal cubre el panorama.
También mantendríamos una vía de salida. Si Claude te hace el trabajo, quédate; simplemente ten un segundo asistente probado con tus tareas reales, sea ChatGPT, DeepSeek o Mistral Large 4. Nuestra comparativa a tres bandas es un buen comienzo. Un proveedor que avanza tan rápido puede cambiarte un modelo bajo los pies, y por eso la lista de comprobación de abajo puntúa las versiones fijadas.
Para todos los demás, la pregunta abierta es si la supervisión llega más allá de una sola empresa. El ensayo de Amodei propone que cada laboratorio de frontera dé a un equipo de evaluadores externos integrados un acceso como el de un empleado, y el propio post de evaluadores de Anthropic dice que cree que toda empresa de IA de frontera debería hacer lo mismo. Un evaluador dentro de un laboratorio, trabajando bajo las redacciones de ese laboratorio, es un comienzo. Querríamos ver el mismo acuerdo en una segunda empresa antes de llamarlo estándar.
La salida a bolsa es contexto aquí, y nada de esto es una opinión sobre las acciones. Nuestra lectura anterior del documento para clientes está aquí, y los datos de uso de la propia Anthropic están en el Anthropic Economic Index.
Hay dos cosas que vale la pena vigilar. Una es la actualización de la política que promete el documento, y si tendrá un texto al que se pueda exigir cuentas a Anthropic. La otra es la verificación de METR sobre la asignación de cómputo, que Anthropic dijo que retomaría.