Descripción
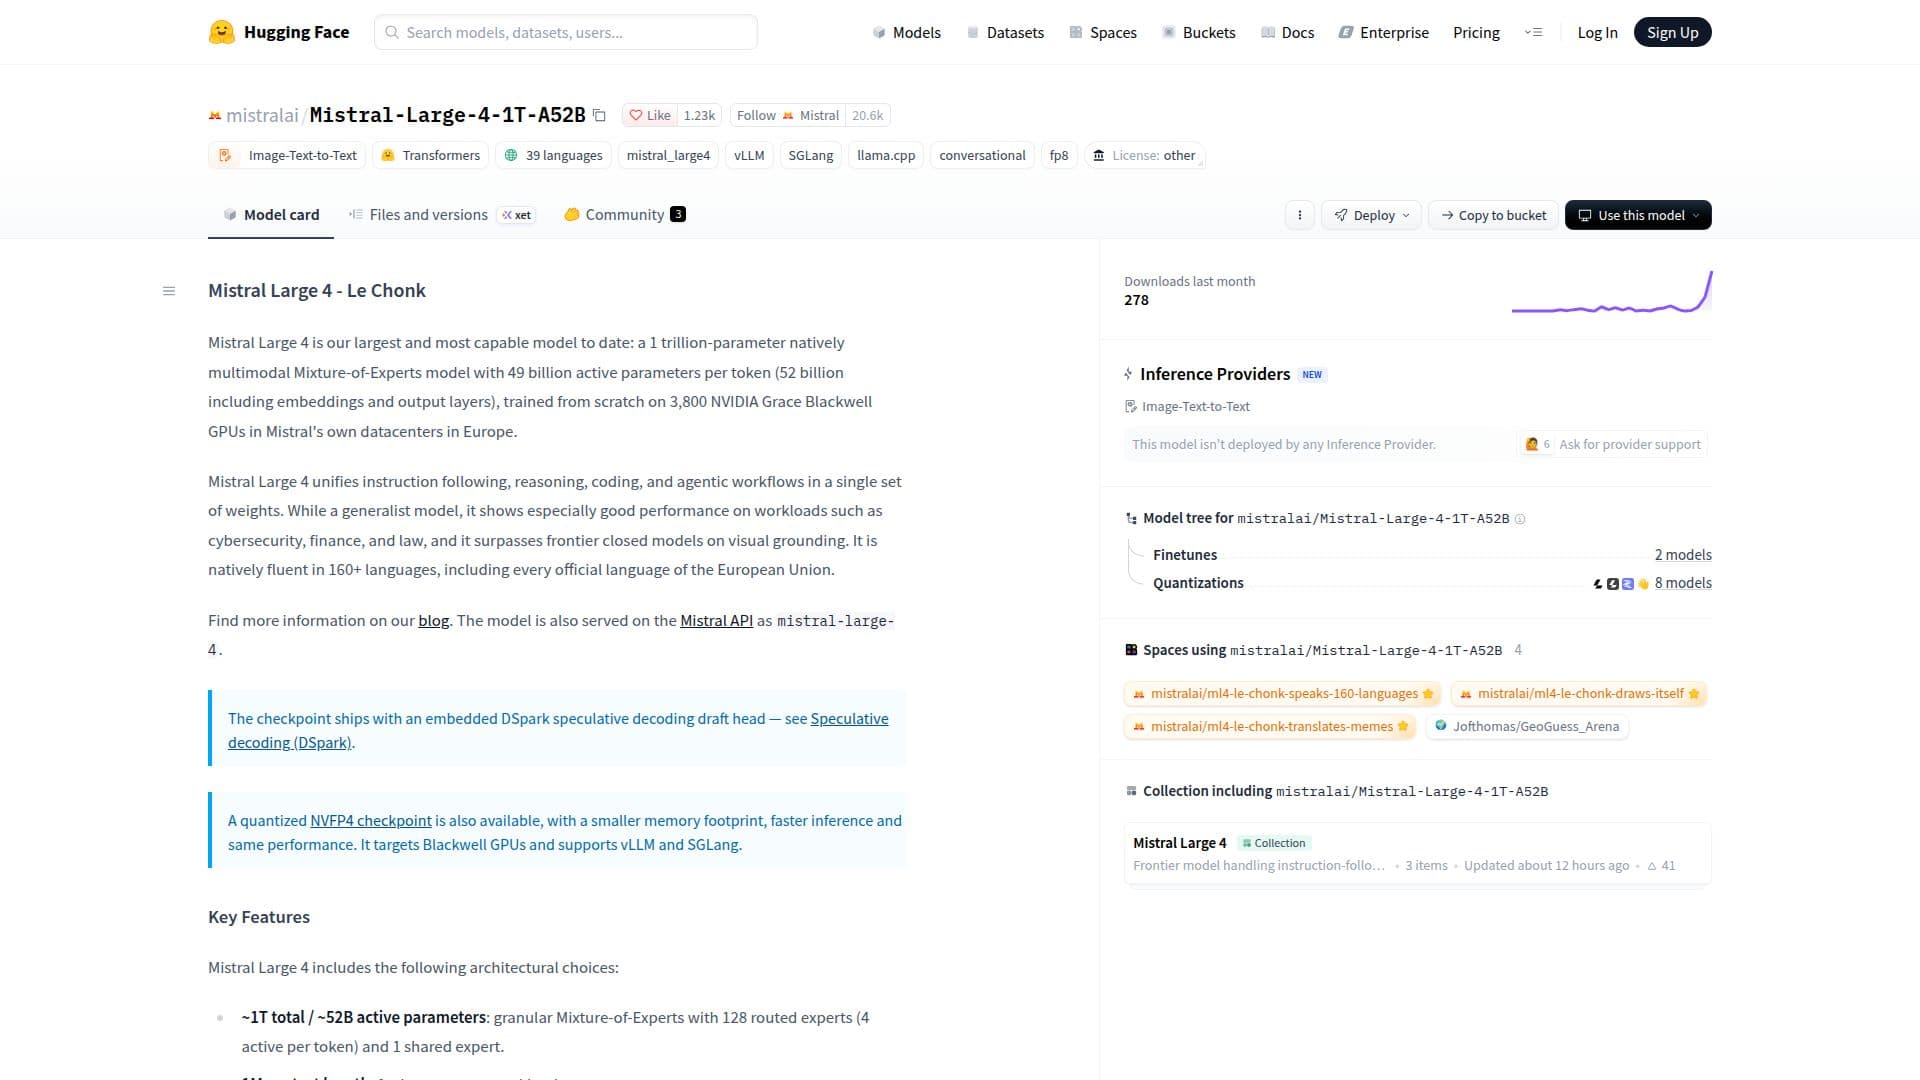
Mistral Large 4, también conocido como «Le Chonk», representa el modelo más avanzado y capaz de Mistral hasta la fecha. Es un modelo Mixture-of-Experts nativamente multimodal de 1 billón de parámetros, con 49 mil millones de parámetros activos por token (52 mil millones incluyendo capas de embeddings y salida). El modelo fue entrenado desde cero en 3,800 GPUs NVIDIA Grace Blackwell dentro de los centros de datos europeos de Mistral, asegurando un rendimiento robusto y escalabilidad.
Leer más
Este modelo generalista unifica el seguimiento de instrucciones, razonamiento, codificación y flujos de trabajo agenticos en un único conjunto de pesos. Aunque es versátil en muchos dominios, Mistral Large 4 demuestra un rendimiento excepcional en áreas especializadas como ciberseguridad, finanzas y derecho. También supera a los modelos cerrados de frontera en capacidades de anclaje visual, lo que lo hace altamente efectivo para tareas que involucran análisis de imágenes.
Una de las principales fortalezas de Mistral Large 4 es su fluidez nativa en más de 160 idiomas, abarcando todos los idiomas oficiales de la Unión Europea. Este amplio soporte lingüístico lo convierte en una herramienta poderosa para aplicaciones globales. El modelo cuenta con una longitud de contexto sustancial de 1M, lo que le permite manejar cargas de trabajo de largo contexto de manera eficiente. Su capacidad de entrada multimodal le permite aceptar tanto entradas de texto como de imagen, generando salidas de texto.
Arquitectónicamente, Mistral Large 4 utiliza un diseño granular de Mixture-of-Experts con 128 expertos enrutados, donde 4 expertos están activos por token, junto con 1 experto compartido. También incluye una cabeza de borrador de decodificación especulativa DSpark embebida, que puede acelerar significativamente la decodificación sin alterar las salidas del modelo objetivo, ofreciendo hasta 1.9 veces mayor rendimiento en ciertos escenarios. También está disponible un punto de control NVFP4 cuantizado, que proporciona una huella de memoria más pequeña, inferencia más rápida y rendimiento equivalente, dirigido específicamente a GPUs Blackwell y compatible con vLLM y SGLang.
Mistral Large 4 se lanza bajo la Licencia de Peso Abierto del Ecosistema Mistral, una licencia MIT modificada que permite tanto el uso comercial como no comercial. Sin embargo, operar un negocio de Modelo como Servicio con Mistral Large 4 requiere una licencia comercial separada de Mistral. El modelo está disponible en la API de Mistral como `mistral-large-4` y puede ser desplegado y ajustado utilizando diversas bibliotecas como vLLM, SGLang, Transformers, llama.cpp, Axolotl, Unsloth y TRL.
- CategoríaModelos de IA y LLM
- Modelo de preciosCódigo abierto
- ImplementaciónNube
- PlataformasWeb
Aspectos destacados de Mistral Large 4
1 Billón de Parámetros Totales
52 Mil Millones de Parámetros Activos por Token
Entrada Nativamente Multimodal (Texto e Imagen)
1 Millón de Longitud de Contexto
Soporte Multilingüe (más de 160 idiomas)
Modo de Razonamiento Configurable (Bajo, Medio, Alto)
Capacidades Avanzadas de Visión para Análisis de Imágenes
Fuerte Adherencia a Prompts del Sistema
Llamadas a Funciones Nativas y Salida JSON
Cumplimiento Estricto del Esquema JSON
Rendimiento de Ciberseguridad de Última Generación
Cabeza de Borrador de Decodificación Especulativa DSpark Embebida
Punto de Control NVFP4 Cuantizado Disponible
Licencia de Peso Abierto para Uso Comercial y No Comercial
Primeros pasos con Mistral Large 4
Acceder al Modelo: Encuentra Mistral Large 4 en Hugging Face o a través de la API de Mistral.
Desplegar con vLLM: Usa la imagen Docker oficial de vLLM para inferencia lista para producción, configurando parámetros como `--tool-call-parser mistral` y `--reasoning-parser mistral`.
Desplegar con SGLang: Utiliza la imagen Docker oficial de SGLang, habilitando la decodificación especulativa con `--speculative-algorithm DSPARK`.
Desplegar con Transformers: Instala Transformers desde el repositorio principal y usa el fragmento de Python proporcionado para el despliegue en múltiples GPUs.
Ajustar el Modelo: Usa bibliotecas como Axolotl, Unsloth o TRL para ajustar Mistral Large 4.
Integrar con Mistral Vibe: Instala Mistral Vibe y configúralo para usar Mistral Large 4 a través de la API de Mistral o un servidor local de vLLM.
Configurar Esfuerzo de Razonamiento: Establece `reasoning_effort` en 'bajo', 'medio' o 'alto' según la complejidad del prompt.
Utilizar Prompts del Sistema: Define entornos y casos de uso claros con prompts del sistema para un aprovechamiento efectivo de la herramienta.
Casos de uso de Mistral Large 4
- Flujos de Trabajo Agenticos Complejos
- Análisis de Ciberseguridad
- Modelado y Análisis Financiero
- Procesamiento de Documentos Legales
- Comunicación Multilingüe
- Recuperación de Información de Largo Contexto
- Análisis de Imágenes y Gráficos
- Generación y Depuración de Código
- Seguimiento de Instrucciones y Automatización
- Chatbot e IA Conversacional