Descripción
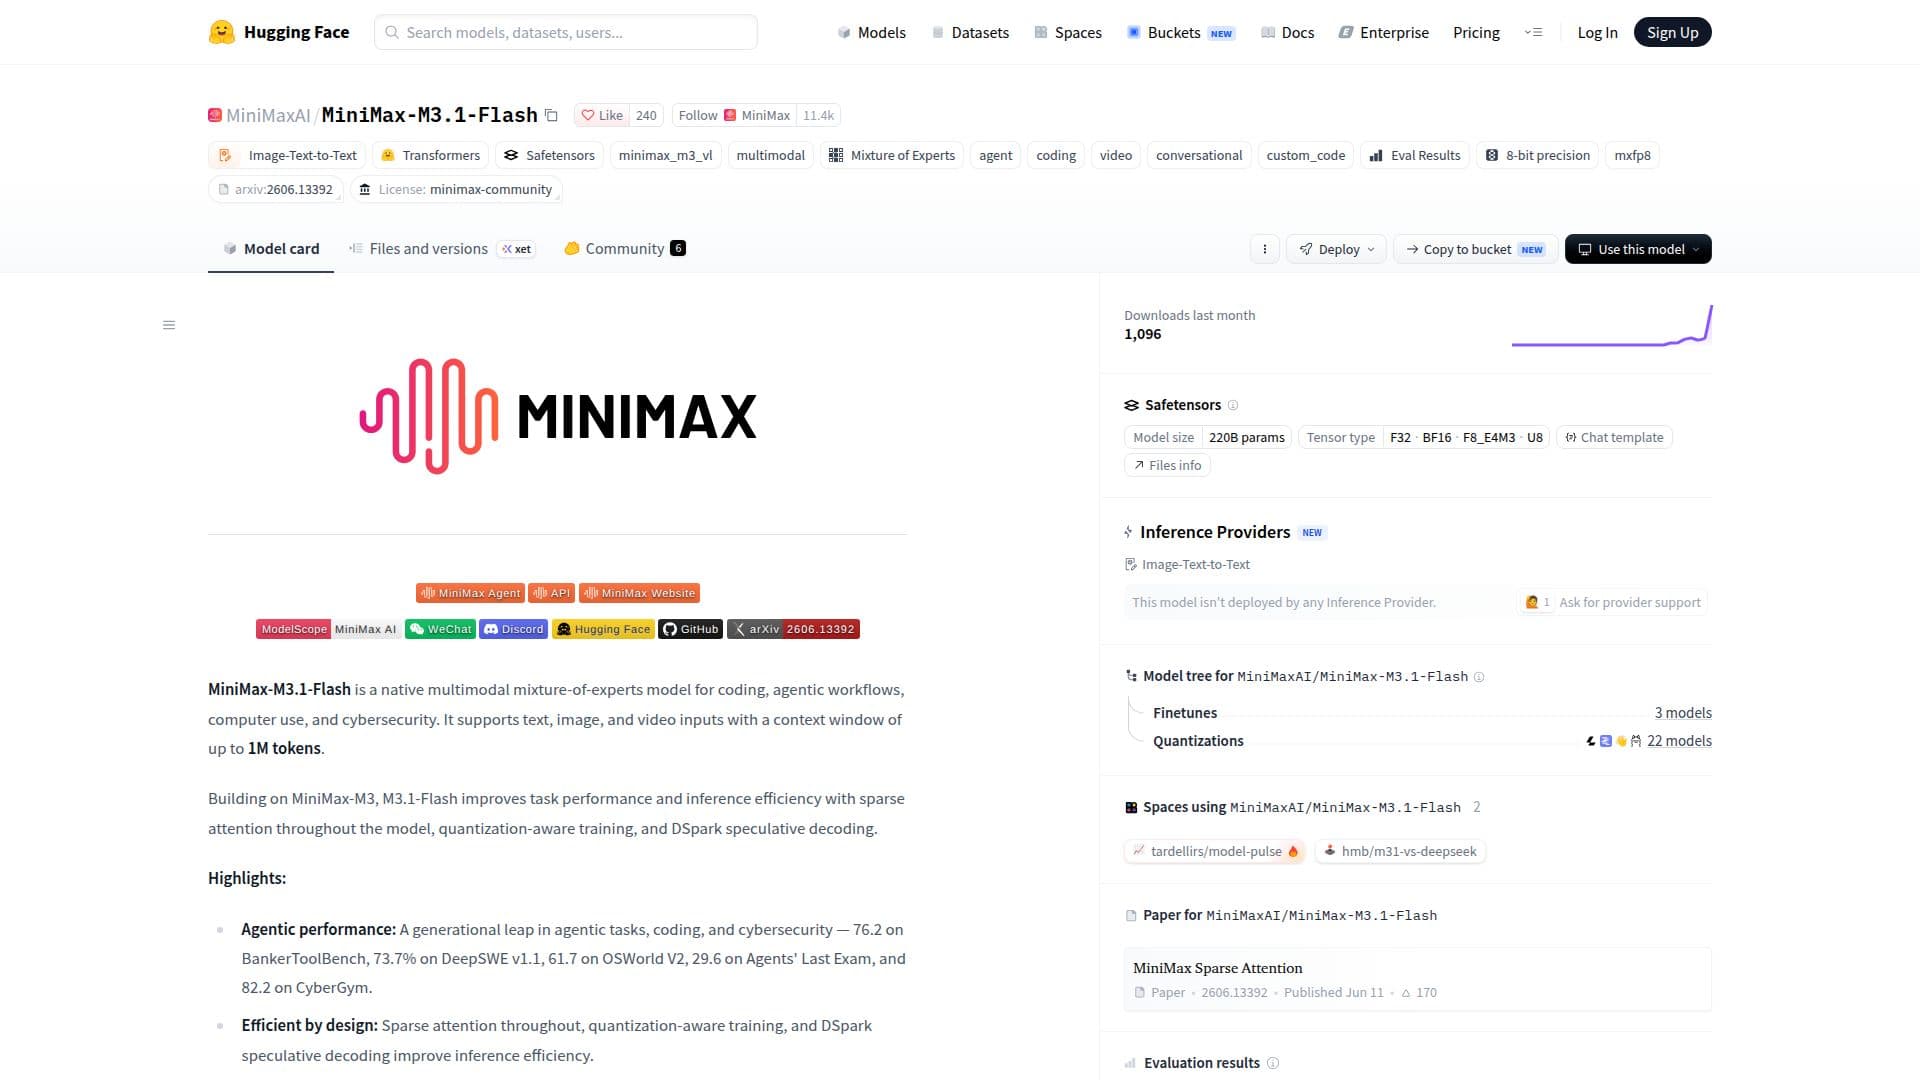
MiniMax-M3.1-Flash es un modelo avanzado de mezcla de expertos multimodal desarrollado para mejorar la codificación, flujos de trabajo agenticos, uso de computadoras y ciberseguridad. Este modelo soporta entradas de texto, imagen y video, proporcionando una ventana de contexto de hasta 1 millón de tokens. Basándose en la arquitectura MiniMax-M3, M3.1-Flash introduce mejoras en el rendimiento de tareas y eficiencia de inferencia mediante el uso de atención dispersa en todo el modelo, entrenamiento consciente de cuantización y decodificación especulativa DSpark.
Leer más
La arquitectura del modelo está diseñada para manejar una amplia gama de entradas y salidas, con aproximadamente 428 mil millones de parámetros, de los cuales 23 mil millones se activan por token. Esto permite un procesamiento eficiente y un alto rendimiento en varios benchmarks, incluyendo una puntuación de 76.2 en BankerToolBench y 82.2 en CyberGym.
M3.1-Flash es particularmente notable por su rendimiento agentico, ofreciendo un salto generacional en tareas relacionadas con la codificación y la ciberseguridad. Logra altas puntuaciones en varios benchmarks, como 73.7% en DeepSWE v1.1 y 61.7 en OSWorld V2. La eficiencia del modelo se mejora aún más con características como atención dispersa y entrenamiento consciente de cuantización, que reducen la huella de memoria y mejoran la eficiencia de servicio.
Para el despliegue, MiniMax-M3.1-Flash soporta varios marcos de inferencia, incluyendo SGLang, vLLM y TokenSpeed, con integraciones adicionales en progreso. El modelo está diseñado para un despliegue multi-chip, ofreciendo flexibilidad en las configuraciones de servicio. Los usuarios pueden ajustar la configuración de inferencia, como temperatura y top_p, para optimizar el rendimiento para tareas específicas.
En general, MiniMax-M3.1-Flash es una herramienta poderosa para desarrolladores e investigadores que buscan aprovechar capacidades avanzadas de IA en contextos multimodales, proporcionando un soporte robusto para flujos de trabajo complejos y aplicaciones de ciberseguridad.
- CategoríaModelos de IA y LLM
- Modelo de preciosCódigo abierto
- ImplementaciónNube
- PlataformasWeb
Aspectos destacados de MiniMax-M3.1-Flash
Arquitectura de mezcla de expertos multimodal
Soporta entradas de texto, imagen y video
Ventana de contexto de hasta 1 millón de tokens
Atención dispersa en todo el modelo
Entrenamiento consciente de cuantización
Decodificación especulativa DSpark
Aproximadamente 428 mil millones de parámetros
Alto rendimiento en múltiples benchmarks
Primeros pasos con MiniMax-M3.1-Flash
Acceder a la página del modelo: Visita la página oficial de Hugging Face para MiniMax-M3.1-Flash
Autenticarse: Asegúrate de tener las credenciales necesarias para acceder al modelo
Configurar: Configura el modelo con tu marco de inferencia preferido
Enviar solicitudes: Introduce datos de texto, imagen o video para su procesamiento
Ajustar: Modifica configuraciones como temperatura y top_p para obtener resultados óptimos
Casos de uso de MiniMax-M3.1-Flash
- Asistencia en Codificación
- Ciberseguridad
- Flujos de Trabajo Agenticos
- Procesamiento Multimodal
- Eficiencia de Inferencia