Descripción
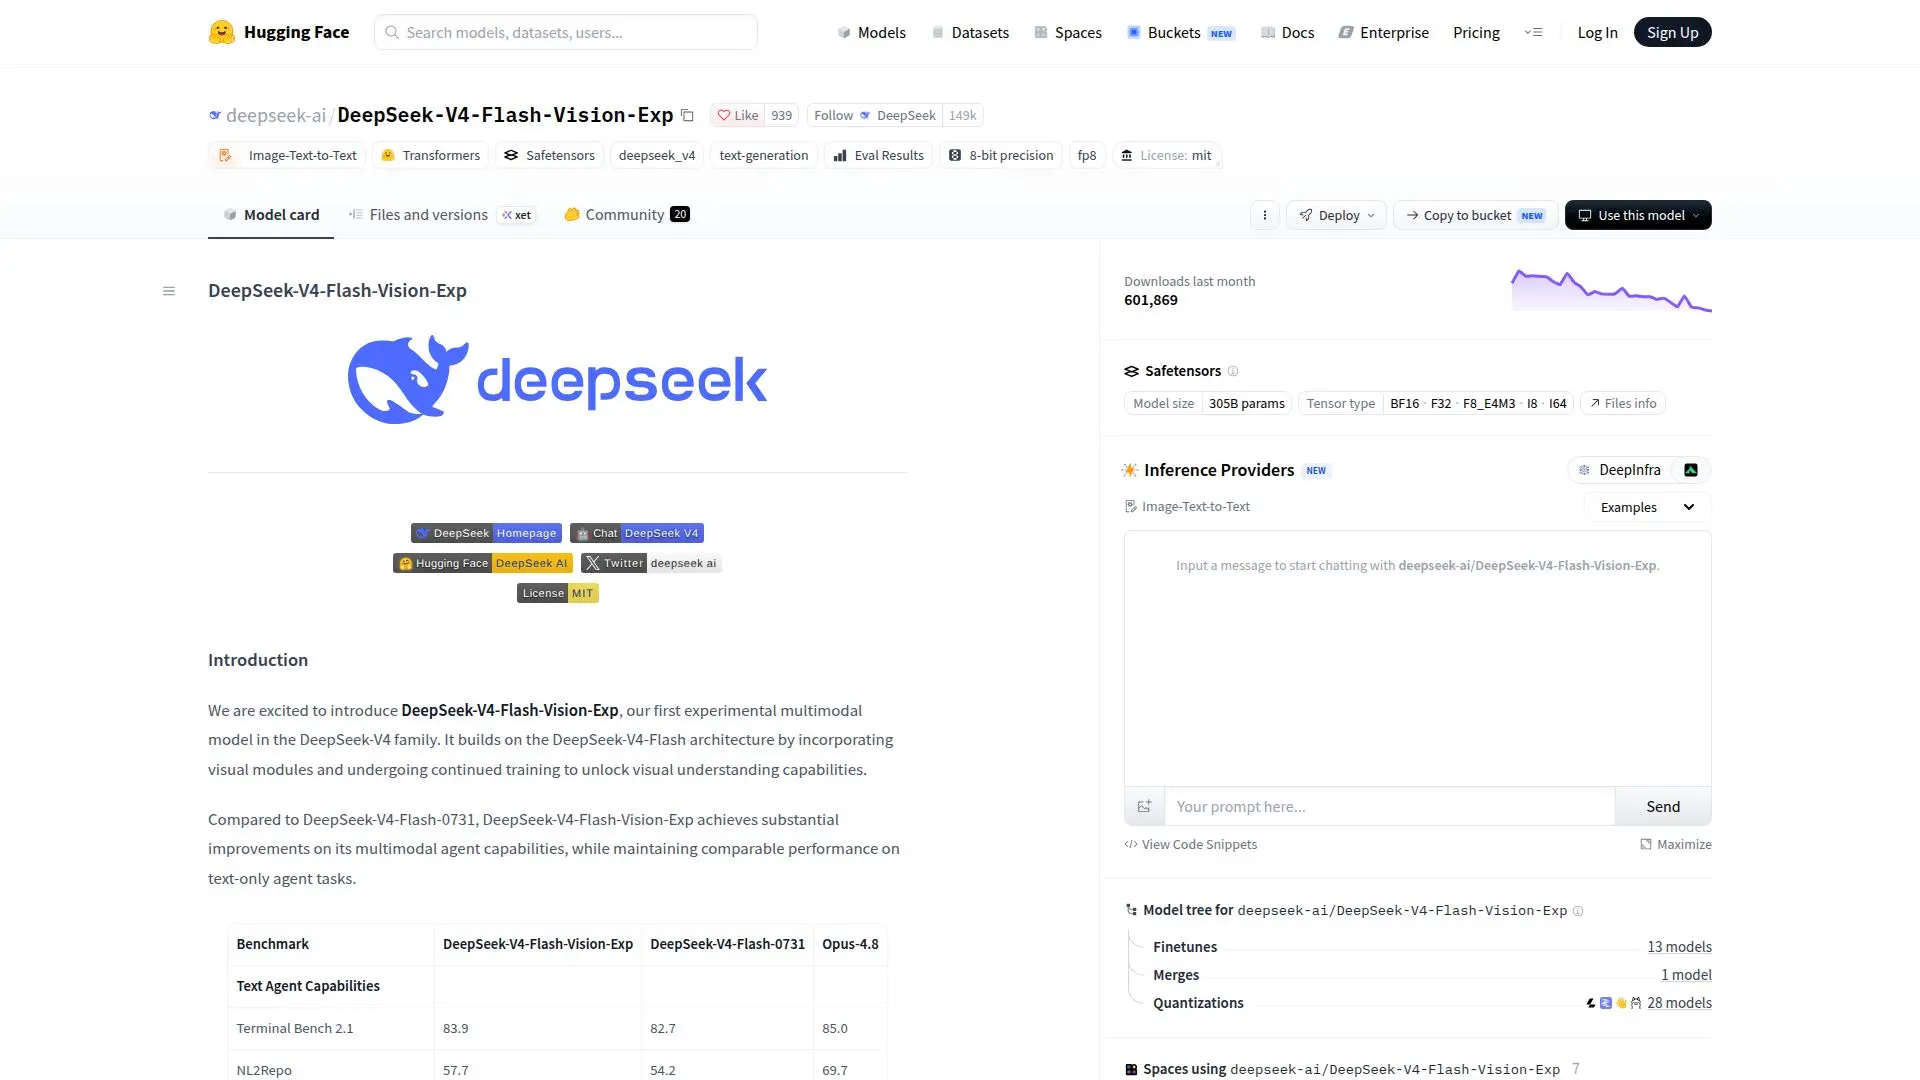
DeepSeek-V4-Flash-Vision-Exp es un modelo multimodal experimental innovador de la familia DeepSeek-V4. Mejora la arquitectura existente DeepSeek-V4-Flash al incorporar módulos visuales, que mejoran significativamente sus capacidades de comprensión visual. Este modelo ha sido sometido a un entrenamiento extenso para garantizar que ofrezca mejoras sustanciales en las capacidades de los agentes multimodales, mientras mantiene un rendimiento comparable en tareas de agentes solo de texto.
Leer más
El modelo ha sido evaluado en comparación con varios otros modelos, mostrando su rendimiento superior en diversas tareas. Por ejemplo, en el Terminal Bench 2.1, obtuvo una puntuación de 83.9, superando al DeepSeek-V4-Flash-0731. En el benchmark NL2Repo, logró una puntuación de 57.7, nuevamente superando a su predecesor. Estos benchmarks destacan las capacidades mejoradas del modelo para manejar tareas multimodales complejas.
DeepSeek-V4-Flash-Vision-Exp está diseñado para ser accesible y fácil de usar. El repositorio incluye el tokenizador, la referencia de codificación de prompts y una implementación mínima de inferencia en PyTorch. Esta configuración permite a los usuarios utilizar de manera eficiente el codificador visual del modelo, el alineador, la atención DFlash, MoE, Conexiones Hiper y la ruta hacia adelante DSpark.
El modelo admite tanto bloques de contenido JSON al estilo de OpenAI como notación TXT compacta para la codificación de prompts, asegurando flexibilidad en su uso. Además, se puede ejecutar con vLLM y SGLang, proporcionando a los usuarios diversas opciones para el despliegue según sus configuraciones de hardware.
Con licencia bajo la Licencia MIT, DeepSeek-V4-Flash-Vision-Exp es parte de una iniciativa de código abierto destinada a avanzar y democratizar la inteligencia artificial a través de la ciencia abierta.
- CategoríaModelos de IA y LLM
- Modelo de preciosCódigo abierto
- ImplementaciónNube
- PlataformasWeb
Aspectos destacados de DeepSeek-V4-Flash-Vision-Exp
Capacidades multimodales
Comprensión visual
Rendimiento mejorado del agente de texto
Código abierto
Soporte de inferencia en PyTorch
Rendimiento en benchmarks
Flexibilidad en la codificación de prompts
Licencia MIT
Primeros pasos con DeepSeek-V4-Flash-Vision-Exp
Acceder a la página del modelo: Visita el repositorio de Hugging Face
Autenticarse: Asegúrate de tener acceso a los recursos necesarios
Configurar: Configura el modelo utilizando las instrucciones proporcionadas
Enviar prompts: Utiliza las capacidades del modelo para tus tareas
Ajustar: Modifica los parámetros del modelo según sea necesario
Casos de uso de DeepSeek-V4-Flash-Vision-Exp
- Comprensión Visual
- Tareas Multimodales
- Investigación en IA
- Pruebas de Benchmark
- Despliegue de Modelos