

Para la mayoría de los desarrolladores en 2026, la elección real está entre Claude Code y Codex, y en el benchmark público más duro para trabajo en terminal están empatados dentro del margen de error. Gemini CLI, el tercer nombre de todas las comparativas del año pasado, ya no está disponible para usuarios gratuitos ni de consumo: Google lo sustituyó a principios de este año por una herramienta de código cerrado llamada Antigravity CLI.
Eso cambia la decisión. Los dos primeros se turnan el liderazgo versión tras versión, así que la calidad del modelo es un criterio de desempate débil. Lo que los separa ahora es lo que el agente puede hacer en tu máquina sin preguntarte, cómo pagas por él y si un responsable de equipo puede controlar ambas cosas. Codex trae los valores por defecto más seguros y un cliente de código abierto. Claude Code tiene el kit más completo para los equipos que quieren automatizarlo con scripts y ampliarlo. La CLI de GitHub Copilot encaja en organizaciones que ya viven en GitHub y quieren modelos de varios laboratorios en una sola factura, y OpenCode es la opción si buscas código abierto y el modelo que quieras.
Los precios y las funciones que verás abajo salen de la documentación y las páginas de precios de cada proveedor, y cada cifra de benchmark indica su fuente.
Qué ha cambiado este año en los agentes de terminal
Cuatro cambios importan si miraste esta categoría por última vez hace un año.
Google ha retirado Gemini CLI para la mayoría de la gente. En Google I/O anunció que Gemini CLI dejaría de atender solicitudes de usuarios gratuitos y de suscriptores de Google AI Pro y Ultra, y que sus extensiones para IDE se desactivarían ese mismo día (Google Developers Blog). El sustituto, Antigravity CLI, está escrito en Go y funciona sobre la misma base de agente que la nueva aplicación de escritorio Antigravity 2.0 de Google. Las organizaciones con Gemini Code Assist Standard o Enterprise, y los desarrolladores que pagan mediante claves de la API de Gemini, conservan Gemini CLI.
GitHub lanzó Copilot CLI en disponibilidad general y luego pasó todos los planes de Copilot a créditos de IA por uso, de modo que las sesiones en terminal ahora consumen una asignación medida de $0,01 por crédito (GitHub Docs).
Anthropic cambió lo que ocurre al abrir una sesión. Desde Claude Code v2.1.283, las sesiones interactivas en terminal arrancan en modo auto, en el que un segundo modelo, al que Anthropic llama clasificador, revisa las acciones en lugar de pedirte confirmación para cada una (documentación de Claude Code).
OpenAI renovó esta semana la CLI de Codex con control por voz, una vista /agents para seguir tareas en paralelo y entornos en la nube reutilizables que un equipo puede compartir con ajustes y permisos aprobados (TechCrunch). Mientras tanto, Aider, la opción veterana de código abierto, no ha publicado nada desde una versión de parche menor a principios de este año, y su última versión con novedades es del año pasado (PyPI).
El bucle que ejecuta todo agente de terminal
Quita el branding y todas estas herramientas hacen el mismo trabajo. Describes una tarea en lenguaje natural. El agente lee los archivos relevantes, esboza un plan, edita tantos archivos como necesite, ejecuta tu build y tus tests, y repite el ciclo ante los fallos hasta que puede enseñarte un diff.
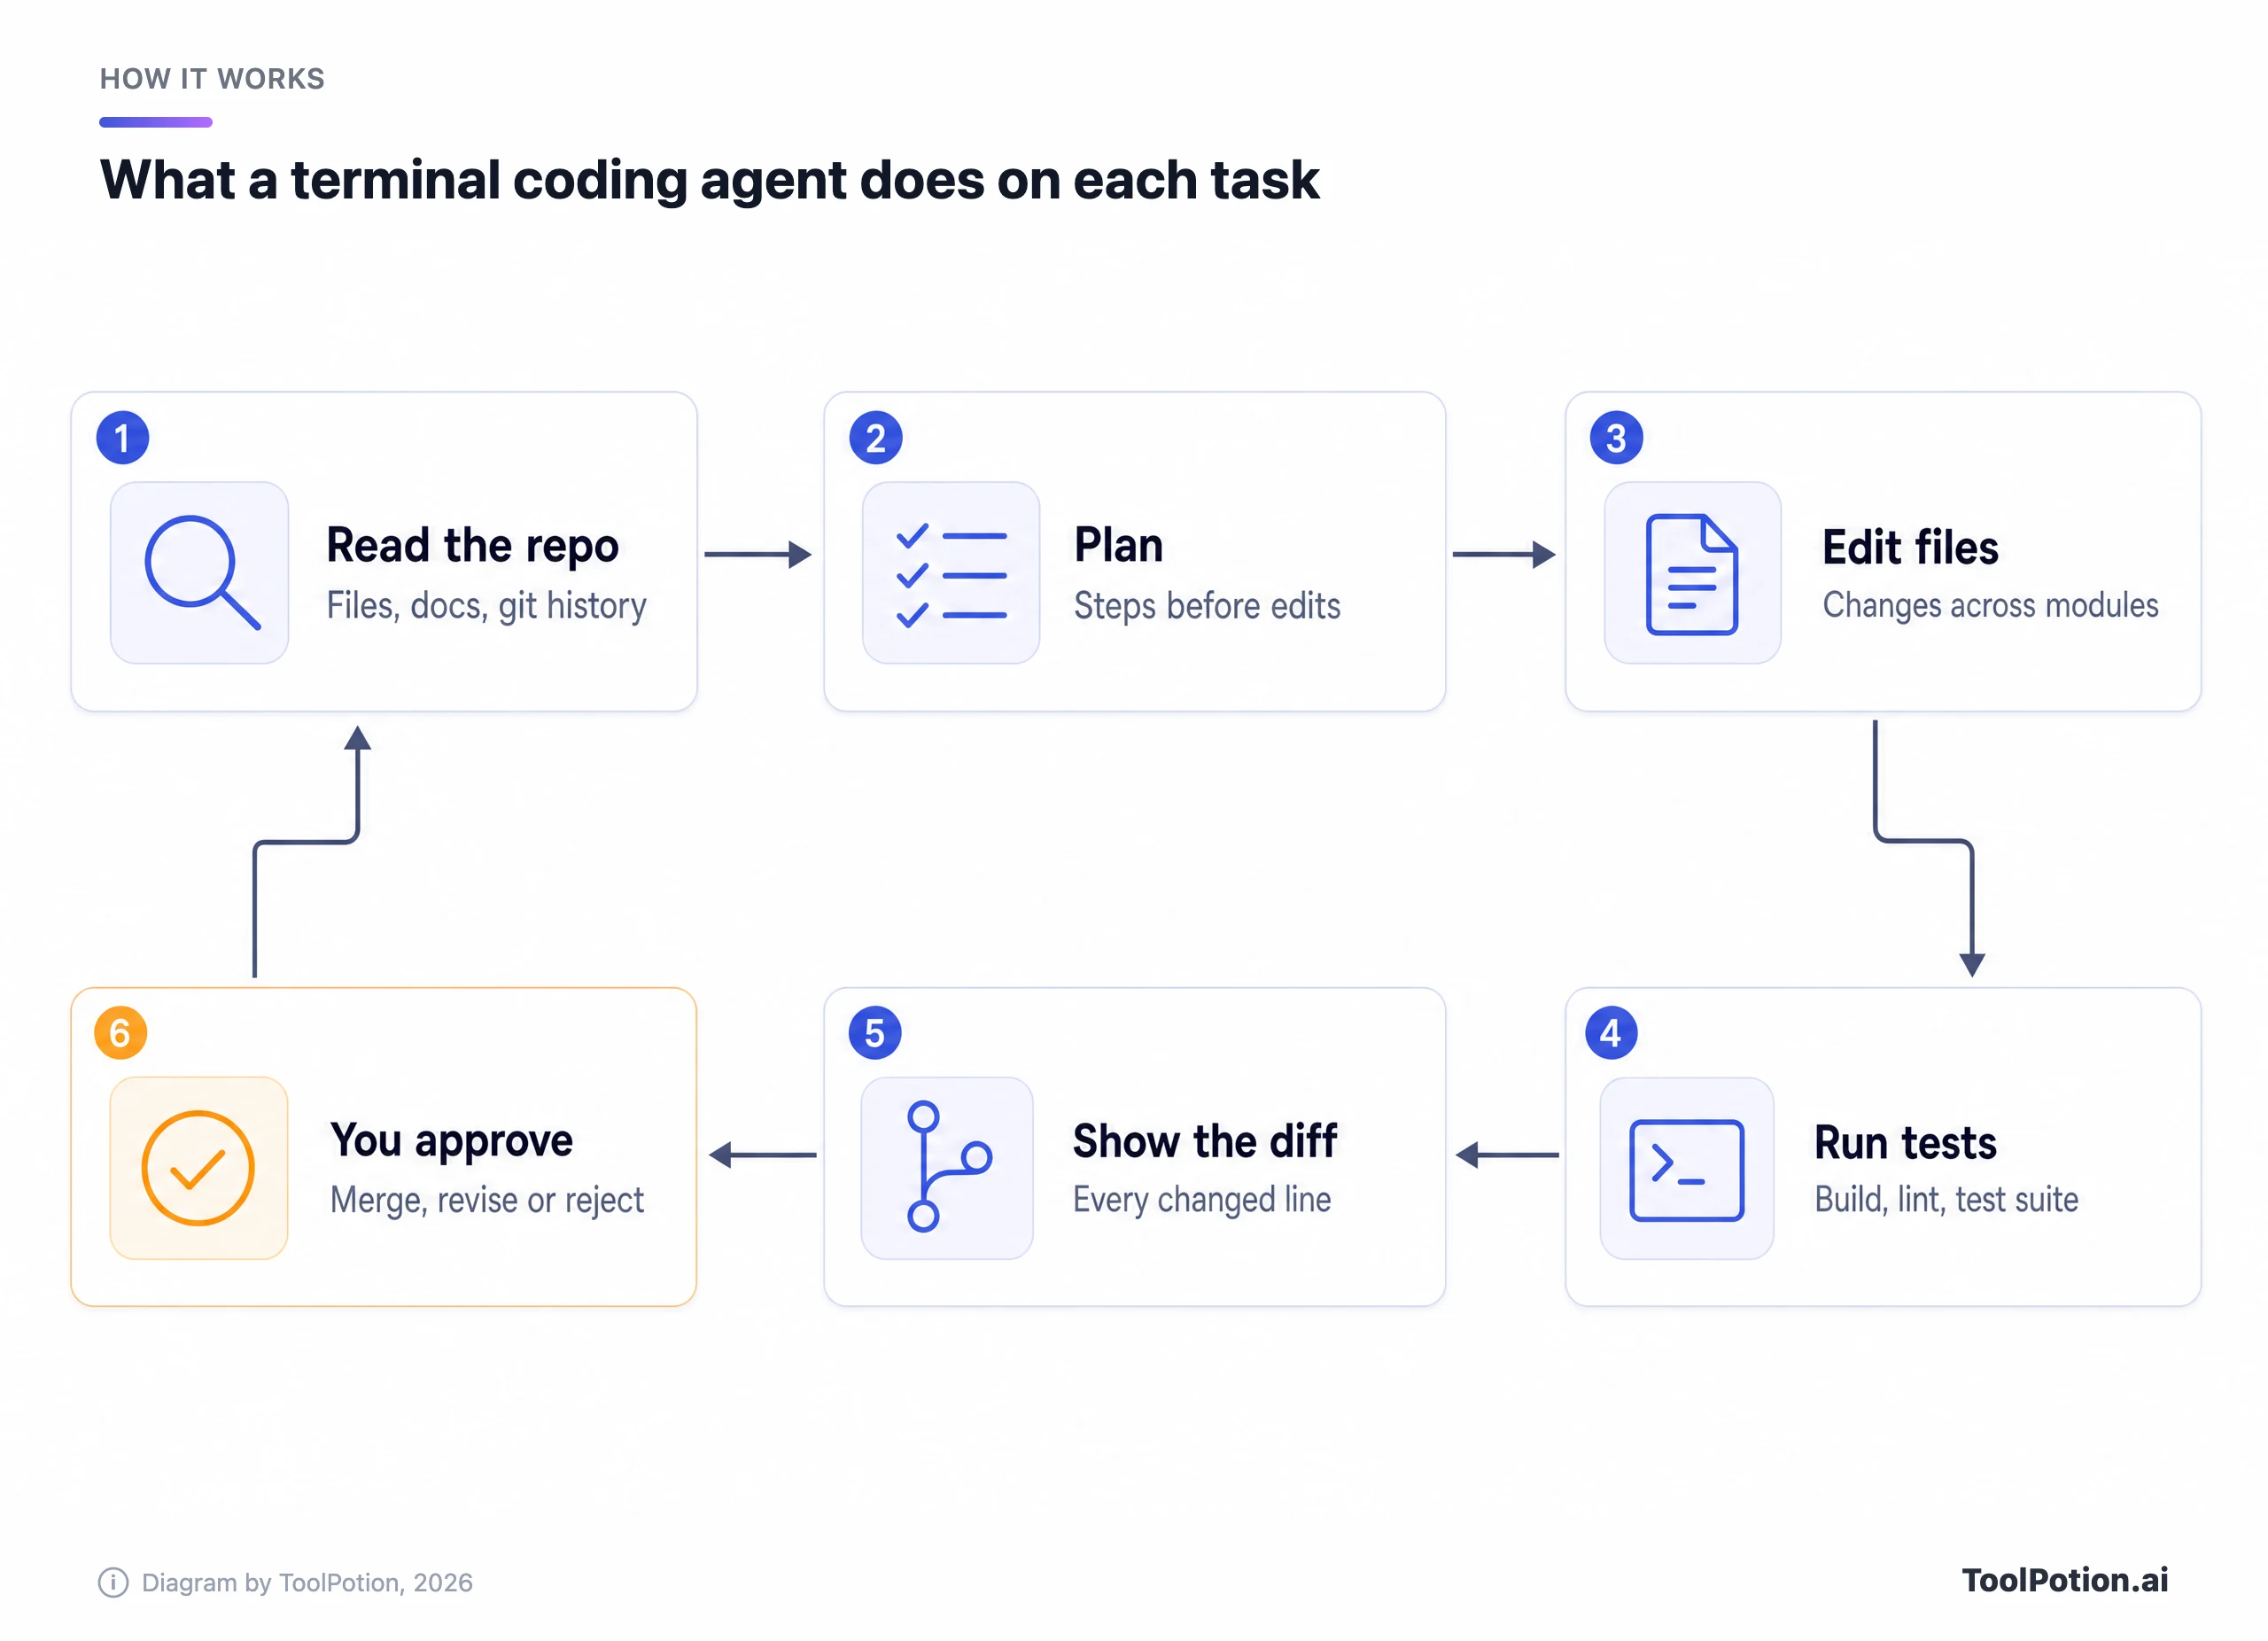
El paso destacado es el que conviene tener en cuenta al diseñar el flujo, porque la aprobación es donde viven tu criterio y tu política de seguridad. Las herramientas se diferencian en tres puntos de ese bucle: qué modelos lo mueven, qué puede hacer el agente antes de que apruebes y dónde se ejecuta (tu portátil, un sandbox del sistema operativo o la nube del proveedor). Los modelos se llevan los titulares, pero los otros dos puntos deciden si todo un equipo puede usarlo.
Claude Code vs Codex, cara a cara
Estos dos son la opción por defecto por buenos motivos. Ambos funcionan en macOS, Linux y Windows, ambos leen un archivo AGENTS.md, ambos admiten servidores MCP, skills, hooks, plugins y subagentes, ambos pueden enviar una tarea a la nube y ambos tienen un plan de $20 al mes. Las diferencias están en los detalles.
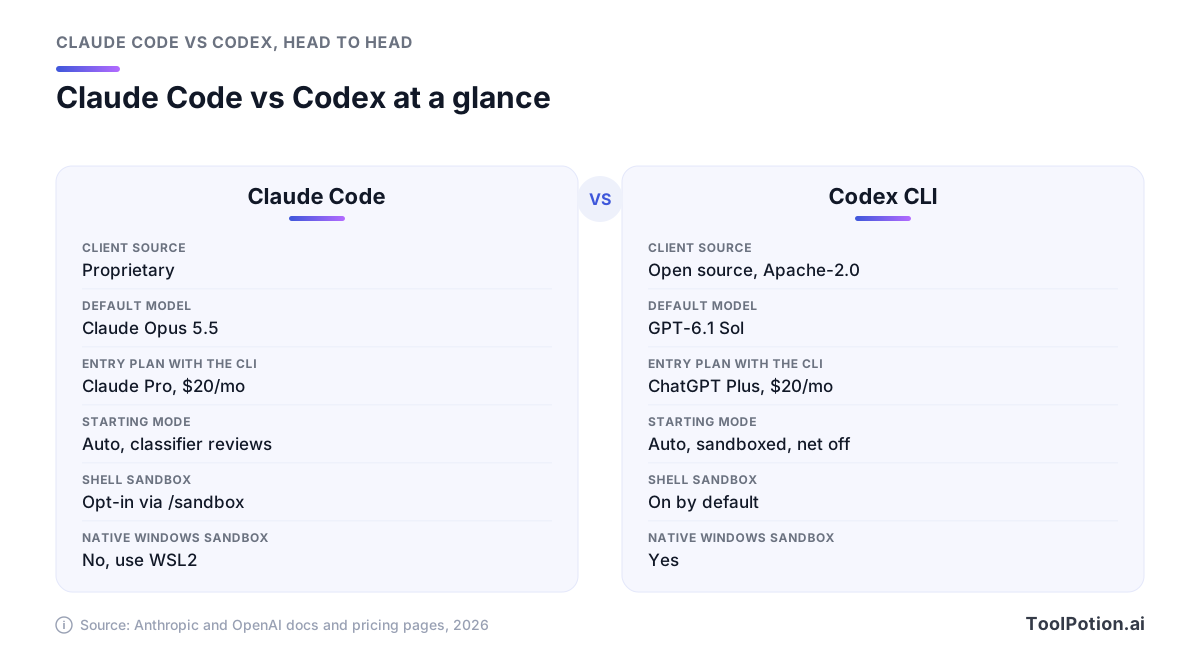
Empecemos por los modelos. Claude Code usa solo modelos de Anthropic y tiene Claude Opus 5.5 por defecto en todos los planes, con Sonnet 5.5 y Haiku como opciones más baratas y Fable 5.1, el modelo más potente de Claude Code, como opción explícita que algunos planes cobran con créditos de uso extra. Codex usa por defecto GPT-6.1 Sol, que según OpenAI casi iguala a su buque insignia GPT-6 Astra en programación agéntica a una quinta parte del precio de la API. El cliente de Codex es de código abierto bajo Apache-2.0 (el repositorio openai/codex está escrito en Rust), mientras que la licencia de Claude Code es de todos los derechos reservados.
Los valores de seguridad por defecto marcan la diferencia más clara. Dentro de un repositorio git, Codex arranca en un preajuste al que llama Auto: puede leer, editar y ejecutar comandos en el espacio de trabajo, pero un sandbox del sistema operativo (Seatbelt en macOS, bubblewrap más seccomp en Linux, un sandbox nativo en Windows) bloquea el acceso a la red y a todo lo que esté fuera del proyecto hasta que lo apruebes (documentación de OpenAI). Fuera de un repositorio git pasa a solo lectura.
Claude Code va por el otro camino. Su sandbox de shell viene desactivado por defecto, y su primera línea de defensa es el clasificador del modo auto más las reglas de denegación, que bloquean en todos los modos. Cuando activas el sandbox, solo envuelve los comandos de shell, y esos comandos aún pueden leer buena parte de la máquina, incluidos ~/.ssh y ~/.aws/credentials, hasta que añades reglas de denegación (documentación de Claude Code). En Windows nativo no hay ningún sandbox, y Anthropic te remite a WSL2.
Claude Code gana en profundidad. Los plugins agrupan skills, subagentes, hooks y servidores MCP, y se instalan desde marketplaces que los administradores pueden permitir o bloquear. Las rutinas ejecutan tareas programadas en la nube de Anthropic, las integraciones con GitHub Actions y GitLab CI/CD se encargan de la revisión y el triaje, y el Agent SDK te permite construir agentes sobre las mismas herramientas. Codex cubre casi lo mismo con menos ceremonia (hooks, skills, plugins, codex exec para scripts, una GitHub Action), y su revisión automática de código cubre los pull requests de GitHub y los merge requests de GitLab.
¿Y dónde flaquea cada uno? Claude Code te ata a un solo laboratorio y, hasta que cambias un ajuste, se apoya en el criterio de un modelo en lugar de en una barrera del sistema operativo, algo que algunos equipos de seguridad no aceptarán. Codex también te ata a un solo laboratorio, y el modelo insignia está muy racionado en el plan de $20: OpenAI estima de 5 a 45 mensajes locales cada cinco horas con GPT-6 Astra en Plus, frente a 15 a 160 con GPT-6.1 Sol (precios de OpenAI).
Antigravity CLI sustituyó a Gemini CLI para la mayoría
Si hoy buscas Gemini CLI, aún encontrarás el repositorio Apache-2.0, que sigue publicando versiones (la v0.62.0 salió esta semana). Eso sí, su documentación lleva ahora un aviso que informa a los usuarios gratuitos y de Google One de que Gemini CLI fue reemplazado. Quienes pueden seguir usándolo son las organizaciones con licencias de Gemini Code Assist Standard o Enterprise y los desarrolladores con claves de API de pago de Gemini o de Gemini Enterprise Agent Platform.
La CLI que lo sustituyó dentro de Google Antigravity es un producto de otro tipo. Es de código cerrado, y Tech Times informa de que su repositorio público no contiene código fuente alguno, un punto delicado para un proyecto que, según la propia cuenta de Google, fusionó 6.000 pull requests. Google admite que todavía no hay paridad 1:1 de funciones, aunque skills, hooks, subagentes y extensiones (ahora llamadas plugins) sí pasaron a la nueva herramienta.
También hay ventajas reales. El menú de modelos de Antigravity incluye Gemini 3.8 Flash y Gemini 3.1 Pro junto a Claude Sonnet 5.5, Claude Opus 5.5 y el modelo de pesos abiertos GPT-OSS-120b, así que una sola suscripción de Google da acceso a modelos de dos laboratorios, aunque la disponibilidad varía según el plan. Además, su preajuste por defecto en macOS y Linux es, sobre el papel, al menos tan estricto como el de Codex: los comandos de terminal se ejecutan en un sandbox sin red, el acceso a archivos se limita al espacio de trabajo y a las carpetas temporales, ~/.ssh y los archivos .env están bloqueados, y las acciones de MCP y web piden confirmación (documentación de Antigravity). En Windows, ese sandbox viene desactivado por defecto.
La pega es la cuota. El plan Individual gratuito muestra límites semanales básicos, muy lejos de las 1.000 solicitudes gratuitas al día que Gemini CLI daba a las cuentas personales. La capacidad de pago va en los planes Google AI Pro y Ultra, y Google reorganizó esos niveles cuando lanzó Antigravity, así que consulta los límites actuales en la página de planes de Google antes de comprometerte. Elige Antigravity CLI si vives en Google Cloud, quieres modelos de Claude sin un contrato aparte con Anthropic o quieres valores de sandbox estrictos de serie. Descártalo si para ti importa un cliente de código abierto.
Copilot CLI, Cursor, OpenCode y el resto
Copilot CLI es la opción más infravalorada para empresas. Ejecuta modelos de Anthropic, OpenAI y Google con una sola factura y trae el kit moderno: modo plan, modo autopilot, agentes integrados para explorar y revisar código, MCP, plugins, skills, hooks y un prefijo & que entrega una tarea al agente de programación en la nube de GitHub (GitHub Changelog). Lo incluyen todos los planes: Free, Pro a $10 al mes, Pro+ a $39 y Max a $100, además de Business a $19 y Enterprise a $39 por puesto (GitHub Docs).
Su punto débil son los permisos. Copilot te pide confiar en una carpeta y luego aprueba herramientas una a una o para toda la sesión, y la propia documentación de GitHub advierte de que aprobar rm durante una sesión le permite borrar cualquier archivo de ese árbol de directorios sin preguntar. El sandbox local es opcional mediante /sandbox enable, y un flag --yolo desactiva todas las comprobaciones.
Así se comparan los cuatro nombres más grandes en atributos que puedes comprobar en su documentación y sus licencias, no en su marketing.
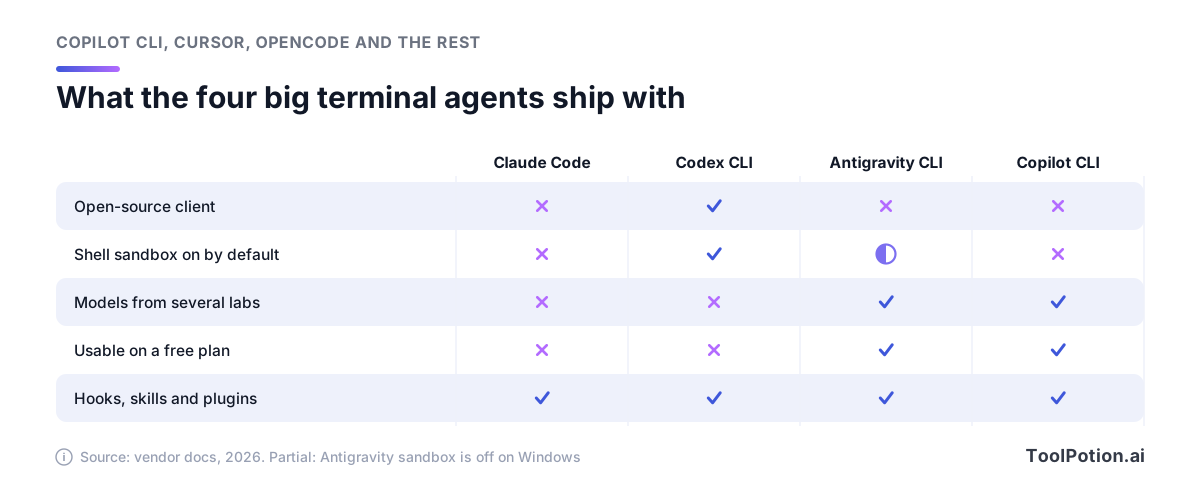
Solo Codex combina un cliente de código abierto con un sandbox activado por defecto en todas partes. Antigravity y Copilot son los dos que mezclan modelos de distintos laboratorios sin montajes extra. La extensibilidad ha convergido, ya que los cuatro admiten hooks, skills y plugins.
Cursor lleva su agente del editor a la terminal con modos agent, plan y ask, un modo print para scripts y CI, y el mismo traspaso con & a un agente en la nube. Es el complemento obvio si tu equipo ya paga Cursor (Individual desde $20 al mes, Teams a $40 por usuario) y una venta difícil si no.
OpenCode es la gran opción de código abierto: licencia MIT, más de 211.000 estrellas en GitHub y conexión con más de 75 proveedores de modelos, incluidos modelos locales. Puedes iniciar sesión con una cuenta de GitHub Copilot o de ChatGPT Plus o Pro en lugar de pagar dos veces. Eso sí, ojo con sus valores por defecto. OpenCode deja que el agente edite archivos y ejecute comandos de shell sin preguntar a menos que escribas reglas, no tiene sandbox del sistema operativo, y sus protecciones integradas solo cubren los archivos .env, las rutas fuera del proyecto y un agente atascado repitiéndose (documentación de OpenCode).
Otras tres merecen una línea cada una. Amp traslada los costes de los modelos a precios del proveedor sin margen para particulares, mezcla GPT-5.6 y Claude Fable 5.1 por debajo, y tiene un plan gratuito y otro de $20. Warp es ahora una terminal agéntica con licencia AGPL y agente propio, con precios que van de gratis a $20 Build y $200 Max, y dice que funciona con cualquier agente de programación compatible con MCP. Aider sigue teniendo la mejor historia con git: confirma cada cambio con un mensaje que puedes revisar con diff y deshacer, pero su ritmo de versiones se ha estancado, así que comprueba que admite el modelo que quieres antes de decidirte. Para ver el panorama completo, nuestro ranking de asistentes de programación con IA y nuestro ranking de agentes de IA siguen las posiciones a medida que cambian.
Los benchmarks dejan a Claude Code y Codex en empate técnico
La vara de medir pública más útil para esta categoría es Terminal-Bench, alojado por Stanford, Harbor y el Laude Institute, que puntúa pares de agente y modelo en tareas difíciles dentro de una terminal real. En su clasificación actual 4.0, Codex con GPT-6 Astra con esfuerzo de razonamiento máximo lidera con un 58,2 %, y Claude Code con Fable 5.1 con esfuerzo máximo queda en un 57,9 % (Terminal-Bench). Cada entrada ejecuta 330 pruebas con un intervalo de confianza de aproximadamente tres puntos arriba o abajo, así que es un empate.
La noticia mayor es el dial de esfuerzo. Compara cada par en su ajuste de razonamiento más bajo y más alto.
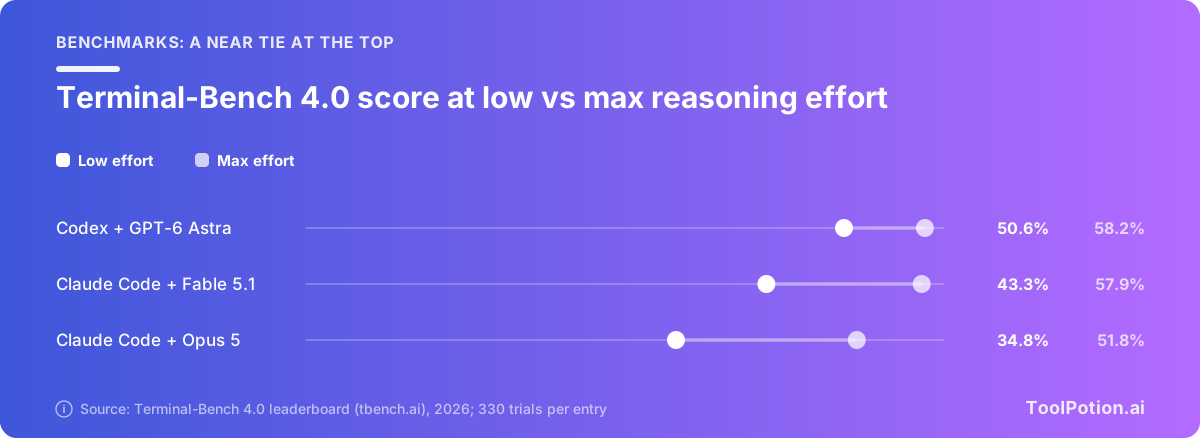
Pasar de esfuerzo máximo a bajo le cuesta a Codex con Astra menos de 8 puntos y a Claude Code con Fable 5.1 casi 15. Claude Code con el Opus 5 anterior cae 17. El ajuste que dejas por defecto puede importar tanto como la marca de la caja.
El coste cuenta una segunda historia. La clasificación registra lo que gastó cada ejecución: $3.267 para Codex con Astra a esfuerzo máximo frente a $6.244 para Claude Code con Fable 5.1, es decir, unos $9,90 frente a $18,90 por tarea para la misma puntuación. Son costes a tarifa de API en tareas largas y difíciles, no lo que paga un suscriptor. Ningún agente de Google aparece en la clasificación, así que la mejor entrada que usa un modelo Gemini es un agente de terceros con Gemini 3.8 Flash, con un 19,1 %. Las afirmaciones de los proveedores, como la de Anthropic de que Sonnet 5.5 supera a Opus 5.5 en programación agéntica, provienen de las pruebas de los propios proveedores.
Modos de permisos, de solo lectura a automático total
Todas las herramientas ofrecen ya la misma escalera de autonomía con nombres distintos. El peldaño que elijas decide cada cuánto te interrumpen y cuánto daño puede hacer una mala instrucción (o una inyección de prompt escondida en un README).
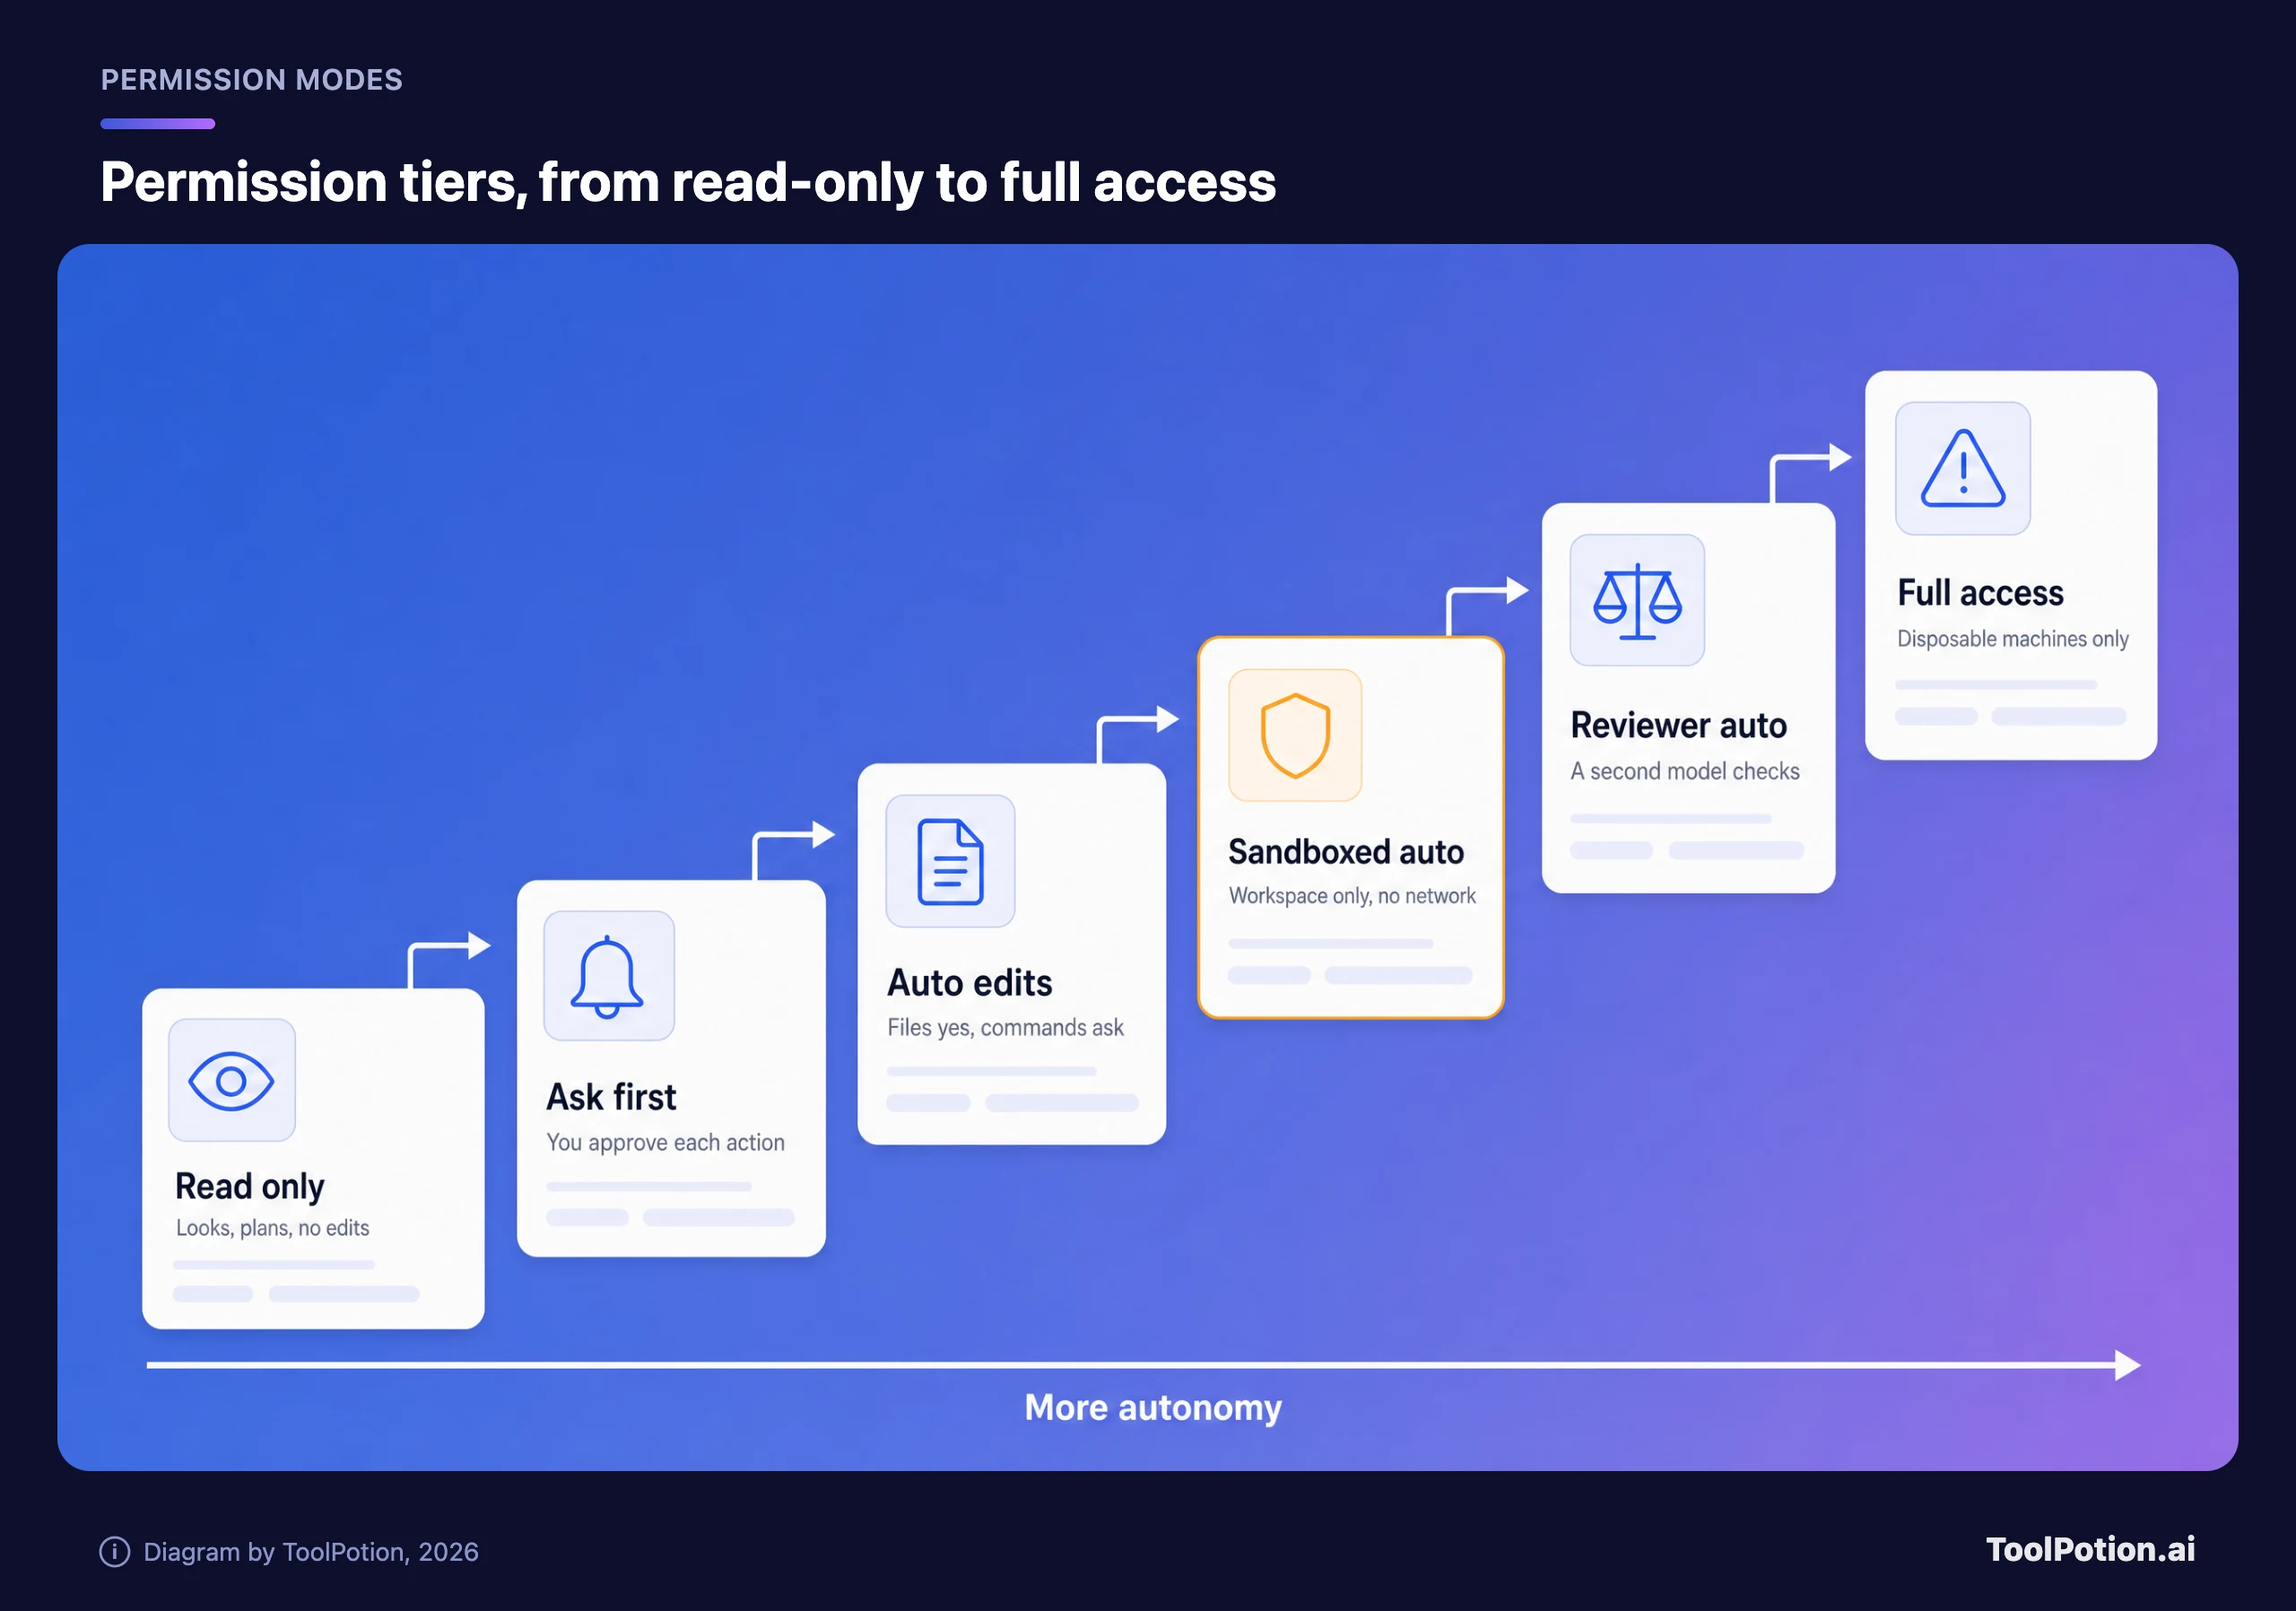
El auto en sandbox es el valor por defecto diario adecuado. El agente edita y ejecuta comandos libremente dentro del proyecto, sin red y sin acceso a tu directorio personal. El auto con revisor reduce aún más las confirmaciones, pero confía en el juicio de un modelo. El acceso total pertenece a contenedores y máquinas virtuales desechables, que es también lo que dice la documentación de Anthropic sobre bypassPermissions. Así se llama cada peldaño en las cuatro herramientas principales.
| Nivel | Claude Code | Codex CLI | Antigravity CLI | Copilot CLI |
|---|---|---|---|---|
| Solo lectura | plan | read-only | Modo plan | Modo plan |
| Preguntar primero | default (Manual) | Aprobaciones granulares | Request Review | Confirmación por herramienta |
| Ediciones automáticas | acceptEdits | Ninguno | Accept-Edits | Aprobar herramienta para la sesión |
| Auto en sandbox | Auto-allow de /sandbox | Auto (por defecto en repos git) | Preajuste por defecto | /sandbox enable |
| Auto con revisor | auto (por defecto) | Auto-review (opcional) | Ninguno | Ninguno |
| Acceso total | bypassPermissions | danger-full-access | Turbo | --yolo |
Destacan dos valores por defecto. Codex y Antigravity te colocan dentro de un sandbox, mientras que Claude Code y Copilot te colocan en modos que dependen de confirmaciones o de la revisión de un modelo. Si usas Claude Code, activar el sandbox es el cambio de configuración más útil que puedes hacer.
Planes vs claves de API: cuánto pagarás
Cada proveedor ofrece dos vías de entrada. Un plan mensual fijo limita tu factura, pero te mide con límites de cinco horas y semanales que los proveedores describen como multiplicadores, no como cantidades de tokens. Una clave de API cobra cada token a precio de lista, sin techo.
| Agente | Plan de entrada | Niveles superiores | Equipos |
|---|---|---|---|
| Claude Code | Claude Pro, $20/mes ($17 con facturación anual) | Max 5x $100, Max 20x $200 | Puestos Team $25 o $125/mes; Enterprise $20 por puesto más uso a tarifa de API |
| Codex | ChatGPT Plus, $20/mes (la CLI no está en Free ni en Go) | Pro a $100, $200 o $500 | Business $20/usuario (anual) |
| Copilot CLI | Pro $10/mes (Free incluye una asignación pequeña) | Pro+ $39, Max $100 | Business $19, Enterprise $39 por puesto |
| Antigravity CLI | Plan Individual gratuito | Google AI Pro y Ultra | Business desde $30/puesto vía Google Cloud |
| Cursor CLI | Individual $20/mes | Niveles individuales superiores | Teams $40/usuario |
Los precios proceden de la página de precios de cada proveedor, incluida la de Anthropic. Si las cuentas de los planes se te atragantan, nuestra guía de modelos de precios de herramientas de IA explica créditos, puestos y tokens.
La vía de la API importa sobre todo para usuarios intensivos y CI. Anthropic cobra $4 por millón de tokens de entrada y $20 por millón de salida en Opus 5.5, y $2 y $10 en Sonnet 5.5. OpenAI cobra $2 y $10 por GPT-6.1 Sol y $10 y $50 por GPT-6 Astra (precios de OpenAI). El caché mueve más la factura que las tarifas de cabecera, porque los bucles de agente reenvían constantemente el mismo contexto. En la ejecución de Terminal-Bench de arriba, alrededor del 96 % de los tokens de entrada de Codex fueron lecturas de caché, que OpenAI cobra a una décima parte de la tarifa de entrada de Astra.
Introduce abajo tus propios números. Los valores por defecto copian la mezcla de tokens de una de esas tareas del benchmark (unos $10 por tarea con Astra), y las ejecuciones del benchmark son largas y difíciles, así que sustitúyelos por cifras de tu propio panel de uso antes de presupuestar con ellos.
Con los valores por defecto, un desarrollador que ejecute 40 de esas tareas al mes con Opus 5.5 gastaría unos $126 con una clave de API, así que Claude Pro y Max 5x salen más baratos si sus límites aguantan. Cambia el modelo a GPT-6 Astra y la misma carga cuesta unos $401. Esa diferencia es la razón por la que los usuarios de Codex deberían reservar el modelo insignia para los problemas que lo necesitan y dejar que GPT-6.1 Sol haga el resto.
Cómo elegir uno y desplegarlo con seguridad
Parte de dónde viven ya tu código y tus contratos, y deja que los valores de seguridad por defecto desempaten.
- Si tu equipo ya paga ChatGPT, o quieres un cliente de código abierto con sandbox activado por defecto, empieza por Codex.
- Si quieres la mayor personalización y estás a gusto con los modelos de Claude, elige Claude Code y activa su sandbox antes que nada.
- Si tu organización funciona sobre GitHub y quiere modelos de Claude, GPT y Gemini bajo un solo presupuesto con límites por usuario, Copilot CLI es el de menor fricción.
- Las empresas centradas en Google Cloud deberían probar Antigravity CLI.
- Elige OpenCode cuando necesites código abierto de punta a punta o modelos locales, y asume que las barreras de protección las escribirás tú.
¿Sigues dudando? Pondera abajo lo que más te importa. Las puntuaciones son nuestra lectura editorial de la documentación y los precios de cada proveedor, no resultados de pruebas.
Si das el máximo peso a la seguridad, lidera Codex y Copilot CLI queda segundo. Si subes al primer puesto la administración de equipos y los límites de gasto, Copilot se adelanta, y si pones al máximo la elección de modelo y el código abierto, OpenCode pasa a primer lugar. Claude Code sube siempre que la extensibilidad pese más que los valores seguros por defecto.
Un despliegue seguro en equipo
- Haz un piloto con un solo agente, con unos pocos desarrolladores y en un solo repositorio, para comparar resultados y no herramientas.
- Fija el permiso por defecto de forma centralizada. En Claude Code eso significa ajustes gestionados con el sandbox activado y reglas de denegación para pushes y despliegues, y los administradores pueden desactivar el modo auto en toda la organización. En Codex, mantén workspace-write con la red desactivada y reserva danger-full-access para ejecuciones de CI desechables.
- Mantén los secretos fuera de alcance. No ejecutes agentes en shells que tengan credenciales de producción, deniega la lectura de ~/.ssh, de los archivos de credenciales de la nube y de .env, y recuerda que los hooks y los servidores MCP locales de Claude Code se ejecutan fuera de su sandbox con todos tus permisos.
- Revisa los diffs del agente como el pull request de alguien que acaba de incorporarse. Los agentes pueden abrir ramas y PRs, pero quien hace el merge es una persona. Un revisor automático como Claude Code Security Review o la revisión de código de Codex es una segunda comprobación, nunca un sustituto.
- Limita el gasto antes de escalar. Copilot admite presupuestos por usuario y por centro de costes, y su uso adicional viene activado por defecto, así que ponle un límite o desactívalo. El plan Enterprise de Anthropic cobra el uso a tarifa de API además del puesto, y los planes de empresa de Antigravity ofrecen límites de gasto tanto para el uso de la API como el de la suscripción.
- Examina los plugins y los servidores MCP como si fueran dependencias. La documentación de Anthropic dice que un plugin que instalas ejecuta código con tus privilegios de usuario, así que permite solo marketplaces concretos en lugar de dejar que cada uno añada los suyos.
- Dale a CI una lista de permitidos exacta. El modo dontAsk de Claude Code con herramientas con nombre, o Codex en un sandbox de solo lectura o workspace-write, mantiene predecibles las ejecuciones desatendidas.
Los equipos que ya ejecutan agentes en otras áreas del negocio reconocerán buena parte de esto de nuestro artículo sobre agentes de IA en producción. Para una visión más amplia de las herramientas centradas en el editor, consulta nuestro resumen de asistentes de programación con IA.
Preguntas frecuentes
¿Sigue disponible Gemini CLI?
Sí, para organizaciones con Gemini Code Assist Standard o Enterprise y para desarrolladores que usan claves de pago de la API de Gemini. Los usuarios de Free, Google AI Pro y Ultra pasaron a Antigravity CLI. El código Apache-2.0 sigue en GitHub, así que cualquiera puede hacer un fork.
¿Puedo usar Claude Code con una suscripción de ChatGPT, o Codex con un plan de Claude?
No. Cada plan cubre el agente de su propio proveedor. Si quieres un único cliente para varios proveedores, OpenCode permite iniciar sesión con cuentas de ChatGPT Plus o Pro y de GitHub Copilot, mientras que Copilot CLI y Antigravity CLI agrupan modelos de varios laboratorios en una sola suscripción.
¿Qué agente de terminal es el más barato para un desarrollador individual?
Copilot Pro, a $10 al mes, es la forma de pago más barata de entrar. ChatGPT Go, a $8, no incluye la CLI de Codex, que empieza en Plus. Copilot Free y el plan gratuito de Antigravity no cuestan nada, pero vienen con asignaciones pequeñas. Para un uso más intensivo, compara Claude Pro y ChatGPT Plus, a $20, con tu factura de API prevista.
¿Necesito un sandbox si reviso todos los diffs?
Sí. La revisión del diff detecta código malo, pero ocurre cuando el agente ya ha ejecutado comandos. Un sandbox limita lo que esos comandos pueden tocar mientras se ejecutan, incluidas las llamadas de red que podrían enviar un secreto a donde no debe ir.
¿Es Terminal-Bench una forma fiable de elegir?
Es la mejor vara de medir pública para el trabajo en terminal, pero mide pares de agente y modelo con ajustes de esfuerzo fijos en tareas difíciles. Diferencias de unos pocos puntos caen dentro de los intervalos de confianza, así que trátalas como empates y haz un piloto breve en tus propios repositorios.