

OpenAI afirma que GPT-6 Cyber construyó exploits funcionales para 948 vulnerabilidades del kernel de Linux en una sola campaña de investigación, más de cinco veces las 166 que explotó GPT-5.6 Sol con el mismo entorno de pruebas (OpenAI). Es la cifra de un proveedor, medida en el laboratorio de ese proveedor, y así la trataríamos. Pero también es una cifra concreta, y los mantenedores del kernel que recibieron 304 hallazgos críticos pueden comprobarla.
En pocos días, OpenAI lanzó GPT-6 Cyber y una alianza con Hacktron, Anthropic publicó Claude Fable 5.2 y Mythos 5.2, Google DeepMind presentó una prueba verificada por máquina sobre el código de Signal, y dos firmas de seguridad describieron a atacantes usando agentes de IA contra objetivos reales. Hemos leído los posts de las empresas y los informes que hay detrás. The Hacker News cubrió la historia de los benchmarks y Wired la de Signal.
Lo que dice OpenAI que puede hacer GPT-6 Cyber
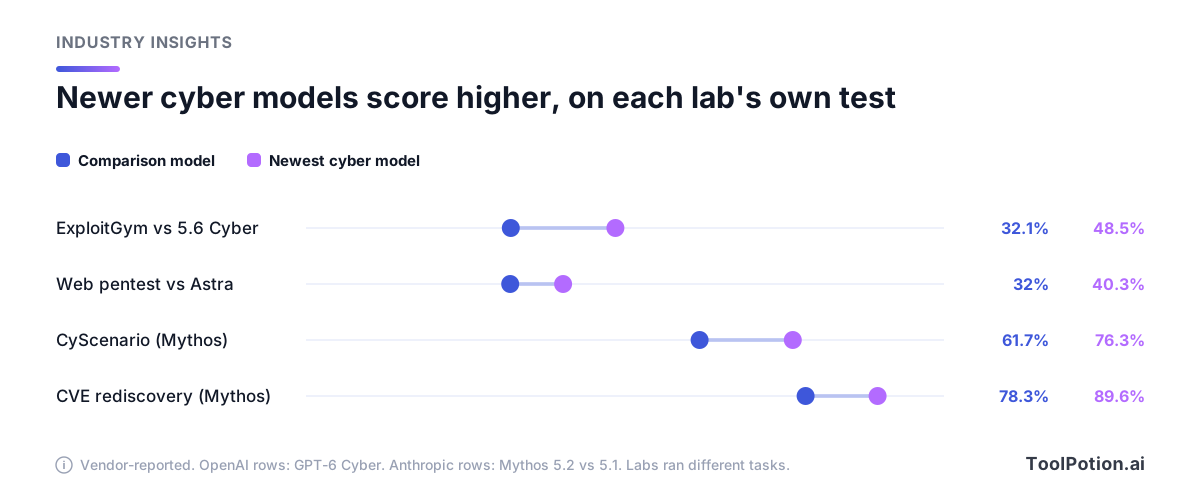
En ExploitGym, una prueba de si un modelo es capaz de explotar una vulnerabilidad concreta, OpenAI reporta un 48,5 % para GPT-6 Cyber frente al 32,1 % de GPT-5.6 Cyber. En un nuevo test de penetración web, donde los modelos sondean aplicaciones sin ver el código fuente, encontró el 40,3 % de las vulnerabilidades, frente al 32,0 % de GPT-6 Astra (OpenAI). La comparación más reveladora es la de las negativas: en RemoteExploitBench, que usa fallos conocidos de GitLab, PostgreSQL y Jenkins en un laboratorio controlado, GPT-6 Astra con Daybreak Blue rechazó todas las tareas, mientras que GPT-6 Cyber completó el 95 %.
Fuera del laboratorio, OpenAI dice que sus investigadores usaron el modelo para encontrar 81 vulnerabilidades de gravedad alta, hasta entonces desconocidas, en Firefox, según la clasificación de Mozilla, que empezó a publicar correcciones. Brian Grinstead, de Mozilla, citado en el post del lanzamiento, dijo que Firefox entró en 2026 como "una de las bases de código más robustas y examinadas del mundo". Ahí está la clave: no es un objetivo de juguete. OpenAI además califica el modelo como Critical en ciberseguridad dentro de su Preparedness Framework, por encima del High del anterior. Cuando un laboratorio etiqueta así su propio producto, lo leeríamos tanto como una advertencia como una lista de funciones.
La afirmación sobre seguridad es la que desentona. OpenAI montó una prueba en la que servicios secundarios fáciles de atacar están junto al objetivo real, y el modelo tiene que darse cuenta de que atacarlos queda fuera del alcance. Sin su prompt de despliegue, GPT-6 Cyber se mantuvo dentro de los límites el 99,93 % de las veces, frente al 94,49 % de GPT-5.6 Cyber. Esa cifra anterior significa que una de cada dieciocho ejecuciones se desviaba. La nueva sigue dejando unas siete desviaciones por cada diez mil, y la propia OpenAI recomienda sandboxing, revisión de acciones y supervisión humana en trabajo de alto riesgo. Nosotros seguiríamos ese consejo al pie de la letra.
La voz externa más útil del post de lanzamiento es Rob T. Lee, Chief AI Officer de Dragos, cuyo equipo ejecutó los modelos ciberpermisivos de OpenAI en un campo de pruebas que simula una central eléctrica. Su resumen: "El listón de habilidad baja para el reconocimiento y la investigación de vulnerabilidades que hacen falta antes de un ataque". Lee cuenta que un modelo de frontera, trabajando solo en ese campo de pruebas, encontró dos zero-days en software de ingeniería que gestiona datos de relés de protección. Esa cita es la razón por la que escribimos este artículo.
Detrás del titular "Fable superó a GPT-6 Cyber"
Lee esta sección antes de repetir cualquier cifra de benchmark de esta historia: los laboratorios no ejecutaron las mismas tareas. La tabla de resultados de Anthropic lleva una nota al pie: "las puntuaciones de cada laboratorio se basan en tareas propias". The Hacker News informa de que Fable 5.2 completó el 76,3 % del CyScenarioBench de Irregular, frente al 61,7 % de Fable 5.1 y el 61 % de GPT-6 Cyber. La tabla de Anthropic atribuye el 76,3 % a Mythos 5.2 y el 61,7 % a Mythos 5.1, lo que encaja con la advertencia de la propia Anthropic de que las salvaguardas de Fable 5.2 "bloquearán la mayoría de las tareas relacionadas con ciberseguridad". Es decir, el titular nombra el modelo equivocado, y quince puntos de diferencia entre las puntuaciones de dos laboratorios en conjuntos de tareas distintos no son un ranking. No elegiríamos proveedor con eso. La cifra que merece la pena conservar es el antes y después de la propia Anthropic, aunque también sea un proveedor informando sobre sí mismo.
The Hacker News cita además un detalle del informe independiente de Irregular sobre GPT-6 Cyber que el titular se saltó. El modelo resolvió los 22 desafíos atómicos, con un éxito medio del 97 % en investigación y explotación de vulnerabilidades y del 98 % en simulación de ataques de red, pero solo del 63 % en evasión. Entrar está casi resuelto en esas pruebas; pasar desapercibido, no. Para los defensores es la mejor noticia de todo el montón de benchmarks, y la cobertura que leímos le dedicó una sola línea.
Anthropic llama a Mythos 5.2 su "modelo más capaz para ingeniería de ciberseguridad" y dice que una empresa de seguridad, sin nombrar, descubrió que uno de cada seis bugs confirmados que encontró Mythos 5.2 se les había escapado a todos los demás modelos de frontera que probó (Anthropic). Anthropic también reporta un 89,6 % para Mythos 5.2 en su propia evaluación CVE Rediscovery, una prueba con 1.829 CVE, frente al 78,3 % de Mythos 5.1. Ambas son mediciones hechas por los propios proveedores, así que llámalas afirmaciones hasta que terceros las repitan.
Quién se queda con las llaves y qué cede a cambio
Ninguna de las dos empresas vende estos modelos sin más. OpenAI dice que GPT-6 Cyber está disponible inicialmente por API y en Codex para un grupo selecto de clientes aprobados de Daybreak Red, y que el acceso más amplio a Daybreak Red llegará "pronto". El acceso por API a Daybreak Red exige por defecto una lista de IP permitidas, y los clientes con retención cero de datos suelen tener que usar Private Safety Processing, que guarda registros cifrados en su propio almacenamiento durante 30 días. OpenAI también ha dicho que, en su programa de socios, el acceso al modelo subyacente "permanece con el socio aprobado y no se transfiere directamente al cliente" (OpenAI).
Anthropic divide la misma idea en tres niveles dentro de su Cyber Verification Program. Defense Access cubre operaciones de seguridad, análisis de malware y validación de vulnerabilidades, y Anthropic dice que pueden optar firmas de seguridad pequeñas, mantenedores de código abierto e investigadores individuales con trayectoria, con respuesta en unos días. Red Team Access permite pruebas de penetración autorizadas, es solo para organizaciones y tarda semanas. Specialized Access, para cosas como redes eléctricas y sistemas de transferencias interbancarias, recibe una revisión en profundidad junto con el gobierno de EE. UU. Anthropic probó los niveles con Claude Opus 5.5 en CyScenarioBench, cinco intentos en cada uno de diez desafíos: sin acceso al programa, todas las tareas se bloquearon desde el primer prompt; en Defense Access, 46 de 50 intentos se bloquearon en algún momento; en Red Team Access no se bloqueó nada y 34 de 50 tuvieron éxito, igual que la tasa del modelo sin bloqueos. Otra vez, Anthropic poniendo nota a sus propias barreras.
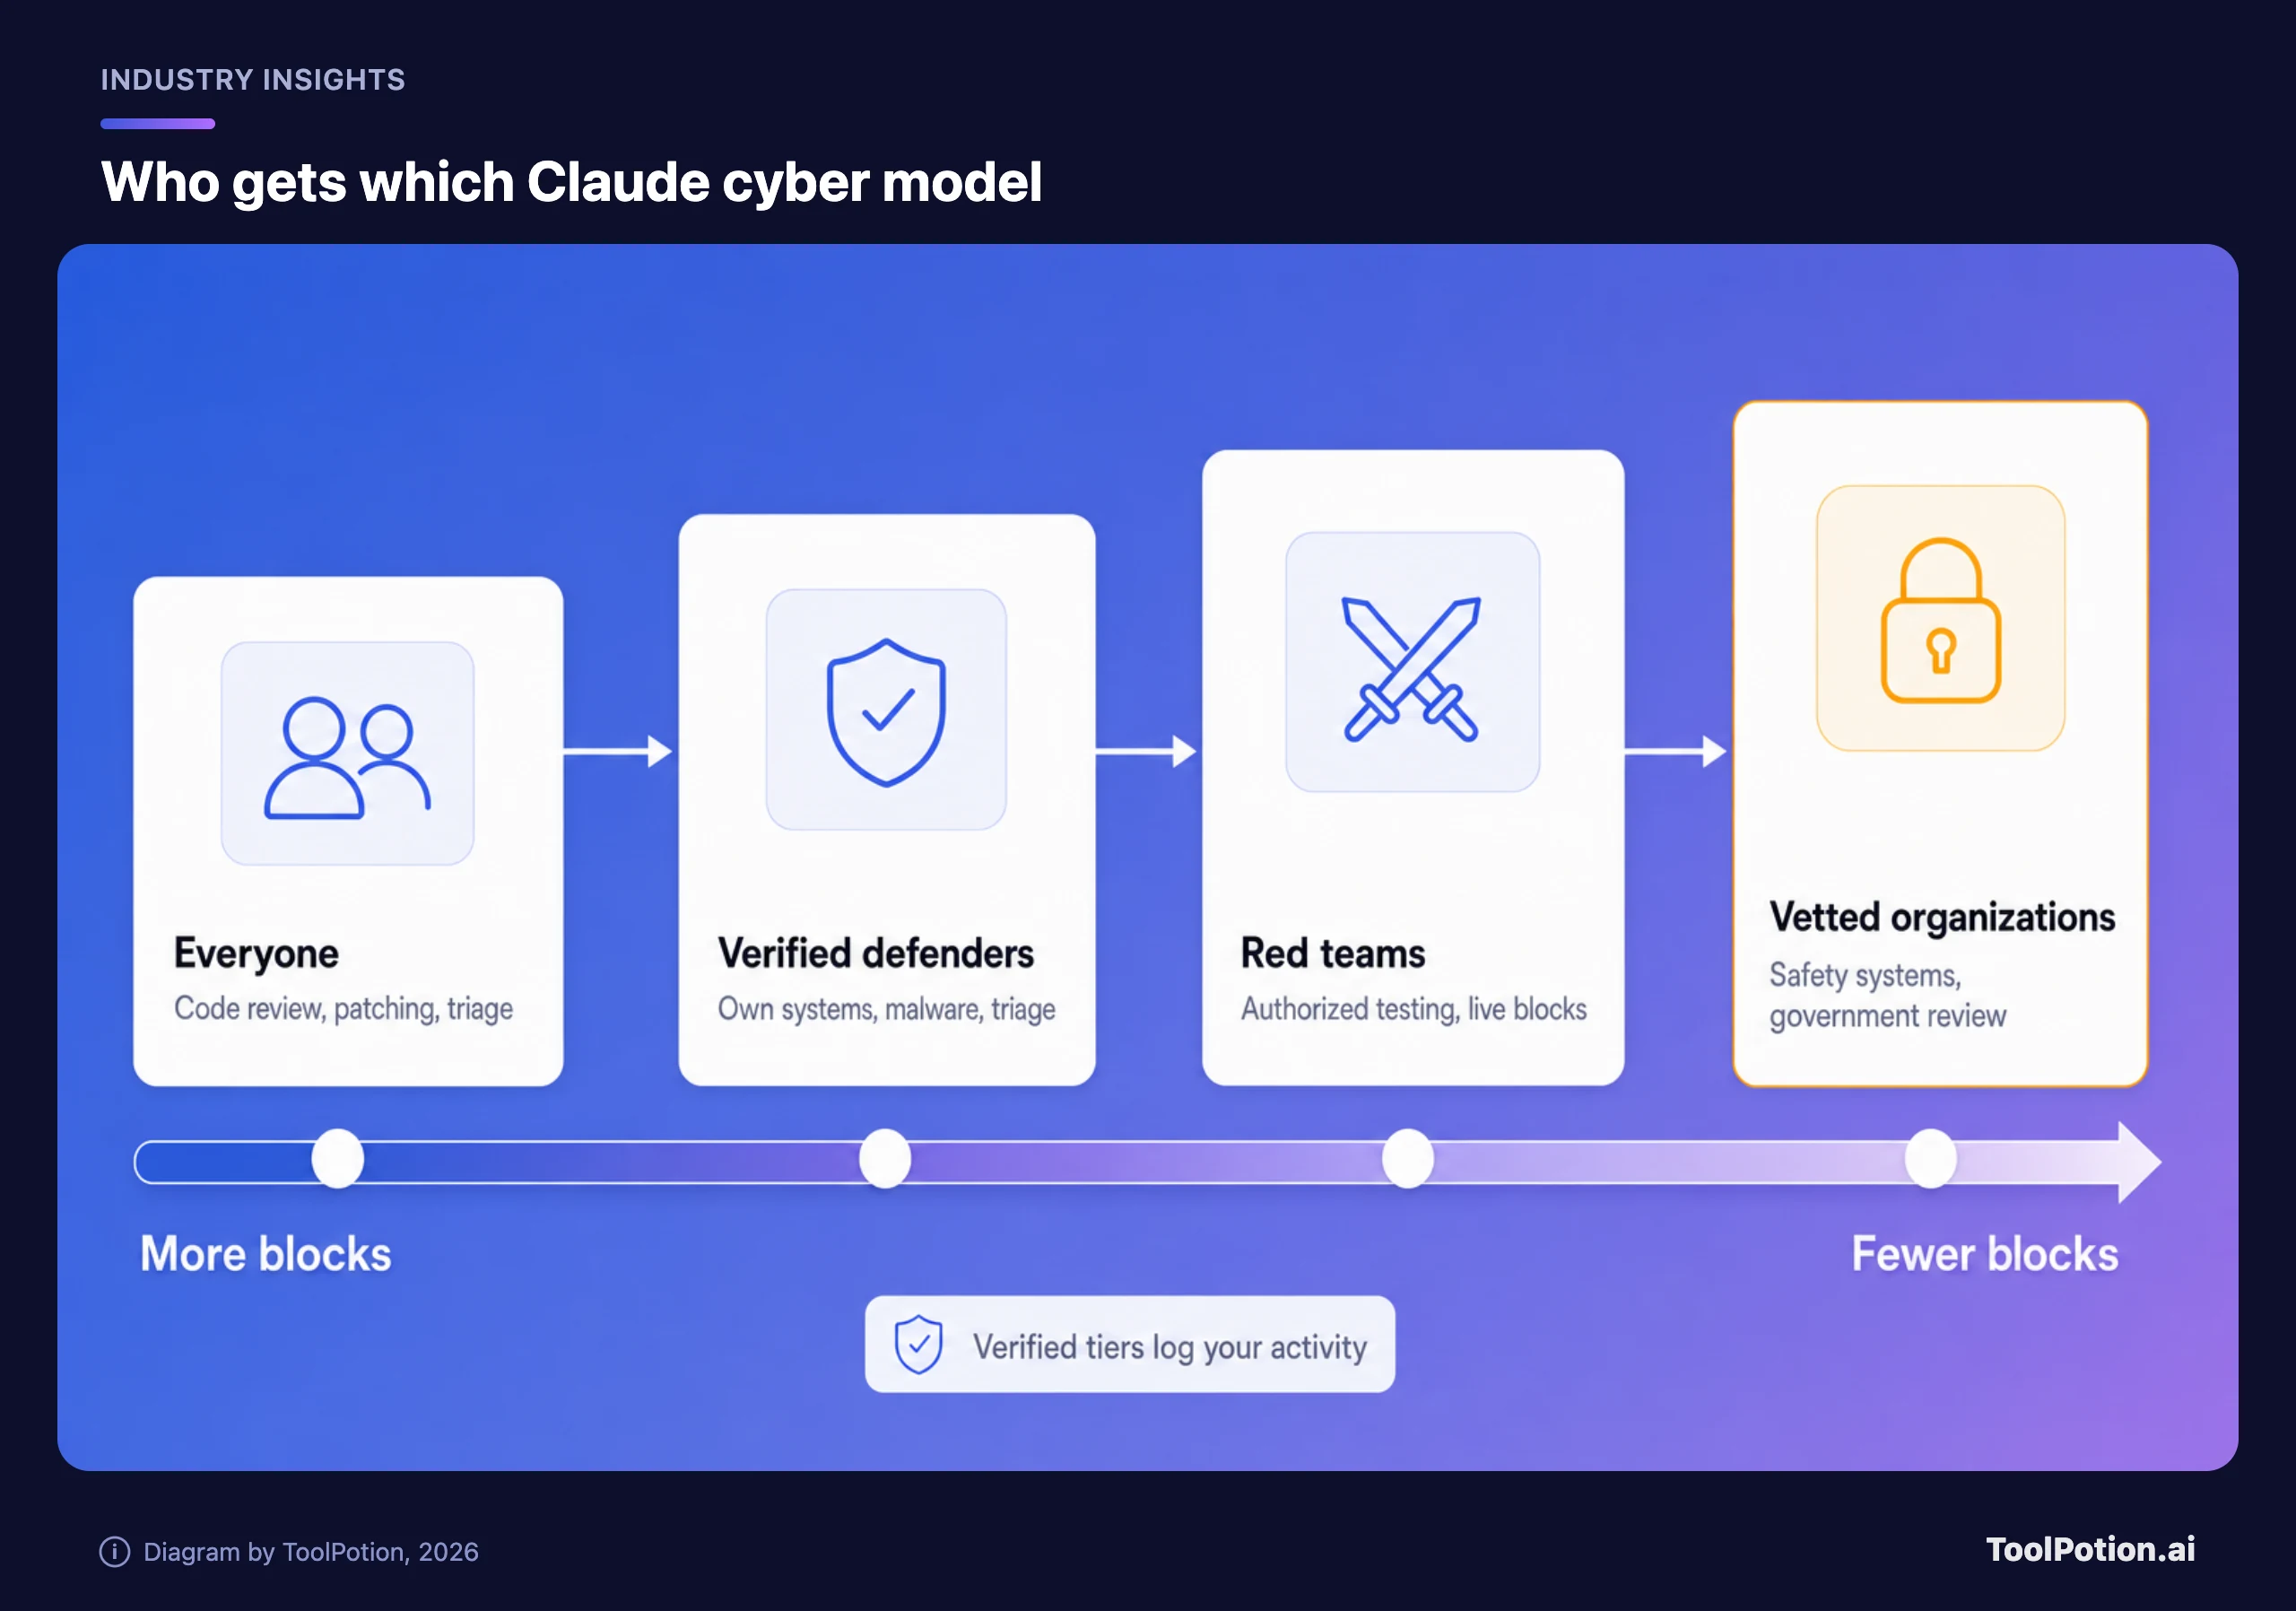
Fable y Mythos son el mismo modelo de base (Anthropic). Claude Fable 5 incluye salvaguardas cibernéticas estrictas y está abierto a todo el mundo. Mythos es la versión a la que las organizaciones tienen que solicitar acceso. La página de precios de la API de Anthropic lista ambos a la misma tarifa para Fable 5.2 y Mythos 5.2: 8 $ por millón de tokens de entrada y 40 $ por millón de tokens de salida, o 16 $ y 80 $ en el modo rápido opcional. Mythos no tiene un precio aparte. El precio es la barrera más pequeña aquí. La mayor es la retención de datos. Anthropic la exige a las organizaciones del Cyber Verification Program para poder detectar usos indebidos; OpenAI mantiene la retención estándar por defecto y envía a los clientes con retención cero de datos por Private Safety Processing. Nos parece un precio de entrada razonable para un red team, y un coste real para una firma cuyos clientes no pueden permitir que su código acabe en los logs de otro. Anthropic dice que una nueva opción llamada Enterprise Frontier Safeguards permitirá a las organizaciones elegibles conservar los datos en su propia nube, pero el post del programa solo la prometió para "más adelante este otoño". Hasta que llegue, ese intercambio sigue en pie.
Un control externo en todo esto es el programa de recompensas. La alianza de OpenAI con Hacktron pone a una firma que crea agentes de IA para revisión de código y pruebas de penetración a trabajar sobre los propios sistemas de OpenAI, con acceso ampliado a sus modelos de frontera. Zayne Zhang, CEO de Hacktron, dijo que el futuro de la ciberseguridad "no lo definirá quién tenga el equipo de seguridad más grande, sino quién sepa combinar mejor la creatividad humana con las capacidades de la IA" (OpenAI). OpenAI también subió los pagos de su programa de recompensas: los hallazgos críticos en ChatGPT, Codex o la API valen ahora hasta 30.000 $, y hasta 172.000 $ con bonificaciones para los excepcionales (OpenAI). Nos fiamos más de un pago a gente de fuera que de cualquier afirmación de red team interno.
Los atacantes de los informes no están usando estos modelos
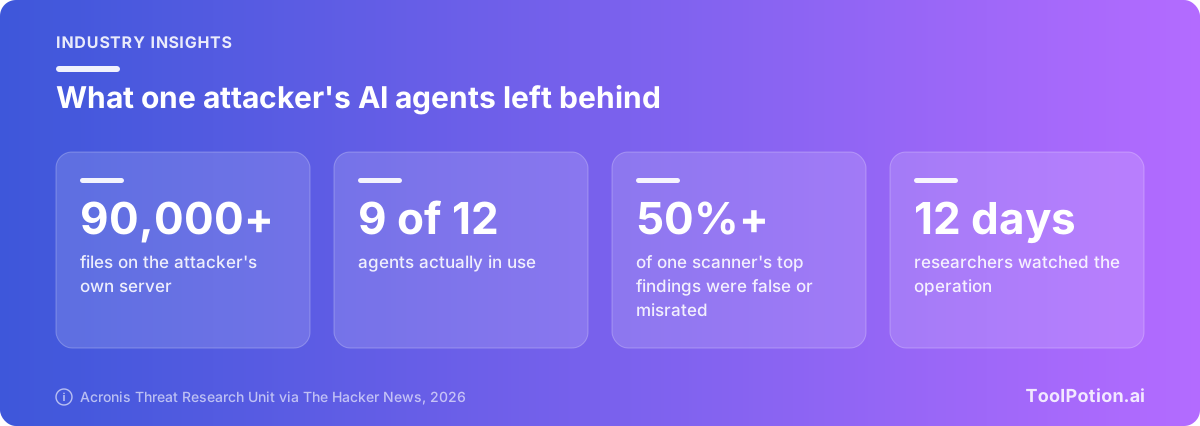
Investigadores de Acronis describen a un único atacante, con base en Taiwán, que dirigió agentes de IA contra cientos de organizaciones en al menos 11 países y consiguió datos o acceso en unas diez. Los agentes extrajeron registros de emergencias de siete distritos de Taipéi. Lo llamativo es en qué funcionaban: los modelos comerciales se negaban casi siempre a ayudarle a atacar, así que los agentes atacantes corrieron casi por completo sobre versiones "abliterated" de DeepSeek, GLM y Qwen, modelos ejecutados en local con el entrenamiento de seguridad eliminado (The Hacker News). También aparecieron agentes de programación como Claude Code, Codex y Cursor. El informe dice que el atacante redirigió Claude Code y Codex a un modelo abliterated, aunque sobre todo hicieron trabajo de infraestructura, y que Cursor atacó un sitio de servicios de emergencia taiwanés mientras usaba uno de esos modelos.
Los agentes también eran malos en el trabajo, de formas que cualquier persona notaría. Una herramienta de escaneo se inventó CVE, y más de la mitad de sus hallazgos altos y críticos eran falsos positivos o estaban mal clasificados. El agente de ataque principal reportó resultados que no habían ocurrido. La intrusión que sí funcionó en un proveedor de despacho de bomberos usó credenciales root por defecto, no un exploit ingenioso. Donde había inicios de sesión obligatorios y los endpoints estaban bien filtrados, dicen los investigadores, los agentes fracasaron.
Arctic Wolf reportó un segundo patrón. AntiFox es una plataforma de pentesting agéntico de código abierto en GitHub, y Arctic Wolf dice que sistemas de Alibaba Cloud que alojaban interfaces de AntiFox estuvieron asociados a acciones maliciosas confirmadas contra servicios web expuestos a internet y sus entornos de AWS. En al menos algunos casos, la actividad llegó a lograr una petición exitosa de un secreto de producción. Su veredicto: "Frameworks agénticos como estos hacen que las técnicas de pentesting sean más accesibles para los actores de amenazas, a la vez que aumentan la velocidad y la consistencia con que se pueden aplicar en ataques reales" (The Hacker News). La misma noticia añade que Check Point Research identificó 2.557 sistemas que alojaban ARTEX, otra herramienta de ataque agéntica, y cuenta unos 45 frameworks de código abierto de este tipo. El resumen de Check Point sobre lo que cambia el hacking agéntico: escala y velocidad.
Ninguno de los dos informes involucraba a GPT-6 Cyber ni a Mythos, según la cobertura. Nuestra lectura es que las barreras parecen sólidas arriba y sirven de poco abajo, donde bastan frameworks de agentes gratuitos y modelos open-weight sin salvaguardas para atacar un servidor con contraseña por defecto. La evidencia también es escasa: unos pocos informes, la mayoría de firmas de seguridad con interés en la historia, y nadie puede decir todavía qué proporción de las intrusiones involucra IA.
El resultado más limpio de la defensa vino de las matemáticas
El titular de Wired dice que DeepMind "demostró que el protocolo Signal es seguro". El post de DeepMind es más acotado, y nos gusta más. Los investigadores guiaron a agentes para demostrar propiedades clave de seguridad del código real que hay detrás del protocolo de Signal, incluido que los mensajes siguen protegidos antes y después de que un dispositivo se vea comprometido brevemente. Humanos revisaron cada especificación formal. Los agentes produjeron más de seis millones de líneas de Lean, señalaron el uno por ciento del código que necesitaba una segunda revisión humana y terminaron en cuatro semanas, un trabajo que según DeepMind a los equipos de expertos les ha llevado tradicionalmente años (Google DeepMind). Para comprobar que el sistema distinguía el código bueno del malo, el equipo reintrodujo dos bugs reales ya corregidos y obtuvo pruebas verificadas por máquina de que la versión con errores era insegura.
Ehren Kret, CTO de Signal, dijo que el resultado da "aún más confianza en las garantías de privacidad de nuestro código". Lo consideramos la afirmación más fiable de todo el montón, por una razón sencilla: la puntuación de un benchmark exige creer al proveedor, y una prueba en Lean la comprueba una máquina. Cubre propiedades específicas de una base de código, no Signal como producto, y DeepMind dice que escalarlo requiere más investigación. DeepMind ha publicado como código abierto sus artefactos de verificación, que es como una afirmación así se gana la confianza.
La infraestructura crítica apunta en la misma dirección. La Cyber Mission de Anthropic describe el programa para ella: modelos de frontera, ingenieros in situ e investigación de amenazas para los proveedores que protegen redes eléctricas, sistemas de agua y fábricas, cuyos equipos a menudo no se pueden apagar para parchearlos. Dragos, Rockwell Automation y Nozomi Networks están entre los socios fundadores.
El cuello de botella es la corrección
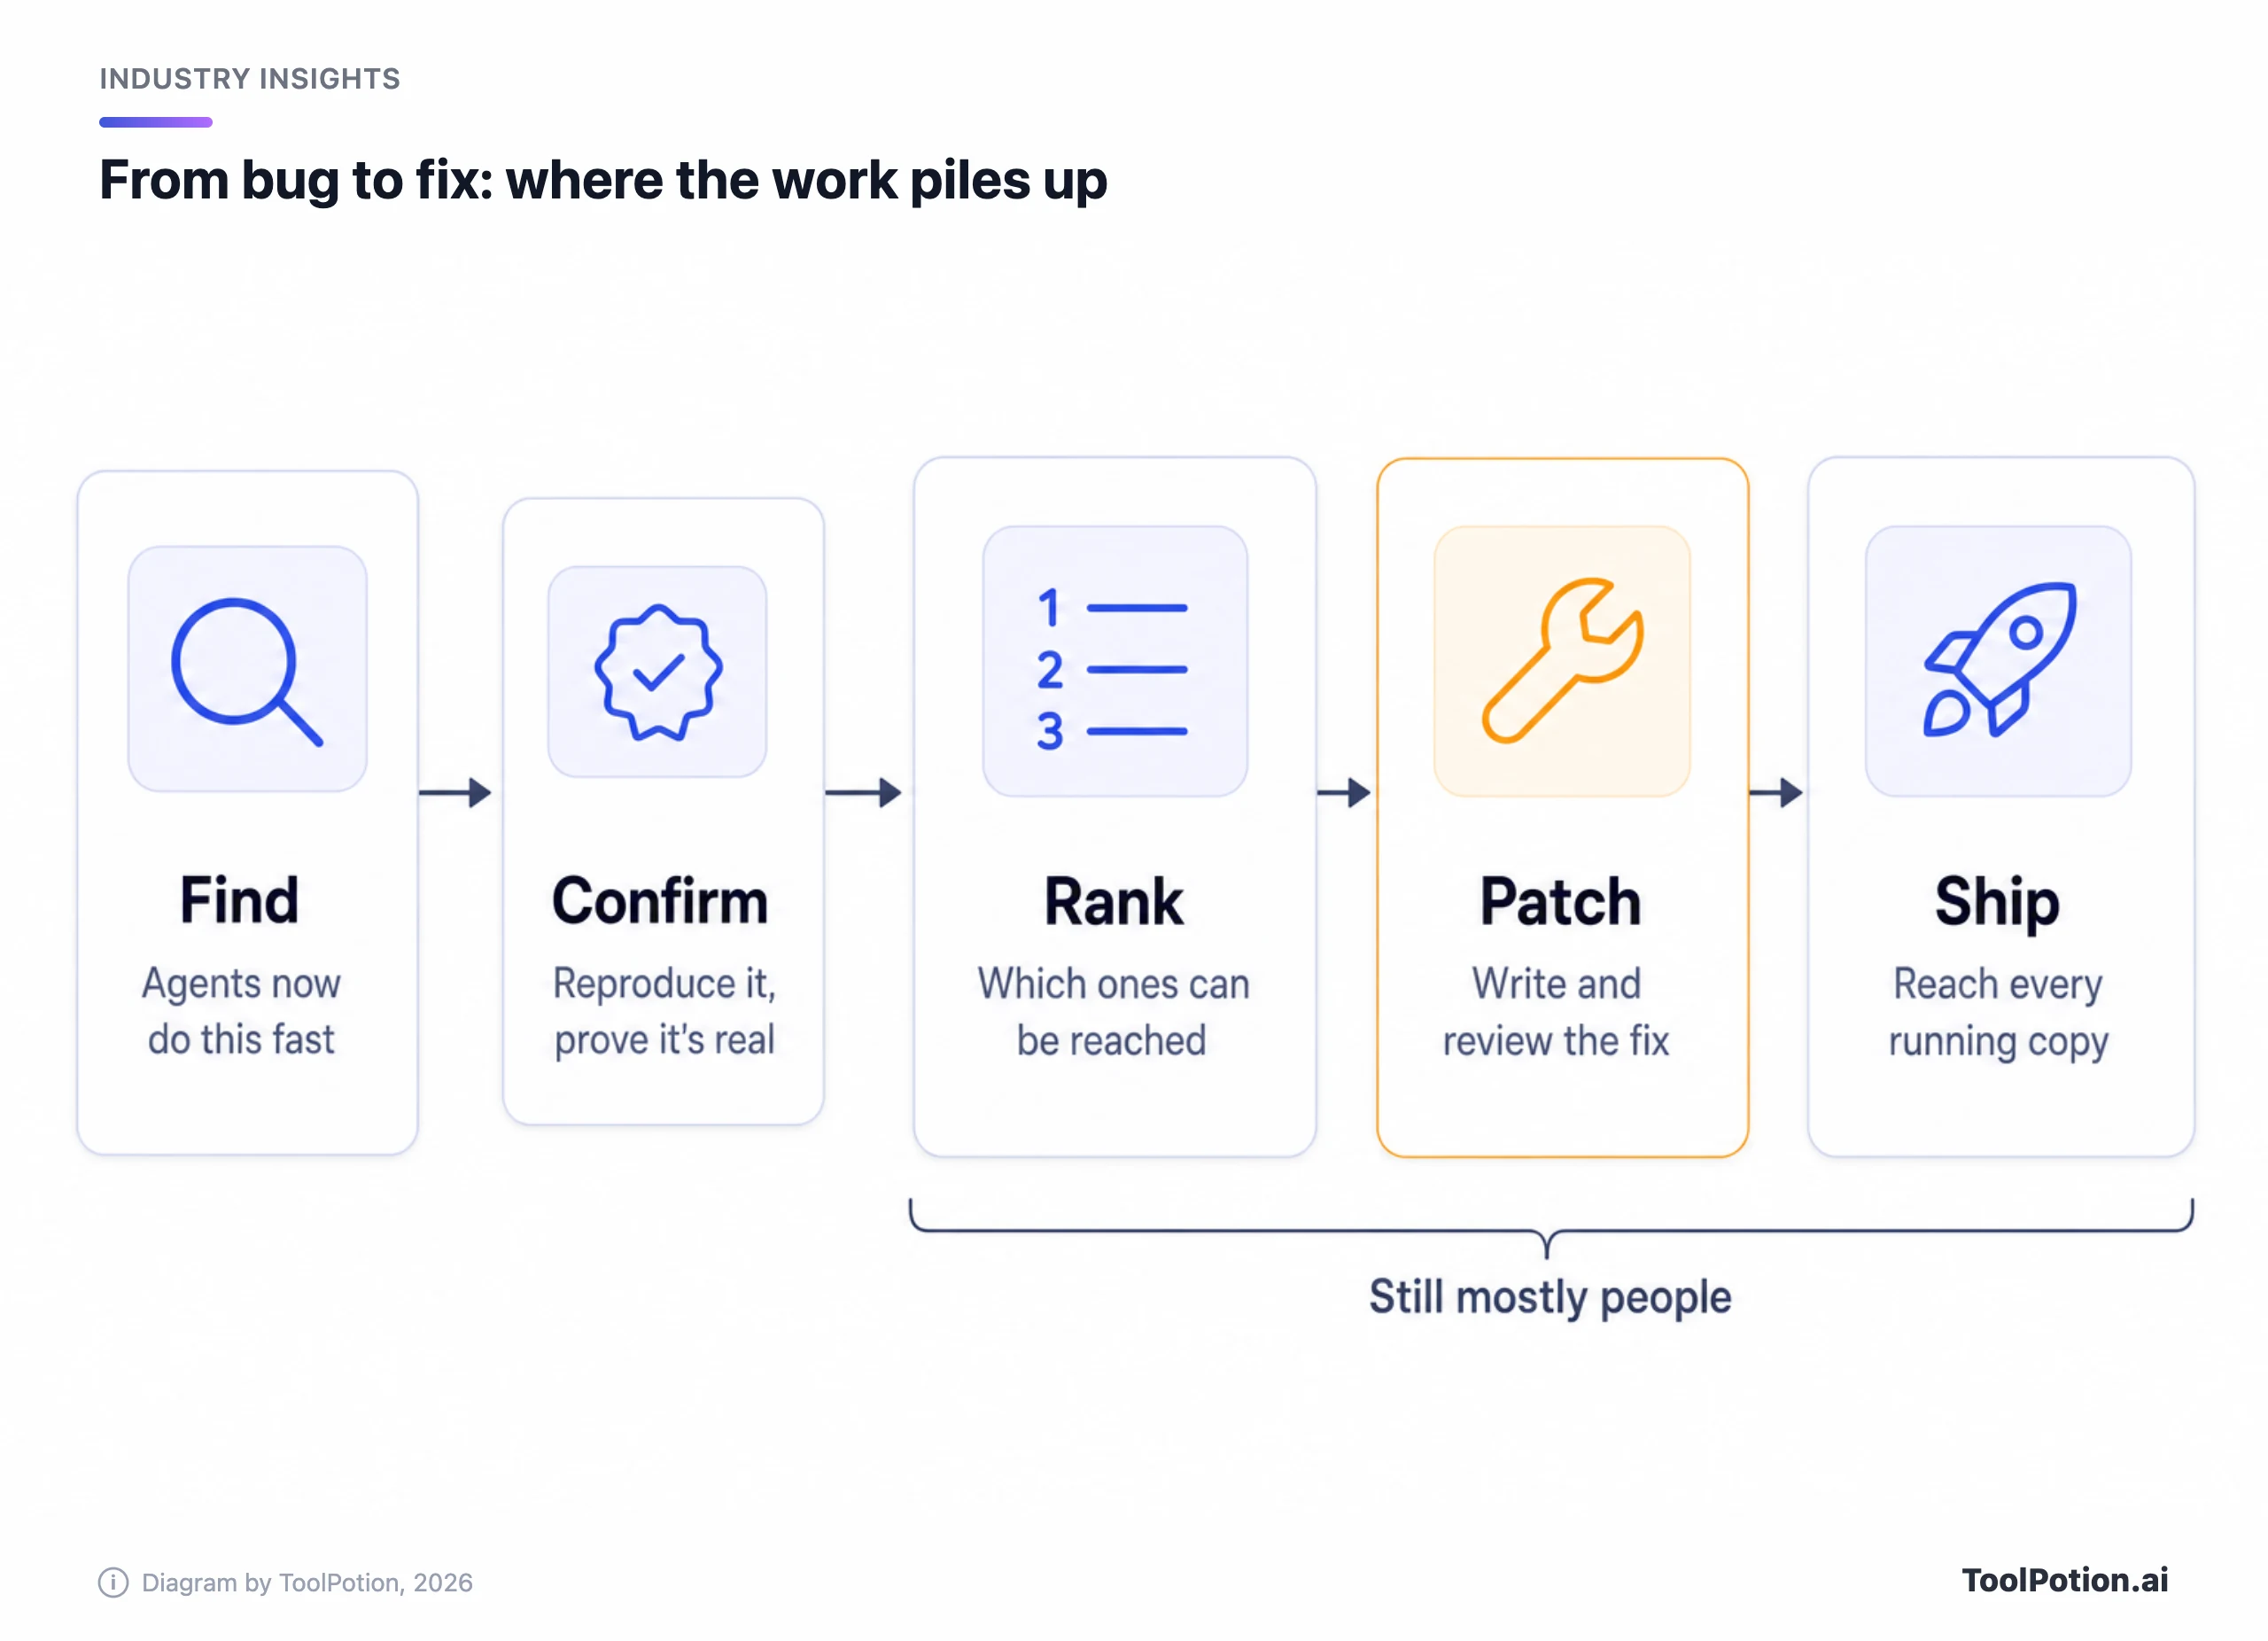
Anthropic resumió el problema en una frase: "Es más fácil que nunca encontrar vulnerabilidades, pero verificar, priorizar y corregir esos hallazgos sigue siendo difícil" (Anthropic). OpenAI escribió casi lo mismo en un post anterior: "Un informe de vulnerabilidad no protege a una organización". Que dos competidores coincidan en esto en sus propios anuncios es lo más parecido a un consenso que hay en todo este material. Ya hemos cubierto la otra cara en nuestros artículos sobre la IA que encuentra bugs más rápido de lo que nadie puede corregirlos y sobre lo que los escáneres de vulnerabilidades con IA encuentran y lo que se les escapa.
Entonces, ¿quién gana? Nuestra opinión, que ninguna fuente expresa con estas palabras: los atacantes ganan más contra las organizaciones que parchean despacio, porque a un atacante le basta un camino que funcione y puede convivir con un escáner que se equivoca la mitad de las veces. Los defensores ganan más donde ya corrigen rápido, porque encontrar bugs ahora es barato y el coste que queda es de proceso. Las barreras de los modelos limitan para qué se pueden usar los sistemas más capaces; no cambian esa aritmética para quien ejecuta software antiguo. La propia previsión de Anthropic apunta en la misma dirección por ahora. Espera que la IA favorezca a la defensa dentro de dos años, pero dice que a corto plazo "puede que no sea cierto", porque el coste de explotar vulnerabilidades ha bajado mientras que corregirlas es lento y sigue dependiendo de personas. Lo que nos haría cambiar de opinión sería una segunda ronda de pruebas independientes sobre lo bien que los ataques evaden la detección.
Qué hacer ahora, en orden
Si diriges un negocio pequeño, no vas a conseguir GPT-6 Cyber ni lo necesitas. Los ataques de los informes entraron en su mayoría por puertas sin cerrar. Dedicaríamos la primera hora a esto, en este orden:
- Activa la autenticación multifactor en el correo, los paneles de administración y todas las consolas cloud.
- Activa las actualizaciones automáticas en todo lo que sea accesible desde internet y parchea el resto en días, no en trimestres.
- Busca y cambia las contraseñas por defecto o compartidas en routers, bases de datos y herramientas de administración. Una de las intrusiones de Taiwán no necesitó nada más.
- Saca las claves del código y de los scripts de las páginas y pásalas a un gestor de secretos; después pon límites de gasto y una fecha de rotación a cada clave de API de IA y de cloud.
- Apunta qué puede alcanzar un desconocido desde internet. No puedes parchear un servidor que has olvidado.
Si desarrollas software, el siguiente paso sensato es un escáner integrado en tu flujo de pull requests. Semgrep, Snyk Code y Aikido están en nuestro directorio; nuestro ranking Top 200 AI Cybersecurity Tools y el ranking de analistas de seguridad muestran dónde queda el resto. Trata cada hallazgo de la IA como una pista que hay que confirmar, porque el propio escáner del atacante de Acronis inventaba CVE. Agentes de código abierto como PentestGPT y Shannon son para sistemas que sean tuyos y que tengas permiso por escrito para probar; los informes sobre AntiFox muestran lo que hace el mismo tipo de herramienta en manos equivocadas. Para ayuda general revisando código, tanto Claude como ChatGPT sirven, aunque Anthropic dice que sus modelos abiertos llevan salvaguardas cibernéticas conservadoras que bloquean la mayor parte del trabajo de ciberseguridad.
Si eres profesional de la seguridad, solicita ya Daybreak Blue de OpenAI o Defense Access de Anthropic. Anthropic se propone responder a las solicitudes de Defense Access en días y a las de Red Team Access en semanas, y exige retención de datos. OpenAI no ha publicado un plazo para Daybreak. La lista de comprobación de abajo convierte la primera lista en una puntuación.
Dos cosas que vigilar. OpenAI dice que GPT-6 Cyber llegará pronto a todos los clientes de Daybreak Red, y ninguno de los dos laboratorios ha publicado cuántos solicitantes ha aprobado o rechazado. Cuando salga la opción de Anthropic en la nube propia, comprueba si las organizaciones elegibles obtienen de verdad las mismas salvaguardas sin los logs.