

Anthropic lanzó esta semana un escáner de seguridad con IA gratuito y opcional para proyectos de código abierto, y llega en un momento complicado. La IA ya es capaz de encontrar bugs reales en código que personas llevan años auditando. También puede enterrar a un mantenedor voluntario bajo una avalancha de bugs falsos. Ambas cosas son ciertas a la vez, y un equipo pequeño tiene que decidir qué hacer al respecto.
El nuevo servicio, llamado OSS Scanner, ejecuta análisis periódicos de vulnerabilidades en los proyectos inscritos con los modelos más potentes de Anthropic. Cada informe incluye un reproductor, una explicación y, cuando es posible, un parche candidato (Anthropic). Se suma a una larga lista de iniciativas similares de Google, OpenAI, GitHub, Snyk y Semgrep, y a una pila creciente de informes de IA de baja calidad que ha llevado a algunos mantenedores a cerrar sus puertas.
Este artículo pone orden: qué hacen estas herramientas, cuáles no cuestan nada, cómo apuntarte sin hacerte daño y un flujo de trabajo que puede llevar un equipo de dos personas. La versión corta: los escáneres de IA ya son lo bastante buenos como para tomárselos en serio, y nadie debería hacer merge de lo que producen sin leerlo antes.
Qué hace el OSS Scanner de Anthropic
Los mantenedores principales se inscriben abriendo un pull request en un repositorio de GitHub, siguiendo una plantilla. Anthropic decide caso por caso, con criterios parecidos a los de OSS-Fuzz de Google: un proyecto debe tener "un impacto crítico en la infraestructura y la seguridad de los usuarios" (Anthropic). Así que no es para cualquier repo de aficionados. Piensa en curl y wolfSSL, el tipo de librerías a las que enlaza la mitad de internet.
Es gratis. Los análisis se pagan con un fondo que Anthropic llama Defender Advantage Fund (SiliconANGLE), y la empresa asegura que la participación seguirá sin coste para los proyectos inscritos.
Lo más importante es lo que falta. Los informes son "totalmente generados por el modelo, sin revisión ni triaje humanos", y Anthropic admite abiertamente que algunos serán erróneos (Anthropic). Un ejemplo que menciona es una valoración de gravedad equivocada. Los proyectos sin personal para filtrar informes pueden seguir usando el proceso de divulgación actual de Anthropic, donde primero verifican personas (SiliconANGLE).
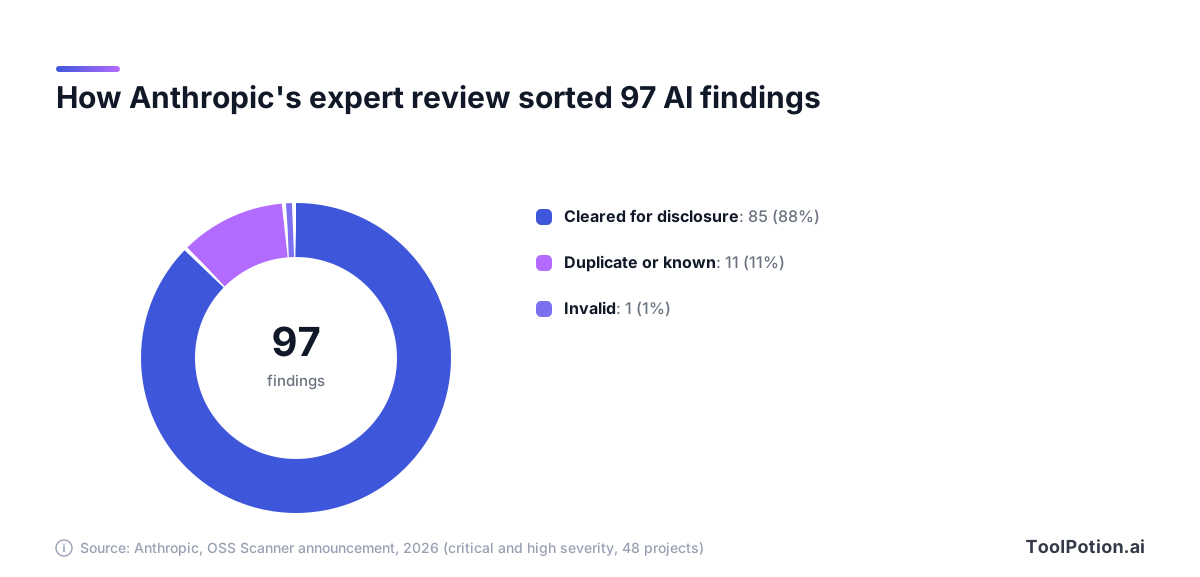
Las cifras de Anthropic explican por qué cree que el intercambio merece la pena. Pentesters expertos revisaron 97 hallazgos de gravedad crítica y alta en 48 proyectos. De ellos, 85 cumplían los requisitos para una divulgación coordinada, 11 eran duplicados o reales pero ya conocidos, y uno no era válido (Anthropic). Por otro lado, wolfSSL informó de que 72 de los 74 informes de una prueba inicial eran válidos y que de ellos salieron cinco CVE (SiliconANGLE).
Daniel Stenberg, responsable de curl, dijo que el escáner encontró "una de las peores vulnerabilidades de curl reportadas en los últimos años" (Anthropic). Ten en cuenta que todas estas cifras vienen de Anthropic o de sus socios. Además, Anthropic dice que espera una tasa de verdaderos positivos superior al 90 % (Anthropic), lo cual es una previsión, no una garantía para tu repo.
Qué hace realmente un escáner de IA: encontrar, demostrar, parchear
El análisis estático de toda la vida compara el código con reglas. Es rápido y predecible, y te inunda de avisos. Los escáneres agénticos más nuevos funcionan más bien como un investigador de seguridad junior: leen el código, formulan una teoría sobre dónde falla, intentan provocar el fallo y solo entonces lo documentan.
Ese paso intermedio es el que hay que buscar. Un hallazgo que viene con un exploit funcional es otra cosa muy distinta de uno que viene con un párrafo de prosa muy segura de sí misma.
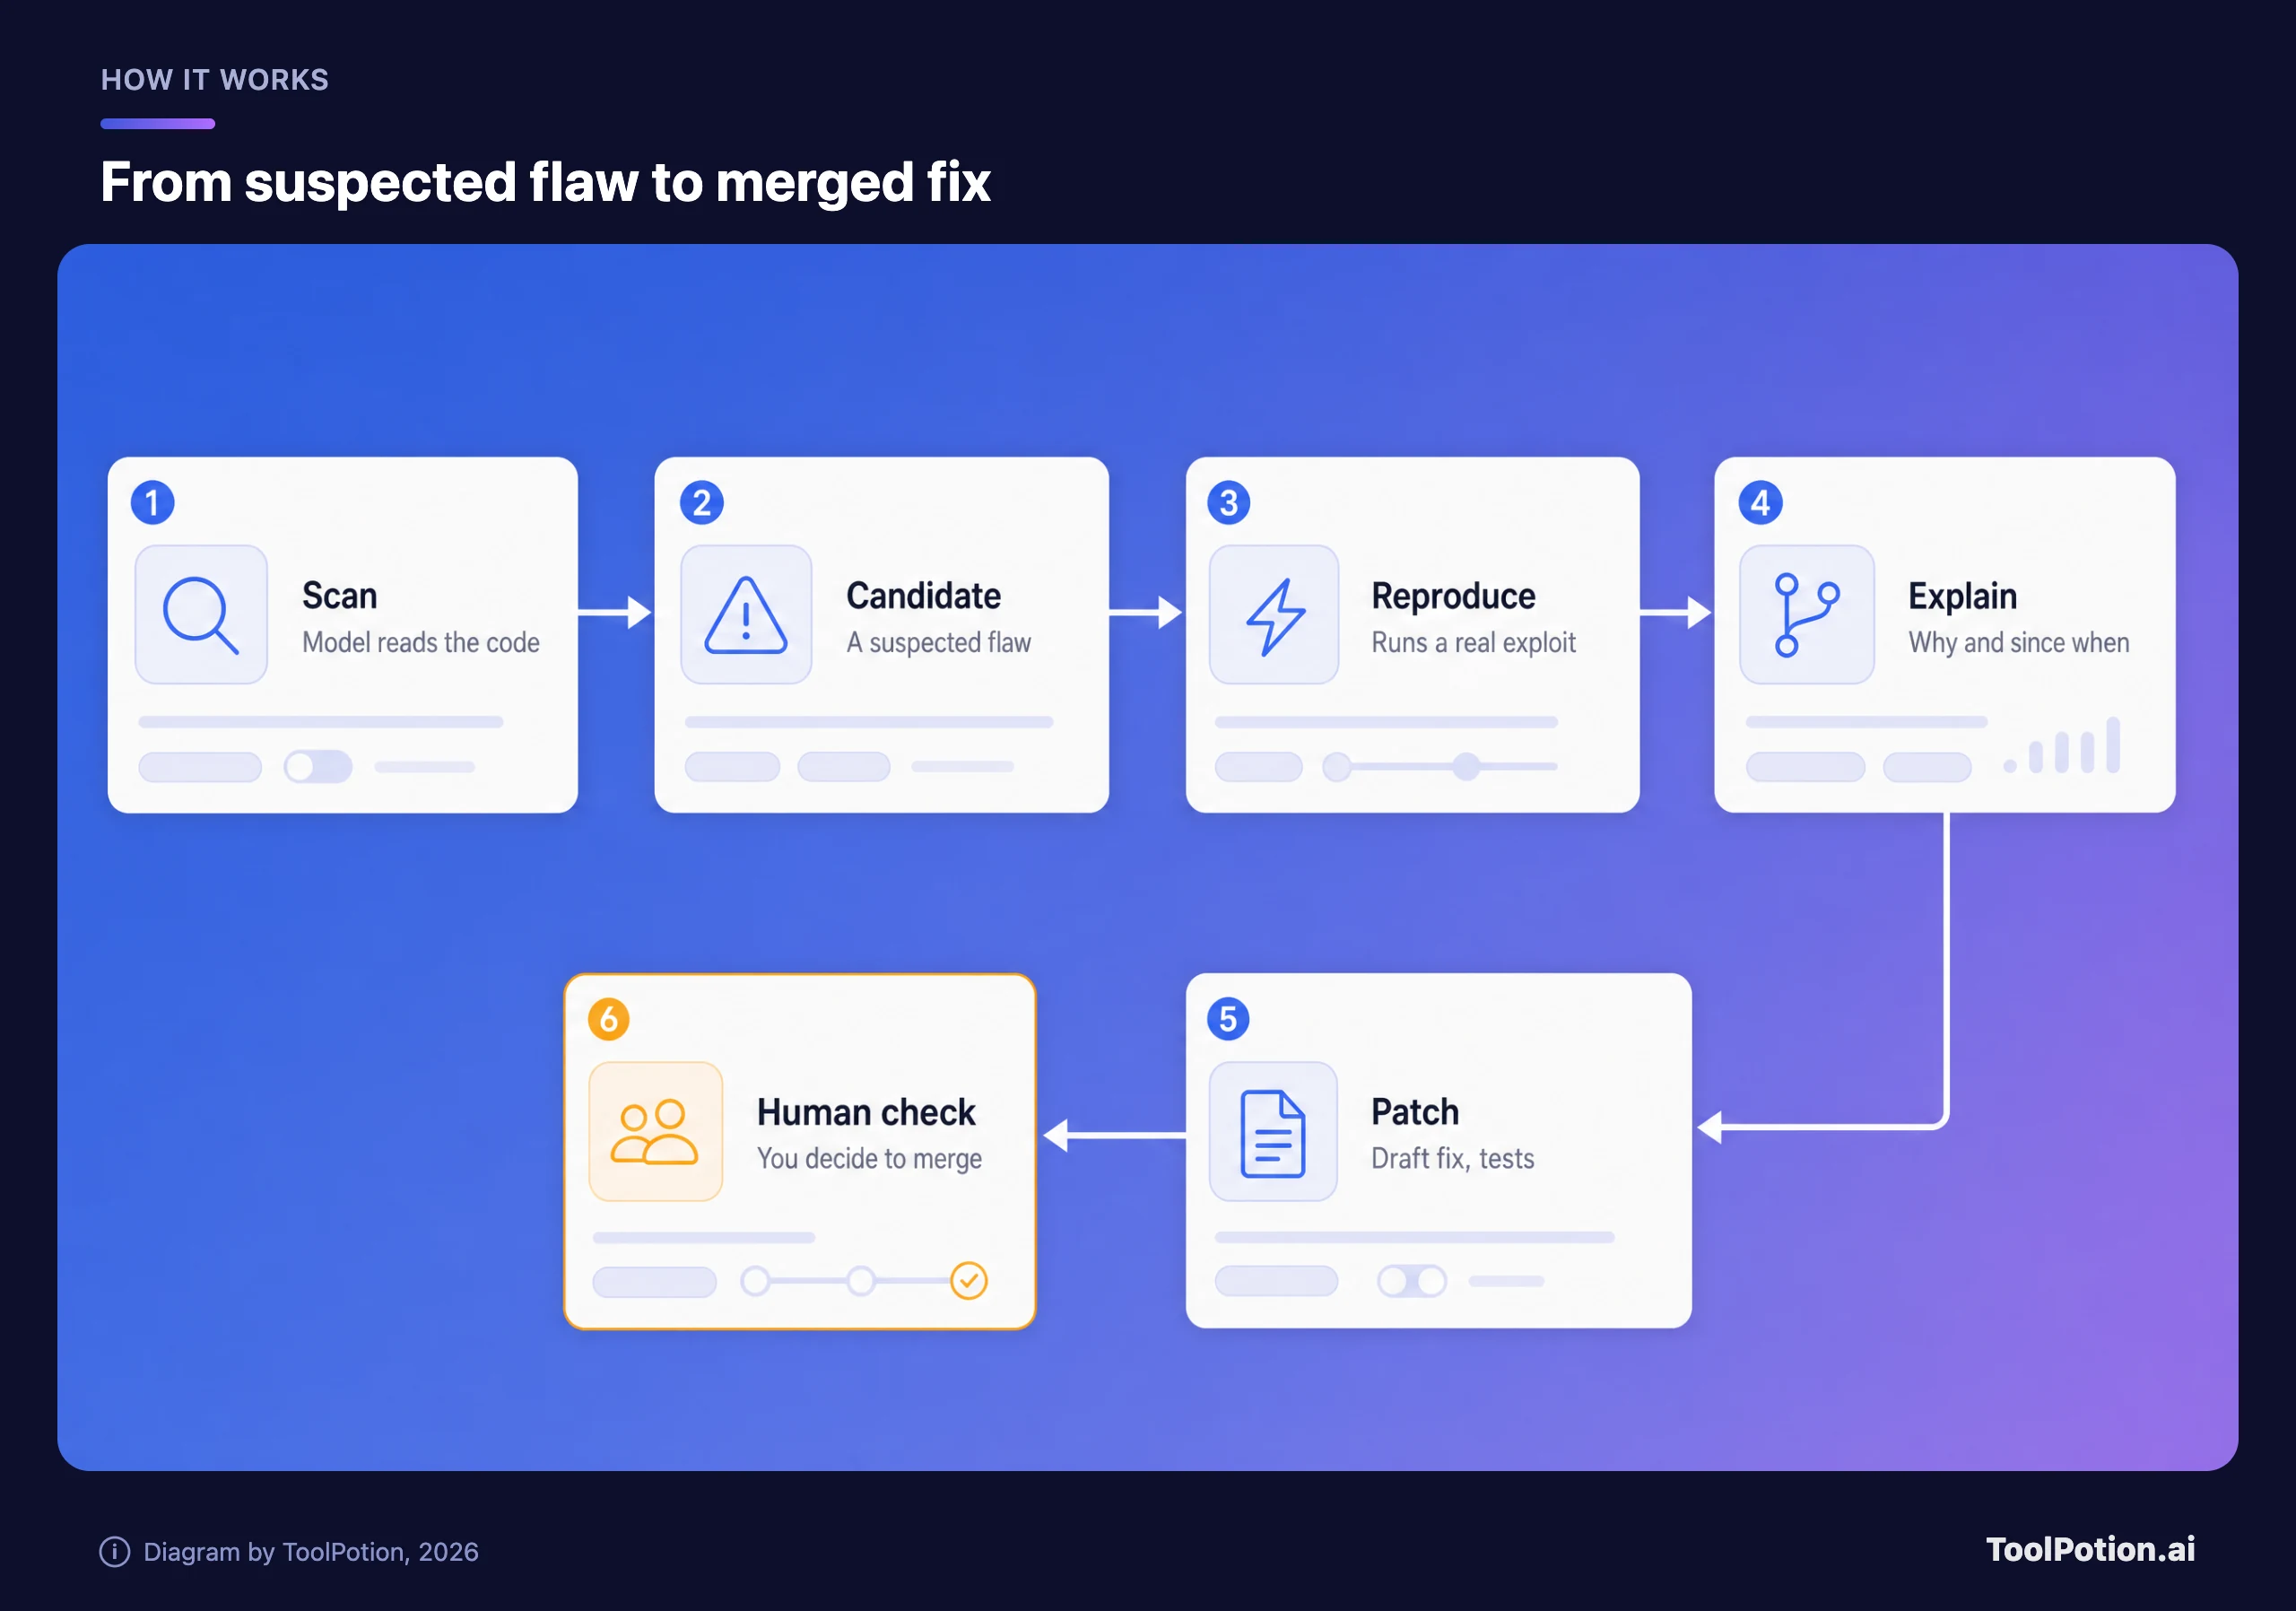
Lee el proceso de izquierda a derecha. Los tres primeros pasos tratan de acertar: un candidato pasa una prueba real antes de que nadie lo vea. Los pasos cuatro y cinco tratan de ser útiles, con una explicación de qué se rompió y un borrador de arreglo. La última casilla es tuya, y es ámbar por algo. Google dice que todos los parches de CodeMender pasan por revisión humana, y el Autofix de GitHub solo sugiere. El escáner de Anthropic es la excepción en el triaje, y por eso esa última casilla te toca a ti.
El panorama en 2026
OSS Scanner no está solo. DeepMind, de Google, creó Big Sleep, un agente que caza bugs, y CodeMender, que escribe los arreglos. DeepMind dijo que ya había subido a proyectos de código abierto 72 correcciones de seguridad y que cada parche había sido revisado antes por investigadores humanos (Google DeepMind). Desde entonces, CodeMender ha pasado a una vista previa pública para clientes empresariales de Google Cloud, donde crea exploits de prueba de concepto en un sandbox y devuelve arreglos probados en forma de diffs para que los revise el desarrollador (Infosecurity Magazine).
La versión de OpenAI se lanzó como Aardvark, un agente basado en GPT-5 que construye un modelo de amenazas de tu repo, vigila los commits nuevos, confirma los problemas en un sandbox y propone parches. OpenAI dijo que alcanzó un 92 % en vulnerabilidades conocidas y sintéticas de repositorios de prueba y que había encontrado problemas que dieron lugar a diez CVE (OpenAI). Desde entonces lo ha integrado en Codex con otro nombre: su página de Aardvark ahora dice "Aardvark is now Codex Security", disponible como vista previa de investigación (OpenAI). La documentación describe Codex Security como un agente que ayuda a los equipos a "encontrar, confirmar y corregir vulnerabilidades", con la versión en la nube todavía en vista previa de investigación (documentación de OpenAI).
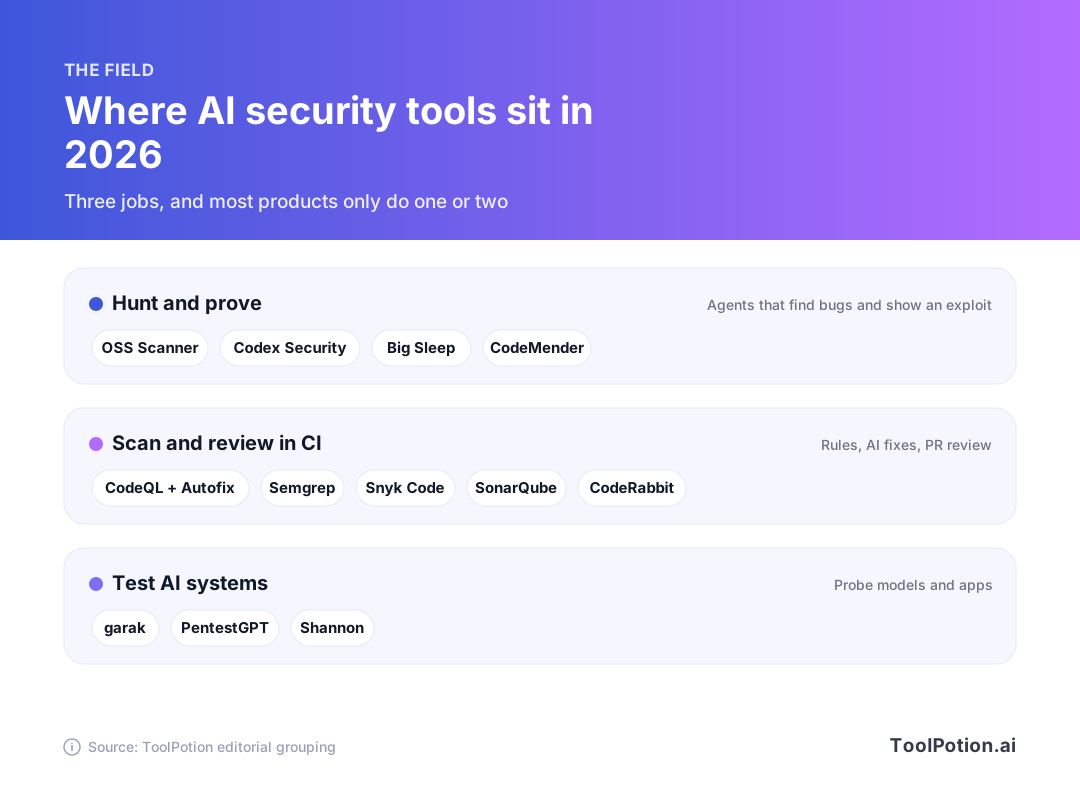
El mapa las agrupa por tarea, y la agrupación es nuestra, no de los proveedores. La fila superior caza y demuestra. La del medio vive en tu pipeline y trabaja en cada commit. La inferior apunta en sentido contrario y prueba los propios sistemas de IA.
En la fila del medio, Autofix de GitHub Copilot sugiere correcciones para las alertas que lanza CodeQL, el escáner de GitHub. Semgrep y Snyk Code hacen un trabajo parecido con sus propios motores, y SonarQube cubre la calidad del código además de comprobaciones de seguridad. CodeRabbit revisa pull requests. En la fila inferior, garak busca debilidades en modelos de lenguaje, y PentestGPT dirige pruebas de penetración con un modelo. Nuestro ranking de ciberseguridad con IA clasifica el conjunto más amplio, y el ranking de revisión de código cubre las herramientas para pull requests.
| Herramienta | Función principal | Quién puede usarla |
|---|---|---|
| OSS Scanner (Anthropic) | Encuentra y demuestra bugs, redacta parches | Proyectos de código abierto inscritos, gratis |
| Codex Security (OpenAI) | Encuentra, confirma y corrige | Vista previa de investigación dentro de Codex |
| CodeMender (Google) | Analiza, demuestra y parchea | Vista previa pública, clientes de Google Cloud |
| Copilot Autofix (GitHub) | Sugiere correcciones para alertas de CodeQL | Gratis en repos públicos |
| Semgrep | Análisis basado en reglas con funciones de IA | Gratis hasta 10 colaboradores |
| Snyk Code | Análisis de código y dependencias | Plan gratuito, 100 pruebas de Code al mes |
Casi todo lo de esa tabla sale de páginas de los proveedores, y los proveedores describen sus propios productos con generosidad. Considera las condiciones de acceso como la columna útil. Cambian rápido.
La otra cara: los mantenedores se ahogan
Los mismos modelos que encuentran bugs reales también escriben otros falsos muy convincentes. curl es el caso más claro. Su programa de recompensas funcionó desde 2019 hasta principios de 2026, pagó más de 100.000 $ por 87 vulnerabilidades confirmadas y luego se cerró. En 2025, menos del 5 % de los informes se confirmaban, frente al 15 % o más de años anteriores (Daniel Stenberg).
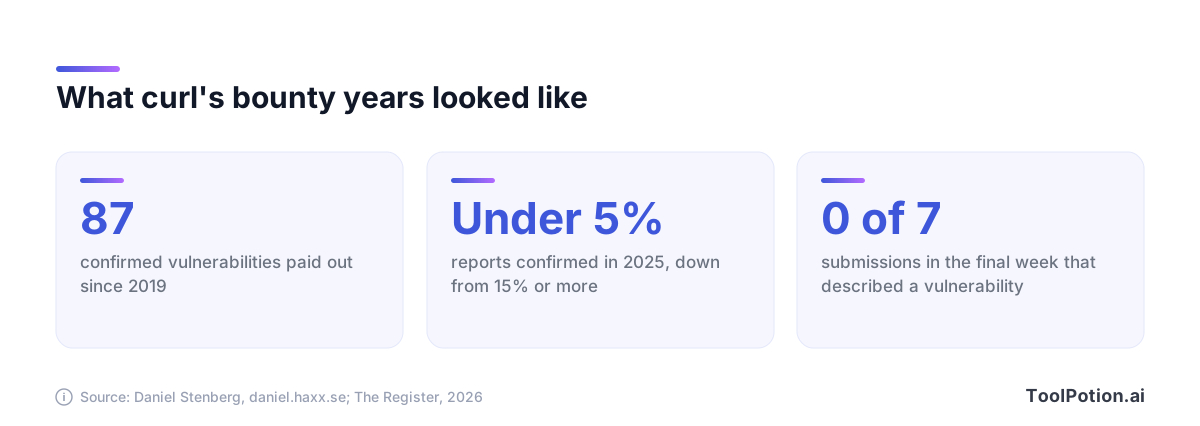
En la última semana antes de que acabara el programa de recompensas, curl recibió siete envíos y ninguno describía una vulnerabilidad (The Register). El razonamiento de Stenberg fue tajante. El objetivo era "quitar el incentivo para que la gente nos envíe basura e informes mal investigados. Generados por IA o no". Piotr Karwasz, de Apache Log4j, describió el mismo patrón y dijo que muchos informes "pasan por alto los fundamentos de nuestro modelo de seguridad, aportando ruido en lugar de valor" (Daniel Stenberg).
Curl fue más lejos después. Stenberg escribió que el proyecto pausó los informes de vulnerabilidades durante un mes este verano y lo calificó de "posiblemente nuestra mejor decisión de proyecto en mucho tiempo" (Daniel Stenberg).
Fíjate en que el mismo proyecto que cerró su programa de recompensas para frenar el ruido de la IA elogió a un escáner de IA que encontró uno de sus peores bugs. No es una contradicción. La diferencia es un reproductor que funciona y un remitente que ya ha hecho la comprobación. Un modelo que demuestra lo que afirma le cuesta minutos al mantenedor. Una persona que pega la salida de un modelo le cuesta horas.
El escáner de Anthropic se salta al intermediario humano, y ahí están a la vez su atractivo y su riesgo. Acelera la entrega, pero también significa que un informe puede llegar a tu puerta sin que nadie lo haya leído antes. Si mantienes un proyecto, espera más de eso de todos los proveedores de la tabla.
Los atacantes tienen los mismos modelos
El propio anuncio de Anthropic dice que "los modelos de frontera pueden usarse indebidamente para explotar vulnerabilidades y realizar ciberoperaciones" (Anthropic). La lectura práctica es sencilla. Cualquiera puede apuntar un modelo potente a código público y preguntarle dónde falla, y el código abierto es público por definición.
Ese es el verdadero argumento para escanear tu propio código. No es que los escáneres de IA sean magia. Es que la ventana entre que existe un bug y alguien más lo encuentra se está acortando, y más te vale llegar primero. Un proyecto sin análisis no es seguro. Simplemente no está observado.
Qué es gratis y qué no
Buena parte de la capa útil es gratuita si tu código es público. Copilot Autofix viene activado por defecto en los repositorios públicos que usan CodeQL, sin necesidad de suscripción a Copilot (GitHub). GitHub lo hizo gratuito para todos los repositorios públicos ya en 2024 (GitHub changelog).
La edición gratuita de Semgrep cubre hasta 10 colaboradores y 10 repositorios, con 60 créditos de IA incluidos (Semgrep). El plan gratuito de Snyk permite cinco proyectos y 100 pruebas de Snyk Code al mes (Snyk), y la empresa también tiene un programa al que los mantenedores de código abierto pueden solicitar acceso gratuito.
Lo de pago se concentra sobre todo en el código privado y los agentes. El autofix agéntico más reciente de GitHub, todavía en vista previa, consume créditos de IA, y Copilot Autofix en repositorios privados necesita una licencia de Code Security (GitHub). Codex Security requiere acceso a la vista previa de investigación (documentación de OpenAI).
Cómo apuntarte con seguridad
Que sea gratis no significa que no tenga consecuencias. Un escáner que lee tu código y te envía informes afecta a tu flujo de trabajo, a tu proceso de divulgación y, a veces, a tu reputación. Unos pocos pasos lo mantienen bajo control.
- Comprueba primero la elegibilidad. OSS Scanner busca proyectos con impacto crítico en infraestructura o seguridad, así que lee los criterios en el repositorio de Anthropic antes de perder tiempo con un pull request.
- Decide adónde van los informes. Usa un canal privado, como el reporte privado de vulnerabilidades de GitHub o una dirección de correo de seguridad, para que un hallazgo no sea público antes de que exista un arreglo.
- Nombra a un responsable. Una persona recibe todos los informes y decide qué se hace. Con dos personas, cada una da por hecho que lo lleva la otra.
- Lee las condiciones de datos de cualquier escáner alojado. Semgrep, por ejemplo, indica que las funciones de IA a las que te hayas apuntado pueden procesar las partes de los archivos que contienen hallazgos (Semgrep). Sabe qué sale de tu máquina.
- Empieza con acceso de solo lectura y deja los parches como sugerencias. Ninguna herramienta debería hacer push a tu rama principal.
- Escribe tu plazo de divulgación antes de que llegue el primer informe. Es mucho más fácil seguir una regla que escribiste con la cabeza fría.
Nada de esto es raro. Es la misma higiene que aplica un buen mantenedor con cualquier investigador externo, aplicada antes de que llegue el volumen.
Un flujo de trabajo para un equipo pequeño
Si eres un equipo de dos a diez personas que saca un producto, no necesitas un escáner agéntico desde el primer día. Necesitas una cola que de verdad puedas vaciar. El ciclo de abajo tiene seis pasos, y el ámbar es donde la mayoría de los equipos se salta el proceso.
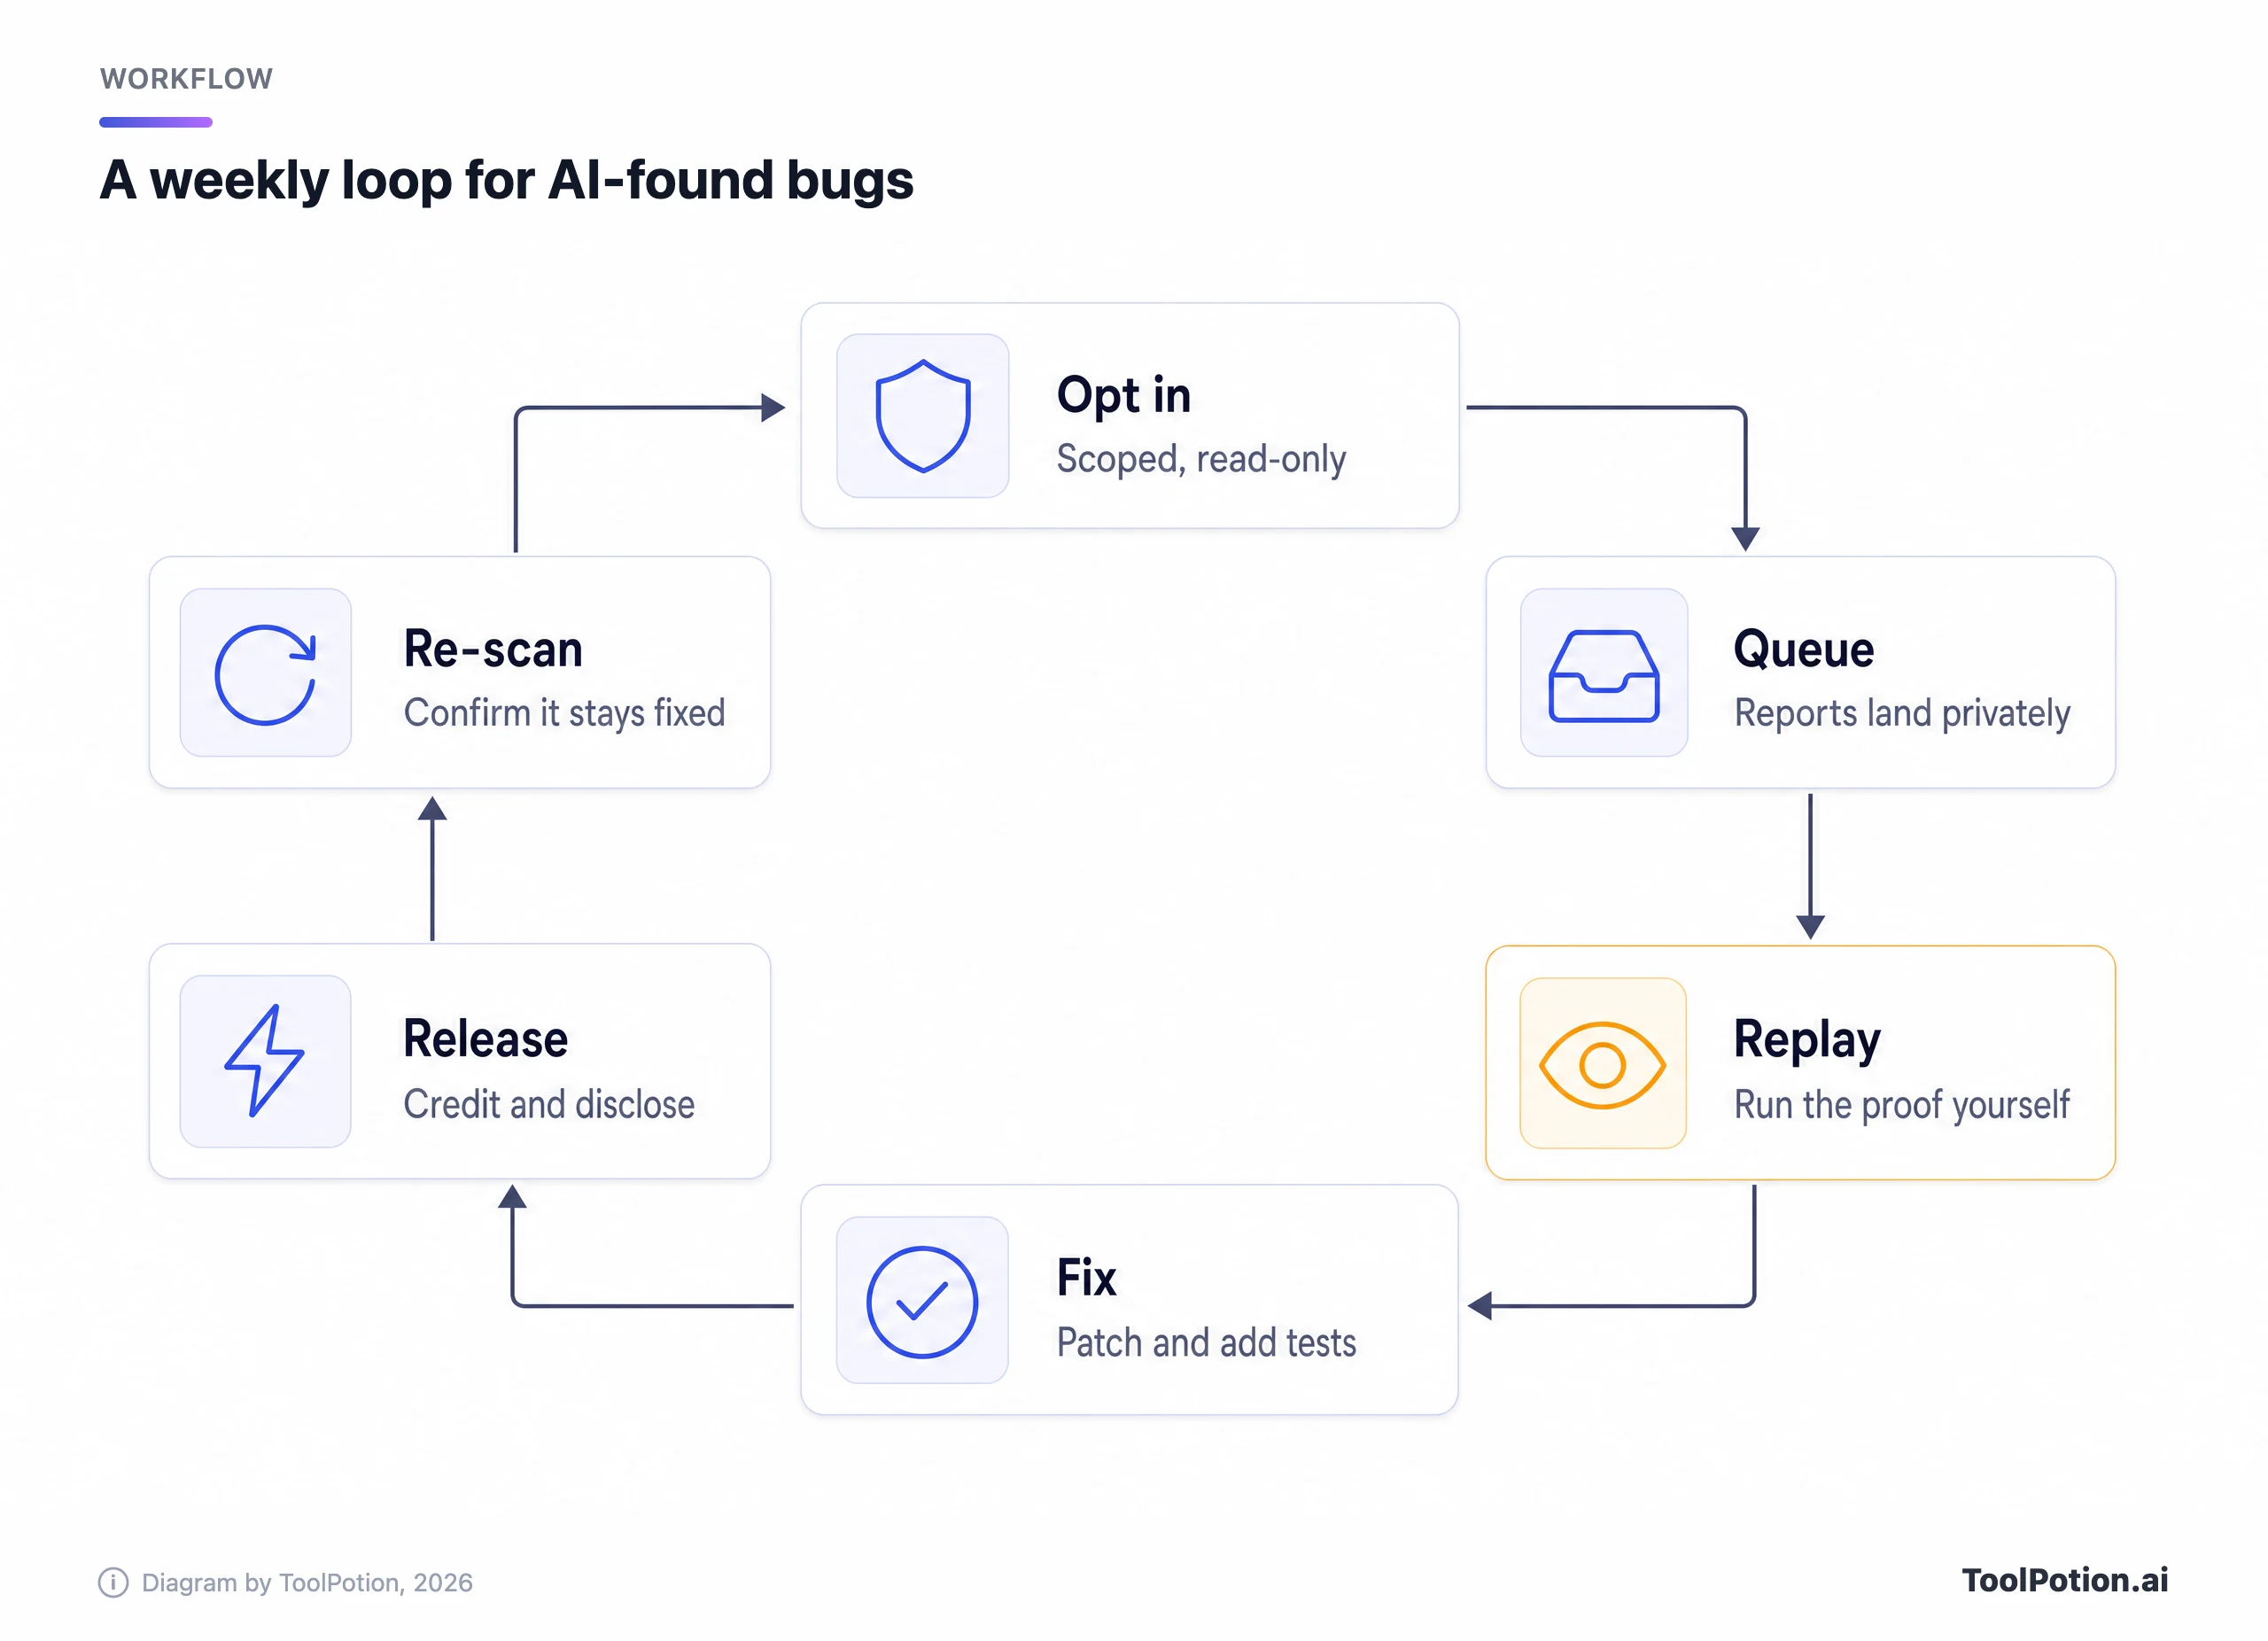
Reproducir es el paso que separa a un escáner útil de uno ruidoso. Si un informe trae un reproductor, ejecútalo tú mismo. Si no lo trae, pídelo. Un modelo que no puede mostrar que lo que afirma funciona te ha dado una teoría, y las teorías son baratas.
¿No sabes por dónde empezar? El árbol de decisión de abajo recoge los casos más comunes. Es un consejo editorial basado en las condiciones de los proveedores que hemos visto, así que adáptalo a tu situación.
Para la mayoría de los equipos pequeños, lo mejor para empezar es un escáner gratuito de pull requests y una persona que se encargue de los resultados. Añade una herramienta agéntica cuando esa cola lleve unas semanas tranquila. Un repo de aficionados puede apañarse con los ajustes gratuitos que ya ofrece su plataforma. Una librería que está en una ruta crítica es la que debería solicitar OSS Scanner.
Cuánto cuesta el triaje
Nadie pone el tiempo de triaje en la página de precios, y es el coste que decide si un escáner ayuda o perjudica. Hasta una buena herramienta produce algunos duplicados. La propia revisión de Anthropic encontró 11 de 97. La calculadora de abajo convierte tu volumen de informes en horas.
Prueba a subir el porcentaje de informes inválidos y mira con qué rapidez se acumulan las horas. Luego prueba a bajar los minutos por informe a 15, como imagen aproximada de lo que te ahorraría una prueba que funcione (la cifra es una ilustración, no una medición). Esa diferencia es el argumento para exigir reproductores, tanto a las herramientas de IA como a las personas.
Unos cuantos hábitos ayudan cuando empiezan a llegar los informes. El gráfico de abajo los resume.
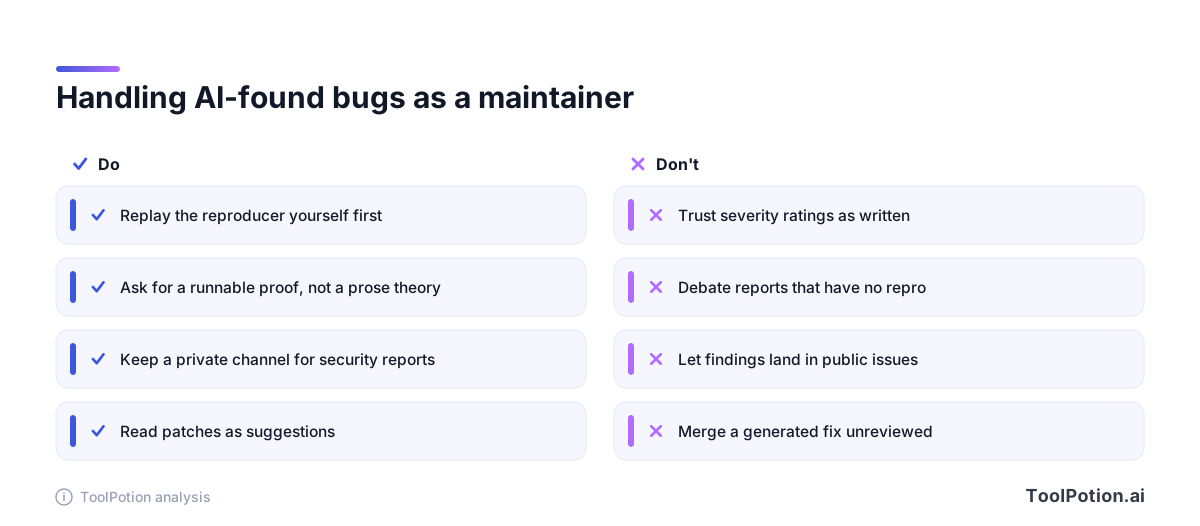
Vale la pena repetir el primer par. Las valoraciones de gravedad las da un modelo, y la propia Anthropic advierte de que pueden ser erróneas (SiliconANGLE). Valóralo tú después de reproducirlo. Un asistente del estilo de Claude Code puede ayudarte a escribir el arreglo y el test de regresión cuando hayas decidido que el bug es real, pero la decisión sigue siendo tuya. Para más contexto sobre este tipo de herramientas, mira nuestro ranking de asistentes de programación y la guía de herramientas de revisión de código con IA.
Dónde se quedan cortas estas herramientas
Son buenas con las clases de bugs que dejan rastro en el código: errores de memoria, inyección, comprobaciones que faltan. Son más débiles con los fallos que dependen de cómo funciona realmente un negocio, como quién debería poder aprobar qué. Un escáner no puede conocer tu intención.
Tampoco sustituyen al resto de la seguridad. CodeMender de Google mantiene a personas revisando los parches antes de que lleguen al proyecto original (Google DeepMind), y GitHub dice que Autofix funciona en la medida de lo posible y no puede confirmar que un arreglo resuelva las alertas de consultas personalizadas (GitHub). Los proveedores que más tienen que ganar son los primeros en decirte que revises el resultado.
El límite real es el volumen. Encontrar bugs se abarata más rápido que corregirlos. Un escáner que entrega cuarenta hallazgos reales a un proyecto de tres personas ha creado un backlog, no un producto más seguro. Elige las herramientas por lo que puedes corregir en un mes, no por lo que pueden encontrar.
Preguntas frecuentes
¿Está abierto el OSS Scanner de Anthropic a cualquier repositorio de GitHub?
No. Es opcional y se evalúa caso por caso, con criterios similares a los de OSS-Fuzz, así que los proyectos deben tener un impacto crítico en la infraestructura y la seguridad de los usuarios. Los mantenedores lo solicitan mediante un pull request al repositorio de GitHub de Anthropic.
¿Los escáneres de IA sustituyen a una prueba de penetración?
No en lo que importa a tus clientes. Cubren bien los bugs a nivel de código y mal los fallos de lógica de negocio. Considéralos una capa extra que funciona todo el tiempo, junto con alguna revisión humana ocasional.
¿Puedo usar Claude o Gemini directamente para auditar mi código?
Puedes pegar código en Claude o Google Gemini y pedir una revisión de seguridad. Sirve para una sola función. No tendrá el sandbox, el modelo de amenazas de todo el repo ni la comprobación de exploits que añaden los agentes especializados de arriba, así que espera más falsas alarmas.
¿Qué hago si recibo un informe escrito por IA que parece falso?
Pide un reproductor contra una versión concreta. Un hallazgo real puede responder a eso. Uno inventado, muchas veces no. Si alguien sigue enviándolos, tienes derecho a cerrar el informe y seguir adelante.
¿Es seguro ejecutar escáneres gratuitos sobre código privado?
Lee las condiciones de cada uno. Algunos se ejecutan por completo en tu propia máquina y otros envían fragmentos de archivos a un modelo alojado. Comprueba qué guarda el proveedor y durante cuánto tiempo antes de conectar un repositorio privado.