

GitHub dice que, en el Artificial Analysis Coding Agent Index, Copilot Fusion Max "obtuvo 60, a dos puntos de Claude Code con Opus 5.5 Max" (GitHub changelog). El titular de The New Stack lo convirtió en un sistema que "supera a Claude Code por la mitad del coste de API" (The New Stack). Son frases distintas, y en el hueco que hay entre ellas es donde un equipo debería ponerse a pensar.
Fusion ya está disponible con carácter general en GitHub Copilot como una nueva entrada del selector de modelos. No eliges un modelo. Eliges un nivel de esfuerzo, y Copilot decide qué modelos se ejecutan, y en qué orden, para cada prompt. Es una buena idea con una base de evidencia escasa, y nosotros lo trataríamos primero como una función de control de costes y solo después como una afirmación de calidad.
Sesenta no es sesenta y dos
Vuelve a leer la redacción de GitHub. Fusion Max quedó a dos puntos de Claude Code con Opus 5.5 Max, con aproximadamente la mitad del coste medio de API por tarea, la mitad de los tokens y alrededor de un 40 % menos de tiempo (changelog). Es un resultado respetable y un argumento de venta razonable. Pero no es una victoria, y el propio cuerpo del texto de The New Stack dice "comparable" bajo un titular que dice "supera". GitHub repitió la afirmación en su resumen de Universe, donde "la mitad del coste" es la versión que se propaga.
Artificial Analysis publica el índice que cita GitHub. Combina tres benchmarks, FrontierCode, Terminal-Bench 4.0 y SWE-Atlas-QnA-AA, con el mismo peso (Artificial Analysis). La vista por defecto de esa página muestra a Claude Code con Opus 5.5 Max en 62 y ninguna entrada de Fusion. Activa el interruptor "Router models" y aparece GitHub Copilot - Copilot Fusion (Max) con 60, así que la cifra es real y está donde GitHub dijo. Ese mismo interruptor muestra el Devin Fusion CLI de Cognition, que combina Opus 5.5 Max con GPT-6 Luna y empata con Claude Code en 62; eso indica que los routers como categoría se están poniendo al día, no que el de GitHub sea el que hay que batir. No contrastamos las columnas de coste de la página con la cifra de "la mitad del coste" de GitHub, así que esa parte sigue siendo palabra de GitHub.
Tres caminos tras una sola entrada del menú
La documentación define Fusion como "un router y orquestador de modelos inteligente en tiempo de ejecución" (GitHub Docs). Para cada prompt elige uno de tres patrones de ejecución, y prompts distintos dentro de una misma sesión pueden seguir caminos distintos.
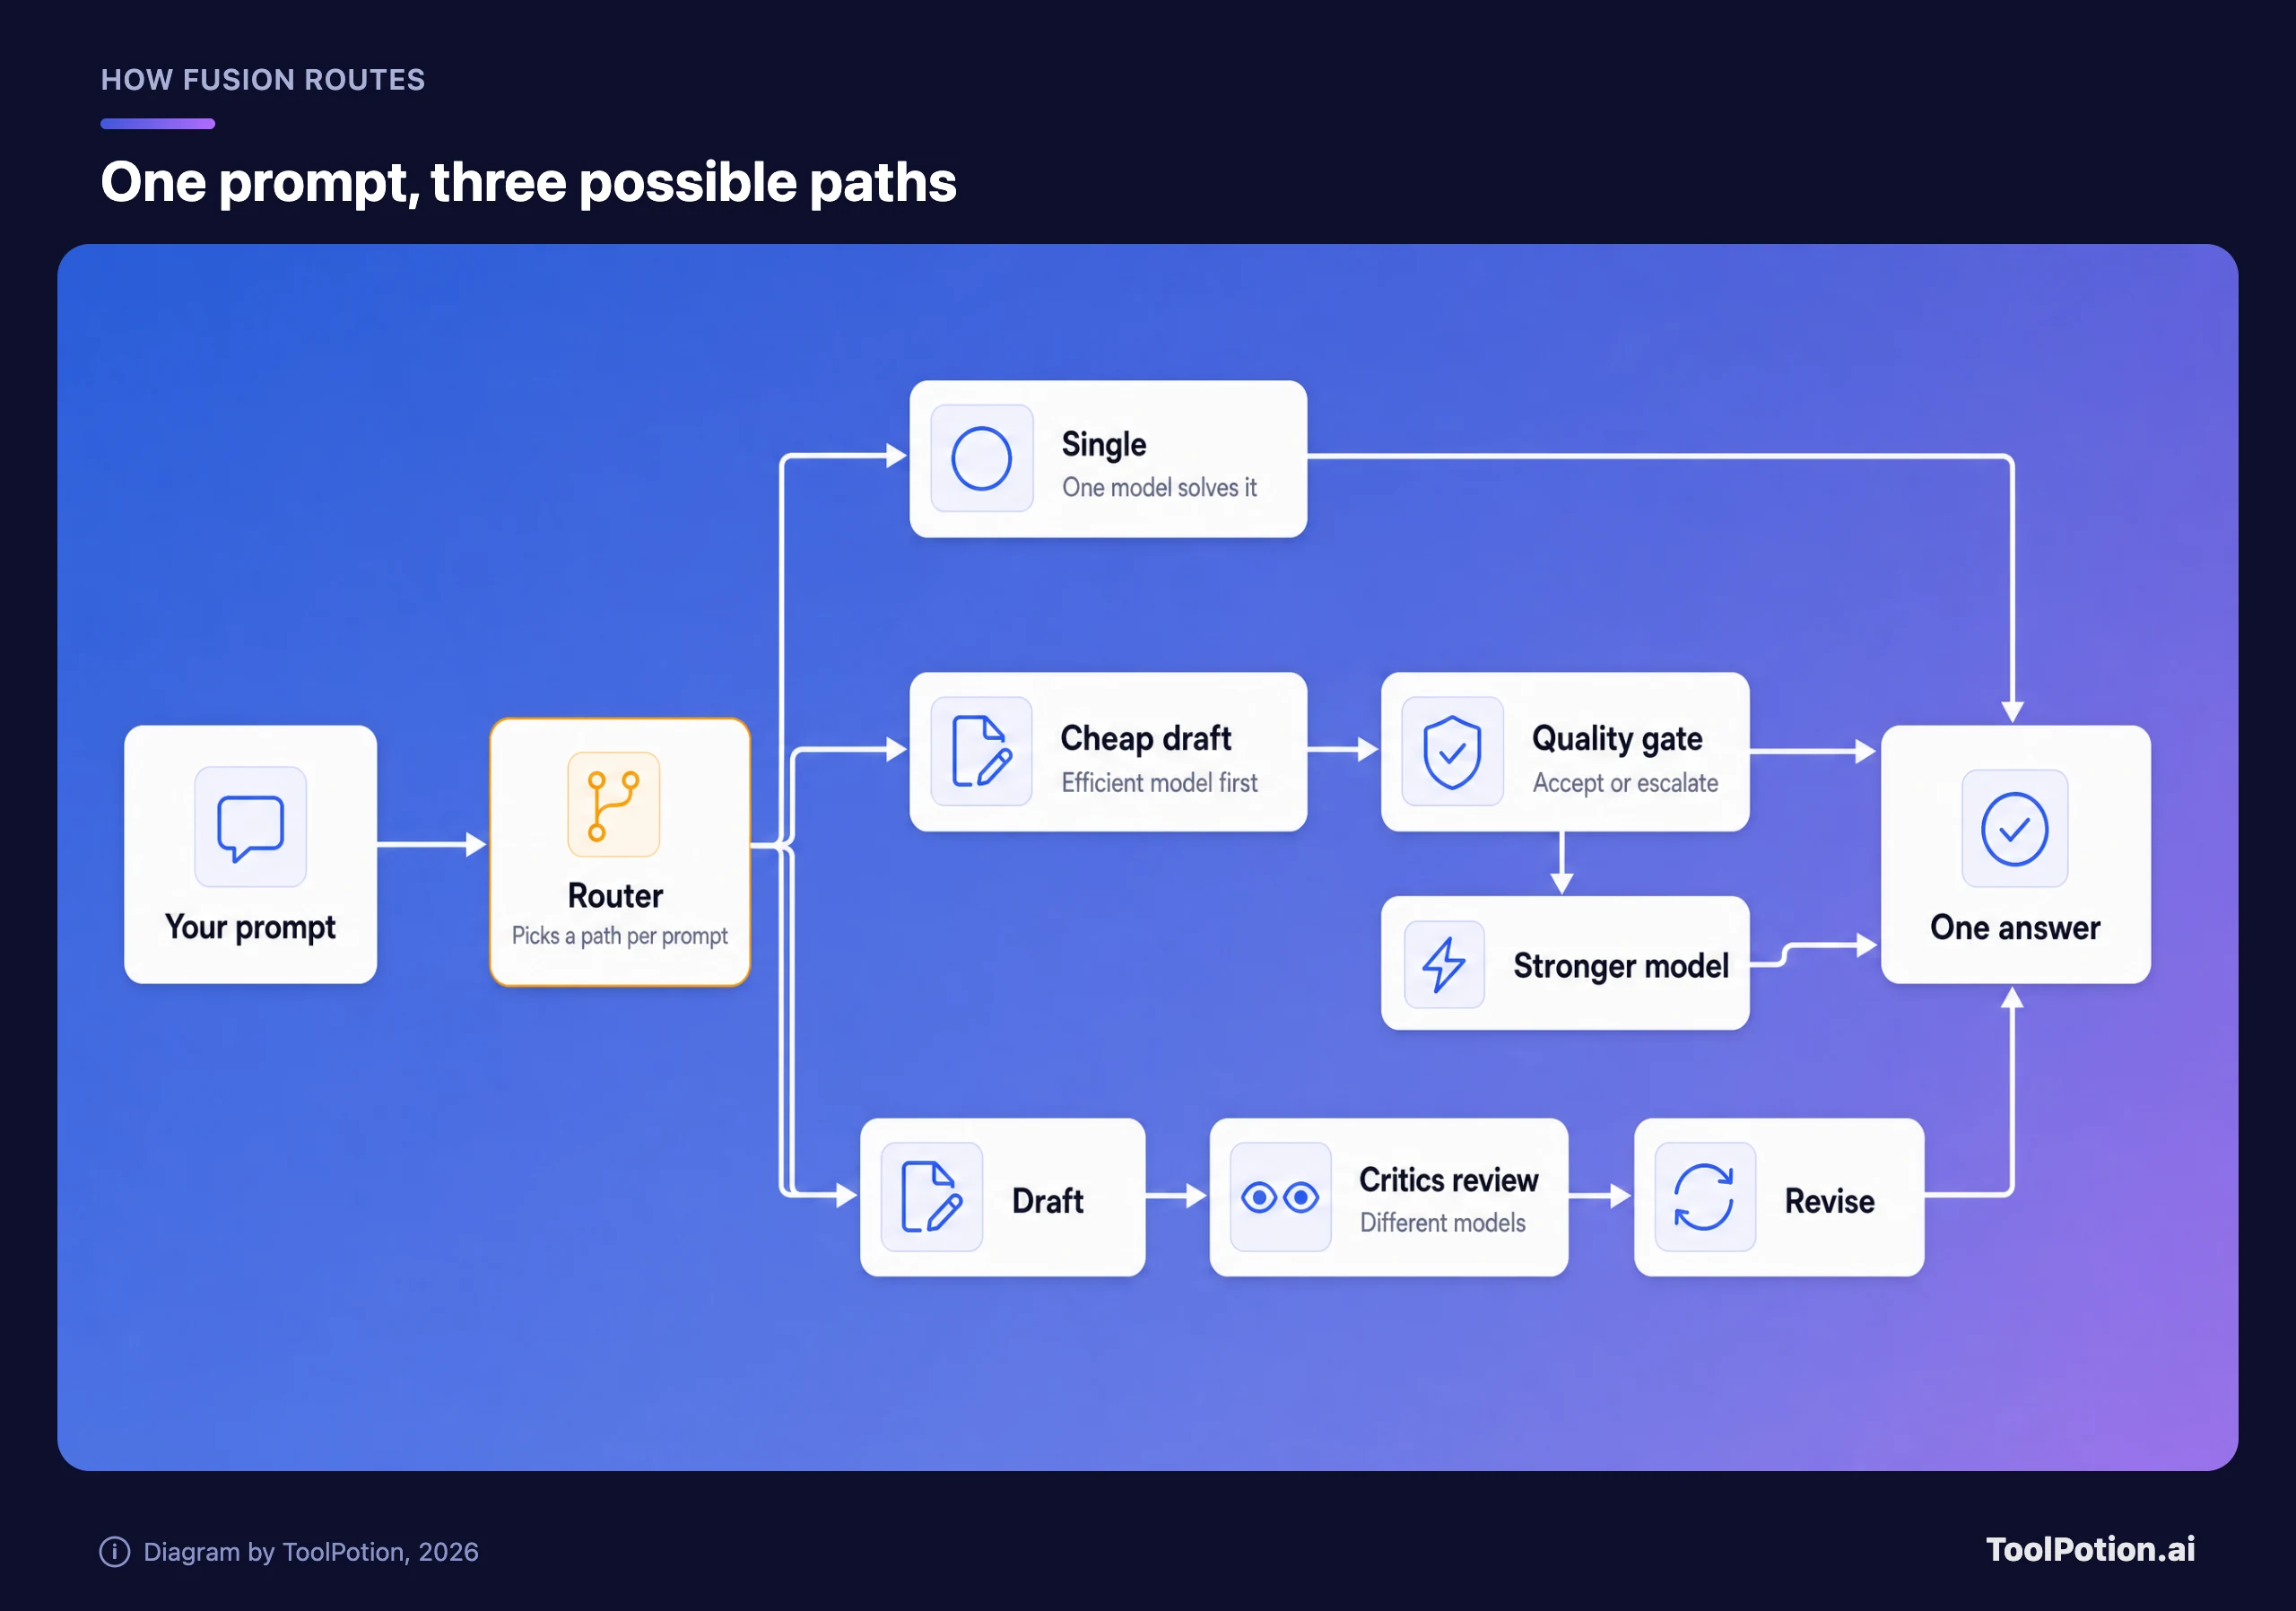
Single es un solo modelo que responde directamente. Cascade deja que un modelo eficiente redacte un borrador y luego un juez decide si lo acepta o lo escala a un modelo más potente. Critique hace que un modelo redacte mientras otros modelos lo revisan, y el redactor lo corrige. Los niveles de esfuerzo determinan lo agresivo que es el enrutamiento: Standard para el trabajo diario, High para tareas sustanciales, Max para el razonamiento más difícil.
Un detalle cambió entre la vista previa y el lanzamiento. La entrada anterior de GitHub sobre la vista previa de investigación describía "un crítico independiente de solo lectura de una familia de modelos distinta" (GitHub blog). El changelog del lanzamiento dice "otro modelo lo revisa", mientras que la documentación dice que varios modelos critican en paralelo y que sus comentarios se agregan. Nuestra lectura es que el paso de crítica pasó de un revisor a varios, pero GitHub no lo dice y el changelog no señala la diferencia.
Todos los planes lo incluyen, y pagas por modelo
El changelog dice que Fusion está disponible en todos los planes de Copilot en VS Code, la app de Copilot, Copilot CLI y los IDE de JetBrains, y que vendrán más clientes. Se te factura cada modelo que usa a la tarifa estándar de ese modelo, sin ningún cargo aparte por Fusion. Los planes de pago tienen un 30 % de descuento en el coste de los modelos durante un tiempo limitado, y la documentación sitúa el fin de ese descuento más adelante este año (docs).
Dos cabos sueltos. La documentación de Fusion dice que está "disponible con todos los planes de GitHub Copilot". La página de planes dice que en Free y Student el acceso a los modelos es solo mediante selección automática de modelo. GitHub no concilia ambas cosas. La tabla de niveles de esfuerzo por plan de la documentación marca la disponibilidad con iconos que, al leerla nosotros, aparecieron como celdas vacías, así que no podemos decirte qué niveles tienen los puestos Free y Student. Comprueba tu propio selector. Y como High y Max pueden llamar a varios modelos, la propia documentación avisa de que una tarea puede consumir más créditos de IA que en Standard. La mitad del coste por tarea es una afirmación sobre Max frente a Claude Code, no una promesa sobre tu saldo de créditos.
El benchmark es GitHub evaluando a GitHub
La entrada anterior sobre HydraFusion es más franca que el anuncio del lanzamiento. Sus pruebas se ejecutaron con el mismo nivel de razonamiento medio para todos los modelos, usaron costes estimados bajo supuestos de precios compartidos y se compararon con Opus 5 y GPT-5.6 Sol. GitHub también dice que ajustó la política de enrutamiento mediante búsqueda en haz (beam search) sobre los mismos tres benchmarks que luego reportó (GitHub blog).
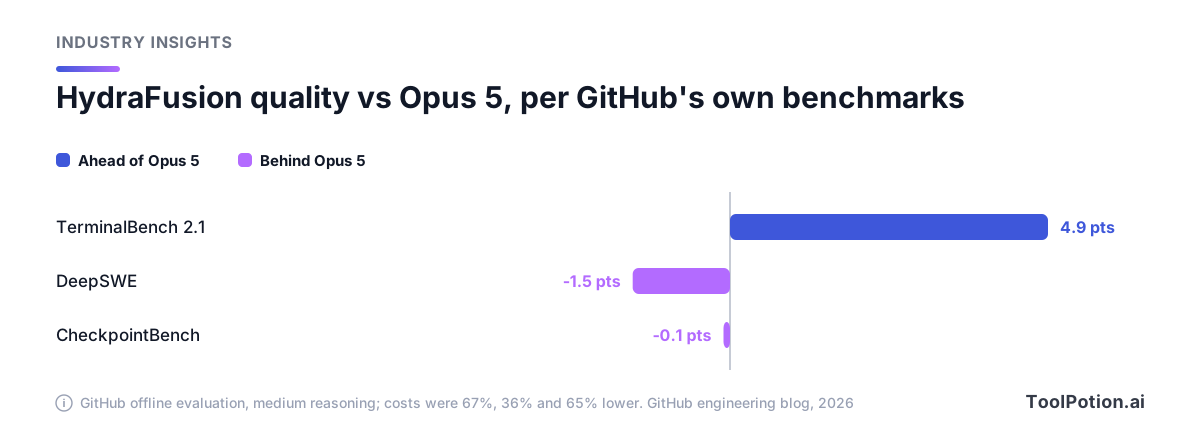
Fíjate en la forma. Un benchmark muestra una mejora de 4,9 puntos. Los otros dos muestran pequeñas pérdidas, con costes entre un 36 % y un 67 % menores. Es una historia de costes con la calidad más o menos igual, que es también lo que acabó diciendo el texto del lanzamiento.
Los desarrolladores de Hacker News fueron a por la línea base. Un comentarista escribió que "Opus 5 (en la práctica) no es una buena línea base con la que comparar" (HN). Otro dudó del resultado: "No cuesta mucho superar a la frontera en benchmarks concretos si metes software extra entre el modelo y el harness" (HN). Un usuario de Copilot CLI en el mismo hilo dijo que el modo auto "solo cambia de modelo al inicio de una sesión o tras la compactación" (HN), y otro calificó la selección automática de "básicamente inutilizable" para él (HN). Son comentaristas sueltos, no estudios. Pero sí muestran dónde está el escepticismo.
Hay además un desajuste de facturación que conviene tener en cuenta. El índice y la comparación de GitHub usan el coste de API de pago por token. Un desarrollador con una suscripción plana a Claude Code nunca ve esa cifra, así que "la mitad del coste" le llega de forma distinta a un usuario individual que a un equipo que mide su gasto de API. La propia Artificial Analysis señala que muchos usuarios acceden a estas herramientas mediante suscripciones y no con pago por token. La conclusión es inferencia nuestra, no una afirmación de GitHub, pero cambia a quién va dirigido el titular.
La única voz de cliente que aporta GitHub es la de Hari Pokhrel, de AT&T, citada en el propio changelog de GitHub: "Antes, los desarrolladores solían elegir un modelo más potente para una tarea compleja y olvidaban volver al anterior para las actividades cotidianas". Ese es el argumento honesto a favor de Fusion: evita que la gente deje un modelo caro activado para el trabajo rutinario.
Tu política decide quién lee tu diff
Esta es la parte que leeríamos antes que el benchmark. Fusion solo usa los modelos habilitados en las políticas de tu empresa y de tu organización. Los administradores pueden desactivar modelos concretos para Fusion sin desactivarlos en todas partes, y los modelos excluidos por políticas de residencia de datos o FedRAMP se dejan fuera (docs).
La revisión por un segundo modelo es la apuesta de diseño, y la entrada de la vista previa dice que ese revisor viene de una familia de modelos distinta. Si eso significa otro proveedor, ese proveedor ve tu diff, y esa es una decisión de tratamiento de datos que alguien de tu equipo debería tomar a propósito. Tras una respuesta, puedes pasar el cursor sobre la etiqueta de esfuerzo para ver qué modelos se ejecutaron.
La sección de limitaciones también importa. Si Fusion descarta un borrador, las ediciones de archivos que ese borrador ya hizo no se deshacen automáticamente, así que revisa el diff antes de hacer commit. Además, Fusion no tiene ventana de contexto propia: la cifra que se muestra es la más pequeña entre las de sus modelos.
Dónde lo pondríamos en una prueba de equipo
Ejecutaríamos Fusion Standard como opción por defecto para un equipo de Copilot, y no pondríamos Max por defecto. Su 60 en el índice independiente es respetable, pero Max es el nivel que llama a más modelos y gasta más créditos. Standard es donde vive la historia de AT&T y donde el enrutamiento ahorra más. Para los equipos que ya usan Claude Code o Codex, la cuestión del lock-in va en sentido contrario: esas herramientas están atadas a los modelos de un solo proveedor, mientras que Fusion es un router que controla GitHub y que puede reorganizar a su criterio. Ninguna de las dos opciones está libre de dependencia.
Nuestras comparativas existentes cubren las herramientas en sí: agentes de programación en terminal, Cursor frente a Copilot y Windsurf, cómo ajustar los niveles de modelo a las tareas y la lista más amplia de herramientas de programación. Fusion cambia la columna de costes en esas comparativas, no la herramienta que elegirías. Los usuarios de Cursor aún no tienen un veredicto equivalente, y el ranking de asistentes de programación de ToolRank es el lugar para ver cómo se ordena el sector ahora mismo.
La prueba que lo zanja es barata. Toma diez tickets reales, pásalos por Fusion Standard y por tu configuración actual, y cuenta los cambios aceptados y los créditos gastados. El descuento de GitHub se acaba más adelante este año, así que mide antes de que ocurra. Después vuelve a mirar la vista Router models en Artificial Analysis, porque las entradas de routers de ahí son las que probablemente se muevan.