

Una forma habitual de gastar de más en modelos de IA es elegir el mejor una sola vez y enviarle todo. En 2026 el nivel medio cuesta una fracción del superior, y los propios laboratorios admiten que la brecha de calidad se está estrechando.
La solución es el enrutamiento. Envía cada tarea al nivel más barato que la resuelva de forma fiable, escala cuando falle una comprobación y vuelve a bajar cuando las cosas se estabilicen. Esta guía te da las reglas, los precios verificados y dos herramientas para hacer tus propios cálculos.
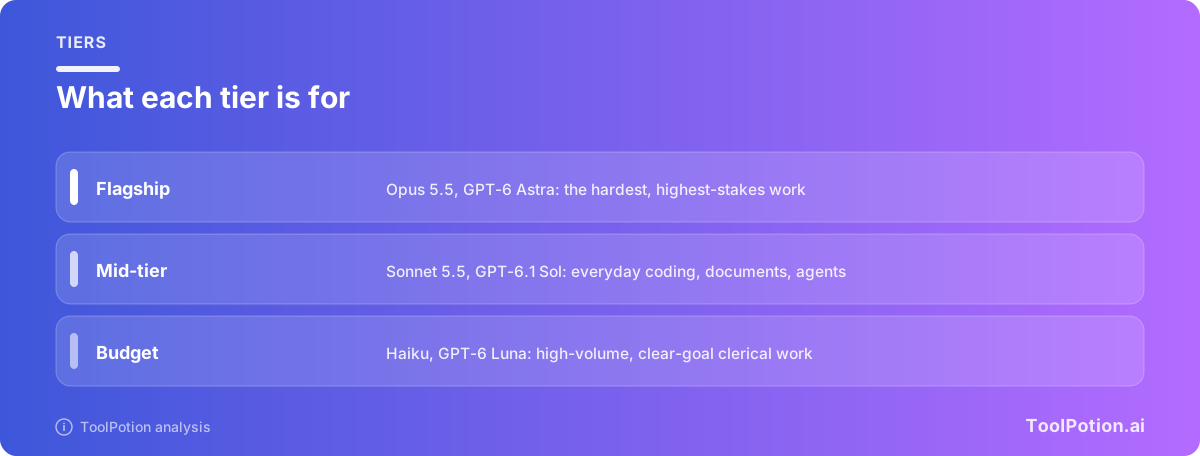
Hoy todos los grandes laboratorios venden más o menos los mismos tres escalones. Claude tiene Opus, Sonnet y Haiku. ChatGPT y la API de OpenAI ofrecen la familia GPT-6 con Astra, Sol y Luna. Google Gemini vende Flash y Flash-Lite por debajo de su modelo de frontera. Los nombres cambian cada pocas semanas. La decisión no, así que la construiremos en torno a tareas, no a marcas.
Tres escalones, y las diferencias entre ellos son enormes
Empecemos por el dinero, porque la diferencia es mayor de lo que mucha gente supone. Con las tarifas estándar actuales, el modelo más barato y el más caro de los que aparecen abajo difieren por un factor de 100 en tokens de salida. Ese es tu margen de maniobra.
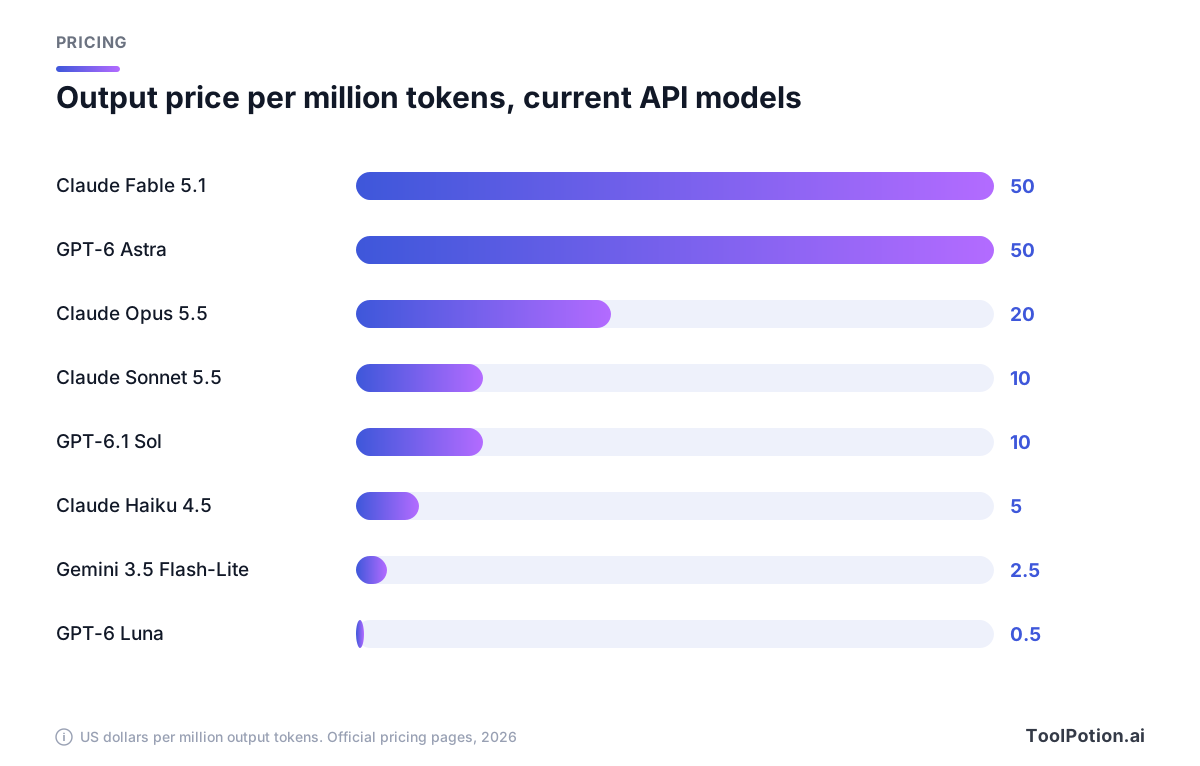
Las cifras salen directamente de las páginas de precios de los proveedores. Anthropic lista Opus 5.5 a 4 $ de entrada y 20 $ de salida por millón de tokens, Sonnet 5.5 a 2 $ y 10 $, y Haiku 4.5 a 1 $ y 5 $ (precios de Anthropic). OpenAI lista GPT-6 Astra a 10 $ y 50 $, GPT-6.1 Sol a 2 $ y 10 $, y GPT-6 Luna a 0,10 $ y 0,50 $ (precios de OpenAI). Google lista Gemini 3.5 Flash-Lite a 0,30 $ y 2,50 $, y su nuevo Gemini 3.8 Flash a 0,75 $ y 3,75 $ con una tarifa introductoria que sube en 2027 (precios de Google AI). Anthropic también vende un escalón premium por encima de Opus, Fable 5.1, a 10 $ y 50 $, que recomienda para razonamiento exigente y trabajo de agentes de largo recorrido (resumen de modelos de Anthropic).
Sonnet 5.5 cuesta la mitad que Opus 5.5 y una quinta parte que Fable 5.1. GPT-6.1 Sol cuesta una quinta parte que Astra. Los escalones económicos bajan todavía más, y una tarea que se ejecuta un millón de veces al mes nota esa diferencia en la primera factura.
Qué ha cambiado en los últimos diez días
Los precios y las gamas se han movido rápido, y parte de lo que encontrarás por ahí ya está desfasado. Aquí va la versión corta, con cada afirmación vinculada a su fuente.
Anthropic lanzó Claude Opus 5.5 y bajó su precio. Los tokens de salida cuestan ahora 20 $ por millón, frente a los 25 $ del Opus anterior (TechCrunch). Anthropic dice que el modelo rinde al nivel de su Fable 5.1, más grande, en la mayoría de tareas y que cuesta un 40 % menos de ejecutar que Opus 5 en cargas de trabajo típicas (Anthropic). También anunció que Sonnet 5.5 y Haiku 5.5 llegarían en las próximas semanas.
Después llegó Sonnet 5.5. Anthropic lo describe como significativamente más barato y un 30 % más rápido que su predecesor, con un consumo de tokens mucho menor (TechCrunch). Haiku 5.5 todavía no ha salido, así que el Haiku de la lista de precios de Anthropic hoy sigue siendo Haiku 4.5.
OpenAI respondió el mismo día que llegó Opus 5.5. GPT-6 Sol está pensado para tareas complejas, incluida la programación, y GPT-6 Luna para trabajo administrativo de alto volumen, como resumir documentos y extraer información (TechCrunch). OpenAI fijó la API a la mitad del precio de la serie 5.6, algo que atribuye a mejoras de caché e inferencia.
Una semana después llegó GPT-6.1 Sol. OpenAI asegura que casi iguala a GPT-6 Astra en programación con agentes, uso del ordenador y trabajo profesional, con una tasa de error a menos de un 1,9 % de la de Astra en distintos ajustes de razonamiento (TechCrunch). La diferencia de precio está en la página de precios de OpenAI: 2 $ y 10 $ frente a los 10 $ y 50 $ de Astra. La misma noticia cuenta que OpenAI no va a lanzar GPT-6.1 Astra, y que el Wall Street Journal lo atribuyó a preocupaciones de seguridad surgidas en pruebas internas, entre ellas más engaño y una tendencia a seguir adelante sin pedir permiso. The Verge también informa de que OpenAI dice haber frenado el modelo por temas de seguridad. Toma los detalles del WSJ como información reportada, ya que no hemos podido encontrarlos en ningún comunicado de OpenAI.
Gemini 4 Argon de Google es el que debes dejar fuera de tu lista corta. Google lo anunció, pero por ahora limita el acceso a un grupo de ciberdefensores de confianza (The Verge). No puedes enrutar trabajo a un modelo que no puedes llamar.
Por qué el nivel medio es ahora la opción por defecto
La regla de antes era simple: el flagship es el más listo, así que úsalo cuando importe la calidad y el barato cuando no. Esa regla suponía una gran brecha de capacidad. La brecha se está cerrando desde arriba, y los propios laboratorios lo reconocen.
La propia entrada de lanzamiento de Anthropic lo dice sin rodeos. Afirma que, con estos niveles de capacidad, los márgenes en los benchmarks son una guía menos fiable de las diferencias reales, y que la distancia entre Opus 5.5 y Fable 5.1 es menor de lo que sugieren sus puntuaciones (Anthropic). Cuando la empresa que vende el flagship te dice que los márgenes son difusos, hazle caso.
La afirmación más contundente es sobre agentes. Los benchmarks de Anthropic muestran a Sonnet 5.5 superando a Opus 5.5 en programación con agentes, y la hipótesis de TechCrunch es que el modelo más barato puede lanzar varios agentes sin superar los límites de coste (TechCrunch). Tómalo con la sal habitual: es una prueba del propio proveedor y la explicación es una inferencia de un periodista. Pero el mecanismo es plausible y puedes aprovecharlo. El dinero compra intentos en paralelo, y varios intentos más una comprobación suelen superar a un único intento caro.
Eso convierte al nivel medio en un hogar sensato para agentes de programación como Claude Code, Codex in ChatGPT, Cursor, Gemini CLI y GitHub Copilot, donde los bucles largos multiplican cada dólar extra por millón de tokens. Los flagships siguen justificando su precio, pero en un terreno más acotado. Un contrapunto: la documentación de modelos de Anthropic dice que empieces con Opus 5.5 para la mayoría de cargas y subas a Fable 5.1 solo cuando las evaluaciones con mayor esfuerzo se queden cortas (resumen de modelos de Anthropic). A 4 $ y 20 $, Opus 5.5 ya no tiene precio de lujo, así que trátalo como el techo de tu rango habitual y prueba Sonnet 5.5 frente a él.
Enruta por volumen, complejidad, riesgo y latencia
Cuatro preguntas colocan casi cualquier tarea. Hazlas en este orden y detente cuando una te dé una respuesta clara.
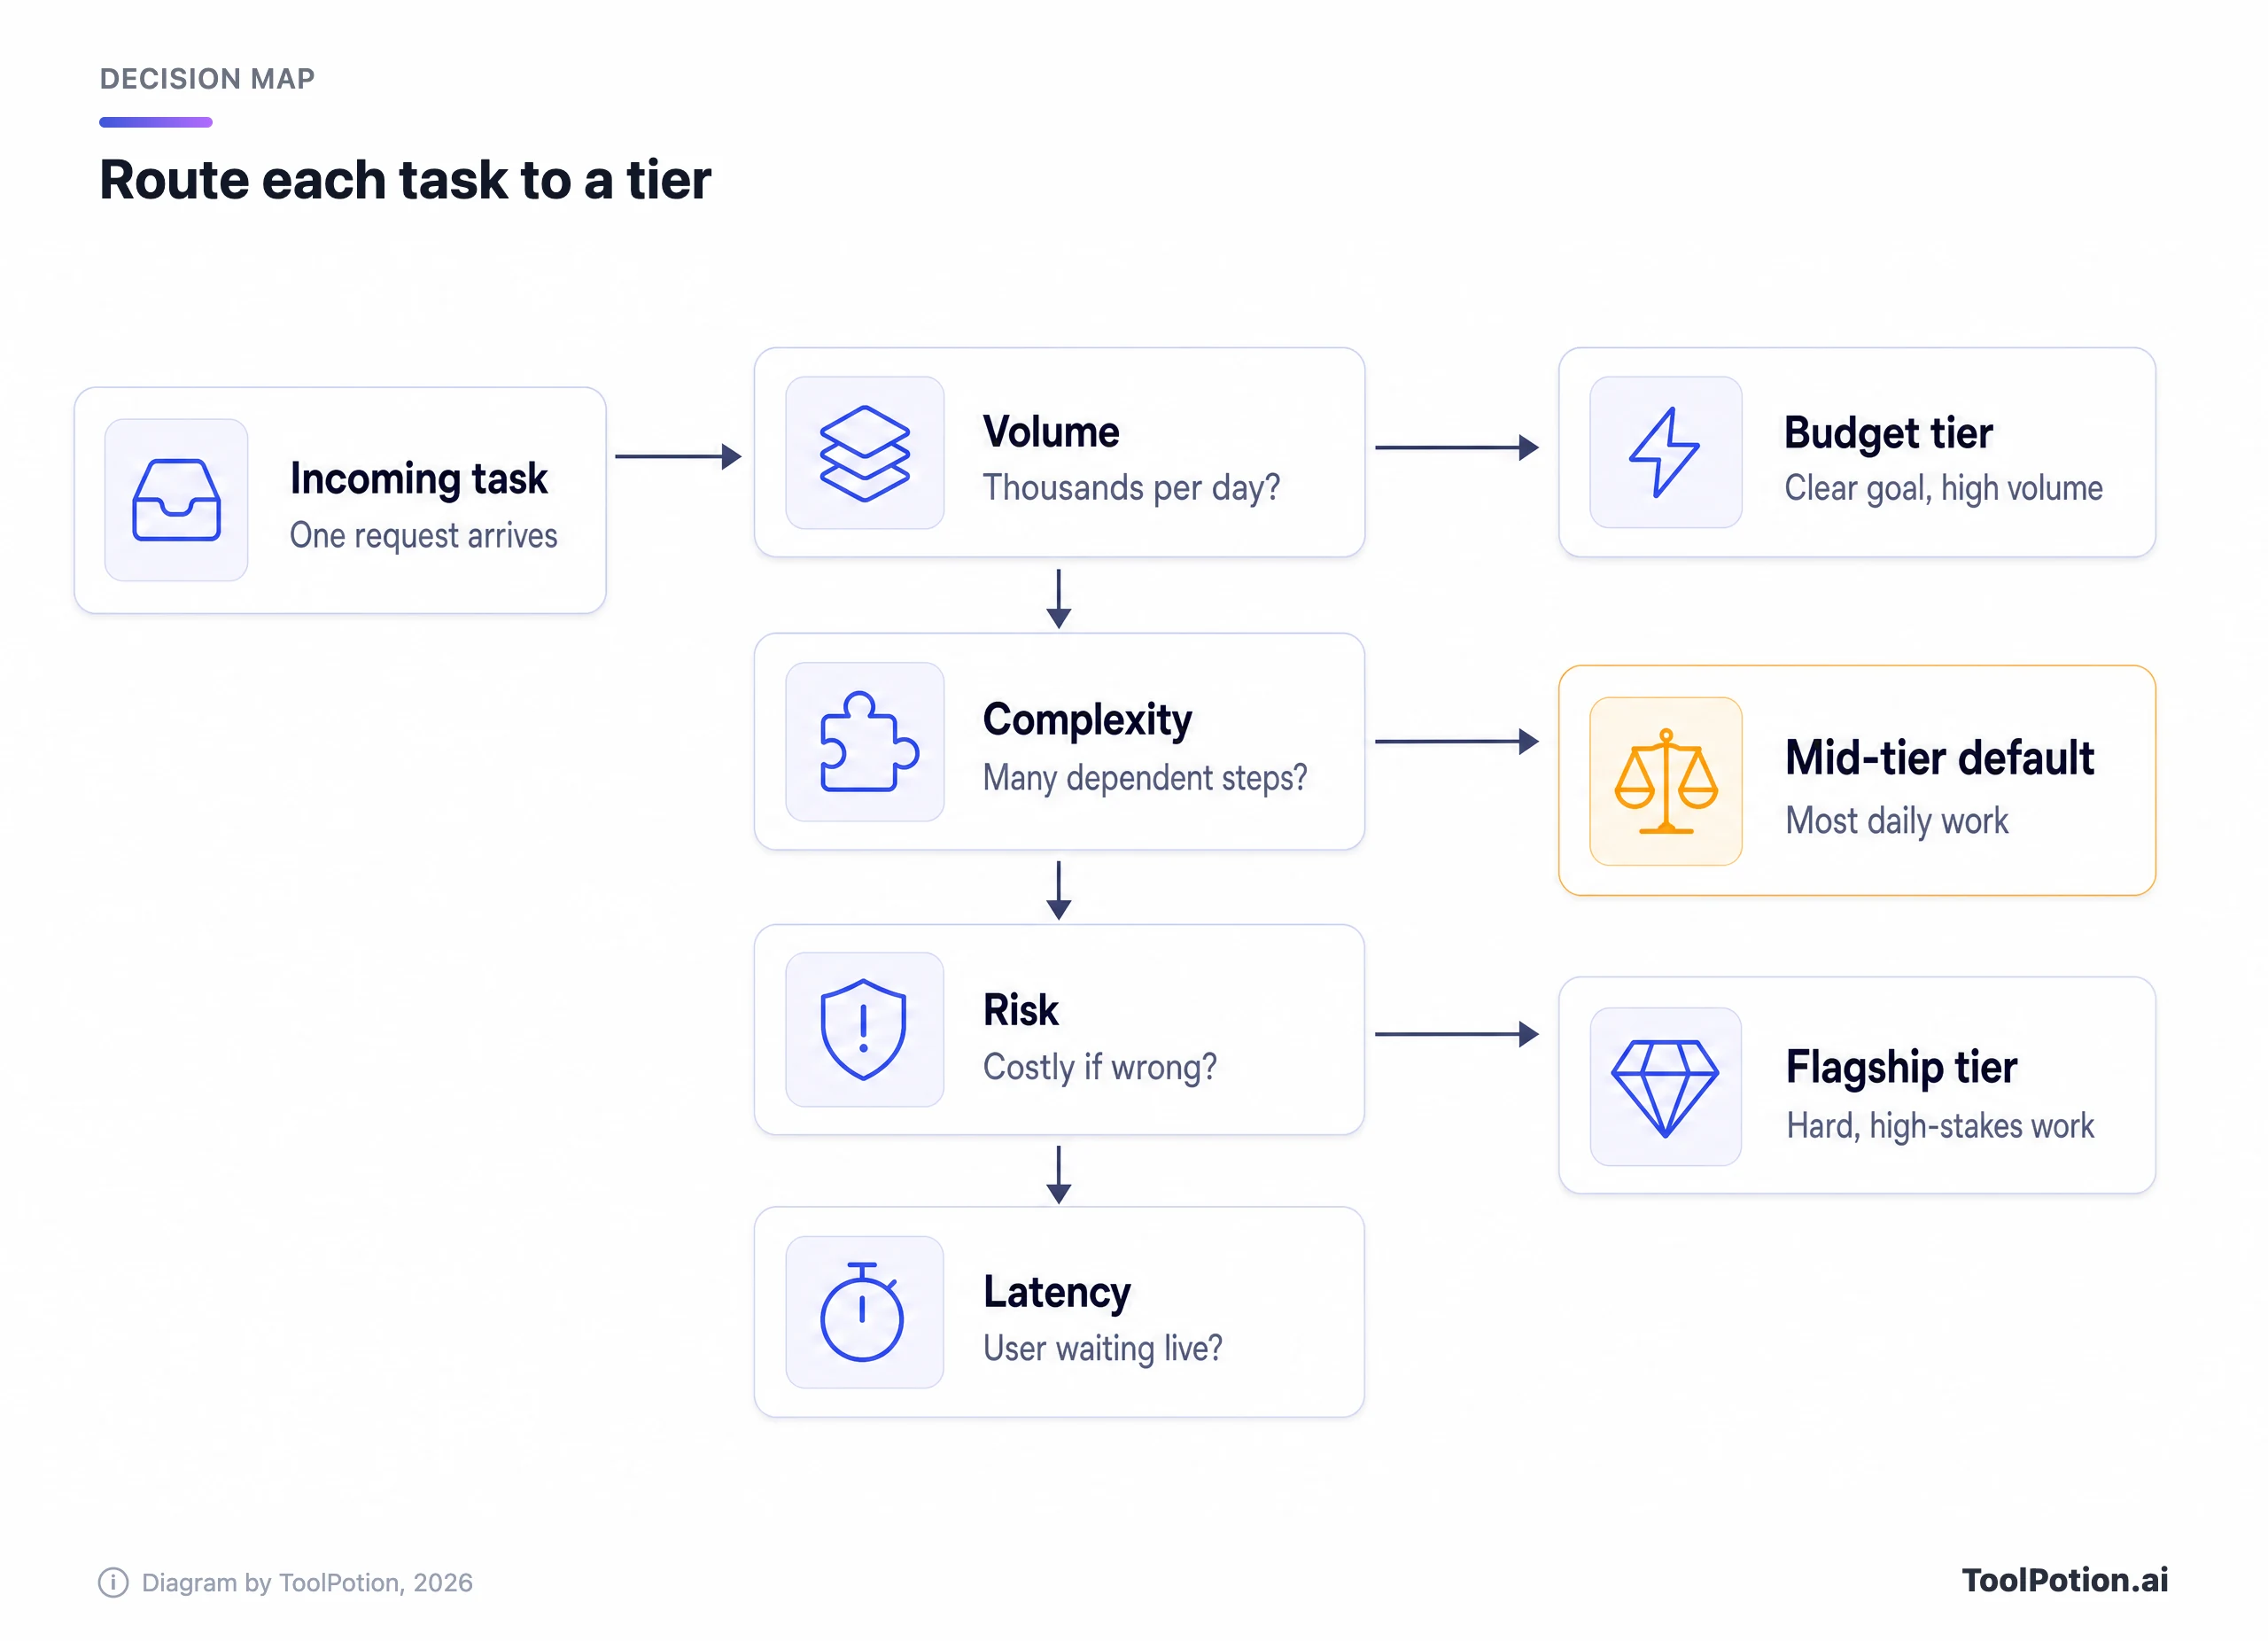
El volumen va primero porque es donde está el dinero. Una tarea que se ejecuta miles de veces al día, con un objetivo claro y una comprobación fácil, pertenece al nivel económico. OpenAI describe Luna como pensado justo para ese tipo de trabajo, y Anthropic presenta Haiku como su modelo más pequeño.
La complejidad decide si el nivel económico aguanta. Las cadenas largas de pasos dependientes, las instrucciones vagas y los repositorios grandes te empujan al nivel medio. El riesgo decide hasta dónde subir. Si una respuesta errónea cuesta dinero real, exposición legal o un cliente, el flagship es un seguro barato para esa llamada concreta. La latencia es el desempate. Alguien que espera una respuesta en directo puede valorar más la velocidad que una mejora marginal de calidad, y Anthropic dice que Sonnet 5.5 es un 30 % más rápido que su predecesor.
La regla de defecto, escalar y bajar
Conviértelo en una política escrita para que nadie discuta en cada pull request.
- Asigna por defecto toda tarea nueva al nivel medio.
- Baja una tarea al nivel económico solo cuando el objetivo sea claro, el volumen alto y puedas comprobar las salidas automáticamente.
- Sube una tarea al nivel flagship solo cuando un error sea caro o el nivel medio falle tus comprobaciones con ejemplos reales.
- Revisa las asignaciones cada vez que un laboratorio lance un nuevo nivel, lo que en 2026 significa cada pocas semanas.
Escala cuando falle y baja cuando todo esté estable
Las asignaciones estáticas se quedan viejas. Un bucle de enrutamiento lo arregla y no necesita mucha infraestructura. Necesitas una primera pasada barata, una forma de verificar y una regla para cuando algo falla.
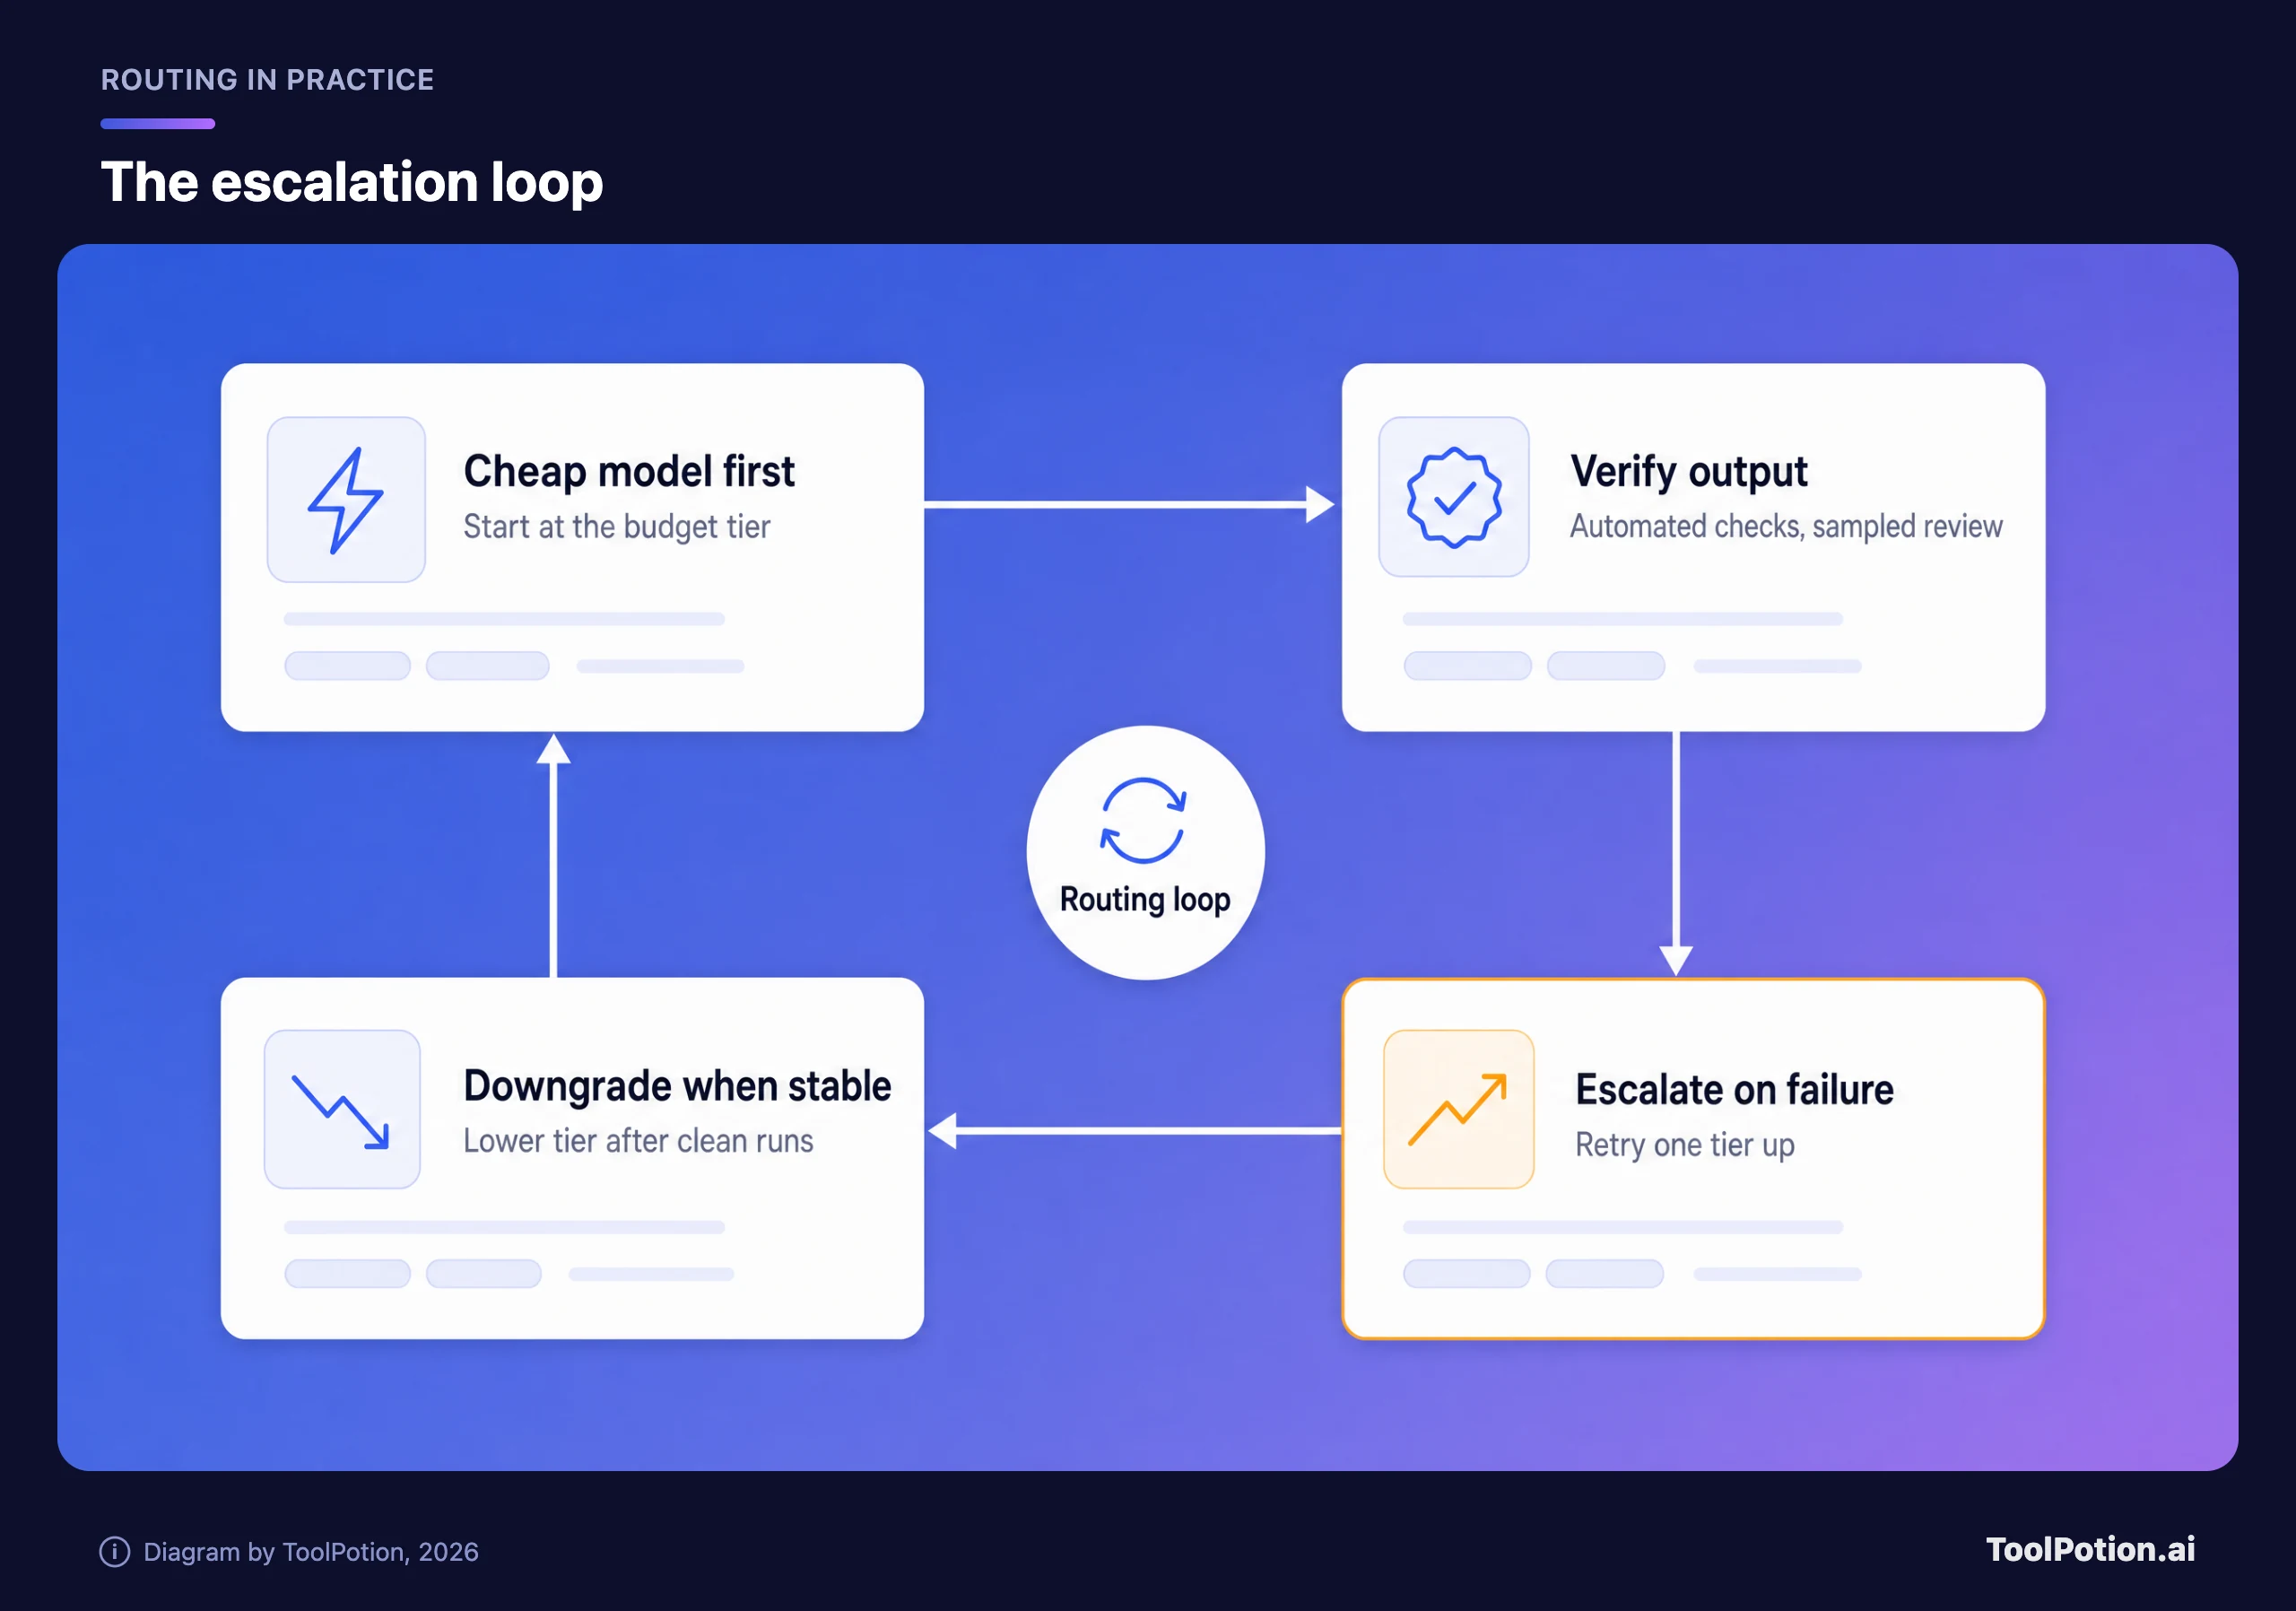
La verificación es la parte que los equipos se saltan. Con salidas estructuradas es fácil: valida el esquema JSON, comprueba que los campos extraídos aparecen en el origen, ejecuta los tests unitarios. Con texto en prosa es más difícil, así que revisa a mano una muestra pequeña y vigila la tasa de fallos en lugar de cada salida. Un modelo también puede evaluar el trabajo de otro, pero es un juez ruidoso: úsalo para marcar candidatos para una persona, no para aprobarlos.
Cuando falle una comprobación, reintenta una vez un nivel más arriba. Registra el fallo y el tipo de tarea. Tras una racha de ejecuciones limpias, prueba el nivel inferior con una parte del tráfico y mira si la tasa de fallos se mantiene. Así descubres, con tus propios datos, qué tareas resuelve de verdad el nivel económico. Los benchmarks de los proveedores no te lo dicen.
Una advertencia sobre el coste. Los reintentos también cuestan dinero. Si más de una pequeña parte de las llamadas del nivel barato escala, estás pagando dos veces y el bucle está perdiendo. Controla la tasa de escalado. Si sube, esa tarea debe pasar al nivel superior de forma permanente.
Dónde encajan las tareas habituales
Nuestra clasificación de abajo es editorial, no un benchmark. Refleja la lógica de volumen y capacidad de arriba, y deberías mover cualquier punto con el que tus propias pruebas no estén de acuerdo.
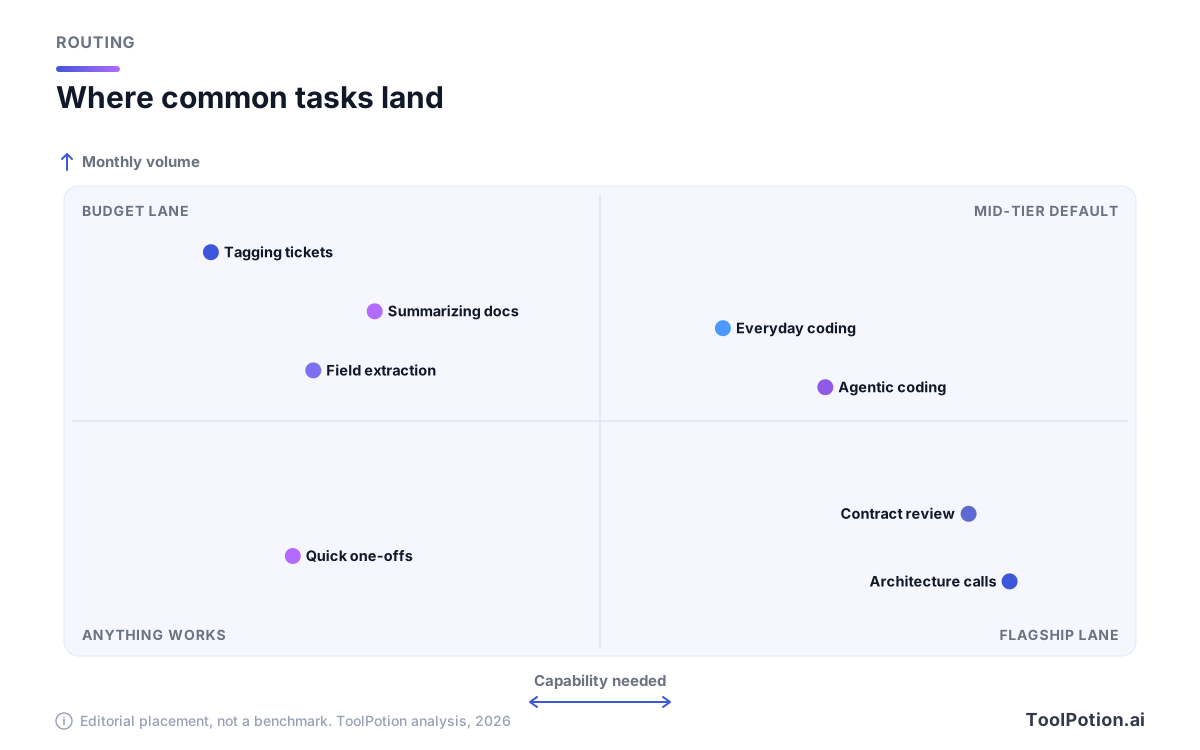
Conviene detallar algunos casos. Etiquetar, extraer campos y resumir son los trabajos clásicos del nivel económico, y los laboratorios orientan sus niveles más baratos a ellos. La programación cotidiana y la redacción de documentos van en el nivel medio. La revisión de contratos, las decisiones de arquitectura y cualquier caso en el que un error salga caro justifican el flagship, aunque incluso ahí puedes usarlo como revisor en lugar de autor.
| Tarea | Empezar en | Escalar cuando | Por qué |
|---|---|---|---|
| Etiquetado de tickets | Económico | Más de un pequeño porcentaje falla la validación | Alto volumen, respuesta clara, comprobación fácil |
| Resúmenes de documentos | Económico o medio | Los resúmenes omiten datos clave en las revisiones por muestreo | Riesgo bajo por elemento, gran volumen total |
| Respuestas a clientes | Medio | Errores de tono o de política llegan a los clientes | Errores visibles, volumen moderado |
| Programación cotidiana | Medio | Los tests fallan tras dos intentos | El nivel medio es el punto óptimo para agentes |
| Agentes de varios pasos | Medio, con límites | Falla un paso de verificación | Intentos en paralelo con tope de coste |
| Contratos, finanzas, seguridad | Flagship | Pocas veces; mejor añadir revisión humana | Los errores son caros |
Haz tus propios cálculos
Aquí tienes la aritmética para un laboratorio, con las tarifas de Anthropic citadas arriba. Introduce lo que gastarías con todo en Opus 5.5 y luego ve pasando trabajo a Sonnet 5.5 y Haiku 4.5. El gasto y los dos porcentajes los editas tú. Las tarifas son fijas, y como Sonnet 5.5 es exactamente la mitad de Opus 5.5 tanto en entrada como en salida y Haiku 4.5 es la cuarta parte, el resultado no depende de tu mezcla de entrada y salida.
Con los valores por defecto, un equipo que gasta 3.600 $ al mes con todo en Opus 5.5 baja a unos 2.070 $ al pasar el 40 % del trabajo a Sonnet y el 30 % a Haiku (el 30 % de 3.600 $ se queda a precio completo, el 40 % a la mitad y el 30 % a una cuarta parte). Es un ahorro de aproximadamente el 43 %, con el 30 % más difícil del tráfico todavía en el flagship. Las facturas reales varían porque la caché, los descuentos por lotes y los reintentos cambian las cuentas, así que usa esto como herramienta de dimensionamiento.
Si no tienes claro por dónde empezar con una tarea concreta, el árbol de abajo te hace tres preguntas rápidas.
Los planes por asiento cambian la pregunta
Todo lo anterior supone que pagas por token. Si tu equipo paga por asiento una app de chat o una herramienta de programación, el laboratorio decide el nivel por ti y tu palanca es otra. Anthropic subió los límites de uso de cinco horas en sus planes Pro, Max, Team y Enterprise por asiento junto con el lanzamiento de Opus 5.5 (Anthropic). En la práctica, quienes usan asientos deberían elegir la opción de nivel medio en el selector de modelos para el trabajo rutinario, reservar el flagship para las sesiones difíciles y comprobar cómo tratan los límites de uso de su plan a cada modelo.
Si no sabes qué modelo de facturación usan tus herramientas, nuestra guía de modelos de precios de herramientas de IA explica los créditos, los asientos y los tokens. Una pasarela como OpenRouter merece un vistazo cuando quieres una sola integración que pueda cambiar de nivel y de laboratorio sin tocar código, ya que toda la idea del enrutamiento depende de poder cambiar barato.
Errores que mantienen alta la factura
- Elegir un nivel por fidelidad a una marca y no volver a probar tras un lanzamiento.
- Juzgar un nivel con un solo ejemplo difícil en vez de una muestra de tu tráfico real.
- Enviar contextos largos al flagship cuando bastaría un modelo más barato con recuperación.
- Saltarse la caché. Anthropic fija las lecturas de caché de Opus 5.5 en 0,20 $ por millón de tokens, lo que importa en bucles de agentes que reenvían el mismo contexto.
- Tratar los benchmarks de los proveedores como una previsión de tus propios resultados.
Los prompts también importan. Un prompt bien construido permite que un nivel más barato resuelva tareas que uno descuidado empuja hacia arriba, y nuestro artículo sobre patrones de prompts que sobreviven a las actualizaciones de modelos explica cómo mantener ese trabajo portable. Para una visión más amplia de los modelos que existen, consulta nuestra comparativa de los mejores modelos de IA y LLM y el ranking en vivo de los Top 20 LLMs. Si lo que buscas es sobre todo un asistente de chat y no una API, el ranking de chatbots de IA y nuestra guía de los mejores chatbots de IA cubren ese terreno, y el ranking de asistentes de programación con IA y el resumen de asistentes de programación hacen lo mismo para desarrolladores. Si te planteas ejecutar los modelos tú mismo, IA local frente a IA en la nube explica cuándo compensa.
Preguntas frecuentes
¿Qué modelo de IA debería usar si solo puedo elegir uno?
Elige el nivel medio del laboratorio que ya use tu stack. Los modelos de la clase de Sonnet 5.5 o GPT-6.1 Sol cubren el abanico más amplio de trabajo a un coste moderado, y más adelante puedes añadir un nivel más barato o más potente donde los datos lo justifiquen.
¿Merece la pena pagar alguna vez por el flagship?
Sí, en el conjunto reducido de llamadas donde un error sale caro o donde el nivel medio falla tus comprobaciones con ejemplos reales. Es una herramienta de precisión, no una opción por defecto.
¿Puede un modelo de nivel medio superar a un flagship?
Los benchmarks de Anthropic muestran a Sonnet 5.5 por delante de Opus 5.5 en programación con agentes. Es un resultado del proveedor en un solo tipo de tarea, así que pruébalo con tu propio trabajo antes de mover un flujo crítico.
¿Debería esperar a Haiku 5.5 o a Gemini 4 Argon?
No te bloquees por ninguno. Anthropic ha dicho que Haiku 5.5 llegará en las próximas semanas, y Google ha limitado Argon a ciberdefensores de confianza por ahora y no lo ha hecho disponible de forma general. Construye la capa de enrutamiento de modo que añadir un nivel nuevo sea un cambio de configuración, y vuelve a ejecutar tus pruebas cuando salgan.
¿Cómo sé si un nivel más barato es suficientemente bueno?
Ejecútalo sobre una muestra de entradas reales, aplica una comprobación automática y compara la tasa de fallos con la del nivel superior. Si la diferencia es pequeña y la tarea es de bajo riesgo, baja de nivel. Si los fallos llegan a los clientes, no lo hagas.
¿Estos precios se aplican a las suscripciones de chat?
No. Son tarifas de API por millón de tokens. Los planes de chat y las herramientas de programación facturan por asiento o por límite de uso, así que el ahorro viene de elegir modelos más ligeros para las sesiones rutinarias.