

Los patrones de ingeniería de prompts que sobreviven una actualización de modelo son los que llevan información que el modelo no puede inferir: un rol que define la audiencia, contexto que no posee, una tarea con una regla de decisión y un contrato de salida aplicado fuera del prompt. Todo lo demás es folclore con fecha de caducidad.
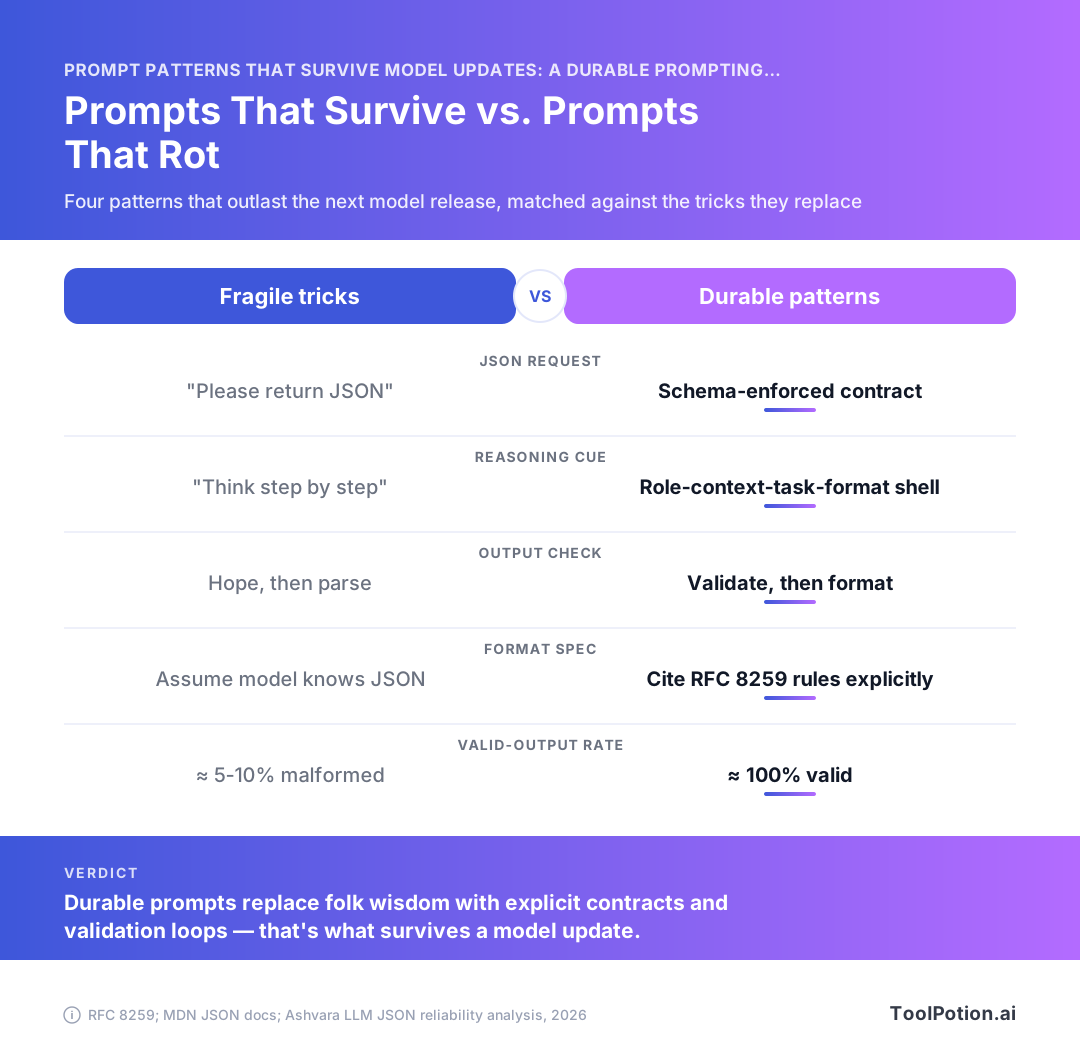
La diferencia se ve con mayor claridad en JSON. Pedirle amablemente a un modelo que devuelva JSON deja aproximadamente un 5-10% de salidas malformadas, el modo JSON te lleva a alrededor de un 95-99% de validez, y la decodificación restringida por esquema es efectivamente el 100% (Ashvara). Misma intención, tres capas de aplicación, tasas de fallo radicalmente distintas el día del lanzamiento.
Este manual cubre cuatro patrones que siguen funcionando en Claude, GPT y Gemini, los trucos frágiles que vale la pena eliminar de tu biblioteca, y una pequeña suite de evaluación que convierte el próximo lanzamiento de modelo en un diff en lugar de un incidente.
Por qué los prompts se pudren: el modo de fallo que nadie versiona
Los prompts no se degradan al azar. Se degradan a lo largo de una línea predecible: las partes que dependen de cómo se comportó un modelo específico quedan invalidadas por el siguiente checkpoint, y las partes que establecen lo que quieres sobreviven.
Dos tipos de prompt: los que describen intención y los que explotan una peculiaridad
Un prompt de intención dice qué debe ser la salida, quién la lee y qué se considera un error. Un prompt de peculiaridad dice lo que casualmente funcionó el martes pasado. SOLO DEVUELVE JSON en mayúsculas. Tres repeticiones de la misma instrucción porque dos no fueron suficientes. Un preámbulo mágico copiado de un hilo de foro. Esos trucos se ajustaron al comportamiento de decodificación de un checkpoint específico, y nada en ellos le dice a un modelo futuro lo que realmente necesitas.
El prompting ingenuo de "por favor devuelve JSON" sigue produciendo un estimado de 5-10% de salidas malformadas (Ashvara), y ese número es una propiedad del modelo, no de tu prompt. Cambia el modelo y el número cambia. Nunca escribiste el contrato, así que no tienes nada con qué responsabilizar al nuevo modelo.
Qué se rompe realmente el día del lanzamiento
La rotura rara vez es ruidosa. Tu parser empieza a fallar con una coma final (aproximadamente el 40% de los errores de JSON en un análisis provienen exactamente de eso, Flying Fish Space), o el modelo se vuelve más conversacional y envuelve la salida limpia en una frase de preámbulo. Mientras tanto, el ritmo de nuevos lanzamientos de modelos significa que el checkpoint que ajustaste puede no ser el que sirva el tráfico el próximo trimestre.
Compara eso con una llamada restringida por esquema, donde la generación está limitada a la forma que suministraste y la validez sintáctica es esencialmente del 100% (Ashvara). La aplicación vive fuera del texto del prompt. Una actualización de modelo puede cambiar el tono, la verbosidad y la profundidad de razonamiento sin afectarla.
La prueba de durabilidad: ¿este prompt seguiría teniendo sentido para un modelo más inteligente?
Una pregunta, aplicada a cada prompt que posees: si el modelo fuera dos veces más capaz de la noche a la mañana, ¿esta instrucción seguiría haciendo un trabajo útil?
"Devuelve un objeto con las claves id, status y confidence, donde status es uno de tres valores literales" pasa. El RFC 8259 ya fija el vocabulario que estás usando: cuatro tipos primitivos, dos tipos estructurados y exactamente tres nombres literales en minúsculas (RFC 8259). Esa instrucción es legible para cualquier modelo, ahora o en el futuro. "Respira profundo y piensa paso a paso" falla, porque está compensando una debilidad que la próxima versión puede no tener. Elimina las compensaciones y conserva los contratos.
Patrones de ingeniería de prompts que se transfieren: rol, contexto, tarea, formato
Reestructura cada prompt ad hoc en cuatro ranuras, y pon solo la información que el modelo no puede inferir en cada una. Rol, contexto, tarea, formato. El shell sobrevive las actualizaciones de modelo porque cada ranura lleva hechos sobre tu problema, no folclore sobre cómo respondía el checkpoint del trimestre pasado a los halagos.
Las cuatro ranuras y qué corresponde a cada una
Rol es para quién es la salida y qué nivel de experiencia asume la respuesta. "Eres un experto de clase mundial" establece un estado de ánimo y no aporta información. "Estás escribiendo para un ingeniero de pagos que ya sabe qué es una clave de idempotencia" le dice al modelo qué explicaciones puede omitir.
Contexto es todo lo que el modelo no tiene forma de saber: el esquema, el sistema upstream, los casos extremos que ya has encontrado en producción, el hecho de que tu parser rechaza un BOM UTF-8. Tarea es el único verbo y su objeto. Formato es el contrato de salida, y debe ser lo suficientemente específico para validarse mecánicamente.
Una ranura de formato que dice "devuelve JSON" es un deseo. Una ranura de formato que nombra las claves, sus tipos y qué sucede cuando se desconoce un valor es un contrato que puedes probar. JSON te da cuatro tipos primitivos (string, number, boolean, null) y dos tipos estructurados, objetos y arrays (RFC 8259), por lo que hay un vocabulario finito pequeño para ser preciso. Usa null en lugar de "déjalo en blanco", porque los nombres literales true, false y null están en minúsculas y nada más es válido (RFC 8259).
Por qué el shell se transfiere entre Claude, GPT y Gemini
Nada en las cuatro ranuras depende de un tokenizador, una peculiaridad del system prompt o una feature flag de un proveedor. A todo modelo hay que decirle qué campos quieres y qué hace tu código downstream con ellos, así que el mismo shell encaja en Claude, GPT y Gemini sin reescritura. Esa portabilidad también es lo que lo hace actualizable: cuando llega un nuevo checkpoint, la ranura de contexto sigue siendo verdadera y la ranura de formato sigue siendo el contrato que tu validador aplica. Cambias el modelo, vuelves a ejecutar las evaluaciones y el diff está vacío.
La mayoría de las 212 herramientas de ingeniería de prompts que estructuran esta plantilla en nuestro directorio te venden las ranuras como un formulario. Puedes obtener el mismo efecto con un heredoc y cuatro comentarios.
Escribir restricciones como hechos, no como conjuros
Hay una prueba para saber si una línea pertenece a tu prompt: ¿podría un contratista competente actuar sobre ella sin hacer una pregunta de seguimiento? "Sé exhaustivo" falla. "Los nombres de propiedades están entre comillas dobles, sin coma final después del último elemento" pasa, y se corresponde con modos de fallo reales, ya que las comas finales por sí solas representan aproximadamente el 40% de los errores de JSON en un análisis (Flying Fish Space).
Un conjuro deja de ganar sus tokens sin nunca fallar ruidosamente, mientras que un hecho declarado mantiene su significado en cada checkpoint al que lo apuntes.
Una reescritura antes/después trabajada
| Antes (ad hoc) | Después (cuatro ranuras) |
|---|---|
| "Eres un experto analista de datos. Extrae cuidadosamente los detalles de la factura y devuelve JSON. ¡Sé preciso!" | Rol: la salida es consumida por una llamada Python json.loads, ningún humano la lee. Contexto: las facturas son PDFs con OCR; los nombres de proveedores suelen estar truncados; los importes pueden llevar símbolo de moneda. Tarea: extraer vendor, invoice_number, total_cents, issued_date. Formato: un objeto JSON, claves exactamente como se indican, total_cents un entero sin ceros iniciales, valores desconocidos como null, sin prosa antes ni después. |
La versión posterior no dice nada sobre la personalidad del modelo y todo sobre tus datos. Ten en cuenta que null y {} son ambos JSON válido pero significan cosas distintas (Jsonic), así que elige uno y escríbelo. Los ceros iniciales tampoco son válidos en los números JSON (MDN), por eso la ranura de formato especifica la regla del entero en lugar de confiar en que el modelo recuerde la gramática.
Estructuras de few-shot ajustadas para la transferencia
Elige ejemplos por la ambigüedad que resuelven. Un bloque de few-shot que demuestra cuatro casos donde un humano dudaría enseña algo que el siguiente modelo también necesita. Un bloque que muestra cuatro casos fáciles en un estilo de casa enseña tono, y el tono es lo que cada checkpoint mejora cada vez más por su cuenta.
Ejemplos que enseñan el límite de decisión, no el vocabulario
Antes de pegar un ejemplo, pregúntate qué cambiaría si lo eliminaras. Si la respuesta es "la salida suena un poco menos a nosotros", elimínalo. Si la respuesta es "el modelo clasificaría un reembolso con envío parcial como devolución en lugar de disputa", consérvalo, porque esa decisión no se puede derivar de la descripción de la tarea.
La misma prueba se aplica a la forma de la salida. Un ejemplo que muestra un resultado vacío como [] en lugar de null vale más que cinco ejemplos de resultados poblados, ya que un array vacío y null son ambos JSON válido y significan cosas distintas (Jsonic). Los modelos hacen suposiciones distintas al respecto, y un ejemplo lo resuelve definitivamente.
Los casos extremos y los negativos justifican su coste en tokens
Dos o tres de tus ejemplos deberían ser casos que fallaste en producción. El campo que falta. La entrada que ya está en el formato de destino. El registro donde la respuesta correcta es "datos insuficientes" y un modelo servicioso inventará un valor en su lugar.
Los negativos funcionan cuando los empareja con la corrección en lugar de establecer una prohibición. Muestra la salida malformada y la corregida una al lado de la otra, y el límite es concreto. Las instrucciones de "no uses comillas simples" por sí solas envejecen mal, y las comillas simples son uno de los infractores recurrentes detrás del JSON malformado, junto con las comas finales, que representan aproximadamente el 40% de los errores en un análisis (Flying Fish Space).
Cuántos ejemplos usar y cuándo bajar a cero
Empieza en cero. Añade ejemplos solo cuando un caso de evaluación falla, y añade el ejemplo más pequeño que solucione ese caso. La mayoría de los prompts de clasificación y extracción se estabilizan entre tres y seis; pasados ocho, generalmente estás compensando una descripción de tarea que nunca escribiste correctamente.
Baja a cero siempre que un esquema haga el trabajo. La decodificación restringida contra un esquema suministrado te da esencialmente un 100% de JSON sintácticamente válido (Ashvara), por lo que los ejemplos de formato son peso muerto allí. Conserva los ejemplos para el juicio, usa el esquema para la estructura.
El olor a sobreajuste: ejemplos que el siguiente modelo imitará demasiado literalmente
Presta atención a los ejemplos cuyas características superficiales son accidentales. Si todas las entradas de ejemplo tienen alrededor de 40 palabras, un modelo más potente puede tratar la longitud como una señal. Si los cuatro ejemplos caen en la misma etiqueta, has sesgado el prior. Si tus ejemplos usan nombres de marcador de posición como Acme Corp, espera que esos nombres aparezcan en la salida real eventualmente.
Vuelve a ejecutar tu conjunto de few-shot con un nuevo checkpoint la semana que se lanza y difiere las salidas en los casos que los ejemplos no cubren. Ahí es donde se filtra la imitación. Los equipos que publican casos reales de implementación tienden a mantener el conjunto de ejemplos bajo control de versiones exactamente por esta razón: un ejemplo que no puedes differenciar es un ejemplo que no puedes retirar.
Contratos de salida que sobreviven al modelo
Baja la aplicación en la pila hasta que el formato deje de depender de cómo un checkpoint se sienta ese día. Pedir amablemente JSON es el nivel más débil disponible, y es el que sigue usando la mayor parte del código de producción.
Tres niveles de fiabilidad: solicitud en prosa, modo JSON, decodificación restringida
| Nivel | Cómo lo pides | Qué recibes |
|---|---|---|
| 1 | "Por favor devuelve JSON" en el texto del prompt | Un estimado de 5-10% de las salidas están malformadas (Ashvara) |
| 2 | Modo JSON del proveedor activado | Aproximadamente 95-99% sintácticamente válido en observaciones de producción (Ashvara) |
| 3 | Generación restringida a un esquema suministrado | Esencialmente 100% sintácticamente válido (Ashvara) |
Usa el nivel 3 siempre que tu proveedor lo soporte. La validez proviene entonces del decodificador en lugar de los pesos, por lo que un cambio de modelo no puede regresarla. Conserva igualmente el contrato a nivel de prompt, porque la decodificación restringida garantiza la forma y no dice nada sobre si los valores son correctos. Si prefieres no escribir la infraestructura, los frameworks que envuelven la aplicación de esquemas en nuestro directorio tienen 128 entradas.
Qué debe especificar un contrato más allá de "devuelve JSON"
Nombra las claves, el tipo detrás de cada clave y el comportamiento cuando el modelo no tiene nada que poner allí.
- Cada clave escrita exactamente como tu parser espera, con un tipo extraído de los seis tipos JSON: cuatro primitivos (string, number, boolean, null) y dos tipos estructurados, object y array (RFC 8259).
- Solo literales en minúsculas. La gramática permite exactamente tres: false, null, true (RFC 8259).
- Nombres de clave únicos dentro de cada objeto, lo que el RFC 8259 recomienda para que cada parser acuerde el mismo mapeo nombre-valor.
- Si las claves opcionales se omiten o se emiten con un valor null, y cualquier enum que esperes, escrito como strings literales.
Los modos de fallo que vale la pena codificar: comas finales, comillas simples, strings sin escapar
Un análisis sitúa las comas finales en aproximadamente el 40% de todos los errores de JSON, con las comillas simples, las comillas sin escapar dentro de strings, las comas faltantes y los caracteres BOM UTF-8 ocultos cubriendo la mayor parte del resto (Flying Fish Space). Esos cinco fallos cuestan quizás 25 tokens para prohibirlos explícitamente en la ranura de formato, y la prohibición sigue siendo correcta en cada modelo al que lo apuntes. Combínalo con un paso de validar-luego-formatear en tu lado en lugar de confiar en el string (QuickTinyData).
Objeto vacío, array vacío, null: tres respuestas distintas
Aquí es donde los contratos se filtran entre versiones de modelo sin que nadie lo note. Un objeto vacío y un array vacío son ambos JSON válido, y ambos significan algo distinto de null (Jsonic). Un checkpoint devuelve [] cuando no hay coincidencias, el siguiente devuelve null, y tu código downstream trata uno de ellos como un error.
Elige la representación, establécela en el contrato y valida para ello. Tu parser también necesita sobrevivir a un valor desnudo en el nivel superior, ya que cualquier valor JSON único cuenta como un documento completo, incluyendo un string aislado o el número 42 (Jsonic).
Los trucos frágiles que mueren con cada lanzamiento
Abre tu biblioteca de prompts y busca estos cuatro patrones. Cada coincidencia es candidata a ser eliminada, porque cada una estaba compensando una debilidad del modelo que o bien se corrigió o bien se desplazó.
El genérico 'piensa paso a paso' como añadido
Añadir "piensa paso a paso" a un prompt tenía sentido cuando los modelos saltaban directamente a una respuesta. Los modelos de razonamiento actuales ya descomponen por defecto, por lo que la frase añade tokens y a veces arrastra una tarea de clasificación breve a tres párrafos de narración que luego hay que eliminar.
Conserva las instrucciones de razonamiento solo cuando son específicas de la tarea: "enumera las cláusulas en conflicto antes de elegir una" le dice al modelo sobre qué razonar. El reemplazo duradero es la ranura de tarea de tu shell de rol-contexto-tarea-formato, especificando el artefacto intermedio que quieres. El conjuro genérico va a la papelera.
Amenazas, sobornos y presión de rol
"Te despedirán si te equivocas." "Te daré una propina de $200." "Eres el mejor analista del mundo." Estos se apoyaban en peculiaridades de checkpoints RLHF específicos, y las peculiaridades no sobreviven al reentrenamiento. Peor aún, son infalsificables: no puedes escribir una prueba que demuestre que la propina fue lo que arregló tu salida, por lo que la línea permanece en el prompt para siempre, sin cuestionarse.
Reemplaza la presión con restricciones. Una rúbrica con la que el modelo se evalúa a sí mismo, o una lista explícita de lo que se considera fallo, hace el mismo trabajo y sigue funcionando cuando el checkpoint cambia.
Hacks de formato que pelean con el tokenizador
Rellenar prompts con exigencias en MAYÚSCULAS, signos de exclamación triples o largas series de delimitadores como ##### es folclore. La parte de los delimitadores tenía algo de verdad (los límites de sección claros ayudan), pero la escalada no. Dos saltos de línea y una etiqueta tipo XML superan a cuarenta almohadillas.
Lo mismo aplica para "sin bloques de código, sin preámbulo, sin explicación, solo devuelve JSON" apilado tres veces. Dilo una vez en la ranura de formato y luego pon la garantía donde realmente viven las garantías: restringir la generación a un esquema suministrado es lo que te lleva a un JSON esencialmente 100% sintácticamente válido (Ashvara), y ningún montón de prohibiciones en el lado del prompt se acerca a ese número.
Súplicas a nivel de prompt donde debería haber un parser
Los modos de fallo son aburridos y estructurales: comas finales después del último elemento, claves sin comillas, caracteres de comillas no válidos, comas faltantes, llaves desbalanceadas (QuickTinyData). Las comas finales por sí solas representan aproximadamente el 40% de los errores de JSON en un conjunto de datos de errores (Flying Fish Space), y están prohibidas por el formato en sí (MDN). Ninguna cantidad de ruegos cierra esa brecha.
Elimina las súplicas. Pon un esquema y un validador en su lugar, y deja que el prompt diga qué significan los campos.
Los bucles de evaluación tratan los prompts como artefactos versionados
Construye veinte casos de prueba antes de construir cualquier cosa inteligente. Un prompt sin un conjunto de evaluación es un prompt que no puedes actualizar, porque no tienes forma de saber si el nuevo modelo lo mejoró o rompió el único caso que importa a tu cliente más importante sin avisarte.
Veinte no es un número de compromiso. Es suficiente para detectar las clases de fallo que ya conoces, lo suficientemente pequeño como para escribirlo en una tarde, y lo suficientemente barato como para volver a ejecutarlo en cada checkpoint sin pensar en el coste.
La evaluación mínima viable: 20 casos, una aserción cada uno
Una aserción por caso, y que sea un booleano: ¿se procesó la salida, contenía el campo requerido, rechazó cuando debía haber rechazado? Las rúbricas, los modelos juez y las puntuaciones de similitud pueden venir después, una vez que el booleano es verde. Los casos con tres aserciones se convierten en casos que no puedes depurar, y una ejecución en rojo no te dice nada sobre cuál de los tres falló.
Elige tus veinte del tráfico real, con peso hacia el extremo complicado. Cinco caminos felices, cinco entradas ambiguas, cinco que son adversariales o están vacías, cinco que fallaron en producción en algún momento. Guárdalos junto al prompt en el mismo repositorio, en el mismo commit. Si el prompt cambia y los casos no, es un comentario de revisión.
Validar primero, luego formatear: tomando prestado el flujo de trabajo de depuración de JSON
El mundo de JSON resolvió este debate hace años. La guía de solución de problemas de QuickTinyData recomienda validar primero y formatear segundo, porque imprimir bien un documento roto oculta el error estructural exacto que estás buscando: comas finales, claves sin comillas, caracteres de comillas incorrectos, comas faltantes, llaves desbalanceadas (QuickTinyData).
Ejecuta tu evaluación de la misma manera. Afirma la validez antes de afirmar la calidad. Una salida de modelo que falla en json.loads no debería avanzar a la comprobación semántica, y tampoco debería recibir crédito parcial. Tu suite de evaluación necesita dos columnas, tasa de parseo y tasa de aprobación, y la segunda solo cuenta las filas donde la primera tuvo éxito.
Conocer la distribución de errores te dice qué afirmar. Un análisis sitúa las comas finales en aproximadamente el 40% de los errores de JSON, con las comillas simples, las comillas sin escapar dentro de strings, las comas faltantes y los caracteres BOM UTF-8 ocultos constituyendo la mayor parte del resto (Flying Fish Space). El del BOM vale una aserción dedicada, ya que es invisible en todos los editores que usarás para inspeccionar la salida.
Ejecuciones de regresión el día del lanzamiento
Llega un nuevo checkpoint. Ejecutas los veinte, obtienes un diff, decides. Ese es el procedimiento completo, y tarda unos cuatro minutos si construiste la suite correctamente.
- Fija el modelo antiguo y vuelve a ejecutar la suite para confirmar que tu línea base sigue reproduciéndose. Si no lo hace, el problema está en la configuración de tu prueba, no en el lanzamiento.
- Ejecuta la suite contra el nuevo checkpoint y registra la tasa de parseo y la tasa de aprobación por separado.
- Lee cada caso que cambió, en ambas direcciones. Un caso que empezó a pasar puede ser suerte, y merece tanta atención como una regresión.
- Lanza, revierte o parchea el prompt. Luego confirma los nuevos números de línea base junto al archivo de prompt.
Esto importa más en stacks de agentes donde un parseo incorrecto se propaga en cascada, porque el fallo aparece tres llamadas de herramienta después como algo que no se parece en nada a un error de formato.
Fijar versiones y qué hacer cuando no puedes
Fija a IDs de modelo con fecha en todo lugar que puedas, y trata un alias como una dependencia flotante que has elegido no bloquear. Algunos proveedores no te darán una fijación, o deprecarán la que tienes con una ventana corta. Cuando eso suceda, tu suite de evaluación es lo que se interpone entre un cambio de comportamiento silencioso y un ticket de soporte que no puedes reproducir.
Ejecuta la suite de forma programada contra el endpoint no fijado. Semanal está bien. Encontrarás la desviación antes de que tus usuarios te la narren en un informe de error.
Portar un prompt entre Claude, GPT y Gemini
Aproximadamente el 80% de un prompt bien construido se porta sin cambios. El resto es una capa adaptadora que escribes una vez por proveedor y luego mayormente olvidas. Si estás reescribiendo todo para cada proveedor, tu prompt llevaba comportamiento específico del proveedor que nunca necesitó llevar.
Qué permanece idéntico: el shell, los ejemplos, el contrato
El shell de cuatro ranuras se mueve entre proveedores sin ediciones. Rol, contexto, tarea, formato describen el trabajo, y el trabajo no cambia cuando intercambias checkpoints. Lo mismo aplica a tu bloque de few-shot: los ejemplos que resuelven ambigüedad genuina en tu dominio enseñan a cada modelo lo mismo, porque la ambigüedad vive en tus datos, no en el decodificador.
Tu contrato de salida permanece idéntico también, y tiene que hacerlo. Lo que sea que devuelva un proveedor tiene que satisfacer el mismo parser: nombres de propiedades entre comillas dobles, sin comas finales, sin NaN ni Infinity, y solo cuatro caracteres de espacio en blanco legales (espacio, tabulación, salto de línea, retorno de carro) (MDN). Escribe el esquema una vez. Valida las tres salidas con el mismo validador y difiere los fallos.
Mantén tu conjunto de evaluación también neutral respecto al proveedor. Veinte casos que pasan en Claude y fallan en Gemini te dicen algo útil. Veinte casos escritos contra las peculiaridades de Claude no te dicen nada.
Qué reajustas por proveedor: peso del system message, delimitadores, API de aplicación
Tres cosas reciben un adaptador. Cuánta de tu instrucción va en el system message versus el turno de usuario, ya que los proveedores ponderan eso de forma diferente. Qué usas para delimitar bloques, etiquetas tipo XML o encabezados markdown. Y qué API de aplicación llamas.
Esa última es la parte complicada. El modo JSON de cualquier variante te da sintaxis y se detiene ahí: las observaciones de producción lo sitúan alrededor del 95-99% sintácticamente válido, mientras que restringir la generación a un esquema suministrado es esencialmente el 100% (Ashvara). Ninguno de los dos niveles dice nada sobre si las claves son las que pediste, así que la comprobación del esquema permanece en tu código sin importar con qué proveedor estés. Si estás eligiendo objetivos, vale la pena un paso para comparar los modelos en sí antes de comprometerte, y las plataformas multi-proveedor en nuestro directorio absorberán parte de este trabajo de adaptador.
Una lista de verificación de portabilidad antes de lanzar
- Elimina cada oración que nombre un modelo, una versión o un comportamiento conocido de uno. Esas son las líneas que se rompen primero.
- Ejecuta el mismo conjunto de evaluación contra los tres proveedores y registra las tasas de aprobación por caso, no solo un promedio.
- Confirma que el validador de esquema se ejecuta en cada respuesta independientemente de si el proveedor afirma tener decodificación restringida.
- Vuelve a leer la documentación de aplicación de cada proveedor cuando conectas el adaptador, y mantén cualquier redacción o indicador que requiera dentro del adaptador en lugar de en el prompt compartido.
- Registra qué adaptador se activó. Cuando llega un checkpoint y la calidad cambia, quieres saber si el prompt o el adaptador cambió por debajo de ti.
Si un prompt falla esta lista de verificación en un solo proveedor, el error casi siempre está en el adaptador, no en el shell.
Preguntas frecuentes
¿Necesito reescribir mis prompts cada vez que llega un nuevo modelo?
No, y si lo haces, tu prompt probablemente llevaba hacks específicos del modelo en lugar de instrucciones. Las partes que sobreviven las actualizaciones son las vinculadas a algo externo al modelo: una descripción de tarea, datos de entrada y un contrato de salida como un esquema JSON. La decodificación restringida contra un esquema suministrado produce JSON esencialmente 100% sintácticamente válido independientemente del modelo que haya detrás, porque la restricción vive en el decodificador. Lo que deberías reescribir en un cambio de modelo es nada. Lo que deberías volver a ejecutar es tu conjunto de evaluación.
¿'Piensa paso a paso' sigue funcionando en los modelos actuales?
Es mayormente peso muerto ahora. Esa frase era un remedio para modelos que saltaban directamente a una respuesta, y los modelos actuales ya descomponen el trabajo de varios pasos sin que se lo digan. Peor aún, añadirla a un prompt que exige una salida JSON estricta invita al modelo a emitir prosa de razonamiento alrededor del objeto, que es exactamente la clase de fallo que lleva a los prompts ingenuos a una tasa estimada de 5-10% de JSON malformado. Si quieres razonamiento, dale un campo con nombre en tu esquema y deja que el parser lo mantenga separado del payload.
¿Es suficiente el modo JSON, o necesito un esquema?
Usa el esquema. El modo JSON te lleva a aproximadamente 95-99% de salida sintácticamente válida, lo que suena bien hasta que estás ejecutando diez mil llamadas al día y absorbiendo cien fallos. La decodificación restringida por esquema lleva la validez sintáctica a esencialmente el 100%, y también fija tus nombres de clave, lo que importa porque el RFC 8259 trata un objeto JSON como una colección desordenada de pares nombre-valor y solo recomienda nombres únicos. La validez sintáctica no es corrección semántica, así que sigue validando el objeto parseado contra tus propias reglas de cualquier manera.
¿Cuántos ejemplos de few-shot debe incluir un prompt duradero?
De dos a cuatro, y elige por cobertura de casos extremos, no por volumen. Los ejemplos que muestran el mismo camino feliz repetidamente no enseñan al modelo nada que no haga ya; los ejemplos que fijan los casos difíciles son los que se transfieren entre modelos. Para salida estructurada, dedica al menos un ejemplo a la distinción entre un contenedor vacío y un valor faltante, ya que [un objeto vacío {} y un array vacío [] son ambos JSON válido pero semánticamente distintos de null](https://jsonic.io/guides/json-examples). Si tus ejemplos contienen formato que un parser estricto rechazaría, estás enseñando el fallo: las comas finales por sí solas representan alrededor del 40% de los errores de JSON en un análisis.
¿Qué tamaño debe tener un conjunto de evaluación de prompts para ser útil?
Treinta a cincuenta casos etiquetados detectarán la mayoría de las regresiones, y veinte es mejor que el cero con el que trabaja la mayoría de los equipos. El tamaño importa menos que la composición: pondera el conjunto hacia los modos de fallo que realmente has visto en producción, como claves sin comillas, comillas simples, comillas sin escapar dentro de strings, comas faltantes y caracteres BOM UTF-8 ocultos, todos los cuales aparecen en análisis documentados de errores de JSON. Ejecuta la validación antes del formateo para detectar roturas estructurales en lugar de enmascararlas, que es el flujo de trabajo que QuickTinyData recomienda. Versiona el conjunto junto al prompt y vuelve a ejecutarlo el día que llegue un nuevo modelo.
¿Puede el mismo prompt ejecutarse sin cambios en Claude, GPT y Gemini?
El cuerpo de la instrucción se porta limpiamente. La capa de aplicación de salida no, porque el modo JSON y la decodificación restringida por esquema se configuran de forma diferente por proveedor, así que planifica un prompt y tres adaptadores delgados. Mantener el contrato en un formato con el que todos los proveedores ya están de acuerdo ayuda: el RFC 8259 es independiente del lenguaje y define cuatro tipos primitivos más objetos y arrays, con true, false y null en minúsculas como los únicos nombres literales. Si buscas herramientas para gestionar prompts entre proveedores, nuestro directorio lista 212 herramientas de ingeniería de prompts y 324 entradas en modelos de IA.