

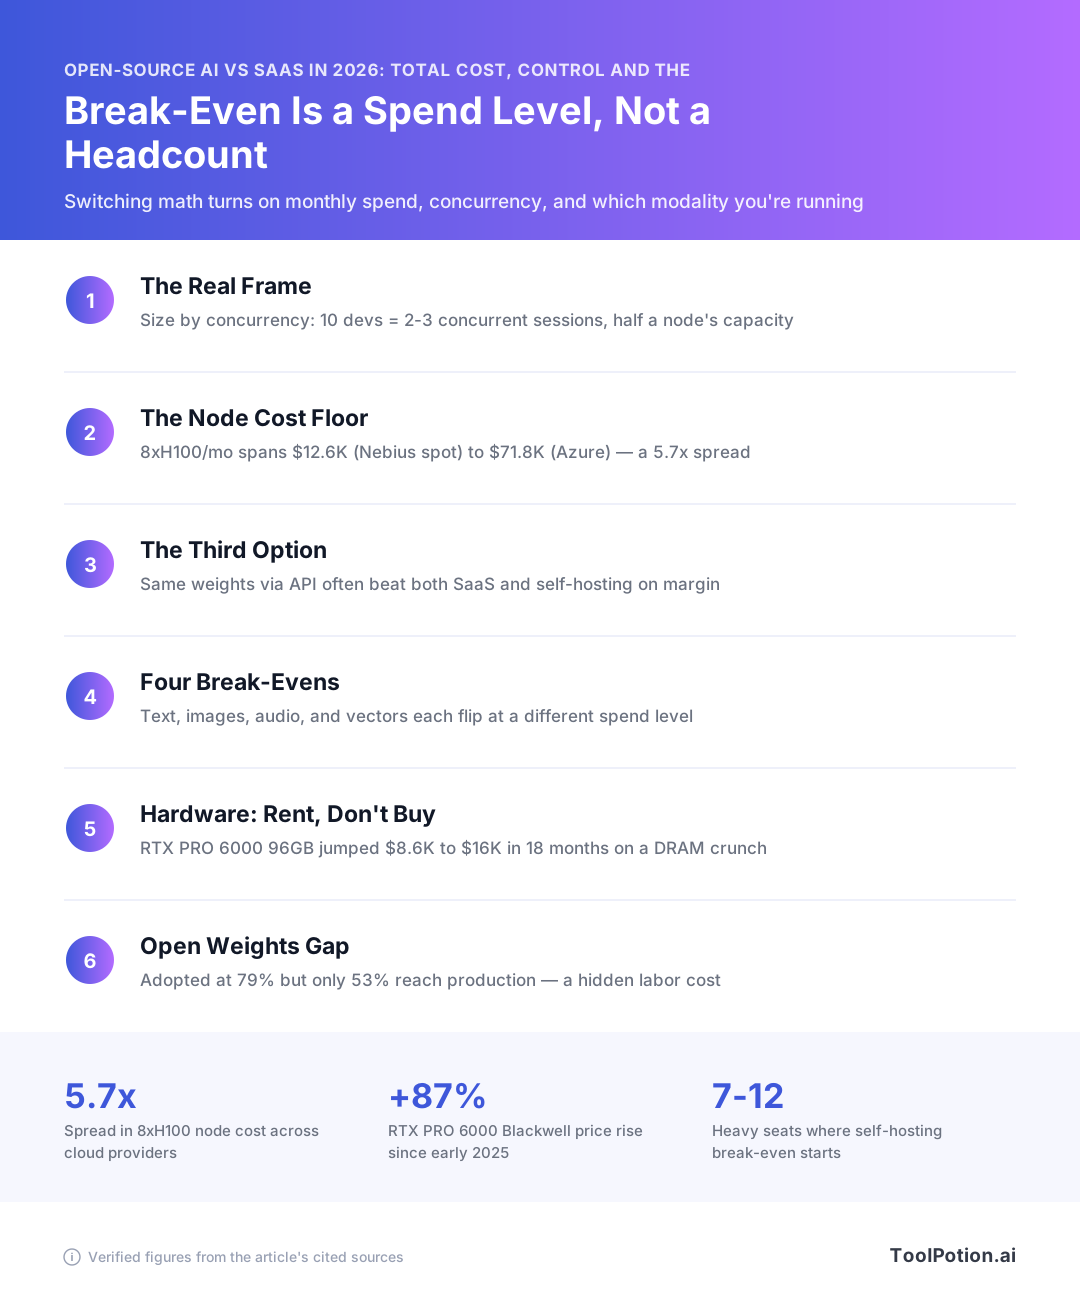
La decisión entre IA open source y SaaS depende de dos números: tu gasto mensual y tu perfil de concurrencia. El número de empleados es un indicador pobre para ambos. Los propios ingenieros de DoiT tienen un promedio de $2.200 por desarrollador al mes en Claude Code de pago por uso, lo que sitúa el punto de equilibrio de un nodo de $15.000–$25.000 en torno a 7 o 12 puestos de uso intensivo. Pero solo el 10–20% de un equipo tiene una solicitud en vuelo en un momento dado, de modo que diez desarrolladores equivalen a dos o tres sesiones concurrentes y medio nodo sin utilizar.
Y antes de cotizar ninguna GPU, comprueba la tercera opción que nadie incluye en sus comparativas: DeepInfra sirve Llama-3.3-70B a $0,10 de entrada / $0,32 de salida por millón de tokens. Los mismos pesos, con márgenes multi-tenant que no podrás igualar. La matemática que sigue se aplica cuatro veces: para texto, imágenes, transcripción y la capa vectorial.
El punto de equilibrio es un nivel de gasto y un perfil de concurrencia
Dos números deciden si debes auto-alojar, y el tamaño del equipo no es ninguno de ellos. El primero es lo que gastas al mes en IA ahora mismo. El segundo es cuántas solicitudes están en vuelo al mismo tiempo. Todo lo demás, incluida la elección de modelo, depende de esos dos.
Los dos números que lo deciden antes de elegir ningún modelo
Un nodo de GPU cuesta lo mismo tanto si lo saturas como si lo dejas inactivo a las 3 de la mañana. Ahí reside la asimetría en la que se basa toda la comparación: SaaS te cobra por token, un nodo te cobra por hora. La pregunta es si tu factura mensual ha superado el coste fijo de un servidor que puedas mantener ocupado.
El equipo de ingeniería de DoiT promedia unos $2.200 por desarrollador al mes con los precios de pago por uso de Claude Code Enterprise, lo que sitúa el punto de equilibrio de auto-alojamiento de $15.000–$25.000/mes en torno a 7 o 12 puestos de uso intensivo de IA. Es un umbral mucho más bajo que el «necesitas cientos de ingenieros» que repiten la mayoría de las guías de TCO. Es un umbral de gasto, no de personas. Doce desarrolladores que apenas usan un asistente no llegan ahí, mientras que siete que ejecutan agentes todo el día sí.
La concurrencia es el segundo número, y es el que los equipos calculan mal. El argumento de DoiT es que en cualquier momento solo el 10–20% de un equipo de desarrolladores tiene una solicitud en vuelo, de modo que diez desarrolladores representan dos o tres sesiones concurrentes, como mucho la mitad de la capacidad de un nodo. Estás pagando por ocho H100 y usando tres o cuatro. Dimensiona por solicitudes concurrentes en pico y el rendimiento de tokens objetivo, y luego comprueba si cabe en un nodo antes de cotizar nada.
Por qué «tenemos 50 ingenieros» es el disparador equivocado
El número de empleados solo correlaciona con el gasto cuando el uso por persona es uniforme, y nunca lo es. Un equipo de 50 personas donde 8 ejecutan agentes de código continuamente y 42 usan el chat ocasionalmente tiene el mismo requisito de nodo que un equipo de 8 usuarios intensivos, y prácticamente la misma factura. Cuenta los puestos de uso intensivo.
Calcula esos dos números antes de comparar los modelos de pesos abiertos catalogados en nuestro directorio con cualquier alternativa. Elige el modelo después de saber si un nodo puede mantenerse ocupado, porque un modelo que se queda 6 puntos por detrás de la frontera es un buen intercambio en un servidor saturado y un error costoso en uno que funciona al cuarto de su capacidad.
IA open source vs SaaS: lo que cuesta el auto-alojamiento en 2026
Empieza por la tarifa, porque es el único número que puedes consultar. Todo lo demás en un presupuesto de auto-alojamiento es una estimación que defiendes en una hoja de cálculo.
Tarifas de GPU en alquiler: una diferencia de ~7x en silicio apto para inferencia
Los precios públicos de RunPod listan la H100 SXM 80GB a $3,29/h en Secure Cloud y $2,69/h en Community Cloud, la H200 141GB a $4,59/$3,59, la A100 PCIe 80GB a $1,39/$1,19, la L40S 48GB a $0,99/$0,79, y la B200 180GB a $6,79/$5,98 (RunPod). Eso supone aproximadamente 7x entre la tarjeta más barata y la más cara que puede servir inferencia. Si tu carga de trabajo es un modelo de 7B u 8B con contexto moderado, la línea L40S es la que debes cotizar, y la mayoría de los artículos de TCO nunca la mencionan.
Lambda cobra $4,29/h por una sola H100 SXM bajo demanda, bajando a $3,99/h por GPU en un nodo 8x, con H100 PCIe a $3,29/h y B200 SXM6 a $6,69–$6,99/h (Lambda). Un nodo 8xH100 a esa tarifa supone unos $31,92/h, o aproximadamente $23.300 para un mes de 730 horas al 100% de disponibilidad. Nadie funciona al 100% de disponibilidad, que es la clave del siguiente número.
El descuento por compromiso es la palanca individual más importante que controlas. Together AI cobra $3,99/GPU-h bajo demanda para HGX H100 y $3,19–$3,69/GPU-h en términos reservados de 7 a 180+ días (Together AI). Calcula un 20% de descuento, disponible solo si confías suficientemente en tu carga para firmar el plazo.
El multiplicador del proveedor: de $12.600 a $71.800 por el mismo mes de 8xH100
DoiT calculó el precio de un nodo 8xH100 idéntico durante un mes de 730 horas en distintos proveedores: unos $12.600 en Nebius spot, $22.500 en Nebius bajo demanda, $40.200 en AWS, $64.100 en GCP y $71.800 en Azure (DoiT). El mismo silicio, una diferencia de 5,7x. Tu elección de proveedor mueve la matemática del cambio más que tu elección de modelo, de modo que si haces esta evaluación con los precios de lista de los hyperscalers porque ahí tienes tu gasto comprometido, estás comparando la peor versión del auto-alojamiento contra SaaS.
| Proveedor / tarjeta | Tarifa por hora | Notas |
|---|---|---|
| RunPod L40S 48GB | $0,99 / $0,79 | Secure vs Community Cloud |
| RunPod H100 SXM 80GB | $3,29 / $2,69 | Secure vs Community Cloud |
| Lambda H100 SXM (nodo 8x) | $3,99 por GPU | ~$23.300 / mes de 730 h |
| Together AI HGX H100 | $3,99 bajo demanda, $3,19–$3,69 reservado | Plazos de 7–180+ días |
Las partidas que nadie presupuesta: horas inactivas, redundancia y mano de obra de mantenimiento
Un nodo en alquiler factura por reloj de pared. Tu factura de API rastrea tokens, mientras que tu factura de GPU rastrea horas que quizás nunca usas. Si tu tráfico es en horario laboral y entre semana, estás pagando por unas 168 horas de capacidad útil de 730 y asumiendo el resto, así que multiplica tu coste efectivo por token por cuatro antes de compararlo con una factura de API. Añade un segundo nodo o una clave de API de respaldo si el servicio es de cara al cliente, porque un único nodo no tiene conmutación por error. Añade el ingeniero que parchea vLLM, rota versiones de modelos, vigila la presión de caché KV y recibe alertas a las 2 de la mañana. Los proveedores en nuestro directorio de plataformas de machine learning gestionarán parte de eso por un margen, que suele ser más barato que los medio puestos que de otro modo gastarías.
Así que un número mensual defendible es: horas de nodo a la tarifa real de tu proveedor, divididas por tu disponibilidad real, más redundancia, más tiempo de ingeniería cargado. Calcula los cuatro antes de comparar nada.
La tercera opción que elimina la mayoría de los casos de auto-alojamiento
Casi todos los artículos que comparan open source con SaaS ponen una factura de GPU junto a una factura de API de frontera y declaran un ganador. Esa comparación omite la opción que la mayoría de los equipos debería elegir: alguien más ejecuta los pesos abiertos por ti, en multi-tenant, y cobra por token.
DeepInfra sirve Llama-3.3-70B-Instruct-Turbo a $0,10 de entrada / $0,32 de salida por millón de tokens, y Meta-Llama-3.1-8B a $0,02/$0,04 (DeepInfra). Los mismos checkpoints que descargarías. Los mismos términos de licencia. La diferencia es que sus H100 funcionan cerca de su capacidad máxima entre miles de clientes, y las tuyas funcionan a lo que sea que tu tráfico resulte ser a las 3 de la mañana de un domingo.
Los mismos pesos abiertos, la curva de ocupación de otro
Haz la aritmética frente al nivel dedicado de DeepInfra y la brecha se vuelve embarazosa. Una H100 80GB dedicada cuesta $2,20/h allí (DeepInfra), es decir, $1.606 para un mes de 730 horas. A $0,32 por millón de tokens de salida, esos mismos $1.606 compran unos cinco mil millones de tokens de salida en el endpoint serverless. Repartido en los 43.800 minutos de ese mes, tu única H100 tendría que sostener aproximadamente 115.000 tokens de salida por minuto, cada minuto, solo para igualar la API en precio. Un despliegue real pasa una gran parte de esos minutos inactivo.
Compras capacidad dedicada por razones distintas al precio unitario: residencia de datos, sin retención por terceros, pisos de latencia que controlas tú, LoRAs personalizadas, modelos que nadie aloja. Esas razones son reales. Son razones de contratación más que razones de hoja de cálculo, y deberías decirlo en voz alta cuando lo presentes.
Cuándo dejar de alquilar los pesos deja de ser más barato
El extremo de los modelos pequeños del mercado ha colapsado sobre sí mismo. GPT-5-nano cuesta $0,05/$0,40 por millón de tokens y GPT-5 cuesta $1,25/$10,00 (OpenAI), lo que significa que un modelo propietario ahora cuesta menos que lo que pagarías por mantener un modelo de 8B de código abierto caliente en tu propio hardware. Las API de pesos abiertos baratas y las API propietarias baratas compiten en el mismo eje, y el auto-alojamiento está perdiendo frente a ambas.
Elige tu referencia con cuidado, porque decide la respuesta. La horquilla de Anthropic va de $10/$50 por millón para Fable 5.1 hasta $1/$5 para Haiku 4.5 (Anthropic). Compara el auto-alojamiento con el nivel superior de esa horquilla y parece una ganga. Compáralo con Haiku, o con el Llama de DeepInfra, y el nodo de GPU tiene que justificarse por el control, no por el coste.
Cuatro modalidades, cuatro puntos de equilibrio completamente distintos
Un equipo que auto-aloja la transcripción casi nunca auto-aloja la inferencia de texto, y la razón es aritmética. Cada carga de trabajo tiene su propio precio mínimo en SaaS, su propio patrón de carga de GPU y sus propias reglas de licencia. Aplica un único modelo de punto de equilibrio a las cuatro y obtendrás una respuesta incorrecta tres veces.
Inferencia de texto: el punto de giro más amplio e impredecible
Esta es la modalidad donde el punto de giro varía más, porque el precio de API contra el que comparas abarca un orden de magnitud. Anthropic cobra $2/$10 por millón de tokens de entrada/salida para Sonnet 5 y $1/$5 para Haiku 4.5 (precios de Claude), mientras que OpenAI lista GPT-5-mini a $0,25/$2,00 y GPT-5-nano a $0,05/$0,40 (precios de la API de OpenAI). Elige tu nivel de referencia y el punto de equilibrio oscila entre unos pocos cientos de millones de tokens al mes y varios miles de millones.
Una H100 dedicada a $2,20/h en DeepInfra cuesta unos $1.606 al mes a plena disponibilidad (precios de DeepInfra). Frente a la tarifa combinada de GPT-5-nano, necesitarías un volumen que la mayoría de los equipos nunca alcanza. Frente a Fable 5.1 a $10/$50 por millón (precios de Claude), el mismo nodo se amortiza mucho antes. Decide qué nivel necesita tu carga de trabajo antes de modelar nada, y navega por las listas de modelos y LLMs si aún estás preseleccionando pesos abiertos.
Generación de imágenes: la licencia lo decide antes que la GPU
Aquí la matemática de la GPU es la parte fácil y la licencia es la trampa. Se informa ampliamente de que los pesos de FLUX.1 [dev] se publican bajo una licencia no comercial, lo que pondría una licencia de pago de Black Forest Labs entre tú y un producto comercial, así que lee los términos tú mismo antes de presupuestar el hardware. Nadie que compare modelos de imágenes abiertos con Midjourney lo menciona, y es la partida que puede invertir la decisión.
El trabajo de imágenes en ráfaga es lo que no supera la prueba. Un equipo de marketing que genera en lotes los martes deja la tarjeta inactiva el resto de la semana, y las horas inactivas facturan a la misma tarifa que las ocupadas. Una L40S a $0,79/h en RunPod Community Cloud (precios de RunPod) es suficientemente barata como para que los trabajos por lotes en estado estable superen el umbral con comodidad, por eso los pipelines programados son la forma que funciona aquí. Hay 727 herramientas de generación de imágenes en nuestro directorio, y los términos de licencia varían más que la calidad de los resultados.
Transcripción: la modalidad que alcanza el punto de equilibrio antes
Excepto que normalmente no lo hace, y la razón es AssemblyAI. OpenAI cobra $0,006/minuto por Whisper y gpt-4o-transcribe, y $0,003/minuto por gpt-4o-mini-transcribe, lo que equivale a $0,36 y $0,18 por hora de audio (precios de la API de OpenAI). Frente a $0,36/hora, una L40S a $0,79/h alcanza el punto de equilibrio en aproximadamente unos pocos cientos de horas de audio al mes, asumiendo un rendimiento en lote más rápido que en tiempo real. Es un umbral genuinamente bajo. Luego AssemblyAI fija el precio de Universal-2 en $0,15/hora y Universal-3.5 Pro en $0,21/hora (precios de AssemblyAI), y tu punto de equilibrio se mueve más del doble.
El único lugar donde el auto-alojamiento sigue ganando claramente es el streaming. AssemblyAI factura el streaming por duración de sesión WebSocket, incluyendo el tiempo de conexión inactiva (precios de AssemblyAI). Si mantienes sockets abiertos para reuniones donde la gente no habla, estás pagando por el silencio. Un endpoint auto-alojado te cobra por segundos de GPU en lugar de por reloj de pared.
RAG y la capa vectorial funcionan según el volumen de consultas
El punto de equilibrio de la búsqueda vectorial se mide en consultas por mes, y la cifra que circula se sitúa en torno a los 60 o 80 millones de consultas antes de que el auto-alojamiento supere los precios gestionados. Trátalo como una regla general más que como una tarifa, ya que varía con el tamaño del índice, el número de réplicas y el presupuesto de latencia que estés dispuesto a gastar. Por debajo de ese rango estás pagando a un ingeniero para que cuide un índice que un servicio gestionado ejecutaría por menos que su línea salarial. La generación de embeddings es un cálculo separado, y es lo más barato de auto-alojar de todo lo que se discute aquí, porque el modelo es pequeño y el trabajo se agrupa perfectamente.
Cuatro cargas de trabajo, cuatro umbrales, y ninguna razón para moverlas todas a la vez.
¿Comprar el hardware? La crisis de memoria de 2026 dice que alquiles
Cualquier cálculo de amortización que hayas leído escrito antes de mediados de 2026 está usando precios que ya no existen. El consejo era razonable en su momento: compra un servidor, amortízalo en tres años, supera la tarifa de alquiler en el mes 14. Luego el mercado de memoria se rompió.
Una subida de precio de ~87% en una GPU sin cambios
La NVIDIA RTX PRO 6000 Blackwell 96GB es el ejemplo más claro porque el producto no cambió. Aparecía a $8.565 en un minorista a principios de 2025 (con un mínimo de preventa de $7.673), llegó a $13.250 en junio de 2026, y alcanzó los $16.000 en agosto de 2026 (igor'sLAB). Eso es aproximadamente un 87% en unos 18 meses, y NVIDIA no ha publicado ninguna explicación oficial.
Pasa eso por una hoja de cálculo de 2025 y el mes de amortización se duplica aproximadamente. Un sistema de sobremesa de una sola tarjeta que tenías presupuestado en $12.000 todo incluido ahora se acerca a los $20.000 antes de comprar la RAM.
Por qué la HBM se comió el suministro de DRAM
La demanda de GPU es solo la mitad de la historia. Lo que importa es lo que esa demanda hizo a las fábricas de memoria: la memoria de alto ancho de banda ahora ocupa un 23% estimado de la capacidad global de obleas de DRAM, frente al 8% en 2024, porque la HBM genera entre 3 y 5 veces los ingresos por oblea que la DDR5 convencional (DatacenterDisk). Las fábricas movieron las obleas hacia donde está el dinero. Los precios de los módulos DDR5 ECC RDIMM de servidor subieron aproximadamente un 100% a 116% entre el primer trimestre de 2025 y el primer trimestre de 2026 como resultado, de modo que la memoria del host alrededor de tus GPU recibió el mismo golpe que los aceleradores. Lo notas dos veces en un mismo sistema: la tarjeta y el 1 TB de RAM del sistema que hay debajo.
Lo que debe asumir un calendario de amortización escrito en 2026
Asume que la distorsión sobrevive a tu decisión de compra. Goldman Sachs pronosticó en mayo de 2026 un déficit global de DRAM del 4,9% para el año, la mayor escasez en 15 años, más un déficit de suministro de HBM del 5,1%, y la mayoría de los analistas no esperan un alivio significativo antes de finales de 2027 (Wccftech). Un calendario de amortización de tres años iniciado hoy pasa sus primeros dos años dentro de la escasez.
Así que calcula el caso de compra con los costes de adquisición de agosto de 2026 en lugar de los números de 2025 que siguen apareciendo en las páginas de rankings, y no asumas una actualización más barata en el año dos. Si los números solo funcionan con los precios de hardware de 2025, alquila. Alquilar es la forma de mantener la opción de comprar en 2028.
Control y cumplimiento: la parte que la hoja de cálculo pasa por alto
Algunas garantías solo puedes obtenerlas ejecutando los pesos tú mismo. La mayoría de las que los equipos citan como razón para auto-alojar, ahora puedes comprarlas.
Lo que el auto-alojamiento realmente compra, y lo que solo parece comprar
Ejecutar tu propia inferencia te da cuatro cosas que ninguna cláusula contractual replica: pesos de modelo que no cambian bajo ti según el calendario de obsolescencia de un proveedor, ningún dato por solicitud que salga de tu VPC, ningún límite de velocidad impuesto por la planificación de capacidad de otro, y la capacidad de ajustar fino o cuantizar sin pedir permiso. Si tu registro de riesgos tiene una línea sobre que una versión de modelo se retira a mitad de una auditoría, ese es un argumento real para poseer el artefacto.
La lista de cosas que el auto-alojamiento solo parece comprar es más larga. Residencia de datos, cifrado en reposo, compromisos de no entrenamiento con tus datos, evidencia SOC 2, registros de auditoría, procesamiento regional: todo eso se puede comprar como términos contractuales más un selector de región, y lleva ya un tiempo disponible. Pagar una prima de GPU por ellas es comprar dos veces. La exposición que impulsa estas conversaciones es la matemática de las penalizaciones, y la matemática de las penalizaciones no le importa quién instala el hardware. Los reguladores han impuesto €7.100 millones en 2.245 multas del RGPD hasta principios de 2026, con una exposición del RGPD que llega al 4% de la facturación global y la exposición a la Ley de IA hasta el 7%. Un modelo auto-alojado mal configurado falla una auditoría exactamente igual de rápido que uno alojado.
El reajuste regulatorio de 2026 cambió los plazos contra los que planificas
Comprueba la fecha del calendario de cumplimiento con el que trabaja tu equipo. Las obligaciones de alto riesgo de la Ley de IA de la UE fueron aplazadas por el Ómnibus Digital de 2026, de modo que el plazo del 2 de agosto de 2026 que varias páginas de comparación ampliamente citadas aún publican ha sido superado, y deberías confirmar las fechas actuales con tu propio asesor legal antes de gastar en función de ellas. Si aprobaste un presupuesto de auto-alojamiento a principios de 2026 para adelantarte a esa fecha, la urgencia sobre la que se construyó ha desaparecido y el gasto merece una segunda revisión.
Esto importa más en los sectores regulados. Los equipos que buscan herramientas de IA para salud y ciencias de la vida son los más propensos a haber presupuestado un despliegue privado contra un plazo que se ha movido.
La nube soberana gestionada es el camino intermedio
El argumento de la residencia se debilitó durante 2026. Las regiones de nube soberana dotadas de personal y gobernadas dentro de la UE son ahora una opción gestionada que no existía cuando se escribieron la mayoría de las comparaciones entre open source y SaaS que encontrarás, así que comprueba lo que tu hyperscaler preferido ofrece en la región antes de cotizar un nodo. Puedes obtener manejo de datos exclusivamente en la UE sin contratar a nadie para que cuide vLLM a las 2 de la mañana.
El orden que se mantiene es este. Si tu requisito es la residencia, compra nube soberana gestionada. Si es la permanencia de los pesos o el ajuste fino sin restricciones, auto-aloja. Si es una línea en un cuestionario que dice «los datos no deben salir de nuestro control», ve a leer lo que tu auditor aceptará antes de firmar por un nodo.
¿Qué tan por detrás están realmente los pesos abiertos?
Cuatro meses. Ese es el desfase medido, y es el número que debería reemplazar lo que actualmente crees sobre que los modelos abiertos están una generación por detrás.
Cuatro meses y seis puntos en el índice
Epoch AI le puso una cifra rastreando el mejor lanzamiento de pesos abiertos frente a la frontera cerrada en el Epoch Capabilities Index entre el 1 de enero y el 28 de mayo de 2026: un desfase de 4 meses, u 8 puntos ECI con un intervalo de confianza del 90% de 7 a 11. Artificial Analysis mide lo mismo de forma diferente y llega al mismo lugar. Los líderes abiertos puntúan entre 52 y 54 en su Índice de Inteligencia frente al 60 de GPT-5.5, una brecha de 6 puntos que era de 13 puntos doce meses antes.
Así que la brecha es real y se está cerrando. Para la mayoría de las cargas de trabajo de producción (clasificación, extracción, resumen, respuestas con recuperación aumentada, código de primer borrador), una frontera de hace cuatro meses es perfectamente válida. Para la cola de razonamiento difícil, no lo es, y ningún trabajo de prompts cierra 8 puntos ECI. Elige tu carga de trabajo antes de elegir tu bando en el argumento. Los lanzamientos de pesos abiertos que seguimos en nuestro directorio se renuevan tan rápido que un modelo que comparaste en marzo no es el que desplegarías hoy.
La brecha de adopción a producción que le cuesta dinero real a los equipos
Los modelos abiertos pierden en el envío más que en la capacidad. La encuesta State of Open Source AI 2026 (N=1.410) encontró que el 79% de los desarrolladores de IA adoptan modelos abiertos pero solo el 53% los lleva a producción, frente al 71% de adopción y el 63% de producción para los modelos cerrados. Se prueban más y se envían menos.
Esa caída de 26 puntos es tiempo de ingeniería que estás pagando y no estás capturando en tu hoja de TCO. Además empeora con la escala en lugar de mejorar: las tasas de producción de modelos cerrados suben del 54% en empresas pequeñas al 73% en empresas grandes, mientras que los abiertos se mantienen prácticamente planos entre el 53% y el 57%. Las organizaciones con más ingenieros de plataforma son las que abandonan los despliegues abiertos con más frecuencia, lo cual es lo contrario de lo que predice el argumento del auto-alojamiento. Presupuesta para los intentos que no se envían.
Rutas de migración: lo que realmente implica el cambio
El propio intercambio es barato. Lo que te cuesta es el trabajo de evaluación que te saltaste antes del intercambio, que luego pagas en incidentes de producción.
El cambio de URL base, y las excepciones documentadas que vale la pena nombrar
vLLM incluye un servidor compatible con OpenAI, así que para una finalización de chat sencilla, la migración es una URL base y un alias de modelo. Apunta tu cliente existente a tu endpoint, cambia model de gpt-5-mini a lo que estés sirviendo, mantén el resto del código. Esa es la parte que cada competidor trata como una caja negra y honestamente es la mitad fácil.
Las excepciones son donde los equipos pierden una semana. Las salidas estructuradas y la aplicación estricta de esquemas JSON se comportan de forma diferente en distintos stacks de servicio, así que cualquier cosa que dependa de argumentos de función con validez garantizada necesita pruebas con cargas reales en lugar de un smoke test. Las llamadas a herramientas en paralelo son una brecha frecuente. El caché de prompts es específico del proveedor, y si tu modelo de costes asumía tasas de entrada en caché en el lado SaaS, ese descuento no te sigue. El comportamiento de contexto largo se degrada en puntos diferentes a los que anuncia la ventana de contexto, y los tokenizadores también difieren, lo que significa que tus presupuestos basados en recuento de tokens y tu lógica de truncamiento necesitan recalibrarse.
Construye el harness de evaluación antes del cambio, no después
Si no puedes medir la calidad en tu propio tráfico, no puedes saber si un desfase de capacidad de cuatro meses importa para tu caso de uso o no. Captura unos pocos cientos de solicitudes reales de producción con sus salidas, puntúalas de la forma en que tu negocio las puntúa, y luego ejecuta el modelo abierto candidato contra el mismo conjunto. Haz esto antes de aprovisionar una GPU.
- Registra 200 a 500 solicitudes reales con respuestas y cualquier señal posterior que ya rastrees (pulgares, ediciones, reintentos, escalaciones).
- Puntúa la salida del SaaS actual para establecer tu línea base. Necesitas el número que estás defendiendo, no una intuición.
- Ejecuta el candidato de pesos abiertos a través de una API primero, ya que DeepInfra sirve Llama-3.3-70B a $0,10 de entrada / $0,32 de salida por millón de tokens (DeepInfra) y no te cuesta nada en infraestructura para probarlo.
- Solo si la calidad se mantiene y el volumen lo justifica, pasa a capacidad dedicada.
El valor predeterminado híbrido: enruta por clase de solicitud en lugar de reemplazar todo
Divide el tráfico según lo que vale cada solicitud. La clasificación, extracción, resumen y reformulación de recuperación funcionan bien en un modelo de 8B a $0,02/$0,04 por millón de tokens (DeepInfra), y la cola de razonamiento difícil va a Sonnet 5 a $2/$10 (Anthropic). Si el 80% de tus llamadas son de la clase barata, habrás reducido la mayor parte de la factura sin apostar la calidad en un solo modelo.
El enrutamiento también te proporciona una ruta de respaldo, que un reemplazo total no tiene. Los stacks de servicio y los routers conforman una buena parte de los 128 frameworks de IA en nuestro directorio, y los repositorios de IA open source por los que vale la pena empezar son los que tienen una superficie compatible con OpenAI, porque eso es lo que mantiene tu rollback en un único cambio de configuración.
Quién debería cambiar en 2026 — y quién no
Tres perfiles tienen la aritmética a su favor. Tres no la tienen, y ningún entusiasmo de tu equipo de plataforma lo arregla.
Tres perfiles donde el auto-alojamiento gana claramente
Transcripción de alto volumen con carga constante. Si procesas más de unos pocos miles de horas de audio al mes a través de un pipeline que funciona según un horario, puedes mantener una tarjeta ocupada y superar el umbral de $0,15/hora de AssemblyAI (AssemblyAI). El trabajo por lotes es la forma ideal aquí porque controlas cuándo se vacía la cola, de modo que mantener la tarjeta alimentada se convierte en un problema de programación en lugar de una esperanza.
Datos regulados que no pueden salir de tu perímetro, donde el requisito es contractual y no una preferencia. La optimización de costes no es el objetivo en ese caso. Estás comprando una respuesta para una auditoría, y la factura de GPU es su precio.
Cincuenta o más desarrolladores con asistentes de código de pago por uso. Con unos 50 desarrolladores la factura se acerca a $110.000 al mes frente a un nodo que puedes mantener saturado, una prima de 3 a 9 veces, y con ~100 desarrolladores (~$220.000/mes) el hardware propio se amortiza en aproximadamente un año (DoiT).
Tres donde pierde solo por aritmética
Equipos de menos de unos 10 desarrolladores. Con ~$22.000/mes la factura del asistente está igualada con un nodo que esas 10 personas no pueden mantener ocupado (DoiT), y un empate no vale una rotación de guardia.
Cualquiera cuya carga de trabajo sea tráfico de consumidor en ráfaga. Las GPU inactivas facturan a tarifa completa, y una curva diurna irregular significa que estás pagando por el pico mientras promedias quizás el 20% de él. Las API de modelos abiertos sin servidor dominan completamente este perfil.
Equipos cuyo nivel de calidad está en la frontera. Si tus evaluaciones solo pasan con Fable 5.1 a $10/$50 por millón de tokens (Anthropic), un modelo abierto auto-alojado es un producto diferente a un nivel de calidad diferente, y el ahorro te compra una degradación.
La prueba de 90 días a ejecutar antes de comprometer capital
- Semanas 1–2: instrumenta la concurrencia, no el gasto. Registra las solicitudes en vuelo por minuto y encuentra tu p95. Si está por debajo de 4, detente aquí.
- Semanas 3–6: dirige el 10% del tráfico a los endpoints de pesos abiertos de DeepInfra y ejecuta tu suite de evaluación existente sobre él. Para la mayoría de los stacks es un cambio de URL base y un alias de modelo.
- Semanas 7–12: alquila, no compres. Una H100 a $2,20/h dedicada (DeepInfra) te da un número real de utilización por menos de $1.700 al mes, que es el número que te pedirá tu director financiero.
Si la tarjeta permanece inactiva más del 60% del tiempo al final de ese período, la respuesta es la API de pesos abiertos gestionada, y has pasado un trimestre aprendiéndolo en lugar de tres años amortizándolo.
Preguntas frecuentes
¿Es el auto-alojamiento de IA open source realmente más barato que los asientos de ChatGPT Business o Claude Team?
A los precios de lista de los puestos, no. Claude Team cuesta $20 por puesto al mes con facturación anual ($25 mensual), con puestos premium a $100/$125, y Enterprise es $20 por puesto al año más uso a tarifas de API (precios de Anthropic). Ninguna GPU en alquiler se acerca a $20 por cabeza, así que las suscripciones de tarifa plana son lo más difícil de batir en IA con tu propio hardware. El auto-alojamiento empieza a competir solo cuando tu equipo está en facturación por uso, donde los propios ingenieros de DoiT promedian unos $2.200 por desarrollador al mes (DoiT).
¿A qué gasto mensual alcanza el punto de equilibrio el auto-alojamiento de un LLM en 2026?
En torno a $15.000 a $25.000 al mes de gasto en API por uso, que con los $2.200 por desarrollador al mes observados por DoiT equivalen a unos 7 a 12 puestos de uso intensivo (DoiT). El número varía más con tu proveedor de nube que con tu modelo: el mismo nodo 8xH100 para un mes de 730 horas cuesta unos $12.600 en Nebius spot, $22.500 en Nebius bajo demanda, $40.200 en AWS y $71.800 en Azure (DoiT). El número de empleados es la unidad equivocada de todas formas. Solo el 10 al 20% de un equipo de desarrolladores tiene una solicitud en vuelo en cualquier momento, de modo que diez desarrolladores son dos o tres sesiones concurrentes, como mucho la mitad de la capacidad de un nodo (DoiT).
¿Cuántas horas de GPU necesito para superar el $0,36 por hora de audio de la API Whisper?
El rendimiento lo determina, y las horas solo importan a través de la tarifa a la que facturan. OpenAI cobra $0,006/minuto por Whisper y gpt-4o-transcribe, que son $0,36 por hora de audio, y $0,003/minuto ($0,18/hora) por gpt-4o-mini-transcribe (OpenAI). En una RunPod L40S 48GB a $0,79/h en Community Cloud (RunPod), necesitas mejor que aproximadamente 2,2x de rendimiento en tiempo real para superar $0,36, aproximadamente 4,4x para superar el nivel mini, y aproximadamente 5,3x para superar la tarifa de $0,15/hora Universal-2 de AssemblyAI (AssemblyAI). El tiempo de GPU inactivo cuenta en tu contra, por lo que el despliegue solo gana con una cola constante en lugar de tráfico diurno en ráfaga.
¿Es la IA open source de uso gratuito con fines comerciales?
No, y los modelos de imágenes son donde los equipos se quedan atrapados. Se informa de que los pesos FLUX.1 [dev] llevan una licencia no comercial, lo que pondría una licencia de pago de Black Forest Labs entre tú y un despliegue comercial, así que lee los términos antes de planificar en torno a ellos. Incluso con pesos totalmente permisivos, el cómputo no es gratuito: DeepInfra sirve Llama-3.3-70B-Instruct-Turbo a $0,10 de entrada y $0,32 de salida por millón de tokens, y Meta-Llama-3.1-8B a $0,02/$0,04 (DeepInfra), que es más barato que lo que la mayoría de los equipos pueden ejecutar los pesos idénticos por su cuenta en una H100 dedicada a $2,20/h.
¿Necesito auto-alojar para cumplir con el RGPD y la Ley de IA de la UE?
No. El cumplimiento tiene que ver con la ubicación de los datos, los acuerdos de procesamiento y la documentación, ninguno de los cuales requiere que poseas el stack de inferencia. Las apuestas son reales (los reguladores han impuesto €7.100 millones en 2.245 multas del RGPD hasta principios de 2026, y la exposición llega al 4% de la facturación global bajo el RGPD más hasta el 7% bajo la Ley de IA, según Kiteworks), pero las opciones de alojamiento gestionado y soberano en la región de la UE ahora cubren la mayor parte de lo que pide un responsable de protección de datos. Auto-aloja cuando un contrato o regulador prohíbe específicamente el procesamiento por terceros, no como cobertura general.
¿Debería comprar o alquilar GPU durante la escasez de memoria de 2026?
Alquila, a menos que tengas una carga de trabajo de varios años que mantenga las tarjetas ocupadas. La NVIDIA RTX PRO 6000 Blackwell 96GB pasó de un precio de venta al público de $8.565 a principios de 2025 a $13.250 en junio de 2026 y $16.000 en agosto de 2026, aproximadamente un 87% más por un producto sin cambios (igor'sLAB). La causa es la memoria: la HBM ahora ocupa un 23% estimado de la capacidad global de obleas de DRAM frente al 8% en 2024, y los precios de los módulos DDR5 ECC RDIMM de servidor subieron aproximadamente un 100 a 116% entre el primer trimestre de 2025 y el primer trimestre de 2026 (DataCenterDisk). Goldman Sachs pronosticó un déficit de DRAM del 4,9% para 2026, el más amplio en 15 años, con alivio improbable antes de finales de 2027 (Wccftech), así que planifica con precios de compra elevados y aprovecha la diferencia del mercado de alquiler, desde $2,20/h por una H100 dedicada en DeepInfra hasta $4,29/h en Lambda.