La privacidad de datos en herramientas de IA se reduce a una sola prueba: confía en los proveedores que publican números de retención a nivel de endpoint con fechas, y trata a todos los demás como no verificados hasta que lo hagan. OpenAI documenta que los datos de la API no se usan para entrenamiento por defecto desde el 1 de marzo de 2023, y luego documenta por separado que los registros de monitoreo de abuso que contienen tus prompts se conservan 30 días (OpenAI). Esos son dos controles distintos. Anthropic elimina los inputs de la API en un plazo de 30 días, pero conserva el contenido relacionado con infracciones de la Política de Uso hasta 2 años y las puntuaciones del clasificador hasta 7 (Anthropic).
Aquí encontrarás cinco preguntas, las respuestas documentadas de cuatro proveedores y un modelo de cuatro niveles para clasificar las otras 18.948 herramientas de nuestro directorio.
El riesgo pasó de tus empleados a tus proveedores
Auditar el comportamiento de los empleados es la mitad barata de este problema, y es la mitad que cubre cualquier otra lista de verificación de la competencia. La mitad cara es saber si el proveedor al otro lado de la API conserva lo que le envías, durante cuánto tiempo y quién puede exigirlo más adelante.
La IA en la sombra ya es el estado predeterminado
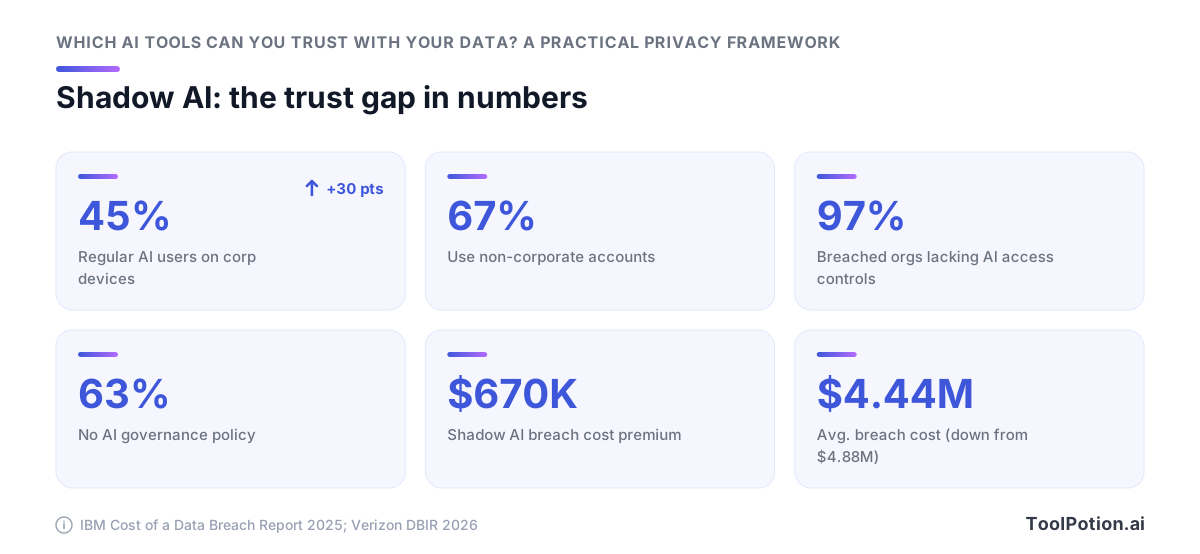
La IA en la sombra también ha escalado hasta convertirse en la tercera acción interna no maliciosa más común en los conjuntos de datos DLP, con un aumento del 400% interanual. Así que una regla que diga «no uses herramientas no aprobadas» es una regla que la mayoría de tu plantilla incumple desde un portátil corporativo antes de comer. La acción viable es hacer un triaje a nivel de proveedor: decide qué herramientas superan un umbral documentado y luego convierte esas en el camino de menor resistencia. Ese conjunto es más amplio de lo que la mayoría de los equipos prevé. Nuestro directorio registra 18.948 listados activos, incluidas las 13.157 apps de IA de nuestro directorio, lo que significa que necesitas un filtro que puedas aplicar en diez minutos, no un cuestionario de seguridad de 40 preguntas.
Lo que cuestan los números de brechas
Los altos niveles de IA en la sombra añadieron 670.000 USD al coste promedio de una brecha, medidos frente a un promedio global de 4,44 millones de USD, bajando desde 4,88 millones, y una media de 241 días para identificar y contener.
Dos cifras más del mismo estudio señalan la causa. El 97% de las organizaciones que sufrieron un incidente de seguridad relacionado con IA carecían de controles de acceso adecuados, y el 63% de las 600 organizaciones estudiadas no tenía ninguna política de gobernanza de IA.
La gobernanza en ese sentido es algo concreto y verificable. Necesitas saber qué proveedor tiene qué datos, bajo qué plazo de retención escrito, confirmado contra una página de política con fecha que puedas abrir ahora mismo y citar a tu equipo legal.
Cinco preguntas que resuelven la privacidad de datos en IA
Cada una de estas preguntas tiene el tipo correcto de respuesta: un documento que puedas guardar, fechar y volver a revisar el próximo trimestre. Si la respuesta es un adjetivo, el proveedor ha suspendido la pregunta. «Seguridad de nivel empresarial» no es una respuesta. Una URL con una fecha de última actualización sí lo es.
1. Si tus datos entrenan el modelo, y en qué nivel
El artefacto es una página de política que nombra el nivel. Los docs de OpenAI indican que «a partir del 1 de marzo de 2023, los datos enviados a la API de OpenAI no se usan para entrenar ni mejorar los modelos de OpenAI (a menos que optes explícitamente)» (OpenAI Developer Docs), y ese valor predeterminado cubre la API, no el ChatGPT de consumo. Anthropic trazó la misma línea al revés para los consumidores: los usuarios Free, Pro y Max que permiten el entrenamiento obtienen una retención de 5 años, los que se excluyen obtienen 30 días, y Claude for Work, Gov, Education y el acceso a la API quedan al margen de todo esto (Anthropic).
Pregunta en qué SKU compró realmente tu equipo. La respuesta cambia según el nivel, y el personal con cuentas personales está en un nivel diferente al de tu contrato.
2. Cuánto tiempo se conserva y cada excepción
Quieres una tabla a nivel de endpoint. El valor predeterminado de 30 días de OpenAI para monitoreo de abuso no aplica en todos lados: los objetos de la Assistants API que no eliminas se «conservan indefinidamente», los Files persisten «hasta que se eliminan», y /v1/videos conserva los datos 48 horas para descarga más 30 días para monitoreo de abuso (OpenAI). Anthropic elimina inputs y outputs de la API «en un plazo de 30 días desde la recepción o generación», y luego lista excepciones que llegan a 2 años para infracciones de la Política de Uso, 7 años para puntuaciones de clasificación de confianza y seguridad, y 5 años para envíos de feedback (Anthropic Privacy Center). Exige esa lista de excepciones por escrito a cualquier proveedor que te ofrezca un número corto.
3. Quién más lo maneja: subprocesadores y hosts de modelos
El artefacto es una lista de subprocesadores versionada con una cláusula de notificación de cambios. La mayoría de las herramientas que evaluarás son wrappers, así que la pregunta real es qué modelo fundacional hay debajo y en la infraestructura de quién. Eso importa sobre todo para los agentes de IA que actúan sobre tus datos, que encadenan herramientas y a menudo pasan por más de un host de modelo por tarea, y para los proveedores de IA a nivel de plataforma cuya lista de subprocesadores define el perímetro.
4. Dónde se procesa y si la residencia está activada por defecto
Consigue una captura de pantalla del ajuste, más la fecha en que se activó. Un sí en la llamada de ventas no significa nada si la consola no muestra la región fijada a tu proyecto, y el modelo detrás de una función tiene sus propias condiciones de datos.
5. Qué pasa bajo una orden de preservación legal
Quieres una política de procesos legales por escrito: quién recibe la notificación, cuándo y qué niveles están excluidos de las órdenes de preservación. El 5 de enero de 2026, el juez Sidney Stein confirmó una orden que exigía a OpenAI entregar 20 millones de conversaciones de ChatGPT de consumidores desidentificadas, concluyendo que las resoluciones del magistrado «no eran claramente erróneas ni contrarias a la ley» (Bloomberg Law). La orden de preservación anterior fue levantada el 9 de octubre de 2025, pero los registros ya capturados bajo ella siguen siendo accesibles (ABA Journal). Un tribunal puede superar a un calendario de eliminación.
La exclusión del entrenamiento y la retención son dos controles distintos
Un proveedor puede decirte, con total veracidad, que no entrena con tus datos y aun así tener tus prompts guardados en disco durante un mes. Son interruptores separados, regidos por párrafos separados en documentos separados, y confundirlos es el error más común en la revisión de proveedores de IA. Haz ambas preguntas y guarda ambas respuestas.
Lo que dicen los valores predeterminados de la API de OpenAI
La frase exacta, de los propios docs para desarrolladores de OpenAI: «A partir del 1 de marzo de 2023, los datos enviados a la API de OpenAI no se usan para entrenar ni mejorar los modelos de OpenAI (a menos que optes explícitamente)» (OpenAI Developer Docs). Ese valor predeterminado cubre la API. No cubre los niveles de ChatGPT de consumo, así que si tu equipo pega material de clientes en una cuenta Plus personal, esta promesa no es la que te protege.
La retención funciona en una pista diferente. OpenAI conserva los registros de monitoreo de abuso, que «pueden contener cierto contenido del cliente, como prompts y respuestas», hasta 30 días en todos los usos de funciones de la API, «a menos que la ley exija una retención más larga, o sea razonablemente necesario para proteger los servicios de OpenAI o a cualquier tercero de daños» (OpenAI Developer Docs). Si te excluyes del entrenamiento, ese registro sigue existiendo.
Por qué el número de 30 días no es uniforme en todos los endpoints
La mayoría de las listas de verificación anotan «30 días» y se detienen ahí. Los docs son más específicos: los objetos de la Assistants API que no eliminas explícitamente se «conservan indefinidamente», los Files persisten «hasta que se eliminan», y la API /v1/videos conserva los datos 48 horas para descarga más 30 días para monitoreo de abuso (OpenAI Developer Docs).
Así que la respuesta a «¿cuánto tiempo conservas mis datos?» depende de qué endpoint conectaron tus ingenieros. El nombre de la empresa en la factura no lo resuelve. Si estás comparando los modelos de IA que rastreamos en cuanto a retención, hazlo por endpoint, por superficie de producto. Un número por empresa es una ficción.
Los 30 días de Anthropic y las excepciones que llegan a 7 años
La página de retención comercial de Anthropic, actualizada por última vez el 1 de julio de 2026, indica que la empresa «eliminará automáticamente los inputs y outputs en nuestro backend dentro de los 30 días posteriores a su recepción o generación» para clientes de la API (Anthropic Privacy Center). Lee las excepciones en la misma página y el panorama cambia: el contenido vinculado a infracciones de la Política de Uso se conserva hasta 2 años, las puntuaciones de clasificación de confianza y seguridad hasta 7 años, y los envíos de feedback durante 5 (Anthropic Privacy Center).
Siete años es una segunda política que se superpone a la de 30 días. Exige la lista de excepciones por escrito a cualquier proveedor que publicite una retención corta, porque los buenos la publican y el resto te enviará una página de marketing.
La retención cero de datos es algo por lo que debes solicitar
ZDR es el control más sólido disponible y el menos autogestionable. En el lado de OpenAI, la aplicación es del lado del servidor, que es el diseño correcto: bajo ZDR, el parámetro store «siempre se tratará como false, incluso si la solicitud intenta establecer el valor en true» (OpenAI Developer Docs). Lo solicitas por cliente y recibes aprobación. No hay casilla de verificación.
Los docs de la plataforma de Anthropic trazan una línea más clara. El contenido de las conversaciones «no se conserva por defecto; la excepción son los Modelos Cubiertos, que requieren retención de 30 días», y Claude Fable 5.1, Mythos 5.1, Fable 5 y Mythos 5 «no están disponibles bajo ZDR a menos que Anthropic lo autorice expresamente» (Claude Platform Docs). Envía una solicitud no conforme y recibirás un invalid_request_error 400, que al menos falla de forma visible. Tu selector de modelos es ahora una decisión de retención.
SOC 2 es una atestación firmada por una empresa de CPA
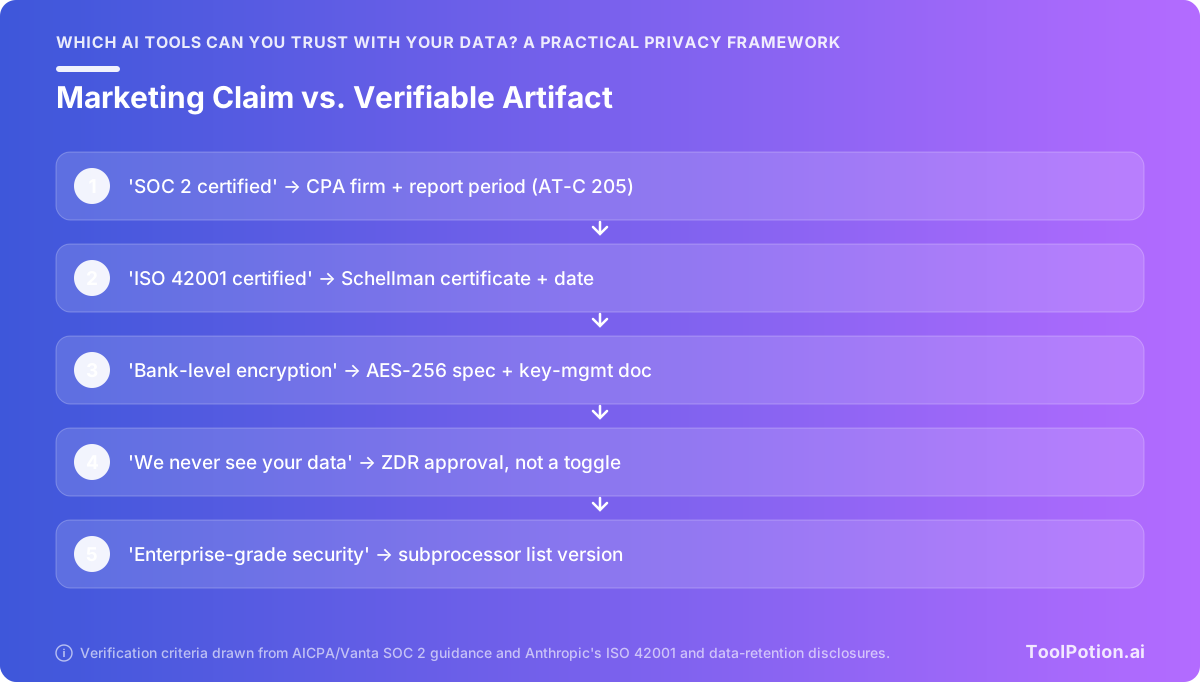
Un informe SOC 2 es una opinión que una empresa de CPA emite sobre un sistema, producida bajo el estándar de atestación AT-C Sección 205 del AICPA. No hay organismo certificador, ni registro, ni línea de aprobado/suspenso (Vanta). Un auditor que detecta controles defectuosos emite una opinión adversa, y ese documento sigue siendo, con precisión, un informe SOC 2.
Por qué «certificado en SOC 2» es una señal de alerta por sí solo
Nadie obtiene certificación en SOC 2, porque la guía del AICPA no permite esa palabra (Vanta). Un proveedor cuya página de seguridad dice «certificado SOC 2» o no sabe lo que produjo su propio auditor, o está contando con que tú no lo sepas. De cualquier manera, ya aprendiste algo sobre cuánto del resto de esa página puedes tomar al pie de la letra.
Pide el informe. Si la respuesta es un logotipo, esa es la respuesta completa.
Qué hace verificable una afirmación de SOC 2
Cuatro cosas, y un proveedor que no entregue las cuatro bajo NDA te está ofreciendo solo un estado de ánimo.
- El nombre de la empresa de CPA que firmó la opinión, para que puedas confirmar que es una práctica con licencia y no un equipo interno.
- Si es Tipo I o Tipo II, y la ventana de observación exacta. Un Tipo II que cubre del 1 de enero al 30 de junio de 2026 no te dice nada sobre cómo se comportaron los controles en agosto.
- La sección de excepciones, textualmente, más la respuesta de la dirección a cada una. Esta es la parte que se recorta del PDF de resumen, y es donde viven los hallazgos reales.
- Qué sistemas cubre el informe. Un informe con alcance en el producto SaaS corporativo no cubre el endpoint de inferencia al que estás enviando registros de clientes.
ISO 42001 y el problema de las auditorías de vigilancia
ISO/IEC 42001 es una certificación real con un organismo acreditado real detrás, lo que la convierte en una evidencia más sólida que el marketing de SOC 2. Aun así, caduca. Anthropic anunció la certificación acreditada ISO/IEC 42001:2023 el 13 de enero de 2025, emitida por Schellman Compliance a través de la acreditación de ANAB (Anthropic). Ese anuncio tiene ya más de un año y medio. Los certificados tienen fechas de vencimiento y dependen de auditorías de vigilancia periódicas, así que el comunicado de prensa demuestra que existió un certificado una vez, no que exista uno hoy.
Descarga el certificado vigente del centro de confianza del proveedor, comprueba las fechas de validez y el enunciado del alcance, y guarda una copia con fecha.
La residencia de datos en la UE es un ajuste por carga de trabajo
Preguntar a un proveedor si admite residencia de datos en la UE te dará un sí que puede cubrir solo la mitad de tu tráfico. La versión útil es por carga de trabajo: qué procesamiento permanece en la región, bajo qué valor predeterminado, y qué modelo hay detrás de la función que activaste.
Las exclusiones de modelos atraviesan tu elección de nube
Los Modelos Cubiertos de Anthropic tienen prohibida la retención cero de datos en la Consola Claude, Claude Enterprise, Amazon Bedrock, Google Cloud Agent Platform y Microsoft Foundry por igual (Anthropic Privacy Center). Elegir la nube no resuelve las condiciones de datos. El modelo detrás de la función tiene sus propias condiciones, y esas cambian cuando un proveedor cambia un backend.
Las cláusulas de residencia rigen dónde se ejecuta la inferencia y dónde se ubica el almacenamiento primario. Las copias de monitoreo de abuso funcionan bajo un calendario separado: OpenAI conserva esos registros hasta 30 días por defecto, «a menos que la ley exija una retención más larga, o sea razonablemente necesario para proteger los servicios de OpenAI o a cualquier tercero de daños» (OpenAI Developer Docs).
Tres cosas que sacar de la consola de administración antes de firmar nada:
- El nombre del interruptor de enrutamiento o residencia, su estado actual y la fecha del último cambio.
- Qué rol de administrador puede cambiarlo, porque un ajuste que cualquier propietario del espacio de trabajo puede deshabilitar no es un control.
- La lista de subprocesadores versionada, guardada como archivo con fecha, para que el diff del próximo trimestre sea un trabajo de dos minutos.
Aplica la misma pregunta a los proveedores más pequeños antes de que cualquiera de ellos toque registros de clientes, incluidas las 2.917 apps de IA para móviles que rastreamos, donde un ajuste de región publicado es el primer artefacto que desaparece.
Por qué valen la pena las sanciones de la Ley de IA
El nivel máximo del Artículo 99 llega hasta 35.000.000 € o el 7% de la facturación anual mundial total, lo que sea mayor, con un nivel medio de 15.000.000 € o el 3% y un nivel de información de 7.500.000 € o el 1% (EU AI Act). Ese techo supera los 20 M€ y el 4% del RGPD. Una hora en cuatro consolas de administración es barata frente a esas cifras.
Cualquier política puede ser anulada por un tribunal
Un calendario de eliminación es un compromiso empresarial. Te vincula al proveedor contigo. No vincula a un juez federal, y cuando ambos colisionan, el juez gana.
La orden de producción de 20 millones de conversaciones
El 5 de enero de 2026, el juez de distrito federal Sidney Stein confirmó la orden de un magistrado que obligaba a OpenAI a entregar una muestra de 20 millones de conversaciones de ChatGPT de consumidores desidentificadas a los demandantes periodísticos en el MDL de derechos de autor consolidado, sosteniendo que «las resoluciones de la jueza Wang no eran claramente erróneas ni contrarias a la ley» (Bloomberg Law). Las protecciones de privacidad en las que se apoyó el tribunal fueron la desidentificación, una orden de protección y una designación de solo para abogados. Son salvaguardas reales. La mayoría de los compradores interpreta una política de retención de 30 días como una garantía de que sus datos nunca salen del proveedor, y esta orden muestra el tamaño de esa brecha.
Nadie que escribió en ChatGPT en 2024 tuvo voz en eso.
Las órdenes de preservación van y vienen, los registros capturados se quedan
La orden de preservación anterior fue levantada el 9 de octubre de 2025. Se liberó a OpenAI de preservar y segregar los datos de registros de output en adelante y, con excepciones limitadas, ya no tenía que conservar registros posteriores al 26 de septiembre de 2025. Los registros ya capturados bajo la orden siguieron siendo accesibles (ABA Journal). Una retención por litigio es un trinquete. Puede pausar un calendario de eliminación en cualquier momento, y levantarla no deshace lo que quedó congelado mientras tanto.
Qué niveles quedaron excluidos y por qué eso importa
Los clientes de la API con Retención Cero de Datos, más ChatGPT Enterprise y Edu, fueron excluidos de la orden de preservación original (ABA Journal). Eso es lo más parecido a una prueba de qué nivel de contrato resiste la presión legal. Los niveles de consumo quedaron incluidos. Los niveles con un acuerdo empresarial firmado y ZDR aplicado por servidor, no.
Un modelo de confianza por niveles que puedes aplicar a cualquier herramienta
Clasifica cada herramienta que uses en uno de cuatro niveles, y deja que el nivel decida qué datos puede tocar. Los artefactos que puedes guardar en una carpeta fijan el nivel, y las garantías de un ingeniero de ventas en una llamada no lo modifican. Una URL de política con fecha del propio dominio del proveedor. Una empresa de CPA nombrada y un período de informe con fecha de inicio y fin. Una lista de subprocesadores con versión o registro de cambios. Un interruptor de residencia que puedas capturar en la consola de administración.
Nivel 1, solo público: sin artefactos verificables
No pudiste encontrar una página de retención, el centro de confianza es un formulario de contacto o la lista de subprocesadores está «disponible bajo solicitud». Trata la herramienta como un canal público. Cualquier cosa que estarías cómodo publicando en tu sitio de marketing puede entrar, y nada más. La mayoría de las 13.157 herramientas de nuestro directorio de Apps de IA se encuentran aquí por defecto, porque un wrapper de dos personas sobre la API de otra empresa generalmente no tiene artefactos en absoluto.
Nivel 2, interno: política con fecha, auditor nombrado, subprocesadores publicados
Tres artefactos en el archivo, cada uno con una fecha que anotaste. Los documentos internos están bien. Los datos de clientes no.
Nivel 3, confidencial: ZDR contractual, residencia activada, compromisos en procesos legales
La retención cero de datos debe estar en tu acuerdo firmado, y en el lado de OpenAI se aplica y aprueba por cliente en lugar de ser activada por ti (OpenAI Developer Docs). También quieres un compromiso escrito sobre cómo el proveedor maneja citaciones y órdenes de preservación. Los datos empresariales confidenciales, el código fuente y los registros de clientes van aquí.
Nivel 4, regulado: solo con un acuerdo firmado y una revisión cada trimestre
Datos de salud, registros financieros, cualquier cosa bajo un DPA con dientes reales. Contrato firmado, subprocesadores nombrados, residencia verificada por carga de trabajo, y una entrada en el calendario para la próxima revisión. Si no puedes obtener los cuatro, la carga de trabajo se mantiene fuera de la herramienta o se mueve a una de las alternativas de código abierto autoalojables donde tú eres dueño del disco.
La regla de obsolescencia: cualquier evaluación de más de un trimestre está vencida
El 9 de junio de 2026, Anthropic designó cuatro Modelos Cubiertos y eliminó la opción ZDR para ellos en la Consola Claude, Claude Enterprise, Amazon Bedrock, Google Cloud Agent Platform y Microsoft Foundry (Anthropic Privacy Center). Los clientes que habían firmado términos ZDR no hicieron nada mal. El compromiso se redujo bajo ellos. Ese es el argumento para volver a descargar cada artefacto cada trimestre y comparar las diferencias, y aplica con más fuerza a los proveedores de modelos fundacionales cuyos términos cambian más rápido.
Cómo ejecutar la evaluación en veinte minutos
Abre una carpeta con el nombre del proveedor. Si no puedes completarla en veinte minutos a partir de páginas públicas más un correo electrónico, la herramienta se queda en el Nivel 1 y nunca toca datos de clientes. Ese valor predeterminado hace más trabajo que cualquier rúbrica de puntuación.
Los cinco artefactos que recopilar antes de la llamada
Los cinco suelen ser públicos. Guarda PDFs o capturas de pantalla con fecha, porque las páginas cambian bajo tus pies.
- La página de retención con su propia fecha de última actualización. La de Anthropic indica el 1 de julio de 2026 y te da 30 días para inputs y outputs de la API (Anthropic Privacy Center). La guía de controles de datos de OpenAI te da el valor predeterminado de entrenamiento de la API desde el 1 de marzo de 2023 (OpenAI).
- La tabla de retención por endpoint, no el número titular. Los objetos de la Assistants API que no eliminas se «conservan indefinidamente» (OpenAI).
- La lista de excepciones. Anthropic publica 2 años para infracciones de la Política de Uso, 7 años para puntuaciones de confianza y seguridad, 5 años para feedback (Anthropic). La mayoría de los proveedores no la publicarán, lo que ya es una respuesta.
- La lista de subprocesadores versionada con una ventana de notificación de cambios.
- La portada del informe SOC 2, o la solicitud de NDA que te permite obtenerlo.
Cuatro preguntas que los proveedores esquivan de forma habitual
Envíalas tal cual. Pide las respuestas por escrito, en el mismo hilo, para tener algo que adjuntar a la carpeta.
Nombra la empresa de CPA que firmó tu informe SOC 2 más reciente y el período exacto del informe. Anthropic nombró a Schellman Compliance para su certificado ISO 42001 (Anthropic), así que el listón es público y alcanzable. Lista cada excepción a tu período de retención declarado. Confirma si la residencia en la UE puede activarse en un proyecto que ya creamos o solo en uno nuevo. Indica tu política de notificación cuando recibas una citación u orden de preservación que cubra nuestros datos.
Qué hacer cuando la respuesta es una página de marketing
Trata un enlace a una página de inicio del centro de confianza como una no-respuesta y reenvía la pregunta con la oración específica que quieres que confirmen. El silencio tras un seguimiento fija el nivel por ti: Nivel 1, solo datos públicos y sintéticos. Puedes hacer esto con cualquier listado de nuestro directorio en los mismos veinte minutos, y los proveedores pequeños fallan más rápido que los grandes, lo que te ahorra la llamada.
Preguntas frecuentes
¿Es seguro usar herramientas de IA con datos de la empresa?
Depende completamente del nivel y contrato en que estés, y el nivel de consumo es donde se concentra la mayor parte del riesgo. Los docs para desarrolladores de OpenAI indican que desde el 1 de marzo de 2023, los datos enviados a la API de OpenAI no se usan para entrenar ni mejorar los modelos de OpenAI a menos que optes explícitamente, y ese valor predeterminado cubre solo la API, no los planes de ChatGPT de consumo. El peligro práctico es el uso no gestionado: el 45% de los empleados son ahora usuarios habituales de IA en dispositivos corporativos, frente al 15% del año anterior, y el 67% de ellos usa cuentas no corporativas, mientras que el 97% de las organizaciones que sufrieron un incidente de seguridad relacionado con IA carecían de controles de acceso adecuados. Lleva a la gente a acuerdos empresariales con términos de retención nominados, porque los altos niveles de IA en la sombra añadieron unos 670.000 USD al coste promedio de una brecha.
¿Excluirme del entrenamiento de IA significa que mis datos no se almacenan?
No. La exclusión del entrenamiento y la retención son dos controles separados, y los proveedores los documentan por separado. OpenAI conserva registros de monitoreo de abuso que «pueden contener cierto contenido del cliente, como prompts y respuestas», hasta 30 días por defecto en todos los usos de funciones de la API, y el número de 30 días no es uniforme: los objetos de la Assistants API que no eliminas se «conservan indefinidamente», los Files persisten «hasta que se eliminan», y la API /v1/videos conserva los datos 48 horas para descarga más 30 días para monitoreo de abuso. La política comercial de Anthropic indica que «eliminará automáticamente los inputs y outputs en nuestro backend dentro de los 30 días posteriores a su recepción o generación», con excepciones que duran mucho más: el contenido vinculado a infracciones de la Política de Uso hasta 2 años, las puntuaciones de clasificación de confianza y seguridad hasta 7 años, y los envíos de feedback durante 5 años. Pide esa lista de excepciones por escrito a cada proveedor.
¿Qué significa «certificado en SOC 2» para un proveedor de IA?
Significa que el proveedor está usando un lenguaje que la propia guía del AICPA no permite. SOC 2 es una atestación realizada por una empresa de CPA con licencia bajo AT-C Sección 205, sin organismo certificador y sin resultado de aprobado/suspenso, por lo que incluso una opinión adversa sigue produciendo un «informe SOC 2». Pide el propio informe, el nombre de la empresa de CPA, el período del informe y la opinión, ya que una insignia en una página de marketing no te dice nada de eso. ISO/IEC 42001 es una certificación real por comparación, y Anthropic anunció la certificación acreditada ISO 42001 el 13 de enero de 2025 a través de Schellman Compliance, un organismo acreditado por ANAB, aunque los certificados necesitan auditorías de vigilancia periódicas, así que consulta el certificado vigente en lugar del anuncio.
¿Puede cambiar la promesa de retención cero de datos de un proveedor después de que firme?
Sí, y hay un ejemplo documentado de 2026. La regla de retención de Modelos Cubiertos de Anthropic, introducida el 9 de junio de 2026, eliminó la opción ZDR para esos modelos en la Consola Claude, Claude Enterprise, Amazon Bedrock, Google Cloud Agent Platform y Microsoft Foundry. Sus docs de plataforma ahora indican que el contenido de las conversaciones «no se conserva por defecto; la excepción son los Modelos Cubiertos, que requieren retención de 30 días», nombrando a Claude Fable 5.1, Mythos 5.1, Fable 5 y Mythos 5, que «no están disponibles bajo ZDR a menos que Anthropic lo autorice expresamente», con solicitudes no conformes que devuelven un invalid_request_error 400. ZDR tampoco es un interruptor en OpenAI: se aprueba por cliente, y una vez concedido, el parámetro store «siempre se tratará como false, incluso si la solicitud intenta establecer el valor en true».
¿La residencia de datos en la UE significa que mis prompts nunca salen de Europa?
No, y tratar la residencia como una casilla de sí/no es cómo los compradores quedan expuestos. Las cláusulas de residencia generalmente rigen dónde se ejecuta la inferencia y dónde se ubica el almacenamiento primario, mientras que las copias de monitoreo de abuso viven bajo un calendario separado: OpenAI conserva esos registros hasta 30 días por defecto, «a menos que la ley exija una retención más larga, o sea razonablemente necesario para proteger los servicios de OpenAI o a cualquier tercero de daños». Las exclusiones a nivel de modelo también cruzan los límites de la nube, ya que los Modelos Cubiertos de Anthropic tienen prohibida la ZDR en Amazon Bedrock, Google Cloud Agent Platform y Microsoft Foundry por igual. Lee la lista de subprocesadores y los valores predeterminados de exclusión, y luego evalúa el lado negativo: las sanciones de la Ley de IA de la UE alcanzan hasta 35.000.000 € o el 7% de la facturación anual mundial, lo que sea mayor.
¿Con qué frecuencia debo revisar la postura de privacidad de una herramienta de IA?
Cada trimestre, e inmediatamente antes de que cualquier nueva carga de trabajo toque datos regulados. La historia reciente muestra por qué una revisión anual es demasiado lenta: la actualización de los términos de consumo de Anthropic publicada el 28 de agosto de 2025 estableció una retención de 5 años para los usuarios Free/Pro/Max que permiten el entrenamiento y dio una fecha límite de decisión del 8 de octubre de 2025, y la excepción ZDR para Modelos Cubiertos llegó el 9 de junio de 2026. Las órdenes judiciales también se mueven más rápido que las páginas de política: la orden de preservación de registros de ChatGPT fue levantada el 9 de octubre de 2025, aunque los registros ya capturados bajo ella siguen siendo accesibles, y el 5 de enero de 2026 el juez Sidney Stein confirmó la orden que exigía a OpenAI producir 20 millones de conversaciones de ChatGPT de consumidores desidentificadas. Cualquier evaluación con una URL de fuente primaria con fecha de más de un trimestre debe considerarse obsoleta.