

Los modelos de pesos abiertos ya están tan cerca de los mejores modelos cerrados que, para mucho trabajo, la pregunta real ya no es la calidad. Es quién ejecuta el modelo, adónde van tus datos y qué te permite hacer la licencia. Bloomberg Intelligence sitúa la brecha entre el mejor modelo chino y el líder estadounidense en un 3 % aproximadamente en un benchmark importante, frente a cerca del 15 % a principios de este año (AI Weekly, citando a Bloomberg).
Este cambio importa sobre todo si eres desarrollador, tienes una startup o formas parte de un equipo con normas de privacidad. Ahora puedes descargar un modelo de Hugging Face, ejecutarlo en hardware que controlas y obtener resultados en código y agentes que hace un año quedaban detrás de una API de pago. O puedes olvidarte del hardware y llamar a esos mismos pesos a través de un proveedor barato.
No todo son ventajas. "Abierto" abarca licencias que van desde "haz lo que quieras" hasta "lee la letra pequeña", algunos de los modelos más grandes necesitan un rack de GPUs y unos cuantos arrastran problemas serios de seguridad y censura. Esta guía ordena a los líderes actuales, te muestra lo que cuestan y te da reglas para elegir. Si buscas un panorama más amplio de modelos cerrados y abiertos, nuestro ranking Top 25 LLMs lo sigue de cerca.
La brecha se redujo y el panorama cambió
La brecha en el benchmark es el titular, así que veamos qué hay detrás. Según las mediciones de Bloomberg, el mejor modelo chino iba cerca de un 15 % por detrás a principios de este año, cerca de un 9 % a mitad de año y cerca de un 6 % un mes después, un mínimo récord en ese momento (The Next Web). La última lectura es de aproximadamente un 3 %. El dato más reciente es DeepSeek V4.1 Flash, que obtuvo 81,1 en LiveBench frente a 83,4 de un modelo líder de Anthropic, y que encabeza la subprueba de programación agéntica de ese benchmark por 77,3 a 66,1.
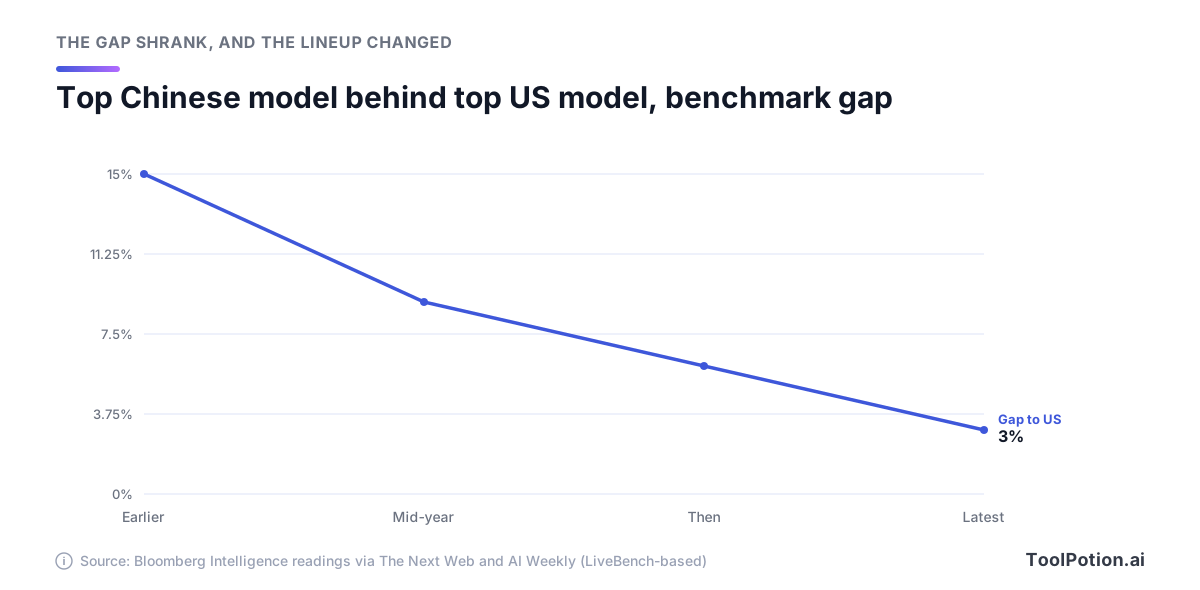
Ten presentes las salvedades. Solo tres de las 15 primeras entradas de LiveBench son chinas, así que esto habla del frente de la frontera, no de un barrido. Además, la brecha es la visión de un solo benchmark sobre el mejor modelo de cada lado, y ninguna de las dos fuentes dice que se limite a modelos abiertos. Aun así, la dirección es clara, y el modelo que la cerró, DeepSeek V4.1 Flash, es de pesos abiertos.
Este año han cambiado otras dos cosas. Primero, Qwen lanzó por primera vez un modelo de clase Max con pesos abiertos, según su propia model card de Qwen3.8-2.4T-A95B. Segundo, se movieron los lanzamientos abiertos de Meta. Los modelos Llama más recientes en la página de Meta en Hugging Face siguen siendo la familia Llama 4 de 2025, como Llama 4 Scout. El sitio para desarrolladores de Meta ahora destaca sus modelos alojados Muse Spark y presenta como modelo abierto a Muse Glimmer, un modelo de 30B de pesos abiertos para agentes locales.
Mistral es la otra novedad. Acaba de anunciar Mistral Large 4, un modelo de 1 billón de parámetros (1T) con 52.000 millones activos, y ha puesto una vista previa en su API. Dice que los pesos llegarán antes de que acabe el mes (Mistral). Cuando se escribió esto no se podían descargar y Mistral no había publicado licencia, así que trata Large 4 como algo prometido, no lanzado. No planifiques en torno a él hasta que los pesos y la licencia estén en Hugging Face.
Los modelos de pesos abiertos que conviene conocer
Estos son los líderes actuales de un vistazo. Los tamaños y las licencias salen de la ficha de cada modelo en Hugging Face, y los precios, de la página de precios de cada fabricante. "Activos" es cuántos parámetros se activan por token en un modelo de mezcla de expertos, que es lo que determina la velocidad.
| Modelo | Licencia | Tamaño (activos) | Contexto | API del fabricante, $ por M de tokens entrada / salida |
|---|---|---|---|---|
| DeepSeek V4.1 Flash | MIT | 763B (8B a 16B) | 1M | 0,30 / 1,20 en hora punta |
| DeepSeek V4-Pro | MIT | 1,7T | 1M | 1,32 / 3,96 en hora punta |
| Kimi K3 | Kimi K3 License | 2,8T (104B) | 1M | 3.00 / 15.00 |
| GLM-5.3 | GLM-5.3 License | 753B | 1M | 1.40 / 4.40 |
| Qwen3.8-27B | Apache 2.0 | 27B denso | 262K | versión alojada próximamente |
| gpt-oss-120b | Apache 2.0 | 117B (5,1B) | n/d | sin API del fabricante |
| Gemma 4 31B | Apache 2.0 | 31B denso | 256K | sin API del fabricante |
| Muse Glimmer | Apache 2.0 | 30B denso | 131K+ | sin API del fabricante |
| Mistral Large 4 | sin publicar | 1T (52B) | n/d | 1,36 / 4,18 en vista previa |
DeepSeek es la opción segura en costes. Los pesos de V4.1 Flash tienen licencia MIT, el precio de la API es el más bajo entre los modelos grandes y las horas valle con la mitad de precio lo reducen aún más (documentación de DeepSeek). Que el nombre no te engañe: aquí "Flash" es un modelo de 763B, con una descarga de 510 GB (model card). V4-Pro-0813 es todavía mayor, con unos 1,7T.
Kimi K3 es el que se lleva los titulares. Con 2,8 billones de parámetros y 104.000 millones activos, logra 93,5 en GPQA Diamond y 91,2 en BrowseComp según su propia ficha. Son cifras de Moonshot, así que tómalas como afirmaciones. Además, la API de Moonshot es la más cara del grupo abierto, lo que sorprende a más de uno (más abajo lo vemos).
GLM-5.3 de Z.ai es el especialista en código. Comparte modelo base con GLM-5.2, y Z.ai dice que todas las mejoras vinieron del posentrenamiento, incluido un salto del 50 % en su benchmark interno de programación (model card). Es una medición del propio fabricante. Su hermano barato Flash, GLM-5.3-Flash, cuesta $0,15 de entrada y $0,50 de salida.
Qwen tiene la gama más amplia. Qwen3.8-27B es un modelo denso de 27B con licencia Apache 2.0, visión, contexto nativo de 262K y un 61,7 reportado en SWE-bench Pro (model card). Para una sola estación de trabajo es la mejor primera prueba en código y agentes, y para la mayoría de equipos pequeños es el modelo con el que empezar. El gran Qwen3.8-2.4T tiene una licencia aparte, que vemos a continuación. También puedes probar Qwen en su app.
gpt-oss-120b de OpenAI ya es veterano, pero sigue siendo útil. Tiene licencia Apache 2.0, 5,1B de parámetros activos y, según OpenAI, funciona en una sola GPU de 80 GB (model card). Se publicó en 2025 y en la página de OpenAI en Hugging Face no apareció ningún gpt-oss más reciente. Gemma 4 es la familia actual de Google; el modelo de 31B tiene licencia Apache 2.0, ventana de 256K y trae versiones cuantizadas para Ollama y llama.cpp (model card). Muse Glimmer es el pequeño: Meta dice que una versión de unos 4 bits ocupa menos de 20 GB y cabe en un margen de 24 GB o 32 GB, con cerca de un 1 % de pérdida de calidad en el ajuste más estrecho (model card).
Europa tiene hoy dos opciones. Mistral Medium 3.5 es un modelo denso de 128B con ventana de 256K y una licencia MIT modificada, que Mistral describe como abierta para uso comercial salvo para empresas con ingresos elevados. Mistral Small 4, de 119B, y el más antiguo Mistral Large 3 tienen licencia Apache 2.0 en Hugging Face.
"Abierto" aún puede traer condiciones
Solo los modelos con Apache 2.0 y MIT son abiertos en el sentido que la mayoría de desarrolladores le da a la palabra. Varios de los más potentes no lo son. Lee el archivo de licencia, no el titular.
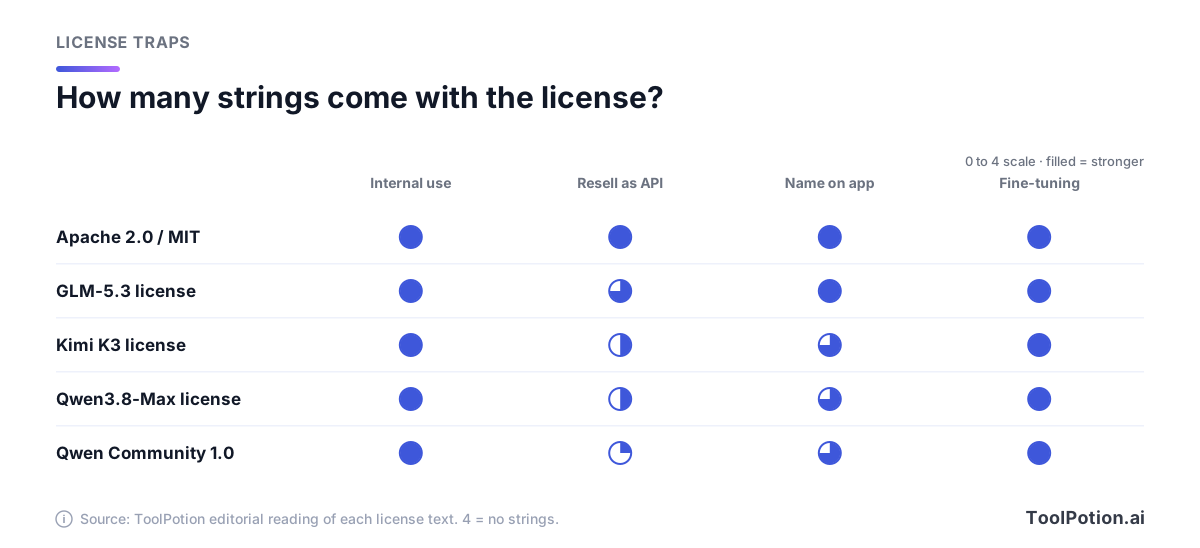
El patrón es el mismo en todas las licencias personalizadas. Puedes usar, modificar y ajustar el modelo libremente. Las condiciones se aplican a vender el modelo a terceros, normalmente como API, cuando superas cierto umbral de ingresos. La licencia de Moonshot, por ejemplo, dice que un operador de "Model as a Service" con más de 20 millones de dólares de ingresos en 12 meses necesita un acuerdo aparte antes del uso comercial. Los productos con 100 millones de usuarios mensuales o 20 millones de dólares de ingresos mensuales deben mostrar "Kimi K3" en la interfaz (texto de la licencia). El uso interno está exento.
La licencia de Z.ai es más laxa. El único filtro es una revisión de seguridad para operadores de Model-as-a-Service con más de 10.000 millones de dólares de ingresos. Las licencias de Qwen son las más estrictas del grupo. La Qwen Community License de Qwen3.8-Flash-Next dice que cualquier empresa que gestione un negocio de Model-as-a-Service o de "AI Work Assistant" debe obtener antes una licencia aparte de Qwen, con una excepción para el uso interno (texto de la licencia). La licencia Max del modelo de 2.4T eleva ese listón a 50 millones de dólares de ingresos.
Si creas una app sobre uno de estos modelos, casi seguro que no tendrás problema. Si tu producto es "una API que sirve este modelo", lee la licencia con un abogado antes de lanzar. Si no quieres ninguna duda, quédate con Apache 2.0 o MIT. Eso significa DeepSeek, Qwen3.8-27B, gpt-oss, Gemma 4 y Muse Glimmer.
Lo que cuestan las API alojadas
Pesos abiertos no significa API barata. El panorama cambia según quién aloje el modelo.
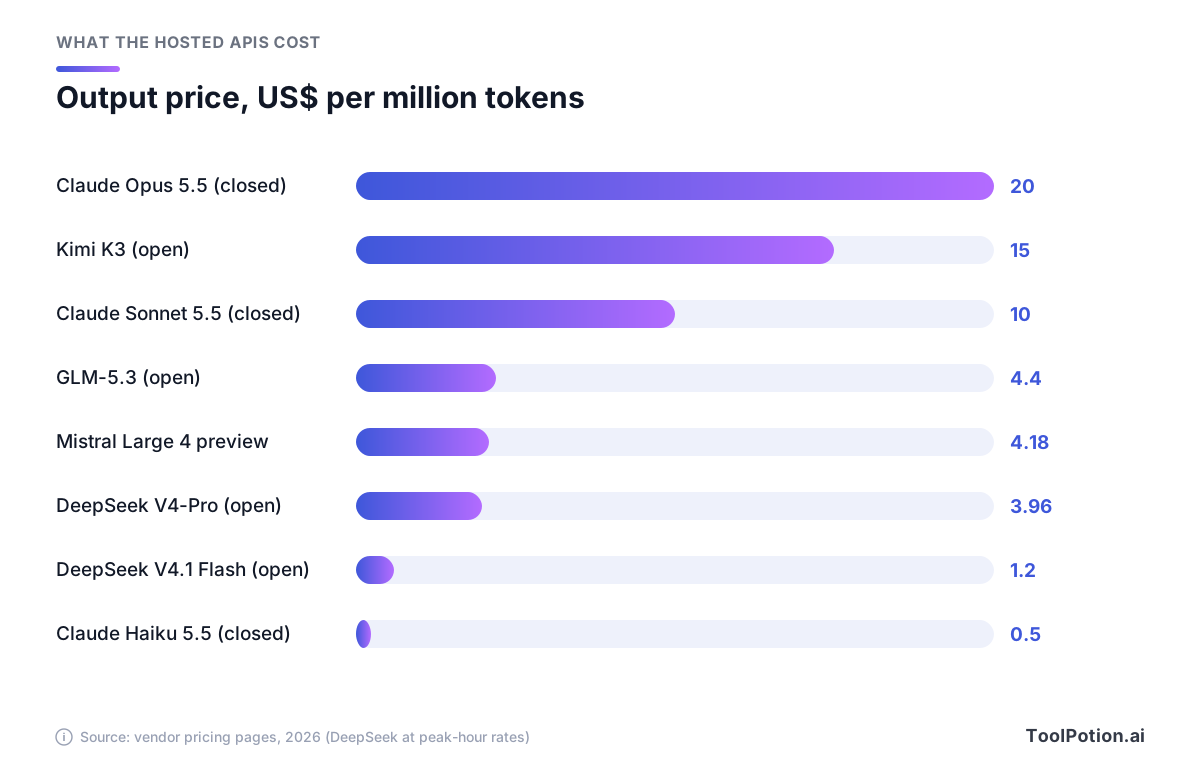
Moonshot cobra $3 de entrada y $15 de salida por millón de tokens por Kimi K3, según su página de precios. Es más que Claude Sonnet 5.5 de Anthropic, a $2 y $10, y Sonnet es un modelo cerrado. DeepSeek es lo contrario: la salida de V4-Pro cuesta $3,96 en hora punta y $1,98 en horas valle. GLM-5.3 de Z.ai cuesta $1,40 de entrada y $4,40 de salida.
Los modelos cerrados pequeños recortan precios frente a la mayoría de los buques insignia abiertos. Claude Haiku 5.5 cuesta $0,10 de entrada y $0,50 de salida, igual que GPT-6 Luna de OpenAI, según la página de precios de cada proveedor. Así que "pásate a lo abierto para ahorrar" solo vale frente a los niveles cerrados caros, y solo si eliges un proveedor abierto barato.
La ruta más barata suele ser un tercero que sirve los mismos pesos. La lista pública de modelos de OpenRouter muestra gpt-oss-120b a unos $0,04 de entrada y $0,17 de salida por millón de tokens, y los precios allí varían según el proveedor y cambian a menudo. OpenRouter, Together AI, Fireworks AI y Groq revenden modelos abiertos con un único formato de API, así que cambiar de proveedor es cambiar la URL base.
Ejecutarlo tú o usar un proveedor
Hay cuatro formas de ejecutar un modelo abierto, y cada una te da un poco más de control y un poco más de trabajo.
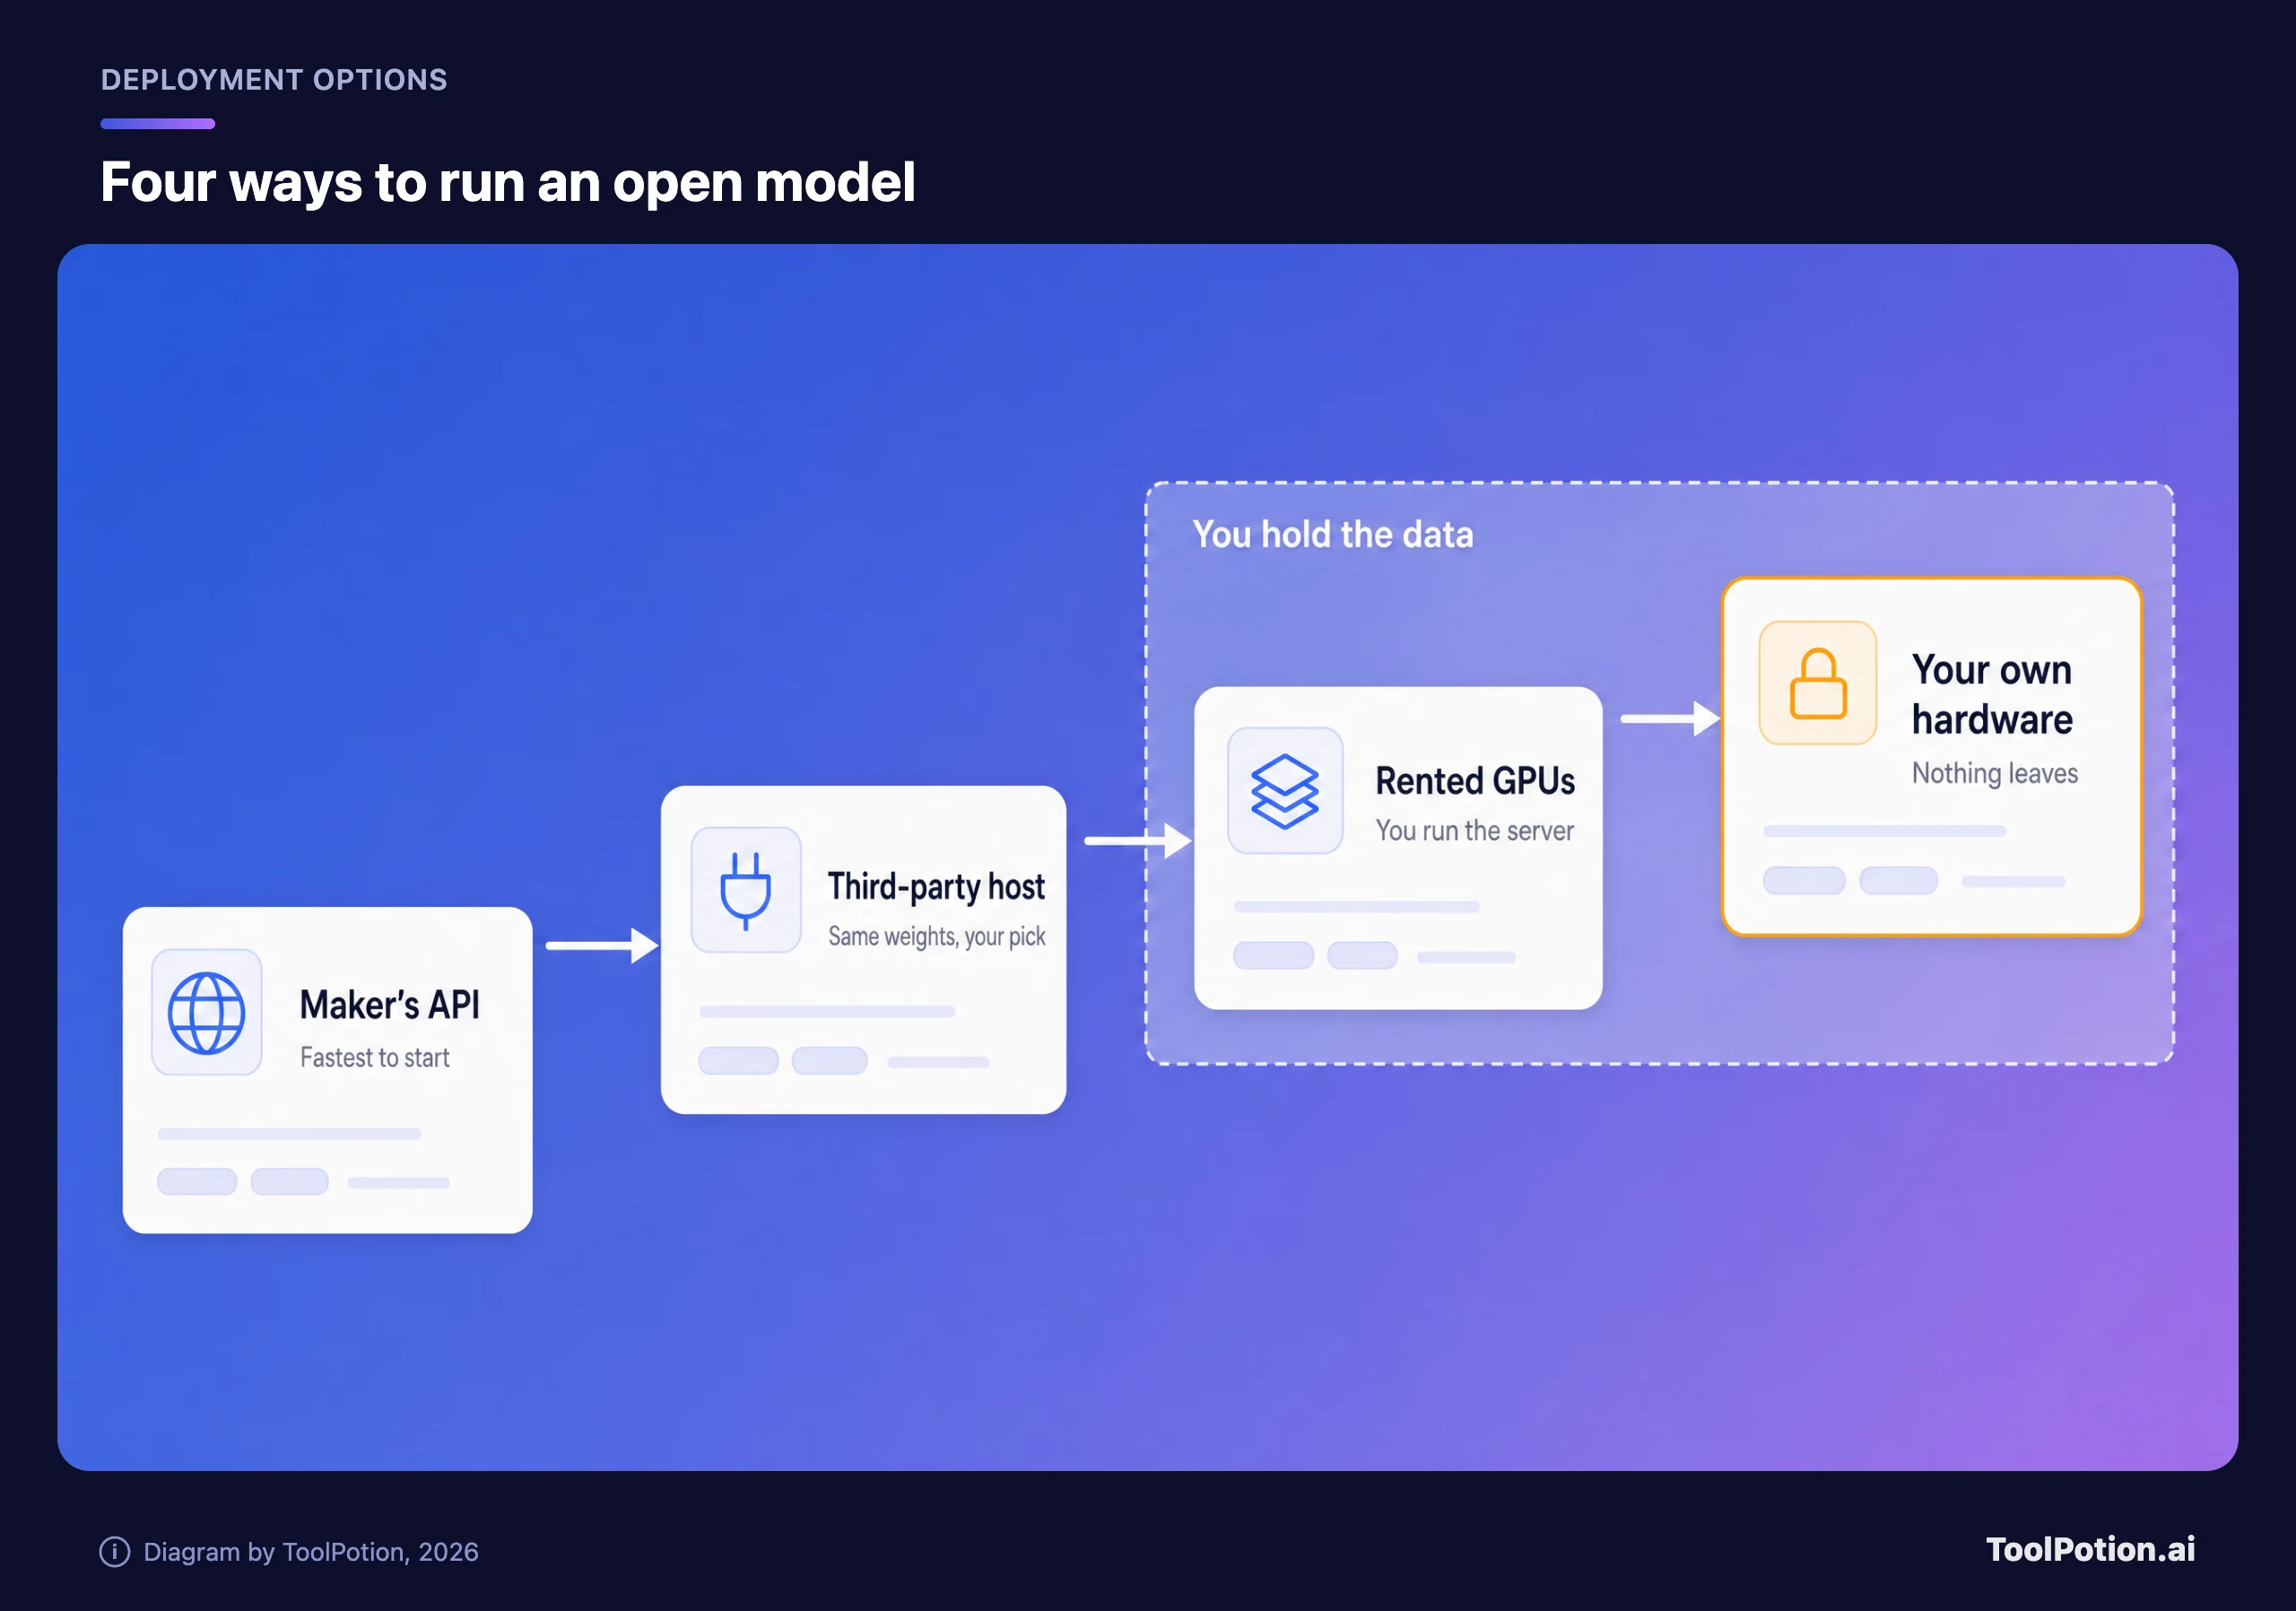
Las dos primeras son gestionadas. Envías tokens al fabricante o a un proveedor, y tus datos viajan por la red de otro. Las dos últimas ponen el modelo en máquinas que controlas, que es lo que importa si un contrato o un regulador dice que los datos no pueden salir. Lo que suele bloquear es que los pesos no caben en tu hardware, así que empieza por el tamaño.
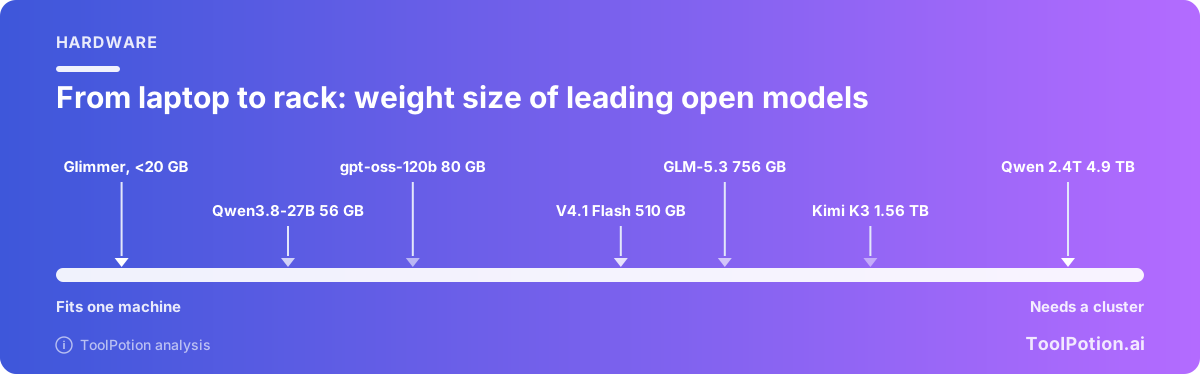
La mayoría de los modelos que acaparan titulares son demasiado grandes para una sola máquina. Solo los pesos de Kimi K3 ocupan 1,56 TB, más que los 1,44 TB que ofrece un nodo de ocho GPUs B200 de 180 GB. DeepSeek V4-Pro y GLM-5.3 necesitan cada uno cientos de gigabytes. Los modelos que caben en una sola máquina son los de la clase de 20B a 120B. Usa el estimador para comprobar un modelo y una precisión contra tu hardware.
Prueba los valores por defecto. gpt-oss-120b a 4 bits necesita unos 70 GB con la sobrecarga, así que cabe en una GPU de 80 GB. Cambia a Kimi K3 y el mismo estimador pide diez GPUs de 180 GB. Diez GPUs son dos nodos de ocho. Al precio bajo demanda de Lambda de $6,69 por hora de B200 según su página de precios, esas 16 GPUs funcionando todo el mes salen por unos $78.000. Ese es el coste de autoalojar un modelo abierto de frontera, antes de poner a nadie a operarlo.
El extremo pequeño es mucho más amable. Lambda ofrece una GPU de 80 GB desde $3,99 la hora, unos $2.900 al mes si funciona las 24 horas. Que eso compense frente a una API depende por completo del volumen.
Con 300 millones de tokens de salida al mes y un precio de API de $10, las dos facturas salen más o menos iguales. Por debajo, gana la API. Por encima, gana el alquiler, siempre que la GPU esté ocupada y el modelo sea lo bastante bueno para la tarea. Pero la comparación honesta es con un proveedor barato. Al precio de proveedor listado de gpt-oss-120b, unos $0,17 por millón de tokens de salida, $2.900 compran unos 17.000 millones de tokens de salida, así que una sola GPU alquilada casi nunca gana a un proveedor solo por costes. Alquila por privacidad, control y latencia predecible. No alquiles para ahorrar con un modelo pequeño.
Un ejemplo práctico con un volumen inventado pero plausible. Imagina un equipo de soporte que resume 20.000 tickets al día, cada uno de 1.500 tokens de entrada y 300 de salida. Son unos 900 millones de tokens de entrada y 180 millones de salida al mes. Con Claude Sonnet 5.5 a $2 y $10 por millón, la factura es de $3.600. Con DeepSeek V4.1 Flash a tarifa de hora punta son como máximo $486, y la mitad en horas valle. Con gpt-oss-120b a los precios de proveedor listados son unos $64. Una GPU de 80 GB alquilada cuesta $2.913 envíes lo que envíes. El proveedor barato gana por goleada, y el modelo cerrado cuesta unas siete veces más que el abierto al precio del propio fabricante.
Dos atajos ayudan antes de gastar nada. Para un portátil o una estación de trabajo, Ollama y llama.cpp ejecutan versiones cuantizadas de Gemma 4, Qwen3.8-27B y Muse Glimmer con un solo comando. Para un servidor de producción, vLLM es el motor de inferencia que las fichas de Kimi K3 y Qwen3.8 indican como compatible.
Cómo elegir
Empieza por tu restricción, no por el ranking. Tres preguntas ordenan la mayoría de los casos.
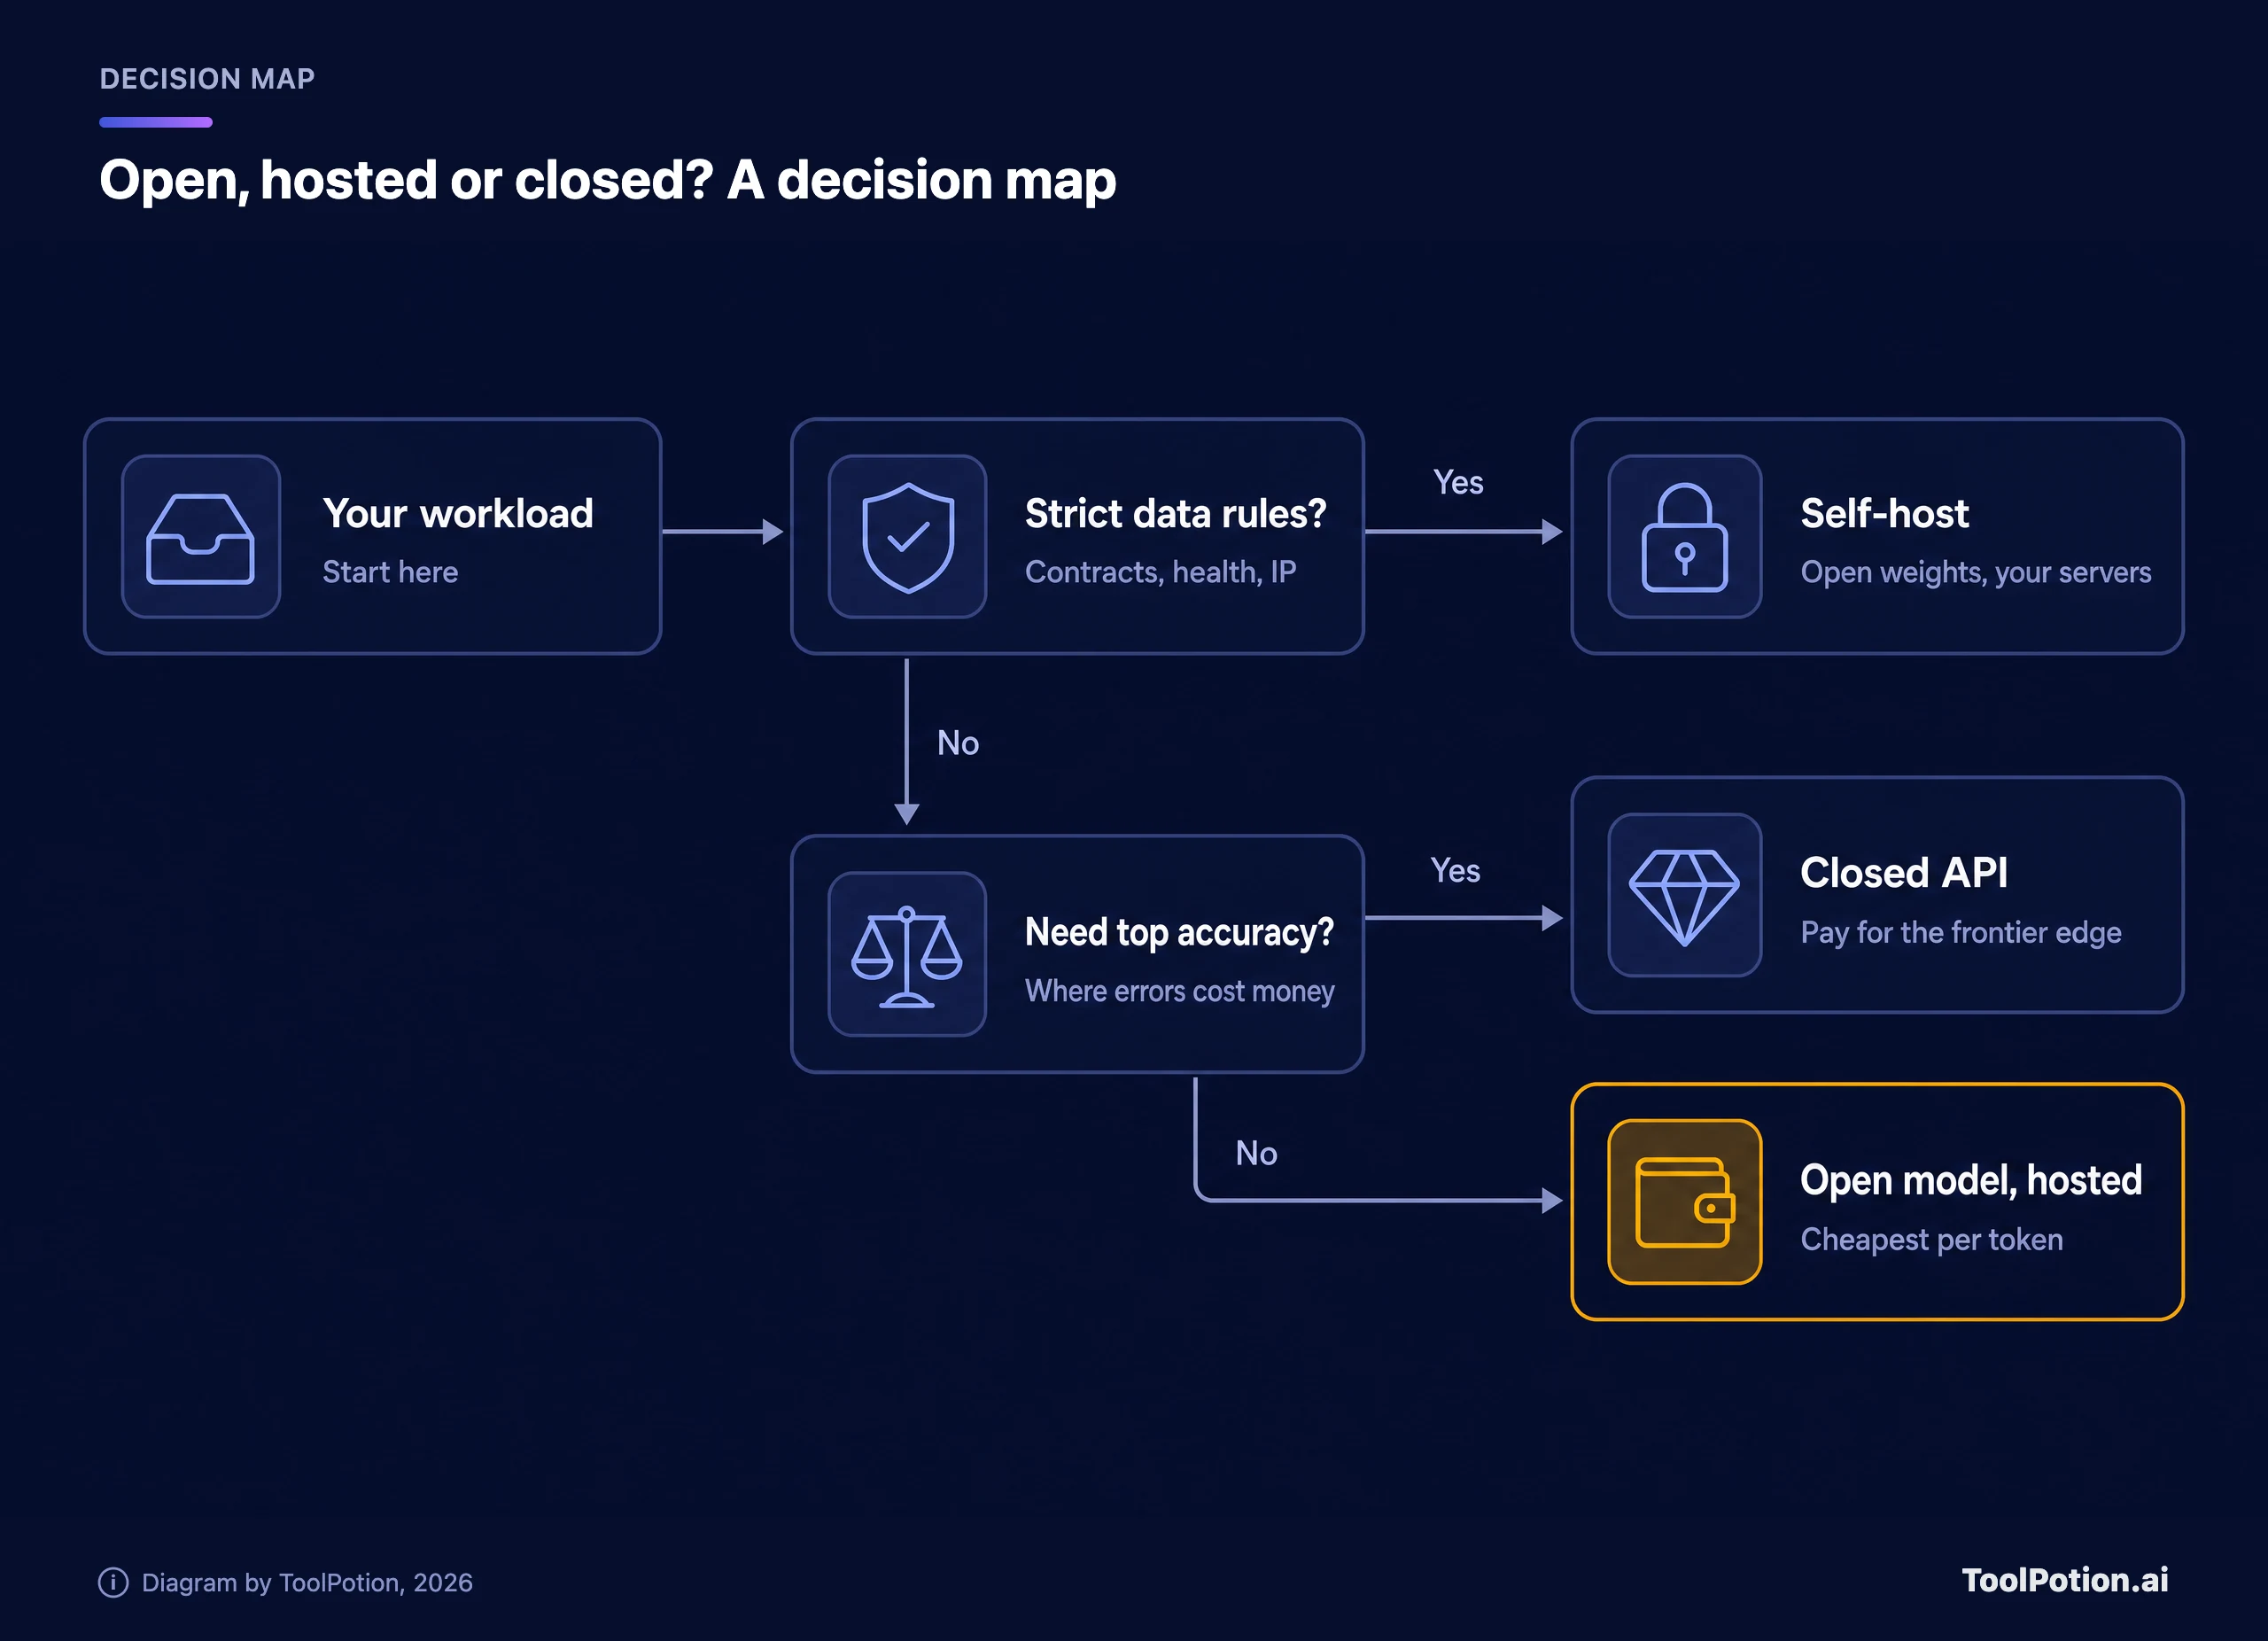
Si tus datos no pueden salir de tu control, vas a autoalojar, y el modelo tiene que caber en tu hardware. Con esa restricción:
- Una GPU o una estación de trabajo: Qwen3.8-27B para código y agentes, gpt-oss-120b si quieres un modelo occidental, Muse Glimmer o Gemma 4 para un portátil.
- Un servidor con varias GPUs: DeepSeek V4.1 Flash o GLM-5.3 si puedes permitirte ocho tarjetas grandes y unos cientos de gigabytes de pesos.
- Un clúster: Kimi K3 o Qwen3.8-2.4T, pero solo si tienes un equipo que vive de ejecutar inferencia.
Si tus datos pueden salir, pregúntate si los errores son caros. Cuando lo son (borradores legales, análisis financiero, código que se publica sin revisión), paga un modelo cerrado de frontera y compruébalo con tus propios ejemplos. Cuando no (resumir, etiquetar, extraer datos, búsqueda interna, código en primer borrador), un modelo abierto a través de un proveedor barato es el mejor precio que encontrarás.
Repasa esta lista en orden antes de elegir:
1. Anota la restricción que no puede moverse: ubicación de los datos, presupuesto mensual o un mínimo de calidad.
2. Revisa la licencia para tu caso de uso. Un producto construido sobre el modelo está bien casi en todas partes. Revender el modelo es donde están las condiciones.
3. Comprueba la memoria: los pesos en GB frente al hardware que realmente comprarías o alquilarías.
4. Calcula el precio de la misma carga en una API del fabricante, en un proveedor externo y en una GPU alquilada.
5. Pasa 50 de tus propias tareas por dos o tres candidatos y quédate con el ganador.
Prueba antes de comprometerte. Los benchmarks de aquí son los del propio fabricante, ejecutados en suites distintas, así que un 90 en un ranking dice poco sobre un 88 en otro. Toma 50 tareas reales de tu carga de trabajo, pásalas por dos o tres candidatos y puntúa los resultados. Una tarde así vale más que una semana leyendo model cards.
Los riesgos que nadie pone en la model card
Seguridad. Los pesos abiertos no hacen seguro a un modelo. En su evaluación de 2025 de modelos DeepSeek más antiguos, el NIST del gobierno de EE. UU. comprobó que el mejor de ellos, R1-0528, cumplió el 94 % de las peticiones abiertamente maliciosas bajo jailbreaks comunes, frente al 8 % de los modelos de referencia estadounidenses. Los agentes de DeepSeek también tenían 12 veces más probabilidades de seguir instrucciones maliciosas ocultas en el contenido que manejaban (NIST CAISI). Son modelos anteriores a la línea V4 actual, y en las fuentes de este artículo no apareció una evaluación pública equivalente de las versiones actuales. Tómalo como una razón para probar, sobre todo antes de darle a un modelo herramientas y acceso de escritura.
Censura. El NIST también encontró que los modelos de DeepSeek repetían cuatro veces más narrativas inexactas del PCCh que los modelos de referencia estadounidenses. Otro informe del NIST sobre Kimi K2 Thinking halló una censura fuerte en chino, pero el modelo estaba relativamente sin censurar en inglés, español y árabe. Si tus usuarios preguntan por política o historia en chino, pruébalo directamente. Si se trata de código y hojas de cálculo, rara vez sale el tema.
Residencia de datos. Quién aloja el modelo decide adónde van tus datos. La política de privacidad de DeepSeek dice que recopila, procesa y almacena datos personales en la República Popular China (política de privacidad de DeepSeek). Eso se aplica a su propia app y API, no a los pesos con licencia MIT que ejecutes en otro sitio. Mistral hace el planteamiento contrario: dice que entrenó Large 4 en sus propios centros de datos en Europa y que ejecuta la vista previa como un despliegue europeo bajo la ley europea. Con cualquier proveedor, pregunta dónde se ejecuta la inferencia y qué se registra antes de enviar datos de clientes.
Obsolescencia. Los modelos abiertos se quedan anticuados en cuestión de meses. Los pesos de gpt-oss tienen un año, el Llama más nuevo de Meta es de 2025, y Qwen y DeepSeek han lanzado varias versiones solo en 2026. Fija la versión exacta del modelo que probaste y vuelve a probar cuando actualices.
Quién debería seguir pagando una API cerrada
El 3 % es la lectura de un solo benchmark. Los modelos cerrados aún lideran en la cima absoluta, y los laboratorios que los venden siguen añadiendo herramientas y funciones gestionadas que los pesos abiertos no traen.
Paga por Claude o ChatGPT si necesitas la mayor precisión en trabajo difícil y de alto riesgo, si no tienes a nadie que gestione infraestructura o si el volumen es tan pequeño que ningún sistema de alojamiento marcaría la diferencia. Un equipo que hace unos miles de llamadas al día gastará menos en tiempo de ingeniería de lo que ahorraría en tokens. Paga también si quieres que un único proveedor responda por la disponibilidad, la seguridad y el soporte.
Combina, no cambies del todo. Una configuración habitual envía el grueso rutinario a un modelo abierto a través de un proveedor y escala los casos difíciles a uno cerrado. Las reglas de enrutado de nuestra guía sobre cómo asignar niveles de modelo a tareas se aplican directamente: barato por defecto, escalar si falla.
Preguntas frecuentes
¿Qué diferencia hay entre pesos abiertos y código abierto?
Pesos abiertos significa que puedes descargar el modelo entrenado. Código abierto, en sentido estricto, incluiría además los datos de entrenamiento y el código bajo una licencia aprobada. Casi nada de esta lista cumple ese listón. Los modelos con Apache 2.0 y MIT son lo más cercano en la práctica. Las licencias personalizadas, como las de Kimi y Qwen, añaden condiciones.
¿Puedo usar estos modelos con fines comerciales?
Sí, para construir productos sobre ellos, con todas las licencias que vemos aquí. Las condiciones aprietan cuando vendes el propio modelo como servicio y, en unos pocos casos, cuando tu producto es enorme. Los modelos con Apache 2.0 y MIT no tienen ninguna condición de ingresos.
¿Qué modelo abierto es mejor para programar?
Según las cifras de los propios fabricantes, lideran GLM-5.3, Kimi K3 y DeepSeek V4.1 Flash, y los tres necesitan hardware de clase servidor. Para una sola máquina, Qwen3.8-27B es la opción práctica. Haz tus propias pruebas con tu propio código, porque las suites de benchmarks difieren.
¿Es seguro usar DeepSeek con datos de empresa?
Depende de cómo lo ejecutes. La app y la API de DeepSeek almacenan los datos en China según la política citada arriba. Los pesos MIT, ejecutados en tus propios servidores o en un proveedor de confianza, no envían nada a DeepSeek. Los riesgos separados de comportamiento del modelo de la evaluación anterior del NIST siguen vigentes.
¿Cuánta memoria de GPU necesito?
Aproximadamente parámetros por bits divididos entre ocho, más un 20 % para la caché y el entorno de ejecución. Un modelo de 27B a 8 bits ronda los 33 GB con sobrecarga. Un modelo de 117B a 4 bits ronda los 70 GB. El estimador de arriba te hace las cuentas.
¿Cuándo será abierto Mistral Large 4?
Mistral ha prometido los pesos poco después del anuncio y no ha publicado los términos de la licencia. Consulta su página de Hugging Face antes de planificar en torno a él.