

Tu pipeline multimodal no fallará porque un modelo alucine. Fallará porque la URL de descarga de Sora expiró 61 minutos después de que terminó el renderizado, o porque tu podcast de 90 minutos superó el límite de transcripción de 25 MB de OpenAI cuando AssemblyAI habría aceptado el archivo completo de 5 GB en una sola solicitud.
Cada salto entre modelos tiene un contrato: un formato de archivo exacto, un nivel de plan que lo desbloquea, una ventana de expiración y un respaldo para cuando el proveedor elimine el modelo. La mayoría de las guías omiten los cuatro.
Esta te da los contratos, tres pipelines trabajados y el plan de sustitución que necesitas antes de que OpenAI cierre la Videos API y ambos modelos Sora 2 el 24 de septiembre de 2026 sin ningún reemplazo listado. Faltan 19 días.
Por qué los pipelines multimodales fallan en los traspasos, no en los modelos
Cada modelo en tu cadena funciona. La transcripción es precisa, la imagen se ve bien, la voz suena humana, el vídeo se renderiza. Lo que falla es el momento en que el archivo de salida de un modelo tiene que convertirse en el archivo de entrada del siguiente, y nadie escribió cómo debía verse ese resultado.
Un ejemplo concreto: las URLs de descarga de activos generados por Sora son válidas como máximo una hora después de la generación, y el resultado llega como un MP4 más una miniatura WebP y una hoja de sprites JPG (OpenAI). Si tu pipeline encola el renderizado y llega al paso de copia 90 minutos después, el renderizado ya no existe. El modelo hizo su trabajo a la perfección.
El contrato de traspaso: formato, nivel, expiración, respaldo
Trata cada salto como un contrato con cuatro cláusulas que escribes antes de construir nada.
El formato es la especificación exacta del archivo que el siguiente salto requiere, hasta la frecuencia de muestreo y las dimensiones en píxeles, no una relación de aspecto y una esperanza. El nivel es el plan de suscripción o el parámetro de API que desbloquea ese formato, porque muchos de los formatos que necesitas están restringidos tras una suscripción de pago o el nombre de un modelo antiguo. La expiración es el tiempo durante el que el artefacto permanece recuperable desde el proveedor antes de que la pérdida sea tu responsabilidad. El respaldo es lo que intercambias cuando el proveedor retira el modelo, lo cual ahora mismo no es hipotético.
Escribe esas cuatro líneas por salto y la mayoría de los errores de depuración desaparecen antes de que empieces.
Cuatro modos de fallo que matan un pipeline a mitad de la ejecución
- El salto anterior emite un formato que el salto siguiente degrada silenciosamente o rechaza por completo.
- Una función que asumiste que estaba en la API resulta estar detrás de un nivel de plan superior o una versión de modelo más antigua.
- El artefacto expira en el almacenamiento del proveedor mientras tu trabajo sigue en cola.
- El modelo sobre el que construiste recibe una fecha de cierre y el proveedor no lista ningún reemplazo recomendado.
Los tres pipelines que siguen son instancias del mismo contrato: podcast a notas del programa, guión a vídeo narrado y foto de producto a conjunto de campaña. Cada uno nombra el formato, el nivel, la expiración y el respaldo en cada salto.
Esto está escrito para alguien que entrega un resultado, no para quien compara arquitecturas de fusión. Puedes elegir las herramientas individuales entre las 18.982 herramientas de IA activas en nuestro directorio. Conectarlas es la parte que nadie documenta.
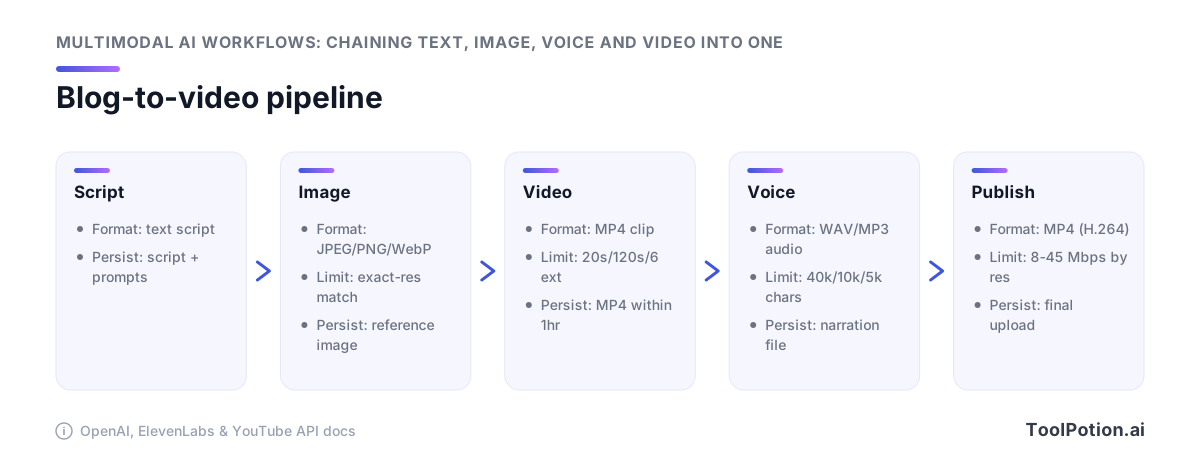
Pipeline 1: artículo de blog a vídeo narrado
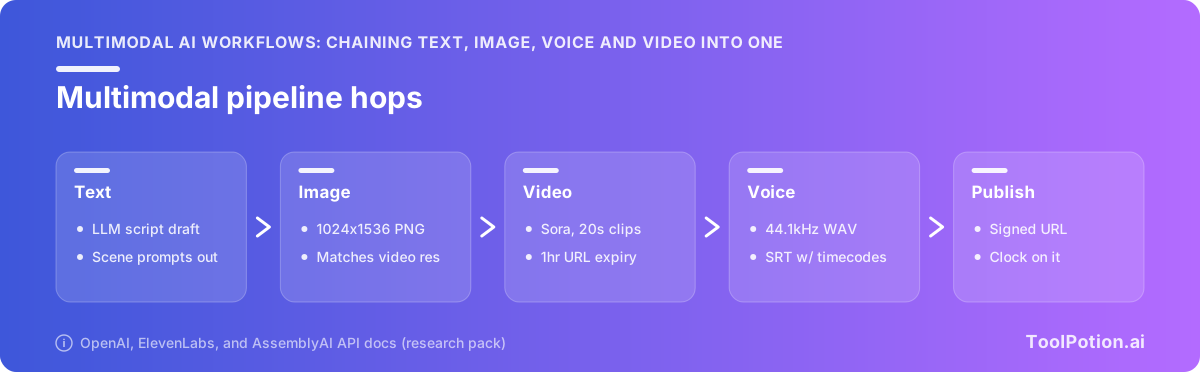
Tienes un artículo de 1.200 palabras y quieres obtener un vídeo narrado de dos minutos al final. Cuatro saltos: divide el texto, genera imágenes fijas, anímalas, ponles voz. Cada uno de esos saltos tiene una especificación que el salto anterior debe satisfacer, y estableces la mayoría de esas especificaciones antes de hacer una sola llamada a la API.
Segmentación del guión antes de cualquier llamada de generación
La segmentación no es un paso de formato que haces al final. Es el parámetro que hereda todo lo que viene después, porque el modelo de voz que elijas limita lo que puedes enviar por solicitud. Eleven Flash v2.5 acepta 40.000 caracteres, Multilingual v2 acepta 10.000 y v3 se detiene en 5.000 (ElevenLabs). Elige v3 para narración expresiva y tu guión de 1.200 palabras cabe en una sola llamada. Úsalo para un explicativo de 9.000 palabras y tendrás que dividirlo en dos, con una juntura que debes ocultar.
Segmenta por límites de escena, no por conteo de oraciones. Cada segmento necesita una idea visual, una duración objetivo en segundos y una resolución de píxeles objetivo adjunta como metadatos. Ese último campo es el que lee el salto de imagen.
Salto de imagen: igualar exactamente las dimensiones en píxeles del salto de vídeo
La ruta imagen-a-vídeo de Sora requiere que la imagen de referencia coincida exactamente con la resolución del vídeo objetivo, en image/jpeg, image/png o image/webp (OpenAI). Exactamente significa píxeles, no «16:9». Un generador de imágenes al que se le pide producir una imagen panorámica te entregará felizmente 1792x1024 cuando la llamada al vídeo quiere 1280x720, y el trabajo falla en el envío en lugar de en el renderizado. Así que la plantilla del prompt de imagen incluye el ancho y el alto como enteros literales extraídos de la configuración del salto de vídeo, y validas las dimensiones y el tipo MIME del archivo devuelto antes de encolar nada más. Entre los 324 modelos de IA listados en nuestro directorio, los que te permiten especificar dimensiones de píxeles arbitrarias en lugar de preajustes con nombre son los que vale la pena integrar aquí.
Salto de vídeo: clips de 16 y 20 segundos encadenados
Tanto sora-2 como sora-2-pro generan clips de 16 o 20 segundos. Cada extensión añade hasta 20 segundos, con un máximo de seis extensiones y 120 segundos en total (OpenAI). Tu segmento de dos minutos son seis llamadas encadenadas.
La continuidad entre esas seis es tu problema. El modelo no recuerda el arco narrativo entre la extensión 3 y la extensión 4, por lo que el prompt de cada llamada debe volver a indicar el escenario, el sujeto y el comportamiento de la cámara. Presupuesta reintentos en las junturas.
Salto de voz y el muxeo
Genera la narración por segmento, no por vídeo, para que una toma mala te cueste una sola llamada. Luego alinea: el audio del segmento 4 tiene que encajar en el clip de 20 segundos que renderizaste para el segmento 4, lo que generalmente significa recortar el texto del guión en lugar de estirar el audio en el tiempo. Muxea con ffmpeg, un segmento a la vez, luego concatena.
Pipeline 2: episodio de podcast a clips y notas del programa
Entra un WAV de 58 minutos. Salen una transcripción, capítulos con marcas de tiempo, seis clips verticales con subtítulos incrustados y una página de notas del programa. El audio nunca cambia de formato después del primer salto, que es lo que hace este pipeline más sencillo que el de vídeo. Lo que decide si funciona es a qué proveedor de transcripción enrutas y qué tres parámetros estableces en la solicitud.
El límite de 25 MB y cómo esquivarlo
El endpoint de transcripción de OpenAI limita las subidas a 25 MB y acepta mp3, mp4, mpeg, mpga, m4a, wav y webm (OpenAI). Un WAV de 58 minutos a 48 kHz pesa aproximadamente 300 MB. Así que o bien transcodificas a un MP3 de bajo bitrate y confías en la suerte, o divides el archivo, y dividir audio en límites de bytes arbitrarios corta palabras por la mitad y desplaza cada marca de tiempo tras la división.
AssemblyAI acepta hasta 5 GB por solicitud en /v2/transcript (2,2 GB si subes archivos locales a través de /v2/upload) y gestiona desde 160 ms hasta 10 horas (AssemblyAI). Eso es unas 200 veces el límite máximo. Para audio de larga duración, envía el episodio completo allí y reserva tu proveedor de LLM para los saltos de razonamiento posteriores.
Las marcas de tiempo a nivel de palabra son el primitivo de corte de clips
No puedes cortar clips automáticamente de una transcripción que solo tiene límites de párrafo. Necesitas saber que la palabra «bueno» empieza a las 00:41:12.340 para que el corte aterrice antes, no a través de ella.
Dos advertencias en el lado de OpenAI. La salida SRT y VTT más el parámetro timestamp_granularities[] solo funcionan con whisper-1, no con gpt-transcribe ni gpt-4o-transcribe (OpenAI). Si tu pipeline incrusta subtítulos o corta por código de tiempo, mantienes el modelo más antiguo en la cadena a propósito y dejas de tratarlo como deuda técnica. ElevenLabs Scribe v2 te proporciona marcas de tiempo a nivel de palabra, diarización y detección de entidades en más de 90 idiomas en una sola respuesta (ElevenLabs), lo cual es la opción más limpia si ya les pagas por el salto de TTS.
La diarización solo funciona si la solicitas
Las etiquetas de locutor requieren que chunking_strategy esté configurado en auto para cualquier audio de más de 30 segundos, y gpt-4o-transcribe-diarize solo realiza identificación de locutores (OpenAI). Omite el parámetro y la solicitud se completa con éxito. Recibes de vuelta un bloque de texto limpio, fluido y completamente sin etiquetar, y nada en la respuesta te indica que una entrevista a dos presentadores acaba de colapsarse en una sola voz. Comprueba los campos de locutores en tu paso de validación, no a ojo.
De la transcripción a notas del programa, capítulos y textos para redes sociales
Una transcripción con marcas de tiempo de palabras se ramifica en cuatro artefactos sin ningún procesamiento de audio adicional: marcadores de capítulo por cambios de tema, un párrafo de resumen más una lista de enlaces para la página de notas del programa, candidatos a clip clasificados por densidad de citas, y los propios cortes verticales renderizados a partir de esos puntos de entrada y salida. Alimenta la misma transcripción a cada uno, en paralelo, con distintos prompts. Si buscas referencias de formato antes de construir, hay 201 podcasts de IA en nuestro directorio que publican aproximadamente con esta pila.
Pipeline 3: fotos de producto a variantes de anuncio
Una foto de estudio de un zapato se convierte en doce imágenes estáticas con la identidad de marca y luego en cuatro anuncios en movimiento de 8 segundos para publicidad en redes sociales. Los saltos son imagen de entrada, imagen de salida, vídeo de salida, y el trabajo de ingeniería interesante se sitúa entre los saltos dos y tres, donde un modelo de visión examina lo que produjo el generador de imágenes y decide si pasa la prueba.
Revisión con modelo de visión como puerta de control de calidad
Las imágenes de producto generadas fallan de maneras predecibles. Logotipo en el lugar equivocado, seis ojales en vez de cinco, una sombra que contradice la luz principal. No quieres que un humano revise a ojo 120 variantes, así que las envías a un modelo de visión junto con la foto original y una especificación escrita de la marca, y pides un resultado de aprobado/reprobado más una cadena de texto con el motivo.
Claude acepta hasta 100 imágenes por solicitud en modelos de contexto de 200k y 600 en otros modelos, con 20 por mensaje en claude.ai, limitadas a 8000x8000 px y 10 MB por imagen (Claude Docs). Esos no son los números que te van a dar problemas.
El límite estándar de tamaño de solicitud de 32 MB sí lo es. Doce PNGs de 4K lo superan mucho antes de llegar a las 100 imágenes, por eso Anthropic recomienda subir a través de la Files API y referenciar cada imagen por file_id en lugar de incrustarlas en base64 (Claude Docs). Construye el salto de revisión así desde el primer día. Adaptarlo después de que tus tamaños de lote crezcan significa reescribir el constructor de solicitudes y la lógica de reintentos al mismo tiempo.
El muestreo de fotogramas es una palanca de coste directa
Claude factura las imágenes como tokens visuales de 28x28 píxeles, calculados como ⌈ancho/28⌉ × ⌈alto/28⌉. Un fotograma de 3840x2160 cuesta 4.784 tokens visuales en el nivel de alta resolución y 1.560 tras el escalado reducido en el nivel estándar, aproximadamente $23,92 por cada mil fotogramas de 4K a la tarifa de entrada de $5/M de Claude Opus 5 (Claude Docs). Reduce la escala antes de enviar, a menos que la revisión de control de calidad dependa de detalles finos como costuras o texto pequeño.
El mismo cálculo rige el salto de análisis de vídeo. Revisar cuatro anuncios de 8 segundos a 24 fps son 768 fotogramas si no eres cuidadoso. Muestrea a 2 fps, comprueba 64, y tu factura de revisión cae por un factor de doce sin perder un solo cambio de escena.
Agrupar imágenes sin superar el límite de la solicitud
Agrupa por bytes de carga útil, no por número de imágenes. Ordena las variantes en grupos que se mantengan por debajo de aproximadamente 25 MB de referencias, mantén la foto original en cada lote como ancla de comparación, y reenvía los fallos individualmente a resolución completa para que la cadena de texto con el motivo merezca la pena leer. Nuestro directorio lista 727 generadores de imágenes y 342 editores de fotos entre las herramientas de IA de imagen y foto de nuestro directorio, y casi ninguno expone los mecanismos de agrupación que necesitas aquí. Esa parte sigue siendo tu código.
La hoja de especificaciones de traspaso: qué exigir en cada salto
Escribe el contrato antes de escribir el código. Cada salto en una cadena tiene tres cosas que necesitas tener definidas: el formato de salida exacto que estás pidiendo, el nivel de plan o parámetro que lo desbloquea, y cuánto tiempo vive el artefacto antes de desaparecer. Equivócate en eso y el fallo aparece dos saltos después como una queja de calidad que nadie puede rastrear.
Audio: el nivel que habilita la salida de calidad para difusión
ElevenLabs pone pcm_44100, pcm_48000, wav_44100 y wav_48000 detrás de una suscripción Pro, y mp3_44100_192 detrás de Creator (Referencia de la API de ElevenLabs). Así que con un plan gratuito o básico, tu editor de vídeo recibe un MP3 con pérdidas a 128 kbps o menos sin importar lo bueno que sea el modelo de voz. Ese es un techo de calidad fijado por la facturación, no por la inferencia.
Si tu entregable es un podcast que necesita alcanzar -16 LKFS con pico verdadero igual o inferior a -1 dBFS (Apple Podcasts), quieres audio sin pérdidas al principio y una sola codificación al final. Normalizar un MP3 de 128 kbps y volver a codificarlo acumula dos generaciones con pérdidas. Presupuesta el nivel Pro como un coste de producción, no como una mejora.
Vídeo: URLs con expiración y archivos adjuntos
Sora no te entrega un solo archivo. Un renderizado completado te da un MP4, una miniatura WebP y una hoja de sprites JPG, y las URLs de descarga son válidas como máximo una hora (Guía de vídeo de OpenAI). Tu tarea en ese salto es copiarlo a tu propio almacén de objetos, activado por el evento de finalización, no por un proceso nocturno. Si pierdes la ventana, el renderizado es irrecuperable.
Texto y tiempo: los campos que requieren los pasos posteriores
Los pasos posteriores requieren campos específicos de forma estricta, y los que necesitan tiempo son los que fallan silenciosamente. La salida SRT y VTT más timestamp_granularities[] solo funcionan con whisper-1, no con los modelos de transcripción más recientes (OpenAI voz a texto). Cualquier elemento que corte clips o incruste subtítulos necesita marcas de tiempo a nivel de palabra en el contrato.
| Salto | Exige esta salida | Qué lo desbloquea | Expiración |
|---|---|---|---|
| Texto a voz | wav_48000 o pcm_44100 | Nivel Pro; Creator para mp3_44100_192 | Sin expiración, almacenar al escribir |
| Voz a texto | Marcas de tiempo a nivel de palabra, etiquetas de locutor | whisper-1 para SRT/VTT; chunking_strategy: auto para más de 30 s para diarización | Sin expiración |
| Imagen a vídeo | MP4 más miniatura y hoja de sprites | Imagen de referencia que coincida exactamente con la resolución del vídeo | 1 hora en las URLs de descarga |
| Vídeo a texto | Fotogramas muestreados a una frecuencia fija | El nivel estándar vs. alta resolución cambia el coste en tokens visuales ~3x | Sin expiración |
Cualquiera que sea el orquestador que elijas entre los 128 frameworks de IA en nuestro directorio, ponlo a prueba primero con los saltos binarios. Pasar JSON entre modelos es la parte fácil.
Plataforma de automatización o código manual
La regla es sencilla: deja que la plataforma decida qué ocurre y cuándo, y deja que tu propio código mueva los bytes. Todo lo que toque un archivo grande o compita con una ventana de expiración pertenece a un script con almacenamiento de objetos detrás.
Dónde gana una plataforma
Disparadores, reintentos en pasos económicos, puertas de aprobación y la ramificación al final. Zapier ofrece más de 9.000 integraciones de aplicaciones conectadas en Zaps, Tables, Forms y Zapier MCP, y ese catálogo es la razón real para usarlo. Llevar las notas finales del programa a tu CMS y los enlaces de clips a un calendario de contenidos es trabajo de conector, y escribir esos conectores tú mismo no te aporta nada.
El ciclo de aprobación humana también encaja aquí. Un Zap que publica cuatro variantes de anuncio en Slack, espera una aprobación y luego lanza el paso de publicación requiere veinte minutos de configuración y es lo único que se interpone entre una afirmación de producto alucinada y tu presupuesto de publicidad de pago.
Donde los medios binarios lo superan
Los nodos sin código pasan JSON bien y archivos mal. Un WAV de 58 minutos tiene que dividirse en fragmentos de 25 MB o menos antes de que el endpoint de transcripción de OpenAI lo acepte (OpenAI). Un renderizado de Sora de dos minutos son hasta seis llamadas de extensión encadenadas de 20 segundos cada una (OpenAI), y la URL de descarga es válida como máximo una hora después de la generación (OpenAI). La lógica de reintentos entre seis llamadas con una cuenta atrás corriendo sobre el artefacto es un programa, no un lienzo.
Dos plataformas sí gestionan medios. n8n mantiene los archivos como datos binarios entre nodos en lugar de forzar conversiones de ida y vuelta en base64, y su nodo de código está justo al lado de los nodos de agente (n8n). Descript expone transcripción, clips y subtítulos a través de una API en lugar de una interfaz gráfica (Descript).
El camino intermedio: plataforma para el flujo de control, código para los bytes
Cada salto escribe en tu propio bucket y devuelve una clave. La plataforma pasa claves y códigos de estado, nunca el archivo. Organizar el trabajo de esa manera también reduce el cómputo: el sistema OnePiece reporta una disminución de 16x en el consumo de GPU para Wan2.1 imagen-a-vídeo una vez que un pipeline monolítico se descompone en servicios por etapas (arXiv).
Si estás eligiendo componentes, nuestro directorio rastrea 550 agentes de IA y herramientas de orquestación junto con 301 repositorios de IA de código abierto. Los repositorios son donde suele vivir el código que mueve bytes, porque ningún proveedor vende esa parte.
Especificaciones de entrega: adaptarse a donde publica la plataforma
Tu último salto no es el renderizado. Es la subida, y la subida también tiene una hoja de especificaciones.
Vídeo: objetivos de bitrate y audio para la subida
YouTube publica los bitrates de entrega recomendados por resolución: 8 Mbps para 1080p SDR, 16 Mbps a 1440p y 35-45 Mbps a 4K, con audio entregado como AAC-LC, Opus o Eclipsa a 48 kHz y 384 kbps estéreo (Ayuda de YouTube). Si tu salto de vídeo te entrega un archivo muy por debajo de esos números, no aumentes el bitrate al exportar. Gastarás tiempo de codificación rellenando artefactos de compresión. Lo que sí debes hacer es que el paso de codificación lea la resolución fuente y elija el objetivo correspondiente, para que un renderizado de Sora a 1080p no se vea forzado a una escalera de 4K porque alguien lo programó en un archivo de configuración hace seis meses.
El objetivo de audio importa más que el de vídeo para contenido narrado. Una pista AAC de 48 kHz y 384 kbps procedente de una fuente a 44,1 kHz implica un remuestreo en algún punto, y quieres que ese remuestreo ocurra una sola vez, en tu propia llamada a ffmpeg, donde puedas verlo.
Audio: acondicionamiento de volumen antes de la codificación
Apple Podcasts pide -16 dB LKFS ±1 dB con pico verdadero igual o inferior a -1 dB FS, medido según ITU-R BS.1770-5, y es explícito en que el audio debe estar acondicionado a ese objetivo antes de la codificación (Apple Podcasts para creadores). Es el orden de operaciones, no una preferencia. Normalizar un MP3 terminado significa que estás aplicando ganancia a través de artefactos con pérdidas que se introdujeron a un nivel diferente, y el pico verdadero en un MP3 decodificado ya puede superar lo que vio el codificador. Aplica el paso de volumen al WAV, luego codifica.
Por eso el nivel de formato TTS del principio de la cadena sigue siendo importante. Entregarle a tu normalizador un MP3 de 128 kbps es un peor punto de partida que entregarle PCM, y ningún cuidado posterior lo arregla.
Procedencia y etiquetado de activos generados
Decide sobre la procedencia mientras diseñas el pipeline, no después de que una plataforma lo exija. SynthID de Google marca con marca de agua los medios generados en el momento de la creación, lo que significa que viaja con el activo solo si tu pipeline no lo elimina ni lo recodifica. Cada paso de ffmpeg entre la generación y la subida es una oportunidad de perder esa señal, así que registra qué salto introdujo el archivo y mantén un registro del modelo, el prompt y la marca de tiempo en tu propio almacén de metadatos, en lugar de confiar en que el contenedor lo conserve.
Construye para el cambio: el precipicio de la depreciación bajo cada salto de vídeo
Si tu salto de vídeo llama a Sora, tienes 19 días. OpenAI anunció el 24 de marzo de 2026 que la Videos API y ambos modelos sora-2 y sora-2-pro se cierran el 24 de septiembre de 2026, incluidas las instantáneas sora-2-2025-10-06, sora-2-2025-12-08 y sora-2-pro-2025-10-06, sin ningún modelo de reemplazo recomendado listado (Depreciaciones de OpenAI). Una columna de reemplazo vacía significa que eliges tú mismo el sucesor, y lo eliges antes del límite, no después.
Abstraer el salto para que un cambio sea un cambio de configuración
La solución es un adaptador delgado por salto generativo. Tu pipeline le entrega al adaptador un trabajo normalizado: prompt, ruta de la imagen de referencia, resolución objetivo, duración en segundos, clave del bucket de salida. El adaptador posee todo lo que tiene la forma del proveedor. La regla de Sora de que la imagen de referencia debe coincidir exactamente con la resolución del vídeo, sus clips de 16 y 20 segundos extendidos en pasos de 20 segundos hasta un máximo de 120 segundos, su expiración de descarga de 1 hora (OpenAI generación de vídeo). Nada de eso se filtra a tu código de orquestación.
Así, cambiar de proveedor es un valor de configuración, no una reescritura. Valida un segundo adaptador contra los docs de modelos de Runway ahora, ejecuta ambos con los mismos diez prompts y mantén al perdedor en espera.
Las familias de imagen y audio tienen sus propias fechas, así que trata esto como mantenimiento recurrente en lugar de una carrera puntual. Nuestro directorio existe en parte para que puedas rastrear lanzamientos y cierres de modelos entre los 324 modelos listados.
Una lista de verificación de migración para pipelines en producción hoy
- Busca en cada repositorio y JSON de flujo de trabajo las cadenas
sora-2,sora-2-proy la ruta base de la Videos API. Incluye los cron jobs y los scripts puntuales, que es donde viven las llamadas olvidadas. - Envuelve cada resultado en un adaptador con tu propio esquema de trabajo antes de cambiar de proveedor, para que el cambio y la refactorización no sean el mismo commit.
- Ejecuta el proveedor alternativo con diez prompts reales y compara los resultados en resolución, duración de clips y calidad de movimiento.
- Pon un recordatorio en el calendario dos semanas antes de cada fecha de cierre publicada, por proveedor y por familia de modelos.
- Registra el ID del modelo y la instantánea en cada renderizado para poder responder «qué generó este activo» después de que el modelo haya desaparecido.
Preguntas frecuentes
¿Qué es un flujo de trabajo de IA multimodal, en términos prácticos?
Es una cadena de llamadas a la API donde el archivo de salida de un modelo se convierte en el archivo de entrada del siguiente, y cada salto tiene un contrato de formato que debes satisfacer. Una cadena típica va de transcripción a guión, de guión a imagen fija, de imagen fija a vídeo, de vídeo a locución y de locución al renderizado final, y cada flecha es un punto donde una resolución o codec incorrectos interrumpen la ejecución. El salto imagen-a-vídeo de Sora es un buen ejemplo de lo literales que se vuelven esos contratos: la imagen de referencia debe coincidir exactamente con la resolución del vídeo objetivo y ser image/jpeg, image/png o image/webp, por lo que el paso de imagen anterior necesita las dimensiones en píxeles del paso de vídeo, no solo una relación de aspecto (Documentación de generación de vídeo de OpenAI). Piensa en el pipeline como un conjunto de traspasos, no de herramientas.
¿Cómo encadeno herramientas de IA sin perder calidad entre los pasos?
Fija la especificación de salida en cada salto según lo que necesite el último paso de la cadena, luego trabaja hacia atrás. La pérdida de calidad suele venir de un nivel de precio o un parámetro predeterminado, no del modelo: ElevenLabs pone pcm_44100, pcm_48000, wav_44100 y wav_48000 detrás de una suscripción Pro y mp3_44100_192 detrás del nivel Creator, de modo que una cuenta de nivel básico le entrega a tu editor un MP3 con pérdidas tanto si lo querías como si no (Referencia de creación de voz de ElevenLabs). Copia cada artefacto generado a tu propio almacén de objetos de inmediato, porque las URLs de descarga de Sora son válidas como máximo una hora después de la generación (Documentación de generación de vídeo de OpenAI). La frecuencia de muestreo también es una palanca de coste, no solo de calidad: Claude factura un fotograma de 4K a 4.784 tokens visuales en el nivel de alta resolución frente a 1.560 en el estándar, aproximadamente $23,92 por cada mil fotogramas de 4K a la tarifa de entrada de $5/M de Opus 5 (Documentación de visión de Claude).
¿Qué formato de audio debo pasar de un paso de texto a voz a un editor de vídeo?
WAV sin comprimir a 48 kHz o PCM, lo que en ElevenLabs significa wav_48000 o pcm_48000 con una suscripción Pro o superior (Referencia de creación de voz de ElevenLabs). Entregar a un editor un MP3 de 128 kbps introduce artefactos de compresión que sobreviven a cada codificación posterior. Si el destino es YouTube, el objetivo de entrega final es AAC-LC, Opus o Eclipsa a 48 kHz y 384 kbps estéreo (Configuración de codificación para subidas de YouTube), y si es un feed de podcast, Apple pide que el audio esté acondicionado a -16 dB LKFS ±1 dB con pico verdadero igual o inferior a -1 dB FS, medido según ITU-R BS.1770-5, antes de codificar (Requisitos de audio de Apple Podcasts). No puedes alcanzar ninguno de los dos objetivos de forma fiable a partir de un intermedio con pérdidas.
¿Por qué falla la transcripción de mi podcast en episodios completos?
El endpoint de transcripción de OpenAI limita las subidas a 25 MB y acepta mp3, mp4, mpeg, mpga, m4a, wav y webm, por lo que cualquier archivo de más de aproximadamente media hora a un bitrate decente debe dividirse en fragmentos de 25 MB o menos (Documentación de voz a texto de OpenAI). Por eso los pipelines de larga duración suelen enrutar la transcripción fuera del proveedor de LLM: AssemblyAI acepta hasta 5 GB por solicitud en /v2/transcript (2,2 GB para subidas locales) y archivos de 160 ms a 10 horas, unas 200 veces el límite de OpenAI (Documentación de audio pregrabado de AssemblyAI). Hay otros dos modos de fallo que parecen éxitos: la diarización de locutores devuelve silenciosamente texto sin etiquetar a menos que establezcas chunking_strategy en 'auto' para audio de más de 30 segundos, y la salida SRT/VTT más timestamp_granularities[] solo funcionan con whisper-1, no con gpt-transcribe ni gpt-4o-transcribe (Documentación de voz a texto de OpenAI). Si necesitas marcas de tiempo a nivel de palabra para corte automático de clips, ElevenLabs Scribe v2 las proporciona en más de 90 idiomas junto con diarización (Modelos de ElevenLabs).
¿Debería construir un pipeline de contenido de IA en n8n o Zapier, o escribir el código yo mismo?
Escribe código para cualquier salto que mueva medios binarios, y usa una plataforma de automatización para los disparadores, aprobaciones y notificaciones a su alrededor. El punto fuerte de Zapier es la amplitud, con más de 9.000 integraciones de aplicaciones declaradas por el proveedor más Zaps, Tables, Forms y Zapier MCP (Plataforma para desarrolladores de Zapier), que es exactamente lo que quieres para «nueva fila en Airtable, lanza el renderizado, publica el enlace en Slack». Es la capa equivocada para un MP4 de 200 MB con una URL que expira en una hora. n8n se sitúa en el medio, ya que sus nodos de agente y el manejo de paso de archivos binarios te permiten mantener los archivos dentro del flujo de trabajo (Documentación de Tools Agent de n8n), y hay un argumento de infraestructura real para dividir la cadena en etapas en lugar de un monolito: el artículo de OnePiece reporta una disminución de 16x en el consumo de GPU al descomponer un pipeline AIGC en microservicios por etapas para Wan2.1 imagen-a-vídeo (arXiv).
¿Qué reemplaza a Sora en un pipeline de vídeo después del cierre de septiembre de 2026?
OpenAI anunció el 24 de marzo de 2026 que la Videos API y los modelos sora-2 y sora-2-pro (instantáneas sora-2-2025-10-06, sora-2-2025-12-08 y sora-2-pro-2025-10-06) se cierran el 24 de septiembre de 2026, y no lista ningún modelo de reemplazo recomendado (Depreciaciones de OpenAI). A partir del 5 de septiembre de 2026 quedan 19 días, por lo que la medida práctica es poner hoy tu salto de vídeo detrás de una interfaz delgada y apuntarla a otro proveedor, con la API de Runway como el reemplazo más directo a evaluar (Documentación de modelos de Runway). Presupuesta también una reescritura de tu lógica de fragmentación, ya que los límites de Sora han dado forma a muchos pipelines: clips de 16 y 20 segundos, hasta 20 segundos añadidos por extensión y un máximo de 120 segundos en hasta seis extensiones, lo que convirtió un segmento narrado de dos minutos en seis llamadas encadenadas (Documentación de generación de vídeo de OpenAI). Si estás buscando alternativas, nuestro directorio rastrea actualmente 452 herramientas bajo Generadores de Vídeo con IA.