

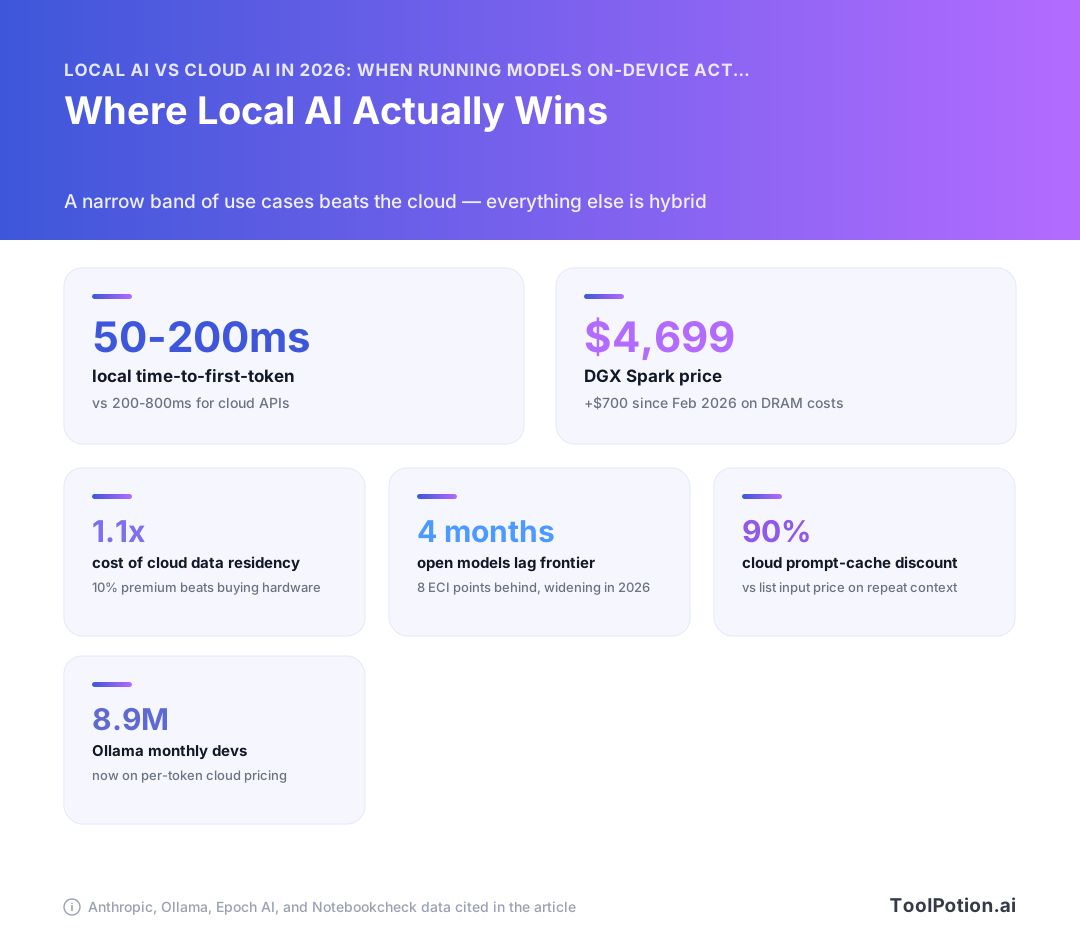
Compra la GPU solo si la vas a mantener ocupada. Esa es la respuesta corta sobre IA local vs IA en la nube en 2026: por encima de aproximadamente el 26 % de uso diario sostenido, un equipo local supera el pago por token. Por debajo de eso, estás financiando silicio inactivo a los precios de memoria de 2026, y esos precios son feos: NVIDIA subió el DGX Spark de $3,999 a $4,699 en febrero de 2026, alegando costos de DRAM y almacenamiento (Notebookcheck).
Mientras tanto, el lado cloud se abarató de maneras que la mayoría de las comparaciones omiten. Las lecturas de caché de prompts cuestan 0,1x el precio de entrada, y el descuento del 50 % de Batch se acumula encima, llevando a Claude Haiku 4.5 a $0,50 entrada / $2,50 salida por millón de tokens (Anthropic).
Aquí está cómo quedan esos números, qué corre en 24 GB y dónde cae la línea en tu caso.
IA local vs IA en la nube: el manual de 2026 falló en cuatro puntos
Las matemáticas de punto de equilibrio que has leído están equivocadas, y no por un error de redondeo. Están equivocadas porque el hardware se encareció, la estadística de capacidad se malinterpretó, las herramientas cambiaron de bando y la tarifa cloud bajó silenciosamente por debajo de la hoja de cálculo de todo el mundo.
Los tres supuestos que toda comparación sigue haciendo
Casi todas las guías de local vs nube en la primera página de resultados se basan en las mismas tres afirmaciones, todas del año 2024. Primera: el hardware es un costo fijo y decreciente, por lo que amortizas una GPU de $1,999 en 18 meses y lo comparas con el gasto por token. Segunda: los modelos de pesos abiertos van tres a seis meses por detrás de los modelos de frontera cerrada, así que lo que ejecutas en casa tiene un retraso de un par de trimestres. Tercera: «local» significa Ollama en tu máquina y «nube» significa una API de frontera, una pelea limpia de dos bandos.
Las tres eran razonables en 2024. Ninguna sobrevive al contacto con 2026.
Qué cambió entre 2024 y ahora
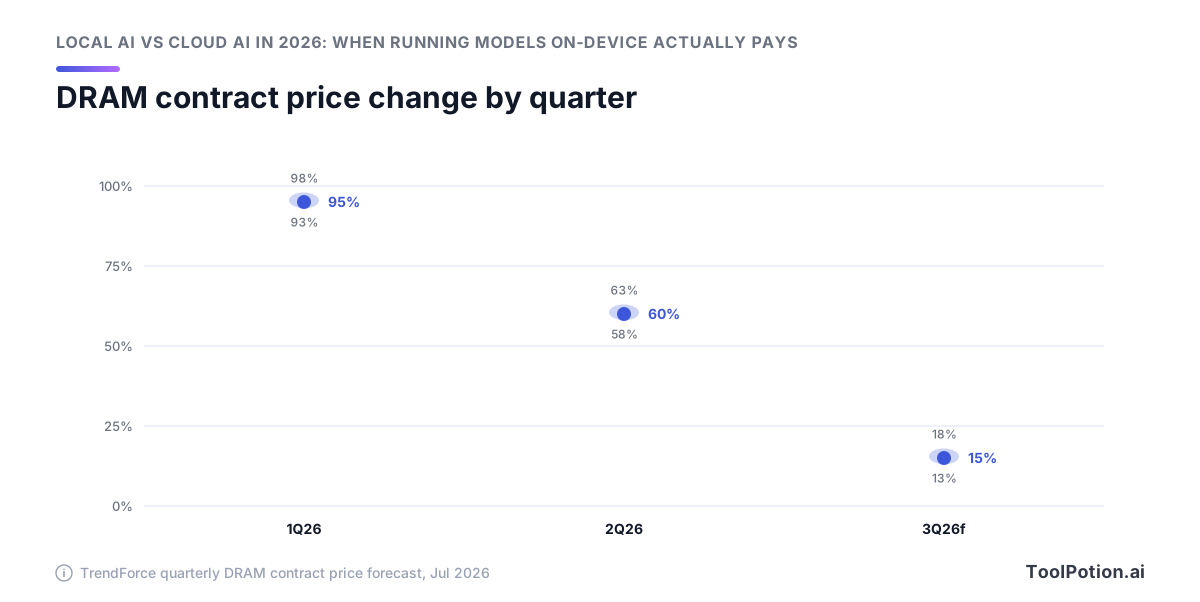
Empieza por el suelo del hardware, porque se movió en la dirección equivocada. NVIDIA subió el DGX Spark de $3,999 a $4,699 en febrero de 2026, una subida de $700 que atribuyó a costos desorbitados de DRAM y almacenamiento. Los precios de contrato de DRAM convencional subieron aproximadamente un 93–98 % trimestre a trimestre en 1T26 y siguen subiendo un 13–18 % en 3T26. Cualquier calculadora que cite el MSRP está subestimando tu CapEx en cuatro cifras.
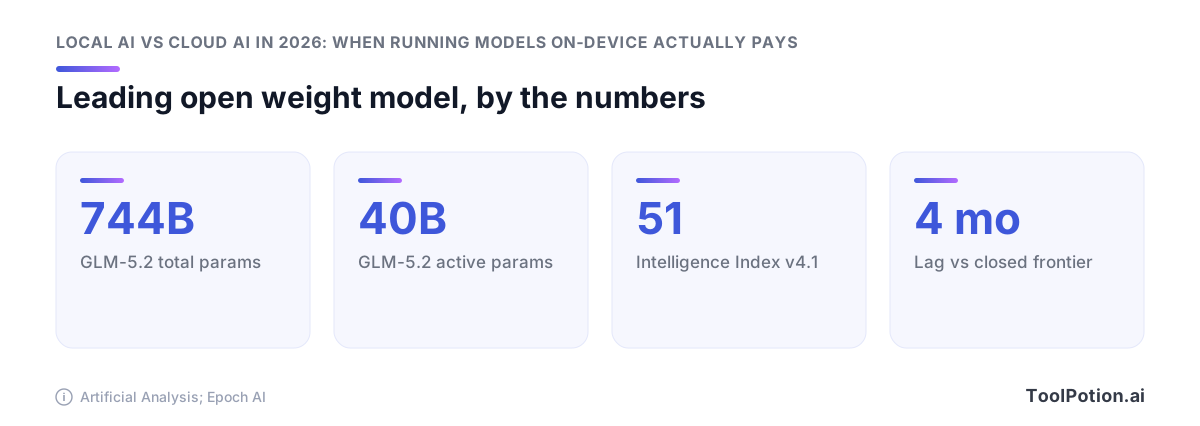
Luego, la brecha de capacidad. Epoch AI sitúa el retraso en 4 meses, u 8 puntos ECI desde enero de 2026, más amplia que el promedio de 3 meses que midió desde enero de 2023 hasta octubre de 2025. Lo que nadie cita: el modelo que sostiene esa afirmación, GLM-5.2, tiene 744B parámetros totales y 40B activos. Eso es un rack, no un portátil.
La tercera ruptura es la más extraña. El 31 de agosto de 2026, Ollama pasó Pro, Max y Team a precios cloud por token a $20, $100 y $500 al mes. La herramienta predeterminada para «ejecutar modelos localmente» ahora te vende tokens, lo que convierte la comparación en una carrera de tres vías entre tu GPU, pesos abiertos alojados baratos y APIs de frontera. Si estás evaluando opciones entre los modelos de IA que seguimos, ese carril intermedio es el primero que hay que cotizar.
Y el lado cloud se abarató de maneras que ninguna calculadora publicada modela: lecturas de caché de prompts a 0,1x el precio base de entrada, un descuento del 50 % de la Batch API que se acumula encima, y anclaje de inferencia solo en EE. UU. con un multiplicador de 1,1x. Esta última opción te vende la propiedad de residencia de datos por la que la gente compra hardware, con una prima del 10 % en lugar de $4,699.
Lo que los modelos locales realmente manejan en 2026
Una tarjeta de 24 GB en 2026 ejecuta un buen modelo de mezcla de expertos de 20–30B, y ese modelo redactará, resumirá, clasificará y razonará sobre problemas estructurados con una calidad que la mayoría de los equipos consideran aceptable. También inventará hechos con confianza sobre cualquier cosa fuera de sus datos de entrenamiento. Esas dos oraciones son el mapa de capacidad, y la mayoría de las guías de punto de equilibrio se saltan la segunda.
El techo del hardware de consumo es la clase MoE de 20–30B
gpt-oss-20b y Qwen3-30B-A3B son el techo práctico para una sola GPU de consumo. Ambos son diseños MoE dispersos, por lo que el número de parámetros activos se mantiene lo suficientemente pequeño como para que una tarjeta de 24 GB contenga los pesos y aún le quede espacio para el contexto. Por debajo de ellos están los modelos densos de clase Llama, Mistral y Phi en 7–14B, que caben con más comodidad y ceden capacidad a cambio. Nuestros listados de LLM de pesos abiertos se inclinan fuertemente hacia esta banda, porque es lo que la gente puede ejecutar en casa.
Fuertes en razonamiento, débiles en conocimiento del mundo
Dale a un modelo local de 30B un documento y pídele que extraiga campos, siga un esquema o recorra una cadena de pasos, y aguanta bien. Pregúntale quién adquirió a quién en 2024 y obtendrás ficción plausible.
El número de parámetros es lo que compra hechos memorizados, y un modelo de tamaño consumidor ha descartado la mayoría de esos parámetros. La recuperación cierra la brecha: pon los hechos en contexto y deja que el modelo local haga la parte estructurada. Todo lo que necesite un recuerdo amplio sin una capa de recuperación detrás pertenece a una API de frontera.
Por qué el titular de «los modelos abiertos están alcanzando» habla de hardware que no tienes
Epoch AI sitúa la brecha en 4 meses, u 8 puntos ECI, desde enero de 2026, ligeramente más amplia que el promedio de 3 meses que midió de enero de 2023 a octubre de 2025 (Epoch AI). El número es sólido y no dice nada sobre tu portátil. El modelo que lleva la corona de pesos abiertos, GLM-5.2, obtiene 51 en el Índice de Inteligencia v4.1 de Artificial Analysis con 744B parámetros totales y 40B activos (Artificial Analysis). Eso es hardware de centro de datos. La misma medición muestra que GLM-5.2 quema 43,000 tokens de salida por tarea, 37,000 de ellos tokens de razonamiento, lo que equivale a aproximadamente $0,46 por tarea frente a $0,18 para MiniMax-M3.
Qué te cuesta la cuantización
Q4_K_M es el valor predeterminado por una razón. En Mistral-7B-Instruct-v0.2 con llama.cpp en un Apple M1 Pro, redujo el modelo de 7,2 GB a 4,1 GB, un 43,1 % más pequeño, con una pérdida de perplejidad del 0,51 % (dasroot). Q2_K es donde la curva se rompe, con un 7,94 % de pérdida de perplejidad, y eso se nota en el seguimiento de instrucciones mucho antes de verlo en un benchmark. Cuantiza a 4 bits, para ahí, y gasta la memoria ahorrada en longitud de contexto.
El suelo del hardware subió, y subió en la dirección equivocada
Todas las calculadoras de punto de equilibrio que encontrarás asumen que puedes comprar el equipo al precio de lista. En 2026, en la mayoría de los casos no puedes, y el precio de lista en sí mismo subió.
La crisis de memoria, en precios que puedes verificar
Los precios de contrato de DRAM convencional subieron aproximadamente un 93–98 % trimestre a trimestre en 1T26, otro 58–63 % en 2T26, y TrendForce prevé un 13–18 % adicional en 3T26 (TrendForce). Eso es desaceleración, no alivio. Los precios siguen subiendo desde una base que ya se duplicó. La demanda no viene de ti: los centros de datos están absorbiendo hasta el 70 % de la producción mundial de memoria en 2026 frente al 20–30 % aproximado de 2022, y solo el HBM se llevó el 23 % de las obleas de DRAM este año frente al 8 % en 2024 (IDC). La inferencia local es una compra de capacidad de memoria que compite con los que construyen las nubes que intentas evitar.
DGX Spark, RTX 5090 y la brecha entre el MSRP y el precio de calle
NVIDIA subió el DGX Spark de $3,999 a $4,699 en febrero de 2026, una subida de $700 que la empresa atribuyó a los desorbitados costos de DRAM y almacenamiento (Notebookcheck). Sus 128 GB de LPDDR5X son la razón completa por la que resulta interesante para modelos locales, y también la razón por la que su precio sigue un mercado de materias primas que no controlas.
Trata cualquier MSRP de 2025 que veas citado en una publicación comparativa como ficción. Comprueba a qué precio se vende la pieza esta semana y luego haz tus cálculos con ese número.
La electricidad es la partida que todo el mundo olvida
Una GPU es una compra única que te manda una factura cada mes. La electricidad residencial media en EE. UU. fue de 18,34 ¢/kWh en junio de 2026, un 5,0 % más interanual, con estados que van desde 8,96 ¢ en Nuevo México hasta 28,50 ¢ en California (EIA). El mismo equipo tiene un costo operativo que varía más de 3x según dónde esté enchufado. Si estás en California, solo la electricidad puede rivalizar con lo que costarían los tokens equivalentes alojados. En Nuevo México el cálculo es lo suficientemente diferente como para cambiar la respuesta.
Cuánto cuesta un equipo defendible para 2026
Presupuesta el equipo al precio de calle actual, añade el consumo eléctrico a tu tarifa real de suministro, y suma las horas que dedicarás a frameworks de inferencia local y ajuste de cuantización que un endpoint alojado no te pide. Una cifra de CapEx de cuatro dígitos con un OpEx anual de tres dígitos es el punto de partida honesto, y ambas mitades empeoraron este año por razones que no tienen nada que ver con la calidad de los modelos.
Ollama vs API cloud: la comparación ahora es de tres vías
Ahora importan tres precios: la GPU que compras, los pesos abiertos alojados y una API de frontera. La opción intermedia gana para la mayoría de las cargas de trabajo, y es la que casi ninguna fórmula publicada de punto de equilibrio incluye.
El propio Ollama se convirtió en una API cloud el 31 de agosto de 2026
La herramienta que enseñó a toda una generación de desarrolladores a ejecutar modelos en su propia máquina ahora vende tokens. El 31 de agosto de 2026, Ollama pasó Pro, Max y Team a precios cloud por token: $20/mes con $60 de uso incluido, $100/mes con $300 y $500/mes con $1,000 compartidos entre usuarios ilimitados, sin retención de datos y con alojamiento en EE. UU. y Europa (Ollama). Por tanto, «Ollama vs la nube» ya no describe una elección real.
Pesos abiertos alojados: la opción intermedia que nadie modela
| Modelo | Entrada / salida por MTok | Fuente |
|---|---|---|
| nemotron-3-super (Ollama Cloud) | $0,015 / $0,60 | Ollama |
| deepseek-v4-flash (Ollama Cloud) | $0,22 / $0,66 | Ollama |
| qwen3.5:397b (Ollama Cloud) | $0,60 / $3,60 | Ollama |
| Claude Haiku 4.5 | $1,00 / $5,00 | Anthropic |
| Claude Sonnet 5 | $2,00 / $10,00 | Anthropic |
Lee la letra pequeña antes de construir una previsión con esos números. La mayoría de las tarifas de Ollama Cloud se duplican entre las 12:00 y las 18:00 UTC en días laborables (Ollama), lo que convierte tu factura en una cuestión de planificación. Envía los trabajos en bloque a noches y fines de semana y mantendrás la tarifa anunciada. Ejecuta un producto interactivo para usuarios europeos por la tarde y pagarás la tarifa doble cada día laborable. Esa variable de horario merece más atención que la elección entre dos proveedores de alojamiento con precios similares.
Las APIs de frontera son más baratas de lo que sugiere su precio de lista
Las lecturas de caché se facturan al 0,1x el precio base de entrada, la Batch API aplica un 50 % de descuento tanto en entrada como en salida, y los dos descuentos se acumulan (Anthropic). Haiku 4.5 en batch llega a $0,50 entrada y $2,50 salida por millón de tokens, y Sonnet 5 mantuvo su precio introductorio de $2/$10 en lugar de moverse al previsto $3/$15 el 1 de septiembre de 2026 (Anthropic). El trabajo en bloque asíncrono es exactamente para lo que se promocionan los equipos locales, y es la carga de trabajo donde más muerden los descuentos cloud.
La nota al pie del tokenizador que va en sentido contrario
Claude 4.7 y posteriores usan un tokenizador más nuevo que produce aproximadamente un 30 % más de tokens para el mismo texto (Anthropic). Tu factura real de Sonnet 5 sobre un corpus fijo es aproximadamente un 30 % superior a lo que implica la tarifa de $2/$10 cuando la comparas con un modelo local con un tokenizador más antiguo. Cuenta los tokens en tu propio texto con ambos antes de comprometerte.
Calculando el cruce: ¿a qué volumen gana tu GPU?
El hardware propio empieza a superar a los pesos abiertos alojados en torno al 26 % de utilización diaria sostenida de la GPU, aproximadamente seis horas al día de trabajo real cada día, amortizado contra los precios de hardware de 2026 y tu tarifa eléctrica local. Por debajo de esa línea la tarjeta está inactiva mientras corre el reloj de la depreciación. Cotiza tu propio volumen frente a la tarifa alojada antes de comprar: deepseek-v4-flash corre a $0,22 entrada y $0,66 salida por millón de tokens en Ollama Cloud (Ollama).
Dónde gana lo local (una lista corta y concreta)
Cuatro casos resisten el escrutinio. Todo lo demás es una configuración híbrida donde enrutas las consultas sencillas a un modelo local y escala el resto.
Trabajo en bloque de alto volumen sostenido que mantiene la tarjeta ocupada
Si tu GPU está inactiva el 90 % del día, compraste un calefactor. El caso de compra necesita que la tarjeta trabaje más de una cuarta parte del día, todos los días, y debe superar la comparación con la Batch API de Claude, que recorta los tokens de entrada y salida un 50 % y se acumula con el caché de prompts (Anthropic). Eso pone el trabajo en batch de Haiku 4.5 a $0,50 por millón de tokens de entrada y $2,50 de salida. Tu equipo local tiene que superar eso en hardware amortizado más electricidad, y con una media residencial en EE. UU. de 18,34 ¢/kWh en junio de 2026 (EIA), una tarjeta con carga real tampoco es gratis. Haz los cálculos con tu volumen real de tokens antes de hacerlos con una hoja de especificaciones.
Soberanía de datos estricta, CLOUD Act y no solo GDPR
Existe una categoría real aquí, y es más estrecha de lo que la mayoría afirma. El cumplimiento del GDPR es un problema contractual. El requisito de que ninguna entidad de jurisdicción estadounidense pueda ser obligada a producir tus datos es un problema físico, y los problemas físicos se resuelven con hardware que controlas.
Bucles interactivos donde el tiempo hasta el primer token es el producto
La inferencia local ofrece 50–200 ms de tiempo hasta el primer token frente a 200–800 ms de la nube, con Claude Haiku 4.5 medido en 597 ms y GPT-4.1 Mini en torno a 2.400 ms (Eden AI). Para una ventana de chat, nadie lo nota. Para el autocompletado de código en línea, o un agente multi-paso encadenando ocho llamadas, esa diferencia se acumula en algo que los usuarios sienten. Si estás construyendo en esa forma, explora los agentes de IA en nuestro directorio y comprueba cuántos de ellos hacen un viaje de ida y vuelta por cada pulsación de tecla.
Operación sin conexión y en red aislada
No hay argumento que hacer. O hay red o no la hay.
El argumento de privacidad que la nube ahora te vende de vuelta
El contraargumento más fuerte al segundo caso es que Anthropic te vende la propiedad directamente. En Claude 4.6 y posteriores, anclar la inferencia solo a EE. UU. con inference_geo: "us" cuesta un multiplicador de 1,1x en todas las categorías de tokens (Anthropic). Es una prima del 10 % en lugar de $4,699 de DGX Spark. Los planes de pago de Ollama, por su parte, anuncian cero retención de datos alojados en EE. UU. y Europa a partir del 31 de agosto de 2026 (Ollama). Si tu requisito de privacidad se satisface con una garantía contractual y un anclaje geográfico, no tienes un requisito de hardware.
La configuración híbrida en la que aterriza la mayoría de los profesionales
Enruta por dificultad, no por principio. Un modelo MoE de 20–30B en tu propia tarjeta maneja aproximadamente siete de cada diez consultas en una carga de trabajo típica de asistente o procesamiento de documentos, y las tres restantes van a una API de frontera. Esa división es la arquitectura. Todo lo demás es ajuste.
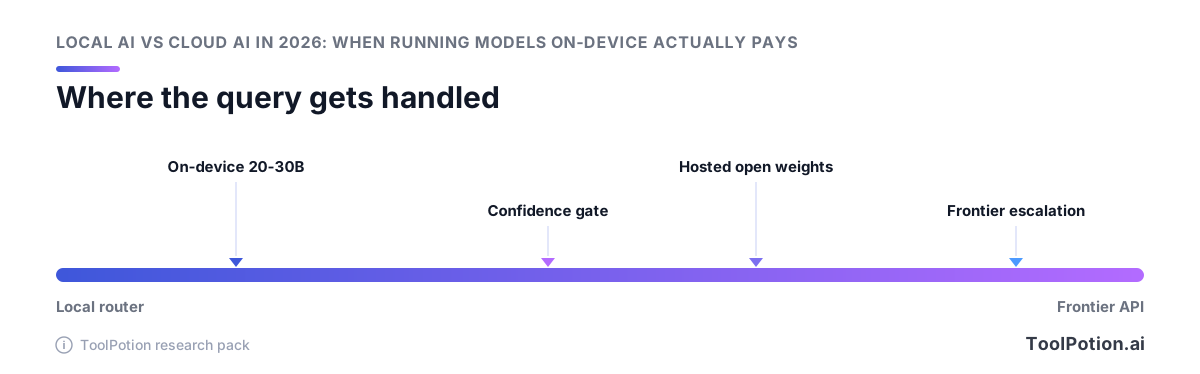
Tres señales deciden la escalada, y puedes calcularlas todas antes de que el modelo local termine: la propia confianza del modelo (margen log-prob o una autocomprobación barata), si la consulta necesita conocimiento del mundo que los pesos locales no tienen, y la longitud del contexto. La de conocimiento captura la mayoría de tus fallos. Un modelo de clase 24 GB razona bien y recuerda mal, así que cualquier cosa que parezca «quién adquirió a quién en 2025» debería saltarse lo local por completo.
Una pila concreta que funciona
Ollama o LM Studio por delante, una API de frontera por detrás, y un enrutador ligero en medio que registra cada decisión.
Envía el tráfico escalado a Claude Haiku 4.5 a $1/MTok entrada y $5/MTok salida primero, y solo recurre a Sonnet 5 a $2/$10 cuando la respuesta de Haiku no supera tu verificación (precios de Anthropic). Si el trabajo escalado es asíncrono, ponlo en batch: la Batch API reduce ambos lados a la mitad, así que Haiku llega a $0,50/$2,50. La mayoría de los equipos se saltan esto y pagan precio de lista por trabajo que podría haber esperado veinte minutos.
Instrumenta la tasa de escalada o navegarás a ciegas
Registra cuatro números por solicitud: qué nivel la sirvió, la confianza del modelo local, el recuento de tokens y si un humano reintentó la respuesta. La tasa de reintentos es tu señal de calidad real. Si la escalada está por debajo del 20 % aproximadamente, tu modelo local está respondiendo cosas que no debería y lo verás en los reintentos. Por encima del 45 % y la GPU no está ganando su depreciación.
Por qué el límite se mueve cada trimestre
Los precios de ambos lados se mueven más rápido que tu arquitectura. Ollama reprecio Pro, Max y Team a facturación cloud por token el 31 de agosto de 2026 (Ollama), las tarifas de Ollama Cloud se duplican entre las 12:00 y las 18:00 UTC en días laborables (precios de Ollama), y la capacidad de los pesos abiertos va por detrás de los modelos de frontera cerrada unos 4 meses de media desde enero de 2026 (Epoch AI). Vuelve a calcular tus umbrales de enrutamiento con números en tiempo real una vez por trimestre. Ponlo en el calendario.
La capa de herramientas es suficientemente estable para construir sobre ella
Ollama funciona con 8,9 millones de desarrolladores activos mensuales con un equipo de 14 personas, está presente en el 85 % del Fortune 500, y recaudó $65M liderado por Theory Ventures en julio de 2026 (TechCrunch). Ese no es un proyecto que desaparezca el año próximo. El pegamento de enrutamiento a su alrededor es la parte que te pertenece, y puedes tomar prestada la mayor parte de los repos de IA de código abierto que ya publican este patrón.
Decide en cinco preguntas
Respóndelas en orden. La primera que te dé un sí categórico decide tu configuración y puedes parar ahí.
¿Tienes un requisito de soberanía estricto?
Estricto significa red aislada, exposición al CLOUD Act que el departamento legal ha puesto por escrito, o un contrato que nombra la máquina. Si ese eres tú, compra el hardware y deja de leer la sección de costos. Si tu requisito es más flexible que eso, Anthropic puede anclar la inferencia solo a EE. UU. con inference_geo: "us" en Claude 4.6 y posteriores con un multiplicador de 1,1x en todas las categorías de tokens (documentación de precios de Anthropic), y los planes de pago de Ollama ofrecen cero retención de datos en EE. UU. y Europa (Ollama). Una prima del 10 % supera a $4,699 de hardware para casi todo el mundo.
¿Tu trabajo está limitado por latencia o por rendimiento?
Los bucles interactivos donde una persona espera cada token favorecen lo local: 50–200 ms hasta el primer token frente a 200–800 ms de la nube, con Claude Haiku 4.5 medido en 597 ms (Eden AI). El trabajo de rendimiento va en sentido contrario. Ponlo en batch y toma el 50 % de descuento, que pone a Haiku 4.5 en $0,50/MTok entrada y $2,50 salida (Anthropic).
¿Estará la GPU ocupada más de una cuarta parte del día?
Por debajo de esa línea tu tarjeta se deprecia en inactividad y los pesos abiertos alojados ganan en costo. Por encima de ella, los números locales empiezan a funcionar. Sé honesto con el denominador, ya que las noches y los fines de semana cuentan.
¿Tu tarea necesita conocimiento del mundo o solo razonamiento?
Razonar sobre el texto que tú proporcionas funciona bien en un modelo MoE de 20–30B. Las preguntas que dependen de hechos que el modelo ya tiene que conocer pertenecen a una API de frontera, o a GLM-5.2 alojado, que tiene 744B parámetros totales y nunca cabe en tu portátil (Artificial Analysis).
¿Puedes tolerar reajustes cada trimestre?
La brecha abierto-cerrado está en 4 meses y se movió desde un promedio de 3 meses (Epoch AI), así que tu umbral de enrutamiento tiene una fecha de caducidad. Los equipos que no vayan a revisarlo deberían usar por defecto una API de frontera con caché activado y no enrutar nada. Los que sí puedan hacerlo pueden consultar estudios de caso de implementaciones reales para ver cuáles fueron los umbrales de otras personas.
Qué cambiaría este veredicto en 2027
Este consejo tiene fecha de caducidad, y hay tres números concretos que la fijan.
Los precios de memoria se están desacelerando, no cayendo
Los precios de contrato de DRAM convencional subieron aproximadamente un 93–98 % trimestre a trimestre en 1T26, luego un 58–63 % en 2T26, con un 13–18 % pronosticado para 3T26. Esa curva se está aplanando. Todavía apunta hacia arriba. Una tasa de incremento más lenta no te devuelve los $700 que NVIDIA añadió al DGX Spark en febrero de 2026, y nada en las previsiones dice que los precios de calle bajen el año próximo. Planifica que el caso del hardware seguirá siendo débil hasta 2027 a menos que la demanda de los centros de datos se relaje.
Vigila la brecha abierto/cerrado, no el benchmark titular
Dos señales importan más que cualquier posición en un ranking. La primera es la brecha ECI de Epoch AI, que estaba en 4 meses, u 8 puntos, desde enero de 2026. La segunda es el número de parámetros activos: GLM-5.2 lidera en pesos abiertos con 40B activos de 744B totales, así que el día en que un modelo de menos de 30B activos se acerque a pocos puntos ECI de la frontera, la tarjeta de 24 GB vuelve a ser interesante. También vigila si la duplicación de tarifas en hora punta de Ollama (12:00–18:00 UTC en días laborables) se mantiene o se normaliza. Nuestros informes de tendencias de IA siguen los lanzamientos de modelos que moverían cualquiera de estos.
Preguntas frecuentes
¿Es más barato ejecutar un LLM localmente o usar una API cloud en 2026?
Para la mayoría de las personas, la nube, y la brecha se amplió en 2026. Claude Haiku 4.5 tiene un precio de lista de $1 por millón de tokens de entrada y $5 por millón de salida, cae a $0,50/$2,50 a través de la Batch API, y los aciertos de caché de prompts se facturan al 0,1x la tasa base de entrada (precios de Anthropic). Por otro lado, un NVIDIA DGX Spark pasó de $3,999 a $4,699 en febrero de 2026 por los costos de DRAM y almacenamiento (Notebookcheck), y sigues pagando electricidad a una media residencial en EE. UU. de 18,34 ¢/kWh en junio de 2026 (EIA). Lo local gana dinero en trabajo en bloque de alto volumen sostenido que mantiene la tarjeta ocupada gran parte del día, en operación en red aislada y en bucles sensibles a la latencia.
¿Qué hardware necesito para ejecutar un LLM localmente en 2026?
Una GPU de 24 GB es el suelo práctico de consumo, y te limita a la clase de mezcla de expertos de 20–30B en lugar de algo cercano a la frontera de pesos abiertos. Por encima de eso, estás comprando un equipo con 128 GB de LPDDR5X como el DGX Spark, que ahora cuesta $4,699 (Notebookcheck). Presupuesta para precios de memoria que siguen subiendo: los precios de contrato de DRAM convencional subieron aproximadamente un 93–98 % trimestre a trimestre en 1T26 y un 58–63 % en 2T26, con otro 13–18 % pronosticado para 3T26 (TrendForce). La cuantización estira lo que cabe, y 4 bits es casi gratuito: Q4_K_M redujo Mistral-7B-Instruct-v0.2 de 7,2 GB a 4,1 GB con una pérdida de perplejidad del 0,51 %, mientras que Q2_K se degradó bruscamente al 7,94 % (compensaciones de cuantización).
¿Qué tan buenos son los modelos locales comparados con Claude o GPT?
La brecha ampliamente citada es real pero describe hardware que probablemente no tienes. Epoch AI midió que los modelos de pesos abiertos van por detrás de los modelos de frontera cerrada una media de 4 meses, u 8 puntos ECI, desde enero de 2026, ligeramente más que el promedio de 3 meses para enero de 2023 a octubre de 2025 (Epoch AI). El modelo que sostiene esa afirmación, GLM-5.2, obtiene 51 en el Índice de Inteligencia v4.1 de Artificial Analysis con 744B totales y 40B parámetros activos, lo que es hardware de centro de datos (Artificial Analysis). Lo que cabe realmente en un portátil o una sola GPU es fuerte en razonamiento estructurado y débil en conocimiento del mundo, así que trata la cifra de 4 meses como un techo que no puedes alcanzar en casa.
¿Ollama sigue siendo gratuito y cómo se compara el precio de Ollama Cloud con las APIs de frontera?
El marco local-versus-Ollama dejó de tener sentido el 31 de agosto de 2026, cuando Ollama pasó sus planes Pro, Max y Team a precios cloud por token: $20/mes con $60 de uso incluido, $100/mes con $300 y $500/mes con $1,000 compartidos entre usuarios ilimitados, sin retención de datos alojados en EE. UU. y Europa (blog de Ollama). Los pesos abiertos alojados son baratos ahí: deepseek-v4-flash corre a $0,22 entrada y $0,66 salida por millón de tokens, nemotron-3-super a $0,015/$0,60, qwen3.5:397b a $0,60/$3,60, aunque la mayoría de las tarifas se duplican en horas punta de 12:00 a 18:00 UTC en días laborables (precios de Ollama). Compara eso con Claude Haiku 4.5 a $1/$5 (precios de Anthropic) y la decisión real es de tres vías, con los pesos abiertos alojados superando a tu propia GPU en costo para la mayoría de las cargas de trabajo. Ollama tiene la escala para ser tomado en serio de cualquier manera, con 8,9 millones de desarrolladores activos mensuales y el 85 % del Fortune 500 (TechCrunch).
¿Ejecutar un modelo localmente hace que mis datos sean más privados que con una API cloud?
Te da una propiedad que nada más ofrece: que los bytes nunca salen de tu máquina, y eso importa para el trabajo en red aislada y para requisitos estrictos de soberanía de datos como el CLOUD Act. Para todo lo que sea menos estricto que eso, los proveedores ahora venden la misma garantía a bajo precio. En Claude 4.6 y posteriores, anclar la inferencia solo a EE. UU. con inference_geo: "us" cuesta un multiplicador de 1,1x en todas las categorías de tokens (precios de Anthropic), y los planes de pago de Ollama ofrecen cero retención de datos en EE. UU. y Europa (blog de Ollama). Una prima del 10 % es un compromiso mucho menor que $4,699 de hardware (Notebookcheck).
¿Con qué modelo local debería empezar en una GPU de 24 GB?
Empieza con un modelo de mezcla de expertos de 20–30B como Qwen3-30B-A3B o gpt-oss-20b, cuantizado a Q4_K_M. Esa clase obtiene un 73–87 % en AIME 2024 en una sola RTX 5090, así que el razonamiento se mantiene bien, mientras que el recuerdo de hechos sobre el mundo es donde falla. Q4_K_M es la parada correcta de cuantización: redujo un modelo de 7,2 GB a 4,1 GB con una pérdida de perplejidad del 0,51 %, y Q2_K se degradó bruscamente al 7,94 % (compensaciones de cuantización). Ejecútalo como primer salto y escala las consultas con mucho conocimiento a un modelo cloud.