

Tus salidas son mediocres porque tus entradas están infladas, obsoletas o mal ordenadas. No porque hayas redactado mal el prompt. La propia documentación de Anthropic lo dice sin rodeos: "más contexto no es automáticamente mejor. A medida que el número de tokens crece, la precisión y la recuperación se degradan, un fenómeno conocido como context rot" (Claude Platform docs). La ingeniería de contexto es la solución, y Anthropic la define como curar "el conjunto óptimo de tokens (información) durante la inferencia del LLM" (Anthropic Engineering).
Los números no son amables con el hábito maximalista. En NoLiMa, 11 de 13 modelos que anuncian contextos de 128K o más cayeron por debajo de la mitad de su puntuación en contexto corto al llegar a los 32K tokens (arXiv:2502.05167).
Este es un manual para quienes usan ChatGPT, Claude, Gemini y Copilot en lugar de construir frameworks de agentes: qué parámetro ajustar, en qué producto, y cuánto vale según los datos.
La ingeniería de contexto reemplazó a la magia de los prompts
Si tus salidas son mediocres, la redacción del prompt rara vez es el problema. La ingeniería de contexto es la práctica que corrige esto: Anthropic la define como "el conjunto de estrategias para curar y mantener el conjunto óptimo de tokens (información) durante la inferencia del LLM, incluyendo toda la demás información que puede llegar allí fuera de los prompts", y la llama la progresión natural de la ingeniería de prompts (Anthropic Engineering). La pregunta pasó de "¿cómo lo formulo?" a "¿qué configuración de contexto tiene más probabilidades de generar el comportamiento deseado en nuestro modelo?"
De "¿cómo lo formulo?" a "¿qué debe estar en la ventana?"
La redacción sigue importando en los márgenes. Simplemente dejó de ser donde está el apalancamiento. Una pregunta perfectamente formulada contra una ventana inflada y medio relevante pierde ante una pregunta directa contra una ventana limpia, y el resto de este artículo es en su mayor parte evidencia de esa afirmación.
La mayoría de las 212 herramientas de ingeniería de prompts que rastreamos optimizan la oración que escribes. Casi ninguna toca las otras cinco cosas que comparten la ventana con ella.
Las cinco entradas que realmente controlas
Cada solicitud ensambla una ventana a partir de partes que puedes ver y modificar:
- Las instrucciones del sistema, ya sea el campo de instrucciones de un GPT personalizado, la descripción de un Proyecto de Claude, o un archivo CLAUDE.md en tu repositorio.
- La memoria: lo que el producto ha guardado sobre ti entre sesiones, generalmente sin mostrarte el texto completo.
- Los documentos adjuntos y su calidad de análisis, que es la variable más subestimada de toda la pila.
- Los fragmentos recuperados, si la herramienta hace recuperación, más lo que el recuperador decidió que era relevante.
- Los turnos anteriores de la conversación, incluido cada callejón sin salida que abandonaste veinte mensajes atrás.
- Las definiciones de herramientas, que consumen tokens tanto si se llama a alguna herramienta como si no.
Son seis, y los controlas todos desde la interfaz del producto. Sin frameworks, sin clave de API.
Así que este es un manual del lado de las entradas, escrito para quienes usan ChatGPT, Claude, Gemini y Copilot en lugar de construir sistemas de agentes sobre ellos. Qué parámetro ajustar, en qué producto, y qué dicen los números de 2026 que vale.
La ventana de contexto de IA explicada: tamaño anunciado vs. tamaño utilizable
El número en la ficha técnica es un límite de almacenamiento, no una garantía de rendimiento. Un modelo que acepta un millón de tokens los aceptará con gusto y luego responderá peor que si tuviera 3.000. Trata la ventana anunciada como el techo de una habitación, no como el tamaño del escritorio en el que puedes trabajar.
Qué cuenta realmente contra la ventana
Más de lo que crees. Cada parte de una solicitud a la API ocupa el mismo presupuesto: el system prompt, cada mensaje del hilo incluyendo los resultados de las herramientas, imágenes y PDFs, las definiciones de herramientas en sí mismas, y la propia salida del modelo incluyendo el pensamiento extendido (Claude Platform docs). Los prefijos en caché también ocupan la ventana. El caché de prompts cambia lo que pagas por esos tokens, no si cuentan.
Así que un chat que parece corto puede estar cargando 40.000 tokens de PDF adjunto, esquemas de herramientas y razonamiento previo que nunca ves. Esa es la parte que las páginas de enciclopedia omiten.
El acantilado de los 32K que nadie pone en la ficha técnica
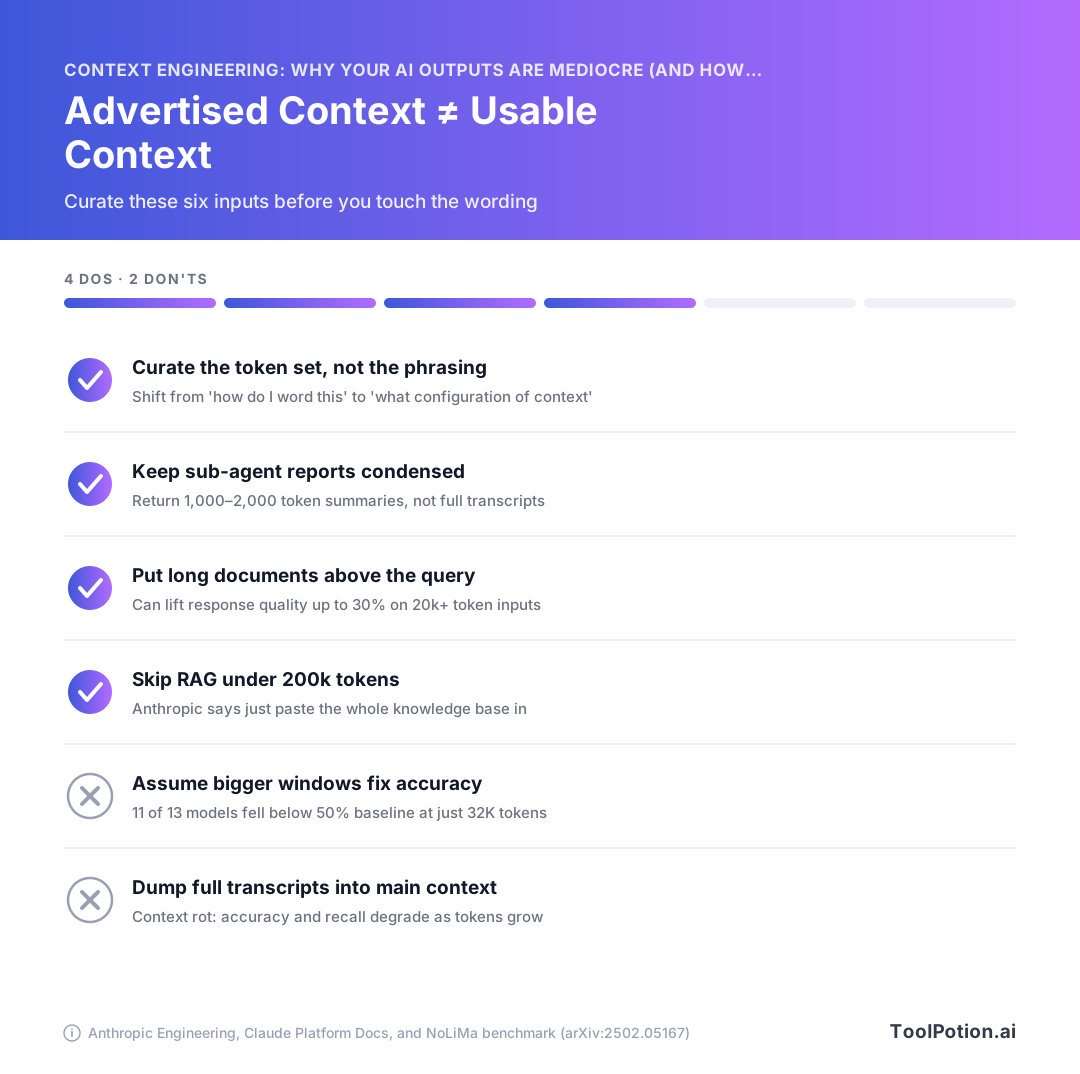
El benchmark NoLiMa eliminó la superposición literal de palabras entre la pregunta y la respuesta enterrada en el pajar, y luego ejecutó 13 modelos que todos afirman tener un contexto de 128K o más. Por debajo de 1K tokens funcionaron bien. A los 32K, 11 de los 13 habían caído por debajo de la mitad de su propia línea base en contexto corto, y Llama 3.1 70B pasó del 94,3% al 42,7% (NoLiMa, arXiv:2502.05167). Ese preprint es de febrero de 2025, así que es anterior a todos los modelos de la tabla siguiente. La forma del hallazgo se ha mantenido en trabajos más recientes, pero los porcentajes específicos son evidencia que envejece, no un marcador actual.
Cuáles son las ventanas actuales (cifras de 2026)
| Modelo | Ventana de contexto | Salida máxima | Imágenes/páginas PDF por solicitud |
|---|---|---|---|
| Claude Fable 5.1, Opus 5, Sonnet 5 (and Mythos 5.1, Opus 4.8/4.7/4.6, Sonnet 4.6) | 1M tokens, predeterminado, precios estándar | 128k | 600 |
| Claude Sonnet 4.5 y versiones anteriores | 200k | — | 100 |
| OpenAI GPT-5.4 | 1.050.000 tokens | 128.000 | — |
Anthropic ofrece esa ventana de 1M sin encabezado beta ni recargo (Claude Platform docs). La de OpenAI es nominalmente más grande y tiene un precio diferente: si superas los 272K tokens de entrada en GPT-5.4, toda la sesión se factura al 2x de entrada y al 1,5x de salida (OpenAI API docs). El exceso es una línea de factura allí, no solo un impuesto a la calidad.
Si comparas capacidades entre proveedores, consulta la página de especificaciones del propio modelo en lugar de resúmenes: las ventanas cambiaron dos veces solo en 2026, y las tablas desactualizadas están en todas partes. Nuestro directorio de 324 modelos de IA es un punto de partida para encontrar la página correcta.
Context rot: por qué agregar más suele empeorar las salidas
La degradación tiene un mecanismo, y no es misterioso. Un transformer tiene que modelar n² relaciones por pares entre n tokens, así que cada token que agregas hace que todos los demás compitan un poco más por la atención del modelo. El equipo de ingeniería de Anthropic llama a esto un presupuesto de atención finito, análogo a la memoria de trabajo humana, y dice que la atención se "diluye" a medida que crece el contexto. Su prescripción es directa: encontrar "el conjunto más pequeño posible de tokens de alta señal que maximicen la probabilidad de un resultado deseado".
El problema del presupuesto de atención
La propia documentación de producto de Anthropic concede el punto en lugar de suavizarlo. "Más contexto no es automáticamente mejor", dice la documentación de la plataforma. "A medida que el número de tokens crece, la precisión y la recuperación se degradan, un fenómeno conocido como context rot." Es el proveedor que te vende una ventana de 1M tokens diciéndote que no la llenes.
Misma pregunta, misma respuesta, 375 veces el ruido
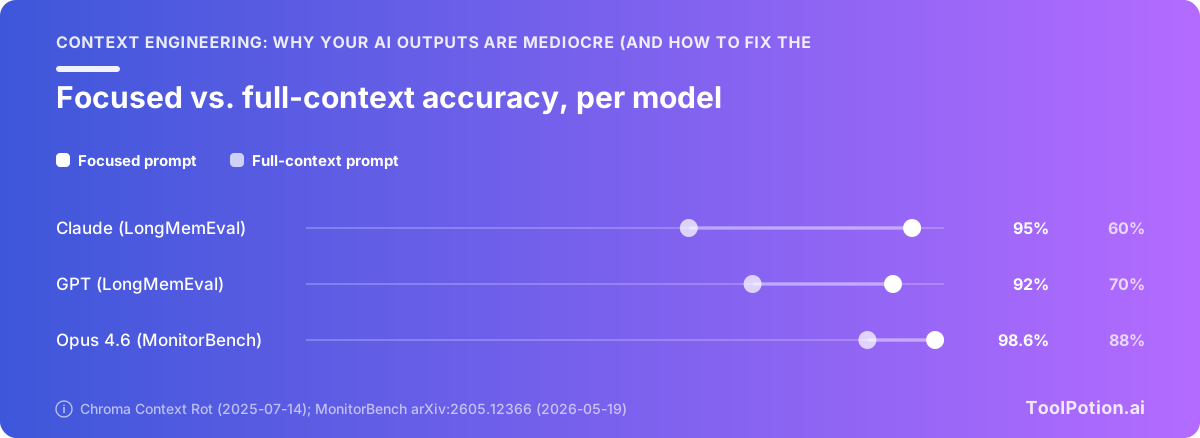
Chroma probó 18 modelos, incluyendo GPT-4.1, Claude 4, Gemini 2.5 y Qwen3, y encontró que la fiabilidad disminuye con entradas más largas incluso en tareas triviales como recuperación y replicación de palabras (Chroma). La ejecución de LongMemEval es la que hay que recordar. Todas las familias de modelos obtuvieron resultados significativamente mejores en prompts enfocados de aproximadamente 300 tokens que contenían solo los turnos relevantes que en prompts completos de unos 113k tokens con todo el historial de conversación, y los modelos de Claude mostraron la mayor diferencia. Misma pregunta. Misma respuesta presente en el contexto en ambos casos. La única variable era cuánto material irrelevante la rodeaba.
Chroma también encontró que los modelos puntuaban mejor con pajares desordenados que con documentos lógicamente coherentes, en los 18. El texto circundante coherente le da al modelo más lugares de aterrizaje que parecen plausibles. Ese informe se publicó el 14 de julio de 2025, así que tiene más de un año y es anterior a la generación de modelos actual.
El efecto no ha desaparecido. En MonitorBench, anteponer 800k tokens de acciones benignas e irrelevantes redujo la recuperación de Opus 4.6 del 98,6% al 88% (arXiv:2605.12366). Nada de la tarea cambió. Solo el relleno.
Dónde te afecta en el uso normal
Ya lo has visto sin nombrarlo. El chat que clavó tu briefing en el mensaje 12 y produce relleno genérico en el mensaje 90, porque el briefing está ahora enterrado bajo 78 mensajes de borradores a medio abandonar. El cuaderno de NotebookLM donde agregaste 40 fuentes por exhaustividad y empezaste a obtener respuestas más vagas que con ocho. La sesión de programación donde el modelo olvida una restricción que mencionaste hace una hora y la reescribe con confianza.
Nada de eso es el modelo volviéndose perezoso. Eres tú gastando el presupuesto de atención en tokens que no se ganan su lugar.
Preparación de documentos: el paso que casi todos omiten
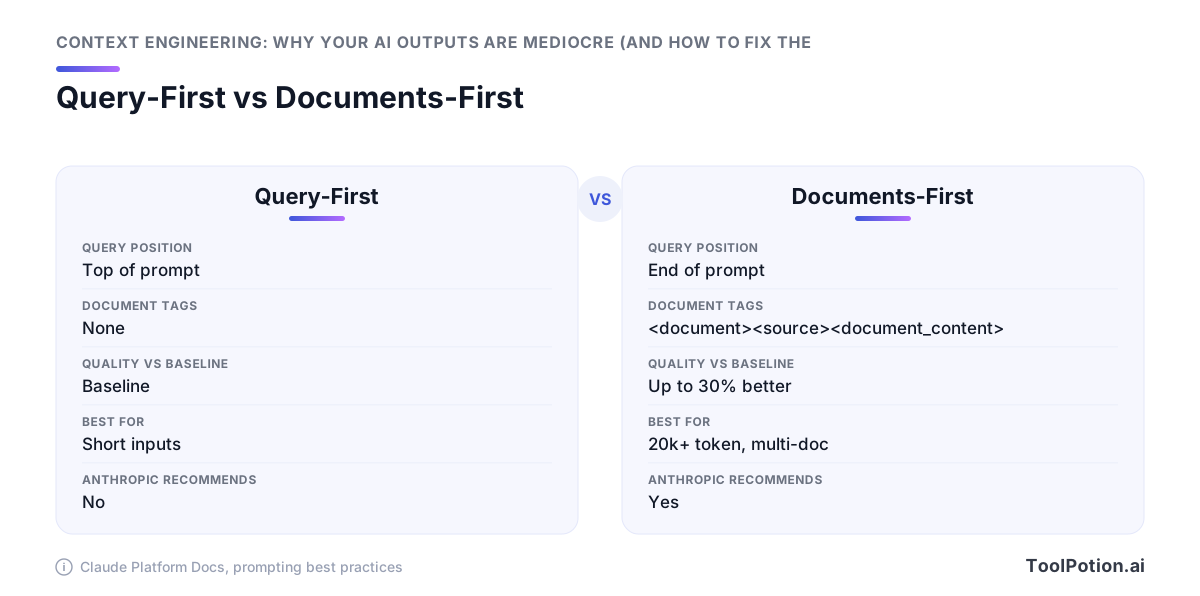
Dónde colocas un documento en el prompt cambia la respuesta que obtienes. Para entradas de más de 20.000 tokens, la documentación de prompts de Anthropic indica que debes colocar los datos en formato largo al principio, por encima de tu consulta, instrucciones y ejemplos: "las consultas al final pueden mejorar la calidad de la respuesta hasta en un 30 por ciento en las pruebas, especialmente con entradas complejas de múltiples documentos" (Claude Platform docs). La mayoría de la gente hace lo contrario. Escribe la pregunta y luego pega el informe debajo.
Pon el material largo al principio
La misma documentación te da una estructura que vale la pena copiar literalmente: envuelve cada documento en etiquetas <document> con subetiquetas <source> y <document_content>, para que el modelo pueda distinguir dónde termina un archivo y dónde empieza el siguiente (Claude Platform docs). Luego pídele que cite los pasajes relevantes antes de responder. Esa línea obliga al modelo a localizar evidencia en el texto en lugar de reconstruirla de lo que recuerda a medias, y te da algo verificable cuando la respuesta parece incorrecta.
<document>
  <source>Q3-board-deck.pdf</source>
  <document_content>...full text here...</document_content>
</document>
<document>
  <source>renewal-contract-2026.pdf</source>
  <document_content>...full text here...</document_content>
</document>

Before answering, quote the passages you relied on.
Question: which renewal terms conflict with the Q3 revenue plan?
Etiqueta tus fuentes para que el modelo pueda citarlas
Una advertencia antes de estandarizar esto: los proveedores no están de acuerdo. Anthropic pone los datos largos primero; la guía de Google apunta en sentido contrario, diciéndote que cierres con tus instrucciones. Así que una plantilla de prompt tomada de un tutorial de Gemini y pegada en Claude puede rendir por debajo sin parecer nunca rota. Ejecuta el mismo conjunto de documentos en ambos órdenes en el modelo que realmente pagas, diez preguntas cada uno, y quédate con el orden que gana. Son veinte minutos de trabajo contra una mejora declarada del 30%.
La elección del analizador decide lo que el modelo llega a ver
Nada de esto rescata una extracción defectuosa. Una tabla de factura escaneada que sale como una sola línea continua, un artículo de dos columnas intercalado fila por fila, una nota al pie insertada a mitad de frase: el modelo lee esa basura fielmente y responde a partir de ella. Tu paso de extracción establece el techo de la precisión, y todo lo que sigue está limitado por él. Trata el analizador como una decisión de calidad y prueba dos o tres con tu archivo real más difícil antes de comprometerte. Nuestro directorio lista 217 herramientas de IA para documentos y PDF, y la diferencia entre las buenas y las malas aparece en tus salidas, no en sus páginas de marketing.
Higiene de recuperación: menos fragmentos pero mejores, superan a más fragmentos
Antes de construir una capa de recuperación, comprueba si la necesitas. La propia guía de Anthropic dice que si tu base de conocimientos es menor de 200.000 tokens (unas 500 páginas), puedes simplemente incluir todo en el prompt sin recuperación alguna (Anthropic Engineering). La mayoría de las wikis internas, manuales de producto y conjuntos de políticas caben por debajo de esa línea.
¿Realmente necesitas recuperación?
Si tu corpus cabe, omite la base de datos vectorial. Evitarás decisiones de fragmentación, deriva de embeddings y toda una clase de fallos silenciosos donde el párrafo correcto nunca llega al prompt. Combínalo con caché de prompts para no pagar el precio completo por los mismos 200k tokens en cada llamada.
Por encima de ese tamaño, la recuperación deja de ser opcional y la calidad se convierte en una pila de pequeñas correcciones que se acumulan.
Las tres correcciones que se acumulan
Anthropic las evaluó una a una. Anteponer contexto específico del fragmento a cada fragmento antes de hacer el embedding redujo los fallos de recuperación entre los 20 primeros del 5,7% al 3,7%, una reducción de aproximadamente el 35%. Añadir búsqueda híbrida BM25 contextual llevó los fallos al 2,9%, una reducción del 49%. Añadir un paso de reranking por encima lo llevó al 1,9%, una reducción total del 67% (Anthropic Engineering). Cada paso es poco glamoroso por sí solo, y los tres juntos triplican aproximadamente la mejora del primero.
Recortar las definiciones de herramientas también cuenta
Los esquemas de herramientas son contexto. Si le das a un modelo cuarenta definiciones de herramientas y necesita dos, has pagado por treinta y ocho distractores. El trabajo RAG-MCP recuperó solo los esquemas relevantes en lugar de listarlos todos y redujo los tokens del prompt en más de la mitad, mientras que la precisión en la selección de herramientas pasó del 13,62% al 43,13% (arXiv:2505.03275). Es la misma disciplina que la selección de fragmentos, aplicada un nivel más arriba.
El patrón de sub-agente de Anthropic lo extiende aún más: los agentes especializados hacen el trabajo de búsqueda y devuelven resúmenes condensados de unos 1.000 a 2.000 tokens a un agente coordinador, para que el contexto principal nunca vea las transcripciones de búsqueda en bruto (Anthropic Engineering). Si estás eligiendo componentes en lugar de escribirlos, nuestro directorio lista 550 agentes de IA y un conjunto de frameworks de recuperación y agentes que implementan estos patrones de fábrica.
Características de memoria: qué parámetro ajustar en cada herramienta
Cada producto de IA de consumo ahora inyecta cosas en tu contexto que no escribiste. Hechos guardados, chats anteriores, actividad de la aplicación, archivos de proyecto subidos. No puedes hacer ingeniería de contexto en una aplicación de chat hasta que sepas qué está ya en la ventana antes de tu primera palabra.
Una memoria incorrecta cuesta más que ninguna memoria. Es texto que parece de alta señal y que el modelo trata como un hecho, y está cerca de tus instrucciones donde la atención es más fuerte. Títulos de trabajo obsoletos, el nombre antiguo de un cliente, una preferencia que configuraste una vez para una tarea puntual: cada uno sesga silenciosamente cada respuesta posterior.
ChatGPT: dos controles independientes
La memoria de ChatGPT son dos mecanismos, no uno. Las memorias guardadas son hechos almacenados discretos que puedes leer y eliminar individualmente, mientras que la referencia al historial de chat extrae de tus conversaciones anteriores a través de una ruta de recuperación separada (Embrace The Red). Apagar uno deja al otro funcionando. Si tus salidas todavía huelen al proyecto del mes pasado después de que borraste las memorias guardadas, el control del historial es el que te perdiste.
Claude: conocimiento del proyecto y escrituras de memoria a mitad de conversación
Desde la unificación de Cowork el 25 de agosto de 2026, Claude escribe memorias a mitad de conversación en lugar de solo en los límites de sesión, así que lo que dices en el chat se traslada a sesiones posteriores (TechCrunch). Eso significa que un comentario de pasada puede convertirse en contexto duradero.
El conocimiento del proyecto es el mejor lever, porque es un corpus que elegiste. Mantenlo por debajo de la regla general de 200.000 tokens de Anthropic (unas 500 páginas) y puede incluirse completo sin que una capa de recuperación adivine qué fragmentos importan (Anthropic). Pódalo como una lista de lectura, no como un archivo.
Gemini: tres sistemas superpuestos donde 'desactivar' no es 'eliminar'
Gemini combina contexto personal, información guardada que escribiste tú mismo, y actividad de las aplicaciones de Google conectadas. Desactivar una fuente detiene las nuevas escrituras. No elimina lo que ya está almacenado, así que una auditoría significa visitar cada control por separado y eliminar, no solo desactivar.
NotebookLM: la alternativa con fuentes limitadas
NotebookLM limita cuántas fuentes puede tener un cuaderno, y el límite juega a tu favor. Obliga a la curación que las otras tres te permiten omitir, que es la misma disciplina que Anthropic prescribe: encuentra el conjunto más pequeño de tokens de alta señal que consiga el resultado que quieres (Anthropic). Cuando una pregunta necesita ocho documentos y no ochenta, empieza ahí.
Elige una herramienta como tu asistente con memoria y mantén el resto limpio. De las 13.174 aplicaciones de IA en nuestro directorio, las que hacen la memoria auditable por elemento valen más que las que prometen que recuerda todo.
Las instrucciones a nivel de proyecto son contexto reutilizable
El contexto más barato que escribirás es el contexto que escribes una vez. Cada herramienta de IA seria ahora tiene un espacio para instrucciones permanentes que se inyectan en cada sesión: AGENTS.md y CLAUDE.md en un repositorio, Proyectos de Claude, instrucciones personalizadas de ChatGPT, archivos de instrucciones de Copilot. La mayoría de la gente deja esos espacios vacíos y luego reescribe los mismos tres párrafos de contexto en cada nuevo chat.
Por qué un archivo de instrucciones permanentes supera a re-explicar
Un estudio en 10 repositorios y 124 pull requests midió qué hace un archivo AGENTS.md a nivel de repositorio en el comportamiento de un agente, y el resultado no es solo sobre corrección. El tiempo de ejecución medio cayó un 28,64%, de 98,57 segundos a 70,34 segundos, y los tokens de salida cayeron un 16,58% con tasas de completitud comparables (arXiv:2601.20404). El agente dejó de explorar para descubrir cosas que tú ya sabías.
Ese es el argumento en una frase. Un buen contexto permanente hace que el modelo sea más rápido y más barato, no solo más preciso, porque la mayor parte de lo que un agente consume en tokens es redescubrir tus convenciones. Si estás eligiendo entre los 260 asistentes de programación de IA en nuestro directorio, que la herramienta lea un archivo de instrucciones de proyecto es un mejor filtro que la mayoría de las comparaciones de características.
Qué pertenece realmente a uno
Mantenlo lo suficientemente corto como para que tú mismo lo leerías. Cinco cosas se ganan su lugar:
- Convenciones que el código no anuncia, como qué test runner es real y cuál está muerto.
- Tu vocabulario. Si «cuenta» y «tenant» significan cosas diferentes aquí, dilo una vez.
- La forma de salida que quieres de vuelta, en el formato que lo quieres (un diff, una tabla, cinco puntos).
- Una lista corta de cosas prohibidas. No toques archivos generados, no añadas dependencias sin preguntar.
- Dónde vive la fuente de verdad, para que el modelo la consulte en lugar de adivinar.
Deja fuera cualquier cosa que la herramienta pueda leer por sí misma. Árboles de directorios, listados de archivos, firmas de funciones repetidas, un resumen de tu README. Esos son tokens gastados duplicando algo que el agente puede obtener en una llamada, y compiten por la atención con las instrucciones que importan. Reescribe el archivo cuando empiece a ignorarse, lo que generalmente significa que se volvió demasiado largo.
El contexto inflado tiene un precio
El contexto descuidado cuesta dinero en la factura, no solo calidad en la salida. Dos mecanismos de precios lo concretan, y ambos recompensan la misma disciplina: un prefijo pequeño, estable y ordenado.
El escalón de los 272K en GPT-5.4
El GPT-5.4 de OpenAI tiene una ventana de contexto de 1.050.000 tokens con hasta 128.000 tokens de salida, pero los prompts de más de 272K tokens de entrada se "facturan a 2x de entrada y 1,5x de salida para toda la sesión" (OpenAI API docs). Lee eso con cuidado. Cruzar la línea una vez no te cuesta un poco más en el exceso. Reprecio toda la sesión, incluyendo la salida, así que pegar descuidadamente un volcado de 300K tokens duplica tu factura de entrada en cada turno que sigue.
Estás pagando el doble por los tokens que más probablemente estén degradando tu respuesta de todos modos.
El caché recompensa un prefijo estable
La API de Claude cobra las lecturas de caché al 0,1x del precio base de entrada, un descuento del 90%, mientras que las escrituras de caché cuestan 1,25x en el TTL de 5 minutos o 2x en el TTL de 1 hora (Claude Platform docs). Su ejemplo práctico: 100k tokens reutilizados diez veces dan $1,075 frente a $5,00 sin caché, un ahorro del 78,5%.
Ese descuento solo se aplica si el prefijo coincide byte por byte. El caché usa como clave un prefijo exacto, así que si reordenas tus documentos, insertas una marca de tiempo en el system prompt, o cambias el orden de las definiciones de herramientas entre turnos, pagas el precio de escritura de nuevo en lugar del precio de lectura. El hábito que mantiene el caché caliente es el mismo que mantiene la recuperación alta: pon el material estable primero en un orden fijo, y deja que solo la consulta cambie al final.
Una auditoría de contexto que puedes hacer esta semana
Nada de esto necesita una clave de API ni un ticket de ingeniería. Cada elemento es un parámetro que ya tienes.
Seis comprobaciones antes de tu próxima sesión larga
- Abre un nuevo chat en lugar de extender el de ayer. Los prompts enfocados de Chroma (~300 tokens de turnos relevantes) superaron a los historiales completos de 113k tokens en todas las familias de modelos que probaron, con Claude mostrando la mayor diferencia (Chroma).
- Lee tus memorias guardadas y elimina las obsoletas. Los hechos guardados se inyectan tanto si ayudan como si no.
- Adjunta tres buenos documentos en lugar de doce mediocres, y envuelve cada uno en etiquetas
<document>con una subetiqueta<source>para que el modelo pueda distinguirlos (Claude docs). - Pon el material largo por encima de tu pregunta. En entradas de más de 20k tokens, ese orden vale hasta un 30% mejores respuestas en las pruebas de Anthropic (Claude docs).
- Escribe las instrucciones permanentes una vez. Un AGENTS.md a nivel de repositorio redujo el tiempo de ejecución medio un 28,64% y los tokens de salida un 16,58% en 124 PRs (arXiv).
- Mantén ese prefijo idéntico turno a turno. Los prefijos estables llegan al caché al 0,1x del precio de entrada (Claude docs).
El único hábito que corrige la mayoría de las malas salidas
Antes de reescribir el prompt, mira qué hay ya en la ventana y saca algo. La propia documentación de Anthropic lo dice: "más contexto no es automáticamente mejor" (Claude docs). Cambia lo que le das al modelo antes de cambiar cómo se lo pides.
Preguntas frecuentes
¿Qué es la ingeniería de contexto y en qué se diferencia de la ingeniería de prompts?
Anthropic define la ingeniería de contexto como "el conjunto de estrategias para curar y mantener el conjunto óptimo de tokens (información) durante la inferencia del LLM, incluyendo toda la demás información que puede llegar allí fuera de los prompts" (Anthropic Engineering). La ingeniería de prompts pregunta cómo formular una solicitud. La ingeniería de contexto pregunta qué configuración de contexto tiene más probabilidades de producir el comportamiento que quieres, y abarca todo lo que ocupa la ventana: el system prompt, cada mensaje incluyendo los resultados de las herramientas, imágenes y PDFs, las definiciones de herramientas en sí mismas, y la propia salida del modelo incluyendo el pensamiento extendido (Claude Platform docs). Anthropic lo enmarca como la progresión natural de la ingeniería de prompts, no como un reemplazo.
¿Una ventana de contexto más grande siempre significa mejor salida de IA?
No. El contexto anunciado y el contexto utilizable son dos números diferentes: el benchmark NoLiMa probó 13 modelos que todos afirman tener soporte de 128K o más, y a los 32K tokens 11 de los 13 puntuaron por debajo de la mitad de su propia línea base en contexto corto, con Llama 3.1 70B cayendo del 94,3% al 42,7% (arXiv:2502.05167, febrero de 2025). La propia documentación de la plataforma de Anthropic lo dice claramente: "más contexto no es automáticamente mejor. A medida que el número de tokens crece, la precisión y la recuperación se degradan" (Claude Platform docs). Llenar la ventana también cuesta dinero en escalones en lugar de en una línea, ya que OpenAI factura los prompts de GPT-5.4 de más de 272K tokens de entrada al 2x de entrada y 1,5x de salida para toda la sesión (OpenAI API docs).
¿Qué es el context rot y cómo lo evito?
El context rot es la degradación de la precisión y la recuperación a medida que crece el número de tokens en una solicitud, y Anthropic lo nombra en su propia documentación (Claude Platform docs). El estudio Context Rot de Chroma probó 18 modelos incluyendo GPT-4.1, Claude 4, Gemini 2.5 y Qwen3, y encontró que la fiabilidad disminuye con entradas más largas incluso en tareas triviales de recuperación y replicación de palabras; en su prueba LongMemEval, cada familia de modelos obtuvo mejores resultados en un prompt enfocado de ~300 tokens que en la misma pregunta enterrada en ~113k tokens de historial de conversación, con los modelos de Claude mostrando la mayor diferencia (Chroma, julio de 2025). Evítalo pegando solo los pasajes que importan, empezando chats nuevos para nuevos temas en lugar de extender los antiguos, y haciendo que los agentes especializados devuelvan resúmenes condensados de 1.000 a 2.000 tokens a un agente coordinador en lugar de transcripciones completas (Anthropic Engineering).
¿Debería desactivar la memoria de ChatGPT, Claude o Gemini?
Depende de la tarea, porque la memoria inyecta tokens que no elegiste en una ventana donde todo cuenta contra el total (Claude Platform docs). Para la redacción de rutina donde que el modelo conozca tu rol, estilo y stack te ahorra reescribirlo, déjala activada. Para el análisis de alto riesgo de un documento específico, empieza un chat limpio con la memoria desactivada, ya que Chroma encontró que cada familia de modelos respondía mejor desde un prompt enfocado de ~300 tokens que desde la misma respuesta rodeada de ~113k tokens de historial no relacionado (Chroma). Trata la memoria como un system prompt por el que estás pagando en cada turno, y pódala como podarías un system prompt.
¿Necesito RAG, o puedo simplemente pegar mis documentos en el prompt?
La guía de Anthropic es que la recuperación a menudo no es necesaria a pequeña escala: "Si tu base de conocimientos es menor de 200.000 tokens (unas 500 páginas de material), puedes simplemente incluir toda la base de conocimientos en el prompt" (Anthropic Engineering, septiembre de 2024). Por encima de eso, la higiene de recuperación se acumula en el benchmark de Anthropic: anteponer contexto específico del fragmento antes del embedding redujo los fallos de recuperación entre los 20 primeros del 5,7% al 3,7%, añadir búsqueda híbrida BM25 contextual lo llevó al 2,9%, y un paso de reranking lo llevó al 1,9%, una reducción total del 67%. Si tu corpus cabe, pegar es el valor predeterminado mejor, y el caché de prompts hace que la reutilización sea barata con lecturas de caché a 0,1x del precio base de entrada (Claude Platform docs).
¿Dónde debo poner los documentos largos en un prompt: antes o después de mi pregunta?
Para Claude, pon los datos en formato largo al principio, por encima de tu consulta, instrucciones y ejemplos. La documentación de prompts de Anthropic da esto como una regla concreta para entradas de 20k tokens o más y dice que "las consultas al final pueden mejorar la calidad de la respuesta hasta en un 30 por ciento en las pruebas, especialmente con entradas complejas de múltiples documentos" (Claude Platform docs). La misma documentación recomienda envolver cada documento en etiquetas <document> con subetiquetas <source> y <document_content>, y pedirle al modelo que cite los pasajes relevantes antes de responder. Los proveedores no están de acuerdo en el orden, así que una plantilla copiada del recetario de un proveedor puede rendir por debajo en el modelo de otro, y vale la pena probar ambos órdenes una vez en tu propia tarea.